1、 问题
最近项目中发现row_number()函数去重写法性能会比group by性能稍微差一些,原语句如下:
bash
SELECT
        COUNT(1)
FROM
        (
        WITH
                ORG AS
                (
                        SELECT
                                *
                        FROM
                                (
                                        SELECT
                                                group_code,
                                                group_name,
                                                ROW_NUMBER() OVER(PARTITION BY group_code ORDER BY NULL) RN
                                        FROM
                                                ORG_BASIS

                                        union all

                                        select
                                                '09' as group_code,
                                                group_name       ,
                                                ROW_NUMBER() OVER(PARTITION BY group_code ORDER BY NULL) RN
                                        from
                                                ORG_BASIS
                                        where
                                                group_code = '0900'

                                )
                        WHERE
                                RN = 1
                )

        select
                o1.group_name as pName,
                o2.group_name as bName  ,
                t1.BUREAU_CODE
        FROM
                TRAN_PLAN t1
        LEFT JOIN ORG o1
        ON
                t1.province_code = o1.group_code
        LEFT JOIN ORG o2
        ON
                t1.BUREAU_CODE = o2.group_code

        WHERE
                t1.PLAN_NATURE     = 1
            AND t1.POWER_GRID_FLAG = 1
            AND t1.SPECIALITY     IN (11, 12, 13)

            AND t1.PLAN_END_TIME  < DATEADD(YEAR, 1, TO_DATE(?, 'yyyy-mm-dd'))
            AND t1.PLAN_END_TIME >= TO_DATE(?, 'yyyy-mm-dd')

            AND T1.PROVINCE_CODE = ?

            AND T1.BUREAU_CODE = ?

            AND
                (
                        t1.PLAN_STATE IN (50, 60, 70, 110)
                )

        )
        t;
计划:
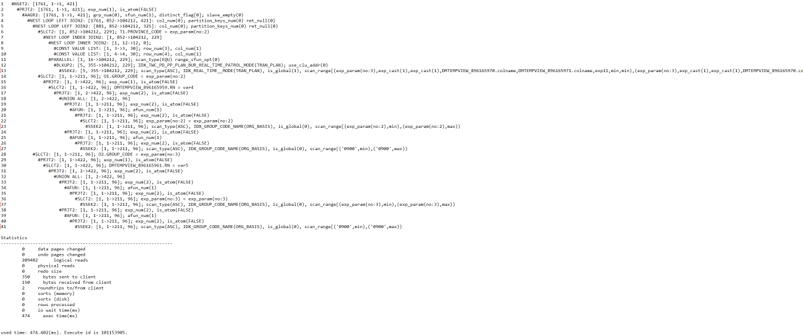
单次执行性能是正常的,但一定的压力下,热点就在窗口函数,压测情况如下:
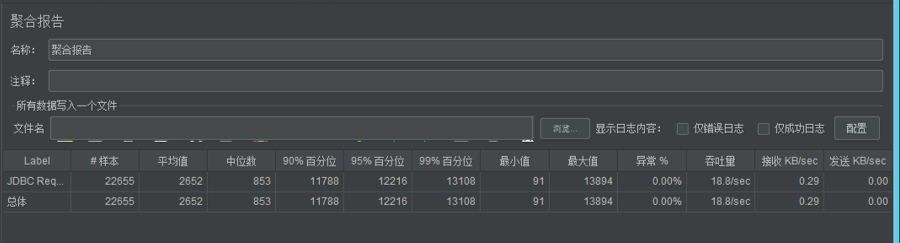
这里平均值达5s左右。
row_number() 是一种 SQL 窗口函数,常用于对分组数据进行排序并生成唯一的行号。大白话就是排序去重。
语句中是对group_code分组生成序号取第一个。group_name和group_code是一一对应的,那么对这两列进行分组就可以满足需求。因此可以用group by替换改写。
2、改写
bash
SELECT
        COUNT(1)
FROM
        (
        WITH
                ORG AS
                (
                        SELECT
                                *
                        FROM
                                (
                                        SELECT
                                                group_code,
                                                max(group_name) group_name
                                       FROM
                                                ORG_BASIS

                                       group by group_code
                                        union all

                                        select
                                                '09' as group_code,
                                                max(group_name) group_name
                                        from
                                                ORG_BASIS
                                        where
                                                group_code = '0900'
                                        group by group_code

                                )

                )

        select

                o1.group_name as pName,
                o2.group_name as buName  ,
                t1.bureau_code
        FROM
                TRAN_PLAN t1
        LEFT JOIN ORG o1
        ON
                t1.province_code = o1.group_code
        LEFT JOIN ORG o2
        ON
                t1.BUREAU_CODE = o2.group_code

        WHERE
                t1.PLAN_NATURE     = 1
            AND t1.POWER_GRID_FLAG = 1
            AND t1.SPECIALITY     IN (11, 12, 13)

            AND t1.PLAN_END_TIME  < DATEADD(YEAR, 1, TO_DATE(?, 'yyyy-mm-dd'))
            AND t1.PLAN_END_TIME >= TO_DATE(?, 'yyyy-mm-dd')

            AND T1.PROVINCE_CODE = ?

            AND T1.BUREAU_CODE = ?

            AND
                (
                        t1.PLAN_STATE IN (50, 60, 70, 110)
                )

        )
        t;
计划:
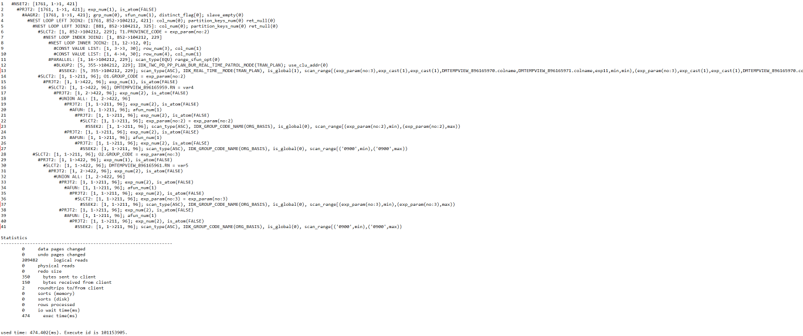
压测情况
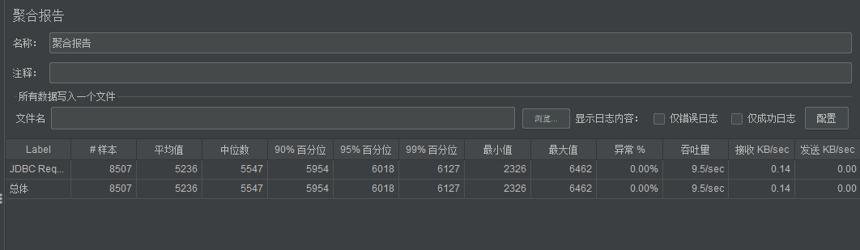
性能比较稳定。
3、小结
Row_number()函数会内部进行排序,因此比group by多了排序内存消耗,所以总的来说,能用group by替换row_number()做去重就选择group by。