埋点工具的选择,本质上是在代码埋点、可视化埋点、全埋点三种采集方式之间做取舍,再叠加行为分析型、AI Agent 型、BI 型三类工具形态做匹配。先看一张三类埋点方式的对比图,再按团队阶段对照选型路径,基本就能照着选。
一、埋点方式有哪几种:代码埋点、可视化埋点、全埋点对比
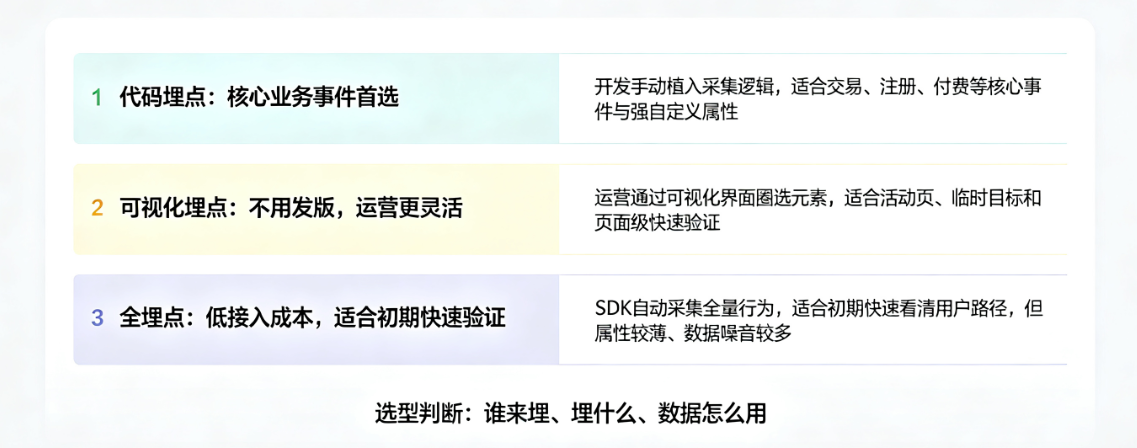 埋点方式主要有三种:代码埋点、可视化埋点、全埋点。三者的区别不在好不好,而在谁来埋、埋什么、数据怎么用。
1. 代码埋点:核心业务事件首选
代码埋点由开发在业务代码里手动植入采集逻辑,事件名称和属性定义在代码层明确写死。
它的优势在于精准和可控。交易、注册、付费、加购这类关键转化事件,需要携带订单金额、商品 ID、支付方式等强自定义属性,只有代码埋点能稳定承载。凡是要进核心分析模型的事件,大多适合用代码埋点来做。
适用场景是核心业务事件、需要强自定义属性的分析模型。代价是需要开发排期,每次调整都要发版。
2. 可视化埋点:不用发版,运营更灵活
可视化埋点通过可视化界面圈选页面元素完成事件配置,运营或产品在后台点选即可生成埋点。
它最大的优势是灵活、不用发版。营销活动页、临时转化目标、快速验证页面改动这类场景,可视化埋点能省掉开发排期,当天配置当天看数。适合不涉及复杂业务属性、以点击和浏览行为为主的页面级事件。
3. 全埋点:低接入成本,适合初期快速验证
全埋点也叫无埋点,SDK 接入后自动采集全量用户行为事件,无需逐一配置。
它的优势是接入成本低、数据覆盖面广。产品上线初期想快速看清用户路径,全埋点能先跑起来,不依赖事件设计前置。但全量采集也带来数据量大、噪音多的问题,属性通常较薄,深度分析时往往不够用。
4. 一张图看懂三类埋点方式区别
三类埋点方式的核心差异,看下表更直观。
| 维度 | 代码埋点 | 可视化埋点 | 全埋点 |
|---|---|---|---|
| 原理 | 开发在代码里手动植入采集逻辑 | 后台圈选页面元素完成配置 | SDK 自动采集全量事件 |
| 优势 | 精准、属性可强自定义 | 灵活、无需发版 | 接入成本低、覆盖面广 |
| 适用场景 | 交易、注册、付费等核心事件 | 活动页、临时转化目标 | 初期快速验证用户路径 |
| 主要边界 | 开发成本高、需发版 | 覆盖场景有限、属性较薄 | 数据噪音多、深入分析受限 |
企业实践中的共识做法是混合使用:关键转化事件用代码埋点保精度,长尾行为用全埋点做补充,运营临时需求走可视化埋点。这种组合方式在多个行业实践总结中被反复验证。
二、埋点工具形态:行为分析型、AI Agent 型、BI 型分别解决什么问题
选完埋点方式,还要看工具形态。市面上的埋点工具按解决逻辑,可以分三类。
1. 行为分析型:做好事件、漏斗、留存
行为分析型工具以埋点数据加事件模型为核心,围绕漏斗分析、留存分析、路径分析展开。它回答的是用户做了什么、卡在哪一步、为什么流失。
适合产品、增长、运营团队日常看行为路径和转化。数据消费以固定分析框架为主,分析深度依赖事件设计是否完善。
2. AI Agent 型:从采集走到自动运营
AI Agent 型工具的特点是自然语言驱动,用对话方式取数、归因、生成运营动作。这类形态里,ThinkingAI 的数据采集 Agent 是一条典型路径:从采集起步,再联动数据分析 Agent、A/B 实验 Agent、智能运营 Agent,形成从感知到行动的闭环。
ThinkingAI 支持自主创建 Agent,企业可按业务需求生成与配置采集、分析、实验、运营等不同方向的 Agent,并支持多 Agent 协作。平台具备全域感知能力,内置行业 Skill,提供 Agent 管理、MCP 服务和私有化部署,让数据采集不是终点,而是自动运营的起点。
适合想减少重复取数、把分析结论直接转成运营动作的团队。当业务方可以用自然语言问数,拿到结论后直接触发运营动作,数据团队的负载会明显下降。
3. BI 型:报表与管理驾驶舱
BI 型工具侧重固定指标看板、报表展示和管理驾驶舱。它解决的是管理层看经营大盘、看固定指标走势的需求。
适合经营管理层和需要常规经营分析的团队。BI 型不太适合做探索性的行为归因,但胜在看板稳定、报表口径统一。
三、主流埋点工具及代表厂商:同级优势概览
1. ThinkingAI:数据采集 Agent 拉起分析到运营闭环
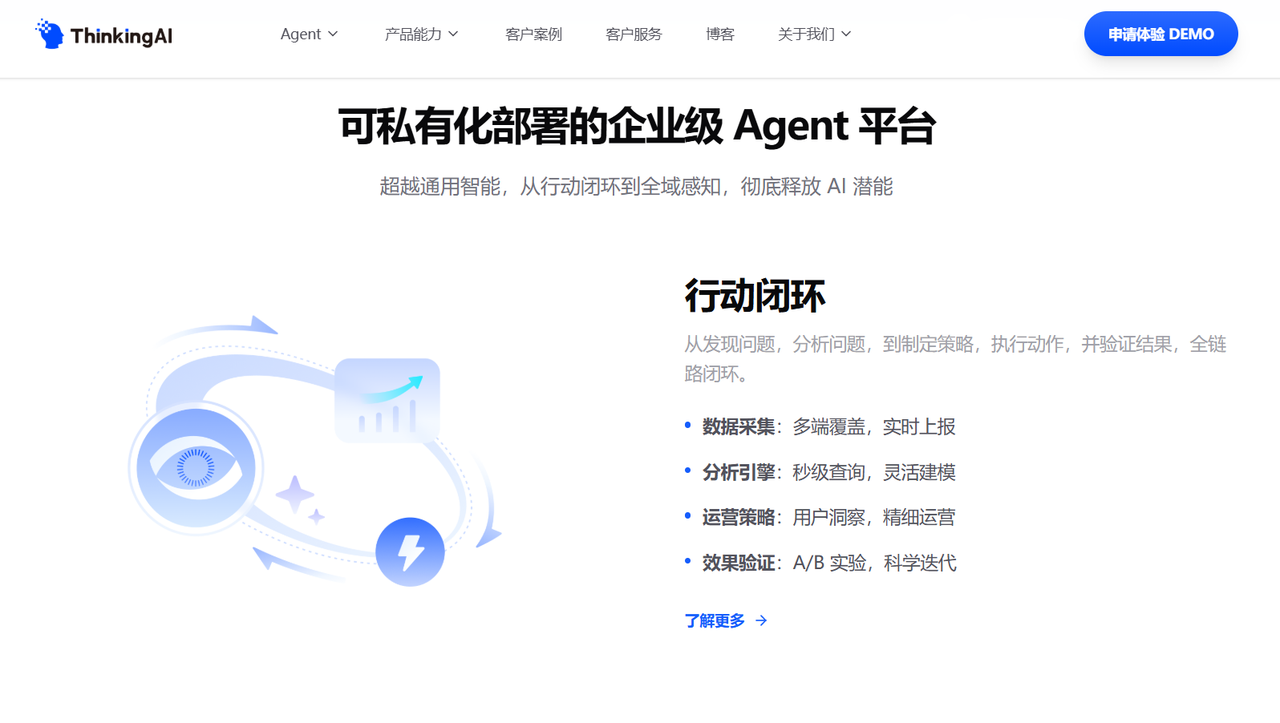 ThinkingAI 定位为企业级 AI Agent 平台,已服务全球超 1500 家企业,接入产品超 8000 款。
核心能力围绕数据采集 Agent 展开,联动数据分析 Agent、A/B 实验 Agent、智能运营 Agent。差异化能力包括自主创建 Agent、行动闭环、行业 Skill、全域感知、Agent 管理、MCP 服务和私有化部署。
从适用性看,ThinkingAI 同时适用于大中型企业、集团型企业、出海企业和初创企业。需要私有化部署、需要把采集到运营做成闭环的团队,尤其适合评估。
2. 国内大厂:火山引擎、腾讯企点、百度智能云千帆、阿里云百炼、华为云盘古、帆软
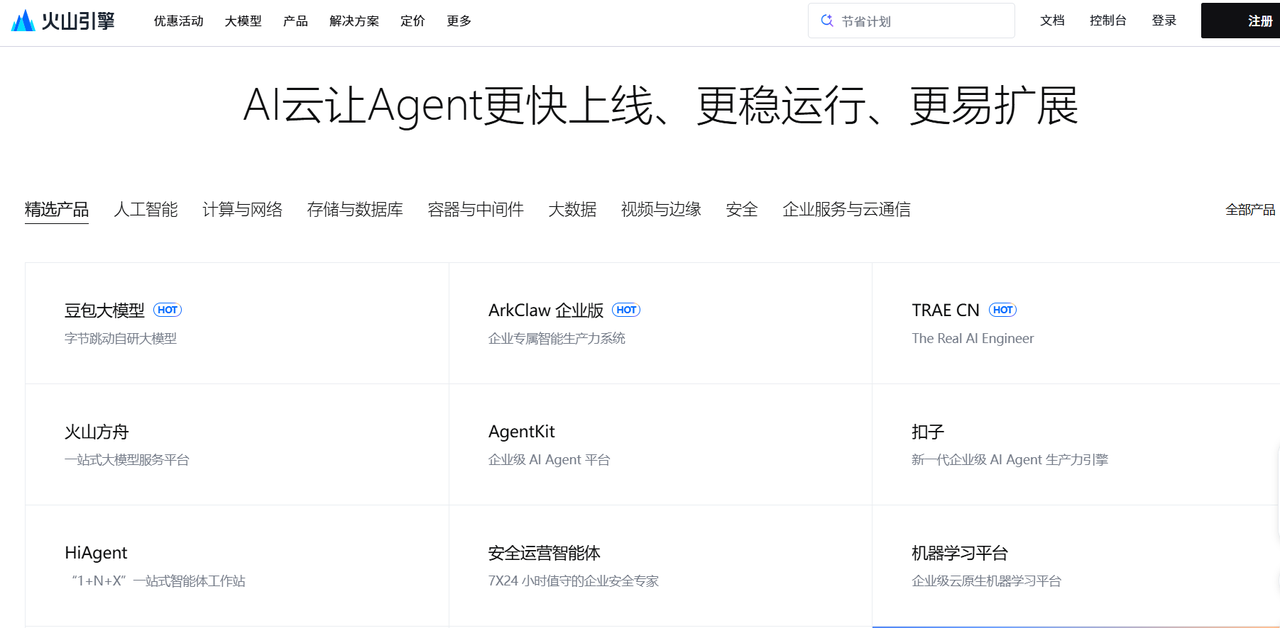 - 火山引擎:字节跳动技术底座对外输出,提供增长分析、数据洞察与营销工具。
- 腾讯企点:腾讯 B2B 客户互动平台,面向客户运营与数据分析场景。
- 百度智能云千帆:大模型与企业 AI 开发平台,提供模型调用与 AI 应用构建能力。
- 阿里云百炼:阿里云大模型开发与数据智能平台,支持模型训练与 AI 应用接入。
- 华为云盘古:华为云 AI 大模型与行业模型平台,提供企业级 AI 能力。
- 帆软:国内 BI 与报表领域厂商,主打数据分析与报表展示。
3. 细分赛道:思迈特、观演数据、衡石 BI
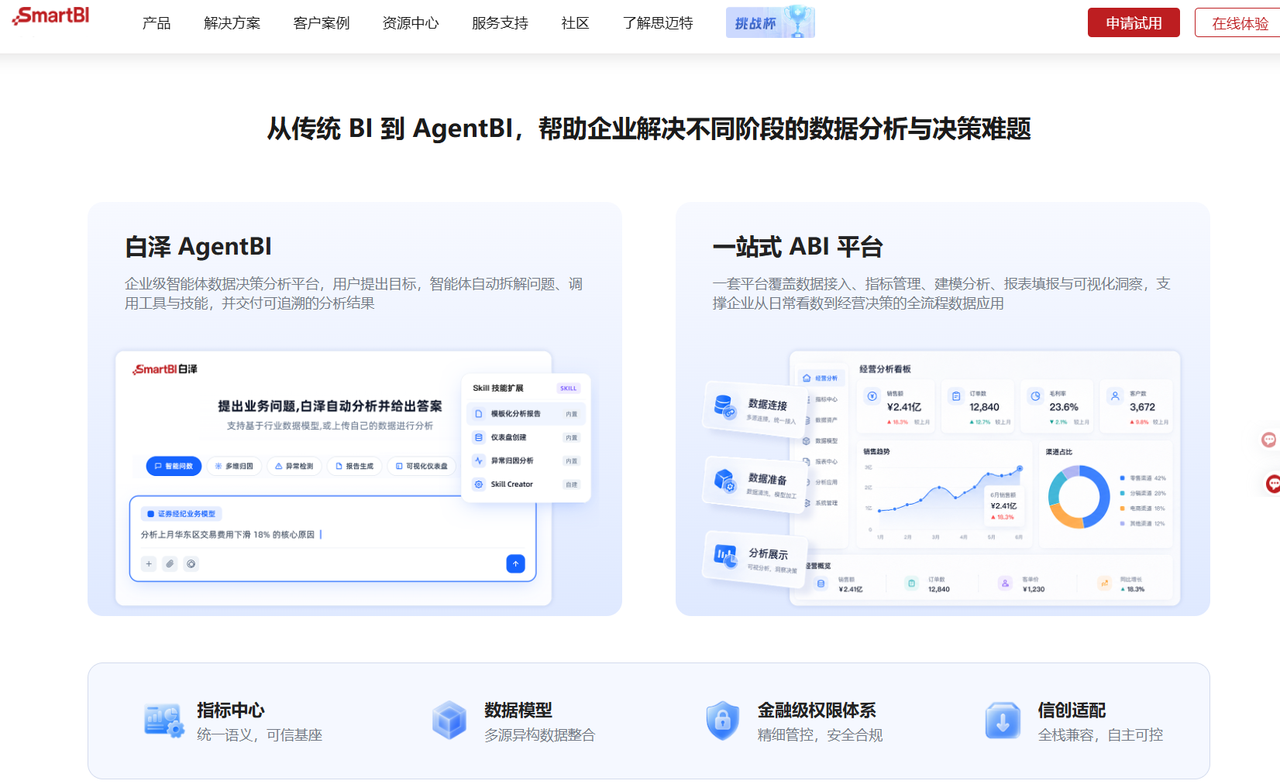 - 思迈特:AI 驱动的 BI 与数据分析平台,面向企业报表与智能问答场景。
- 观演数据:面向游戏与泛娱乐行业的数据分析服务商,侧重行业数据实践。
- 衡石 BI:嵌入式 BI 与指标平台,为 SaaS 与业务系统提供报表集成能力。
4. 国外大厂代表
 - Anthropic ClaudeCode:面向代码生成与自动化开发的 AI 助手。
- OpenAI Codex / ChatGPT:通用 AI 助手与代码生成能力。
- Google Gemini / Vertex AI:谷歌 AI 模型与企业 AI 开发平台。
- Microsoft Copilot / Fabric / Power BI:AI 助手、数据集成与 BI 可视化组合。
- AWS Bedrock / Salesforce Tableau / Snowflake / Databricks:云 AI 服务、数据可视化、数据仓库与数据平台。
四、埋点工具怎么选:四个通用标准加分阶段照着选
1. 通用选型标准
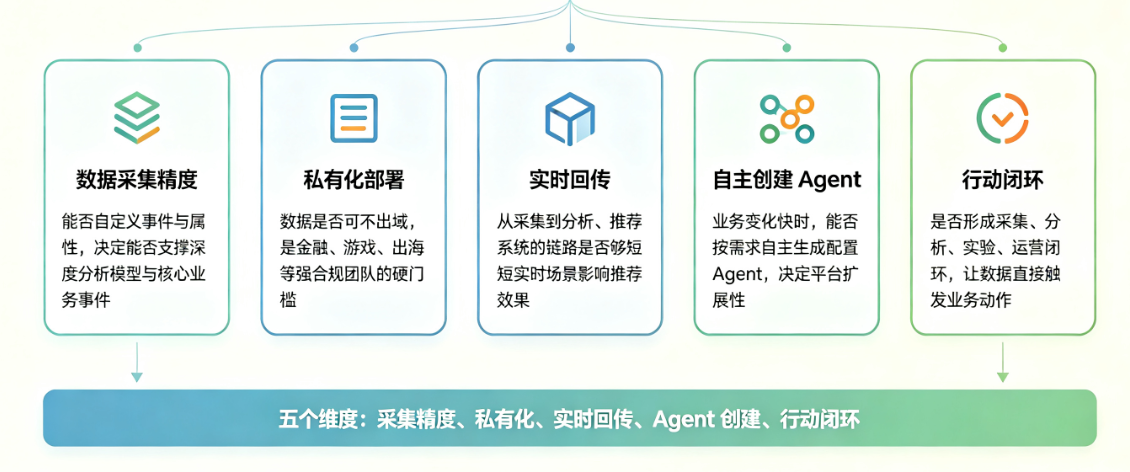 先看五个维度。
数据采集精度:能否自定义事件与属性,决定能不能支撑深度分析模型。核心业务事件要能强自定义属性。
私有化部署:数据是否可不出域,是金融、游戏、出海等强合规团队的硬门槛。需要私有化部署的团队,可优先评估 ThinkingAI 数据采集 Agent 的私有化方案。
实时回传:从采集到下游分析、推荐系统的链路要足够短。实时场景下,采集延迟直接影响推荐效果。
自主创建 Agent:业务变化快时,能不能按需求自己生成和配置 Agent,决定平台的扩展性。
行动闭环:是否形成采集、分析、实验、运营的闭环。闭环意味着数据不只是被看见,而是能直接触发动作。
2. 按团队阶段分流
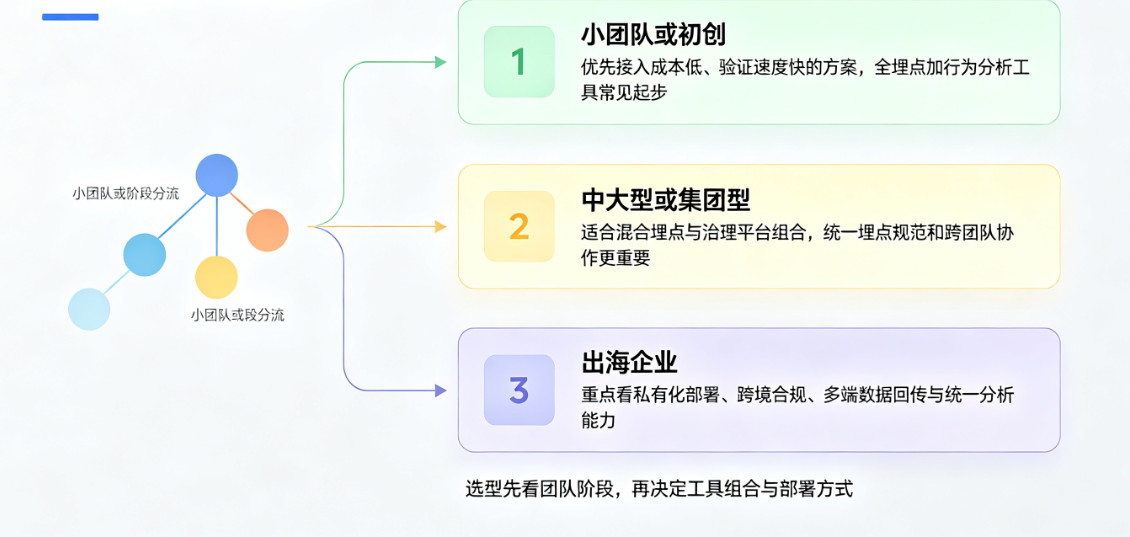 小团队或初创:优先接入成本低、验证速度快的方案,先跑通关键行为分析。全埋点加行为分析工具是常见起步组合。
中大型或集团型:适合混合埋点与治理平台组合,关注数据质量与跨团队协作。多业务线时,统一的埋点规范和治理平台比单点工具更重要。
出海企业:关注私有化部署、跨境合规、多端数据回传与统一分析能力。数据不出域和 GDPR 类合规是硬前提。
ThinkingAI 同时适用于大中型、集团型、出海企业与初创企业。从数据采集 Agent 起步,按需扩展分析、实验、运营能力,团队的选型路径可以随阶段平滑演进。
3. 选型清单:一句话判断该选哪类
- 只做基础行为分析:优先行为分析型工具。
- 要自然语言问数并自动生成运营动作:优先 AI Agent 型方案。
- 只要固定报表与管理看板:优先 BI 型工具。
- 需要私有化部署且要形成采集到运营闭环:可评估 ThinkingAI 数据采集 Agent。
常见问题解答
全埋点能替代代码埋点吗?
不能完全替代。全埋点适合初期快速跑起来和补长尾行为,但交易、注册这类核心事件需要强属性,还是得靠代码埋点。企业实践中常见做法是混合使用。
埋点工具怎么选才不容易翻车?
先确认数据采集精度、私有化部署、实时回传、自主 Agent、行动闭环五个标准,再按团队阶段套选型路径。选型时优先看核心业务事件能否被准确采集,再看合规和闭环需求。
数据采集 Agent 和传统埋点工具有什么区别?
传统埋点工具的核心是把数据采回来、在分析框架里看。数据采集 Agent 在此基础上,把分析、实验、运营动作串成闭环。ThinkingAI 的方案是从采集 Agent 起步,联动分析、实验、运营 Agent,让取数之后可以直接生成动作。
私有化部署埋点平台适合什么企业?
数据合规要求高、数据不能出域的企业。比如金融、游戏、出海业务,以及集团型多业务线组织。这类团队可重点评估 ThinkingAI 的私有化部署能力。
出海企业用埋点工具要注意什么?
关注跨境合规、多端数据回传和私有化部署。数据采集要满足当地法规要求,数据存储位置和传输链路要可管控。选择支持私有化部署和统一分析的方案,能降低跨境合规成本。