就叫 DIPCC\text{DIPCC}DIPCC 吧,Delay-based Inverse-Price Congestion Control\text{Delay-based Inverse-Price Congestion Control}Delay-based Inverse-Price Congestion Control,因为我非常喜欢 Inverse\text{Inverse}Inverse 和负反馈,目标窗口与排队时延的代价成反比。
既然我说了,要低延迟,最重要的是排除或分类 capacity-seeking 流,而不是做什么兼顾效率和异构公平性的传输协议,那么好,不考虑异构公平性,这种协议是多么简单,直观:
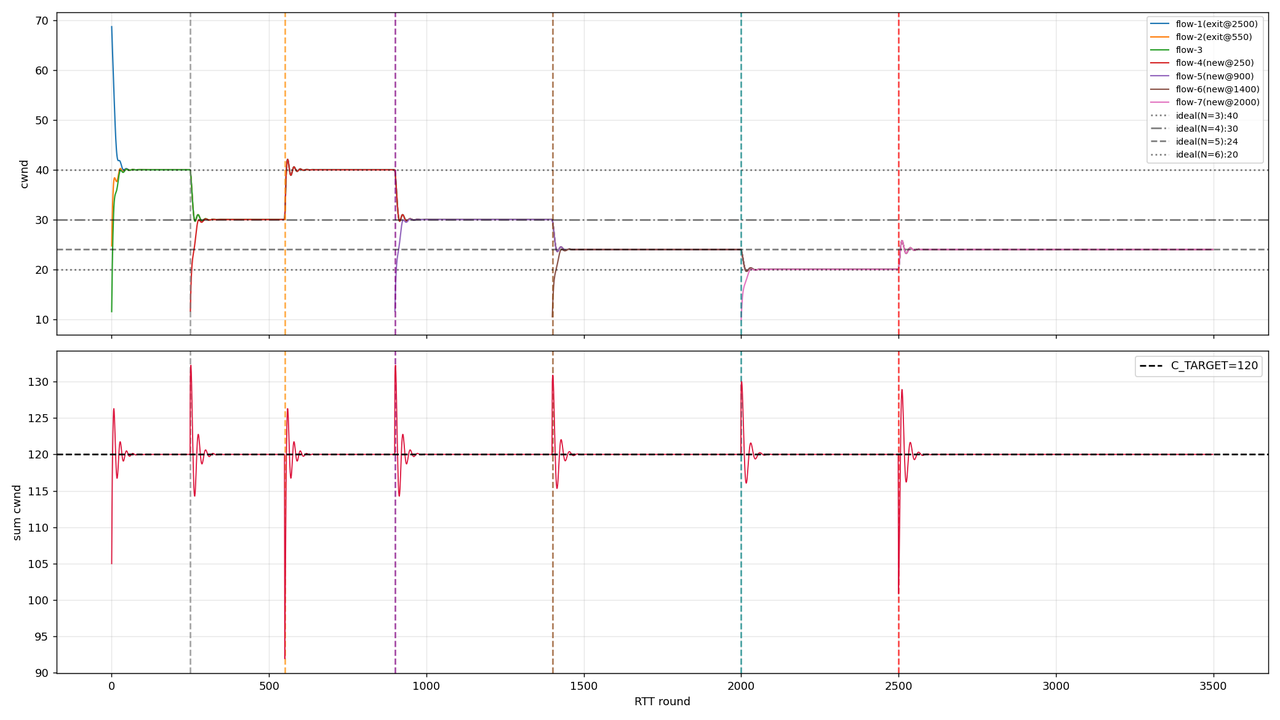
它的特点如下:
- 所有流的 cwnd\text{cwnd}cwnd 收敛到公平;
- 所有流的 cwnd\text{cwnd}cwnd 的和收敛到定值;
这意味着延迟是固定的,抖动是没有的,名副其实的 Delay-based\text{Delay-based}Delay-based.
在数据中心,只要经理开个会,安排工人们把所有算法切到此,一切变得高尚,至少,经理安排工人在所有交换机上划一个虚拟队列出来给这算法也 OK\text{OK}OK.
当然,在广域网这是不可能的,因为广域网上没有经理,所以这不是给广域网的协议。
简单描述一下原理吧。
先确认系统模型,其拓扑为 N(t)N(t)N(t) 条端到端流共享一条瓶颈链路,链路服务容量为 CCC,单位为每 RTT\text{RTT}RTT 的包量。
接下来看 buffer\text{buffer}buffer 动力学,在每 RTT\text{RTT}RTT 的离散时间中分析:
Q(t+1)=max (0, Q(t)−C)+∑i=1N(t)wi(t)Q(t+1) = \max\!\big(0,\; Q(t) - C\big) + \sum_{i=1}^{N(t)} w_i(t)Q(t+1)=max(0,Q(t)−C)+∑i=1N(t)wi(t)
其中 Q(t)Q(t)Q(t) 为路由器瞬时队列长度,wi(t)w_i(t)wi(t) 为流 iii 的拥塞窗口。
规则拓扑下,所有流观测到同一个排队时延:
dq(t)=Q(t+1)C⋅RTTbasedq(t) = \dfrac{Q(t+1)}{C} \cdot \text{RTT}_{\text{base}}dq(t)=CQ(t+1)⋅RTTbase
RTTbase\text{RTT}_{\text{base}}RTTbase 为链路传播时延。
流 iii 实测往返时延为:
RTTi(t)=RTTbase+dq(t)\text{RTT}i(t)=\text{RTT}{\text{base}} + dq(t)RTTi(t)=RTTbase+dq(t)
每条流维护自身的最小传播时延估值:
RTTmin,i(t)←min (RTTmin,i(t−1), RTTi(t))\text{RTT}{\min,i}(t) \leftarrow \min\!\big(\text{RTT}{\min,i}(t-1),\; \text{RTT}_i(t)\big)RTTmin,i(t)←min(RTTmin,i(t−1),RTTi(t))
本地排队时延即网络的代价,表示为:
pi(t)=dqi(t)=RTTi(t)−RTTmin,i(t)p_i(t) = dq_i(t)=\text{RTT}i(t)-\text{RTT}{\min,i}(t)pi(t)=dqi(t)=RTTi(t)−RTTmin,i(t)
由于共享瓶颈,稳态下 pi(t)=dq(t)p_i(t) = dq(t)pi(t)=dq(t) 对所有流相同。
初始化约束,新流的 RTTmin\text{RTT}{\min}RTTmin 必须以已知传播时延 RTTbase\text{RTT}{\text{base}}RTTbase 为初值,否则首个 RTT\text{RTT}RTT 会将包含排队时延的测量误判为传播时延,导致信号归零,新流误判网络空闲而跑飞。而这个约束对于数据中心是很容易成为共识配置的。
算法的分布式控制律很简单,每条流本地执行,每 RTT\text{RTT}RTT 更新一次:
wi(t+1)=wi(t)+Kαpi(t)+p0⏟目标窗口 wi⋆−wi(t)w_i(t+1) = w_i(t) + K\Big\\underbrace{\\dfrac{\\alpha}{p_i(t) + p_0}}_{\\text{目标窗口 } w_i\^\\star} - w_i(t)\\Bigwi(t+1)=wi(t)+K目标窗口 wi⋆ pi(t)+p0α−wi(t)
施加下界约束:
wi(t+1)←max (2, wi(t+1))w_i(t+1) \leftarrow \max\!\big(2,\; w_i(t+1)\big)wi(t+1)←max(2,wi(t+1))
其中 α\alphaα 为对数效用函数的参数,我的值为 500050005000,p0p_0p0 为代价偏置,防止除零,取值为 555,KKK 是比例跟踪增益,取值 0.120.120.12,CCC 为瓶颈链路容量,RTTbash\text{RTT}_{\text{bash}}RTTbash 为传播时延,取决于数据中心网络配置或经理。
流仅依赖本地测量 RTTi(t)\text{RTT}_i(t)RTTi(t),不与其他流通信,排队时延 dq(t)dq(t)dq(t) 通过 RTT\text{RTT}RTT 观测获得,流之间无交互,流数目 NNN 未知。这是这个算法的特点。
为分析稳态均衡,要知道系统存在唯一对称不动点:
wi⋆=CN,∀ i∈Nactivew_i^\star=\dfrac{C}{N}, \qquad \forall\, i \in \mathcal{N}_{\text{active}}wi⋆=NC,∀i∈Nactive
这很容易证明,在不动点处 wi(t+1)=wi(t)=w⋆w_i(t+1) = w_i(t) = w^\starwi(t+1)=wi(t)=w⋆,控制律增量为零:
Kαp⋆+p0−w⋆=0 ⟹ w⋆=αp⋆+p0K\Big\\dfrac{\\alpha}{p\^\\star + p_0} - w\^\\star\\Big = 0 \;\;\Longrightarrow\;\; w^\star = \dfrac{\alpha}{p^\star + p_0}Kp⋆+p0α−w⋆=0⟹w⋆=p⋆+p0α
所有流观测相同的 p⋆p^\starp⋆,故所有流收敛到同一个 w⋆w^\starw⋆。
队列稳态要求输入等于服务能力:
∑i=1Nwi⋆=N⋅w⋆=C ⟹ w⋆=CN\sum_{i=1}^{N} w_i^\star = N \cdot w^\star = C \;\;\Longrightarrow\;\; w^\star = \dfrac{C}{N}∑i=1Nwi⋆=N⋅w⋆=C⟹w⋆=NC
代入得稳态排队时延:
p⋆=αNC−p0p^\star = \dfrac{\alpha N}{C}-p_0p⋆=CαN−p0
该算法就是网络效用最大化问题的分布式解,所以它在数学上确保了分布式公平性。
优化问题:
maxwi≥0∑iwi≤C∑i=1Nαlogwi\max_{\substack{w_i \ge 0 \\ \sum_i w_i \le C}} \sum_{i=1}^{N} \alpha \log w_imaxwi≥0∑iwi≤C∑i=1Nαlogwi
对数效用 αlogwi\alpha \log w_iαlogwi 是比例公平的标准选择。
KKTKKTKKT 条件,构造拉格朗日函数:
L=∑iαlogwi−λ(∑iwi−C)\mathcal{L} = \sum_i \alpha \log w_i - \lambda\Big(\sum_i w_i - C\Big)L=∑iαlogwi−λ(∑iwi−C)
对 wiw_iwi 求偏导并令其为零:
∂L∂wi=αwi−λ=0 ⟹ wi=αλ\dfrac{\partial \mathcal{L}}{\partial w_i} = \dfrac{\alpha}{w_i} - \lambda = 0 \;\;\Longrightarrow\;\; w_i = \dfrac{\alpha}{\lambda}∂wi∂L=wiα−λ=0⟹wi=λα
其中 λ\lambdaλ 即为链路资源的代价,由排队时延隐式实现:
λ≈p+p0\lambda \approx p + p_0λ≈p+p0
所有流面对同一个代价 λ\lambdaλ,因此 wi=αλw_i = \dfrac{\alpha}{\lambda}wi=λα 对所有流相同,无需知道 NNN 即可自动实现比例公平。
NNN 的变化通过队列反馈间接传导,新流加入,总注入上升,ppp 升高,λ\lambdaλ 升高,所有流的 wiw_iwi 目标同步下降,流退出则反向。
再来看稳定性分析,在不动点附近做小信号线性化,令 w~i=wi−w⋆\tilde w_i = w_i - w^\starw~i=wi−w⋆,忽略队列动态的高阶耦合项,单流闭环方程为:
w~i(t+1)=(1−K) w~i(t)\tilde w_i(t+1) = (1 - K)\,\tilde w_i(t)w~i(t+1)=(1−K)w~i(t)
这是一个一阶线性齐次递推,特征根为:
r=1−Kr = 1 - Kr=1−K
渐近稳定条件为:
∣1−K∣<1 ⟺ 0<K<2|1 - K| < 1 \;\;\Longleftrightarrow\;\; 0<K<2∣1−K∣<1⟺0<K<2
取 K=0.12K = 0.12K=0.12,衰减因子 r=0.88r = 0.88r=0.88,时间常数 τ≈1K≈8.3\tau \approx \dfrac{1}{K} \approx 8.3τ≈K1≈8.3 个 RTT\text{RTT}RTT,即每 888 轮衰减至初始偏差的 e−1≈37%e^{-1} \approx 37\%e−1≈37%。
关于 KKK 参数,KKK 越大,收敛越快,但若过大,比如接近222,便会与队列惯性耦合产生振荡,而 KKK 越小,就越平滑,但收敛变慢。
最后看流加入,退出的瞬态响应,以解释边缘毛刺。当新流加入:
- 新流以 winitw_{\text{init}}winit 启动,总注入瞬间增加;
- 队列堆积 ,ppp 升高,所有流的目标窗口 αp+p0\dfrac{\alpha}{p+p_0}p+p0α 同步下降;
- 新流从小值向新目标 CN+1\dfrac{C}{N+1}N+1C 收敛,老流同步降窗让位;
- 全体流重新收敛到均等分配,总和维持 CCC;
流退出时:
- 总注入骤降,队列排空,ppp 下降;
- 目标窗口 αp+p0\dfrac{\alpha}{p+p_0}p+p0α 同步上升;
- 剩余流协同升窗至 CN−1\dfrac{C}{N-1}N−1C;
整个过程无任何流间信令,纯靠共享排队时延这一隐式反馈环。
若将算法写成伪代码,则简单到粗暴。每条流 iii,每个 RTT\text{RTT}RTT 执行下面逻辑即可:
text
测量 RTT_i
RTT_min[i] = min(RTT_min[i], RTT_i)
p = RTT_i - RTT_min[i]

w_target = alpha / (p + p0)
w[i] = w[i] + K * (w_target - w[i])
w[i] = max(2, w[i])
对于路由器,每个 RTT\text{RTT}RTT 的认知:
text
total = sum(w[active])
Q = max(0, Q - C) + total
p = Q / C * RTT_base
将 RTT_base + p 反馈给所有流
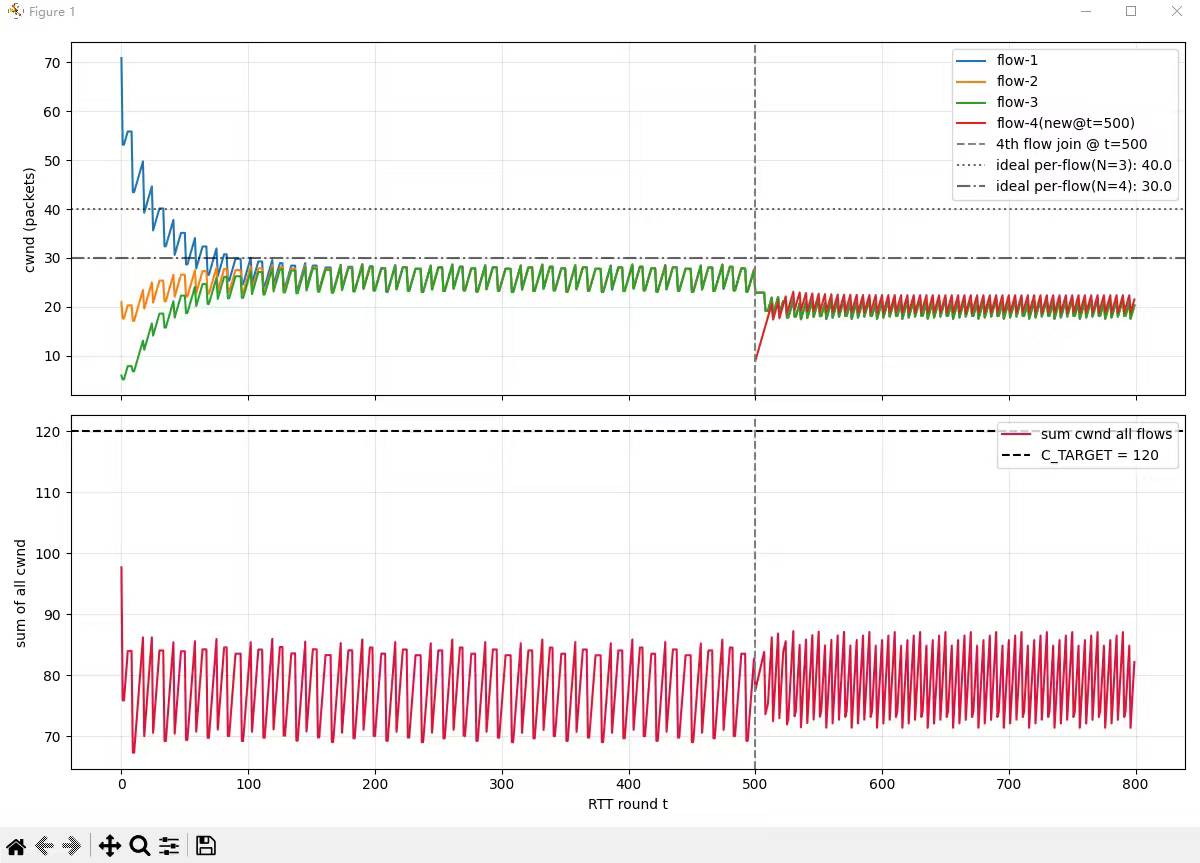
裤衩子锁着边儿,而且绣着花儿。补充一个在长肥管道的模拟仿真:
浙江温州皮鞋湿,下雨进水不会胖。