4×V100 32GB 本地大模型部署实战:为什么选 llama.cpp、从 Q8_0 到 IQ4_XS 的量化演进、任务阻塞破解与单端口多模型路由
摘要 :本文基于一台 4×Tesla V100-SXM2-32GB 服务器的真实部署过程,系统讲清楚四件事:
① 本地部署方式横向对比与 llama.cpp 选型理由 ;
② GGUF 量化权重怎么选,以及从官方 Q8_0 换到 IQ4_XS 魔改版 的实测演进;
③ 大模型任务阻塞的真实根因 与多实例隔离方案;
④ 如何用 OpenResty + Lua 把多个实例收敛成一个
/v1/chat/completions地址 ,靠model字段自动路由。所有数字均来自真实环境实测,脚本可直接使用。
文章目录
- [4×V100 32GB 本地大模型部署实战:为什么选 llama.cpp、从 Q8_0 到 IQ4_XS 的量化演进、任务阻塞破解与单端口多模型路由](#4×V100 32GB 本地大模型部署实战:为什么选 llama.cpp、从 Q8_0 到 IQ4_XS 的量化演进、任务阻塞破解与单端口多模型路由)
-
- 〇、先说结论:这套方案长什么样
- 一、环境说明
-
- [⚠️ V100 的两个"硬约束",决定了后面所有选型](#⚠️ V100 的两个"硬约束",决定了后面所有选型)
- [二、本地部署有哪些方式?为什么最终选 llama.cpp](#二、本地部署有哪些方式?为什么最终选 llama.cpp)
-
- [2.1 三条主流路线](#2.1 三条主流路线)
- [2.2 llama.cpp vs vLLM:这次为什么不选 vLLM](#2.2 llama.cpp vs vLLM:这次为什么不选 vLLM)
- [2.3 选型结论:并发 16 是分界线](#2.3 选型结论:并发 16 是分界线)
- [三、模型选型:量化权重是什么,以及从 Q8_0 到 IQ4_XS 的实测演进](#三、模型选型:量化权重是什么,以及从 Q8_0 到 IQ4_XS 的实测演进)
-
- [3.1 GGUF 量化档位速查](#3.1 GGUF 量化档位速查)
- [3.2 显存预算的正确算法(最容易踩的坑)](#3.2 显存预算的正确算法(最容易踩的坑))
- [3.3 实测:为什么"体积表"和 nvidia-smi 对不上](#3.3 实测:为什么"体积表"和 nvidia-smi 对不上)
- [3.4 我的演进路线:官方 Q8_0 → TURBO-Fable IQ4_XS](#3.4 我的演进路线:官方 Q8_0 → TURBO-Fable IQ4_XS)
- [3.5 最终分工与关键参数](#3.5 最终分工与关键参数)
- 四、任务为什么会阻塞?根因与破解
-
- [4.1 现象](#4.1 现象)
- [4.2 根因:不是"性能差",是"槽位满则排队"](#4.2 根因:不是"性能差",是"槽位满则排队")
- [4.3 破解:多实例物理隔离,而不是在一个实例里挤并发](#4.3 破解:多实例物理隔离,而不是在一个实例里挤并发)
- [五、对外只暴露一个端口:按 `model` 字段路由多后端](#五、对外只暴露一个端口:按
model字段路由多后端) -
- [5.1 为什么厂商能做到"一个地址调所有模型"](#5.1 为什么厂商能做到"一个地址调所有模型")
- [5.2 三种方案对比](#5.2 三种方案对比)
- [5.3 安装 OpenResty(Ubuntu)](#5.3 安装 OpenResty(Ubuntu))
-
- [⚠️ 关键坑:80 端口冲突](#⚠️ 关键坑:80 端口冲突)
- [5.4 完整路由配置(可直接复用)](#5.4 完整路由配置(可直接复用))
- [5.5 测试与验证](#5.5 测试与验证)
- [5.6 进阶:路由表化 + 动态扩缩容](#5.6 进阶:路由表化 + 动态扩缩容)
- 六、实测:大海捞针(Needle-in-a-Haystack)验证长上下文召回
-
- [6.1 为什么必须做这个测试](#6.1 为什么必须做这个测试)
- [6.2 测试思路](#6.2 测试思路)
- [6.1 测试思路](#6.1 测试思路)
- [6.2 脚本做的三个关键升级](#6.2 脚本做的三个关键升级)
- [6.3 完整测试脚本](#6.3 完整测试脚本)
- [6.4 实测结果](#6.4 实测结果)
- [6.5 服务端日志里挖出来的四个关键结论](#6.5 服务端日志里挖出来的四个关键结论)
-
- [① 长上下文是"预填充瓶颈",不是"生成瓶颈"](#① 长上下文是"预填充瓶颈",不是"生成瓶颈")
- [② prefill 吞吐随上下文增长明显衰减](#② prefill 吞吐随上下文增长明显衰减)
- [③ decode 速度几乎不随上下文长度衰减 ⭐](#③ decode 速度几乎不随上下文长度衰减 ⭐)
- [④ MTP 推测解码:接受率 100%,但这个数字要打折看](#④ MTP 推测解码:接受率 100%,但这个数字要打折看)
- [6.6 唯一翻车的一次:2500 段 `WinError 10054`](#6.6 唯一翻车的一次:2500 段
WinError 10054) - [6.7 这次实测推翻了我之前的一个判断 ⚠️](#6.7 这次实测推翻了我之前的一个判断 ⚠️)
- [6.8 顺带验证到的几件事](#6.8 顺带验证到的几件事)
- [七、踩坑清单(按### 坑 1:`-c 131072` 白设了,还白占显存 ⭐⭐⭐⭐⭐](### 坑 1:
-c 131072白设了,还白占显存 ⭐⭐⭐⭐⭐) -
- [坑 2:用 `-c` 指定配置文件报 `"upstream" directive is not allowed here` ⭐⭐⭐⭐⭐](#坑 2:用
-c指定配置文件报"upstream" directive is not allowed here⭐⭐⭐⭐⭐) - [坑 3:shell 里 `true` 写成 `ture`,开关静默失效 ⭐⭐⭐⭐](#坑 3:shell 里
true写成ture,开关静默失效 ⭐⭐⭐⭐) - [坑 4:`--tensor-split layer` 导致三卡负载不均 ⭐⭐⭐⭐](#坑 4:
--tensor-split layer导致三卡负载不均 ⭐⭐⭐⭐) - [坑 5:80 端口冲突(见 §5.3)⭐⭐⭐](#坑 5:80 端口冲突(见 §5.3)⭐⭐⭐)
- [坑 6:流式输出被缓冲 ⭐⭐⭐](#坑 6:流式输出被缓冲 ⭐⭐⭐)
- [坑 2:用 `-c` 指定配置文件报 `"upstream" directive is not allowed here` ⭐⭐⭐⭐⭐](#坑 2:用
- 八、附录:可直接复用的启停脚本
-
- [A. 14B 单卡启停](#A. 14B 单卡启停)
- [B. 27B 三卡(IQ4_XS + MTP)关键参数](#B. 27B 三卡(IQ4_XS + MTP)关键参数)
- [C. 常用运维命令](#C. 常用运维命令)
- 九、总结
- 参考资料
〇、先说结论:这套方案长什么样
                          ┌─────────────────────────────────┐
   客户端 / OpenAI SDK ──▶ │  OpenResty 网关 (单端口 60443)   │
   base_url = https://...  │  读 body 里的 model 字段做路由    │
                          └───────────────┬─────────────────┘
                                          │
                 ┌────────────────────────┴────────────────────────┐
                 │                                                 │
      model = "Qwen3.8-27B-Turbo"                       model = "Qwen3-14B"
                 ▼                                                 ▼
      ┌──────────────────────────┐                    ┌──────────────────────────┐
      │ llama-server  :60080     │                    │ llama-server  :60081     │
      │ Qwen3.8-27B-TURBO-Fable  │                    │ Qwen3-14B-Q8_0           │
      │ IQ4_XS + MTP 推测解码     │                    │ 单卡,parallel=4          │
      │ GPU 4 / 5 / 7 (3 卡)     │                    │ GPU 6 (1 卡)             │
      │ 21.2 / 21.0 / 25.4 GB    │                    │ 26.3 GB                  │
      └──────────────────────────┘                    └──────────────────────────┘
对外只有一个地址、一个 Key、一套 OpenAI 协议,客户端完全感知不到后端是几个实例、跑在哪张卡上。
一、环境说明
| 项目 | 规格 |
|---|---|
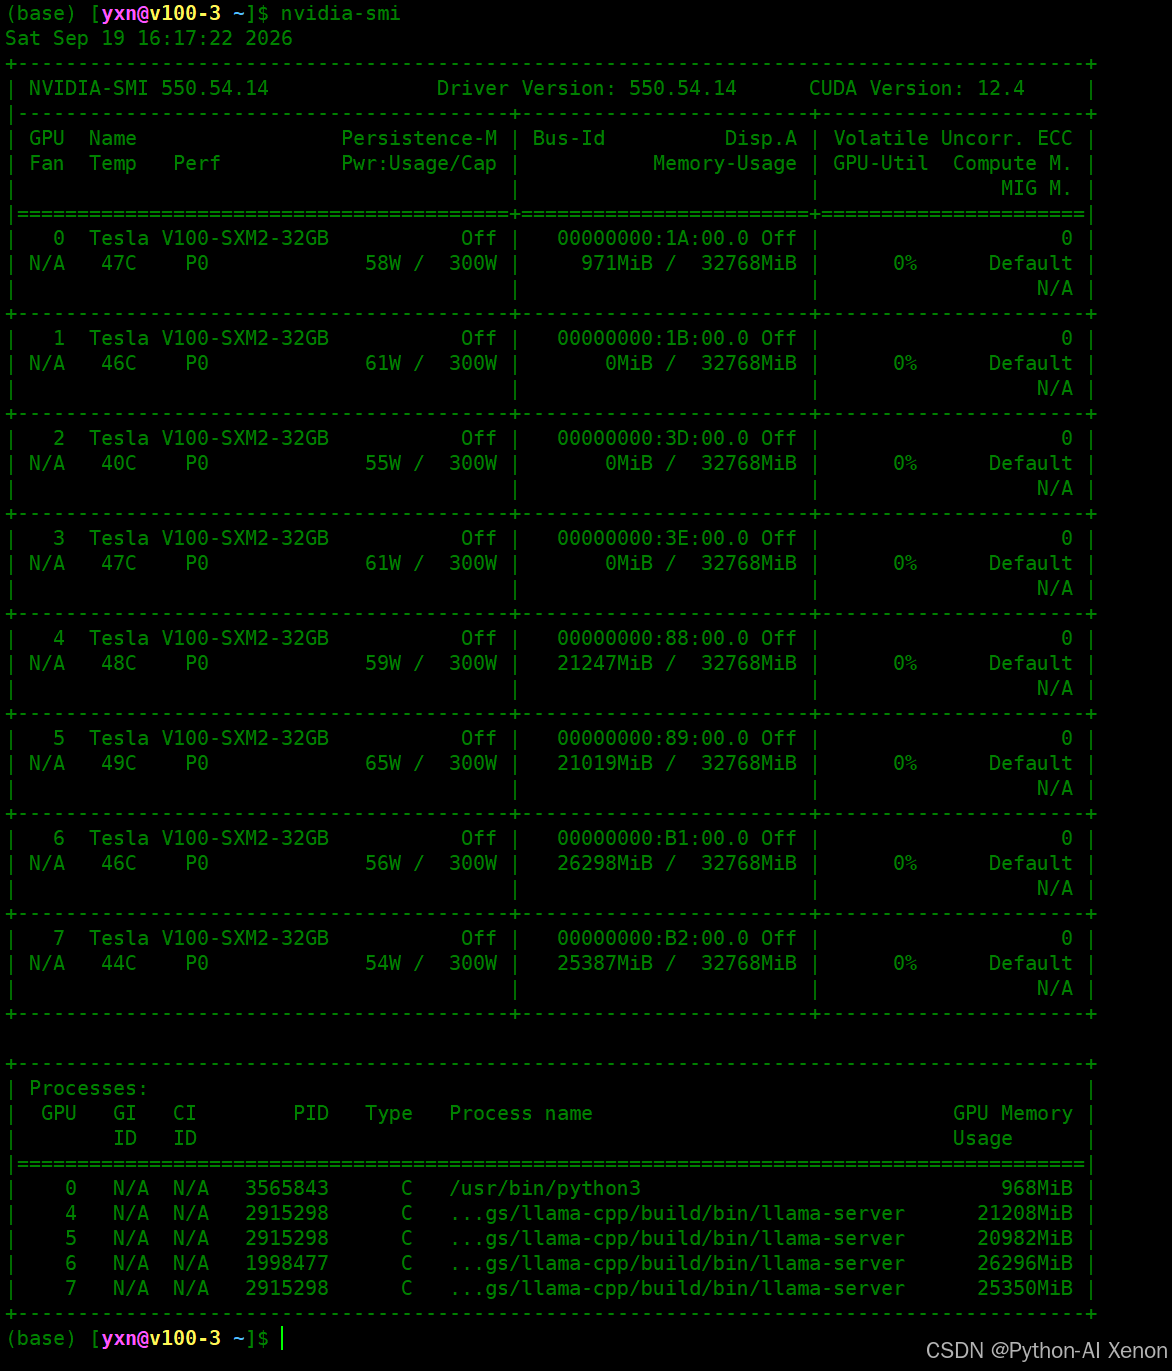
| GPU | 4× Tesla V100-SXM2-32GB(Volta,Compute Capability 7.0) |
| Driver / CUDA | 550.54.14 / 12.4 |
| OS | Ubuntu 20.04.6 LTS(5.4.0-216-generic) |
| 推理引擎 | llama.cpp(自编译,llama-server) |
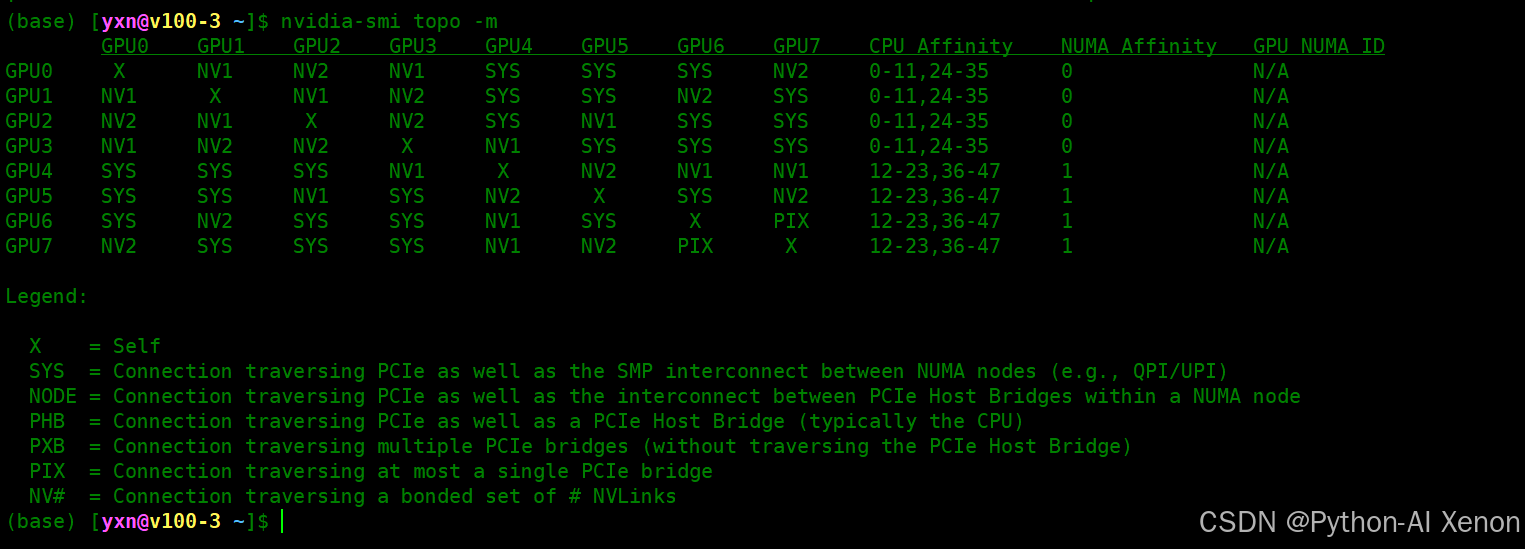
| 后端实例 | GPU 4/5/7 → Qwen3.8-27B(IQ4_XS);GPU 6 → Qwen3-14B(Q8_0) |
| 网关 | OpenResty(nginx + LuaJIT),监听 60443 |
⚠️ V100 的两个"硬约束",决定了后面所有选型
- Volta 不支持 bf16 。原生 HuggingFace 的 bf16 权重在 V100 上要么跑不动、要么被迫转 FP16 后显存翻倍。而 GGUF 量化格式天生就是为这种"老卡/显存紧张"场景设计的,两者是最佳拍档。
- 32GB 是天花板。没有 NVLink 之外的大显存池,意味着"权重 + KV Cache + 计算 buffer"必须在 32GB 内精打细算------这是全篇所有参数调优的隐含前提。
📌 一句话:V100 32GB 上做本地部署,不是"选最好的框架",而是"选能在 32GB 里塞下最多东西的框架"。
二、本地部署有哪些方式?为什么最终选 llama.cpp
2.1 三条主流路线
| 路线 | 代表 | 核心机制 | 上手难度 | 适用场景 |
|---|---|---|---|---|
| 框架级推理引擎 | vLLM、SGLang、TensorRT-LLM | PagedAttention / 连续批处理 | 中高 | 高并发生产 API |
| 量化运行时 | llama.cpp、Ollama(底层 llama.cpp) | GGUF 量化 + C++ 运行时 | 低 | 本地/小团队/单卡多模型 |
| 原生加载 | transformers + accelerate | PyTorch 原生 | 中 | 研究、微调、快速验证 |
2.2 llama.cpp vs vLLM:这次为什么不选 vLLM
vLLM 毫无疑问是"高并发生产服务"的标杆,但在 V100 32GB + 本地多实例 + 并发个位数 的场景下,它的优势发挥不出来,劣势却被放大。
(1)显存:llama.cpp 靠"两把斧"省出一大截
vLLM 的 PagedAttention 会把 KV Cache 切成固定 Block 按需分配、碎片极少,但代价是启动即预留一个 Block Pool。单用户/低并发场景下,这块预留就是纯"死显存",V100 上尤其肉疼。
llama.cpp 这边是两把斧叠加:
- 权重量化:GGUF 从 1.5bit 到 8bit 全档位可选,直接把权重压到 FP16 的 28%~50%;
- KV Cache 量化 :
--cache-type-k q8_0 --cache-type-v q8_0,把 KV Cache 再砍掉约 50%,精度损失极小。
💡 核心洞察 :正是"权重量化 + KV 量化"这两把斧,让 llama.cpp 能在单张 32GB 卡里同时塞下 14B 权重 + 长上下文 + 多个并发槽位。同样一张卡跑 vLLM,往往 FP16 权重刚塞进去,上下文和并发就被挤没了。
(2)CPU/GPU 混合推理:llama.cpp 的独占能力
通过 -ngl N 控制卸载到 GPU 的层数,剩下的层自动落到 CPU 内存。这意味着 70B 模型靠 Q4 + 部分卸载,能在 16GB 内存的机器上跑起来;vLLM 做不到------模型放不进显存就是启动失败,没有"退一半到内存"这个选项。
(3)启动速度与运维复杂度
| 维度 | llama.cpp | vLLM |
|---|---|---|
| 启动速度 | 1~3 秒(二进制几 MB) | 4~90 秒 + Python 运行时常驻 1~2GB |
| 硬件支持 | CPU / ARM / 老 GPU 全覆盖 | 主要 NVIDIA / AMD,对 CUDA 版本有要求 |
| 量化生态 | GGUF 全档位,CPU 上也能量化 | AWQ/GPTQ/FP8,依赖 GPU |
| 并发吞吐 | 低并发(≤16)时单请求延迟更低 | 高并发(>16)连续批处理碾压 |
| 部署复杂度 | 编译 + 一条命令 | Docker / K8s / 模型格式转换 |
2.3 选型结论:并发 16 是分界线
你的并发量级?
├─ < 16(本地开发、小团队、Agent 调用)→ llama.cpp
│     单请求延迟更低、显存更省、能开长上下文、能 CPU 混跑
└─ > 16(生产级对外 API)           → vLLM
      连续批处理吞吐优势 2~4×,值得为它付出显存和部署成本
📌 对本机场景的结论 :4×V100 32GB、日常开发对话、并发个位数、还要"一卡一个模型做物理隔离"------llama.cpp + GGUF 是唯一务实选择。vLLM 的 PagedAttention 在这里反而是"预留显存的负担"。
三、模型选型:量化权重是什么,以及从 Q8_0 到 IQ4_XS 的实测演进
3.1 GGUF 量化档位速查
量化 = 把权重从 FP16(2 字节/权重)压到更少 bit。llama.cpp 用 GGUF + K-Quant 方案:
| 档位 | 位宽 | 相对 FP16 体积 | 质量保留 | 适用 |
|---|---|---|---|---|
| Q8_0 | 8bit | ~50% | ~99.9% | 显存宽裕、追求无损 |
| Q6_K | 6bit | ~40% | ~99.5% | 性价比甜点档 |
| Q5_K_M | 5bit | ~35% | ~99% | 代码 / 指令任务 |
| Q4_K_M | 4bit | ~28% | ~98% | 社区默认档 |
| IQ4_XS | 4bit(iMatrix) | ~25% | ≈ Q4_K_M 但更小 | + iMatrix 重要性矩阵,低比特下的最优解 |
| Q2_K / Q3_K | 2~3bit | ~18% | 损失明显 | 仅显存极度紧张 |
Q4_K_M 的原理:采用"超级块"结构------每 256 个权重共享一个缩放因子,每 32 个共享一个偏移量,所以同为 4bit,精度显著高于朴素的 Q4_0。
IQ4_XS 更进一步:在量化时对"重要张量"(attention 输出、关键 FFN)用 iMatrix 重要性矩阵保留更高精度,做到"该省的地方狠省,该留的地方留足"。
💡 社区经验法则:"更大模型 + 更低量化" 通常优于 "更小模型 + 更高量化" (13B Q4 在多数任务上胜过 8B Q8)。这也是我敢把 27B 压到 IQ4_XS 的底气。
3.2 显存预算的正确算法(最容易踩的坑)
新手最常见的错误:"模型 6GB、显卡 8GB,肯定能跑" ------ 完全忽略了 KV Cache。
真实显存占用 = 权重 + KV Cache + 计算 buffer / CUDA context
               ↑        ↑          ↑
            由量化档位决定   随上下文线性增长   通常 0.5~2GB
KV Cache 的粗略估算(以 14B 为例):FP16 下约 160KB/token,q8_0 量化后约 80KB/token。
| 上下文 | Q8_0 KV Cache(单槽) |
|---|---|
| 8K | ≈ 0.65 GB |
| 32K | ≈ 2.6 GB |
| 128K | ≈ 10 GB |
⚠️ 血的教训 :KV 量化优先于权重量化 。先动 --cache-type-k/v q8_0,收益更直接、精度损失更小。而且长上下文(4K 以上)务必用 q8_0 而不是 q4_0,否则注意力分布会偏移,表现为"长文档后半段开始胡说"。
3.3 实测:为什么"体积表"和 nvidia-smi 对不上
这是我调试时最困惑的一点,值得单独讲:
| 实例 | 权重(体积表) | nvidia-smi 实测 | 差了多少 |
|---|---|---|---|
| Qwen3-14B Q8_0(单卡 GPU 6) | ~15.7 GB | 26.3 GB | +10.6 GB |
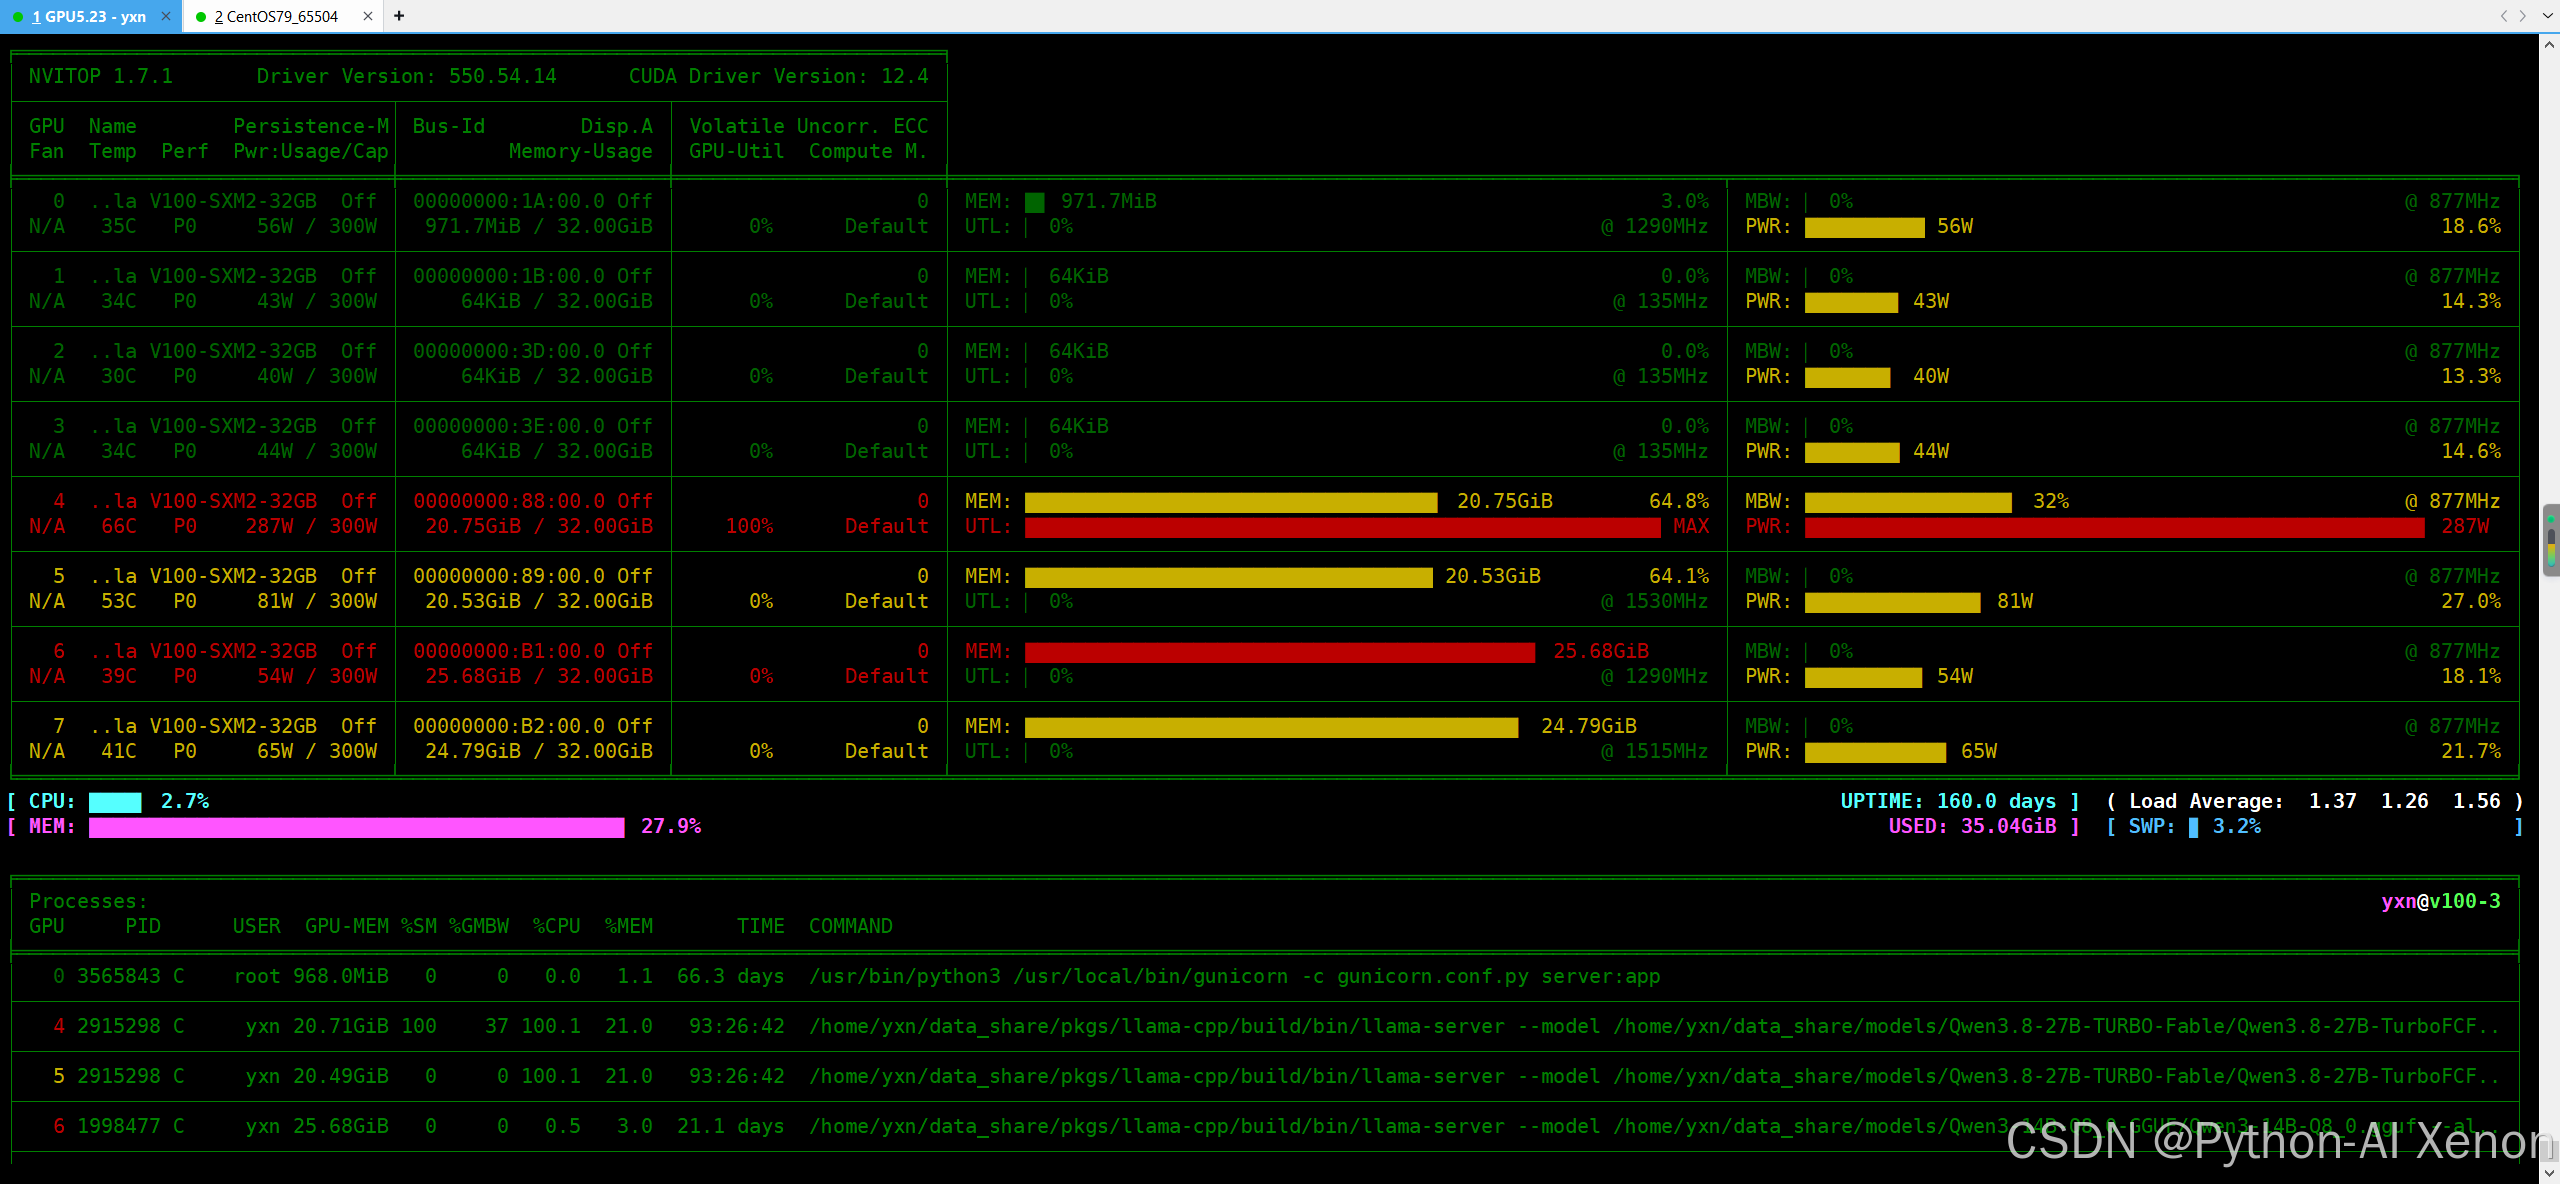
| Qwen3.8-27B IQ4_XS(3 卡) | ~15 GB,每卡 ~5 GB | 21.2 / 21.0 / 25.4 GB | 远超纯权重 |
差额来自哪里?
--kv-unified会一次性把 KV 池开出来 。我给 14B 设了-c 131072,即使后面被 cap,池子也按配置预分配------这部分就是那 ~10GB 的大头。- CUDA context + 计算 buffer:batch-size 1024 / ubatch 512 下,几百 MB 到 1~2GB。
- 3 卡并非均分 :27B 三卡实测 21.2 / 21.0 / 25.4 GB,最后一张卡明显更重(详见 §6 踩坑清单里的
--tensor-split问题)。
📌 方法论:不要信体积表,要信 nvidia-smi。 每次改 -c / --parallel / --batch-size,都要重新看一次实测显存。
3.4 我的演进路线:官方 Q8_0 → TURBO-Fable IQ4_XS
第一阶段:Qwen3.8-27B 官方 Q8_0
    ↓  跑通了,但 3 卡显存吃紧、思考块冗长、出字慢
第二阶段:Qwen3.8-27B-TURBO-Fable IQ4_XS + MTP
    ↓  显存宽裕了、思考 token 砍半、MTP 推测解码再提速
现状:稳定跑在 GPU 4/5/7
为什么换? 三个真实收益:
- 显存:IQ4_XS 比 Q8_0 小接近一半,3 卡从"勉强塞下"变成"留足 KV Cache 和并发余量"。
- 思考瘦身:TURBO 系的微调目标是砍掉格式推演与无效发散,官方实测思考块中位数压到原版的 1/3 ~ 1/10。对我这种"要的是结果不是内心戏"的场景,体感提升巨大。
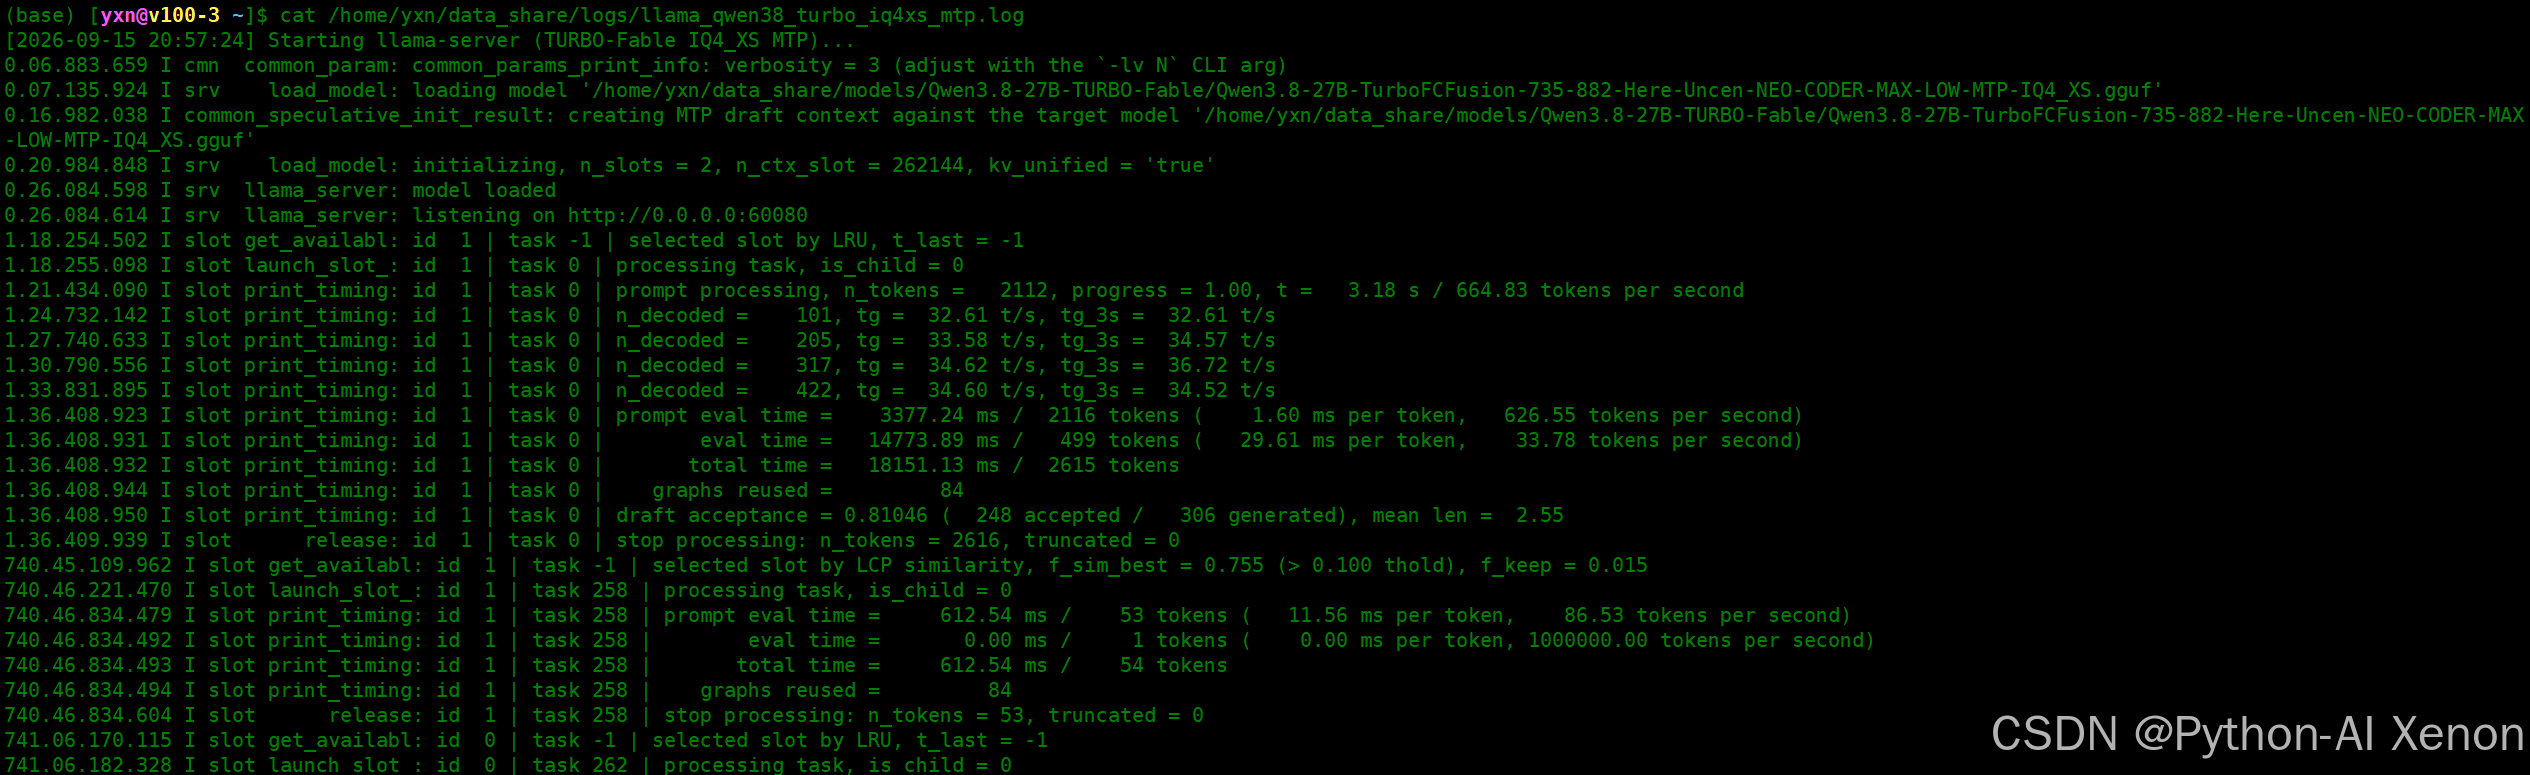
- MTP 推测解码 :这个 GGUF 单文件内嵌了 MTP 头 ,不需要额外 draft 模型,
--spec-type draft-mtp直接开。
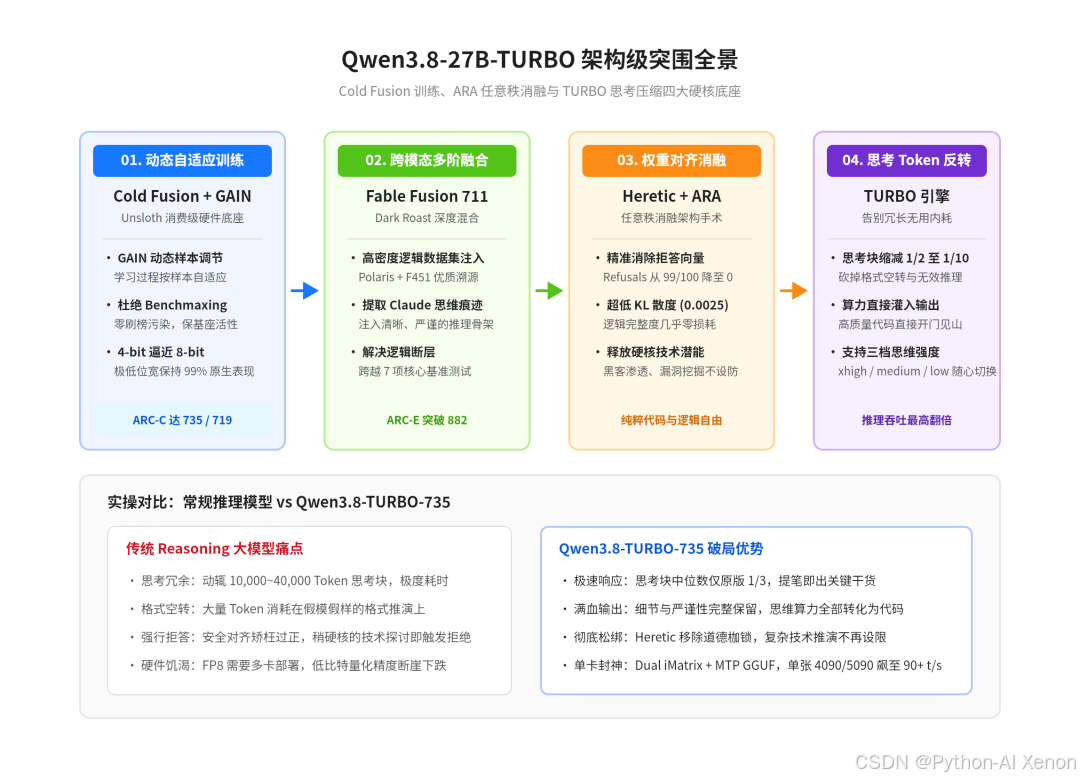
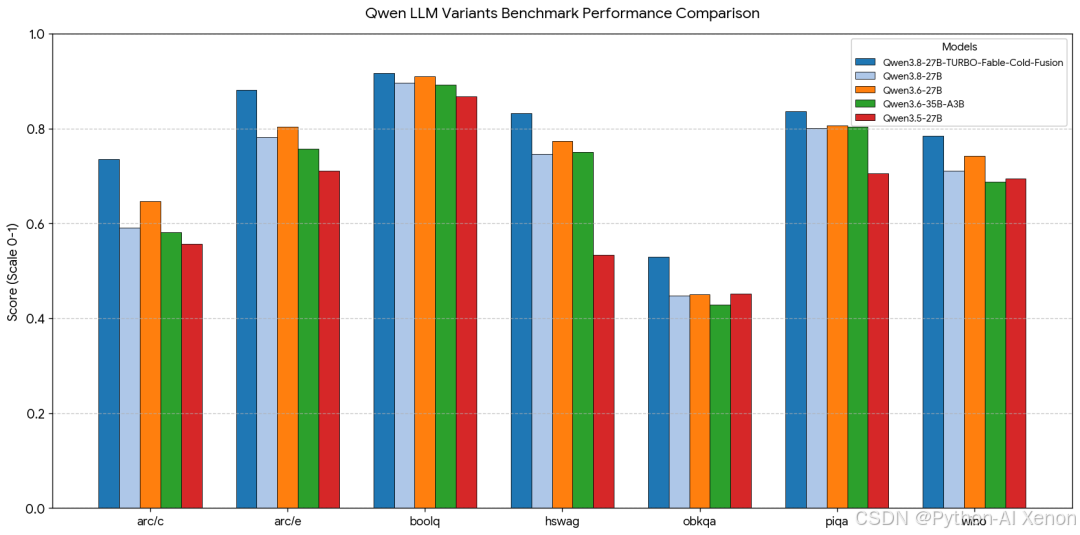
实测基准(官方披露,8-bit 下):
| 基准 | Qwen3.8-TURBO | Qwen3.8 原版 | 提升 |
|---|---|---|---|
| ARC-C(科学推理) | 0.735 | 0.591 | +144 |
| ARC-E(常识推理) | 0.882 | 0.782 | +100 |
| HellaSwag | 0.832 | 0.746 | +86 |
| OpenBookQA | 0.530 | 0.448 | +82 |
| WinoGrande | 0.785 | 0.711 | +74 |
⚠️ 必须提醒的副作用 :魔改模型容易偏科、版本迭代快、稳定性不如原版。生产环境我只建议官方版本或 Unsloth 量化版;魔改版用来压榨本地硬件、做技术探索非常香,但别直接扛核心业务。
3.5 最终分工与关键参数
| 用途 | 显卡 | 模型 | 量化 | 实测显存 | 端口 |
|---|---|---|---|---|---|
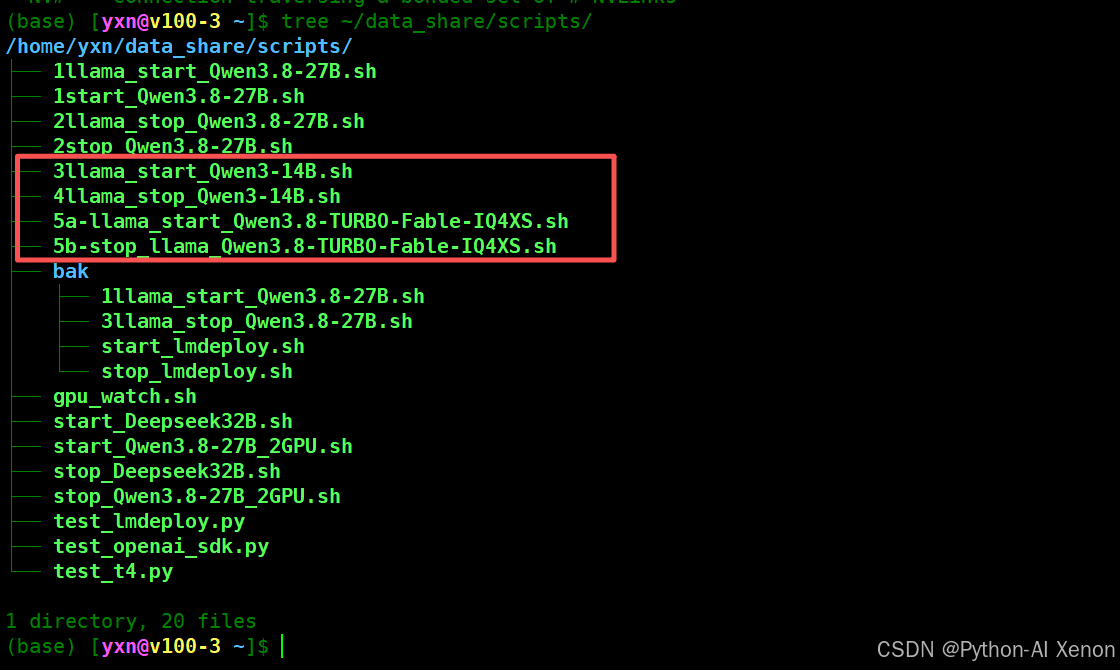
| 主力长文 / 重推理 | GPU 4,5,7 | Qwen3.8-27B-TURBO-Fable | IQ4_XS + MTP | 21.2/21.0/25.4 GB | 60080 |
| 快速响应 / Agent | GPU 6 | Qwen3-14B | Q8_0 | 26.3 GB | 60081 |
部署到 V100 32GB 必调的参数清单:
| 参数 | 作用 | 本场景建议 |
|---|---|---|
-ngl |
GPU 卸载层数 | 99(单卡全卸载)/ 200(多卡全卸载) |
-c |
上下文窗口 | ⚠️ 别盲目设大,见踩坑清单 |
--parallel |
并发槽位数 | 4~8,解决阻塞的核心 |
--kv-unified |
KV Cache 统一池 | 开,槽位动态共享 |
--cache-type-k/v |
KV 量化 | q8_0 |
--flash-attn |
长上下文加速 | on |
--spec-type draft-mtp |
MTP 推测解码 | 内嵌 MTP 头的 GGUF 才可用 |
-t |
CPU 线程 | 12~24 |
💡 性价比本质 :V100 32GB 跑 14B,Q6_K 是甜点档(质量接近 Q8_0,省 3GB 给 KV Cache)。我选 Q8_0 是因为这张卡只跑它一个模型、显存还有余量,属于"不差这点显存就上最好的"。
四、任务为什么会阻塞?根因与破解
4.1 现象
27B 单实例部署时,一个小请求会被一个长请求活活堵死。比如我正在跑一个长文档摘要,此时 Agent 的一个工具调用请求发出去,就一直转圈不返回。
4.2 根因:不是"性能差",是"槽位满则排队"
llama.cpp 的 --parallel N 是有限个并发槽位 。所有槽位被长请求占满后,新请求不是被拒绝,而是排队等待。
回看我最初的配置:
bash
PARALLEL=2          # ← 根因:只有 2 个槽位
CTX_SIZE=524288     # ← 上下文开得很大,槽位预算更紧张
2 个槽位 + 长上下文 = 一旦占满,后续所有请求(哪怕只是一句"你好")都必须排队。
📌 关键认知:这是排队,不是算力不足。堆显卡解决不了,得从架构上隔离。
4.3 破解:多实例物理隔离,而不是在一个实例里挤并发
GPU 4  ┐
GPU 5  ├─ Qwen3.8-27B IQ4_XS  :60080   ← 重任务专用
GPU 7  ┘
GPU 6  ── Qwen3-14B Q8_0      :60081   ← 轻量 / Agent 专用
核心思路 :与其在一个大模型实例里调并发参数,不如多卡各跑一个独立实例,让长任务和短任务在物理层面互不可见。
14B 实例的关键配置(阻塞改善最直接的一段):
bash
export CUDA_VISIBLE_DEVICES=6
./llama-server \
  --model ~/data_share/models/Qwen3-14B-Q8_0-GGUF/Qwen3-14B-Q8_0.gguf \
  --alias "Qwen3-14B" \
  -ngl 99 \
  -c 131072 \
  --batch-size 1024 --ubatch-size 512 \
  --parallel 4 \          # ★ 从 2 提到 4,短请求不再被长请求饿死
  --kv-unified \          # ★ 统一 KV 池,槽位动态共享
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --flash-attn on \
  --jinja \
  --host 0.0.0.0 --port 60081 \
--api-key "sk-xxxxxxxx"对比效果:
| 指标 | 单实例(parallel=2) | 多实例隔离(27B + 14B,parallel=4) |
|---|---|---|
| 最大并发 | 2 | 明显提升,且长短分离 |
| 短请求延迟 | 被长请求阻塞,数十秒起 | 落到空闲实例,秒级返回 |
| 长请求影响面 | 阻塞全部后续 | 只占自己那一个实例 |
📌 本质 :llama.cpp 的排队是"槽位满则等"。多实例 + 路由从物理层面隔离了任务,这才是根本解法------自然也就引出了下一章的问题:实例多了,端口也多了,怎么对外收敛成一个?
五、对外只暴露一个端口:按 model 字段路由多后端
5.1 为什么厂商能做到"一个地址调所有模型"
这不是模型自己的能力,而是前置网关做的:
客户端 → 统一网关 → 解析 model 字段 → 查路由表 → 转发到对应后端 → 翻译响应各类 API 中转网关的本质都是同一套:校验 key → 提取 model → 转格式 → 注入真实 key → 转发。
💡 关键认知:model 字段是路由键(Routing Key),不是模型自己"知道"该调谁。
5.2 三种方案对比
| 方案 | 原理 | 优点 | 缺点 | 推荐度 |
|---|---|---|---|---|
| 路径分流 | /v1-14b/... vs /v1/... |
最简单最稳 | URL 不统一,客户端要感知 | ⭐⭐⭐ 内部用 |
| llama.cpp Router Mode | 原生多模型、一个端口 | 官方支持、进程隔离 | 模型换入换出有 5~10s 延迟,需显存常驻 | ⭐⭐⭐⭐ 单卡多模型 |
| OpenResty + Lua | 读 body 里 model 字段路由 |
真单地址、完全兼容 OpenAI、灵活可扩展 | 需维护一段 Lua | ⭐⭐⭐⭐⭐ |
为什么最终选 OpenResty + Lua?
因为我们已经是"物理隔离多实例"------模型全部常驻显存、零切换延迟,只缺一层"读 model 字段 → 转发"的网关。OpenResty(nginx + LuaJIT)天然胜任,且完全兼容 OpenAI 协议,客户端零改造。
5.3 安装 OpenResty(Ubuntu)
bash
wget -qO - https://openresty.org/package/pubkey.gpg | sudo apt-key add -
echo "deb http://openresty.org/package/ubuntu $(lsb_release -sc) main" \
  | sudo tee /etc/apt/sources.list.d/openresty.list
sudo apt update && sudo apt install openresty
⚠️ 关键坑:80 端口冲突
OpenResty 默认监听 80,如果系统里已经有 nginx,启动会失败。
bash
ps -ef | grep 'nginx: master'          # 先确认有几个 master
sudo ss -tlnp | grep -E ':80|:60443'   # 看 80 到底被谁占着
🔴 共享服务器必读 :先确认 80 端口是不是你的、有没有别人在用,绝不盲目停别人的服务。 我排查后确认 80 只是默认欢迎页(无人使用),才执行:
bash
sudo systemctl stop nginx && sudo systemctl disable nginx如果 80 是别人的,就让 OpenResty 只监听 60443(配置里去掉 listen 80),或用指定配置启动:
bash
sudo /usr/local/openresty/nginx/sbin/nginx -c /your/conf.conf5.4 完整路由配置(可直接复用)
nginx
# ~/data_share/nginx/conf/api_gateway.conf
# OpenResty + Lua:按 model 字段路由到不同后端

upstream backend_27b { server 127.0.0.1:60080; }
upstream backend_14b { server 127.0.0.1:60081; }

server {
    listen 60443 ssl;
    server_name _;

    ssl_certificate     ~/data_share/nginx/ssl/fullchain.pem;
    ssl_certificate_key ~/data_share/nginx/ssl/privkey.pem;
    ssl_protocols TLSv1.2 TLSv1.3;

    set $valid_api_key "sk-xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx";

    # ★ 让小请求体留在内存里,Lua 才能直接读到
    client_body_buffer_size 10m;
    client_max_body_size 100m;

    location = /health {
        return 200 "OK\n";
    }

    location = /v1/models {
        default_type application/json;
        return 200 '{"object":"list","data":[
            {"id":"Qwen3.8-27B","object":"model","owned_by":"user"},
            {"id":"Qwen3-14B","object":"model","owned_by":"user"}]}';
    }

    # ===== 核心:统一的聊天补全入口 =====
    location /v1/chat/completions {
        if ($http_authorization != "Bearer $valid_api_key") {
            return 401 '{"error":"Unauthorized"}';
        }

        access_by_lua_block {
            ngx.req.read_body()
            local body = ngx.req.get_body_data()

            -- body 太大被写入临时文件时,从文件读回来
            if not body then
                local fp = ngx.req.get_body_file()
                if fp then
                    local f = io.open(fp, "rb")
                    if f then body = f:read("*all"); f:close() end
                end
            end

            if body then
                local cjson = require("cjson.safe")
                local ok, data = pcall(cjson.decode, body)
                if ok and type(data) == "table" and data.model then
                    if data.model == "Qwen3-14B" then
                        ngx.exec("@backend_14b")   -- 路由到 14B
                        return
                    end
                end
            end
            ngx.exec("@backend_27b")               -- 默认走 27B
        }

        proxy_pass http://backend_27b;  # 占位,Lua 已跳转,不会执行
    }

    location @backend_27b {
        internal;
        proxy_pass http://backend_27b;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_set_header Authorization "Bearer $valid_api_key";
        proxy_read_timeout 1800s;
        proxy_buffering off;          # ★ 流式输出必须关缓冲
    }

    location @backend_14b {
        internal;
        proxy_pass http://backend_14b;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_set_header Authorization "Bearer $valid_api_key";
        proxy_read_timeout 600s;
        proxy_buffering off;
    }

    location /v1/ {   # embeddings 等其他端点默认给 27B
        proxy_pass http://backend_27b;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_set_header Authorization "Bearer $valid_api_key";
        proxy_buffering off;
    }

    location / { return 404; }
}三个必须注意的点:
access_by_lua_block在访问控制阶段读 body →cjson解析 → 取model→ngx.exec()内部跳转到命名 location。@backend_xxx必须标internal,否则外部可直接访问,鉴权被绕过。proxy_buffering off------ 不关的话流式输出(SSE)会被缓冲成一次性返回,客户端看着像"卡住了突然出一大段"。
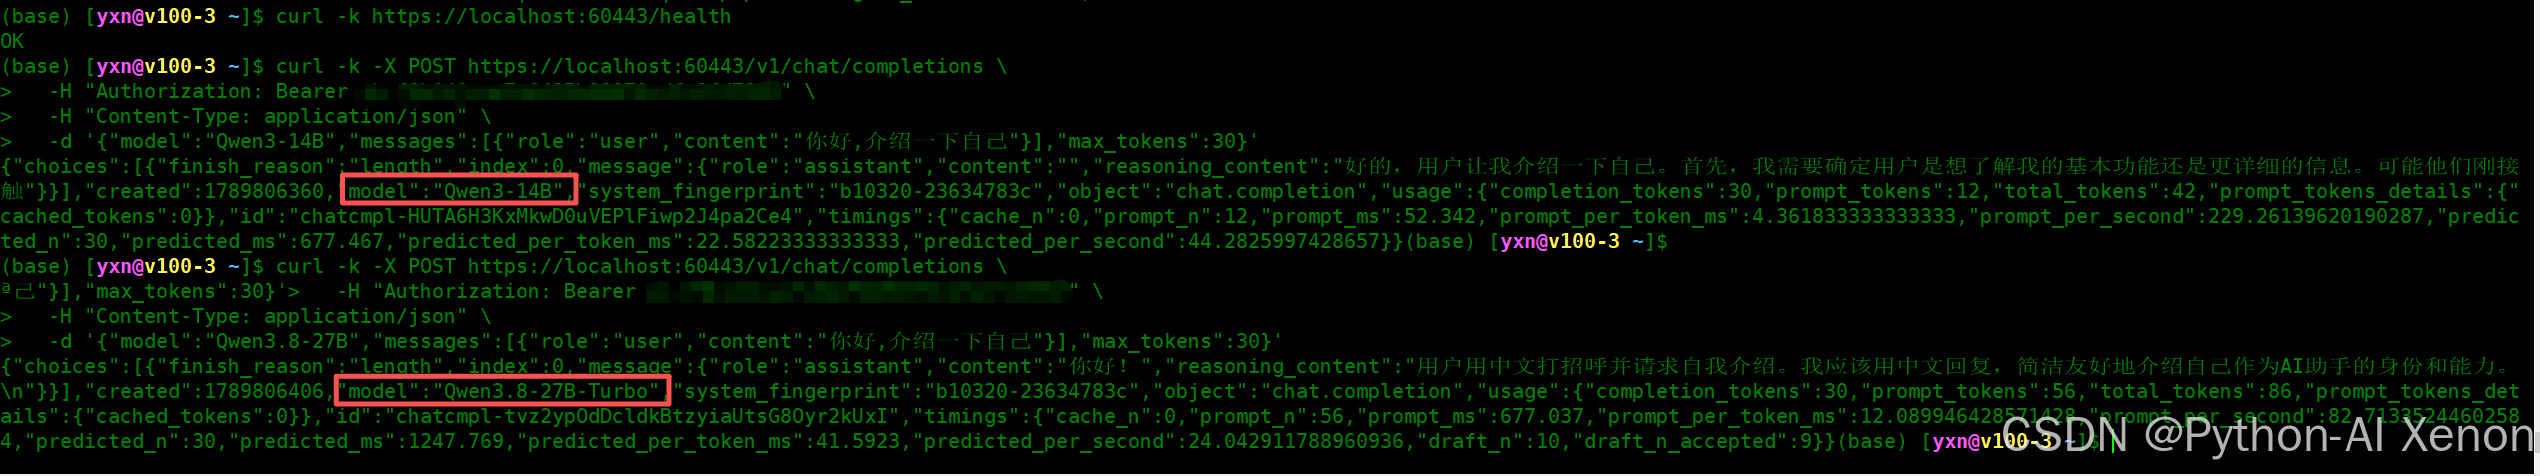
5.5 测试与验证
bash
# 1. 语法检查(必须先做)
sudo /usr/local/openresty/nginx/sbin/nginx -t

# 2. 启动
sudo /usr/local/openresty/nginx/sbin/nginx

# 3. 健康检查
curl -k https://localhost:60443/health
# → OK

# 4. ★ 同一个 URL,靠 model 字段分流到不同后端
curl -k -X POST https://localhost:60443/v1/chat/completions \
  -H "Authorization: Bearer sk-xxxxxxxx" \
  -H "Content-Type: application/json" \
  -d '{"model":"Qwen3-14B","messages":[{"role":"user","content":"你好"}],"max_tokens":30}'
# → 返回 model: "Qwen3-14B"(实际打到 60081)

curl -k -X POST https://localhost:60443/v1/chat/completions \
  -H "Authorization: Bearer sk-xxxxxxxx" \
  -H "Content-Type: application/json" \
  -d '{"model":"Qwen3.8-27B","messages":[{"role":"user","content":"你好"}],"max_tokens":30}'
# → 返回 model: "Qwen3.8-27B"(实际打到 60080)
两次 curl 的返回结果对比
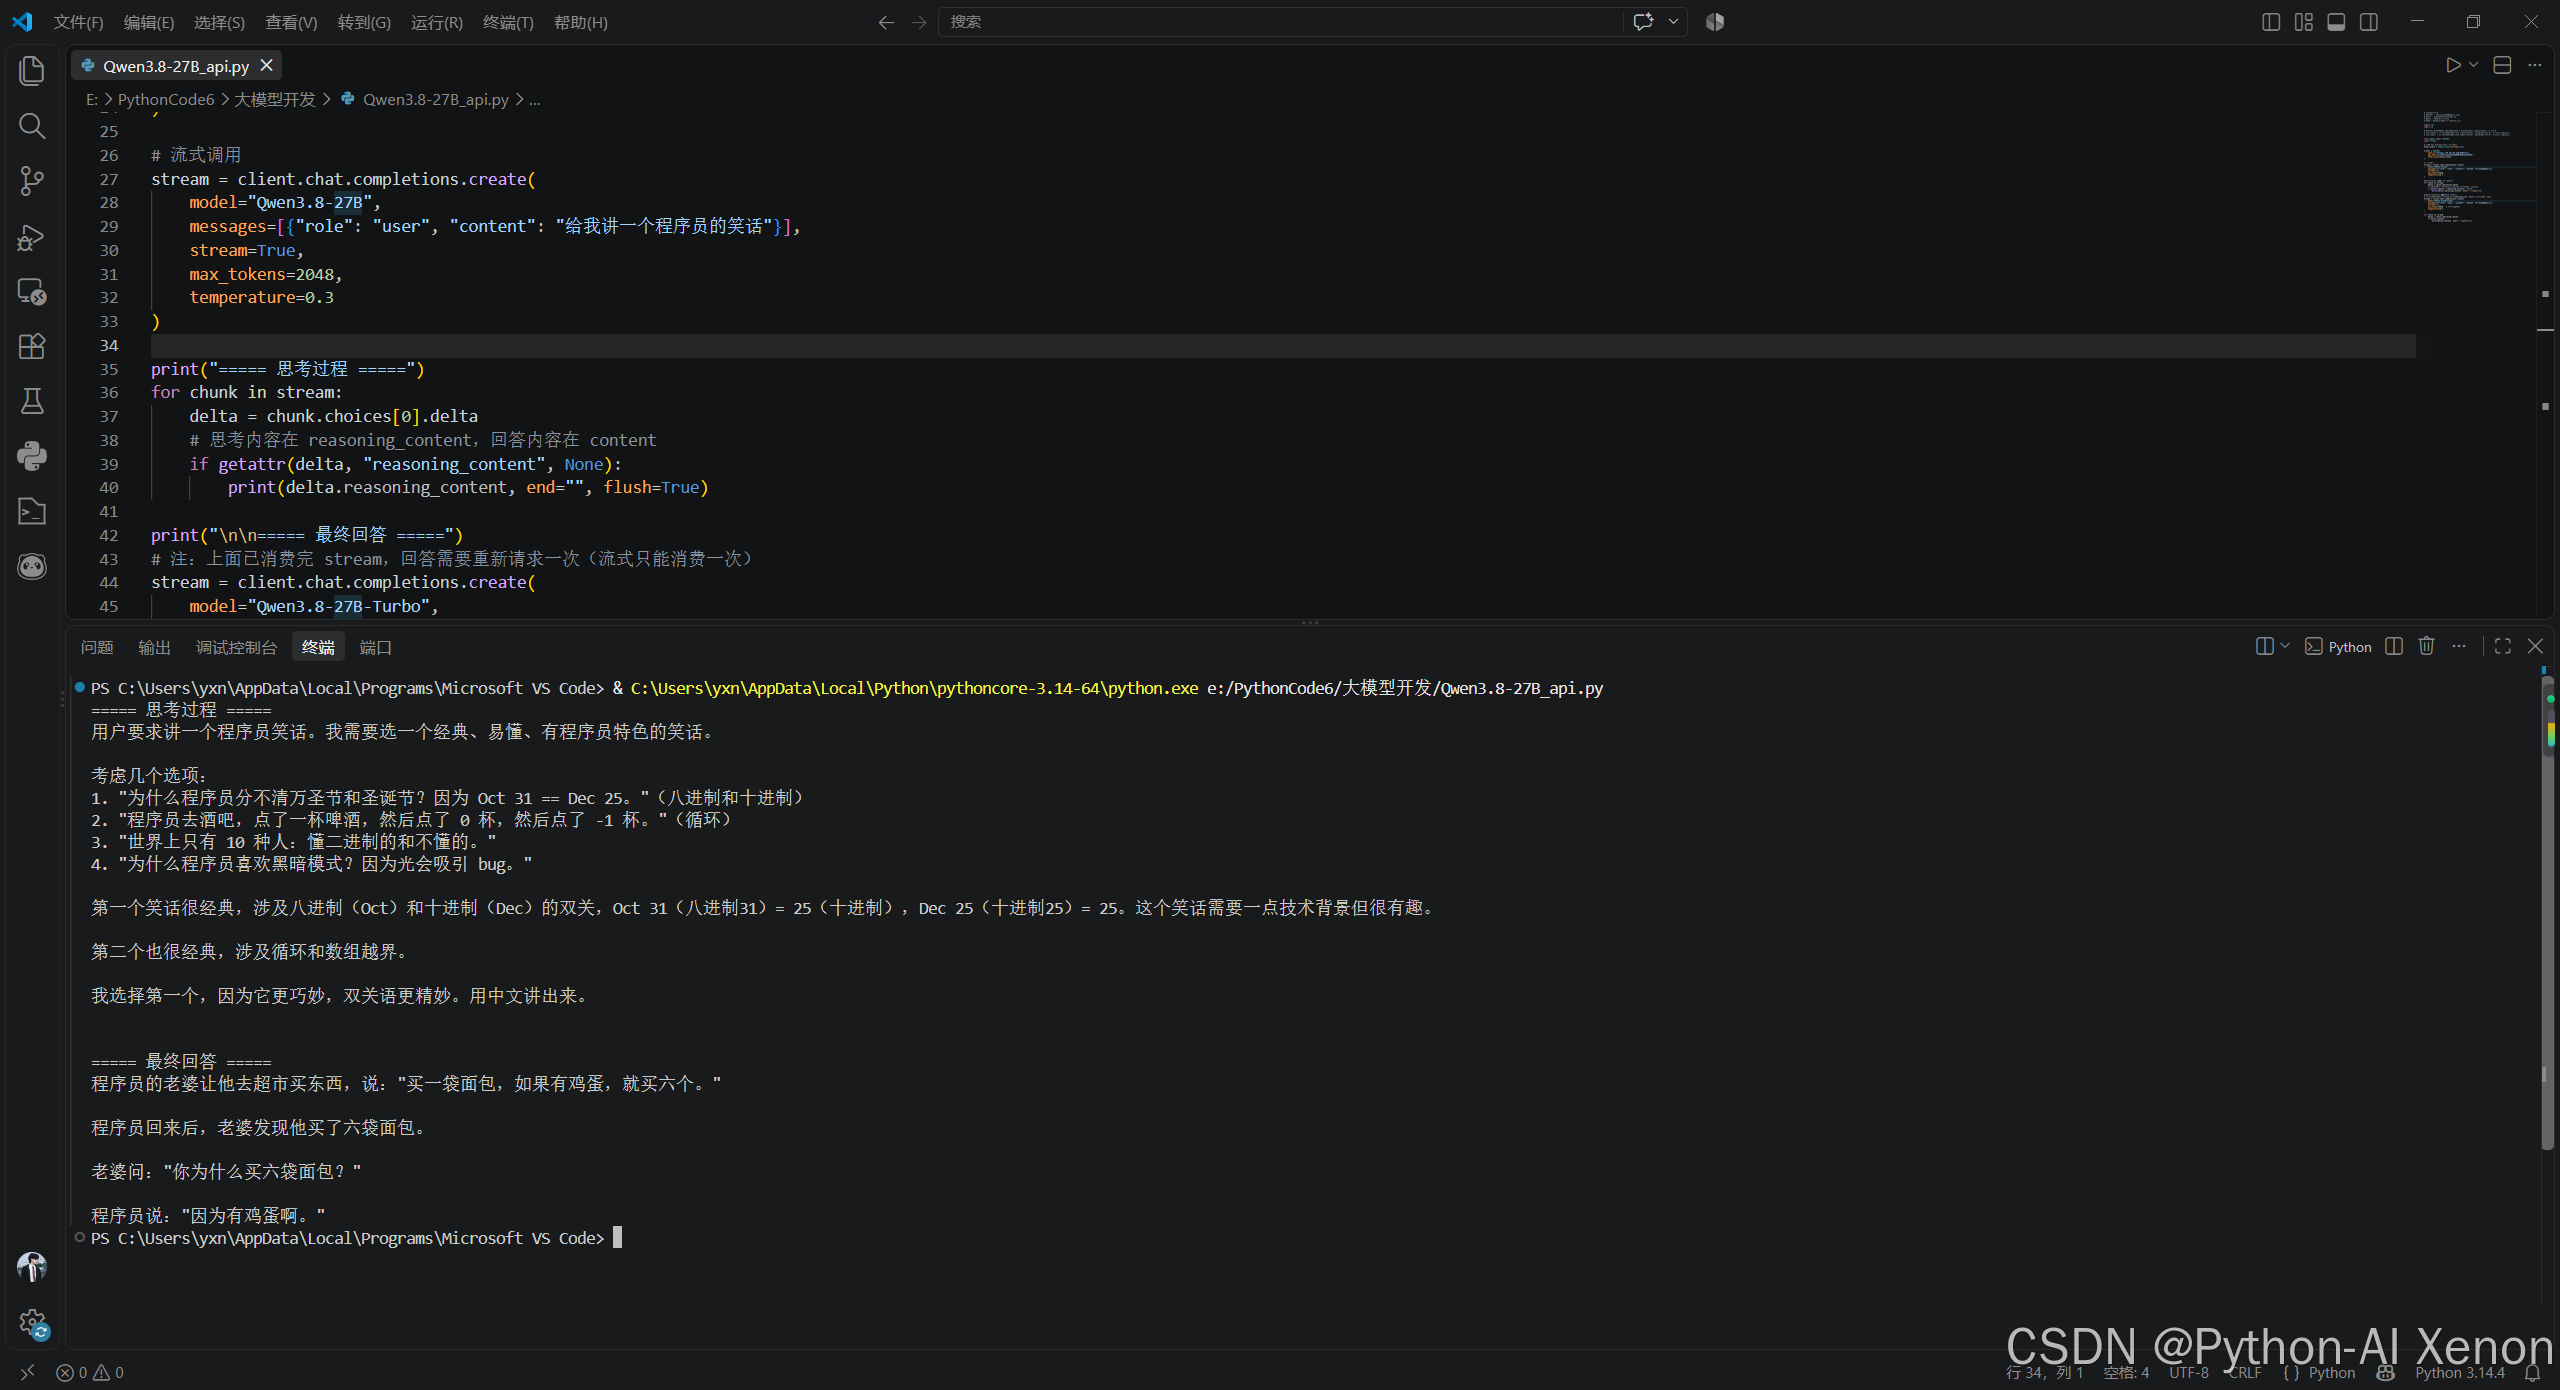
客户端侧(OpenAI SDK)体验:
python
import sys
import io

# Windows 控制台默认 gbk,无法编码 ² 等字符,强制 stdout/stderr 用 utf-8
# sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8", errors="replace")
# sys.stderr = io.TextIOWrapper(sys.stderr.buffer, encoding="utf-8", errors="replace")

from openai import OpenAI
import httpx

# 关闭 SSL 证书校验,跳过自签证书
http_client = httpx.Client(verify=False)

client = OpenAI(
    base_url="https://<你的公网IP>:60443/v1",
    api_key="sk-xxxxxxxx",
    http_client=http_client,
)

# 流式调用
stream = client.chat.completions.create(
    model="Qwen3.8-27B-Turbo", # 想用哪个模型,只改 model 字符串
    messages=[{"role": "user", "content": "给我讲一个程序员的笑话"}],
    stream=True,
    max_tokens=2048,
    temperature=0.3
)

print("===== 思考过程 =====")
for chunk in stream:
    delta = chunk.choices[0].delta
    # 思考内容在 reasoning_content,回答内容在 content
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True)

print("\n\n===== 最终回答 =====")
# 注:上面已消费完 stream,回答需要重新请求一次(流式只能消费一次)
stream = client.chat.completions.create(
    model="Qwen3.8-27B-Turbo",
    messages=[{"role": "user", "content": "给我讲一个程序员的笑话"}],
    stream=True,
    max_tokens=4096,  # 回答长度限制
    temperature=0.3
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
OpenAI SDK 接入测试(test_openai_sdk.py 运行结果)
5.6 进阶:路由表化 + 动态扩缩容
模型多了之后,把 if-else 换成查表:
lua
local routes = {
    ["Qwen3-14B"]     = "@backend_14b",
    ["Qwen3.8-27B"]   = "@backend_27b",
    ["Qwen2.5-7B"]    = "@backend_7b",
}
local target = routes[data.model] or "@backend_27b"
ngx.exec(target)
再进一步,路由表可以放 Redis,实现不停机加模型、扩缩容。
六、实测:大海捞针(Needle-in-a-Haystack)验证长上下文召回
网关搭好之后,光看"能返回"是不够的。我加了一个大海捞针测试,一次性验证三件事:
| 验证目标 | 对应前文章节 |
|---|---|
① 27B 的真实可用上下文上限 到底是多少(-c 262144 究竟有没有生效) |
§三、§七 坑 1 |
| ② 量化到 IQ4_XS 之后,长文本召回有没有退化(量化最怕注意力分布偏移) | §3.2 |
| ③ 网关在超长请求 + 流式输出下稳不稳 |
6.1 为什么必须做这个测试
日常 Agent 调用、长文档摘要、代码库问答都会产生超长 prompt。如果模型在 10 万 token 就开始「失忆」,那 -c 262144 的上下文窗口就是纸面参数------能吃下和能记住是两回事。
而且这里有个更实际的担忧:我把 27B 压到了 IQ4_XS(4bit),量化最怕的就是注意力分布偏移导致长文本后半段「胡说」。所以这个测试同时回答两个问题:
- 窗口是不是真的 ------262144 有没有被
n_ctx_traincap 掉; - 量化有没有伤到长文本------IQ4_XS 在 20 万+ token 下还能不能精准召回。
6.2 测试思路
| §5.4 |
6.1 测试思路
在一大段无意义填充文本("干草堆")的随机位置埋一句口令("针"),然后让模型只输出这句口令。
[填充段 1][填充段 2] ... [★口令:量子密码-1234★] ... [填充段 N]
                              ↑ 埋在 70%~100% 的随机位置
(避免模型靠"看开头结尾"蒙对)埋点位置必须是随机的:如果每次都埋在开头,模型可以靠"注意力天然偏向开头"蒙混过关,测出来是假阳性。
6.2 脚本做的三个关键升级
跑之前我对原始脚本做了三处改造,这三处直接决定了结果可不可信:
| 升级 | 为什么必须做 |
|---|---|
| 用真实 tokenizer 计数,不再按 1.8 字/token 估算 | 中文换算系数是拍出来的,不同 tokenizer 差异巨大。用估算值做"上下文上限"结论,等于用一把没刻度的尺子量长度 |
| 客户端超时从 700s 提到 1800s | 实测 2200 段就要 708 秒,700s 会在终点前自己先超时 |
循环改成 (100, 500, 1500, 1800, 2200, 2500) |
服务端 -c 262144 是真的能吃长上下文,原来的档位拉不满量程,测不出上限在哪 |
token 计数用 modelscope 拉官方 tokenizer(只下 tokenizer 相关文件,别把几十 GB 权重也拖下来):
python
from modelscope import snapshot_download
tok_dir = snapshot_download(
    "Qwen/Qwen3.8-27B",
    allow_file_pattern=["tokenizer*", "vocab*", "merges*"],
)
6.3 完整测试脚本
python
# coding=utf-8
# long_context_test2.py
# 大海捞针:在超长文本中埋口令,验证模型能否在远端位置精准召回

import random, time
import httpx
from openai import OpenAI
from transformers import AutoTokenizer

MODEL = "Qwen3.8-27B-Turbo"
MAX_TOKENS = 260000        # 服务端 -c 262144,留一点余量

tok = AutoTokenizer.from_pretrained(tok_dir, trust_remote_code=True)

http_client = httpx.Client(
    verify=False,                                   # 内网自签证书,正式环境请换受信任证书
    timeout=httpx.Timeout(1800.0, connect=30.0),    # ★ 2200 段实测 708s,700s 不够
)
client = OpenAI(
    base_url="https://<你的公网IP>:60443/v1",        # ★ 只填网关地址,不填后端端口
    api_key="sk-xxxxxxxx",
    http_client=http_client,
)

FILLER = ("人工智能正在改变各行各业。" * 20 + "\n")   # 每段约 260 字


def n_tokens(text: str) -> int:
    return len(tok.encode(text))


def build(total_paragraphs: int, needle_para: int, secret: str) -> str:
    parts = []
    for i in range(total_paragraphs):
        if i == needle_para:
            parts.append(f"【重要提示】请记住这个口令:{secret}。它藏在文档第 {needle_para + 1} 段。\n")
        else:
            parts.append(FILLER)
    return "\n".join(parts)


def run_test(total_paragraphs=500, needle_para=None) -> bool:
    t0 = time.time()
    secret = f"量子密码-{random.randint(1000, 9999)}"
    if needle_para is None:
        needle_para = random.randint(int(total_paragraphs * 0.7), total_paragraphs - 1)
    context = build(total_paragraphs, needle_para, secret)

    ntok = n_tokens(context)
    kb = len(context.encode("utf-8")) / 1024
    unit = "KB" if kb < 1024 else "MB"
    size = kb if kb < 1024 else kb / 1024
    print(f"[测试] 段落数={total_paragraphs},口令埋在第 {needle_para + 1} 段,口令={secret}")
    print(f"[测试] 上下文: {ntok:,} tokens / {MAX_TOKENS:,} "
          f"({ntok / MAX_TOKENS:.1%}) ≈ {size:.1f} {unit}")

    if ntok > MAX_TOKENS:
        print(f"[跳过] 超出量程,跳过")
        return False

    messages = [
        {"role": "system", "content": "你是一个严谨的助手,只回答用户明确问到的内容。"},
        {"role": "user", "content": f"{context}\n\n请只输出文档里【重要提示】中的口令,不要解释。"},
    ]

    try:
        stream = client.chat.completions.create(
            model=MODEL,          # ★ 只改 model 字段就能切后端,地址不用动
            messages=messages,
            stream=True,
            max_tokens=512,
            temperature=0.0,      # ★ 消除采样随机性,召回失败就是失败
        )
        answer = ""
        for chunk in stream:
            delta = chunk.choices[0].delta
            if getattr(delta, "reasoning_content", None):
                continue          # ★ TURBO 版会输出思考块,不跳过会污染判定
            if delta.content:
                answer += delta.content
        answer = answer.strip()
        ok = secret in answer
        print(f"[结果] 模型回答: {answer!r}")
        print(f"[结果] {'✅ 命中' if ok else '❌ 未命中'} (期望: {secret})")
        print(f"[耗时] {time.time() - t0:.2f} 秒")
        return ok
    except Exception as e:
        print(f"[错误] 请求失败: {e} (耗时 {time.time() - t0:.2f} 秒)")
        return False


if __name__ == "__main__":
    for n in (100, 500, 1500, 1800, 2200, 2500):
        run_test(total_paragraphs=n)
        print("-" * 60)
6.4 实测结果
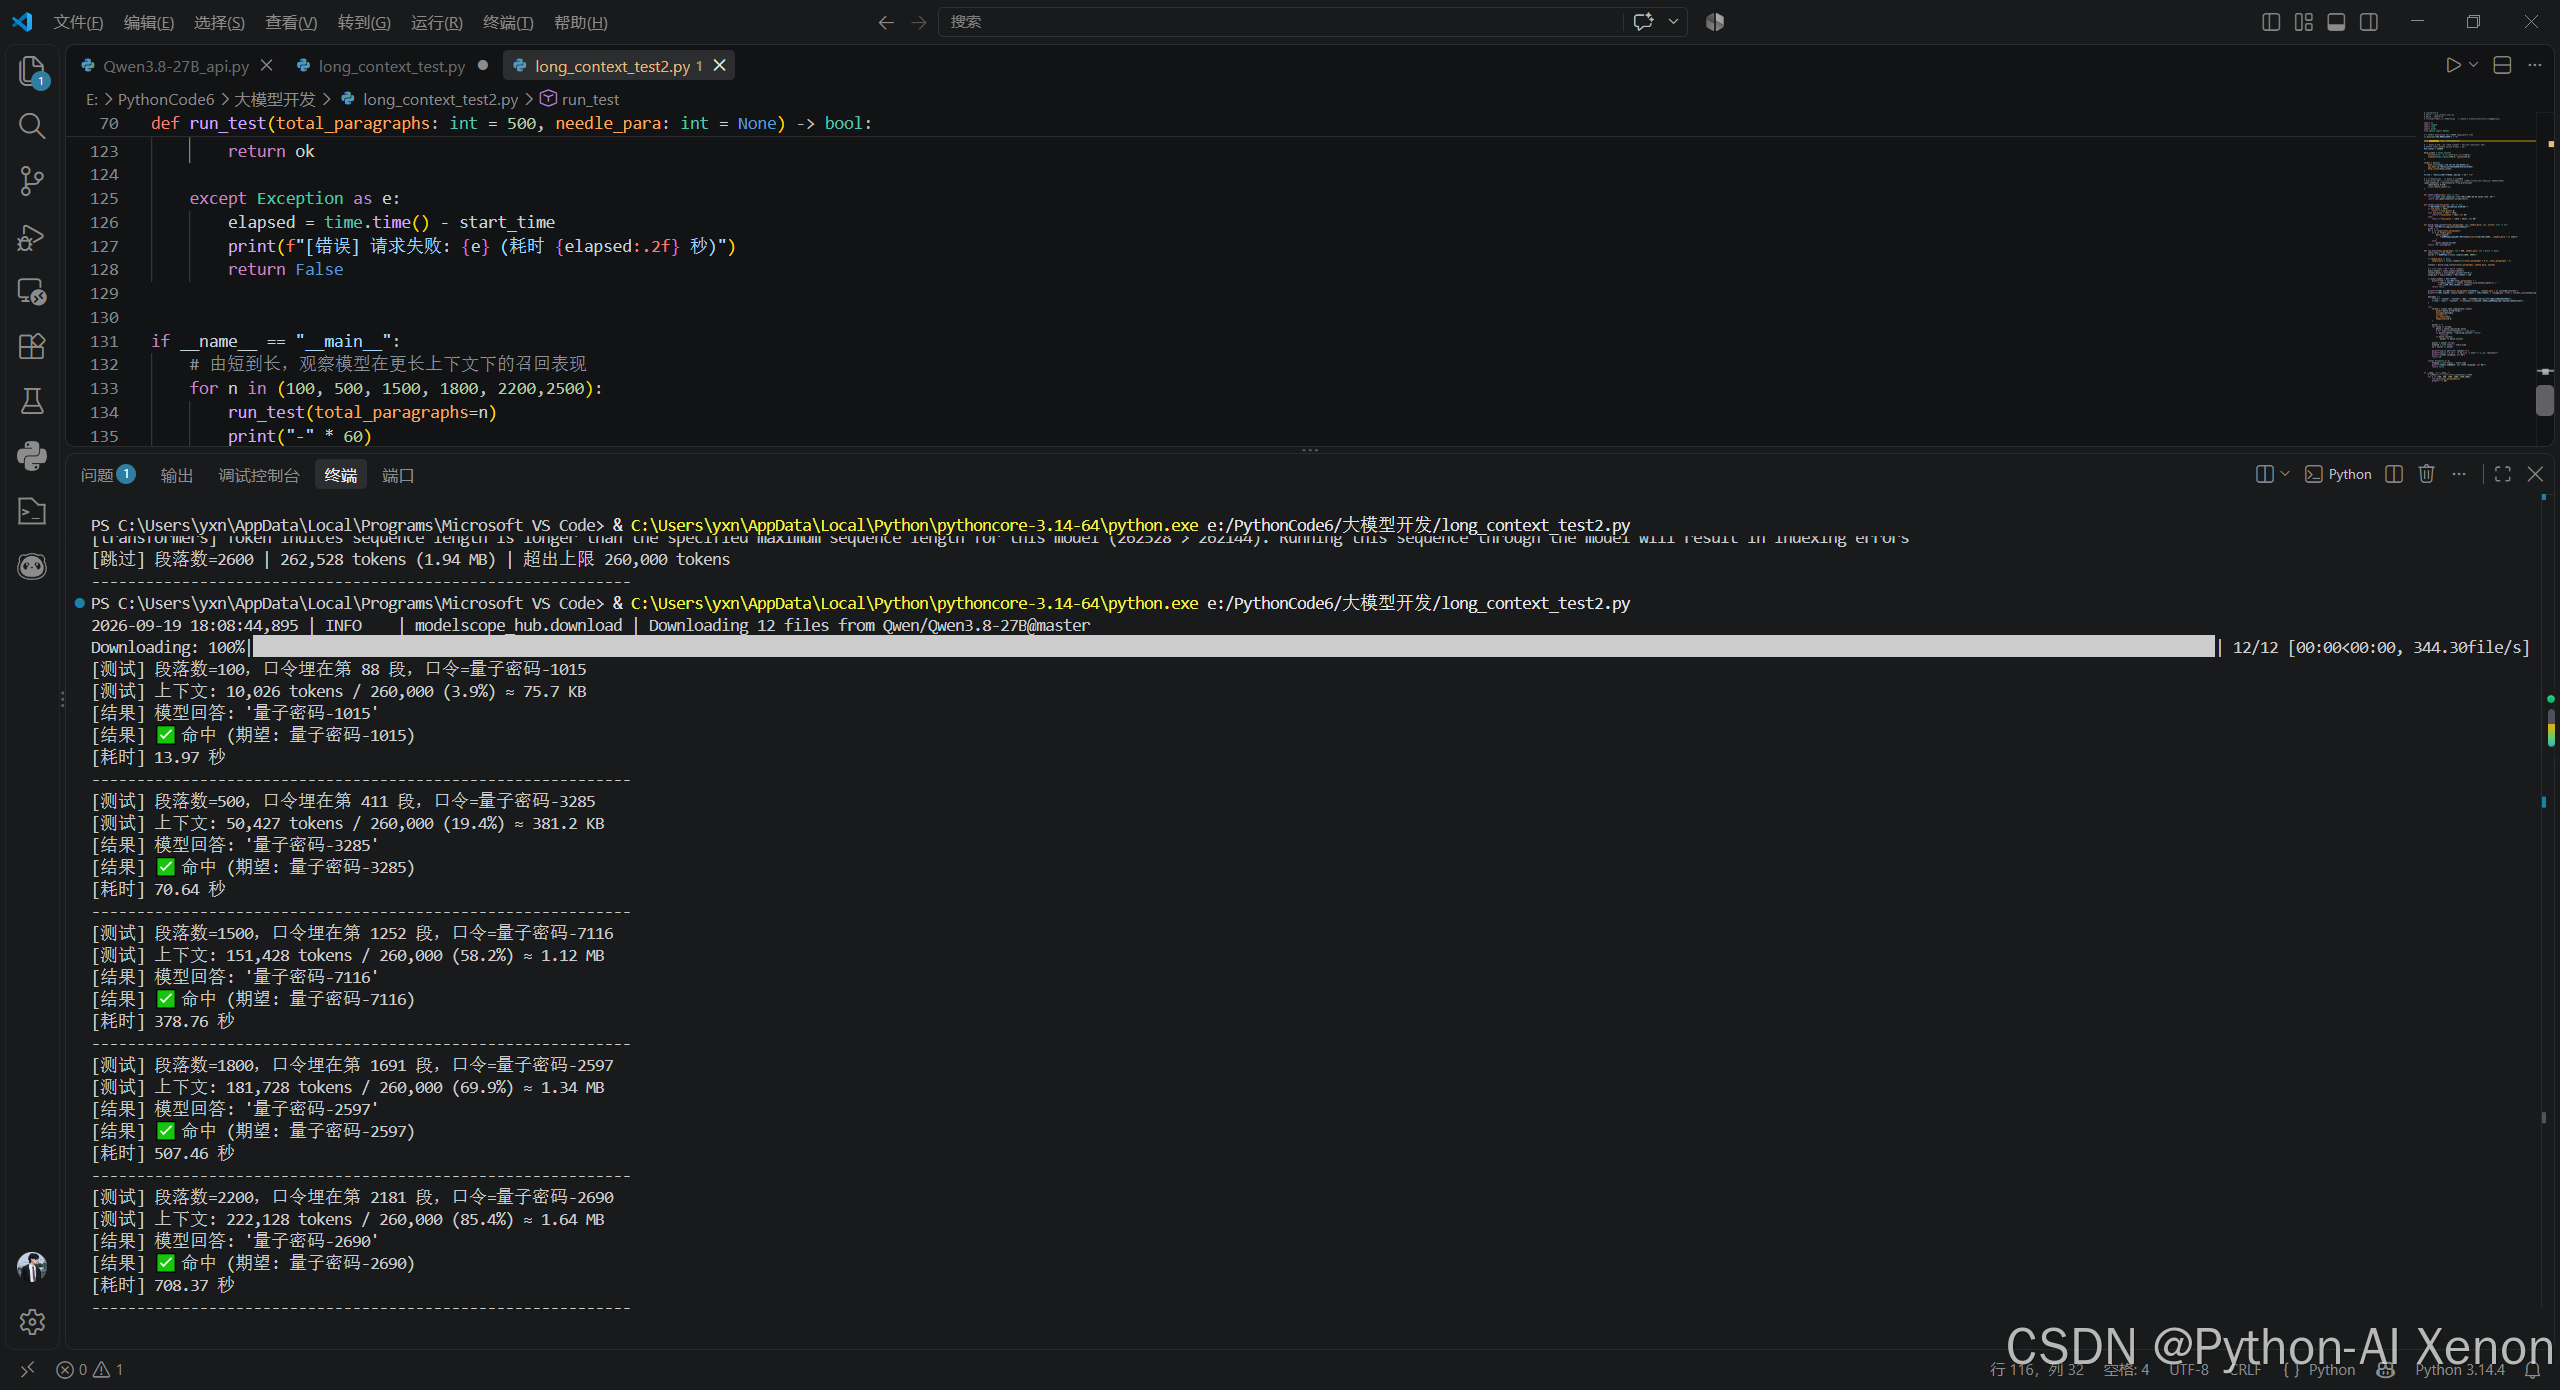
| 段落数 | 上下文 token | 占量程 | 文本体积 | 埋点位置 | 端到端耗时 | 吞吐 | 结果 |
|---|---|---|---|---|---|---|---|
| 100 | 10,026 | 3.9% | 75.7 KB | 第 88 段 | 13.97 s | 718 t/s | ✅ 命中 |
| 500 | 50,427 | 19.4% | 381.2 KB | 第 411 段 | 70.64 s | 714 t/s | ✅ 命中 |
| 1500 | 151,428 | 58.2% | 1.12 MB | 第 1252 段 | 378.76 s | 400 t/s | ✅ 命中 |
| 1800 | 181,728 | 69.9% | 1.34 MB | 第 1691 段 | 507.46 s | 358 t/s | ✅ 命中 |
| 2200 | 222,128 | 85.4% | 1.64 MB | 第 2181 段 | 708.37 s | 314 t/s | ✅ 命中 |
| 2500 | 252,428 | 97.1% | 1.86 MB | 第 1777 段 | 516 s 断连 | --- | ❌ 见 §6.6 |
结论一:IQ4_XS 量化没有损害长文本召回。 22.2 万 token、口令埋在 98% 位置(第 2181/2200 段),模型依然一字不差报出口令。这直接回应了 §3.2 的担忧------KV Cache 用 q8_0 是对的,换成 q4_0 大概率会在这种长度上翻车。
结论二:262144 的上下文窗口是真的。 服务端日志里 truncated = 0,说明 25 万 token 没有被截断。
6.5 服务端日志里挖出来的四个关键结论
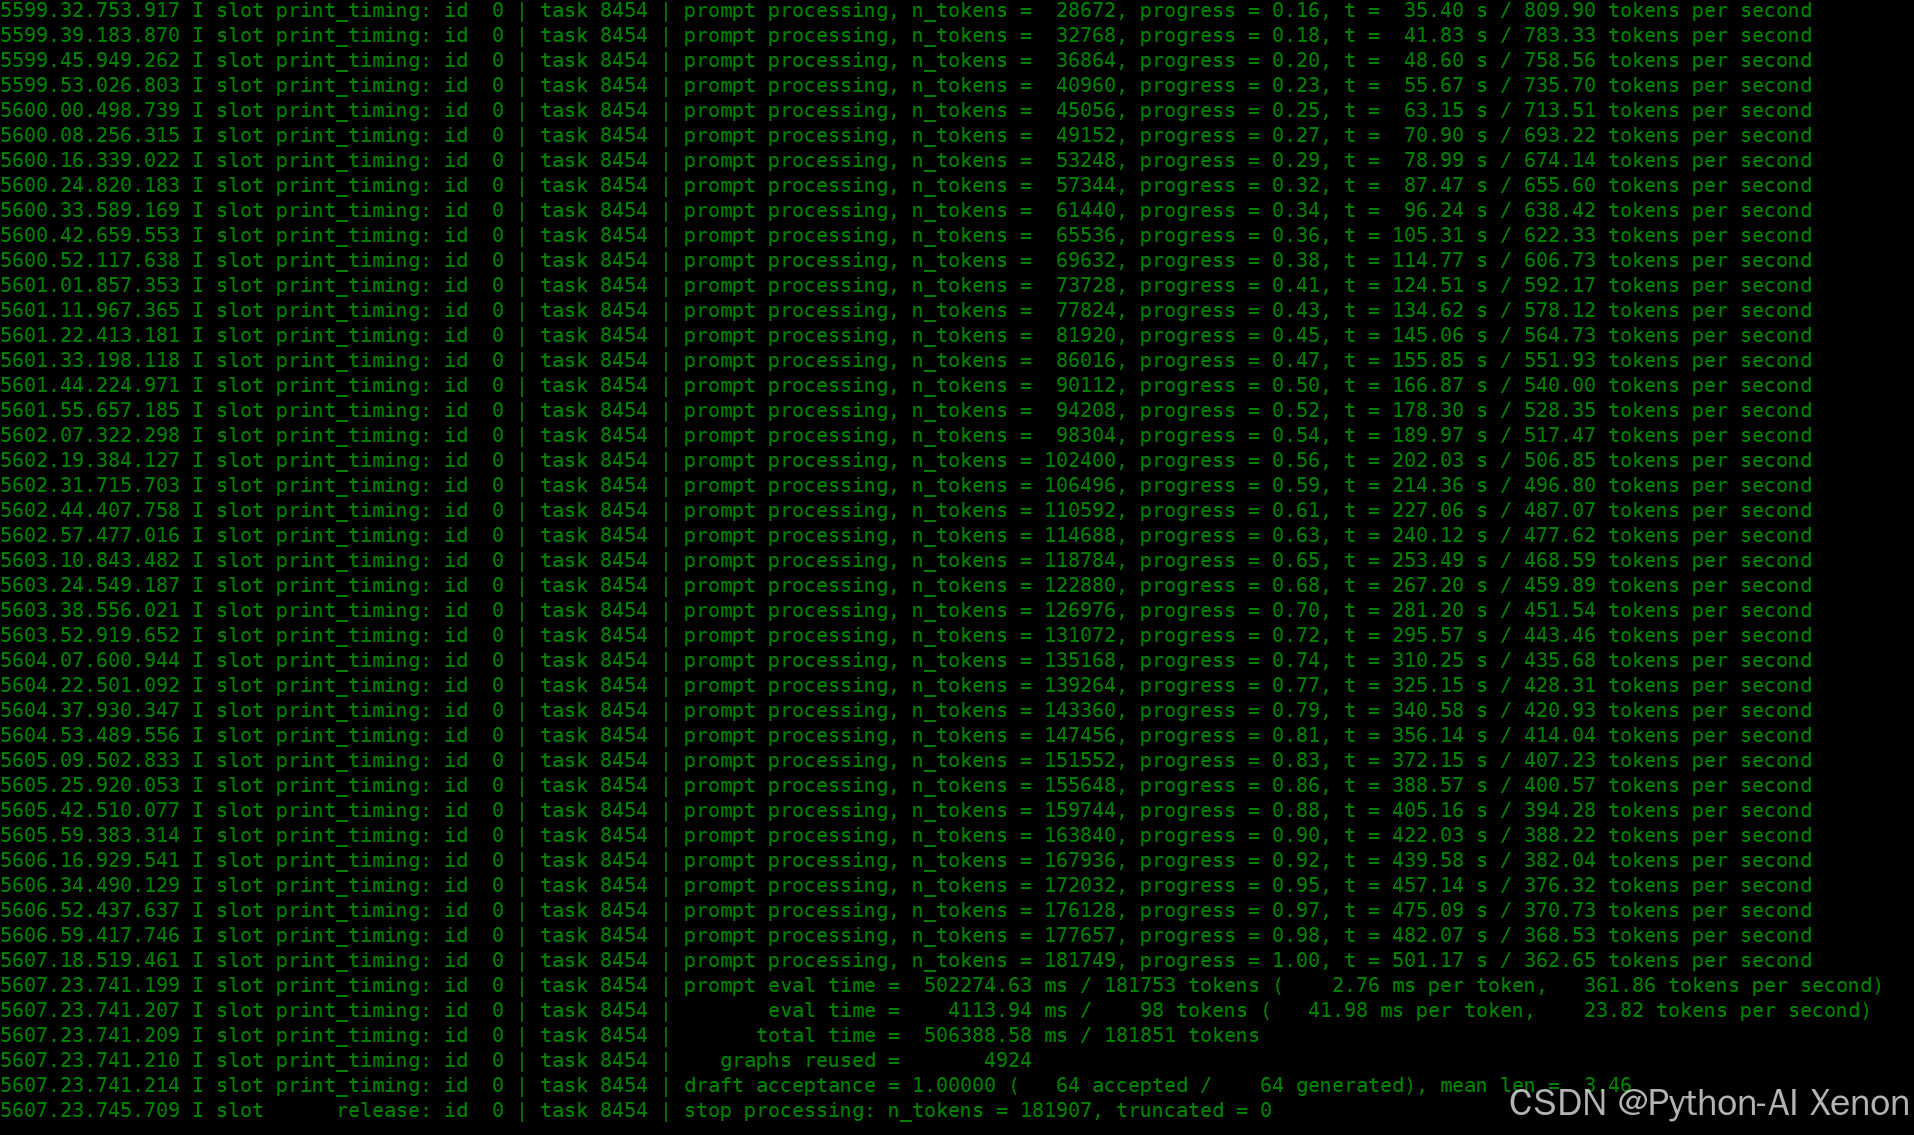
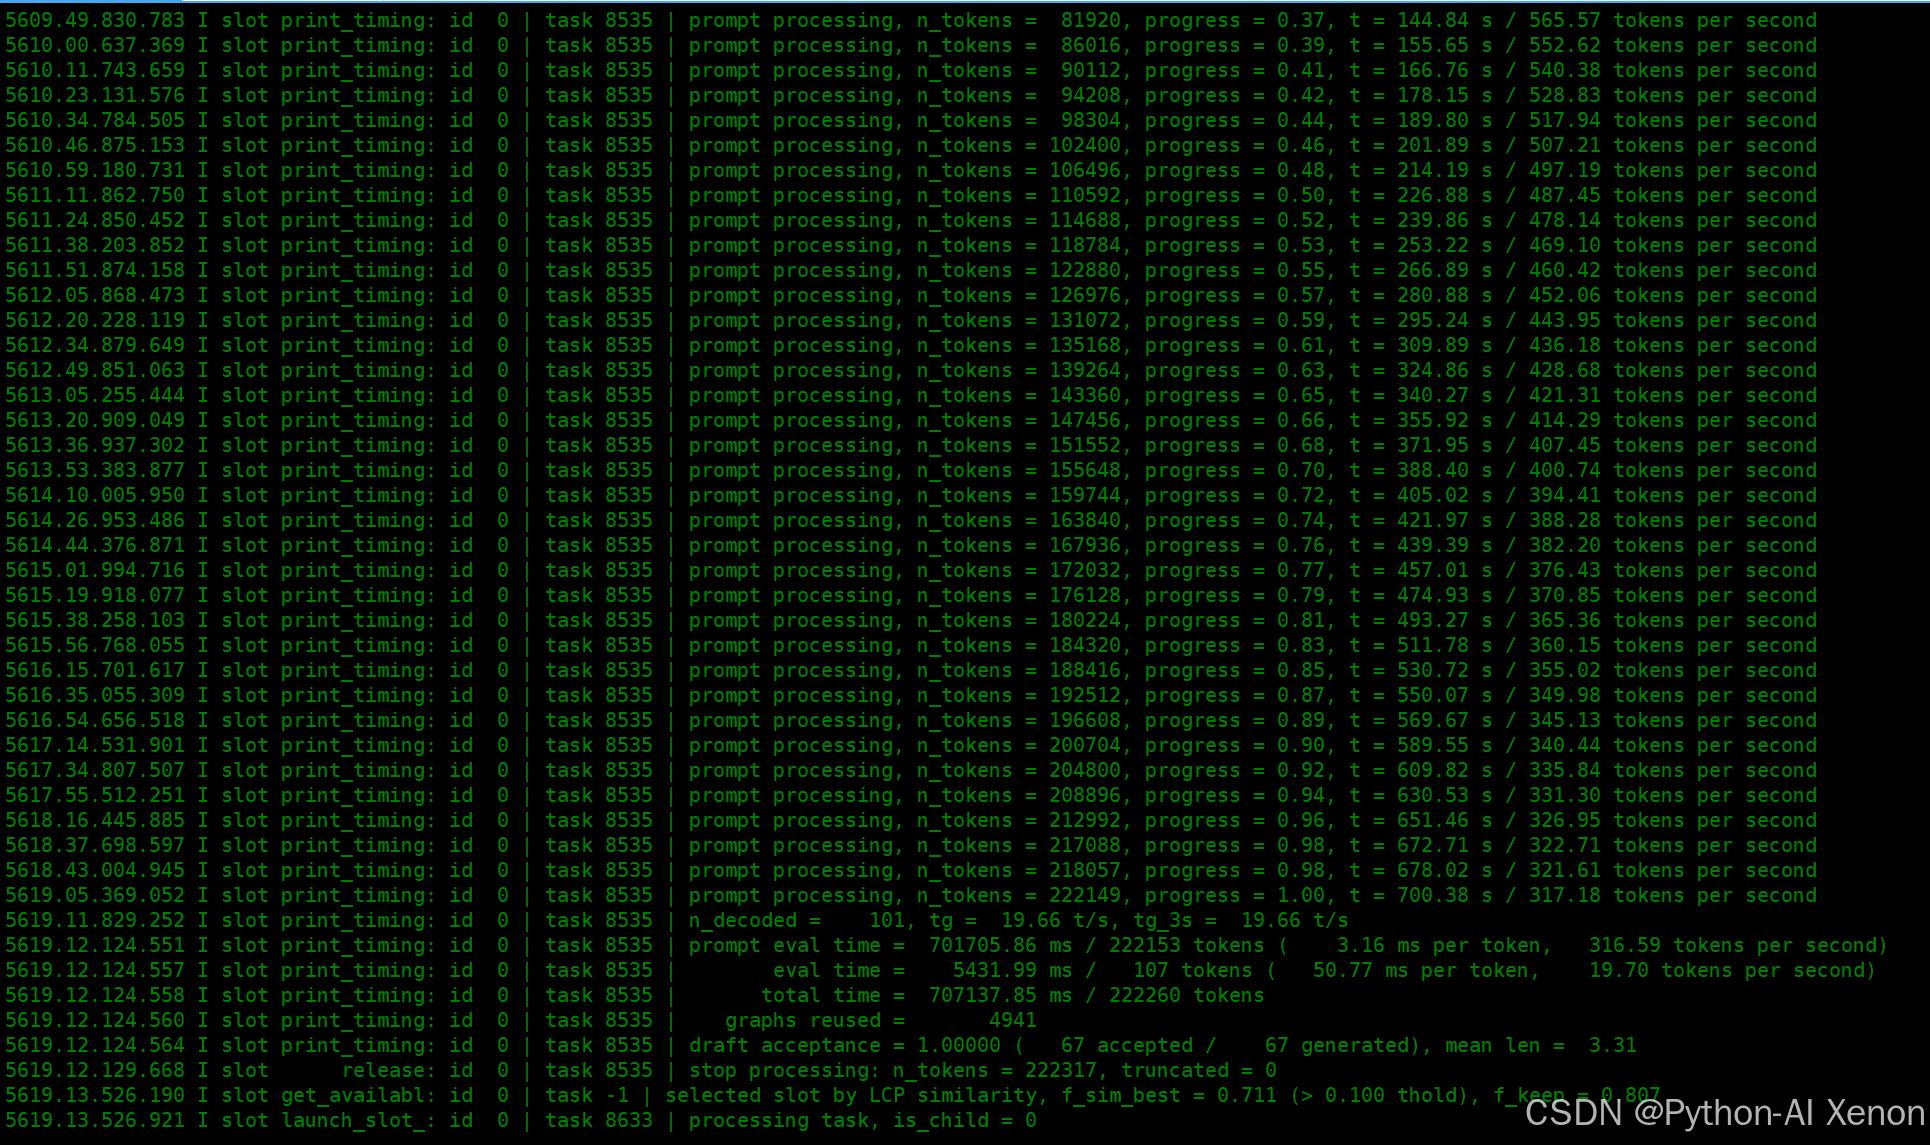
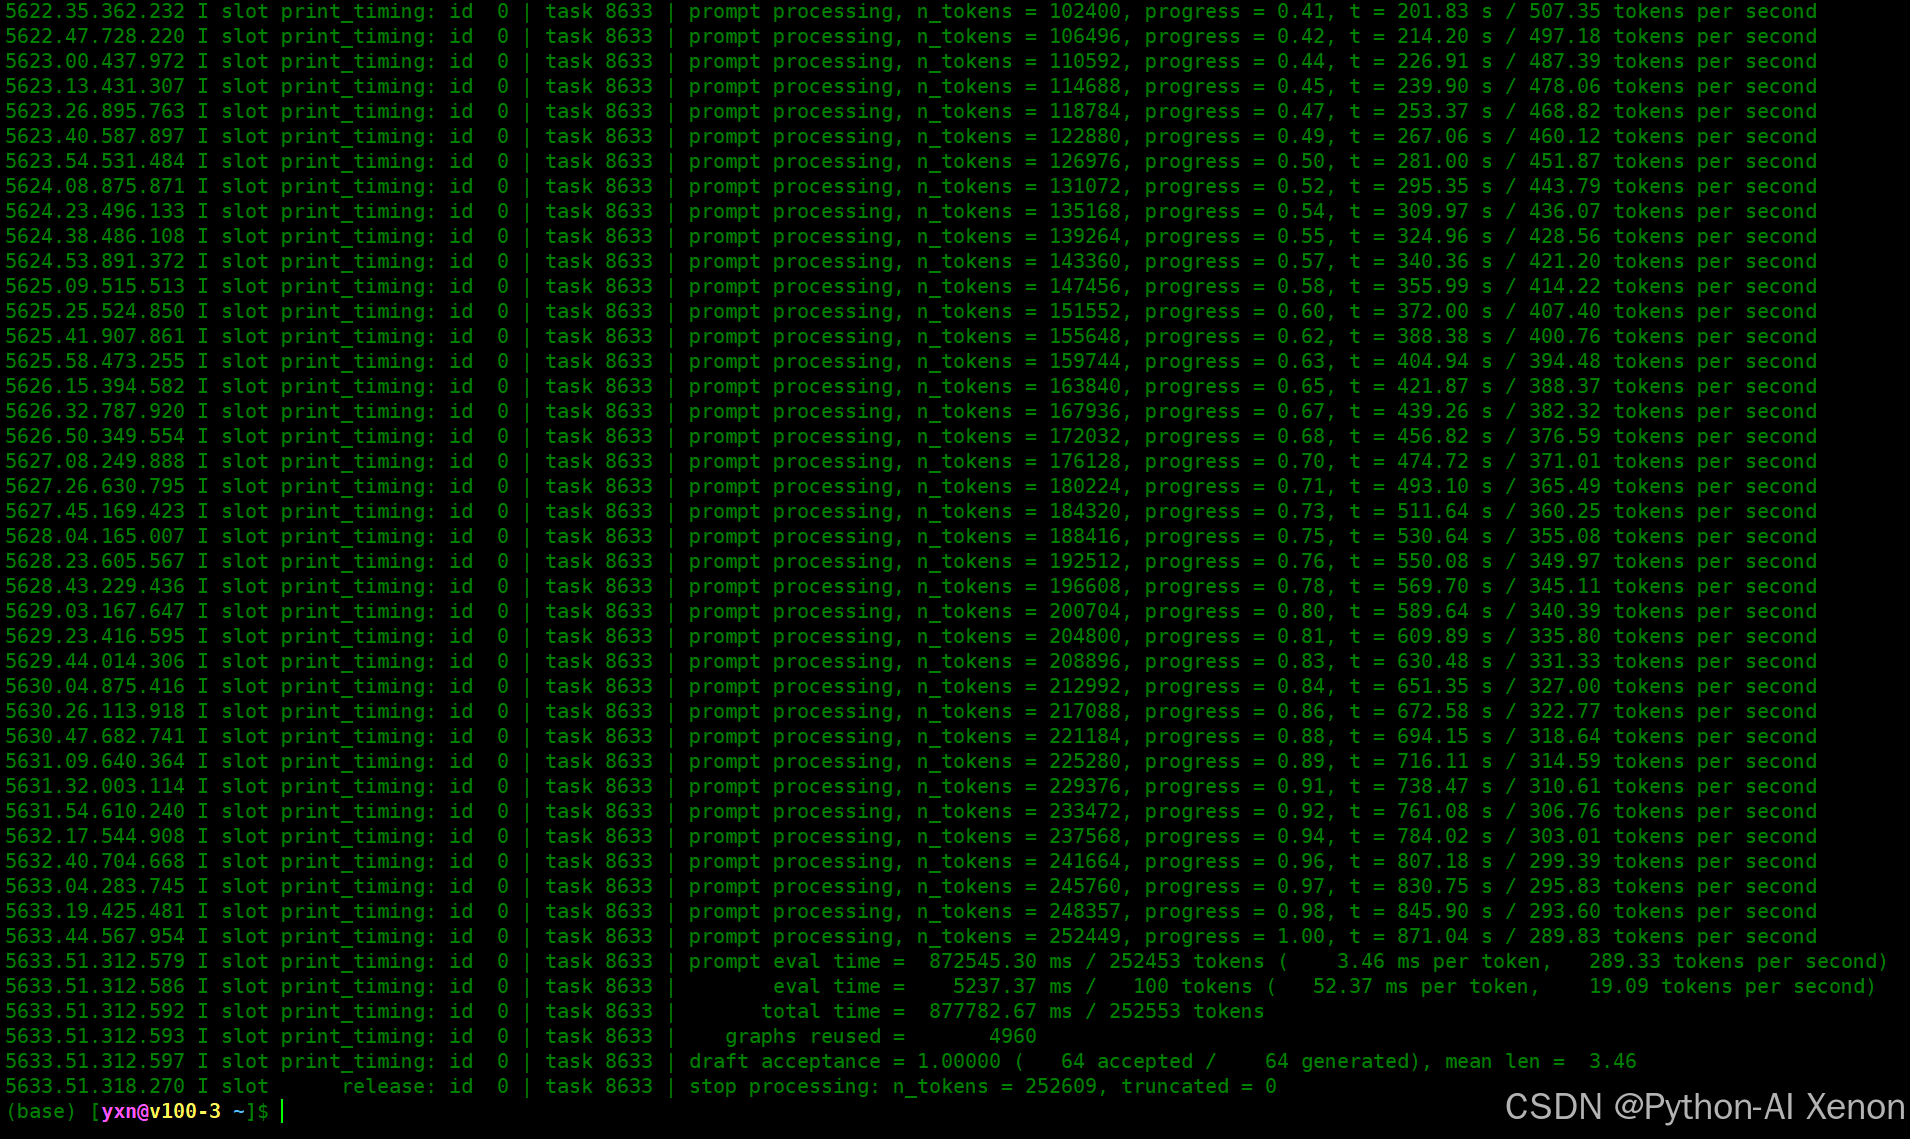
客户端只能看到"对不对、快不快",真正的信息在 llama-server 日志里 。以 2500 段那次为例:
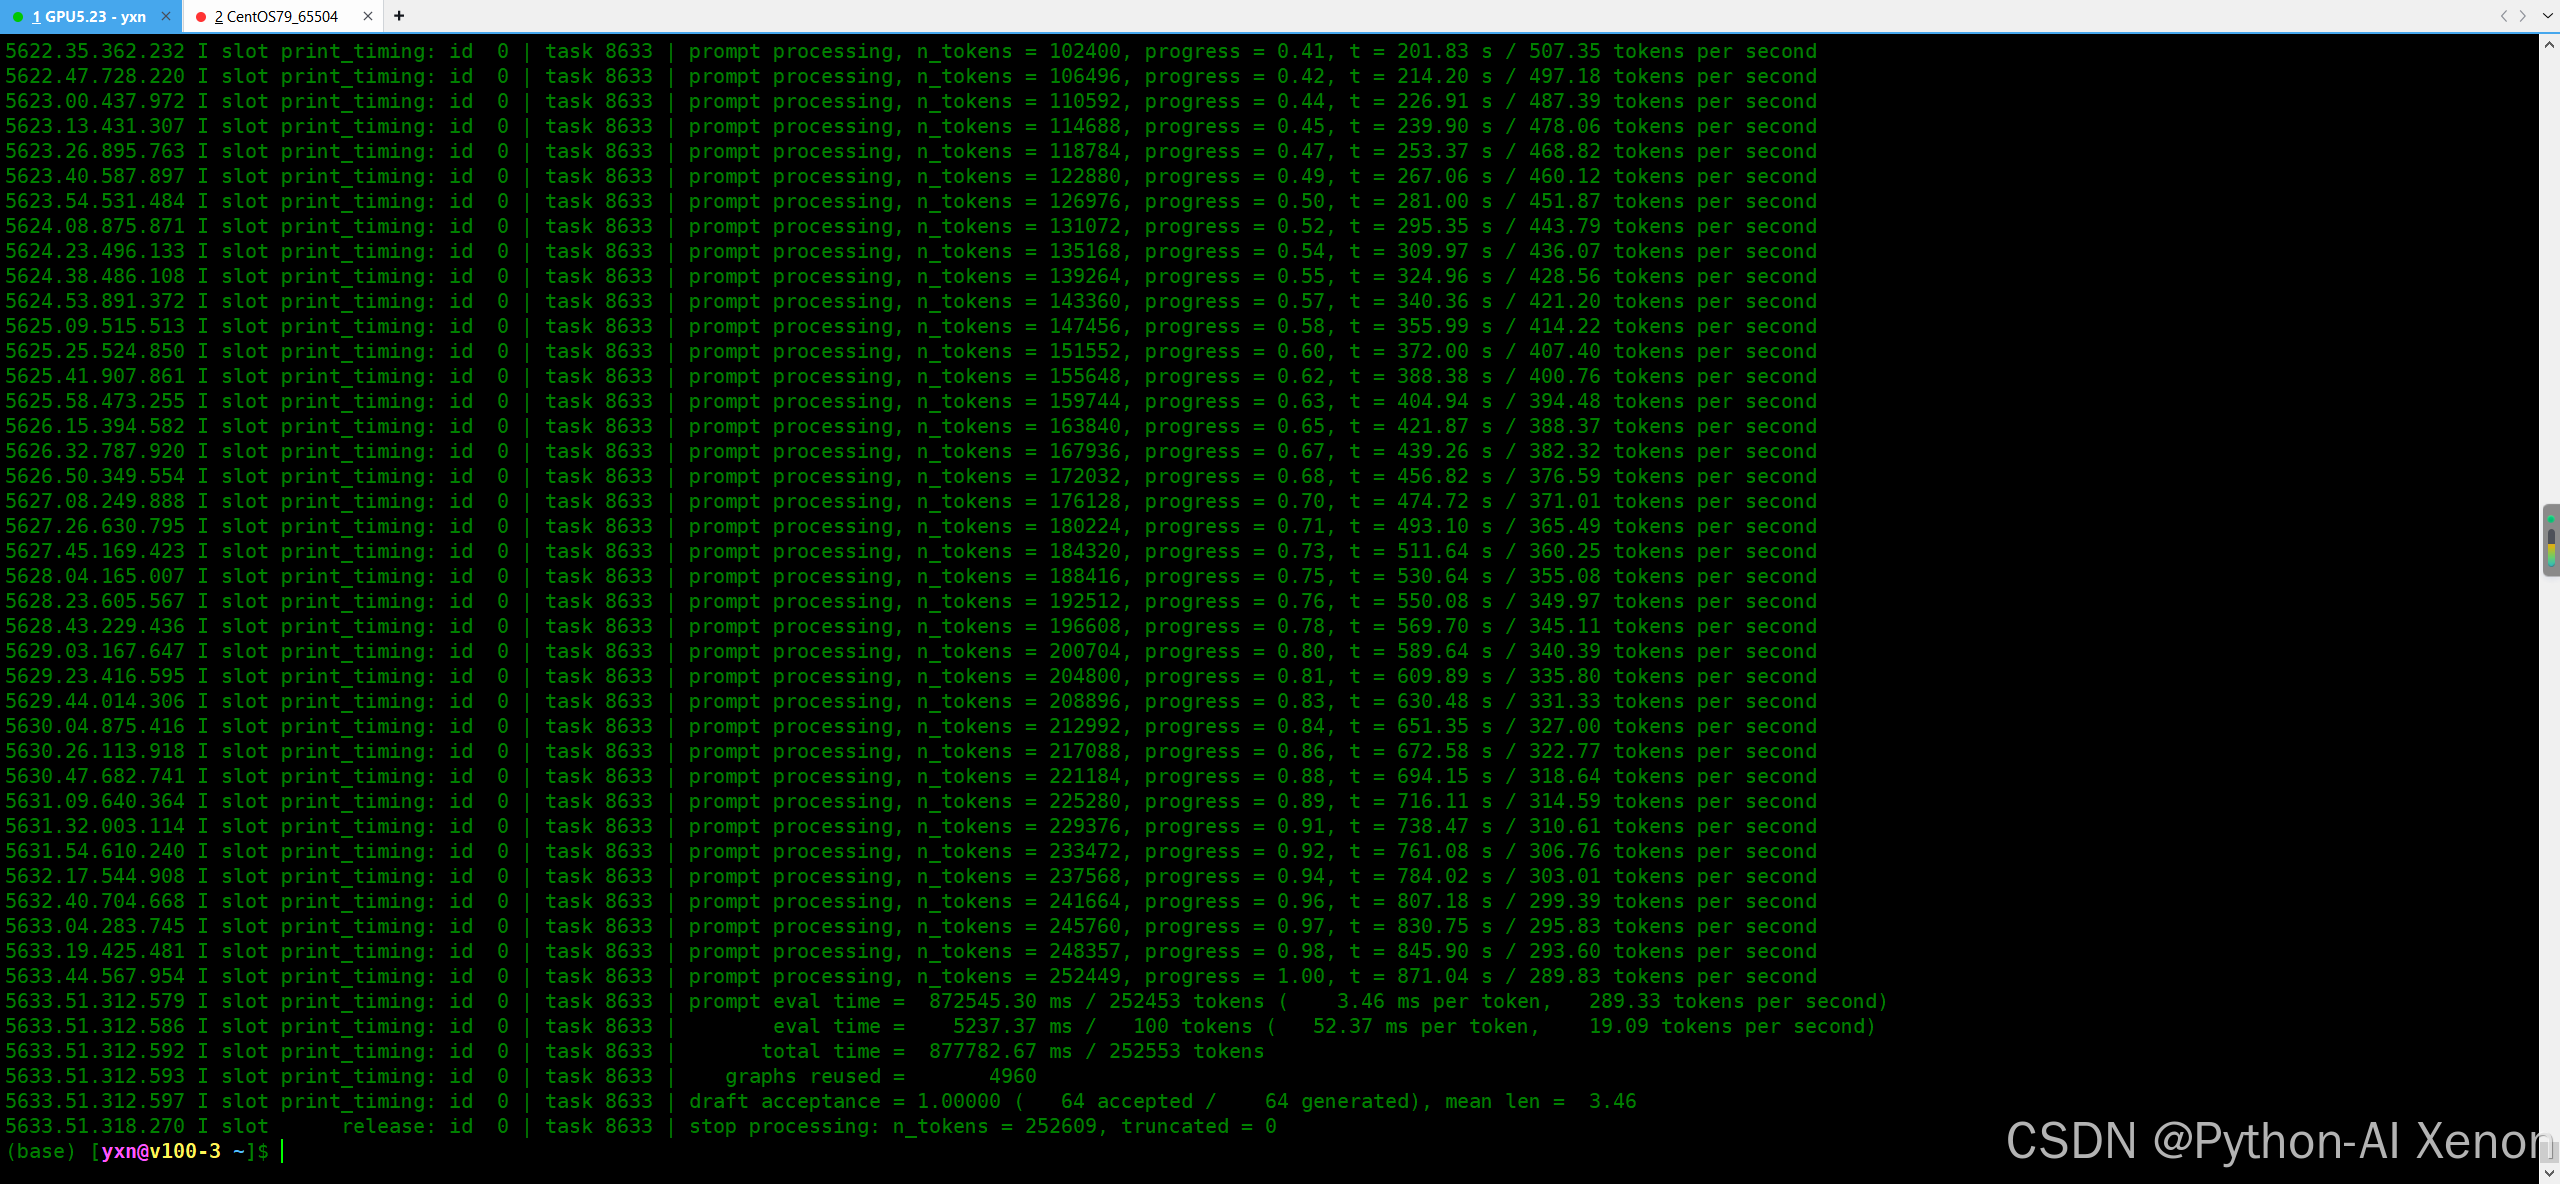
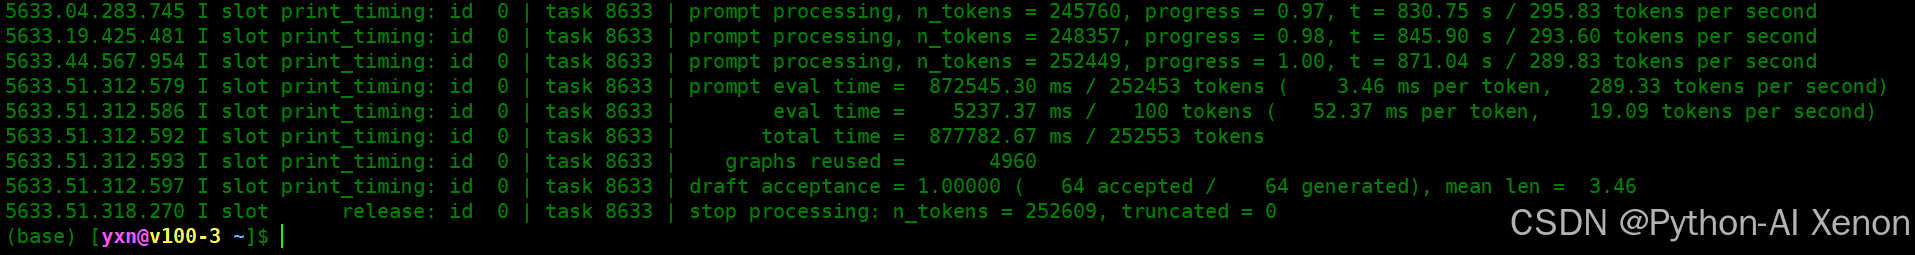
prompt eval time =  872545.30 ms / 252453 tokens (   3.46 ms per token,   289.33 tokens per second)
       eval time =    5237.37 ms /   100 tokens (  52.37 ms per token,    19.09 tokens per second)
      total time =  877782.67 ms / 252553 tokens
   graphs reused =       4960
draft acceptance = 1.00000 (   64 accepted /    64 generated), mean len =  3.46
① 长上下文是"预填充瓶颈",不是"生成瓶颈"
prefill(吃进 25 万 token):  872.5 s   ← 99.4%
decode (吐出 100 个 token):    5.2 s   ← 0.6%
📌 这意味着:长文档场景下优化 decode 速度(MTP、采样、批量)收益极小,真正的战场在 prefill。 想提速只有三条路:更快的卡、FlashAttention 常开、减少不必要的 prompt 长度。
② prefill 吞吐随上下文增长明显衰减
同一个请求内,累计平均吞吐一路下滑:
| 已处理 token | 累计耗时 | 累计平均吞吐 |
|---|---|---|
| 4,096 | 4.27 s | 959 t/s |
| 49,152 | 70.79 s | 694 t/s |
| 98,304 | 189.79 s | 518 t/s |
| 147,456 | 355.99 s | 414 t/s |
| 196,608 | 569.70 s | 345 t/s |
| 252,449 | 871.04 s | 290 t/s |
从 960 t/s 掉到 290 t/s,掉了约 70% 。原因是 KV Cache 越长,每一步注意力要扫的序列越长。这也是为什么"标称上下文"和"能舒服用的上下文"是两回事------能吃下 25 万 token,不代表你愿意等 15 分钟。
③ decode 速度几乎不随上下文长度衰减 ⭐
这是最让我意外的一点:
| 上下文长度 | decode 速度 |
|---|---|
| 222,153 token | 19.70 t/s |
| 252,453 token | 19.09 t/s |
25 万 token 的 KV Cache 压着,解码速度只掉了 3%。 说明 --flash-attn on + --cache-type-k/v q8_0 的组合在 V100 上扛住了,KV Cache 没有成为解码访存瓶颈。
④ MTP 推测解码:接受率 100%,但这个数字要打折看
draft acceptance = 1.00000 (64 accepted / 64 generated), mean len = 3.46两次测试都是 100% 接受率、平均步长 3.46 (接近 --spec-draft-n-max 3 的上限)。
⚠️ 但别被这个数字骗了。 这个测试有两个"作弊"性质:
- 答案是从上下文里抄一个固定格式的字符串 (
量子密码-XXXX),后面还有大量重复的填充文本,可预测性极高; - 填充文本是同一句话重复 20 遍,MTP 几乎闭着眼都能猜对下一个 token。
真实业务(开放生成、代码、多轮对话)的接受率通常在 50%~80% 。所以这里只能证明 "MTP 链路配置正确、能跑通、有正向收益",不能证明"你的场景能提速 3 倍"。想拿真实数字,得换一个开放生成的 benchmark 重测。
6.6 唯一翻车的一次:2500 段 WinError 10054
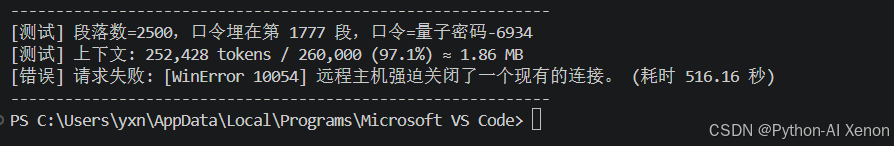
[测试] 上下文: 252,428 tokens / 260,000 (97.1%) ≈ 1.86 MB
[错误] 请求失败: [WinError 10054] 远程主机强迫关闭了一个现有的连接。 (耗时 516.16 秒)
但服务端日志显示,这个请求其实跑完了 ------task 8633 完整处理了 252,453 个 token,truncated = 0,总耗时 877.78 秒。
所以问题不在模型、不在显存、不在网关,而在链路。定位过程:
| 排除项 | 依据 |
|---|---|
| ❌ 不是客户端超时 | 已设为 1800s,实际 516s 就断 |
| ❌ 不是网关超时 | proxy_read_timeout 1800s,且服务端 877s 才返回 |
| ❌ 不是服务端 OOM / 截断 | 日志 truncated = 0,完整跑完 |
| ✅ 是中间链路回收了"长时间无数据"的连接 | 516s 断连,正好落在 NAT/防火墙常见的 300~900s 空闲回收区间 |
根因 :prefill 阶段长达 872 秒 ,客户端开了 stream=True 却在这 872 秒里收不到任何一个字节------连接在链路上看就是"死的",被中间设备主动 RST 了。
✅ 四种解法,按需取用:
python
# 解法 1(最简单):超长档位关掉 stream,让 httpx 一次性等完
stream = client.chat.completions.create(..., stream=False)

# 解法 2:开启 TCP keepalive,告诉中间设备"我还活着"
http_client = httpx.Client(
    timeout=httpx.Timeout(1800.0, connect=30.0),
    transport= httpx.HTTPTransport(retries=1, socket_options=[...]),  # 或用 keepalive 库
)
nginx
# 解法 3:网关侧对齐所有超时,并降低被回收的概率
location @backend_27b {
    proxy_read_timeout 1800s;
    proxy_send_timeout 1800s;
    proxy_connect_timeout 30s;
    proxy_buffering off;      # 流式必须关
}
bash
# 解法 4(最根本):超长任务走内网直连后端,绕过公网 NAT
base_url="http://127.0.0.1:60080/v1"
📌 一句话 :长上下文的瓶颈,从"模型能不能吃下"转移到了"链路能不能扛住"。 这也是云服务上长文档 API 普遍要做异步/轮询的原因。
6.7 这次实测推翻了我之前的一个判断 ⚠️
我在 §七 坑 1 里写过"上下文会被 n_ctx_train cap 掉"。这次实测证明:至少在 Qwen3.8-27B-TURBO-Fable 这个模型上不成立------25 万 token 无截断跑完。
正确的说法应该是:
不同模型的
n_ctx_train天差地别,必须逐个确认。
- Qwen3-14B 官方版:实测被 cap 到 40960(脚本里设 131072 是白设)
- Qwen3.8-27B-TURBO-Fable:实测能吃满 262144(魔改版通常重训/扩过上下文)
判定的唯一可靠方法 :看服务端启动日志里有没有 capping 那行,或者直接用本文这个脚本往上顶,看 truncated 是 0 还是 1。
6.8 顺带验证到的几件事
- 网关大 body 路由正常 :1.86 MB 的请求体远超
client_body_buffer_size 10m?并没有------仍走内存。但如果继续加长超过 10m,会落到"从临时文件读回"那条分支(§5.4 的兜底逻辑),建议单独测一次; - 流式透传正常 :能逐字输出,说明
proxy_buffering off生效; - 前缀缓存被触发 :日志里
selected slot by LCP similarity, f_sim_best = 0.711 (> 0.100 thold), f_keep = 0.807,因为连续几档测试的填充文本高度重复,llama.cpp 命中了前缀复用。⚠️ 这也意味着本测试的绝对耗时可能略优于真实随机长文档,横向对比时要注意; - 三卡是硬需求 :25 万 token 的 q8_0 KV Cache 量级在数十 GB,叠加 IQ4_XS 权重后,单卡或双卡 V100 32GB 根本装不下。这就是 §3.5 里"27B 必须占三张卡"的实测依据。
七、踩坑清单(按### 坑 1:-c 131072 白设了,还白占显存 ⭐⭐⭐⭐⭐
日志会报:
n_ctx_seq (131072) > n_ctx_train (40960) -- capping模型训练时的上下文是硬上限 ,设再大也会被自动 cap 回去。设之前先查模型的 n_ctx_train,否则白占显存、启动还更慢。
⚠️ 重要补充 :此结论对 Qwen3-14B 官方版 成立;但魔改版(如 TURBO-Fable)可能重训/扩过上下文,实测能吃满 262144(见 §6.7)。判定唯一可靠方法 :看服务端启动日志里有没有
capping那行,或直接用 §6.3 的脚本往上顶,看truncated是 0 还是 1。还白占显存 ⭐⭐⭐⭐⭐
日志会报:
n_ctx_seq (131072) > n_ctx_train (40960) -- capping模型训练时的上下文是硬上限 ,设再大也会被自动 cap 回去。设之前先查模型的 n_ctx_train,否则白占显存、启动还更慢。
坑 2:用 -c 指定配置文件报 "upstream" directive is not allowed here ⭐⭐⭐⭐⭐
bash
$ openresty -t -c ~/data_share/nginx/conf/api_gateway.conf
nginx: [emerg] "upstream" directive is not allowed here in ...:4
原因 :-c 指定的必须是完整主配置 (含 http {} 块)。你的片段里顶层直接写 upstream,nginx 不认。
正解 :在 OpenResty 默认 nginx.conf 的 http {} 块内 include 你的配置:
bash
sudo sed -i '/^http {/a\    include /home/<你的用户名>/data_share/nginx/conf/api_gateway.conf;' \
  /usr/local/openresty/nginx/conf/nginx.conf
另外,非 root 执行 -t 还会遇到:
nginx: [alert] could not open error log file: ... (13: Permission denied)用 sudo 跑 -t 即可。
坑 3:shell 里 true 写成 ture,开关静默失效 ⭐⭐⭐⭐
我自己的脚本里就中招了:
bash
NUMA_BIND=ture       # ❌ 拼错
ENABLE_MMPROJ=ture   # ❌ 拼错
...
if [ "$NUMA_BIND" = true ] && command -v numactl &> /dev/null; then
字符串 "ture" != "true",条件永远为假,NUMA 绑定根本没生效,而且没有任何报错。
✅ 修复:
bash
NUMA_BIND=true
ENABLE_MMPROJ=false   # 没有 mmproj 文件就老实关掉
💡 经验 :bash 没有布尔类型,写错就是字符串比较失败,静默出错。这类开关建议加一句 echo "NUMA_BIND=$NUMA_BIND" 自检。
坑 4:--tensor-split layer 导致三卡负载不均 ⭐⭐⭐⭐
27B 三卡实测显存 21.2 / 21.0 / 25.4 GB,最后一张卡明显更重。
原因是 tensor-split 配成了layer 这种不均分比例,加上 --main-gpu 0 的主卡要承担更多计算与调度 buffer。
✅ 想让三卡均分,应该自己进行调整,比如:
bash
--tensor-split "4,4,1"
--main-gpu 0
📌 优化方向:显存最重的那张卡就是整机的瓶颈卡------它决定了你还能开多大上下文、多大 batch。均分之后往往能再挤出几个 GB。
坑 5:80 端口冲突(见 §5.3)⭐⭐⭐
绝不盲目停别人的 nginx 。先 ps -ef | grep 'nginx: master' 和 ss -tlnp 确认归属。
坑 6:流式输出被缓冲 ⭐⭐⭐
proxy_buffering 默认为 on,SSE 流式返回会被攒成一坨。网关层必须 proxy_buffering off。
八、附录:可直接复用的启停脚本
A. 14B 单卡启停
启动脚本 3llama_start_Qwen3-14B.sh:
bash
#!/bin/bash
set -euo pipefail

LLAMA_SERVER="~/data_share/pkgs/llama-cpp/build/bin/llama-server"
MODEL_PATH="~/data_share/models/Qwen3-14B-Q8_0-GGUF/Qwen3-14B-Q8_0.gguf"
PORT=60081
GPUS="6"
LOG_FILE="~/data_share/logs/llama_qwen3_14b_q8.log"
PID_FILE="~/data_share/logs/llama_qwen3_14b_q8.pid"
API_KEY="sk-xxxxxxxx"

# --- 前置检查:PID / 端口 / 文件 / GPU 可用性 ---
if [ -f "$PID_FILE" ]; then
    OLD_PID=$(cat "$PID_FILE" 2>/dev/null || echo "")
    if [ -n "$OLD_PID" ] && kill -0 "$OLD_PID" 2>/dev/null; then
        echo "[ERROR] 服务已在运行 (PID: $OLD_PID)"; exit 1
    fi
    rm -f "$PID_FILE"
fi
[ ! -f "$MODEL_PATH" ] && { echo "[ERROR] 模型不存在"; exit 1; }
if ss -tlnp 2>/dev/null | grep -q ":$PORT "; then
    echo "[ERROR] 端口 $PORT 已被占用"; exit 1
fi

export CUDA_VISIBLE_DEVICES="$GPUS"

ARGS=(
    --model "$MODEL_PATH"
    --alias "Qwen3-14B"
    -ngl 99
    -c 131072
    --batch-size 1024 --ubatch-size 512
    --parallel 4
    --flash-attn on
    --cache-type-k q8_0 --cache-type-v q8_0
    --kv-unified
    --jinja
    --temp 0.7 --top-p 0.9 --top-k 20
    -t 12
    --host 0.0.0.0 --port "$PORT"
    --api-key "$API_KEY"
)

nohup "$LLAMA_SERVER" "${ARGS[@]}" >> "$LOG_FILE" 2>&1 &
echo $! > "$PID_FILE"
bash
#!/bin/bash
# ============================================
# llama.cpp 停止脚本 - Qwen3-14B-Q8_0
# 优雅终止 + 超时强杀 + 残留清理
# ============================================
set -euo pipefail

LOG_DIR="${LLAMA_LOG_DIR:-/data/logs}"
PID_FILE="$LOG_DIR/llama_qwen3_14b_q8.pid"

RED='\033[0;31m'; GREEN='\033[0;32m'; YELLOW='\033[1;33m'; NC='\033[0m'
log_info()  { echo -e "${GREEN}[INFO]${NC} $1"; }
log_warn()  { echo -e "${YELLOW}[WARN]${NC} $1"; }
log_error() { echo -e "${RED}[ERROR]${NC} $1"; }

if [ ! -f "$PID_FILE" ]; then
    log_warn "PID 文件不存在 ($PID_FILE),可能服务未运行"
    PIDS=$(pgrep -f "llama-server.*Qwen3-14B" 2>/dev/null || true)
    if [ -n "$PIDS" ]; then
        log_info "发现残留进程: $PIDS"
        kill $PIDS 2>/dev/null || true
        sleep 2
        kill -9 $PIDS 2>/dev/null || true
        log_info "已清理残留进程"
    fi
    exit 0
fi

PID=$(cat "$PID_FILE")

if ! kill -0 "$PID" 2>/dev/null; then
    log_warn "PID $PID 对应的进程不存在,可能已退出"
    rm -f "$PID_FILE"
    exit 0
fi

log_info "正在停止服务 (PID: $PID)..."
kill "$PID" 2>/dev/null || true

for i in $(seq 1 10); do
    if ! kill -0 "$PID" 2>/dev/null; then
        log_info "服务已正常退出 (耗时 ${i}s)"
        rm -f "$PID_FILE"
        exit 0
    fi
    sleep 1
done

log_warn "优雅终止超时,强制杀死进程..."
kill -9 "$PID" 2>/dev/null || true
sleep 1

if ! kill -0 "$PID" 2>/dev/null; then
    log_info "已强制停止服务"
    rm -f "$PID_FILE"
else
    log_error "无法停止进程,请手动处理"
    exit 1
fi

echo ""
log_info "当前 GPU 显存使用情况:"
nvidia-smi --query-gpu=index,memory.used --format=csv | tail -n +2 | grep -E "^[0-9]"
停止脚本 4llama_stop_Qwen3-14B.sh 的核心思路:优雅终止 → 超时强杀 → 清残留 → 校验显存释放
bash
kill "$PID" 2>/dev/null || true
for i in $(seq 1 10); do
    kill -0 "$PID" 2>/dev/null || { rm -f "$PID_FILE"; exit 0; }
    sleep 1
done
kill -9 "$PID" 2>/dev/null || true

# 兜底:按 alias 清理残留进程
pgrep -f "llama-server.*Qwen3-14B" | xargs -r kill -9 2>/dev/null || true

# 校验显存是否真的释放
nvidia-smi --query-gpu=index,memory.used --format=csv
bash
#!/bin/bash
# ============================================
# llama.cpp 停止脚本 - Qwen3-14B-Q8_0
# 优雅终止 + 超时强杀 + 残留清理
# ============================================
set -euo pipefail

LOG_DIR="${LLAMA_LOG_DIR:-/data/logs}"
PID_FILE="$LOG_DIR/llama_qwen3_14b_q8.pid"

RED='\033[0;31m'; GREEN='\033[0;32m'; YELLOW='\033[1;33m'; NC='\033[0m'
log_info()  { echo -e "${GREEN}[INFO]${NC} $1"; }
log_warn()  { echo -e "${YELLOW}[WARN]${NC} $1"; }
log_error() { echo -e "${RED}[ERROR]${NC} $1"; }

if [ ! -f "$PID_FILE" ]; then
    log_warn "PID 文件不存在 ($PID_FILE),可能服务未运行"
    PIDS=$(pgrep -f "llama-server.*Qwen3-14B" 2>/dev/null || true)
    if [ -n "$PIDS" ]; then
        log_info "发现残留进程: $PIDS"
        kill $PIDS 2>/dev/null || true
        sleep 2
        kill -9 $PIDS 2>/dev/null || true
        log_info "已清理残留进程"
    fi
    exit 0
fi

PID=$(cat "$PID_FILE")

if ! kill -0 "$PID" 2>/dev/null; then
    log_warn "PID $PID 对应的进程不存在,可能已退出"
    rm -f "$PID_FILE"
    exit 0
fi

log_info "正在停止服务 (PID: $PID)..."
kill "$PID" 2>/dev/null || true

for i in $(seq 1 10); do
    if ! kill -0 "$PID" 2>/dev/null; then
        log_info "服务已正常退出 (耗时 ${i}s)"
        rm -f "$PID_FILE"
        exit 0
    fi
    sleep 1
done

log_warn "优雅终止超时,强制杀死进程..."
kill -9 "$PID" 2>/dev/null || true
sleep 1

if ! kill -0 "$PID" 2>/dev/null; then
    log_info "已强制停止服务"
    rm -f "$PID_FILE"
else
    log_error "无法停止进程,请手动处理"
    exit 1
fi

echo ""
log_info "当前 GPU 显存使用情况:"
nvidia-smi --query-gpu=index,memory.used --format=csv | tail -n +2 | grep -E "^[0-9]"
B. 27B 三卡(IQ4_XS + MTP)关键参数
bash
GPUS="4,5,7"
export CUDA_VISIBLE_DEVICES="$GPUS"

ARGS=(
    --model ~/data_share/models/Qwen3.8-27B-TURBO-Fable/...IQ4_XS.gguf
    --alias "Qwen3.8-27B-Turbo"
    --tensor-split "1,1,1"        # ★ 均分,别写 4,4,1
    --main-gpu 0
    -ngl 200
    -c 262144                     # ⚠️ 会被 n_ctx_train cap,先查模型上限
    --batch-size 4096 --ubatch-size 4096
    --parallel 2
    --flash-attn on
    --cache-type-k q8_0 --cache-type-v q8_0
    --kv-unified
    --jinja
    --spec-type draft-mtp         # ★ 单文件内嵌 MTP 头,无需 draft 模型
    --spec-draft-n-max 3
    --spec-draft-p-min 0.75
    -t 24
    --host 0.0.0.0 --port 60080
    --api-key "sk-xxxxxxxx"
)
启动脚本完整:
bash
#!/bin/bash
# ============================================================================
# 脚本名称: 5a-llama_start_Qwen3.8-TURBO-Fable-IQ4XS.sh
# 功能:     启动 Qwen3.8-27B-TURBO-Fable 模型(IQ4_XS 量化,MTP 推测解码)
# ============================================================================
set -euo pipefail

# ------------------------------ 配置区(敏感信息已从环境变量读取) ------------------------------
LLAMA_SERVER="${LLAMA_SERVER_BIN:-/opt/llama-cpp/build/bin/llama-server}"
MODEL_DIR="${QWEN38_MODEL_DIR:-/data/models/Qwen3.8-27B-TURBO-Fable}"
MODEL_PATH="${QWEN38_MODEL_PATH:-$MODEL_DIR/Qwen3.8-27B-TurboFCFusion-IQ4_XS.gguf}"
MMPROJ_PATH="$MODEL_DIR/mmproj-F16.gguf"

PORT="${QWEN38_PORT:-60080}"
API_KEY="${LLAMA_API_KEY:?请设置环境变量 LLAMA_API_KEY}"
GPUS="${QWEN38_GPUS:-4,5,7}"

LOG_DIR="${LLAMA_LOG_DIR:-/data/logs}"
LOG_FILE="$LOG_DIR/llama_qwen38_turbo_iq4xs_mtp.log"
PID_FILE="$LOG_DIR/llama_qwen38_turbo_iq4xs_mtp.pid"

NGL=200
CTX_SIZE=262144
BATCH_SIZE=4096
UBATCH_SIZE=4096
PARALLEL=2
TEMP=0.6
TOP_P=0.8
TOP_K=20
MIN_P=0.0
CPU_THREADS=24
CACHE_K="q8_0"
CACHE_V="q8_0"

ENABLE_MTP=true
SPEC_N_MAX=3
SPEC_P_MIN=0.75

REASONING_ENABLE=true
REASONING_EFFORT="medium"
PRESERVE_THINK=true

ENABLE_MMPROJ=false   # ✅ 已修正原脚本 ture → false(无 mmproj 时默认关闭)
NUMA_BIND=false       # ✅ 已修正原脚本 ture → false(按需开启)
# ------------------------------ 配置区结束 ------------------------------

RED='\033[0;31m'; GREEN='\033[0;32m'; YELLOW='\033[1;33m'; NC='\033[0m'
log_info()  { echo -e "${GREEN}[INFO]${NC} $1"; }
log_warn()  { echo -e "${YELLOW}[WARN]${NC} $1"; }
log_error() { echo -e "${RED}[ERROR]${NC} $1"; }

# ===== 前置检查 =====
if [ -f "$PID_FILE" ]; then
    OLD_PID=$(cat "$PID_FILE" 2>/dev/null || echo "")
    if [ -n "$OLD_PID" ] && kill -0 "$OLD_PID" 2>/dev/null; then
        log_error "服务已在运行 (PID: $OLD_PID, 端口: $PORT)"
        exit 1
    else
        log_warn "发现残留 PID 文件,清理中..."
        rm -f "$PID_FILE"
    fi
fi

[ ! -f "$LLAMA_SERVER" ] && { log_error "llama-server 未找到: $LLAMA_SERVER"; exit 1; }
[ ! -f "$MODEL_PATH" ] && { log_error "主模型文件不存在: $MODEL_PATH"; exit 1; }

if [ "$ENABLE_MMPROJ" = true ] && [ ! -f "$MMPROJ_PATH" ]; then
    log_warn "mmproj 文件不存在 ($MMPROJ_PATH),自动关闭多模态支持"
    ENABLE_MMPROJ=false
fi

GPU_LIST=()
if [[ "$GPUS" == *","* ]]; then
    IFS=',' read -ra GPU_LIST <<< "$GPUS"
elif [[ "$GPUS" == *" "* ]]; then
    GPU_LIST=($GPUS)
else
    for ((i=0;i<${#GPUS};i++)); do GPU_LIST+=("${GPUS:$i:1}"); done
fi

for gpu_id in "${GPU_LIST[@]}"; do
    gpu_id=$(echo "$gpu_id" | tr -d ' ')
    [ -z "$gpu_id" ] && continue
    if ! nvidia-smi -i "$gpu_id" > /dev/null 2>&1; then
        log_error "GPU $gpu_id 不可用"
        exit 1
    fi
done

if ss -tlnp 2>/dev/null | grep -q ":$PORT "; then
    log_error "端口 $PORT 已被占用"
    ss -tlnp | grep ":$PORT "
    exit 1
fi

# ===== 环境准备 =====
export CUDA_VISIBLE_DEVICES="$GPUS"
export PYTHONNOUSERSITE=1
mkdir -p "$LOG_DIR"
if [ -f "$LOG_FILE" ]; then
    BACKUP="$LOG_DIR/$(basename "$LOG_FILE").$(date +%Y%m%d_%H%M%S).bak"
    mv "$LOG_FILE" "$BACKUP"
    log_info "旧日志已备份: $BACKUP"
fi
echo "[$(date '+%Y-%m-%d %H:%M:%S')] Starting llama-server (TURBO-Fable IQ4_XS MTP)..." > "$LOG_FILE"

# ===== 构建启动参数 =====
ARGS=(
    --model "$MODEL_PATH"
    --alias "Qwen3.8-27B-Turbo"
    --tensor-split "4,4,1"
    --main-gpu 0
    -ngl "$NGL"
    -c "$CTX_SIZE"
    --batch-size "$BATCH_SIZE"
    --ubatch-size "$UBATCH_SIZE"
    --parallel "$PARALLEL"
    --flash-attn on
    --cache-type-k "$CACHE_K"
    --cache-type-v "$CACHE_V"
    --kv-unified
    --jinja
    --temp "$TEMP"
    --top-p "$TOP_P"
    --top-k "$TOP_K"
    --min-p "$MIN_P"
    -t "$CPU_THREADS"
    --host 0.0.0.0
    --port "$PORT"
    --api-key "$API_KEY"
)

if [ "$ENABLE_MMPROJ" = true ]; then
    ARGS+=(--mmproj "$MMPROJ_PATH")
    log_info "多模态已启用: $MMPROJ_PATH"
fi

HELP_TXT="$("$LLAMA_SERVER" --help 2>&1)" || HELP_TXT=""

if [ "$REASONING_ENABLE" = true ]; then
    if echo "$HELP_TXT" | grep -q -- '--reasoning '; then
        ARGS+=(--reasoning on)
        log_info "思考已启用(使用 --reasoning on)"
        echo "$HELP_TXT" | grep -q -- '--reasoning-effort' && ARGS+=(--reasoning-effort "$REASONING_EFFORT")
        echo "$HELP_TXT" | grep -q -- '--reasoning-preserve' && ARGS+=(--reasoning-preserve)
    else
        KW="{\"enable_thinking\":true,\"reasoning_effort\":\"$REASONING_EFFORT\""
        [ "$PRESERVE_THINK" = true ] && KW="$KW,\"preserve_thinking\":true"
        KW="$KW}"
        ARGS+=(--chat-template-kwargs "$KW")
        log_info "思考已启用(使用 --chat-template-kwargs,effort=$REASONING_EFFORT)"
    fi
else
    if echo "$HELP_TXT" | grep -q -- '--reasoning '; then
        ARGS+=(--reasoning off)
    else
        ARGS+=(--chat-template-kwargs '{"enable_thinking":false}')
    fi
    log_info "思考已关闭"
fi

if [ "$ENABLE_MTP" = true ]; then
    if echo "$HELP_TXT" | grep -q -- '--spec-type'; then
        ARGS+=(
            --spec-type draft-mtp
            --spec-draft-n-max "$SPEC_N_MAX"
            --spec-draft-p-min "$SPEC_P_MIN"
        )
        log_info "MTP 推测解码已启用 (n-max=$SPEC_N_MAX)"
    else
        log_warn "二进制不支持 --spec-type,关闭 MTP"
        ENABLE_MTP=false
    fi
fi

# ===== 启动进程 =====
log_info "启动 llama-server..."
echo "       主模型: $(basename "$MODEL_PATH")"
echo "       GPU:    $GPUS (Layer Split)"
echo "       上下文: ${CTX_SIZE}"
echo "       端口:   $PORT"

NUMA_CMD=""
if [ "$NUMA_BIND" = true ] && command -v numactl &> /dev/null; then
    NUMA_CMD="numactl --cpunodebind=1 --membind=1"
    log_info "NUMA 亲和性绑定已启用 (node 1)"
fi

$NUMA_CMD "$LLAMA_SERVER" "${ARGS[@]}" >> "$LOG_FILE" 2>&1 &
PID=$!
echo $PID > "$PID_FILE"
log_info "进程已启动 (PID: $PID)"

# ===== 等待就绪 =====
log_info "等待服务就绪 (最多 120 秒)..."
READY=false
for i in $(seq 1 120); do
    if ! kill -0 "$PID" 2>/dev/null; then
        log_error "进程已异常退出,请检查日志"
        tail -n 30 "$LOG_FILE"
        rm -f "$PID_FILE"
        exit 1
    fi
    if ss -tlnp 2>/dev/null | grep -q ":$PORT "; then
        READY=true; break
    fi
    if grep -q "listening on http" "$LOG_FILE" 2>/dev/null; then
        READY=true; break
    fi
    sleep 1
done

if [ "$READY" = true ]; then
    echo ""; echo "========================================"
    log_info "✅ 服务启动成功"
    echo "========================================"
    echo "  API 地址: http://localhost:$PORT"
    echo "  模型别名: Qwen3.8-27B-Turbo"
    echo "  PID:      $PID"
    echo "  日志:     $LOG_FILE"
    echo "========================================"
else
    log_error "服务启动超时,请检查日志"
    tail -n 50 "$LOG_FILE"
    rm -f "$PID_FILE"
    exit 1
fi
停止脚本完整:
bash
#!/bin/bash
# ============================================
# llama.cpp 停止脚本 - Qwen3.8-27B-TURBO-Fable-IQ4XS
# ============================================
set -euo pipefail

LOG_DIR="${LLAMA_LOG_DIR:-/data/logs}"
PID_FILE="$LOG_DIR/llama_qwen38_turbo_iq4xs_mtp.pid"
LOG_FILE="$LOG_DIR/llama_qwen38_turbo_iq4xs_mtp.log"

RED='\033[0;31m'; GREEN='\033[0;32m'; YELLOW='\033[1;33m'; NC='\033[0m'
log_info()  { echo -e "${GREEN}[INFO]${NC} $1"; }
log_warn()  { echo -e "${YELLOW}[WARN]${NC} $1"; }
log_error() { echo -e "${RED}[ERROR]${NC} $1"; }

if [ ! -f "$PID_FILE" ]; then
    log_warn "PID 文件不存在 ($PID_FILE),可能服务未运行。"
    exit 0
fi

PID=$(cat "$PID_FILE" 2>/dev/null || echo "")

if [ -z "$PID" ]; then
    log_warn "PID 文件为空,清理残留文件。"
    rm -f "$PID_FILE"
    exit 0
fi

if ! kill -0 "$PID" 2>/dev/null; then
    log_warn "进程 $PID 已不存在,清理 PID 文件。"
    rm -f "$PID_FILE"
    exit 0
fi

log_info "正在停止服务 (PID: $PID)..."
kill -QUIT "$PID" 2>/dev/null || kill -TERM "$PID" 2>/dev/null || true

WAIT_COUNT=0
while kill -0 "$PID" 2>/dev/null; do
    sleep 1
    WAIT_COUNT=$((WAIT_COUNT + 1))
    if [ $WAIT_COUNT -ge 30 ]; then
        log_warn "进程未能优雅退出,强制终止..."
        kill -9 "$PID" 2>/dev/null || true
        break
    fi
done

rm -f "$PID_FILE"
log_info "服务已停止。"
exit 0
MTP 推测解码的几个注意点:
-
只有内嵌 MTP 头 的 GGUF 才能用
--spec-type draft-mtp,普通 GGUF 加了会启动失败; -
--spec-draft-n-max越大加速潜力越高,但接受率会下降,3 是实测比较稳的值; -
启动前最好做一次能力探测:
bash"$LLAMA_SERVER" --help 2>&1 | grep -q -- '--spec-type' && echo "支持 MTP"
C. 常用运维命令
bash
# 看实时显存 / 利用率
nvidia-smi dmon -i 4,5,6,7

# 看拓扑(选卡前必看)
nvidia-smi topo -m

# 跟进日志
tail -f ~/data_share/logs/llama_qwen3_14b_q8.log

# 网关热重载
sudo /usr/local/openresty/nginx/sbin/nginx -t && sudo /usr/local/openresty/nginx/sbin/nginx -s reload
九、总结
把全文串起来,就是一台 V100 集群的部署哲学:
| 章节 | 问题 | 解法 |
|---|---|---|
| 二 | V100 32GB 选什么框架? | llama.cpp + GGUF(显存省、能开长上下文、启动快、能 CPU 混跑) |
| 三 | 32GB 怎么塞下 14B/27B? | 权重量化 + KV 量化两把斧;从官方 Q8_0 演进到 IQ4_XS + MTP |
| 四 | 为什么小请求被大请求堵死? | 根因是槽位排队 → 多实例物理隔离 + 提高 --parallel |
| 五 | 实例多了端口也多了怎么办? | OpenResty + Lua 按 model 字段路由 ,一个 /v1 地址媲美厂商 API |
📌 一句话总结 :这套方案的价值不在于"用了什么高大上的框架",而在于每一层都针对硬件约束做了务实取舍------显存不够就量化,单实例阻塞就隔离,端口太多就加网关。
后续方向
- 长上下文:Qwen3 支持 YaRN 扩到 128K,但 V100 32GB 单卡不现实,需 48GB+ 或跨卡切分;
- 高并发演进:若并发稳定超过 16,可以把其中一个实例换成 vLLM 做同机吞吐对比,验证第二章的分界线;
- 监控 :
nvidia-smi dmon+ Prometheus + Grafana,长期观察多卡利用率,找出瓶颈卡; - 动态路由:把 Lua 里的路由表搬到 Redis,支持不停机扩缩容。
参考资料
- llama.cpp 官方文档与 Router Mode 说明(ggml-org/llama.cpp)
- GGUF 量化格式文档(ggml-org/llama.cpp)
- PagedAttention 与 vLLM 内存管理机制
- OpenResty 官方安装文档(openresty.org)
- Qwen3 官方模型仓库与上下文参数说明
- Will This LLM Fit My GPU? ------ VRAM 需求估算工具
免责与提醒
- 文中所有 IP、API Key、用户名均已脱敏,请替换为你自己的。
- 魔改(TURBO / Heretic / Uncensored 类)模型偏科风险高、迭代快,生产环境请优先使用官方版本或 Unsloth 量化版 。
如果这篇对你有帮助,欢迎点赞收藏;有踩到新的坑,评论区一起交流 🙌