目录
[1 描述进程](#1 描述进程)
[1.1 查看正在运行的进程](#1.1 查看正在运行的进程)
[1.2 终止Linux进程](#1.2 终止Linux进程)
[2 创建进程](#2 创建进程)
[3 进程状态](#3 进程状态)
[3.1 运行状态](#3.1 运行状态)
[3.2 阻塞状态](#3.2 阻塞状态)
[3.3 挂起状态](#3.3 挂起状态)
[3.4 进程切换](#3.4 进程切换)
[4 进程优先级](#4 进程优先级)
[5 命令行参数和环境变量](#5 命令行参数和环境变量)
[6 进程地址空间](#6 进程地址空间)
1 描述进程
PCB(进程属性的集合) + 自己的代码和数据 = 进程(具体称呼 : Linux中为task_struct)
1.1 查看正在运行的进程
bash
ps ajx | head -1 # 查看进程列表第一行
bash
ps ajx | grep -1 && ps ajx | grep 可执行程序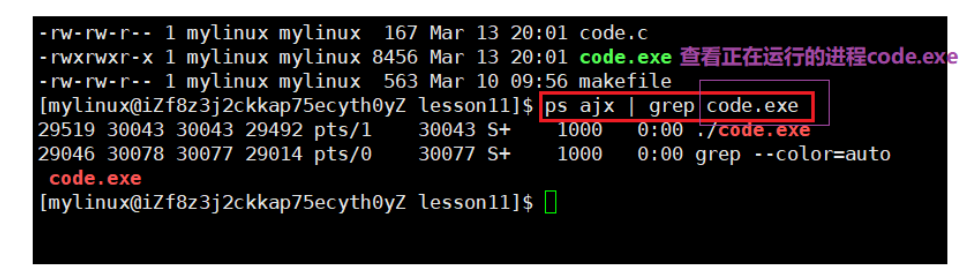
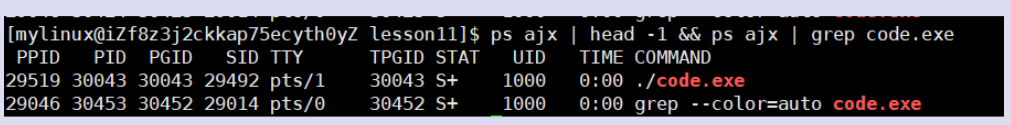
每一个进程都要有自己的唯一表示符 为 进程PID。
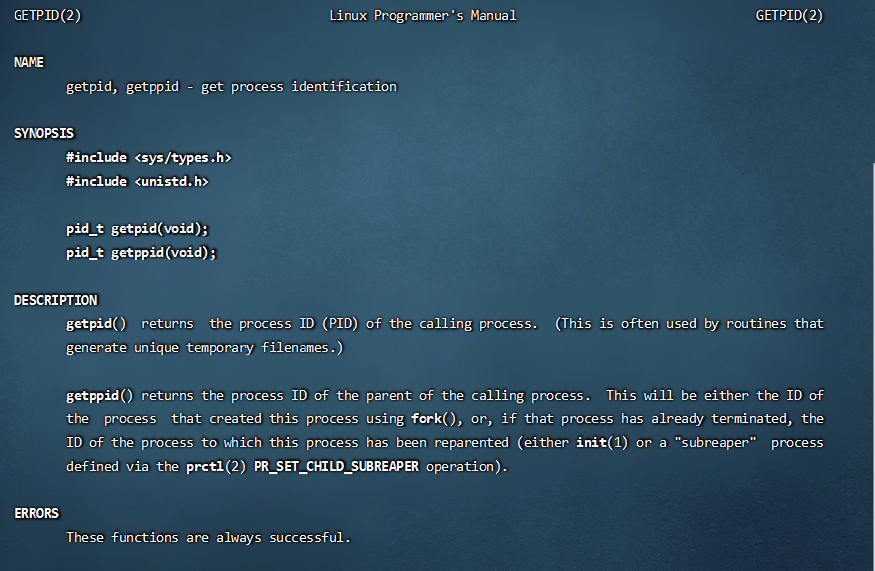
用户不能直接去访问操作系统内对应的内核数据结构的PID信息,所以需要系统调用来完成
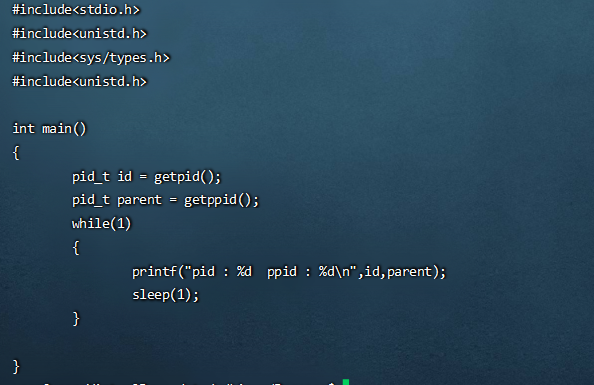
使用系统调用接口getpid()
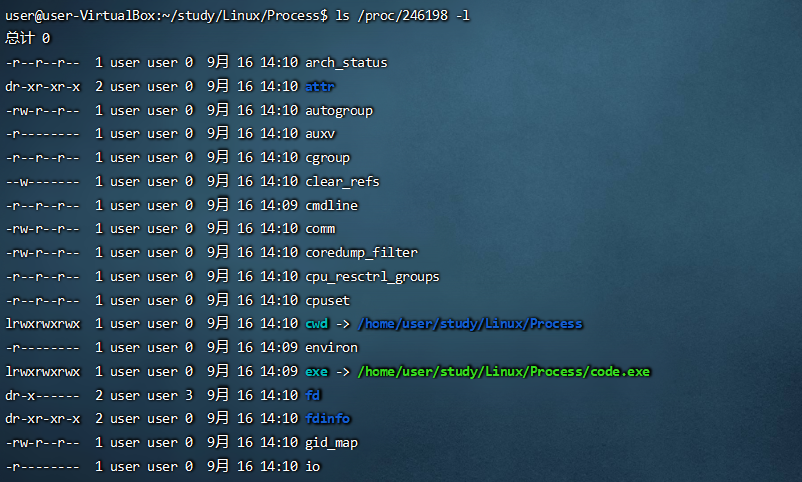
查看进程还可以通过 ls /proc系统文件夹查看,还可以指定经常pid 。
ls /proc/进程PID -l
1.2 终止Linux进程
kill -9 pid
getppid() 当前进程的父进程的pid
例如:
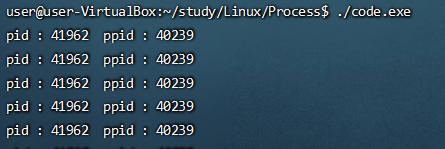
运行结果:
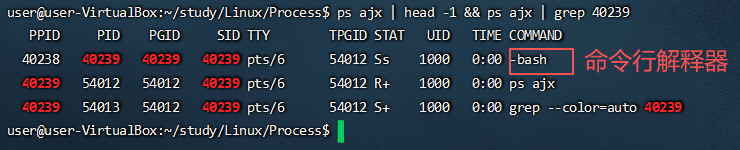
查看进程code.exe
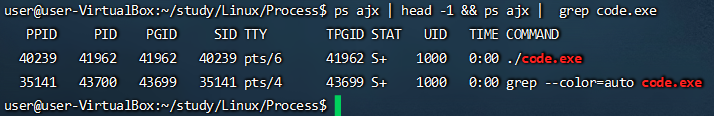
但是ppid 父进程 40239是什么?
2 创建进程
fork 创建子进程
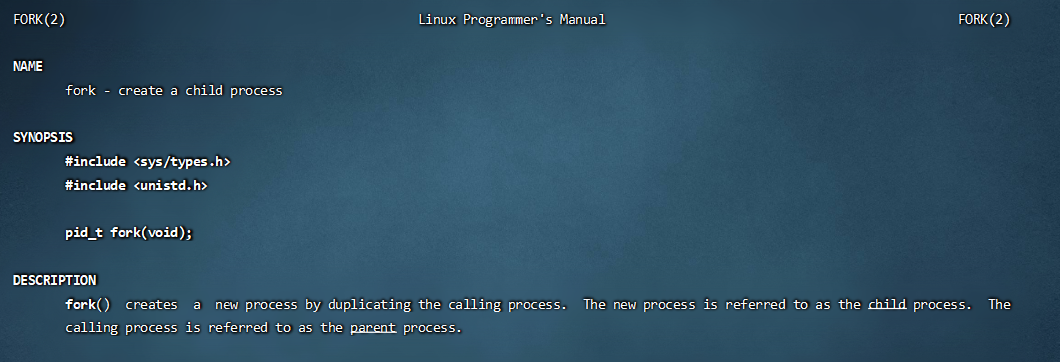
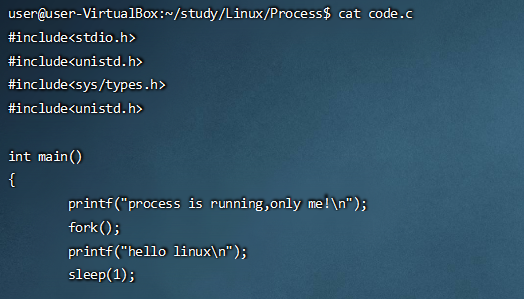
fork之后,父子代码共享
创建一个进程,本质是系统中多一个进程,就是多一个 内核task_struct,有自己的代码和数据
父进程的代码和数据是从磁盘中加载来的,默认情况继承父进程的代码和数据。
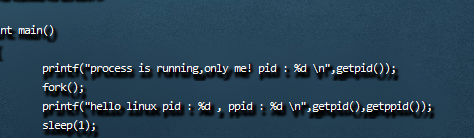
父子进程打印情况:
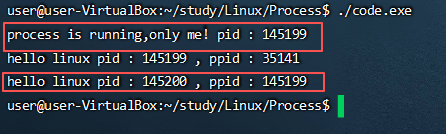
为什么要创建子进程?
让子进程执行和父进程执行不一样的代码
进程具有独立性,父子进程各自独立,原则上数据要分开。
值得注意的是,这里的fork相当于函数,拿fork的返回值;
fork()调用一次,返回两次;
父进程:fork() 返回新创建子进程的PID 大于0;
子进程:fork() 返回0 -- 这里的0是fork返回值,不是子进程自己的pid;
子进程自己的pid,要用getpid获取。
3 进程状态
简单理解为 linux中描述进程的结构体中定义的状态标志位。
|----|---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| R | 进程运行状态 |
| S+ | 休眠状态(进程在等待),可中断睡眠(S+表示在前台) |
| S | 表示在后台 |
| T | 通过kill -19 发送SIGSTOP信号 可以暂停进程; |
| t | 表示当前进程因为被追踪而暂停 |
| D | 磁盘休眠状态,linux比较特有的一种进程状态,也叫不可中断睡眠状态,在这个状态的进程通常会等待IO的结束 |
| Z | 僵尸进程,已经运行完毕,但是需要维持自己的退出信息,在自己的进程task_struct会记录自己的退出信息,未来让父进程来读取; 当进程退出并且父进程没有读取到子进程退出的返回代码时就会产生僵尸进程。 只要子进程退出,父进程还在运行,但父进程没有读取子进程状态,子进程进入Z状态 当进程一直处于僵尸状态会一直导致内存泄漏问题 如果有进程读取时,就会由Z状态变成X状态 |
| X | 死亡状态,这个状态只是一个返回状态 |
孤儿进程:如果父进程先退出,子进程就称为"孤儿进程",一般情况孤儿进程会被1号进程领养(操作系统本身)--- 保证子进程正常被回收。
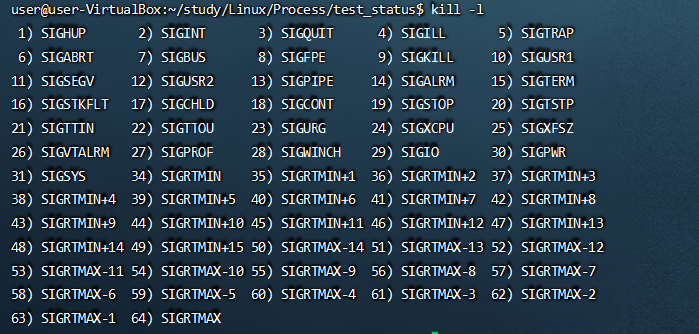
kill -l 查看kill可以使用的信号
-9 杀掉进程

-19 暂停进程

-18 恢复暂停进程

可以看到进程状态为 S+,表示进程正在等待"资源"就绪
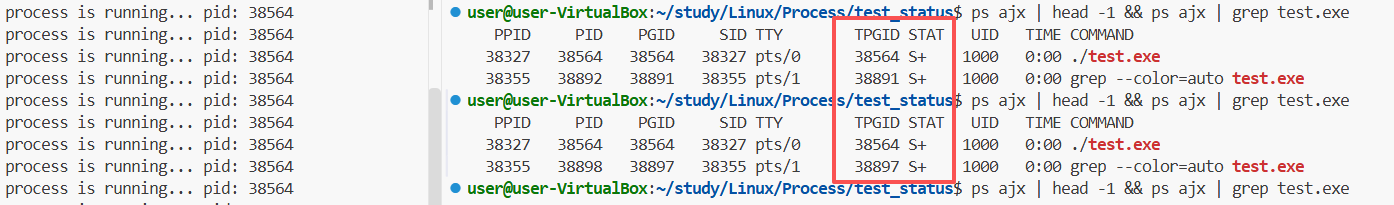
值得注意的是,直接在命令行中启动的进程,他的父进程是bash,bash会自动回收新进程的Z
3.1 运行状态
一个进程一旦持有CPU,会一直运行到这个进程结束吗?
不会,因为基于时间片进行轮转调度的,让多个进程以切换的方式进行调度,在一个时间段内同时得以推进代码(也就是并发)
对于任何时刻,都有同时有多个进程真的同时在运行。(并行)
3.2 阻塞状态
S/D 均是阻塞状态,等待,等待资源是否就绪。
不是只有cpu运行队列,各种设备也有自己的wait_queue。
cpp
// #define KEY_BOARD 1
// #define SCREEN 2

struct device
{
    int type;
    int status;
    // 其他属性....
    struct device* next;
    task_struct* wait_queue;

}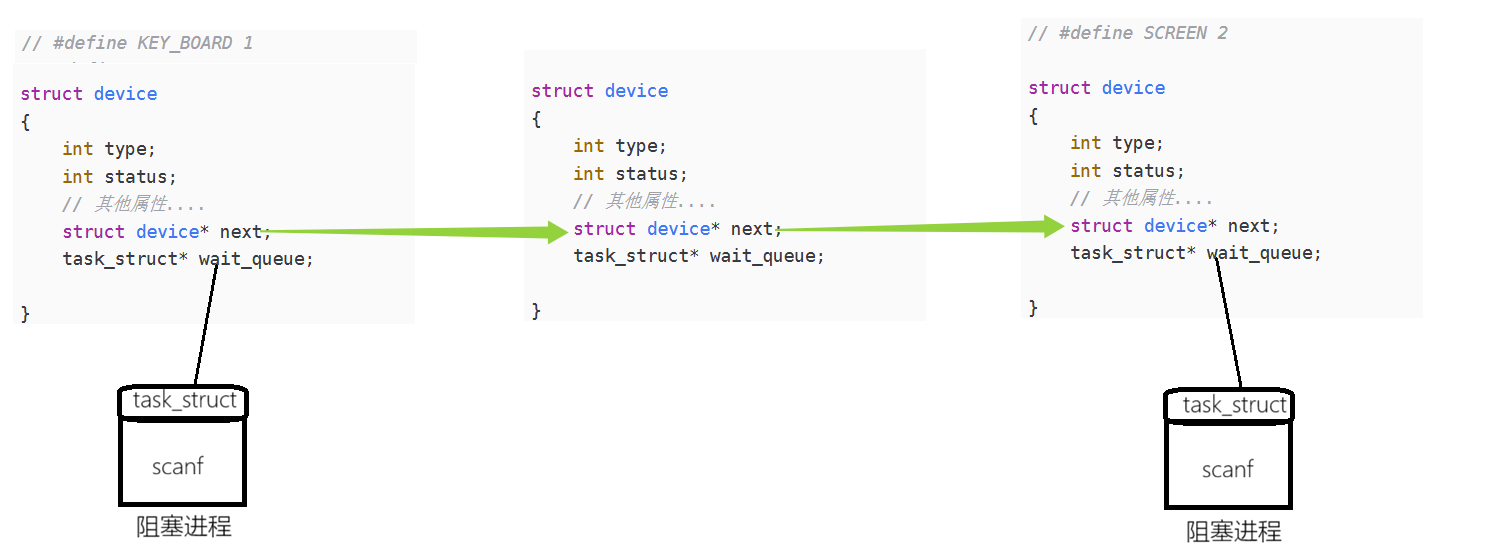
阻塞和运行时状态变化,往往伴随这被连入不同的队列中,入队列的不是进程的代码和数据而是进程的task_struct (这里完全符合 先描述再组织) 。
3.3 挂起状态
这里以阻塞挂起状态为例
当操作系统内存特别吃紧的时候,OS会把阻塞态的进程1的代码和数据给唤出到磁盘中的一个特殊swap分区,等到进程1再次需要时,再把之前进程1的代码和数据唤入到磁盘中
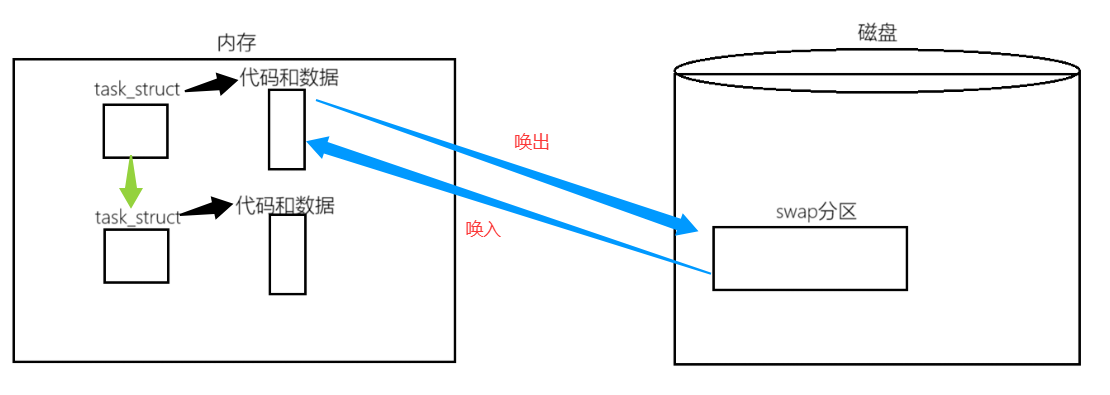 这样就会OS利用辗转腾挪的方法更合理的使用内存资源。
3.4 进程切换
CPU内部的所有的寄存器中的临时数据,叫做进程的上下文
进程在切换,最重要的一件事情是:上下文数据的保护和恢复
4 进程优先级
指定进程获取某种资源(cpu资源等)的先后顺序。
因为进程访问的资源始终都是有限的,系统和中的进程大部分情况都是比较多的。
查看系统进程 ps -la

PRI : 指的是这个进程可被执行的优先级,其值越小越早被执行
NI : 指今进程优先级的修正数据,nice值,新的优先级 = 优先级 + nice,达到对于进程优先级动态修改的过程
如何修改优先级 ?
用top命令更改已存在进程的nice:
top
r
输入进程PID
输入nice值
首先查看进程优先级
bash
ps -la | head -n1 && ps -la | grep code.exe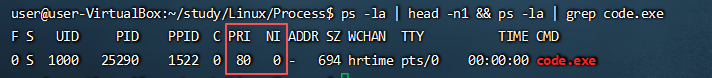
2 修改nice值
先top查看,在输入r ,输入进程PID,再输入nice值 100

但是nice值不能任意调整,范围是-20,19 公有40个数字,我们发现新的进程优先级PRI是99(已经过NI = 19 进行修正)。进程的每次调整优先级都是从 80开始的, 99 = 80 + 19 。
5 命令行参数和环境变量
命令行参数
本质:命令行参数本质就是交给我们程序的不同的选型,用来定制不同的程序功能,因为命令行中会携带很多的选项。
命令行中启动的程序,都会变成进程,其实都是bash的子进程。
环境变量
环境变量是操作系统中全局共享的配置变量,所有运行的程序、终端 Shell 都可以直接读取这些变量的值,用来统一存储系统运行所需的基础配置、路径、参数等信息。
查看所有环境变量:env
PATH: 指令命令的搜索路径
在linux中,存在一些全局的设置,告诉命令行解释器,应该去那些路径下去寻找可执行程序
打印环境变量内容(查看单个环境变量):
bash
echo $PATH
我们知道bash在执行命令的时候,需要先找到命令,PATH环境变量里面维护了一些路径,bash会去PATH里面去找。(也就是默认搜索路径)
在linux中安装和卸载软件本质就是在 /usr/bin/ 下拷贝和删除文件。
值得注意的是,PATH是内存级别的环境变量
正确给PATH添加环境变量的方式:
bash
# PATH=$PATH:自己的环境变量
PATH=$PATH:/home/user/study/Linux/Process
这里添加环境变量后,不用再加上路径,直接使用可执行程序。
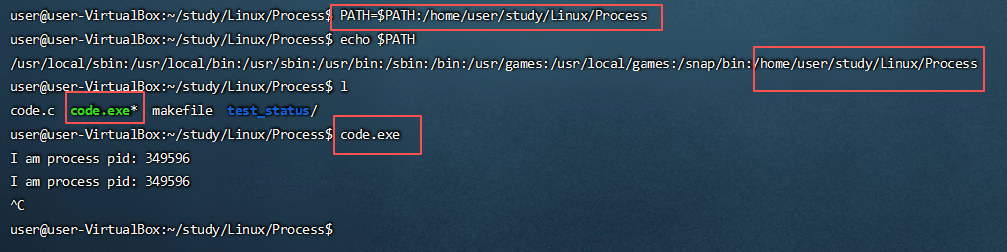
删除添加的环境变量
bash
PATH=${PATH%:你的环境变量}或者开机重启可以自动删去自己添加的环境变量。
最开始的环境变量不是在内存中,而是在系统对应的配置文件中的,在登录linux系统的时候环境变量配置文件会加载到bash进程(内存)中。如果想要永久添加环境变量,就需要修改对应的环境变量配置文件。
自己想命名定义一个环境变量
export MY_ENV=环境变量内容
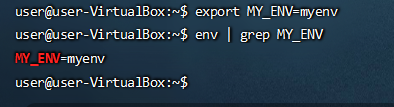
清除环境变量: unset 环境变量名
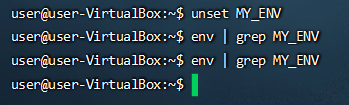
子进程也是可以拿到环境变量
在bash内部会维护一个指针数组,指向一些环境变量(每个环境变量其实是一个字符串),bash进程启动的时候,默认会给子进程形成两张表,argv\[\]命令行参数表,env\[\]环境变量表。
export 导入环境变量其实就是把环境变量字符串 添加到指针数组里面
小总结:
echo: 显示某个环境变量值
export: 设置一个新的环境变量
env: 显示所有环境变量
unset: 清除环境变量
set: 显示本地定义的shell变量和环境变量
大多数普通命令都是由bash创建子进程执行的
其中export、echo属于内建命令,不创建子进程由bash直接执行
环境变量具有系统级的全局属性,因为环境变量本身会被子进程继承下去
获取环境变量方法:
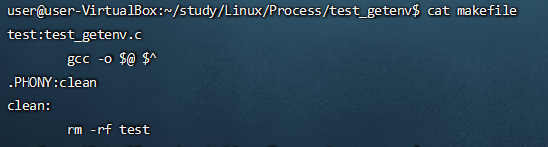
方法1 : extern char** environ; 声明全局环境变量指针
方法2 : 通过main函数参数
方法3 : 通过getenv("path") 获取指定环境变量
获取环境变量:
cpp
#include<stdio.h>
#include<string.h>
#include<unistd.h>
#include<stdlib.h>

int main(int atgc,char* argv[],char* env[])
{
        char* path = getenv("PATH");
        if(path == NULL) return 1;
        printf("path : %s\n",path);
        return 0;
}
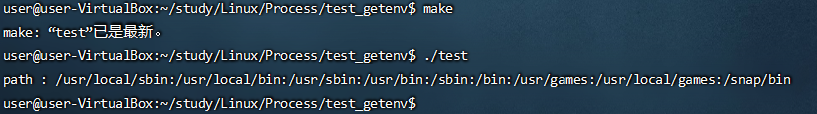
打印结果:
6 进程地址空间
我们知道进程具有独立性,父子进程也具有独立性。
地址空间的本质就是内核中的一个结构体对象,内部很多的属性都是表示start,end的范围。
对于地址空间:
-
让进程以统一的视角看待物理内存以及自己的各个区域,将无序变有序;
-
进程管理模块和内存模块进行解耦;
-
软件层拦截非法请求,对物理内存进行保护。
写时拷贝:(画图理解)
当在OS内部写入时,重新给子进程开辟空间,重新写入数据。
例如:父子进程的地址空间都一样,但是对数据进行写入的时候,子进程会重新开辟空间,重新写入数据,重新映射页表。
虚拟地址是子进程从父进程那里继承下来的,但是子进程和父进程都有各自独立的页表(默认是一致的),刚开始都是一样的,后来子进程发送写入,OS发生写时拷贝,就会出现这样的情况。
一般是OS自主完成写时拷贝(按需申请),本质:通过调整拷贝的时间顺序,达到有效节省空间的目的。
问:地址空间里面的所有字段刚开始从哪里来的呢?
当我们加载程序时,地址空间和页表里面的数据直接从可执行程序中读来,程序加载物理内存的时候,一般都会有新的物理地址,建立映射关系。
程序里面本身就有地址(对应的就是虚拟地址(也就是我们常说的逻辑地址))
创建一个进程,一般会创建PCB,创建地址空间,创建页表,在页表中构建物理地址域虚拟地址的映射。
cpp
#include<stdio.h>
#include<string.h>
#include<unistd.h>
#include<stdlib.h>

int main()
{
        pid_t id = fork();
        if(id == 0)
        {
                while(1)
                {
                        printf("I am child process,id : %d, %p\n",id,&id);
                        sleep(1);
                }
        }
        else if(id > 0)
        {
                while(1)
                {
                        printf("I am parent,id : %d, %p\n",id,&id);
                        sleep(1);
                }
        }


        return 0;
}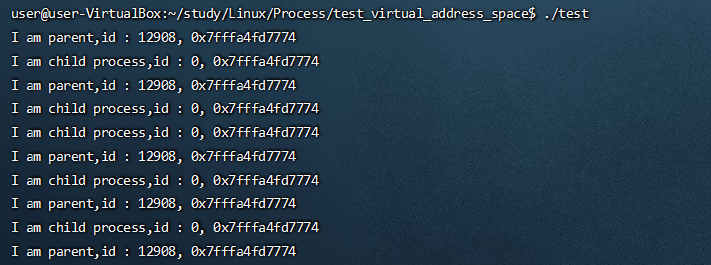
fork 创建子进程时,子进程复制父进程的虚拟地址空间,所以局部变量id虚拟地址相同,初始页表指向同一块物理内存,标记写时拷贝。 fork 返回时,父子分别对id写入不同的值,写操作触发写时拷贝,内核为子进程分配独立物理内存。 父子id变量虚拟地址一致,但物理内存相互独立,所以同一个&id,读到的值不同。
再次验证:
cpp
#include<stdio.h>
#include<string.h>
#include<unistd.h>
#include<stdlib.h>

int main()
{
        pid_t id;
        printf("before fork id : %d addr_id : %p\n",id,&id);

//      pid_t id = fork();
        id = fork();
        if(id == 0)
        {
                while(1)
                {
                        printf("I am child process,pid : %d , id : %d, %p\n",getpid(),id,&id);
                        sleep(1);
                }
        }
        else if(id > 0)
        {
                while(1)
                {
                        printf("I am parent, id : %d, %p\n",id,&id);
                        sleep(1);
                }
        }


        return 0;
}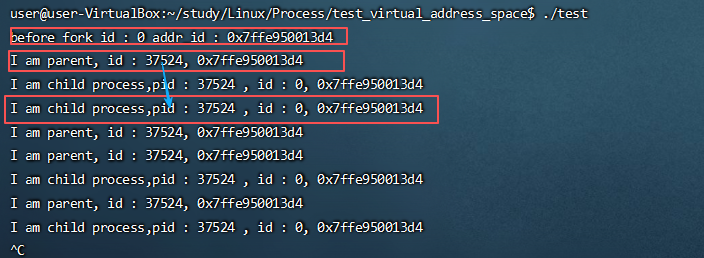
该方法验证了:fork()复制虚拟地址空间,变量虚拟地址完全相同;写时拷贝机制,物理内存相互独立,父进程中fork()返回值 = 子进程的PID,子进程fork()返回值 = 0 。
Linux内核进程真正的是如何调度的?
O(1) 调度器,下面是runqueue,CPU中的运行队列。
其中有两个队列:
**活跃队列:**时间片还没有结束的时候所有进程都按照优先级放在该队列。
nr_active: 表示运行状态的进程个数。
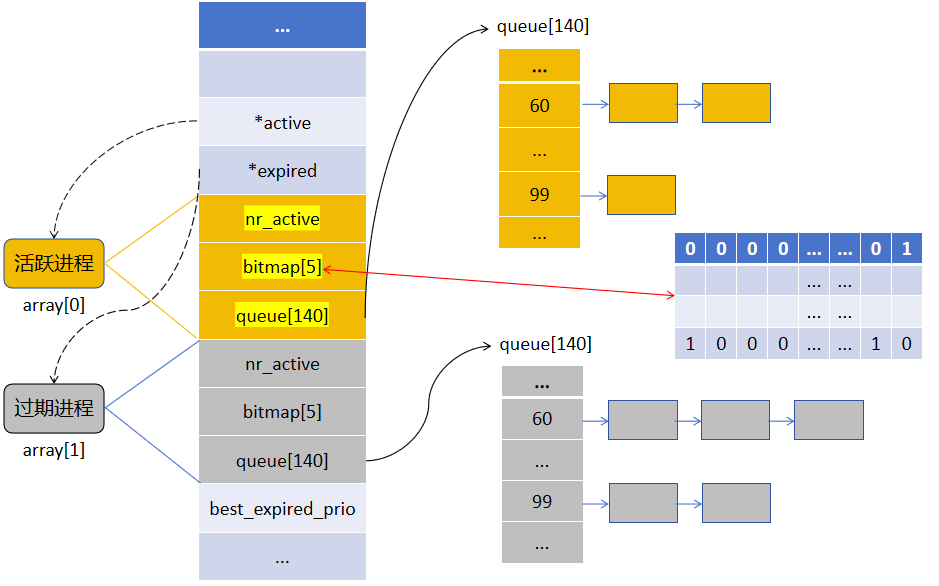
queue140: 一个元素就是一个进程队列,相同优先级的进程按照FIFO规则进行排队调度。
bitmap5: 一共140(32*5 = 140)个优先级,一共140个进程队列,为了提高查找非空队列的效率,使用bit位图表示队列是否为空,这样就可以提高查找效率。(查找的时间复杂度约为:O(1))
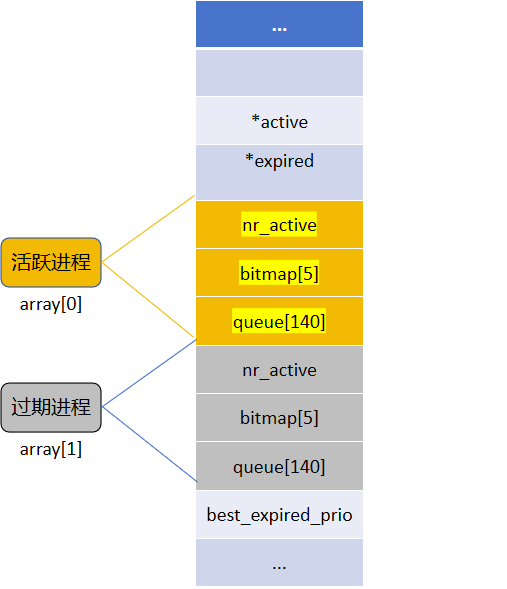
**过期队列:**过期队列上放置的进程都是时间片耗尽的进程,当活动队列上的进程都被处理完后,对过期队列的进程进行时间片重新计算。(因为linux是分时的操作系统)
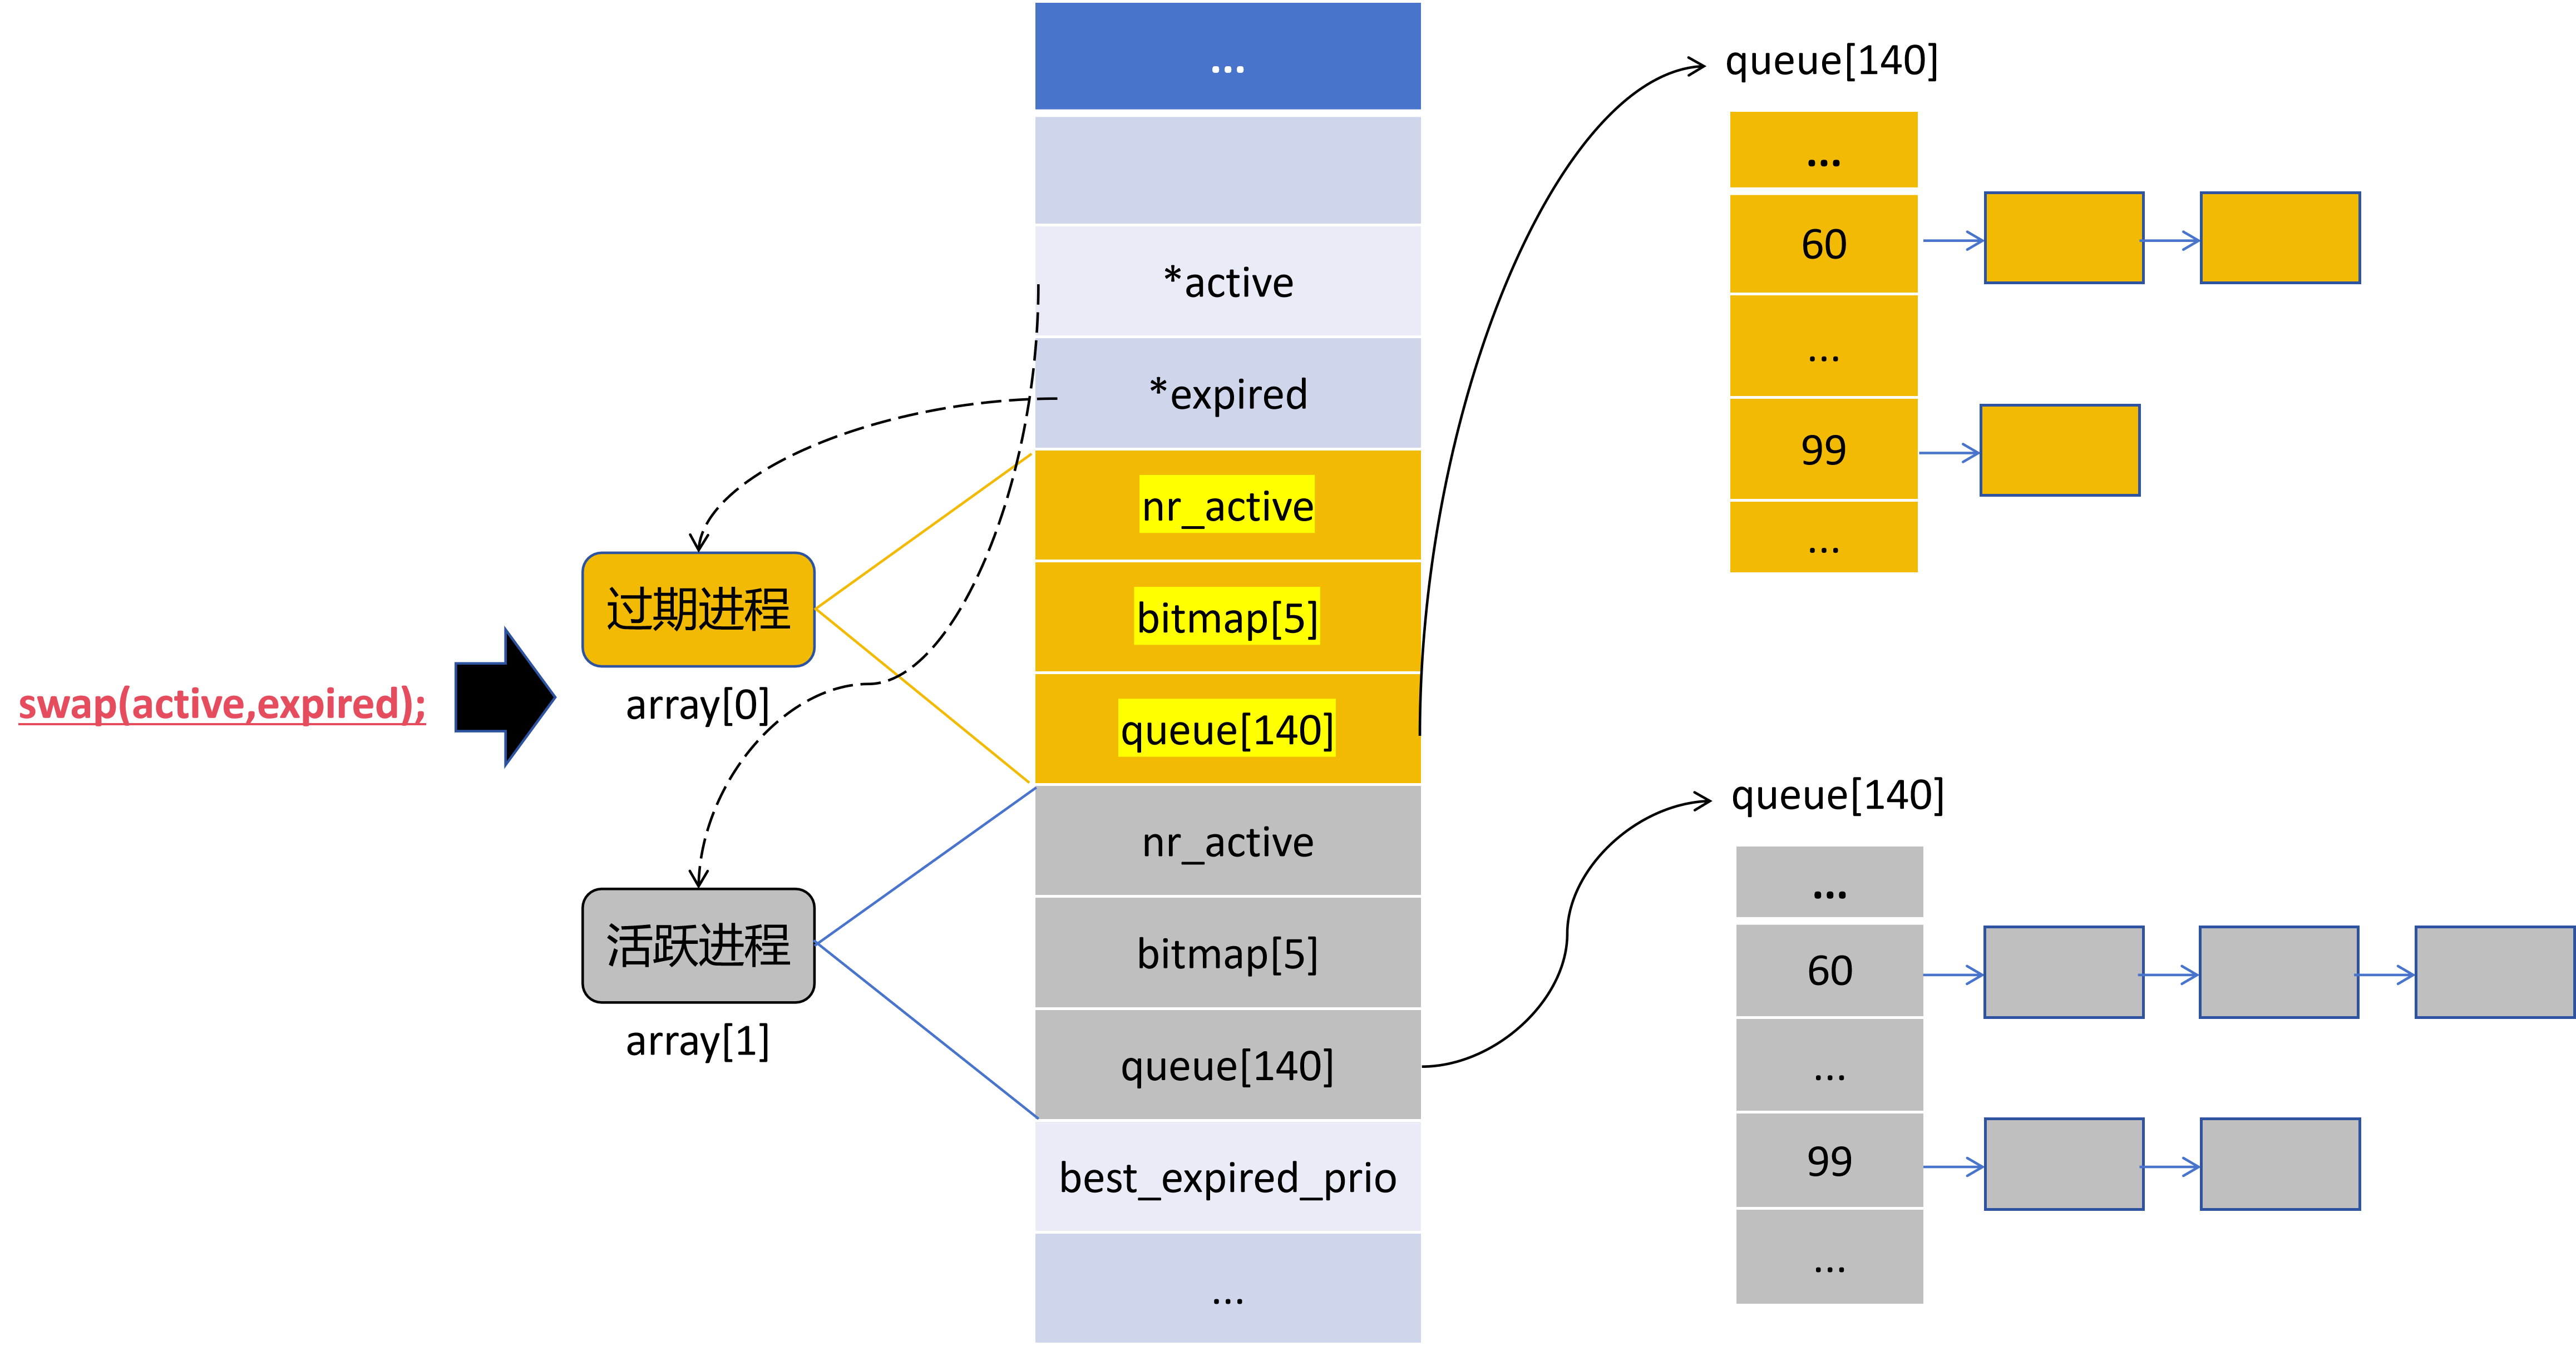
这里的大O(1)调度算法,active指针与expired指针分别指向活跃进程与过期进程,CPU找进程时,先找这两个指针,当bitmap检查数据都处理完后,queue140中的队列中的进程也执行完成后,OS只需将两个指针内容交换,这样就可以对过期队列进程进行分时调度。
两指针交换后:
这里简单介绍一下调度器演进历史
-
O (n) 调度器(Linux 2.4 及之前):每次调度遍历所有进程选最高优先级,复杂度 O (n),进程多时性能差。
-
O (1) 调度器(Linux 2.6 ~ 2.6.22):140 个优先级队列,调度时直接取最高优先级非空队列,复杂度 O (1),但交互性差、算法复杂。
-
CFS 调度器(Linux 2.6.23 ~ 6.5):基于公平性的 vruntime + 红黑树设计,交互性大幅提升,成为事实标准。
-
EEVDF 调度器(Linux 6.6+):优化延迟与公平性的平衡,替代 CFS 核心算法。
-
sched_ext(BPF 调度器,Linux 6.3+):可扩展调度类,支持用 BPF 程序自定义调度逻辑,灵活适配云原生、实时等特殊场景。