文章目录
-
- [一、配置文件 meta_config.yaml](#一、配置文件 meta_config.yaml)
-
- [1.1 tables 模块:点名要同步的表和字段](#1.1 tables 模块:点名要同步的表和字段)
- [1.2 metrics 模块:声明业务指标](#1.2 metrics 模块:声明业务指标)
- [1.3 meta_config.py 类型定义](#1.3 meta_config.py 类型定义)
- [1.4 生成 MetaConfig 对象](#1.4 生成 MetaConfig 对象)
- [二、创建 ORM 实体类](#二、创建 ORM 实体类)
-
- [2.1 什么是 ORM](#2.1 什么是 ORM)
- [2.2 SQLAlchemy 2.0 的新语法](#2.2 SQLAlchemy 2.0 的新语法)
-
- [2.2.1 DeclarativeBase 基类](#2.2.1 DeclarativeBase 基类)
- [2.2.2 tablename 指定表名](#2.2.2 tablename 指定表名)
- [2.2.3 Mapped 和 mapped_column](#2.2.3 Mapped 和 mapped_column)
- [2.2.4 常用列类型](#2.2.4 常用列类型)
- [2.3 四个实体类](#2.3 四个实体类)
- [三、Entity 层,业务实体](#三、Entity 层,业务实体)
-
- [3.1 为啥还要再来一套](#3.1 为啥还要再来一套)
- [3.2 几个业务实体](#3.2 几个业务实体)
-
- [3.2.1 TableInfo](#3.2.1 TableInfo)
- [3.2.2 ColumnInfo](#3.2.2 ColumnInfo)
- [3.2.3 MetricInfo](#3.2.3 MetricInfo)
- [3.2.4 ColumnMetric](#3.2.4 ColumnMetric)
- [3.2.5 ValueInfo](#3.2.5 ValueInfo)
- [3.3 两套实体对比](#3.3 两套实体对比)
- [四、Mapper 层,翻译官](#四、Mapper 层,翻译官)
-
- [4.1 Mapper 干啥](#4.1 Mapper 干啥)
-
- [4.1.1 TableInfoMapper](#4.1.1 TableInfoMapper)
- [4.1.2 ColumnInfoMapper](#4.1.2 ColumnInfoMapper)
- [4.1.3 MetricInfoMapper 和 ColumnMetricMapper](#4.1.3 MetricInfoMapper 和 ColumnMetricMapper)
- [五、Repository 层,数据访问层](#五、Repository 层,数据访问层)
-
- [5.1 Repository 干啥](#5.1 Repository 干啥)
- [5.2 五个 Repository 的分工](#5.2 五个 Repository 的分工)
- [5.3 MetaMySQLRepository](#5.3 MetaMySQLRepository)
- [5.4 DWMySQLRepository,只读取数仓](#5.4 DWMySQLRepository,只读取数仓)
- [5.5 ColumnQdrantRepository](#5.5 ColumnQdrantRepository)
- [5.6 MetricQdrantRepository](#5.6 MetricQdrantRepository)
- [5.7 ValueESRepository](#5.7 ValueESRepository)
- [六、Service 层,总指挥](#六、Service 层,总指挥)
-
- [6.1 入口脚本](#6.1 入口脚本)
- [6.2 MetaKnowledgeService](#6.2 MetaKnowledgeService)
-
- [6.2.1 构造函数,依赖注入](#6.2.1 构造函数,依赖注入)
- [6.2.2 build 方法,调度逻辑](#6.2.2 build 方法,调度逻辑)
- [6.2.3 _save_tables_to_meta_db](#6.2.3 _save_tables_to_meta_db)
- [6.2.4 _save_column_info_to_qdrant](#6.2.4 _save_column_info_to_qdrant)
- [6.2.5 _save_value_info_to_es](#6.2.5 _save_value_info_to_es)
- [6.2.6 _save_metrics_to_meta_db](#6.2.6 _save_metrics_to_meta_db)
- [6.2.7 _save_metric_info_to_qdrant](#6.2.7 _save_metric_info_to_qdrant)
- [6.3 最终落地产物](#6.3 最终落地产物)
P.S. 无意间发现了一个巨牛的人工智能教程,非常通俗易懂,对AI感兴趣的朋友强烈推荐去看看, 传送门https://blog.csdn.net/HHX_01
前面的文章把连接都打通了,客户端管理类跑起来像模像样。结果一转头看数据库------MySQL 里四张表是空的,Qdrant 里连个影子都没有,ES 更是清净得能听见回声。
这就像你租了个写字楼,装修豪华,工位齐全,然后发现公司里一个人都没有。你对着空工位喊"谁来写个 SQL",回音都比 AI 答得快。
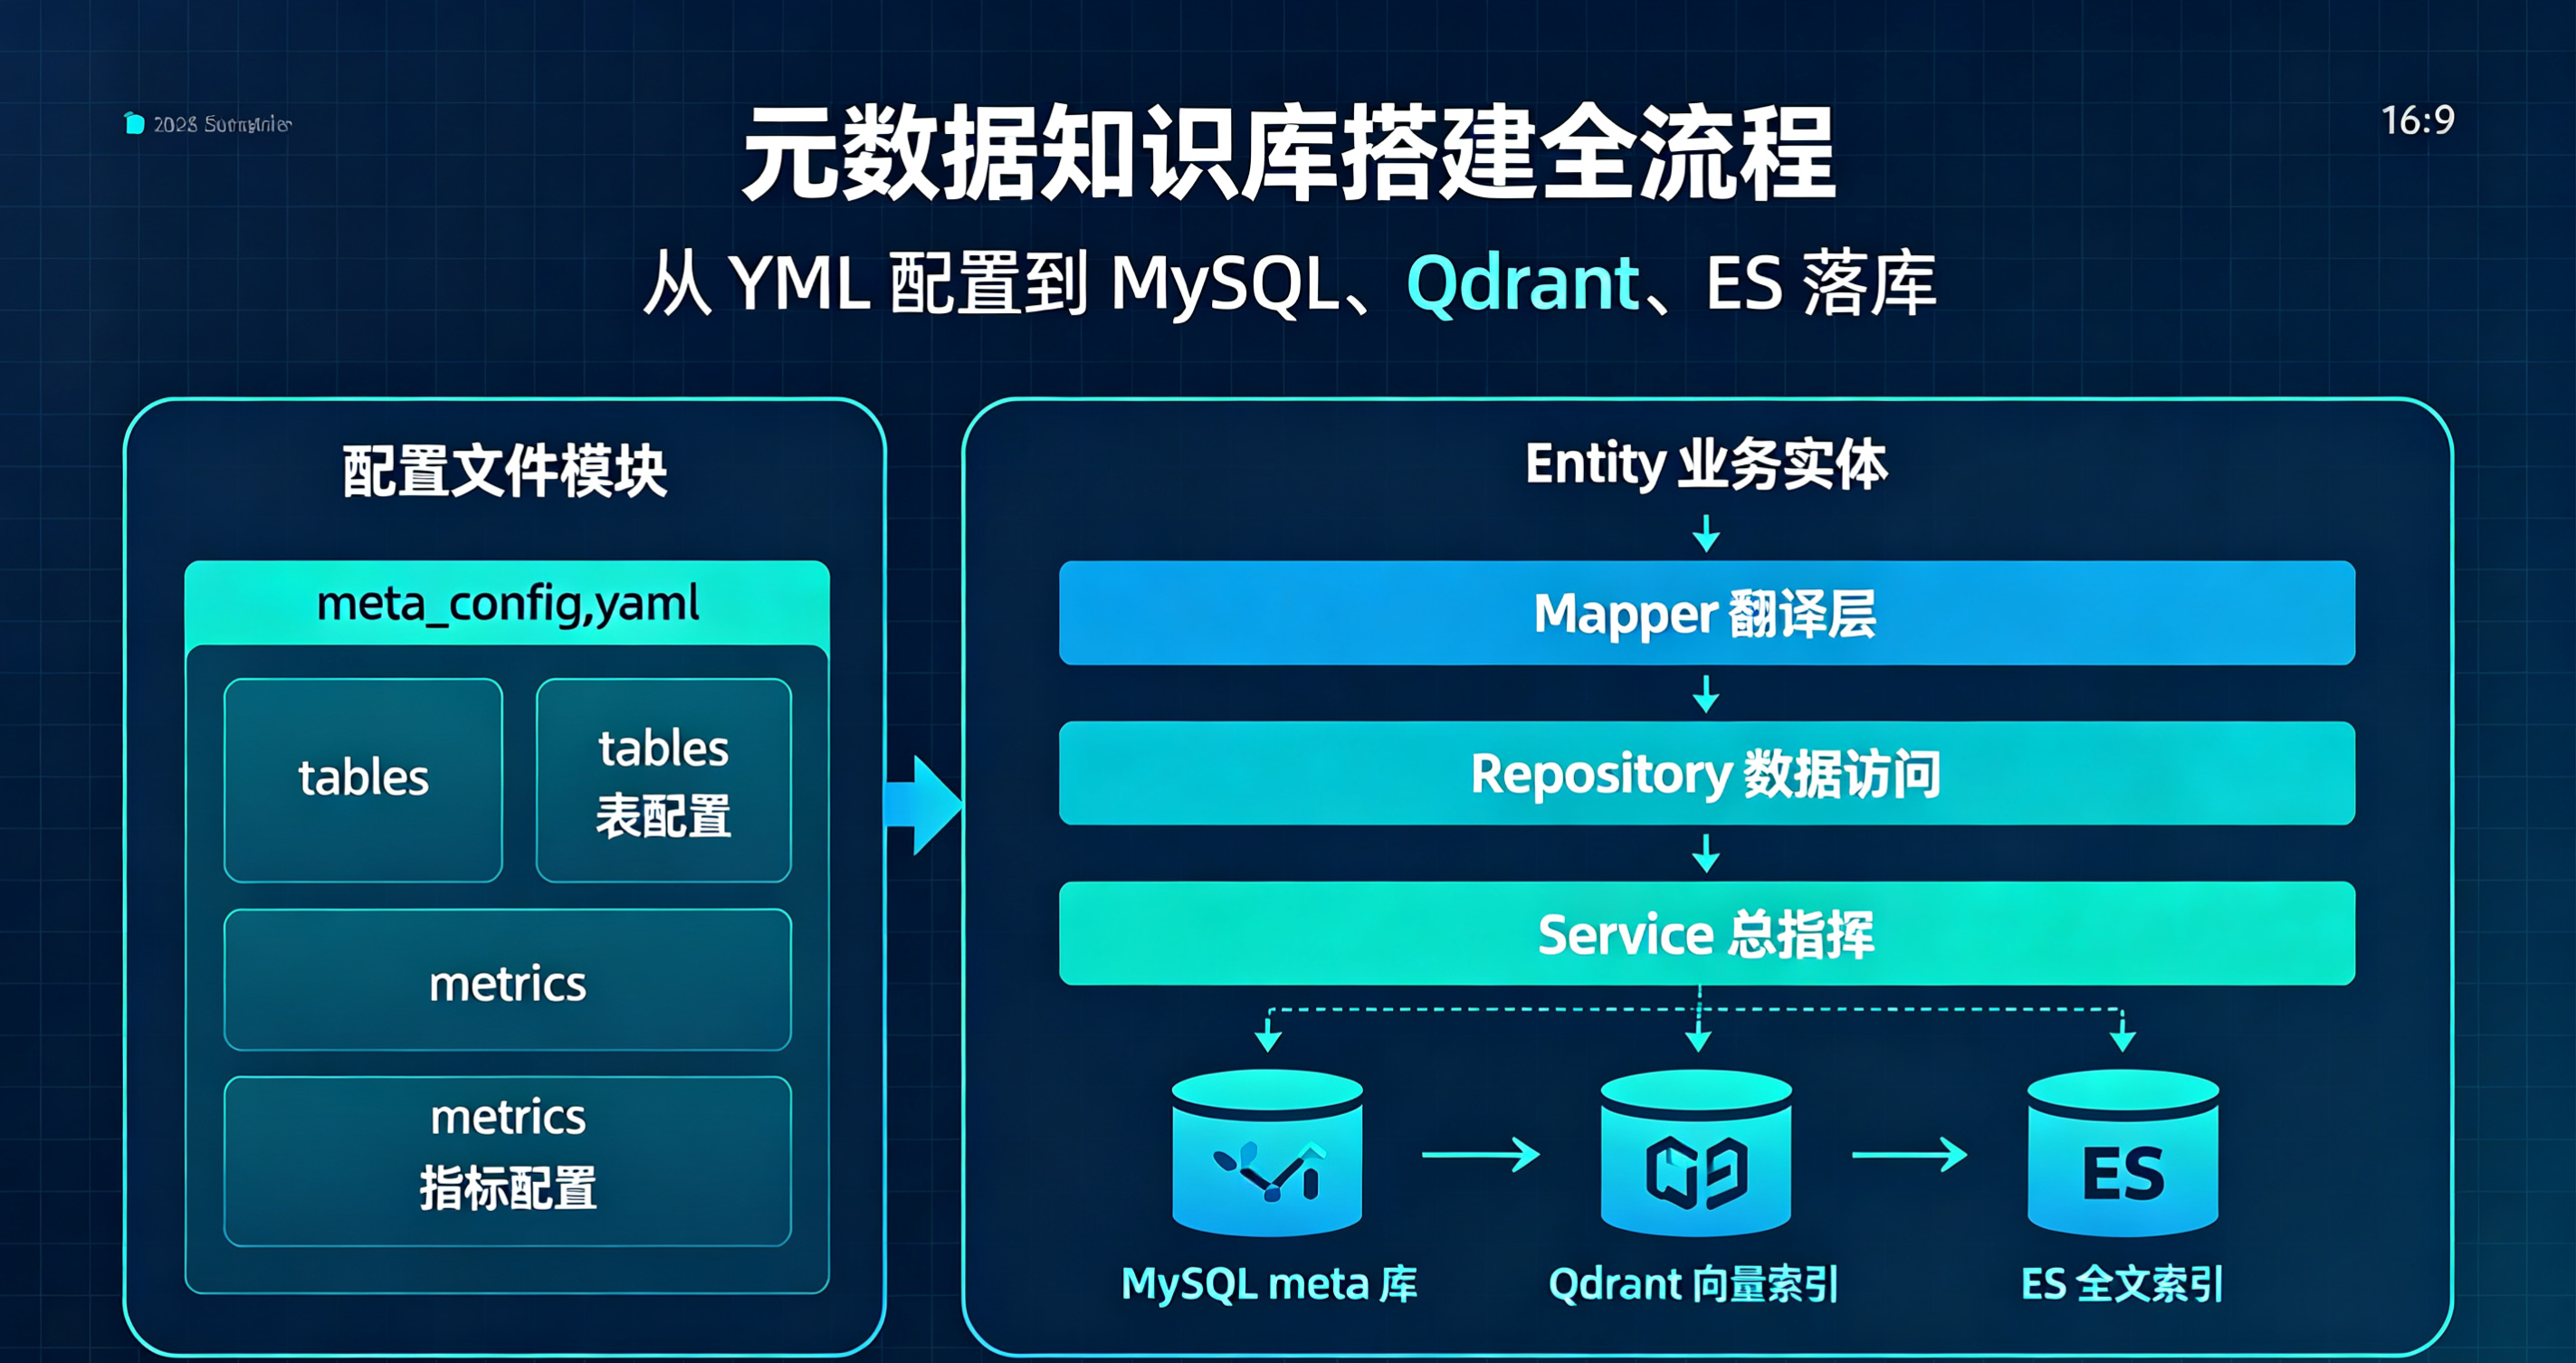
这一章就干一件事:把数据仓库里的表结构信息挖出来,加工成元数据,分别喂给 MySQL、Qdrant、ES 三个大胃王。
先看一下现在家里的状态:
| 数据库 | 当前状态 | 我们想要的状态 |
|---|---|---|
| MySQL meta 库 | 4 张空表(有壳无肉) | 表、字段、指标全填满 |
| Qdrant | 空集合,比钱包还干净 | 字段和指标都有向量索引 |
| ES | 空索引 | 字段取值能全文搜 |
目标很明确:AI Agent 要根据你一句人话就吐出 SQL,它手里得有三份资料------哪张表长啥样、字段同义词怎么映射、字段都有哪些取值。分别对应 meta 库、Qdrant、ES。
但数据库里几十张表上百个字段,你不可能全塞给 AI。日志表塞进去,它给你写个查报错日志的 SQL 回来;临时表塞进去,它直接给你造个不存在的表。所以得有个配置文件,点名说清楚哪些表哪些字段才配让 AI 看见。
一、配置文件 meta_config.yaml
文件放在 data_agent/conf 目录下,分 tables 和 metrics 两块。
1.1 tables 模块:点名要同步的表和字段
这一块相当于给 AI 画地图。哪些表是维度表,哪些是事实表,每个字段叫啥、干嘛用、有哪些别名、取值要不要进 ES,全写在这儿。
yaml
tables:
  - name: dim_region
    role: dim
    description: 地区维度表,用于描述订单发生的地理区域信息。
    columns:
      - name: region_id
        role: primary_key
        description: 地区唯一标识。
        alias: [地区ID, 区域ID]
        sync: false
      - name: province
        role: dimension
        description: 订单所属的省份名称。
        alias: [省份, 省, 所在省份]
        sync: true
      - name: region_name
        role: dimension
        description: 订单所属的大区名称,如华东、华南等。
        alias: [地区, 区域, 大区]
        sync: true
      - name: country
        role: dimension
        description: 地区所属国家名称。
        alias: [国家, 国家名称]
        sync: true
  - name: dim_customer
    role: dim
    description: 客户维度表,描述下单客户的基本属性。
    columns:
      - name: customer_id
        role: primary_key
        description: 客户唯一标识。
        alias: [客户ID, 用户ID]
        sync: false
      - name: customer_name
        role: dimension
        description: 客户名称。
        alias: [客户名称, 用户名称]
        sync: true
      - name: gender
        role: dimension
        description: 客户性别。
        alias: [性别]
        sync: true
      - name: member_level
        role: dimension
        description: 客户会员等级。
        alias: [会员等级, 用户等级]
        sync: true
  - name: dim_product
    role: dim
    description: 商品维度表,描述商品的基本属性信息。
    columns:
      - name: product_id
        role: primary_key
        description: 商品唯一标识。
        alias: [商品ID, 产品ID]
        sync: false
      - name: product_name
        role: dimension
        description: 商品名称。
        alias: [商品名称, 产品名称]
        sync: true
      - name: category
        role: dimension
        description: 商品所属品类。
        alias: [商品类别, 品类, 分类]
        sync: true
      - name: brand
        role: dimension
        description: 商品品牌名称。
        alias: [品牌, 品牌名称]
        sync: true
  - name: dim_date
    role: dim
    description: 时间维度表,用于多时间粒度分析。
    columns:
      - name: date_id
        role: primary_key
        description: 日期唯一标识,格式 yyyyMMdd。
        alias: [日期ID, 日期]
        sync: false
      - name: year
        role: dimension
        description: 年份。
        alias: [年, 年份]
        sync: false
      - name: quarter
        role: dimension
        description: 季度。
        alias: [季度]
        sync: true
      - name: month
        role: dimension
        description: 月份。
        alias: [月, 月份]
        sync: false
      - name: day
        role: dimension
        description: 日。
        alias: [日, 天]
        sync: false
  - name: fact_order
    role: fact
    description: 订单事实表,记录订单数量和金额等核心指标。
    columns:
      - name: order_id
        role: primary_key
        description: 订单唯一标识。
        alias: [订单ID]
        sync: false
      - name: customer_id
        role: foreign_key
        description: 关联客户维度的外键。
        alias: [客户ID, 用户ID]
        sync: false
      - name: product_id
        role: foreign_key
        description: 关联商品维度的外键。
        alias: [商品ID, 产品ID]
        sync: false
      - name: date_id
        role: foreign_key
        description: 关联时间维度的外键。
        alias: [日期, 下单日期]
        sync: false
      - name: region_id
        role: foreign_key
        description: 关联地区维度的外键。
        alias: [地区ID, 区域ID]
        sync: false
      - name: order_quantity
        role: measure
        description: 订单中商品的购买数量。
        alias: [销量, 购买数量, 件数]
        sync: false
      - name: order_amount
        role: measure
        description: 订单金额。
        alias: [销售额, 订单金额, 收入]
        sync: false
这里 role 有四种值,看着像四个职业:
| 值 | 含义 | 举例 |
|---|---|---|
primary_key |
主键,唯一标识一行 | region_id |
foreign_key |
外键,指着别的表 | customer_id |
dimension |
维度字段,用来分组筛选 | province、brand |
measure |
度量字段,用来 SUM/AVG | order_amount |
至于 sync,就是"这个字段的取值要不要进 ES"。true 的像"华北""数码""黄金会员"这种,用户嘴上会说,得建全文索引;false 的像 ID 和金额数值,用户不会念一串数字,建了也是浪费空间。
你要是把 order_id 也设成 sync: true,ES 里会多出几十万条"ORD202409190001"这种文档,搜出来还没用------AI 看到用户说"帮我查一下 10086",它还以为是手机号。
1.2 metrics 模块:声明业务指标
指标不是数据库里现成的列,而是算出来的业务词。比如 GMV = SUM(order_amount),用户张嘴就是"GMV 多少",但表里压根没这一列。你不告诉 AI,它能给你把 GROUP BY 写到外太空去。
yaml
metrics:
  - name: GMV
    description: 全称Gross Merchandise Value,表示所有订单的成交金额总和。
    relevant_columns:
      - fact_order.order_amount
    alias: [成交总额, 订单总额]
  - name: AOV
    description: 全称Average Order Value,表示所有订单的成交金额平均值。
    relevant_columns:
      - fact_order.order_quantity
    alias: [平均单价, 平均订单金额]
本项目一共配了五张表加两个指标。五张表分别是地区、客户、商品、时间四张维度表,加一张订单事实表;指标就是 GMV 和 AOV。
别嫌少。麻雀虽小,五脏俱全。你要是一上来就塞 50 张表 200 个指标,先不说 AI 记不记得住,光你自己写 YAML 都能写到怀疑人生。
1.3 meta_config.py 类型定义
光有 YAML 不行,YAML 是给人看的,Python 不认识。得用 @dataclass 把结构定义出来,再用 OmegaConf 做类型校验。不然你在 YAML 里少写个冒号,程序跑到一半才崩,日志看一眼以为服务器在闹脾气。
python
from dataclasses import dataclass
from typing import Optional
@dataclass
class ColumnConfig:
    name: str
    role: str
    description: str
    alias: list[str]
    sync: bool
@dataclass
class TableConfig:
    name: str
    role: str
    description: str
    columns: list[ColumnConfig]
@dataclass
class MetricConfig:
    name: str
    description: str
    relevant_columns: list[str]
    alias: list[str]
@dataclass
class MetaConfig:
    tables: Optional[list[TableConfig]] = None
    metrics: Optional[list[MetricConfig]] = None
层级关系一目了然:MetaConfig 最顶上,下面挂 tables,tables 里再挂 columns;旁边还挂着 metrics。用 Optional[...] = None 是说两块都可选------你可以只同步表不同步指标,也可以只同步指标不同步表,随你心情。
1.4 生成 MetaConfig 对象
接下来创建 MetaKnowledgeService 类,放在 service 层,管整个元数据库构建流程。第一步就是把 YAML 和 Python 类合并,变出一个 MetaConfig 对象。
python
context = OmegaConf.load(config_path)
schema = OmegaConf.structured(MetaConfig)
meta_config: MetaConfig = OmegaConf.to_object(OmegaConf.merge(schema, context))
执行完这几句,YAML 里那一堆嵌套字典,就全变成了一层层的 dataclass 实例。你想拿第一个表的第一个字段名,直接 meta_config.tables[0].columns[0].name 就行,IDE 还给你自动补全,舒服得像坐电梯。
二、创建 ORM 实体类
2.1 什么是 ORM
ORM 全称 Object-Relational Mapping,对象关系映射。说白了就是:用 Python 的类代表数据库里的表,用类的属性代表表的列。
不用 ORM 的时候,你手写 SQL 字符串:
python
cursor.execute(
    "SELECT id, name, role, description FROM table_info WHERE id = %s",
    ("dim_region",)
)
row = cursor.fetchone()
table_id = row[0]
table_name = row[1]
写完你还得记着 row[0] 是 id、row[1] 是 name。过两周回来改代码,你会盯着这俩下标怀疑人生:"当初为啥不写注释?哦,因为我懒。"
用 ORM 就清爽多了:
python
stmt = select(TableInfoMySQL).where(TableInfoMySQL.id == "dim_region")
result = await session.execute(stmt)
table = result.scalar_one()
print(table.name)  # 直接点号访问,不用记第几列
ORM 帮你把 Python 对象和数据库表来回翻译,你只管摆弄对象,SQL 它自己生成。
2.2 SQLAlchemy 2.0 的新语法
2.2.1 DeclarativeBase 基类
python
from sqlalchemy.orm import DeclarativeBase
class Base(DeclarativeBase):
    pass
所有实体类都继承这个 Base。项目里全局就这一个基类,谁都不许自己再造一个。你要是手贱写了第二个 Base,SQLAlchemy 就跟你分家,ORM 对不上号,错误日志能把你看哭。
2.2.2 tablename 指定表名
python
class TableInfoMySQL(Base):
    __tablename__ = "table_info"
这行类变量告诉 SQLAlchemy:"这个类对应数据库里那张叫 table_info 的表。"
2.2.3 Mapped 和 mapped_column
python
id: Mapped[str] = mapped_column(
    String(64),
    primary_key=True,
    comment="表编号"
)
这是 2.0 的新写法,一半给 IDE 看,一半给数据库看:
| 部分 | 作用 |
|---|---|
id: Mapped[str] |
Python 层面的类型标注,IDE 给你补全 |
mapped_column(...) |
数据库层面的定义,类型、约束、注释 |
至于 Mapped[str] 和 Mapped[str | None] 的区别,前者非空,后者可空。你要是把字段类型标成 Mapped[str | None] 然后业务里又不判空,运行时一个 NoneType has no attribute 能让你从工位弹起来。
2.2.4 常用列类型
| 类型 | 对应 SQL | 用途 |
|---|---|---|
String(64) |
VARCHAR(64) | 短字符串,括号里是最大长度 |
Text |
TEXT | 长文本,不限长度 |
JSON |
JSON | 存列表和字典 |
Integer |
INT | 整数 |
2.3 四个实体类
四个实体类分别对应 meta 库里四张表,你可以这么理解:
| 实体类 | 对应表 | 存什么 | 类比 |
|---|---|---|---|
TableInfoMySQL |
table_info | 表信息 | 书架上有哪些书 |
ColumnInfoMySQL |
column_info | 字段信息 | 每本书有哪些章节 |
MetricInfoMySQL |
metric_info | 指标定义 | 书里的核心概念 |
ColumnMetricMySQL |
column_metric | 字段-指标关联 | 概念出现在哪些章节 |
2.3.1 base.py 基类
python
from sqlalchemy.orm import DeclarativeBase
class Base(DeclarativeBase):
    pass
就这么点东西。别小看它,后面四个实体类都靠它续命。
2.3.2 TableInfoMySQL
python
from sqlalchemy import String, Text
from sqlalchemy.orm import Mapped, mapped_column
from data_agent.app.models.Base import Base
class TableInfoMySQL(Base):
    __tablename__ = 'table_info'
    id: Mapped[str] = mapped_column(
        String(64),
        primary_key=True,
        comment="表编号"
    )
    name: Mapped[str | None] = mapped_column(
        String(128),
        comment="表名称"
    )
    role: Mapped[str | None] = mapped_column(
        String(32),
        comment="表类型(fact/dim)"
    )
    description: Mapped[str | None] = mapped_column(
        Text,
        comment="表描述"
    )
几个设计细节:id 用 String(64) 而不是自增整数,因为 ID 直接用表名这种业务主键;description 用 Text 不用 String,表描述可能写得老长;除了 id 以外都允许为空,免得哪个字段没填就整个写入失败。
这里的 Mapped 是 SQLAlchemy 的关键字,专门定义 ORM 字段用的。它和分层架构里那个 Mapper 层半毛钱关系没有。你要是把两个 Mapper 搞混了,同事看你的代码会像看加密通话。
2.3.3 ColumnInfoMySQL
python
from sqlalchemy import String, Text
from sqlalchemy.types import JSON
from sqlalchemy.orm import Mapped, mapped_column
from data_agent.app.models.Base import Base
class ColumnInfoMySQL(Base):
    __tablename__ = "column_info"
    id: Mapped[str] = mapped_column(String(64), primary_key=True, comment="列编号")
    name: Mapped[str | None] = mapped_column(String(128), comment="列名称")
    type: Mapped[str | None] = mapped_column(String(64), comment="数据类型")
    role: Mapped[str | None] = mapped_column(String(32), comment="列类型")
    examples: Mapped[dict | list | None] = mapped_column(JSON, comment="数据示例")
    description: Mapped[str | None] = mapped_column(Text, comment="列描述")
    alias: Mapped[dict | list | None] = mapped_column(JSON, comment="列别名")
    table_id: Mapped[str | None] = mapped_column(String(64), comment="所属表编号")
重点是 examples 和 alias 两个 JSON 字段。用户说"销售额",LLM 得通过 alias 知道这对应的是 order_amount。用 JSON 类型存,塞进去是列表,取出来还是列表,不用你自己写 split(",") 然后再跟脏数据搏斗。
table_id 逻辑上是外键,但这里没显式声明 ForeignKey。为啥?因为项目靠业务代码维护关联,不要数据库那套硬约束。你要是加了外键约束,哪天想删一张表试试?数据库直接给你脸子看。
2.3.4 MetricInfoMySQL
python
from sqlalchemy import String, Text
from sqlalchemy.types import JSON
from sqlalchemy.orm import Mapped, mapped_column
from data_agent.app.models.Base import Base
class MetricInfoMySQL(Base):
    __tablename__ = "metric_info"
    id: Mapped[str] = mapped_column(String(64), primary_key=True, comment="指标编码")
    name: Mapped[str | None] = mapped_column(String(128), comment="指标名称")
    description: Mapped[str | None] = mapped_column(Text, comment="指标描述")
    relevant_columns: Mapped[dict | list | None] = mapped_column(JSON, comment="关联字段")
    alias: Mapped[dict | list | None] = mapped_column(JSON, comment="指标别名")
指标比字段高一层抽象。用户问"GMV"或者"客单价",数据库里没有现成列,得靠计算。指标表就是告诉大模型:这个指标对应哪些字段、怎么算。
2.3.5 ColumnMetricMySQL
python
from sqlalchemy import String
from sqlalchemy.orm import Mapped, mapped_column
from data_agent.app.models.Base import Base
class ColumnMetricMySQL(Base):
    __tablename__ = "column_metric"
    column_id: Mapped[str] = mapped_column(String(64), primary_key=True, comment="列编号")
    metric_id: Mapped[str] = mapped_column(String(64), primary_key=True, comment="指标编号")
两个字段都标了 primary_key=True,这叫联合主键。意思是 (column_id, metric_id) 这个组合不能重复,但单独一列可以重复。就像你和你同事都叫"张伟"没问题,但你们俩不能同时是同一个工位的同一个人。
三、Entity 层,业务实体
3.1 为啥还要再来一套
项目里其实有两套数据:一套是 models/ 下的 ORM 实体,绑着 SQLAlchemy;另一套是 entities/ 下的业务实体,纯 dataclass。
有人看到这儿就不乐意了:"你这不就是重复造轮子吗?字段一模一样,写两遍,KPI 凑字数呢?"
还真不是。ORM 实体绑着数据库细节,业务实体是干净的数据载体。将来你想把 MySQL 换成别的库,业务代码一行不用改。你要是把业务代码全写在 ORM 实体上,换库那天就是你提离职那天。
3.2 几个业务实体
3.2.1 TableInfo
python
@dataclass
class TableInfo:
    id: str
    name: str
    role: str
    description: str
3.2.2 ColumnInfo
python
@dataclass
class ColumnInfo:
    id: str
    name: str
    type: str
    role: str
    example: list[Any]
    description: str
    alias: list[str]
    table_id: str
3.2.3 MetricInfo
python
@dataclass
class MetricInfo:
    id: str
    name: str
    description: str
    relevant_columns: list[str]
    alias: list[str]
3.2.4 ColumnMetric
python
@dataclass
class ColumnMetric:
    column_id: str
    metric_id: str
3.2.5 ValueInfo
python
@dataclass
class ValueInfo:
    id: str
    value: str
    column_id: str
3.3 两套实体对比
| 对比维度 | ORM 实体 | 业务实体 |
|---|---|---|
| 文件位置 | app/models/ | app/entities/ |
| 依赖 | SQLAlchemy | 无依赖,纯 dataclass |
| 用途 | 数据库读写 | 业务传递、Qdrant payload |
| 能直接序列化吗 | 不方便,带一堆元数据 | 方便,转 dict 就行 |
四、Mapper 层,翻译官
4.1 Mapper 干啥
Mapper 就是 ORM 实体和业务实体之间的翻译官。写库时业务实体转 ORM,读库时 ORM 转业务实体。
4.1.1 TableInfoMapper
python
class TableInfoMapper:
    @staticmethod
    def to_entity(table_info_mysql: TableInfoMySQL) -> TableInfo:
        return TableInfo(
            id=table_info_mysql.id,
            name=table_info_mysql.name,
            role=table_info_mysql.role,
            description=table_info_mysql.description,
        )
    @staticmethod
    def to_model(table_info: TableInfo) -> TableInfoMySQL:
        return TableInfoMySQL(**asdict(table_info))
4.1.2 ColumnInfoMapper
python
class ColumnInfoMapper:
    @staticmethod
    def to_entity(column_info_mysql: ColumnInfoMySQL) -> ColumnInfo:
        return ColumnInfo(
            id=column_info_mysql.id,
            name=column_info_mysql.name,
            type=column_info_mysql.type,
            role=column_info_mysql.role,
            example=column_info_mysql.examples,
            description=column_info_mysql.description,
            alias=column_info_mysql.alias,
            table_id=column_info_mysql.table_id,
        )
    @staticmethod
    def to_model(column_info: ColumnInfo) -> ColumnInfoMySQL:
        return ColumnInfoMySQL(**asdict(column_info))
4.1.3 MetricInfoMapper 和 ColumnMetricMapper
python
class MetricInfoMapper:
    @staticmethod
    def to_entity(metric_info_mysql: MetricInfoMySQL) -> MetricInfo:
        return MetricInfo(
            id=metric_info_mysql.id,
            name=metric_info_mysql.name,
            description=metric_info_mysql.description,
            relevant_columns=metric_info_mysql.relevant_columns,
            alias=metric_info_mysql.alias
        )
    @staticmethod
    def to_model(metric_info: MetricInfo) -> MetricInfoMySQL:
        return MetricInfoMySQL(**asdict(metric_info))
class ColumnMetricMapper:
    @staticmethod
    def to_entity(column_metric_mysql: ColumnMetricMySQL) -> ColumnMetric:
        return ColumnMetric(
            column_id=column_metric_mysql.column_id,
            metric_id=column_metric_mysql.metric_id,
        )
    @staticmethod
    def to_model(column_metric: ColumnMetric) -> ColumnMetricMySQL:
        return ColumnMetricMySQL(**asdict(column_metric))
看到这儿肯定有人拍桌子:"这不就是字段名一样拷贝一遍吗?有这必要?我手写一个转换函数都比这快。"
有必要。关键在于:ORM 实体一旦被 session.add(),SQLAlchemy 就给它挂一堆追踪标记------对象状态、变更记录、懒加载代理。这些标记只在 session 活着的时候有效。
你要是直接把 ORM 实体塞进 Qdrant 的 payload 里,会发生什么?序列化失败,因为它不是普通 dict;离开 session 再访问属性,直接抛 detached instance;就算成功塞进去,里面还带着一堆 SQLAlchemy 内部元数据,白占空间。
业务实体就没这毛病,纯 dataclass,到处乱跑都没事。存 Qdrant 行,转 JSON 行,在 Service 之间传来传去也行。这层翻译看着冗余,其实是帮你把"数据库的脏东西"挡在业务逻辑外头。
五、Repository 层,数据访问层
5.1 Repository 干啥
Repository 把对各个存储引擎的读写封装起来。上层 Service 只管喊"把这些表存进去",至于 INSERT 还是 MERGE、SQL 怎么拼,那是 Repository 的事。
你要是让 Service 直接拼 SQL,业务代码里就会散落着一堆 SQL 字符串,改个字段名都得全局搜索。到时候你不是在写业务,你是在给 SQL 字符串做保洁。
5.2 五个 Repository 的分工
| Repository | 操作的存储 | 负责什么 |
|---|---|---|
MetaMySQLRepository |
MySQL meta 库 | 读写表、字段、指标信息 |
DWMySQLRepository |
MySQL dw 库 | 从数仓查字段类型和取值 |
ColumnQdrantRepository |
Qdrant | 字段向量集合的建集合、写入、检索 |
MetricQdrantRepository |
Qdrant | 指标向量集合的建集合、写入、检索 |
ValueESRepository |
ES | 字段取值全文索引的建索引、写入、检索 |
5.3 MetaMySQLRepository
python
from sqlalchemy import text
from sqlalchemy.ext.asyncio import AsyncSession
class MetaMySQLRepository:
    def __init__(self, session: AsyncSession):
        self.session = session
    async def save_table_infos(self, table_infos: list[TableInfo]):
        models = [TableInfoMapper.to_model(t) for t in table_infos]
        self.session.add_all(models)
    async def save_column_infos(self, columns_info: list[ColumnInfo]):
        models = [ColumnInfoMapper.to_model(c) for c in columns_info]
        self.session.add_all(models)
    async def save_metric_infos(self, metric_infos: list[MetricInfo]):
        self.session.add_all([MetricInfoMapper.to_model(m) for m in metric_infos])
    async def save_column_metrics(self, column_metrics: list[ColumnMetric]):
        self.session.add_all([ColumnMetricMapper.to_model(cm) for cm in column_metrics])
    async def get_table_info_by_id(self, table_id: str) -> TableInfo | None:
        result = await self.session.get(TableInfoMySQL, table_id)
        if result:
            return TableInfoMapper.to_entity(result)
        return None
    async def get_key_columns_by_table_id(self, table_id: str) -> list[ColumnInfo]:
        sql = """
            select * from column_info
            where table_id = :table_id
              and role in ('primary_key', 'foreign_key')
        """
        result = await self.session.execute(text(sql), {"table_id": table_id})
        return [ColumnInfo(**row) for row in result.mappings().fetchall()]
构造函数接收一个 AsyncSession,从外面传进来。为啥不在 Repository 里自己 new 一个?因为事务要在上层管。"存表"和"存字段"得在同一个事务里,要么都成,要么都滚。你要是自己造 session,就跟别人没法共用事务了。
四个 save 方法长得几乎一模一样:业务实体走 Mapper 转 ORM,然后 add_all 进 session。注意它不 commit,commit 留给上层。Repository 要是自己 commit 了,Service 想再塞点别的数据进同一个事务,就只能干瞪眼。
5.4 DWMySQLRepository,只读取数仓
python
class DWMySQLRepository:
    def __init__(self, session: AsyncSession):
        self.session = session
    async def get_column_types(self, table_name: str) -> dict[str, str]:
        sql = f"show columns from {table_name}"
        result = await self.session.execute(text(sql))
        return {row.Field: row.Type for row in result.fetchall()}
    async def get_column_values(self, table_name: str, column_name: str, limit: int):
        sql = f"select distinct {column_name} from {table_name} limit {limit}"
        result = await self.session.execute(text(sql))
        return result.scalars().fetchall()
    async def get_db_info(self):
        result = await self.session.execute(text("select version()"))
        version = result.scalar()
        dialect = self.session.get_bind().dialect.name
        return {'version': version, 'dialect': dialect}
    async def validate_sql(self, sql):
        await self.session.execute(text(f"explain {sql}"))
    async def execute_sql(self, sql):
        result = await self.session.execute(text(sql))
        return [dict(row) for row in result.mappings().fetchall()]
这个 Repository 对 dw 库只读不写,数仓的数据是现成的,构建知识库只需要挖信息。
get_column_types 查字段类型,这些信息配置文件里没写,直接从 INFORMATION_SCHEMA.COLUMNS 拿最准。这是 MySQL 自带的系统表,不用你建。
get_column_values 用 SELECT DISTINCT 查不重复取值。构建字段示例值时查 10 条,构建 ES 索引时查 10 万条。DISTINCT 就是"去重",不然你查个订单状态回来一万条"已支付",除了证明你的系统确实在卖东西,没有任何信息量。
get_db_info 查数据库版本和方言。为啥要这个?因为 MySQL 和 PostgreSQL 的函数名、字符串拼接方式都不一样,MySQL 8.0 支持窗口函数,5.x 不支持。把方言和版本喂给 LLM,它才不会瞎猜语法,给你生成一句 PostgreSQL 风格的 SQL 跑到 MySQL 上。
validate_sql 用 EXPLAIN 检查 SQL 语法对不对、表和字段存不存在。有问题 MySQL 自己抛异常,异常往上冒,谁调用谁处理。
5.5 ColumnQdrantRepository
python
class ColumnQdrantRepository:
    collection_name: str = 'data-agent-column'
    def __init__(self, client: AsyncQdrantClient):
        self.client = client
    async def ensure_collection(self):
        if not await self.client.collection_exists(self.collection_name):
            await self.client.create_collection(
                self.collection_name,
                vectors_config=VectorParams(
                    size=app_config.qdrant.embedding_size,
                    distance=Distance.COSINE
                )
            )
    async def upsert(self, ids: list[str], embeddings: list[list[float]],
                     payloads: list[ColumnInfo], batch_size: int = 20):
        zipped = list(zip(ids, embeddings, payloads))
        for i in range(0, len(zipped), batch_size):
            batch = zipped[i:i + batch_size]
            batch_points = [
                PointStruct(id=id, vector=embeddings, payload=asdict(payload))
                for id, embeddings, payload in batch
            ]
            await self.client.upsert(
                collection_name=self.collection_name, points=batch_points
            )
    async def search(self, embeddings: list[float],
                     score_threshold: float = 0.6, limit: int = 5) -> list[ColumnInfo]:
        result = await self.client.query_points(
            collection_name=self.collection_name,
            query=embeddings,
            score_threshold=score_threshold,
            limit=limit
        )
        return [ColumnInfo(**point.payload) for point in result.points]
ensure_collection 看名字就懂------"确保存在"。有就拉倒,没有就建。调多少次结果都一样,永远不会因为重复创建报错。这种写法很重要,你要是每次启动都 create_collection,第二次直接报错,日志里全是"集合已存在",你看着还以为 Qdrant 跟你过不去。
upsert 是 update + insert 的合成词。ID 存在就更新,不存在就插入。重复跑构建脚本不会产生重复数据,而是覆盖更新。这点很关键,不然你每次重建知识库,Qdrant 里的点就翻倍,最后检索结果一堆重复字段,AI 看着都懵。
search 就是语义检索。用户问"各地区的销售额",查询向量打进去,可能返回 order_amount 排第一(score 0.92),order_quantity 排第二(0.78),region_name 排第三(0.71)。LLM 拿到这些,就知道该查哪张表、用哪几个字段。
5.6 MetricQdrantRepository
这个和 ColumnQdrantRepository 结构一模一样,只是集合名换成 data-agent-metric,操作的是指标数据。ensure_collection、upsert、search 三个方法照搬。代码复用做到这份上,复制粘贴都比手写快。
5.7 ValueESRepository
python
class ValueEsRepository:
    index_name = 'data-agent-value'
    index_mappings = {
        "dynamic": False,
        "properties": {
            "id": {"type": "keyword"},
            "value": {"type": "text", "analyzer": "ik_max_word",
                      "search_analyzer": "ik_max_word"},
            "column_id": {"type": "keyword"},
        }
    }
    def __init__(self, client: AsyncElasticsearch):
        self.client = client
    async def ensure_index(self):
        if not await self.client.indices.exists(self.index_name):
            await self.client.indices.create(
                index=self.index_name, mappings=self.index_mappings
            )
    async def index(self, value_infos: list[ValueInfo], batch_size=20):
        for i in range(0, len(value_infos), batch_size):
            batch = value_infos[i:i + batch_size]
            operations = []
            for value_info in batch:
                operations.append({"index": {"_index": self.index_name,
                                             "_id": value_info.id}})
                operations.append(asdict(value_info))
            await self.client.bulk(operations=operations)
    async def search(self, keyword: str,
                     score_threshold: float = 0.6, limit: int = 5) -> list[ValueInfo]:
        result = await self.client.search(
            index=self.index_name,
            query={"match": {"value": keyword}},
            min_score=score_threshold,
            size=limit
        )
return [ValueInfo(**hit['_source']) for hit in result['hits']['hits']]两个字段类型要分清:value 是 text 加中文分词器,会被切成小块,"华北地区"切成"华北""地区";column_id 是 keyword,整个当一个整体精确匹配,不分词。
dynamic: False 意思是只能存这两个字段,多塞一个就被忽略。不然你哪天手滑多写一个字段,ES 自动给你建个新映射,结构就失控了。
ES 的 bulk API 格式很奇葩:操作头和数据体交替排列。一条操作头说"接下来这条是 index",紧跟一条数据;再来一个操作头,再跟一条数据。这么设计是因为一次批量操作里可以混着写、更新、删除,所以每条数据前面都得有个"操作头"告诉你这条是干嘛的。第一次见这格式你会怀疑人生,看多了就习惯了。
ES 做的是全文检索,和 Qdrant 的语义检索互补。Qdrant 帮你找"哪个字段",ES 帮你找"字段里有哪些取值"。用户说"华北",ES 一搜,告诉你 dim_region.region_name 里有"华北"这个值,AI 写 SQL 时就知道加 WHERE region_name LIKE '%华北%'。
六、Service 层,总指挥
6.1 入口脚本
在讲 Service 之前,先看谁调用它。入口脚本就干三件事:解析参数、初始化所有客户端、组装 Service 然后执行。
python
import asyncio
from argparse import ArgumentParser
from pathlib import Path
async def build(config_path: Path):
    # 1. 初始化所有客户端管理器
    meta_mysql_client.init()
    dw_mysql_client.init()
    qdrant_client_manager.init()
    embedding_client_manager.init()
    es_client_manager.init()
    # 2. 创建数据库会话
    async with (
        meta_mysql_client.session_factory() as meta_session,
        dw_mysql_client.session_factory() as dw_session,
    ):
        # 3. 用会话创建 Repository
        meta_mysql_repository = MetaMySQLRepository(meta_session)
        dw_mysql_repository = DWMySQLRepository(dw_session)
        column_qdrant_repository = ColumnQdrantRepository(qdrant_client_manager.client)
        embedding_client = embedding_client_manager.client
        value_es_repository = ValueEsRepository(es_client_manager.client)
        metric_qdrant_repository = MetricQdrantRepository(qdrant_client_manager.client)
        # 4. 注入 Service
        meta_knowledge_service = MetaKnowledgeService(
            meta_mysql_repository=meta_mysql_repository,
            dw_mysql_repository=dw_mysql_repository,
            column_qdrant_repository=column_qdrant_repository,
            embedding_client=embedding_client,
            value_es_repository=value_es_repository,
            metric_qdrant_repository=metric_qdrant_repository,
        )
        # 5. 开干
        await meta_knowledge_service.build(config_path)
        await meta_mysql_client.close()
        await dw_mysql_client.close()
        await qdrant_client_manager.close()
        await es_client_manager.close()
if __name__ == "__main__":
    parser = ArgumentParser()
    parser.add_argument("-c", "--conf")
    args = parser.parse_args()
    asyncio.run(build(Path(args.conf)))
一句话总结:零件全备好,交给总指挥组装。运行方式:
bash
python -m app.scripts.build_meta_knowledge -c ./conf/meta_config.yaml6.2 MetaKnowledgeService
6.2.1 构造函数,依赖注入
python
class MetaKnowledgeService:
    def __init__(
        self,
        meta_mysql_repository: MetaMySQLRepository,
        dw_mysql_repository: DWMySQLRepository,
        column_qdrant_repository: ColumnQdrantRepository,
        embedding_client: HuggingFaceEndpointEmbeddings,
        value_es_repository: ValueEsRepository,
        metric_qdrant_repository: MetricQdrantRepository,
    ):
        self.meta_mysql_repository = meta_mysql_repository
        self.dw_mysql_repository = dw_mysql_repository
        self.column_qdrant_repository = column_qdrant_repository
        self.embedding_client = embedding_client
        self.value_es_repository = value_es_repository
        self.metric_qdrant_repository = metric_qdrant_repository
六个零件全从外面传进来。为啥不在 Service 里自己 new?因为依赖注入。Service 只管"用",不管"造"。哪天你想换个 Embedding 模型,只要新模型提供一样的接口,Service 代码一行不用动。你要是在里面硬 new,换模型那天你得把 Service 翻个底朝天。
6.2.2 build 方法,调度逻辑
python
async def build(self, config_path: Path):
    # 1. 加载配置
    context = OmegaConf.load(config_path)
    schema = OmegaConf.structured(MetaConfig)
    meta_config: MetaConfig = OmegaConf.to_object(OmegaConf.merge(schema, context))
    # 2. 处理表信息
    if meta_config.tables:
        column_infos = await self._save_tables_to_meta_db(meta_config)
        await self._save_column_info_to_qdrant(column_infos)
        await self._save_value_info_to_es(meta_config, column_infos)
    # 3. 处理指标信息
    if meta_config.metrics:
        metric_infos = await self._save_metrics_to_meta_db(meta_config)
        await self._save_metric_info_to_qdrant(metric_infos)
注意 _save_tables_to_meta_db 返回的 column_infos,后面两步都要用。这就是 Service 层的价值------各步骤之间的数据传递它来协调。你要是把这些流程写在脚本里,传参传得能把自己绕晕。
6.2.3 _save_tables_to_meta_db
python
async def _save_tables_to_meta_db(self, meta_config: MetaConfig) -> list[ColumnInfo]:
    table_infos: list[TableInfo] = []
    column_infos: list[ColumnInfo] = []
    for table in meta_config.tables:
        table_info = TableInfo(
            id=table.name,
            name=table.name,
            role=table.role,
            description=table.description,
        )
        table_infos.append(table_info)
        column_types = await self.dw_mysql_repository.get_column_types(table.name)
        for column in table.columns:
            column_values = await self.dw_mysql_repository.get_column_values(
                table.name, column.name, 10
            )
            column_info = ColumnInfo(
                id=f"{table.name}.{column.name}",
                name=column.name,
                type=column_types[column.name],
                role=column.role,
                examples=column_values,
                description=column.description,
                alias=column.alias,
                table_id=table.name,
            )
            column_infos.append(column_info)
    async with self.meta_mysql_repository.session.begin():
        await self.meta_mysql_repository.save_table_infos(table_infos)
        await self.meta_mysql_repository.save_column_infos(column_infos)
    return column_infos
流程就是:遍历配置里的每张表,构造 TableInfo;去 dw 库查字段类型;再遍历每个字段,查 10 条示例值;凑齐了构造 ColumnInfo;最后一个事务里全写进去。
事务很重要。表信息写了一半字段信息崩了,没有事务的话你 meta 库里就留一堆孤儿数据,下次构建还会冲突。有了事务,错了就整体回滚,干干净净。
6.2.4 _save_column_info_to_qdrant
python
async def _save_column_info_to_qdrant(self, column_infos: list[ColumnInfo]):
    await self.column_qdrant_repository.ensure_collection()
    points: list[dict] = []
    for column_info in column_infos:
        points.append({
            "id": uuid.uuid4(),
            "embedding_text": column_info.name,
            "payload": column_info,
        })
        points.append({
            "id": uuid.uuid4(),
            "embedding_text": column_info.description,
            "payload": column_info,
        })
        for alia in column_info.alias:
            points.append({
                "id": uuid.uuid4(),
                "embedding_text": alia,
                "payload": column_info,
            })
    embedding_texts = [p["embedding_text"] for p in points]
    embeddings = []
    batch_size = 10
    for i in range(0, len(embedding_texts), batch_size):
        batch = embedding_texts[i:i + batch_size]
        batch_embeddings = await self.embedding_client.aembed_documents(batch)
        embeddings.extend(batch_embeddings)
    ids = [p["id"] for p in points]
    payloads = [p["payload"] for p in points]
    await self.column_qdrant_repository.upsert(ids, embeddings, payloads)
一个字段为啥要生成好几条向量?因为用户说话不按剧本走。用户说"订单状态",你得匹配到字段名 order_status;用户说"订单的处理进度",你得匹配到字段描述;用户说"物流情况",你得匹配到别名。
所以每个字段用名字、描述、每个别名各生成一条向量,全部指向同一个 ColumnInfo。不管用户怎么表达,语义相似度总能捞到正确字段。分批 10 条是因为 Embedding 服务有 token 限制,一次塞太多它直接罢工。
6.2.5 _save_value_info_to_es
python
async def _save_value_info_to_es(
    self, meta_config: MetaConfig, column_infos: list[ColumnInfo]
):
    await self.value_es_repository.ensure_index()
    column2sync: dict[str, bool] = {}
    for table in meta_config.tables:
        for column in table.columns:
            column2sync[f"{table.name}.{column.name}"] = column.sync
    value_infos: list[ValueInfo] = []
    for column_info in column_infos:
        if column2sync[column_info.id]:
            values = await self.dw_mysql_repository.get_column_values(
                column_info.table_id, column_info.name, 100000
            )
            current = [
                ValueInfo(
                    id=f"{column_info.id}.{value}",
                    value=value,
                    column_id=column_info.id,
                )
                for value in values
            ]
            value_infos.extend(current)
    await self.value_es_repository.index(value_infos)
只有 sync: true 的字段才把取值全量查出来写 ES。ID 这种唯一值字段同步了也没用,用户不会念一串数字;订单状态这种枚举字段才是 ES 的主战场。
6.2.6 _save_metrics_to_meta_db
python
async def _save_metrics_to_meta_db(self, meta_config):
    metric_infos: list[MetricInfo] = []
    column_metrics: list[ColumnMetric] = []
    for metric in meta_config.metrics:
        metric_info = MetricInfo(
            id=metric.name,
            name=metric.name,
            description=metric.description,
            relevant_columns=metric.relevant_columns,
            alias=metric.alias,
        )
        metric_infos.append(metric_info)
        for relevant_column in metric.relevant_columns:
            column_metric = ColumnMetric(
                column_id=relevant_column,
                metric_id=metric.name
            )
            column_metrics.append(column_metric)
    async with self.meta_mysql_repository.session.begin():
        await self.meta_mysql_repository.save_metric_infos(metric_infos)
        await self.meta_mysql_repository.save_column_metrics(column_metrics)
    return metric_infos
指标信息写一张表,字段和指标的多对多关联写另一张表。一个指标可能用到多个字段,一个字段也可能被多个指标引用,这就是多对多。没有这张关联表,AI 想问 GMV 的时候根本不知道该去哪个字段上 SUM。
6.2.7 _save_metric_info_to_qdrant
逻辑和字段向量那步一模一样,把名字、描述、别名各生成一条向量,批量 Embedding 完了写进 Qdrant。区别只是数据源换成 metric_infos,集合换成 data-agent-metric。代码复制粘贴改个名的事儿,就不重复贴了。
6.3 最终落地产物
| 存储系统 | 位置 | 内容 |
|---|---|---|
| MySQL meta 库 | table_info | 每张表的名称、角色、描述 |
| MySQL meta 库 | column_info | 字段名、类型、角色、描述、别名、示例值 |
| MySQL meta 库 | metric_info | 指标名、描述、关联字段、别名 |
| MySQL meta 库 | column_metric | 字段与指标的多对多关联 |
| Qdrant | data-agent-column | 字段名/描述/别名的向量 |
| Qdrant | data-agent-metric | 指标名/描述/别名的向量 |
| Elasticsearch | data-agent-value | 字段取值的全文索引 |
跑完脚本之后,分别去三个地方验一下:MySQL 看四张表有没有数据,Qdrant 打开 dashboard 看 collections,ES 访问 http://localhost:9200/data-agent-value/_count 看文档数。
三个地方都有数,元数据知识库就算搭完了。下一章就开始真正调那个问数智能体,让它对着这套知识库写出能跑的 SQL。
P.S. 无意间发现了一个巨牛的人工智能教程,非常通俗易懂,对AI感兴趣的朋友强烈推荐去看看,传送门https://blog.csdn.net/HHX_01