AI Agent 为什么总是失忆?一篇讲透 Agent Memory
一、前言:为什么 AI Agent 总是在"失忆"?
如果你经常使用 ChatGPT、Claude、Codex、Claude Code 或者自己开发过 AI Agent,可能遇到过一个非常典型的问题:
AI 很聪明,但是它很健忘。
比如第一次交流时,你告诉 Agent:
text
我是一名 Java 开发者。

我的项目使用:
Spring Boot 3
MySQL
Redis
Vue 3

以后给我后端代码的时候,优先使用 Java。
在当前会话中,AI 通常能够很好地遵守这个要求。
你继续问:
text
帮我写一个用户登录接口。它会自然地给你:
java
@RestController
@RequestMapping("/api/auth")
public class AuthController {

    @PostMapping("/login")
    public Result<LoginVO> login(@RequestBody LoginDTO dto) {
        // ...
    }
}
看起来没有任何问题。
但是如果我们:
text
关闭当前 Session
        ↓
第二天重新创建 Session
        ↓
再次询问 AI
然后问:
text
帮我写一个用户登录接口。如果应用层没有额外的 Memory 机制,它可能直接给你:
python
@app.post("/login")
def login():
    pass
昨天聊了几个小时的内容仿佛全部消失了。
这就是 AI Agent 开发中一个非常核心的问题:
Memory。
很多刚开始接触大模型的人会认为:
AI 不是已经学习了海量数据吗?为什么连我昨天告诉它的事情都记不住?
原因其实很简单:
模型拥有知识,不代表模型拥有你的长期记忆。
从工程角度看,大语言模型本身更接近一个:
text
输入 Context
      ↓
     LLM
      ↓
生成 Output
而不是:
text
输入
 ↓
思考
 ↓
永久记住
 ↓
下次自动回忆
Letta 对这个问题的解释非常直接:LLM 本质上是无状态的计算单元;如果之前的输入没有重新提供给模型,它不会因为曾经处理过这些输入,就天然保留那次会话的记忆。
所以真正拥有"长期记忆"的往往不是模型本身。
而是:
Agent System。
二、先搞清楚一个概念:LLM 并不等于 Agent
很多关于 Agent Memory 的误解,其实来自一个基础概念没有区分清楚:
text
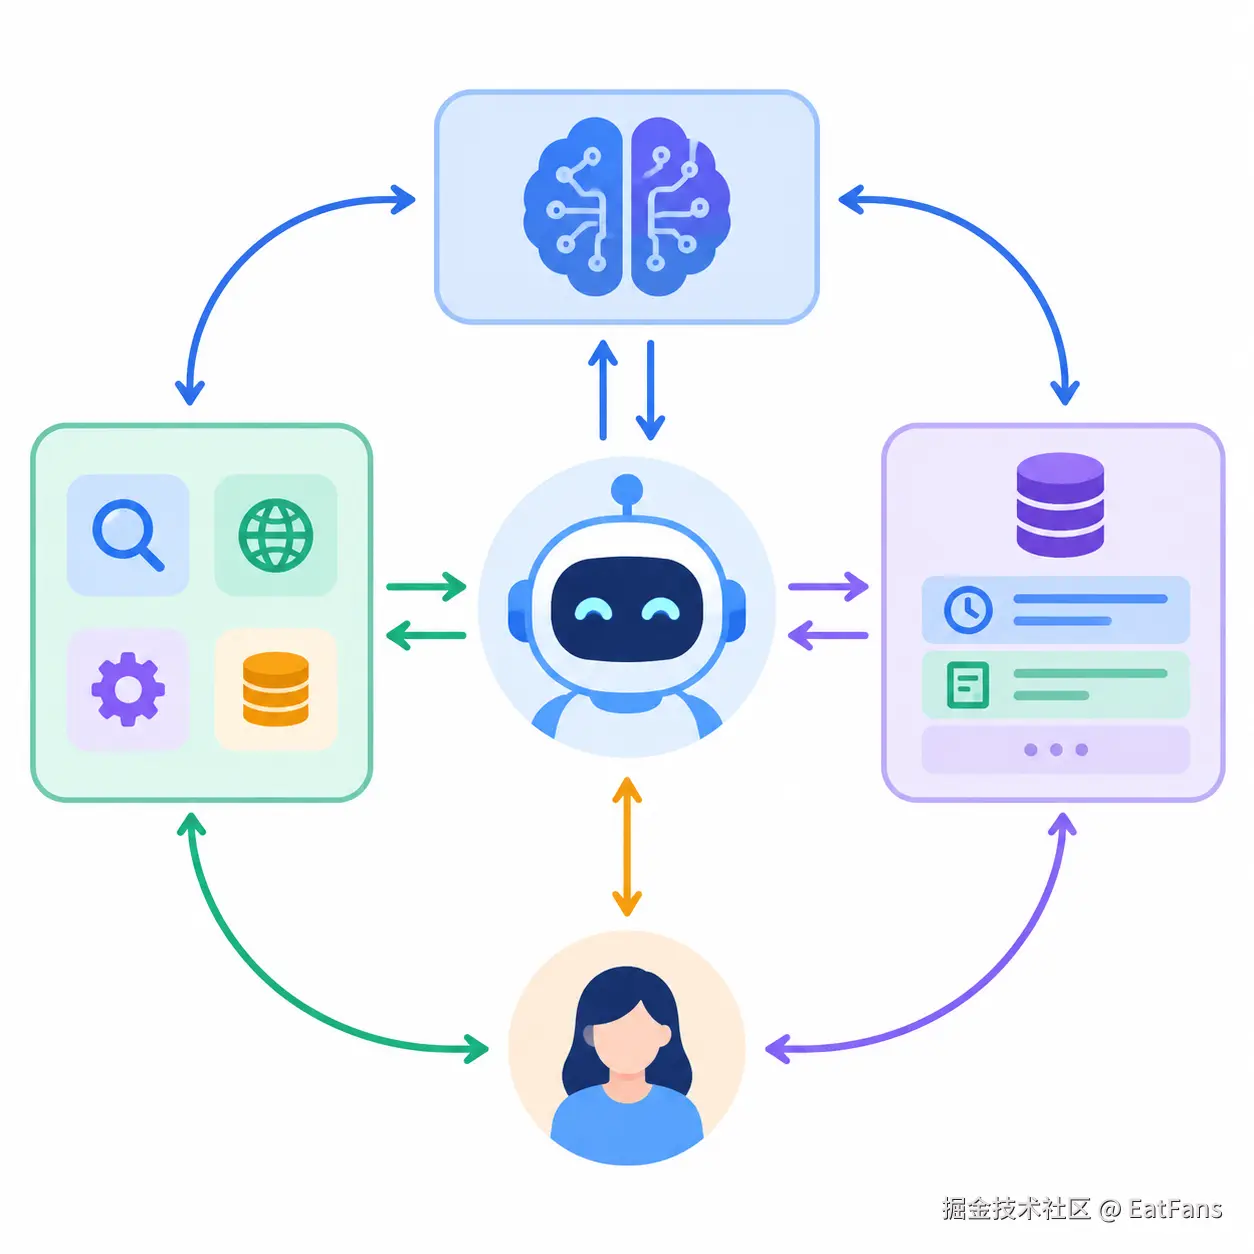
LLM ≠ AgentLLM 可以理解成 Agent 的"大脑",但一个完整 Agent 通常还需要:
text
┌───────────────────────────────┐
│            AI Agent           │
│                               │
│   ┌───────────────────────┐   │
│   │          LLM          │   │
│   └───────────────────────┘   │
│              │                │
│   ┌──────────┴───────────┐    │
│   │                      │    │
│   ▼                      ▼    │
│ Tools                  Memory │
│   │                      │    │
│   ▼                      ▼    │
│ MCP / API          Vector DB  │
│ Browser            Database   │
│ Shell              Files      │
│ Code               Graph DB   │
│                               │
└───────────────────────────────┘
LLM 负责:
text
理解
推理
生成
决策
Tools 负责:
text
搜索
执行代码
调用 API
操作浏览器
读写文件
而 Memory 负责:
text
记住过去
      ↓
在未来需要的时候找到过去
      ↓
重新放入 Context
所以严格来说:
不是让 LLM 本身突然获得无限记忆,而是在 LLM 外面建立一套 Memory System。
这点非常重要。
三、为什么 LLM 天生会"失忆"?
先看最简单的大模型调用。
假设调用一个模型:
python
response = client.responses.create(
    model="xxx",
    input="我最喜欢喝冰美式"
)
模型生成:
text
好的。然后程序结束。
第二次调用:
python
response = client.responses.create(
    model="xxx",
    input="我最喜欢喝什么?"
)
对于一个没有任何外部状态管理的基础调用来说:
text
第一次请求
────────────────

我喜欢冰美式
      ↓
     LLM
      ↓
     好的


第二次请求
────────────────

我喜欢喝什么?
      ↓
     LLM
      ↓
    ???
问题就在这里。
第二次推理的时候,模型并没有自动获得第一次请求的内容。
如果希望它知道,就需要重新提供:
python
messages = [
    {
        "role": "user",
        "content": "我最喜欢喝冰美式"
    },
    {
        "role": "assistant",
        "content": "好的"
    },
    {
        "role": "user",
        "content": "我最喜欢喝什么?"
    }
]
这样模型才能根据上下文回答:
text
冰美式。于是我们获得了最原始的一种"记忆"。
Chat History。
四、Chat History 算不算 Memory?
算。
但它只是非常初级的一种 Memory。
最简单的 AI 应用基本都是:
text
User
 │
 ▼
Chat History
 │
 ▼
Prompt
 │
 ▼
LLM
 │
 ▼
Response
 │
 └───────────────┐
                 │
                 ▼
             Chat History
例如数据库保存:
sql
CREATE TABLE chat_message (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    session_id VARCHAR(64),
    role VARCHAR(20),
    content TEXT,
    create_time DATETIME
);
每次请求的时候:
python
history = db.query("""
    SELECT role, content
    FROM chat_message
    WHERE session_id = ?
    ORDER BY create_time
""")
然后全部拼接:
python
messages = history + [
    {
        "role": "user",
        "content": current_message
    }
]
这样 AI 看起来就"记住"之前发生的事情了。
但很快会出现一个问题。
假设你跟 Agent 聊了一年:
text
第 1 条消息
第 2 条消息
第 3 条消息
...
第 100000 条消息
难道每次调用模型,都把十万条消息重新发进去?
显然不现实。
五、Context Window 这么大,为什么还需要 Memory?
这是 Agent Memory 里非常容易产生误解的问题。
现在模型 Context Window 已经越来越大。
于是有人会认为:
Context 足够大以后,Memory 就没有意义了。
实际上并不是。
假设一个 Agent 有:
text
1,000,000 Token Context看起来非常巨大。
但如果这是一个长期运行的 Coding Agent:
text
项目源码
+ Git History
+ Issue
+ PR
+ 用户聊天
+ Shell Output
+ Test Result
+ Browser Result
+ API Response
+ Agent 思考产生的中间状态
数据量仍然可以快速增长。
更关键的是:
能塞进去,不等于应该塞进去。
假设过去半年产生了:
text
100 MB Agent History用户现在只是问:
text
我这个项目数据库用的是什么?真正需要的信息可能只有:
text
Database: MySQL 8.4如果为了这一句话,把半年聊天全部塞给模型:
text
半年聊天记录
      ↓
几百万 Token
      ↓
      LLM
      ↓
寻找一个答案
不仅成本高,而且会引入大量无关噪声。
更合理的方式是:
text
用户问题
   │
   ▼
Memory Retrieval
   │
   ▼
找到相关 Memory
   │
   ▼
Database = MySQL 8.4
   │
   ▼
放入 Context
   │
   ▼
LLM
这也是为什么 Memory 的核心并不是:
保存所有东西。
而是:
在正确的时候,把正确的过去重新带回当前上下文。
LangChain 在 2026 年关于 Agent Memory 的说明里,也将 Memory 描述为可以跨运行检索、并影响 Agent 后续行为的 durable context。
单纯保存 Trace、Log 或 Transcript 并不等于真正拥有 Memory。
真正重要的是:
text
过去发生了什么
        ↓
提取有价值的信息
        ↓
持久化
        ↓
未来需要时检索
        ↓
重新进入 Context
        ↓
改变 Agent 行为
六、Agent Memory 到底是什么?
现在可以给 Agent Memory 一个比较工程化的定义:
Agent Memory 是一套负责从 Agent 运行过程中提取、存储、组织、检索、更新和遗忘信息,并在未来适当时机重新注入模型 Context 的系统。
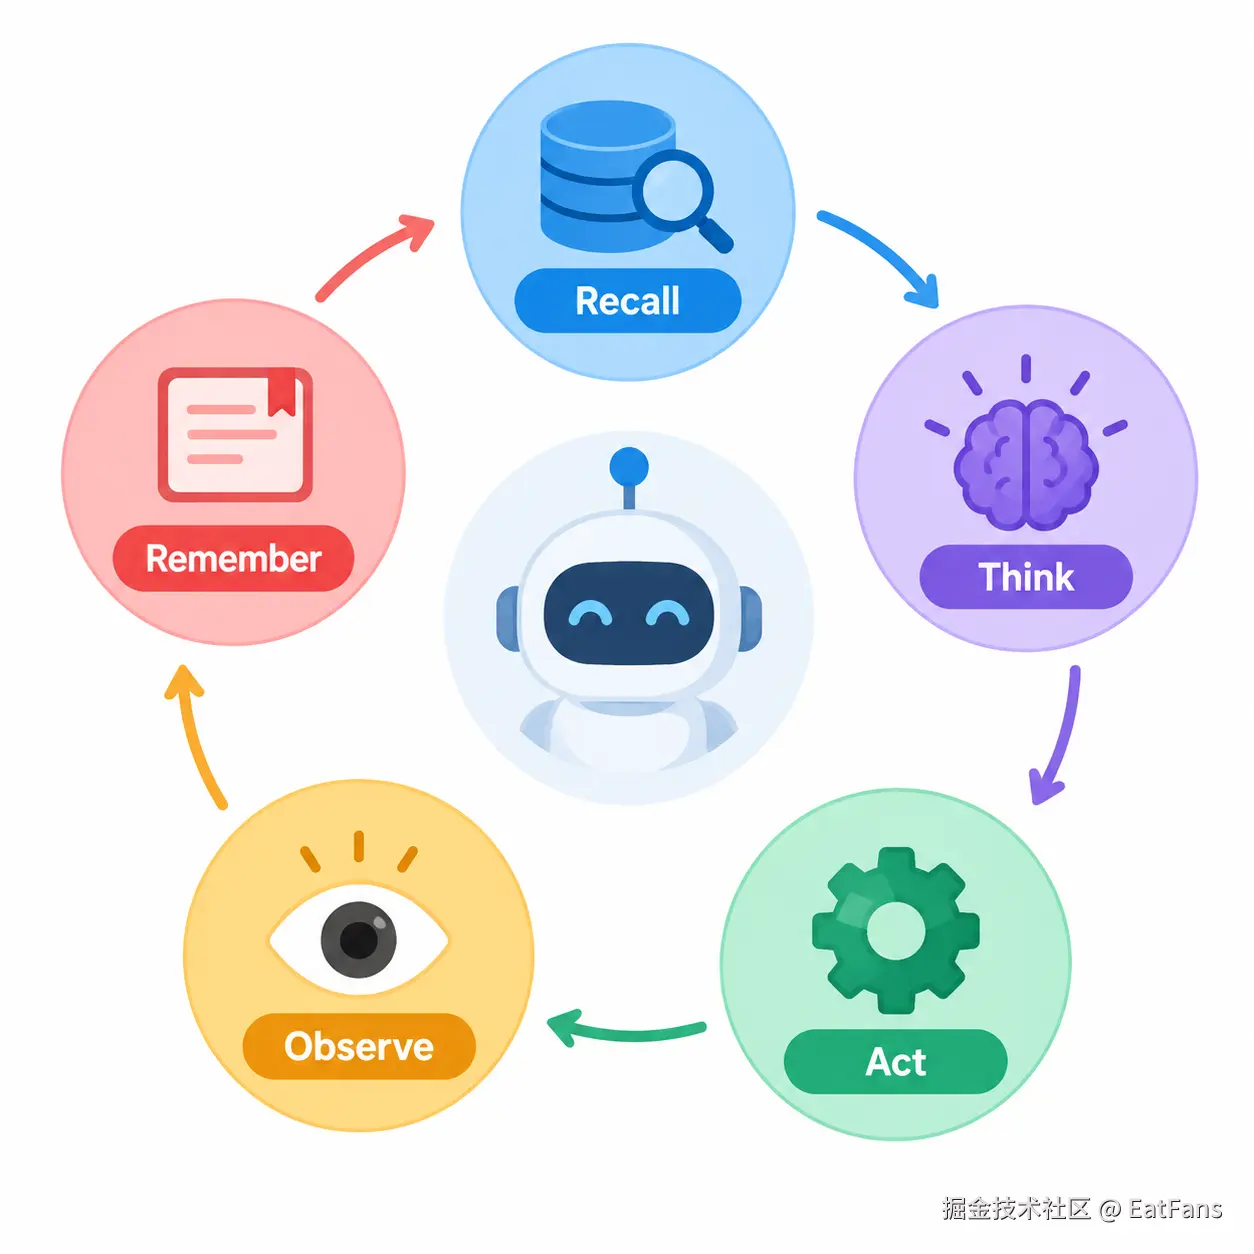
可以把完整流程画成:
text
                 User Input
                     │
                     ▼
             ┌──────────────┐
             │ Memory Search│
             └──────┬───────┘
                    │
          relevant memories
                    │
                    ▼
          ┌─────────────────┐
          │ Context Builder │
          └────────┬────────┘
                   │
                   ▼
                ┌─────┐
                │ LLM │
                └──┬──┘
                   │
                   ▼
               Response
                   │
                   ▼
          ┌─────────────────┐
          │ Memory Extractor│
          └────────┬────────┘
                   │
                   ▼
             Memory Store
换成一句话:
text
Recall → Think → Act → Observe → Remember这才是一个拥有长期记忆能力的 Agent。
七、Agent Memory 可以分成哪些类型?
不同框架的定义并不完全相同。
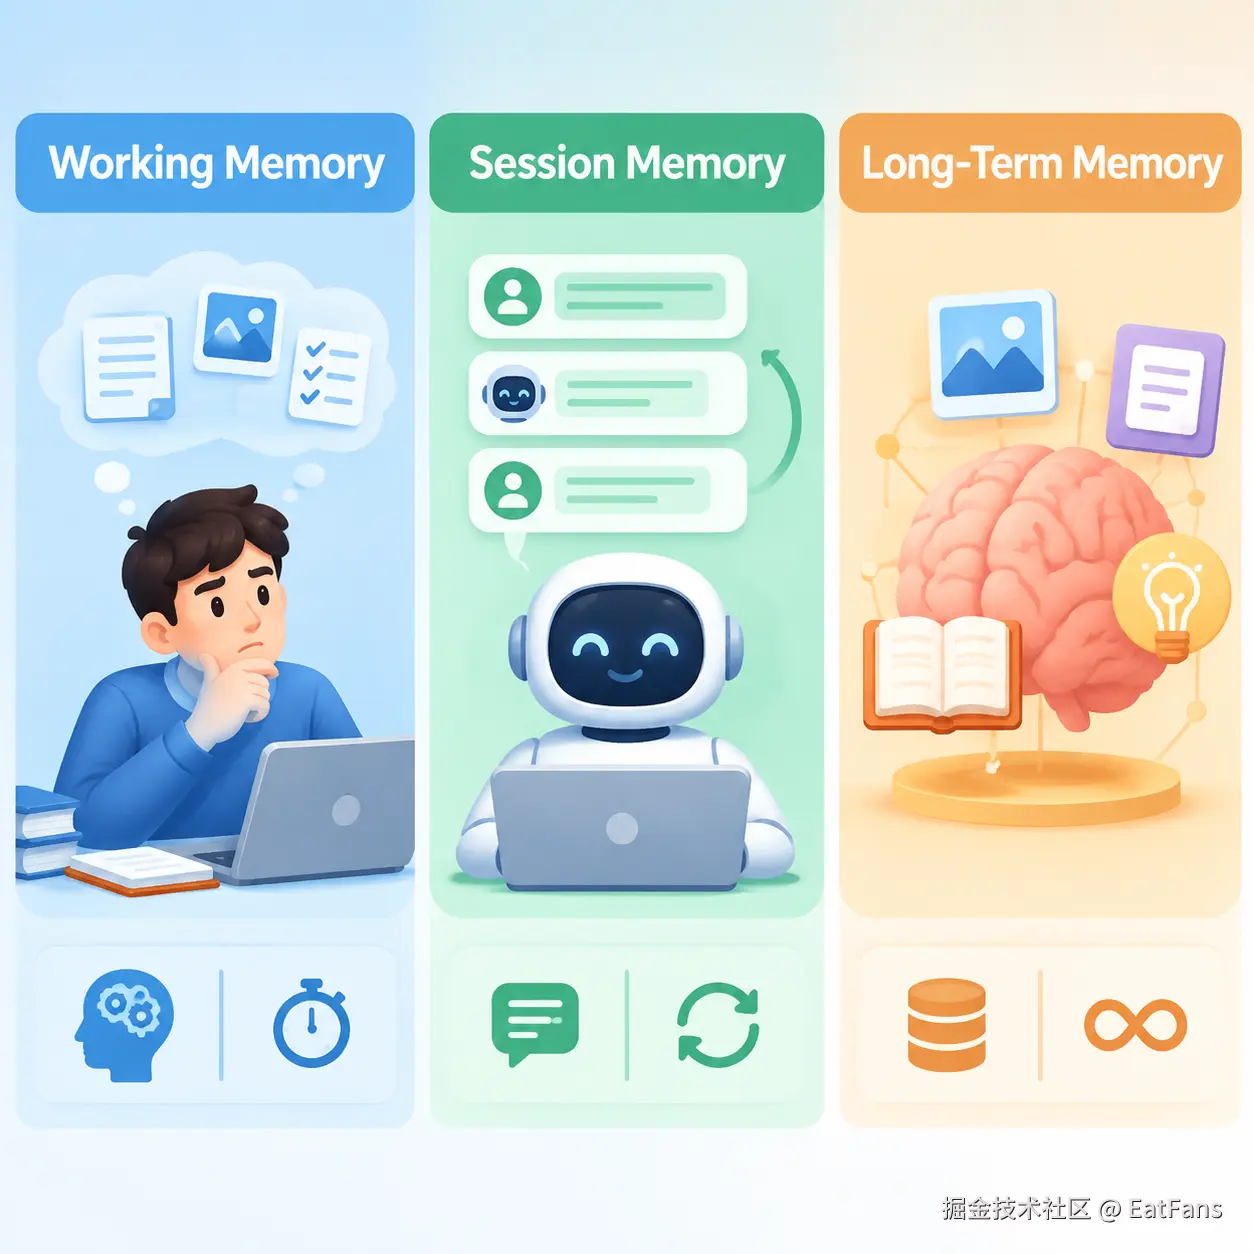
但为了工程理解,我们可以先分成几个层次。
1. Working Memory
也就是:
工作记忆。
负责当前任务。
比如 Coding Agent 正在修复:
text
UserService.login() 登录失败当前可能需要:
text
当前任务目标
当前修改文件
最近 Tool Result
Shell Output
测试失败信息
Todo List
例如:
json
{
  "task": "fix login bug",
  "current_file": "UserService.java",
  "last_test": "LoginServiceTest failed",
  "todo": [
    "check password encoder",
    "fix token generation",
    "run tests"
  ]
}
这些内容通常:
text
生命周期很短任务结束以后就可能没有长期保存价值。
2. Session Memory
Session Memory 是:
当前会话范围内的记忆。
例如:
text
Session A
├── Message 1
├── Message 2
├── Tool Call
├── Message 3
└── Summary
换一个 Session:
text
Session B默认情况下可能无法直接访问 Session A。
这非常类似我们平时看到的:
text
Conversation / Thread / Chat3. Long-Term Memory
真正有意思的是:
Long-Term Memory。
它能够跨 Session 存在。
例如:
text
Session A
2026-01-01

用户:
我的项目使用 PostgreSQL。
Memory:
json
{
    "user_id": "10001",
    "memory": "用户的项目使用 PostgreSQL"
}
三个月后:
text
Session B
2026-04-01
用户问:
text
帮我设计一下数据库索引。Agent 可以先查询:
text
Memory Search得到:
text
项目数据库:PostgreSQL然后回答自然就会针对 PostgreSQL。
这才是真正意义上的:
text
Cross-Session MemoryLangGraph 就明确区分了 thread-scoped 的短期状态和 cross-thread 的长期 Memory。
八、长期记忆还可以继续拆分
如果进一步参考认知科学以及现在 Agent Framework 的设计,还可以把长期 Memory 分成:
text
Long-Term Memory
│
├── Semantic Memory
│
├── Episodic Memory
│
└── Procedural Memory
这三个概念非常值得理解。
九、Semantic Memory:记住"事实"
Semantic Memory 可以理解成:
事实记忆。
例如:
text
用户是一名 Java 开发者
用户喜欢 Spring Boot
项目数据库使用 MySQL
项目部署在 Docker
用户不喜欢生成 Emoji
保存以后可能是:
json
{
  "type": "semantic",
  "subject": "user",
  "content": "User prefers Java for backend development."
}
这类 Memory 回答的是:
text
What do I know?也就是:
我知道什么?
这也是目前很多 Agent Memory 产品最常实现的一层。
十、Episodic Memory:记住"发生过什么"
Episodic Memory 是:
事件记忆。
例如:
text
2026-09-01
用户尝试升级 Spring Boot,失败。

原因:
Redis Client API Breaking Change。

解决方案:
升级 Redisson。
这不是单纯事实。
而是一段:
text
Experience未来如果再次遇到:
text
Spring Boot 升级后 Redis 启动失败Agent 可以检索过去经验:
text
之前遇到类似问题
        ↓
当时是 Redisson 版本不兼容
        ↓
优先检查 dependency
这就非常接近:
从经验中学习。
对于 Coding Agent 来说尤其重要。
十一、Procedural Memory:记住"应该怎么做"
第三种:
Procedural Memory。
它保存的是:
text
How should I do something?比如用户不断纠正 Agent:
text
不要直接提交代码。

修改完成后必须:

1. mvn test
2. npm run lint
3. git diff
4. 用户确认
5. 再 commit
Agent 最终可以形成:
yaml
workflow:
  after_code_change:
    - mvn test
    - npm run lint
    - git diff
    - request_confirmation
以后执行任务时自动遵循。
这就已经不是简单的:
text
"记住用户喜欢 Java"而是:
text
"学习用户的工作方式"这也是 Agent Memory 真正开始变得强大的地方。
十二、Memory 和 RAG 到底有什么区别?
这也是最容易混淆的概念之一。
有人会说:
Memory 不就是 RAG 吗?
不完全是。
RAG:
text
Retrieval-Augmented Generation典型流程:
text
Document
   │
   ▼
Chunk
   │
   ▼
Embedding
   │
   ▼
Vector Database


User Query
   │
   ▼
Embedding
   │
   ▼
Similarity Search
   │
   ▼
Relevant Documents
   │
   ▼
LLM
Agent Memory 确实可以使用完全相同的技术:
text
Memory
 ↓
Embedding
 ↓
Vector DB
 ↓
Search
但是两者关注的问题不同。
RAG 通常关注:
text
外部知识比如:
text
公司文档
PDF
Wiki
API 文档
产品手册
而 Memory 更关注:
text
Agent 过去经历过什么
用户是谁
用户有什么偏好
之前做过什么
哪些策略成功过
哪些错误已经发生过
简单理解:
| RAG | Agent Memory |
|---|---|
| 找知识 | 找过去 |
| 外部文档 | 用户/Agent 经历 |
| 相对静态 | 持续变化 |
| Knowledge Retrieval | Experience Retrieval |
| 通常由系统写入 | 可以由 Agent 自己形成 |
但是底层技术可以高度重叠。
所以:
text
Memory ≠ Vector Database
Memory ≠ RAG
Vector Database 只是实现 Memory 的一种工具。
十三、Agent Memory 最简单怎么实现?
我们自己实现一个最简单版本。
数据库:
sql
CREATE TABLE agent_memory (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,

    user_id VARCHAR(64) NOT NULL,

    memory_type VARCHAR(32),

    content TEXT NOT NULL,

    importance FLOAT DEFAULT 0.5,

    embedding_id VARCHAR(128),

    created_at DATETIME,

    updated_at DATETIME
);
用户说:
text
我的后端项目统一使用 Java 21。通过 LLM 提取:
json
{
  "type": "semantic",
  "content": "用户的后端项目默认使用 Java 21",
  "importance": 0.8
}
保存:
python
memory_repository.save(
    user_id=user_id,
    memory_type="semantic",
    content="用户的后端项目默认使用 Java 21",
    importance=0.8
)
下次用户问:
text
帮我创建一个 Spring Boot 项目。查询 Memory:
python
memories = memory.search(
    query="创建 Spring Boot 项目",
    user_id=user_id
)
得到:
text
用户的后端项目默认使用 Java 21Prompt:
text
System:

Relevant User Memory:

- 用户的后端项目默认使用 Java 21

User:

帮我创建一个 Spring Boot 项目。
模型自然会选择:
xml
<java.version>21</java.version>一个最简单的 Agent Memory 就完成了。
十四、真正困难的不是 Store,而是"记什么"
做到这里,你可能会发现:
text
保存数据一点都不难。
MySQL 都能做。
真正困难的问题是:
什么值得记?
假设用户说:
text
今天有点热。要不要记?
text
用户今天觉得天气热如果永久保存,这条 Memory 几乎没有价值。
用户说:
text
我以后所有 Java 项目统一使用 Java 21。这就明显值得保存。
因此需要:
text
Memory Extraction例如让 LLM 判断:
text
Please extract information that may be useful
in future conversations.

Ignore:
- temporary statements
- casual conversation
- redundant facts
输入:
text
我今天有点困,不过这个项目以后统一用 Java 21。输出:
json
[
  {
    "content": "该项目统一使用 Java 21",
    "importance": 0.9
  }
]
而:
text
今天有点困直接丢弃。
这一步实际上决定了 Memory System 的质量。
十五、Mem0 是怎么解决这个问题的?
目前 Agent Memory 领域一个很有代表性的开源项目就是:
Mem0
GitHub:
Mem0 的核心思路非常容易理解:
text
User Input
    │
    ▼
Retrieve Memory
    │
    ▼
Enrich Prompt
    │
    ▼
LLM
    │
    ▼
Response
    │
    ▼
Extract Memory
    │
    ▼
Store
Mem0 当前官方架构中,会处理:
text
Extraction
Deduplication
Conflict Resolution
Semantic Retrieval
也就是说,不是简单:
text
INSERT INTO memory而是需要判断:
text
这是新 Memory?
      │
      ├── 是 → ADD
      │
      ├── 已存在 → 去重
      │
      └── 与旧信息冲突 → 处理生命周期
例如过去:
text
User prefers Java 17现在:
text
User prefers Java 21如果两个全部保留:
text
Java 17
Java 21
未来 Retrieval 就可能产生冲突。
因此 Memory System 还必须考虑:
text
Memory Lifecycle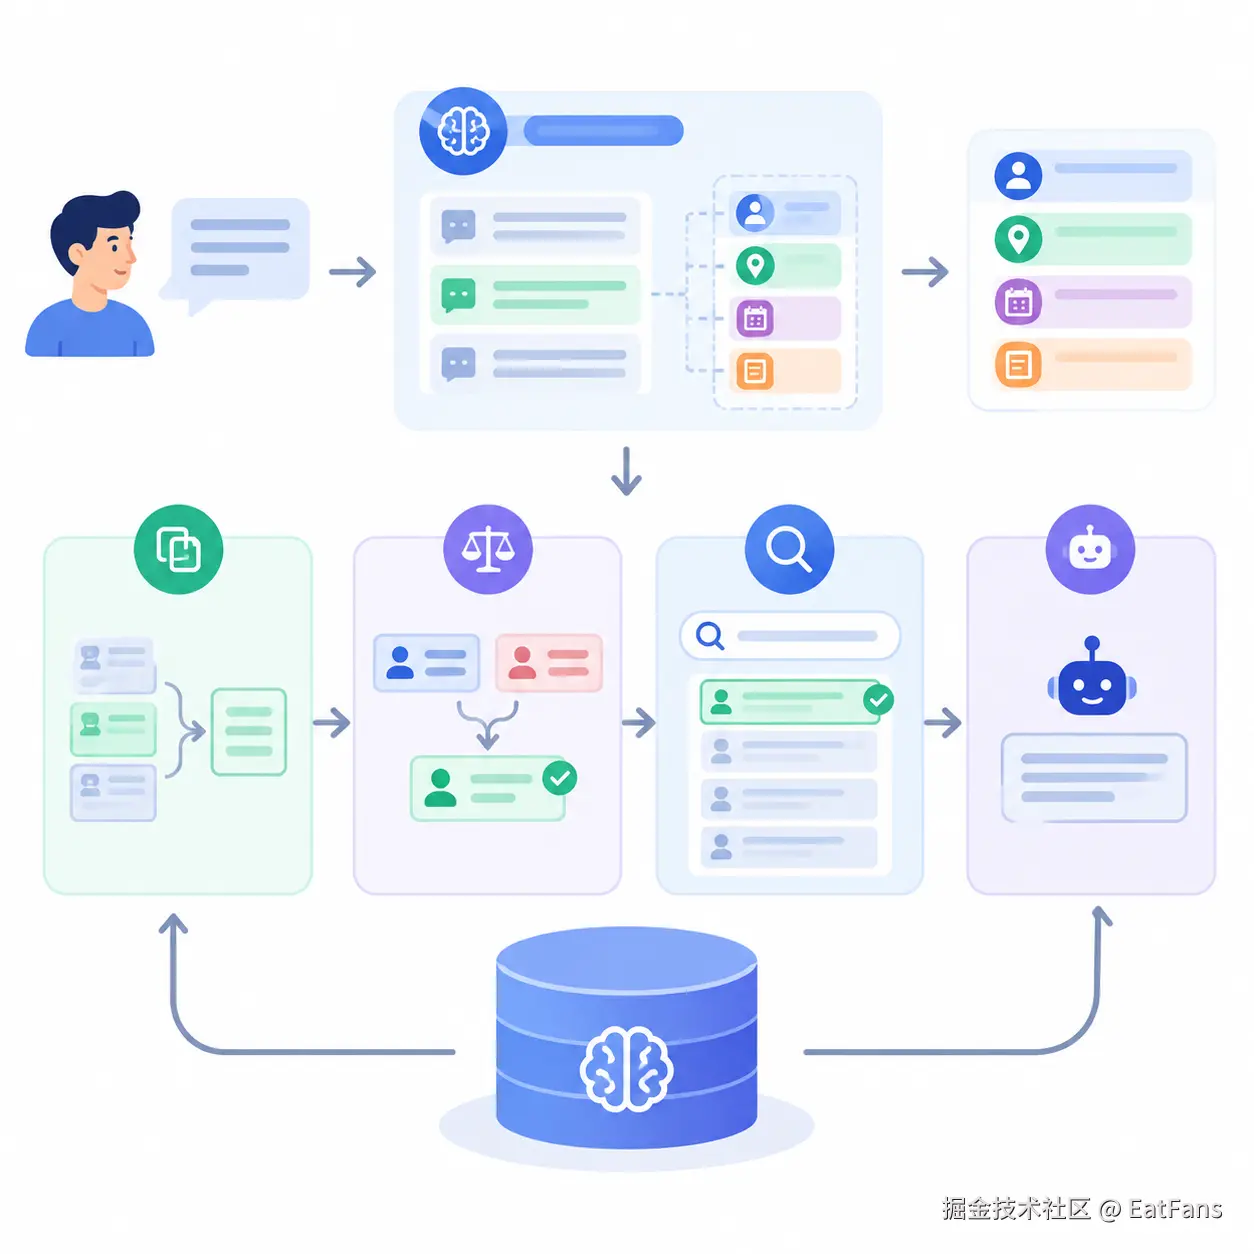
十六、用 Mem0 给 Agent 加长期记忆
例如:
python
from mem0 import Memory

memory = Memory()
保存:
python
messages = [
    {
        "role": "user",
        "content": "我的后端项目默认使用 Java 21"
    }
]

memory.add(
    messages,
    user_id="user_10001"
)
然后用户过几天问:
text
帮我创建一个 Spring Boot 项目。检索:
python
results = memory.search(
    query="Spring Boot 项目技术配置",
    user_id="user_10001"
)
得到相关 Memory 后:
python
memory_context = "\n".join(
    item["memory"]
    for item in results["results"]
)
最终:
python
prompt = f"""
Relevant memories:

{memory_context}

User request:

{user_input}
"""
然后交给模型。
于是:
text
Session A
   │
   ▼
Memory Store
   │
   │  三个月以后
   │
   ▼
Session B
   │
   ▼
Memory Retrieval
Session 已经不是 Memory 的边界。
十七、为什么不能把所有聊天记录都直接存进 Vector DB?
这是另一个非常常见的错误设计。
很多人第一次做 Memory:
text
所有聊天
   ↓
Embedding
   ↓
Vector DB
看起来没问题。
但是半年以后:
text
Memory 1:今天有点困
Memory 2:服务器刚才重启了
Memory 3:这个 Bug 修好了
Memory 4:Java 17
Memory 5:Java 21
Memory 6:测试账号 123
Memory 7:测试账号已经删除
...
然后用户问:
text
项目用什么 Java?搜索出来:
text
Java 17
Java 21
Java 8
JavaScript
整个 Memory Store 逐渐变成:
Memory Garbage Dump。
所以一个成熟 Memory System 必须考虑:
text
Write
Retrieve
Update
Merge
Forget
Expire
而不是只有:
text
Write十八、AI 也必须学会"忘记"
这可能是 Agent Memory 最反直觉的一件事:
好的 Memory System 必须会忘。
人脑其实也是如此。
如果你把人生中:
text
每一句话
每一张图片
每一个声音
每一个细节
全部同等优先级永久保存,反而很难快速找到真正重要的信息。
Agent 也是一样。
可以设计:
text
Memory Score例如:
text
score =
    semantic_similarity * 0.4
  + importance          * 0.3
  + recency             * 0.2
  + frequency           * 0.1
其中:
text
semantic_similarity表示和当前问题的相关程度。
text
importance表示这条 Memory 本身的重要程度。
text
recency表示最近是否使用过。
text
frequency表示过去是否经常被使用。
最终:
python
if score < threshold:
    archive(memory)
甚至:
python
if memory.expired():
    delete(memory)
Mem0 目前也支持为 Memory 设置 expiration date,使过期内容默认不再参与搜索。
这说明 Agent Memory 已经不只是:
text
记住而是:
text
记住
整理
更新
遗忘
十九、Letta / MemGPT:把 LLM 当成操作系统看
Agent Memory 另一个非常值得研究的路线来自:
text
MemGPT
      ↓
Letta
MemGPT 提出了一个非常有意思的思路:
如果 Context Window 类似 RAM,那么外部 Memory 就类似 Disk。
于是:
text
Computer

RAM
 │
 ├── 当前程序
 ├── 当前数据
 └── 高频数据

Disk
 │
 └── 长期数据
对应:
text
AI Agent

Context Window
 │
 ├── System Prompt
 ├── Current Task
 ├── Core Memory
 └── Recent Messages

External Memory
 │
 ├── Conversation History
 ├── Archival Memory
 └── Long-Term Knowledge
Letta 进一步提出:
text
Memory Blocks例如:
text
┌─────────────────────────────┐
│        Context Window       │
│                             │
│ System Prompt               │
│                             │
│ ┌─────────────────────────┐ │
│ │ Human Memory            │ │
│ │                         │ │
│ │ Java developer          │ │
│ │ prefers concise answer  │ │
│ └─────────────────────────┘ │
│                             │
│ ┌─────────────────────────┐ │
│ │ Persona Memory          │ │
│ │                         │ │
│ │ Coding assistant        │ │
│ └─────────────────────────┘ │
│                             │
│ Recent Messages             │
└─────────────────────────────┘
更有意思的是:
Agent 可以修改自己的 Memory。
例如:
text
memory_replace()
memory_append()
这意味着 Memory 不再完全由应用层偷偷管理。
Agent 自己也参与:
text
Memory Management这已经很接近一种:
text
LLM Operating System的思想。
二十、Agent Memory 和数据库有什么区别?
看到这里有人可能会说:
这不就是数据库?
底层当然可以是数据库。
但是 Memory System ≠ Database。
数据库负责:
text
StorageMemory System 负责:
text
Information Extraction
        ↓
Storage
        ↓
Index
        ↓
Retrieval
        ↓
Ranking
        ↓
Conflict Resolution
        ↓
Context Injection
        ↓
Lifecycle
所以底层可能同时存在:
text
MySQL
Redis
Vector Database
Graph Database
File System
例如:
text
                    Memory System
                         │
        ┌────────────────┼────────────────┐
        │                │                │
        ▼                ▼                ▼
    Relational        Vector DB        Graph DB
     Database
        │                │                │
        ▼                ▼                ▼
 Structured Data   Semantic Search   Relationship
不同存储解决不同问题。
二十一、为什么 Agent Memory 开始使用 Graph?
假设 Memory:
text
张三是 A 项目负责人
A 项目属于 JunoYi
李四参与 A 项目
A 项目使用 Spring Boot
单纯 Vector Search 可以找到相似文本。
但如果问:
text
张三负责的项目使用什么技术?实际上需要关系:
text
张三
 │
负责
 ▼
A项目
 │
使用
 ▼
Spring Boot
这就天然适合:
text
Knowledge Graph所以现在部分 Memory 系统开始采用:
text
Vector Memory
+
Graph Memory
Vector 负责:
text
"哪些东西语义上相关?"Graph 负责:
text
"这些东西之间是什么关系?"两者结合以后,Memory Retrieval 会更强。
二十二、真正的 Agent Memory 架构应该是什么样?
如果让我设计一个比较完整的 Agent Memory,我会拆成:
text
                        User
                          │
                          ▼
                 ┌────────────────┐
                 │ Memory Router  │
                 └───────┬────────┘
                         │
                         ▼
                 ┌────────────────┐
                 │ Memory Search  │
                 └───────┬────────┘
                         │
            ┌────────────┼─────────────┐
            │            │             │
            ▼            ▼             ▼
         Vector DB      SQL DB       Graph DB
            │            │             │
            └────────────┼─────────────┘
                         │
                         ▼
                    Reranking
                         │
                         ▼
                  Context Builder
                         │
                         ▼
                        LLM
                         │
                         ▼
                      Agent
                         │
                         ▼
                 Memory Extractor
                         │
                         ▼
                 Memory Evaluator