上文讲到针对自部署的Deepseek v4 flash推理服务缺少识图能力,我们在网关层面加上了一双眼睛的方案。
今天重温下自研推理工程的设计架构, 也便于我们深刻理解推理工程中的可能的优化点。
整体如图 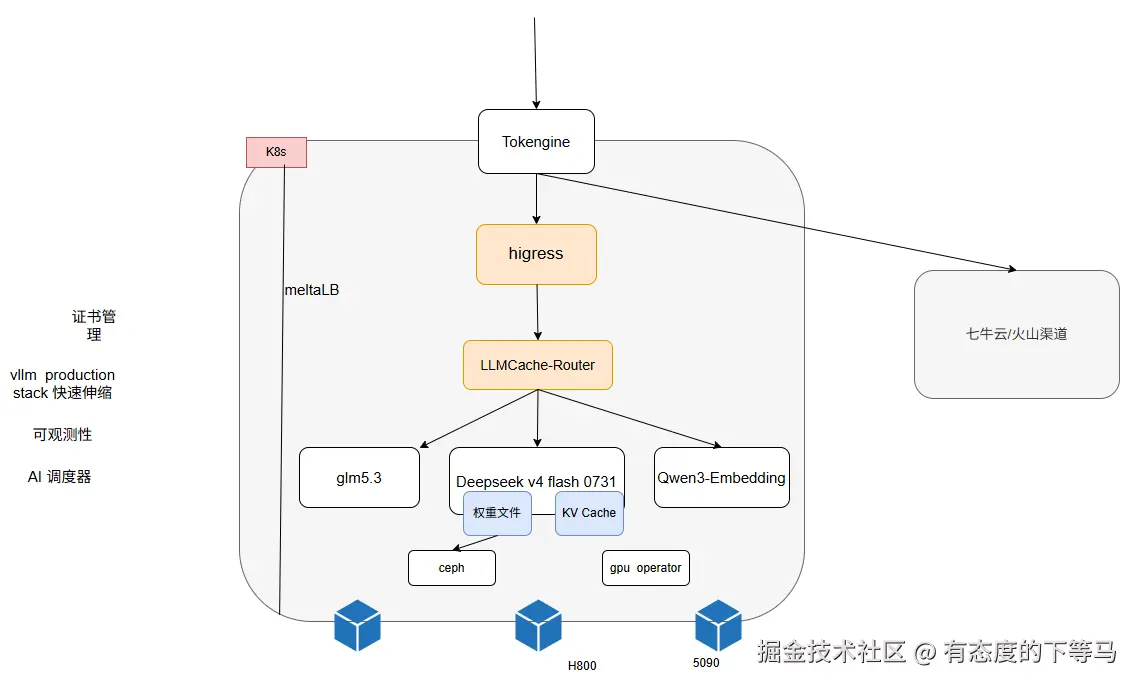
1. vllm
vLLM 代表虚拟大语言模型,vLLM包括一个推理服务器和一个推理引擎(加速推理), 通过PagedAttention算法加速GPU显存的使用 来提高吞吐量。
为理解请求,LLM 需要了解字词之间的关系以及如何在字词之间建立关联,LLM 是通过数学运算来"推理"的, 面对大量用户请求时, 需要消耗大量显存。
从本质上讲,vLLM 作为一组指令,通过持续对用户响应进行"批处理",促使 KV 缓存创建快捷方式。
① KV Cache: 是一种短期内存存储, 它是将每个token(词元)所对应的KV保存到缓存中, 以空间换时间的方式支持快速推理。
② 连续批处理:是一种可同时处理多个查询的技术(将先前计算的查询词元创建快捷方式),。
借助vLLM,LLM可以将批处理请求中重复部分的词元("what is the capital of")保存在短期记忆(KV 缓存)中,并发送一个"翻译请求",而不是两个单独的请求。
2. vllm prooduction stack
- 快速扩缩容
- 可观测性
- 通过请求路由 和KV Cache 卸载来提升推理性能
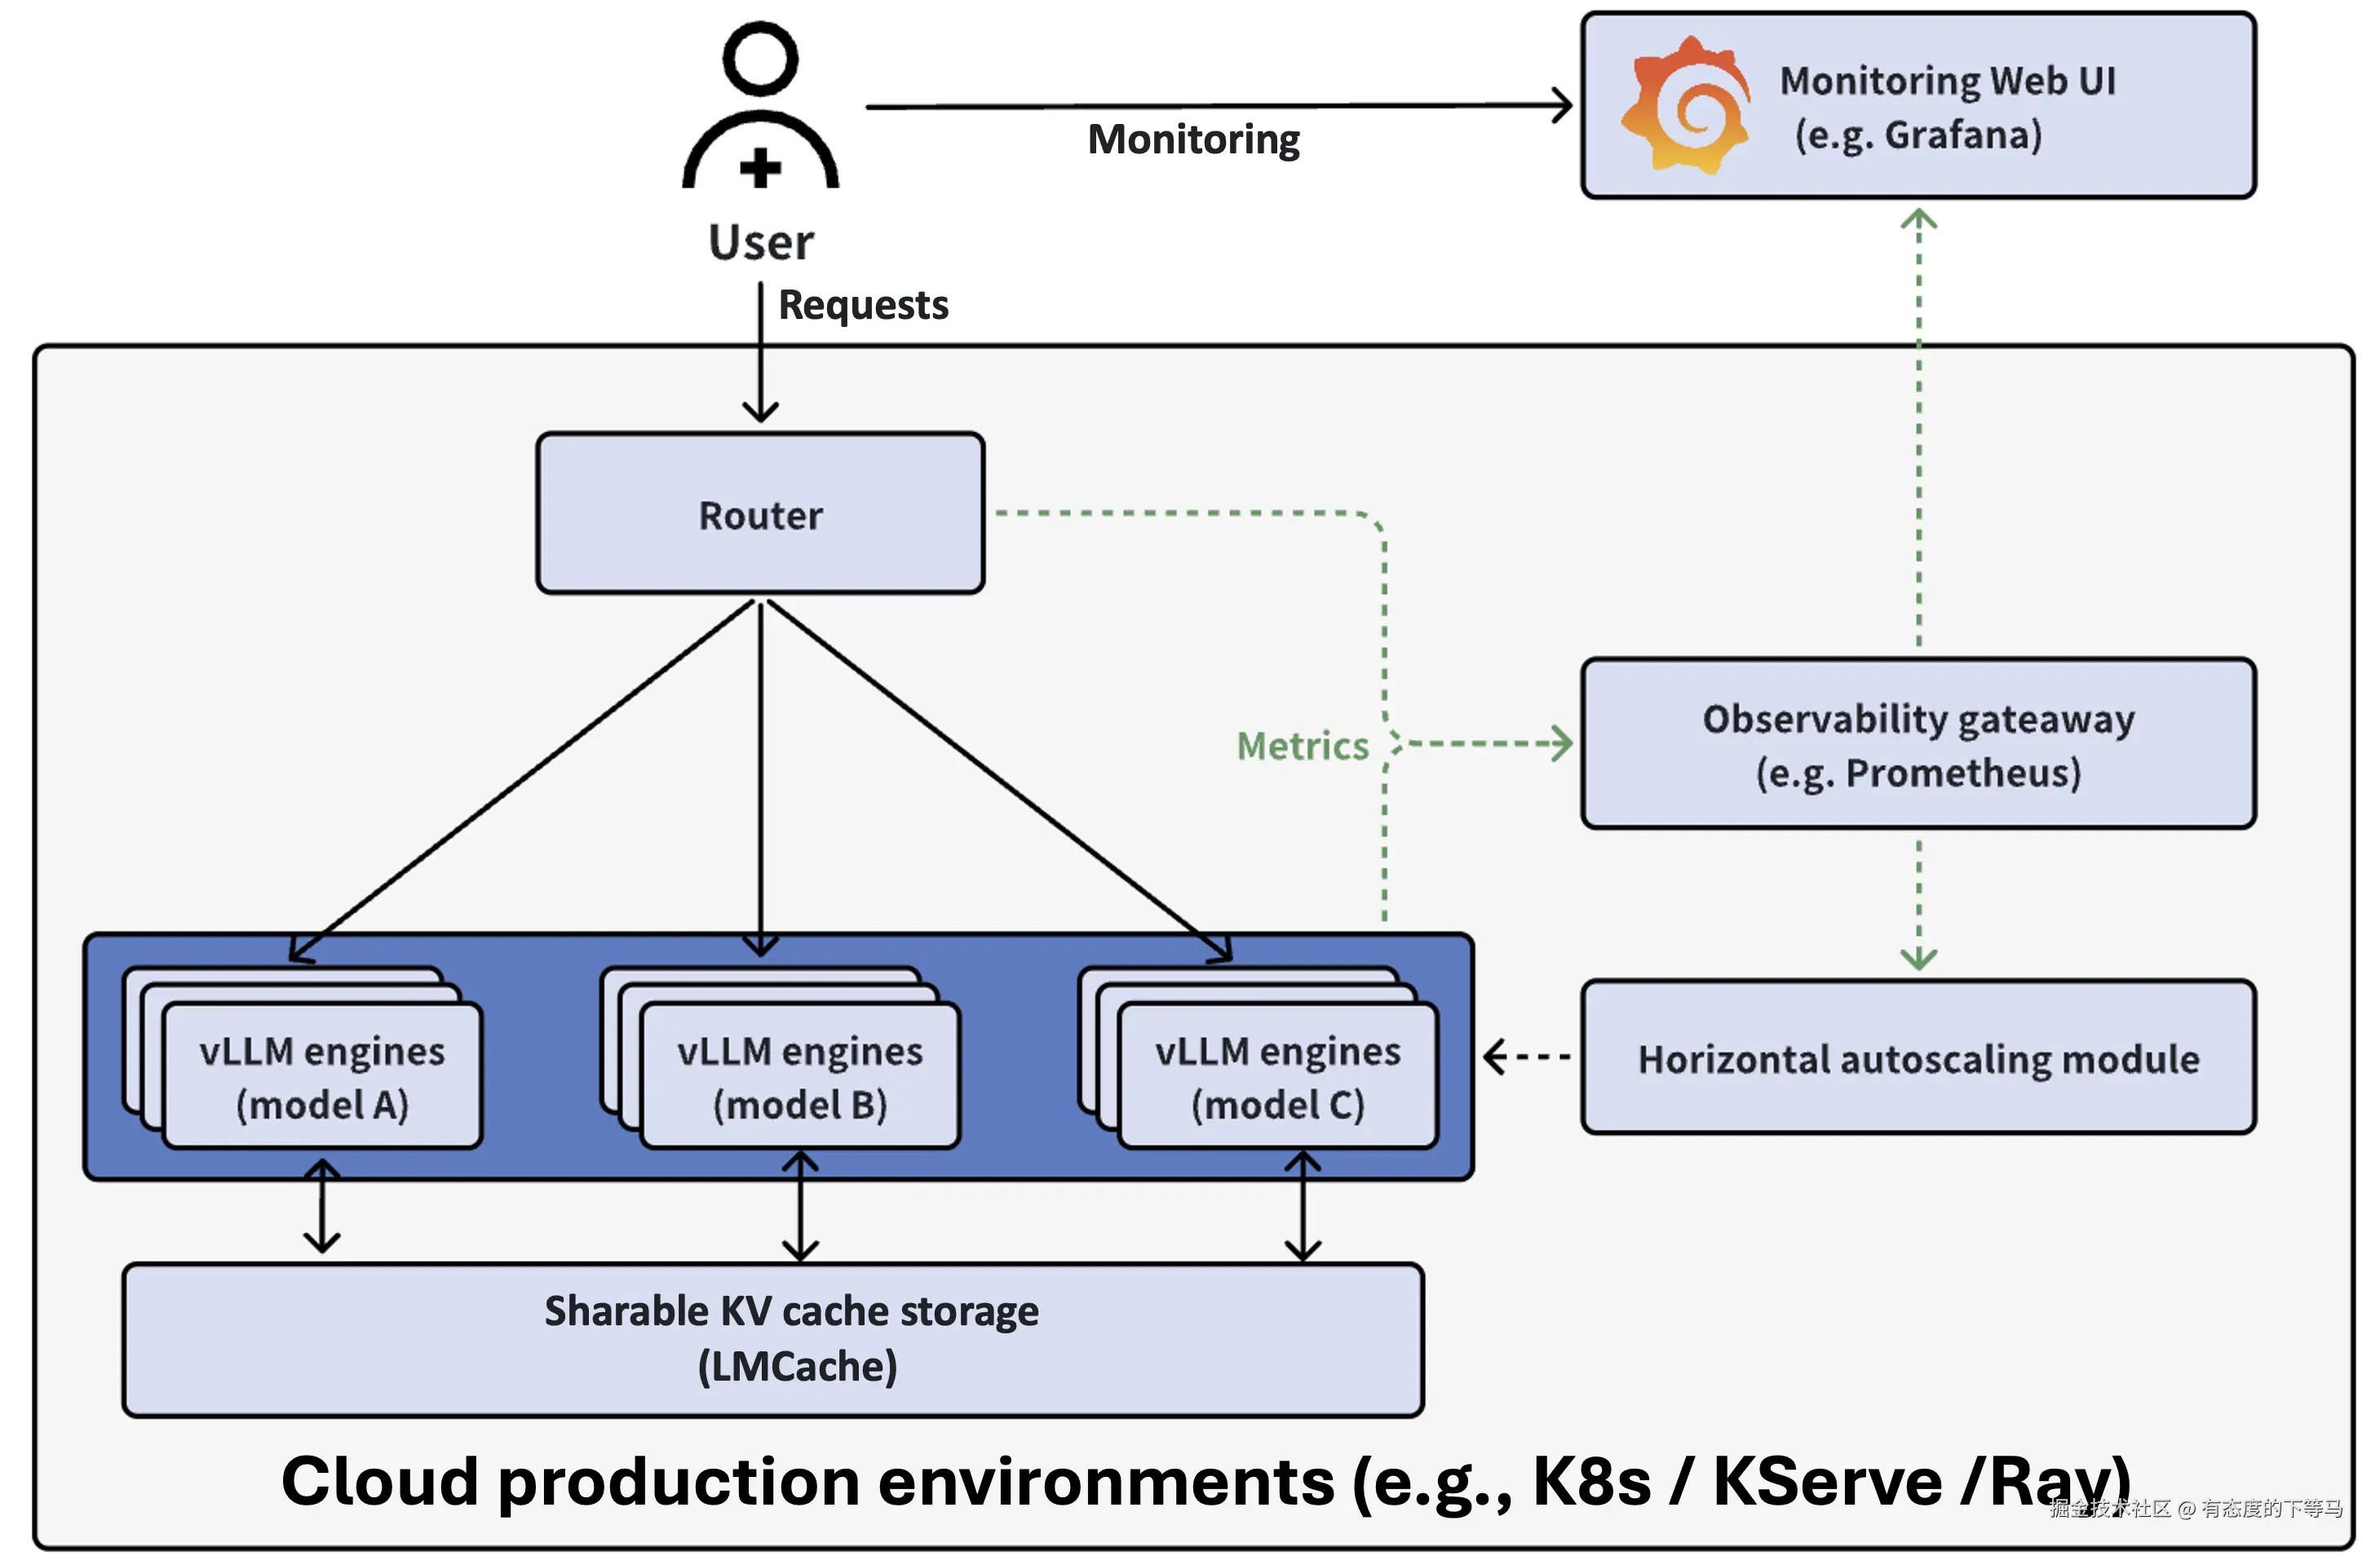
LLMCache/Router:
可用的路由策略:"roundrobin" # @schema enum:[roundrobin,session,prefixaware,kvaware,disaggregated_prefill,disaggregated_prefill_orchestrated]
前缀感知路由可确保后续具有相同提示前缀的请求被路由到同一实例,从而最大限度地提高键值缓存的利用率并提升性能。
以下针对对话模型开启 前缀感知路由,默认使用k8s服务发现(推理服务Pod上均有 app.kubernetes.io/component=serving-engine 标签)。
yaml
servingEngineSpec:
  enableEngine: false
cacheserverSpec:
  enabled: false

routerSpec:
  enableRouter: true
  routingLogic: "prefixaware"  #  按照请求prompt的前缀来路由,把相同前缀的请求都路由调度到同一后端
  replicaCount: 2
  serviceMonitor:
    enabled: true
  startupProbe:
    initialDelaySeconds: 5
    periodSeconds: 10
    failureThreshold: 60
  imagePullPolicy: "IfNotPresent"
  env:
  - name: TZ
    value: "Asia/Shanghai"
  extraArgs:
    - "--k8s-label-selector"
    - "app.kubernetes.io/component=serving-engine"    # 服务发现,推理服务的Pod上都有这个标签
  resources:
    limits:
      memory: 4Gi
    requests:
      cpu: 400m
      memory: 2Gi
这里面有一个问题,非对话模型是不能使用prefixaware, kvaware 路由策略:
向量模型Qwen/Qwen3-Embedding-8B发出的请求如下, 而对话模型会有prompt字段。
rust
curl -X POST https://tokengine.hanyoai.com/v1/embeddings \
  -H 'Authorization: Bearer sk-YJ3fOnCRGMHH2gzLeShdeduYXuJUF4TG5qrSmihvTIl2bBhK' \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen/Qwen3-Embedding-8B","input":"待向量化文本"}'

//  Internal Server Error
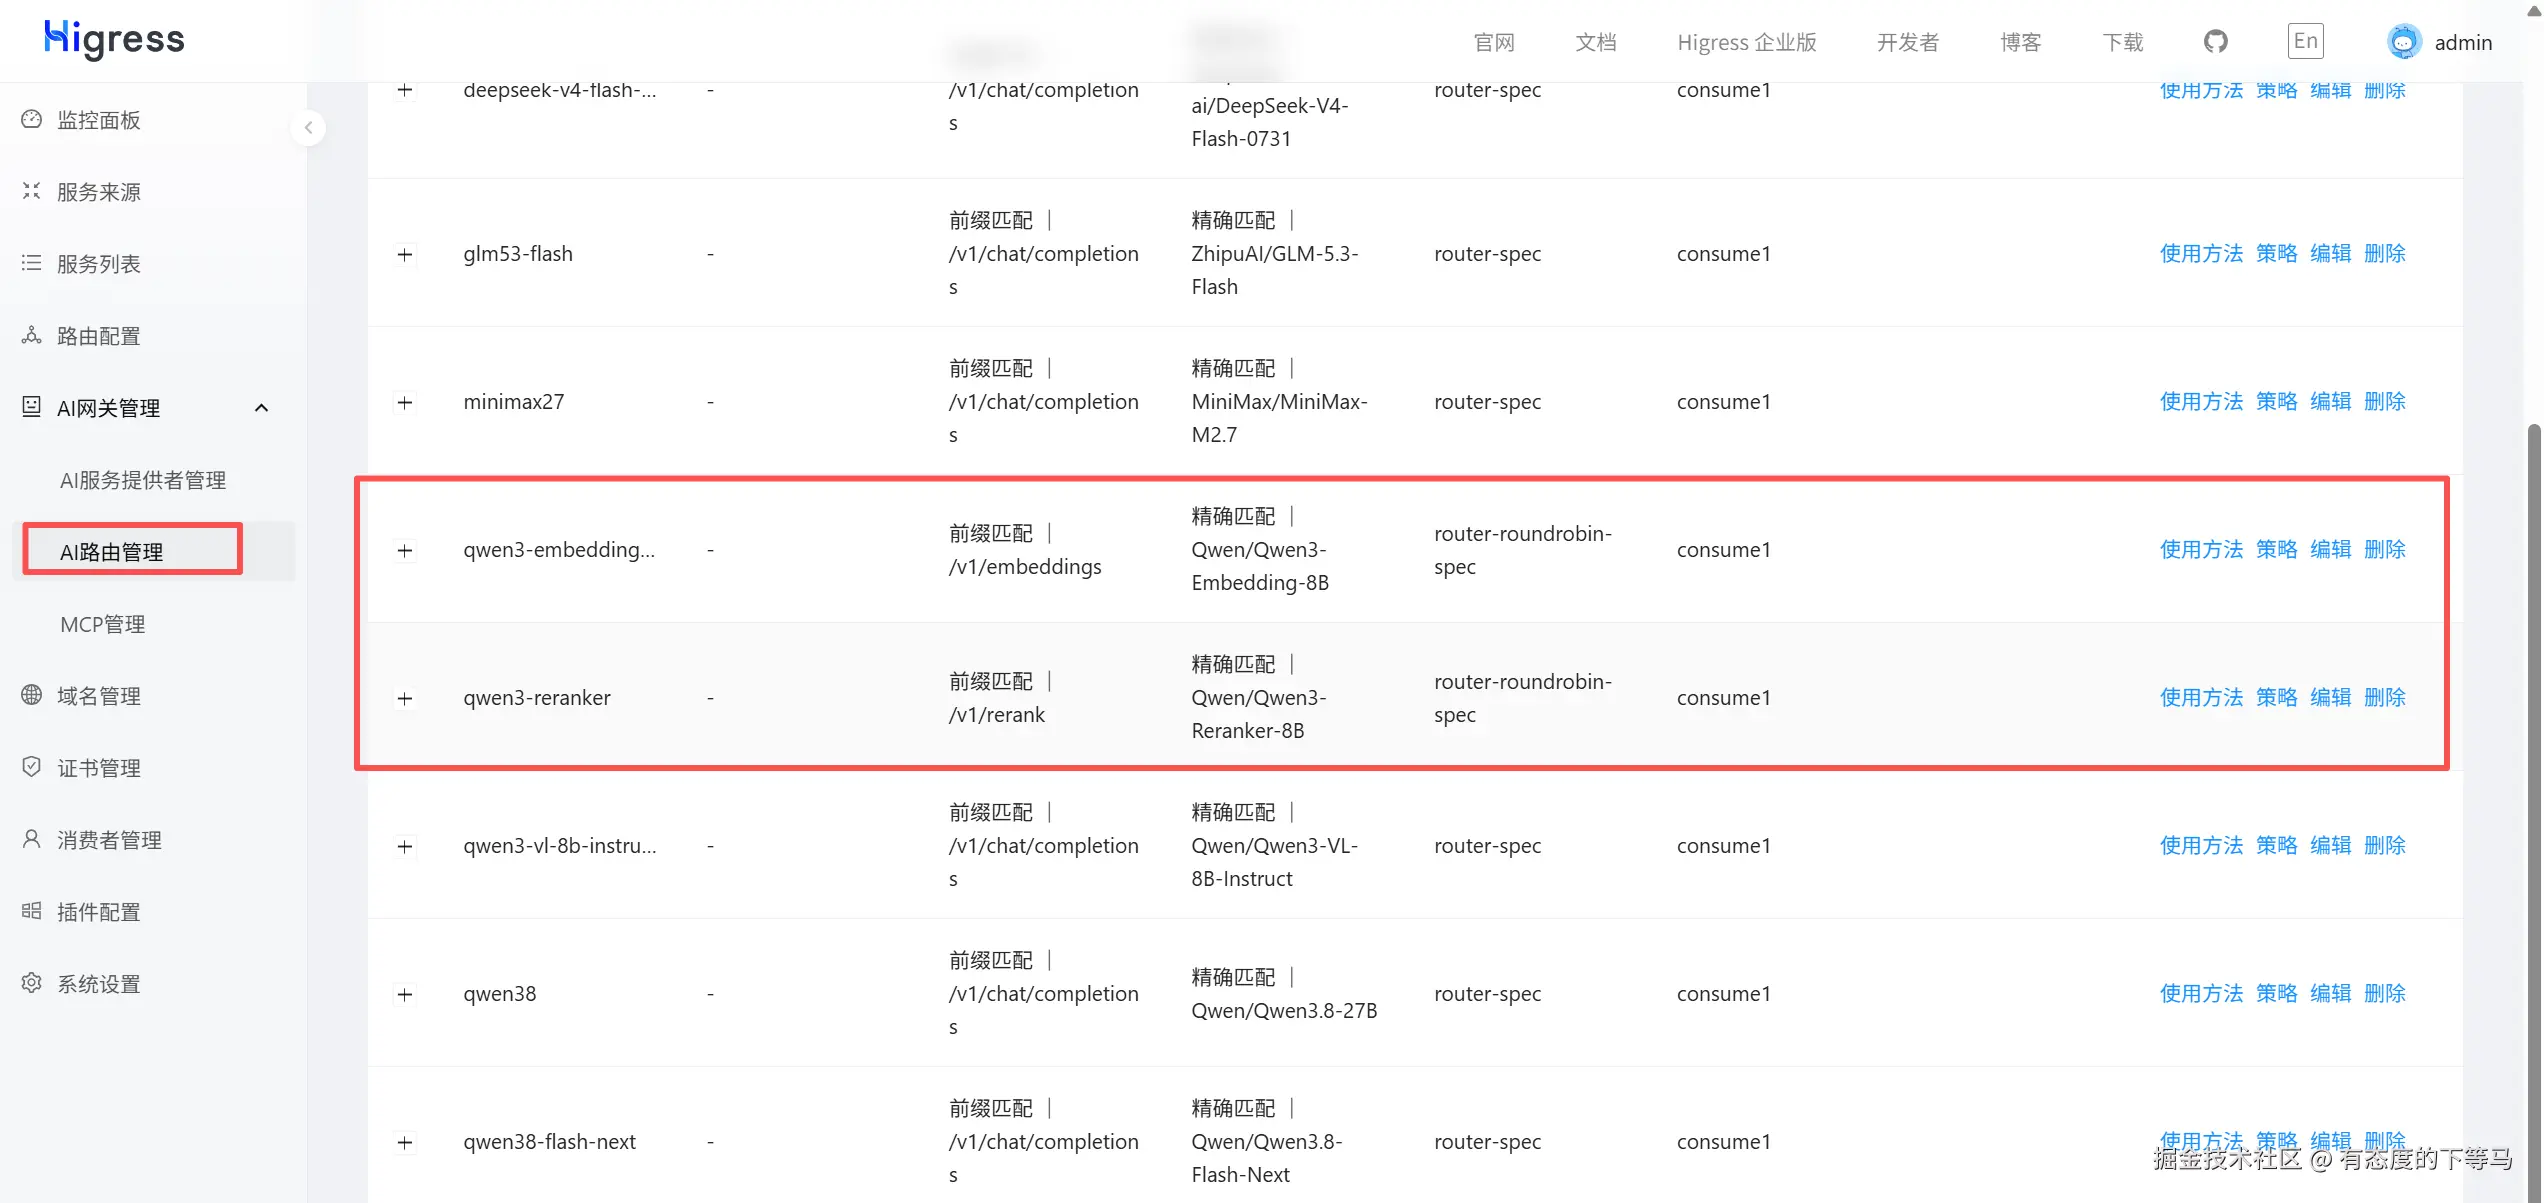
我们的方案是在上层提前分流:
- 新建一个走roundrobin 路由
- 在上层higress上将这些非对话模型的请求路由到 这个roundrobin 路由。
整体的对外输出, 还是可以保持 higress gateway 不变。