低代码、开源系统、定制开发怎么选?用资产管理案例做技术取舍
很多企业准备做管理系统时,第一轮讨论常常会卡在一个问题上:到底用低代码平台、开源系统改造,还是直接定制开发?
如果只看演示页面,这个问题很容易被误判。低代码平台能很快拖出表单和流程,开源系统能很快跑起来一套后台,定制开发可以按需求完全设计。每一种方案都能讲出优点,但真正上线以后,决定成败的往往不是首页长什么样,而是数据模型能不能承接未来变化、权限边界能不能落地、二次开发责任能不能说清楚、源码和部署权能不能交接。
本文固定一个案例:客户要做固定资产系统,第一版只要求资产台账、领用、归还;三个月后,又提出折旧、盘点、多公司多部门权限、二维码标签和财务系统对接。我们不写泛泛的"低代码好不好、开源好不好",而是用一个可复现的评估模型,把技术选型拆成输入数据、评分维度、数据库结构、Java 服务层、JUnit 测试、SQL 验证和上线验收。
示例环境为 Java 17、Spring Boot 风格服务层、MySQL 8.x。低代码平台、开源系统和定制开发都可以接入这个评估模型;本文重点不在推荐某个具体厂商,而在怎样把"感觉上哪个更合适"变成可解释、可复核的技术决策。
目录
- 先固定一个资产管理选型案例
- 为什么不能只看首屏和报价
- 把选型拆成六个可评分维度
- MySQL表结构:选型单、评分项和决策快照
- Java实现:按维度计算推荐方案
- 预期输出和JUnit测试
- SQL验证:上线前怎么复核选型结论
- 异常边界和上线验收
- 小结和延伸阅读
一、先固定一个资产管理选型案例
本篇固定输入如下:
text
评估单号:SEL-20260920-004
业务对象:固定资产管理系统
第一版范围:资产台账、领用、归还、基础报表
三个月后新增:折旧、盘点、多组织权限、二维码标签、财务系统对接
使用组织:3家公司、18个部门、约2600张资产卡
使用角色:普通员工、部门资产员、资产管理员、财务人员、系统管理员
上线目标:45天内上线第一版,后续持续迭代
预算倾向:不希望一次性投入过高,但要求源码、数据和部署可交接
评估结论候选:LOW_CODE、OPEN_SOURCE_CUSTOM、FULL_CUSTOM
三个候选方案先定义清楚:
| 方案 | 本文含义 |
|---|---|
| LOW_CODE | 以低代码平台配置表单、流程、报表为主,少量脚本或插件扩展 |
| OPEN_SOURCE_CUSTOM | 基于开源后台或开源业务系统做二次开发,保留源码和部署控制权 |
| FULL_CUSTOM | 从数据模型、后端、前端、权限到部署全部定制开发 |
这个案例的关键不是"哪个方案一定最好",而是当前输入已经透露出几个风险:第一版看起来很小,但后续需求变化快;资产生命周期长,状态、折旧、盘点和处置会不断扩展;多组织权限和财务对接意味着不能只靠页面配置;客户又要求源码和部署可交接。
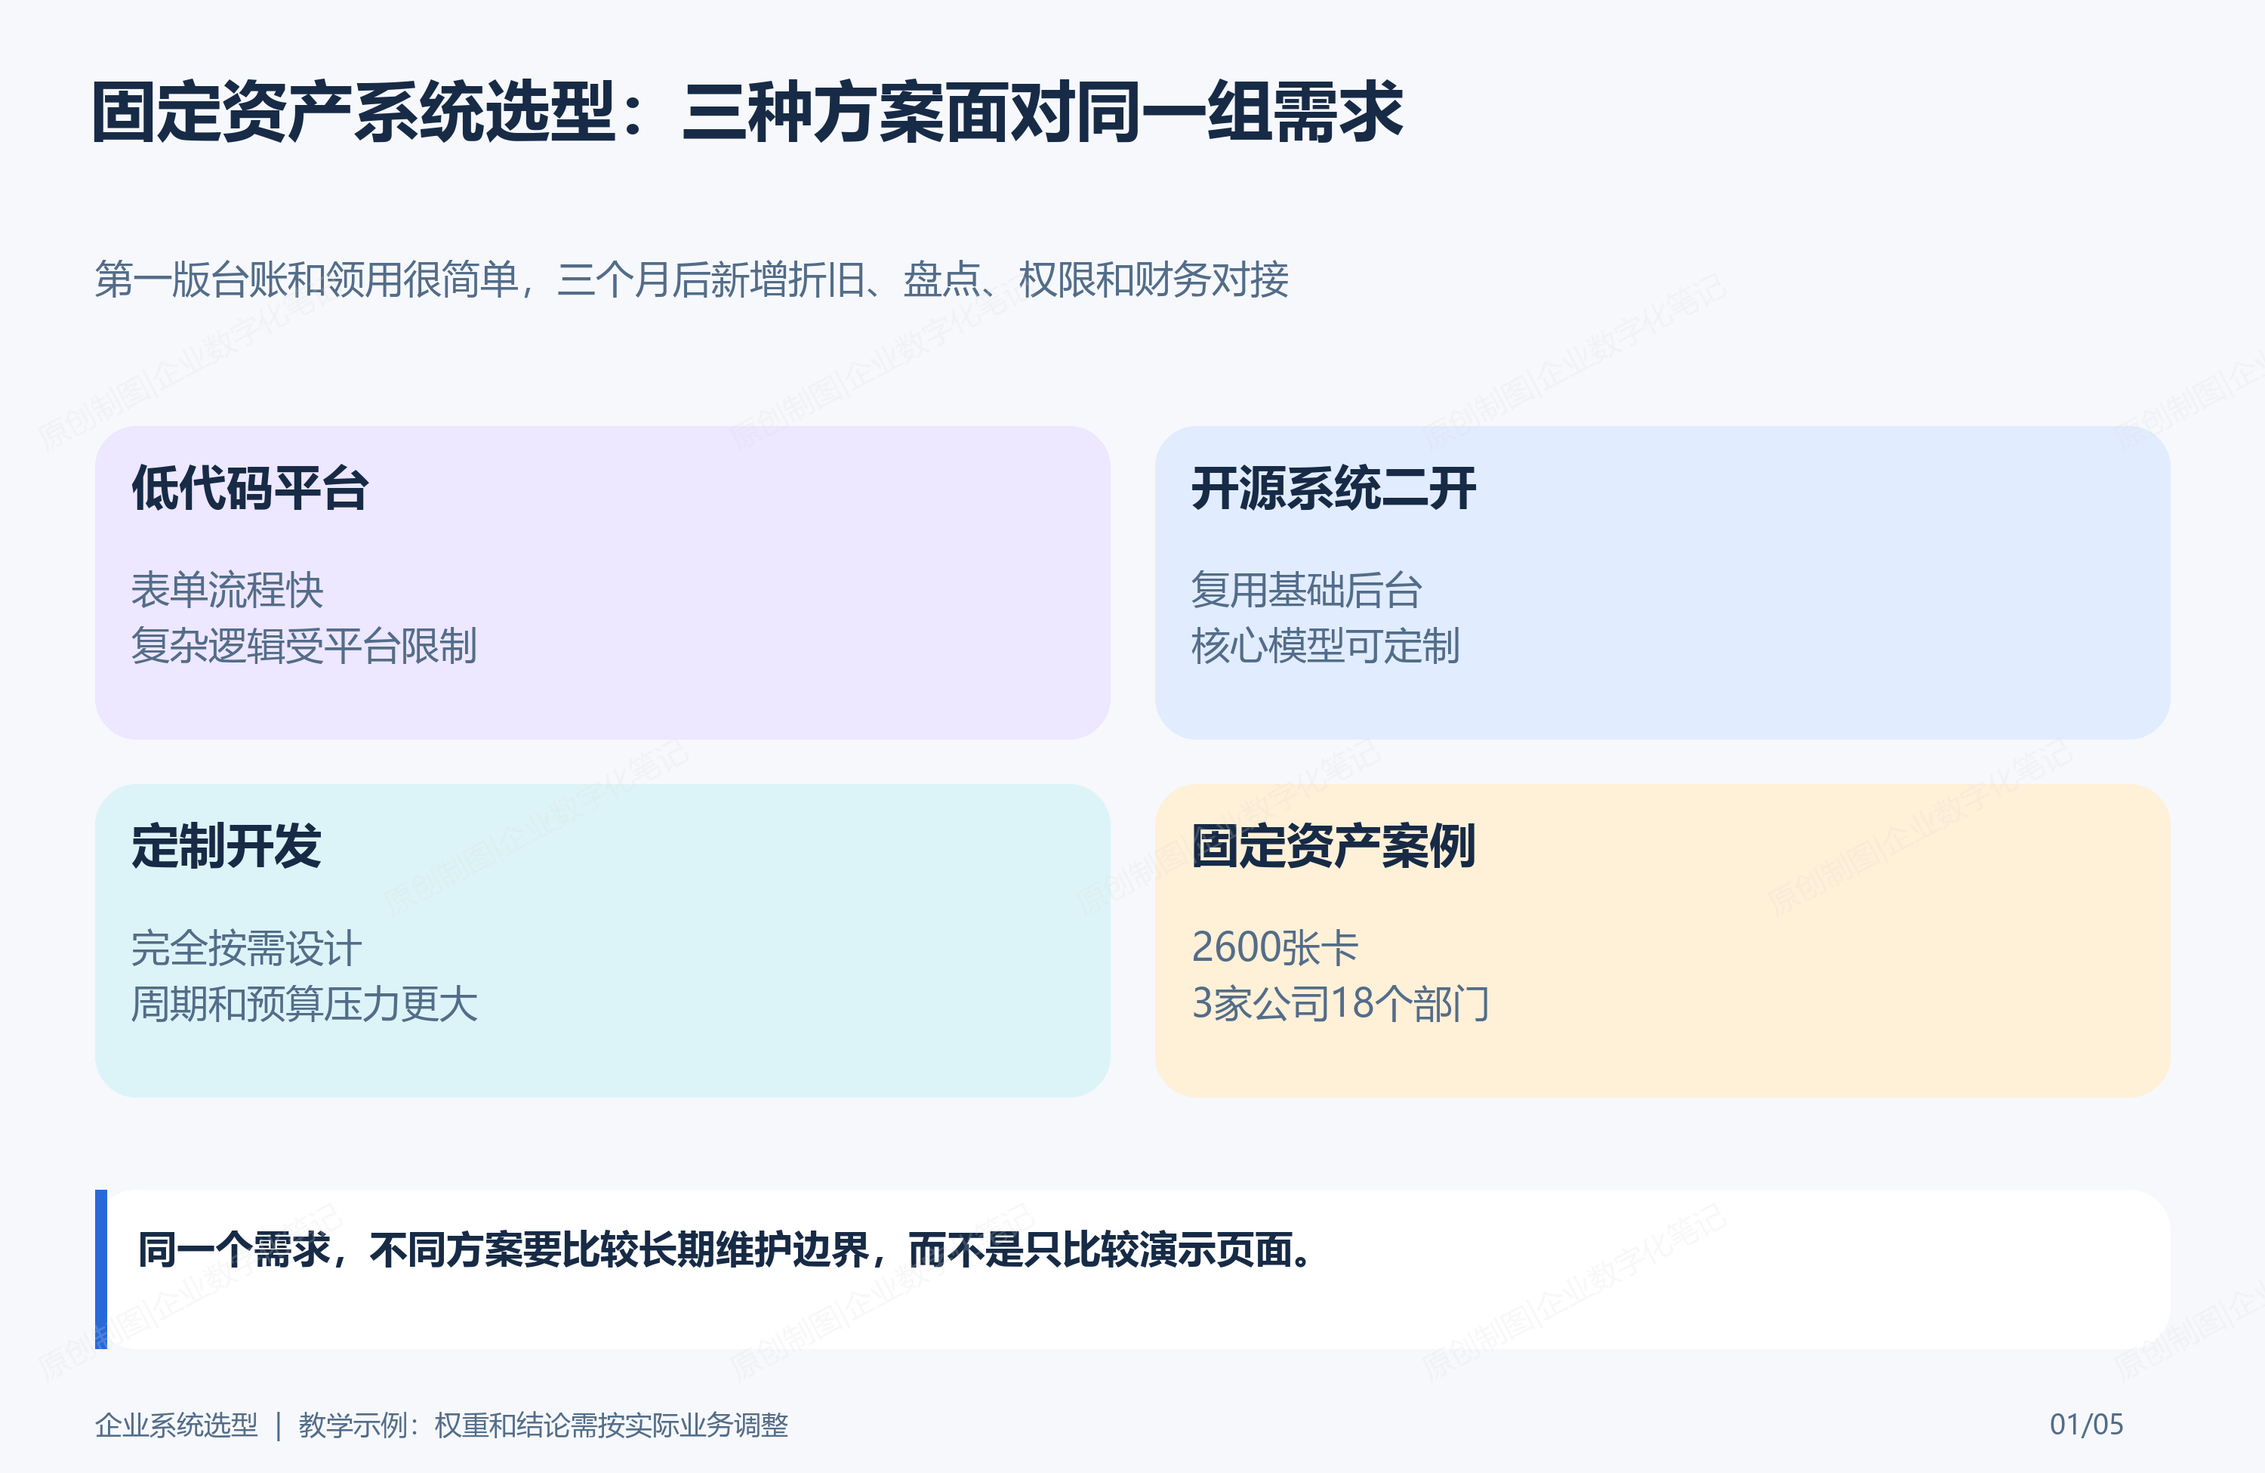
图1:同一个资产系统需求,低代码、开源二开和定制开发关注的风险点不同。
二、为什么不能只看首屏和报价
很多选型失败,是因为评估时只比较了三个表面指标:
text
谁演示页面更快
谁第一版报价更低
谁说自己功能更多
这三个指标都重要,但都不能单独决定方案。
第一,首屏页面不等于数据模型。固定资产系统如果只做台账列表,低代码平台很快;但一旦进入折旧、盘点、调拨、维修、报废,核心表之间会出现状态机、期间、凭证、附件和审计链路。页面拖得快,不代表这些业务事实能长期稳定保存。
第二,第一版报价不等于总成本。低代码平台前期配置快,但复杂逻辑可能变成平台脚本、插件和厂商服务费;开源系统初始成本低,但要评估源码质量、许可证、升级冲突和二开责任;定制开发前期投入高,但边界清晰时后续可控性更强。
第三,功能清单不等于可交接能力。供应商演示"有折旧、有盘点、有二维码",不代表交付时会给出数据字典、源码、部署文档、测试用例和二开边界。企业管理系统不是一次性页面,而是要被维护、迁移和继续开发的资产。
所以本文不按"喜欢哪个"来选,而是把选型变成六个维度的评分和证据:
| 维度 | 要问的问题 |
|---|---|
| 需求稳定度 | 三个月后会不会大改流程、字段、状态和报表 |
| 数据模型复杂度 | 是否有状态机、期间、金额、附件、审计、历史版本 |
| 权限复杂度 | 是否多公司、多部门、多角色、多数据范围 |
| 集成复杂度 | 是否对接财务、二维码、消息、SSO 或第三方平台 |
| 源码和部署控制 | 是否要求私有化、源码交付、独立部署和二开 |
| 时间和预算压力 | 第一版上线窗口和总投入边界 |
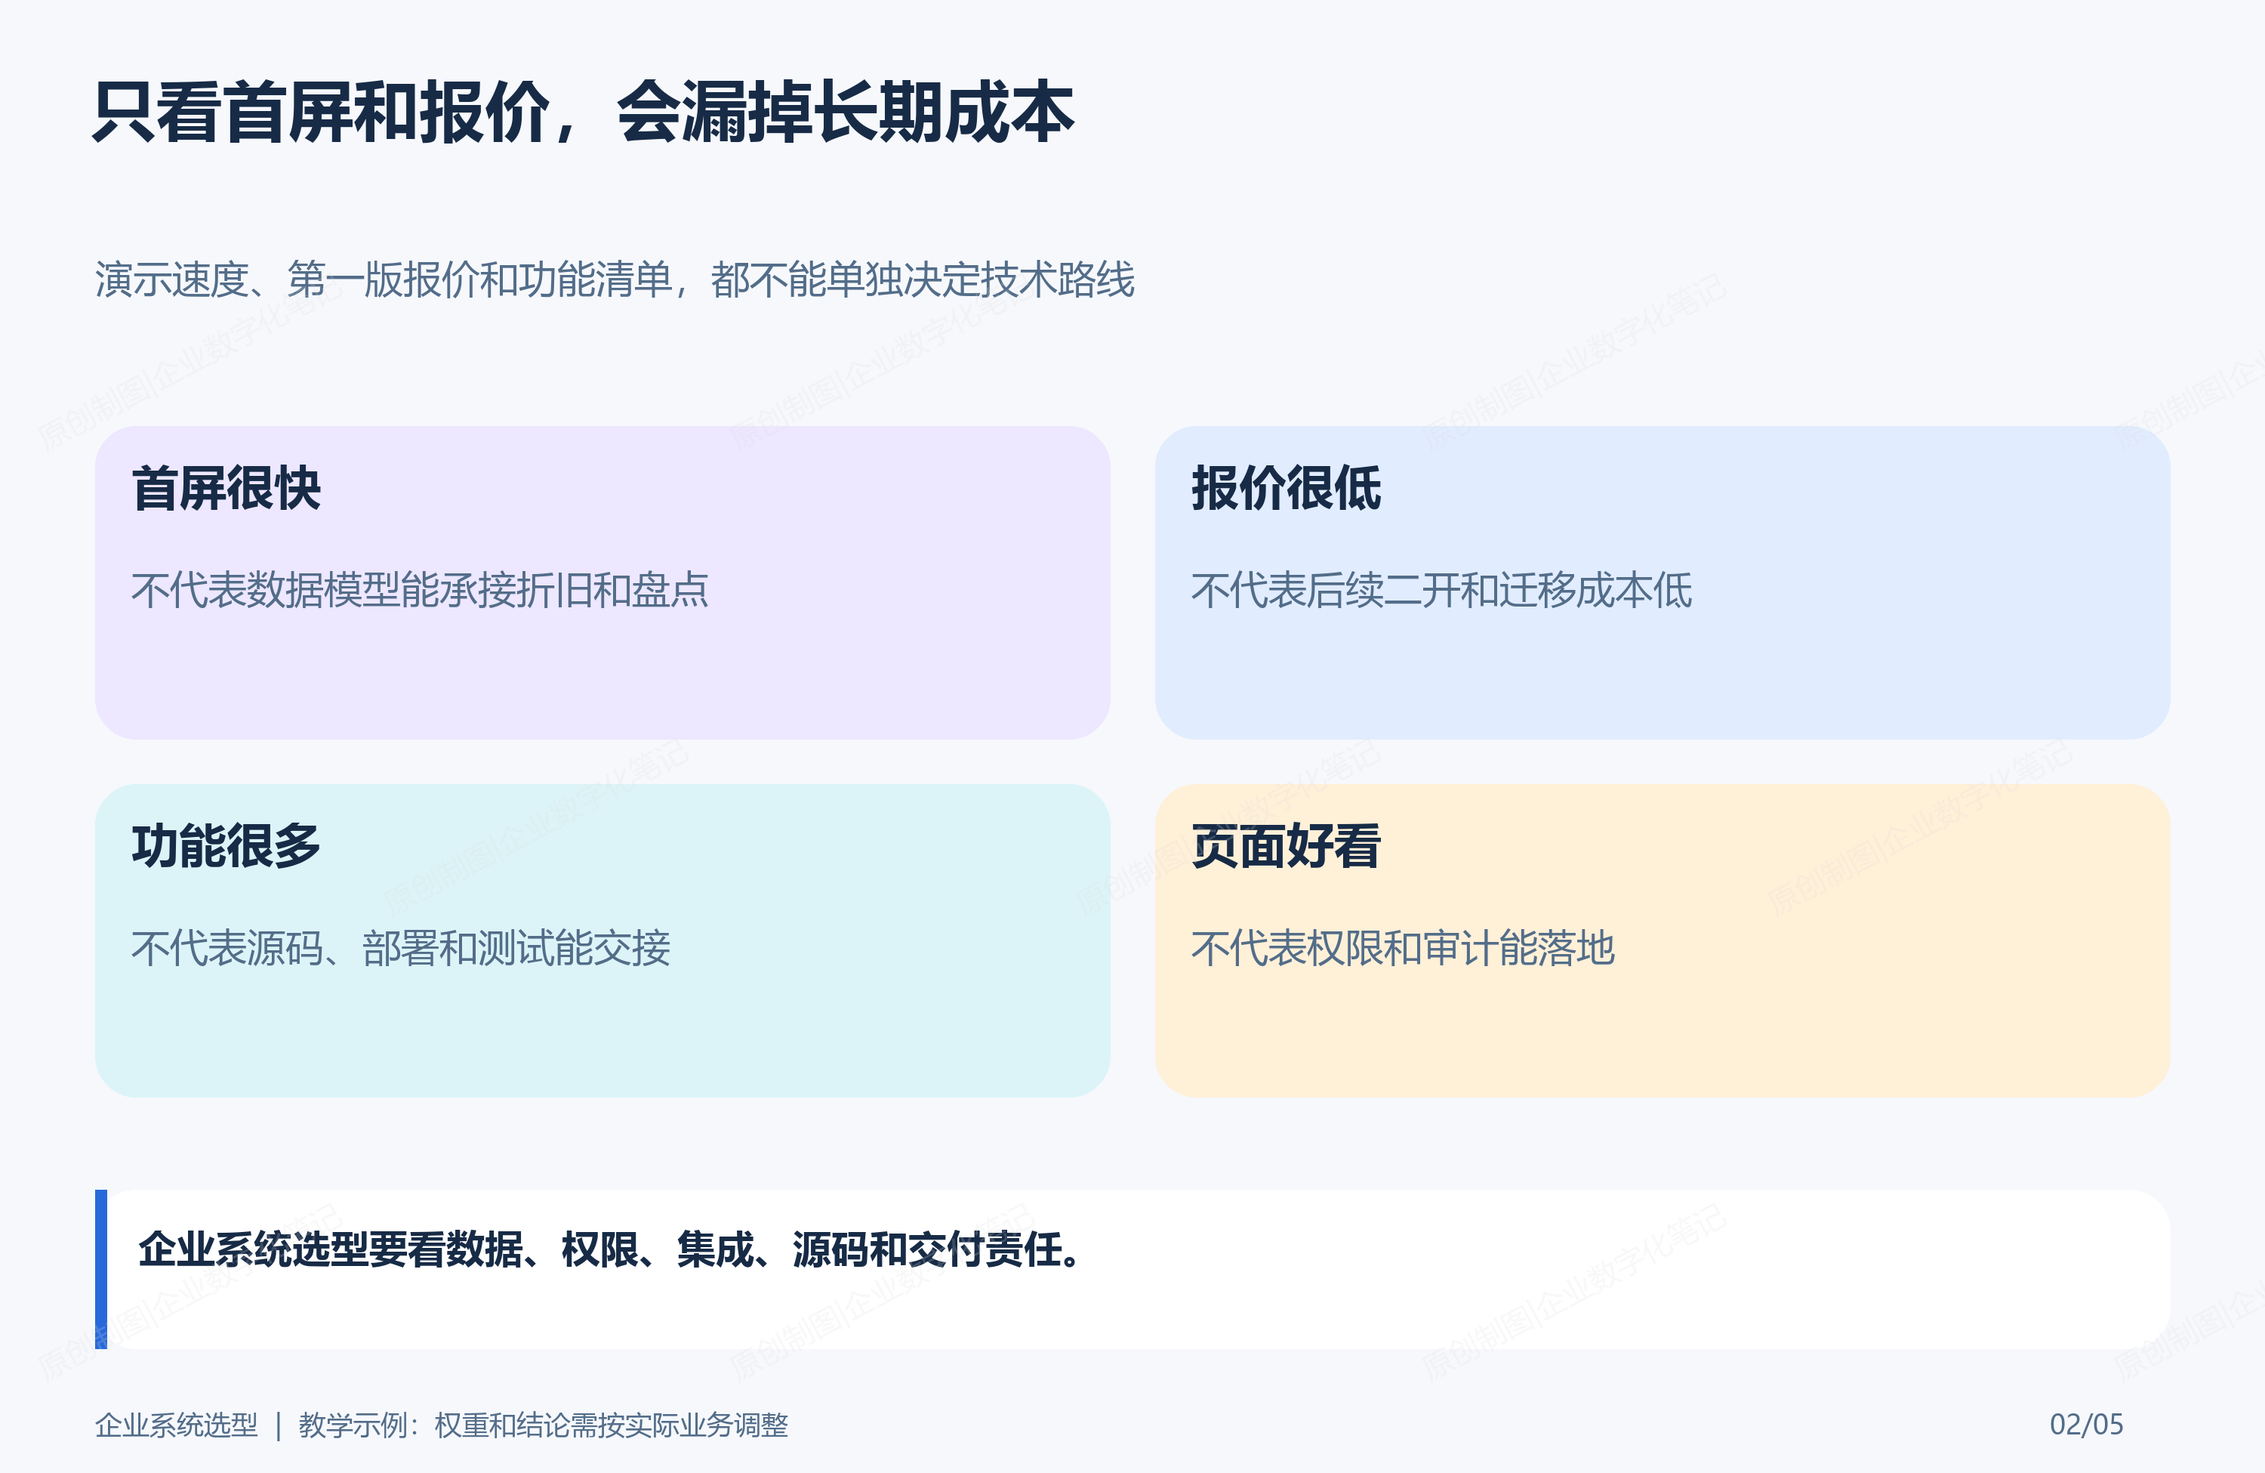
图2:选型不能只比较演示速度和报价,还要比较数据、权限、集成和交付责任。
三、把选型拆成六个可评分维度
为了让选型可复核,可以把每个维度按 1 到 5 分记录。分数不是越高越好,而是表示复杂度或约束强度。
text
1分:简单、稳定、变化少
3分:有明确规则,但存在扩展
5分:复杂、变化快、需要持续开发
本案例可以先打一个样例分:
| 维度 | 分数 | 原因 |
|---|---|---|
| 需求稳定度 | 4 | 第一版很小,但三个月后明确新增折旧、盘点和权限 |
| 数据模型复杂度 | 5 | 资产卡、折旧期间、盘点差异、调拨、维修、报废都要保留历史 |
| 权限复杂度 | 4 | 三家公司、十八个部门,多角色且数据范围不同 |
| 集成复杂度 | 3 | 需要财务系统、二维码标签和消息提醒 |
| 源码和部署控制 | 5 | 客户要求源码、数据和部署可交接 |
| 时间和预算压力 | 3 | 45天上线第一版,但后续持续迭代 |
这组分数已经能解释为什么"纯低代码"风险较高:需求变化、数据模型、权限和源码控制都不低。如果客户只要一个内部登记表,低代码可能合适;但这个案例已经接近长期业务系统,至少要谨慎评估平台锁定和复杂逻辑的维护成本。
也不能简单说"那就全定制"。45 天要上线第一版,预算又不希望一次性过高,如果从零写完整权限、菜单、字典、导入导出、附件和审计,第一版周期会被基础能力吃掉。因此更稳的结论通常是:基于成熟开源后台或开源业务框架二次开发,核心数据模型和业务流程定制,避免被纯配置平台锁死,也避免从零造全部基础设施。
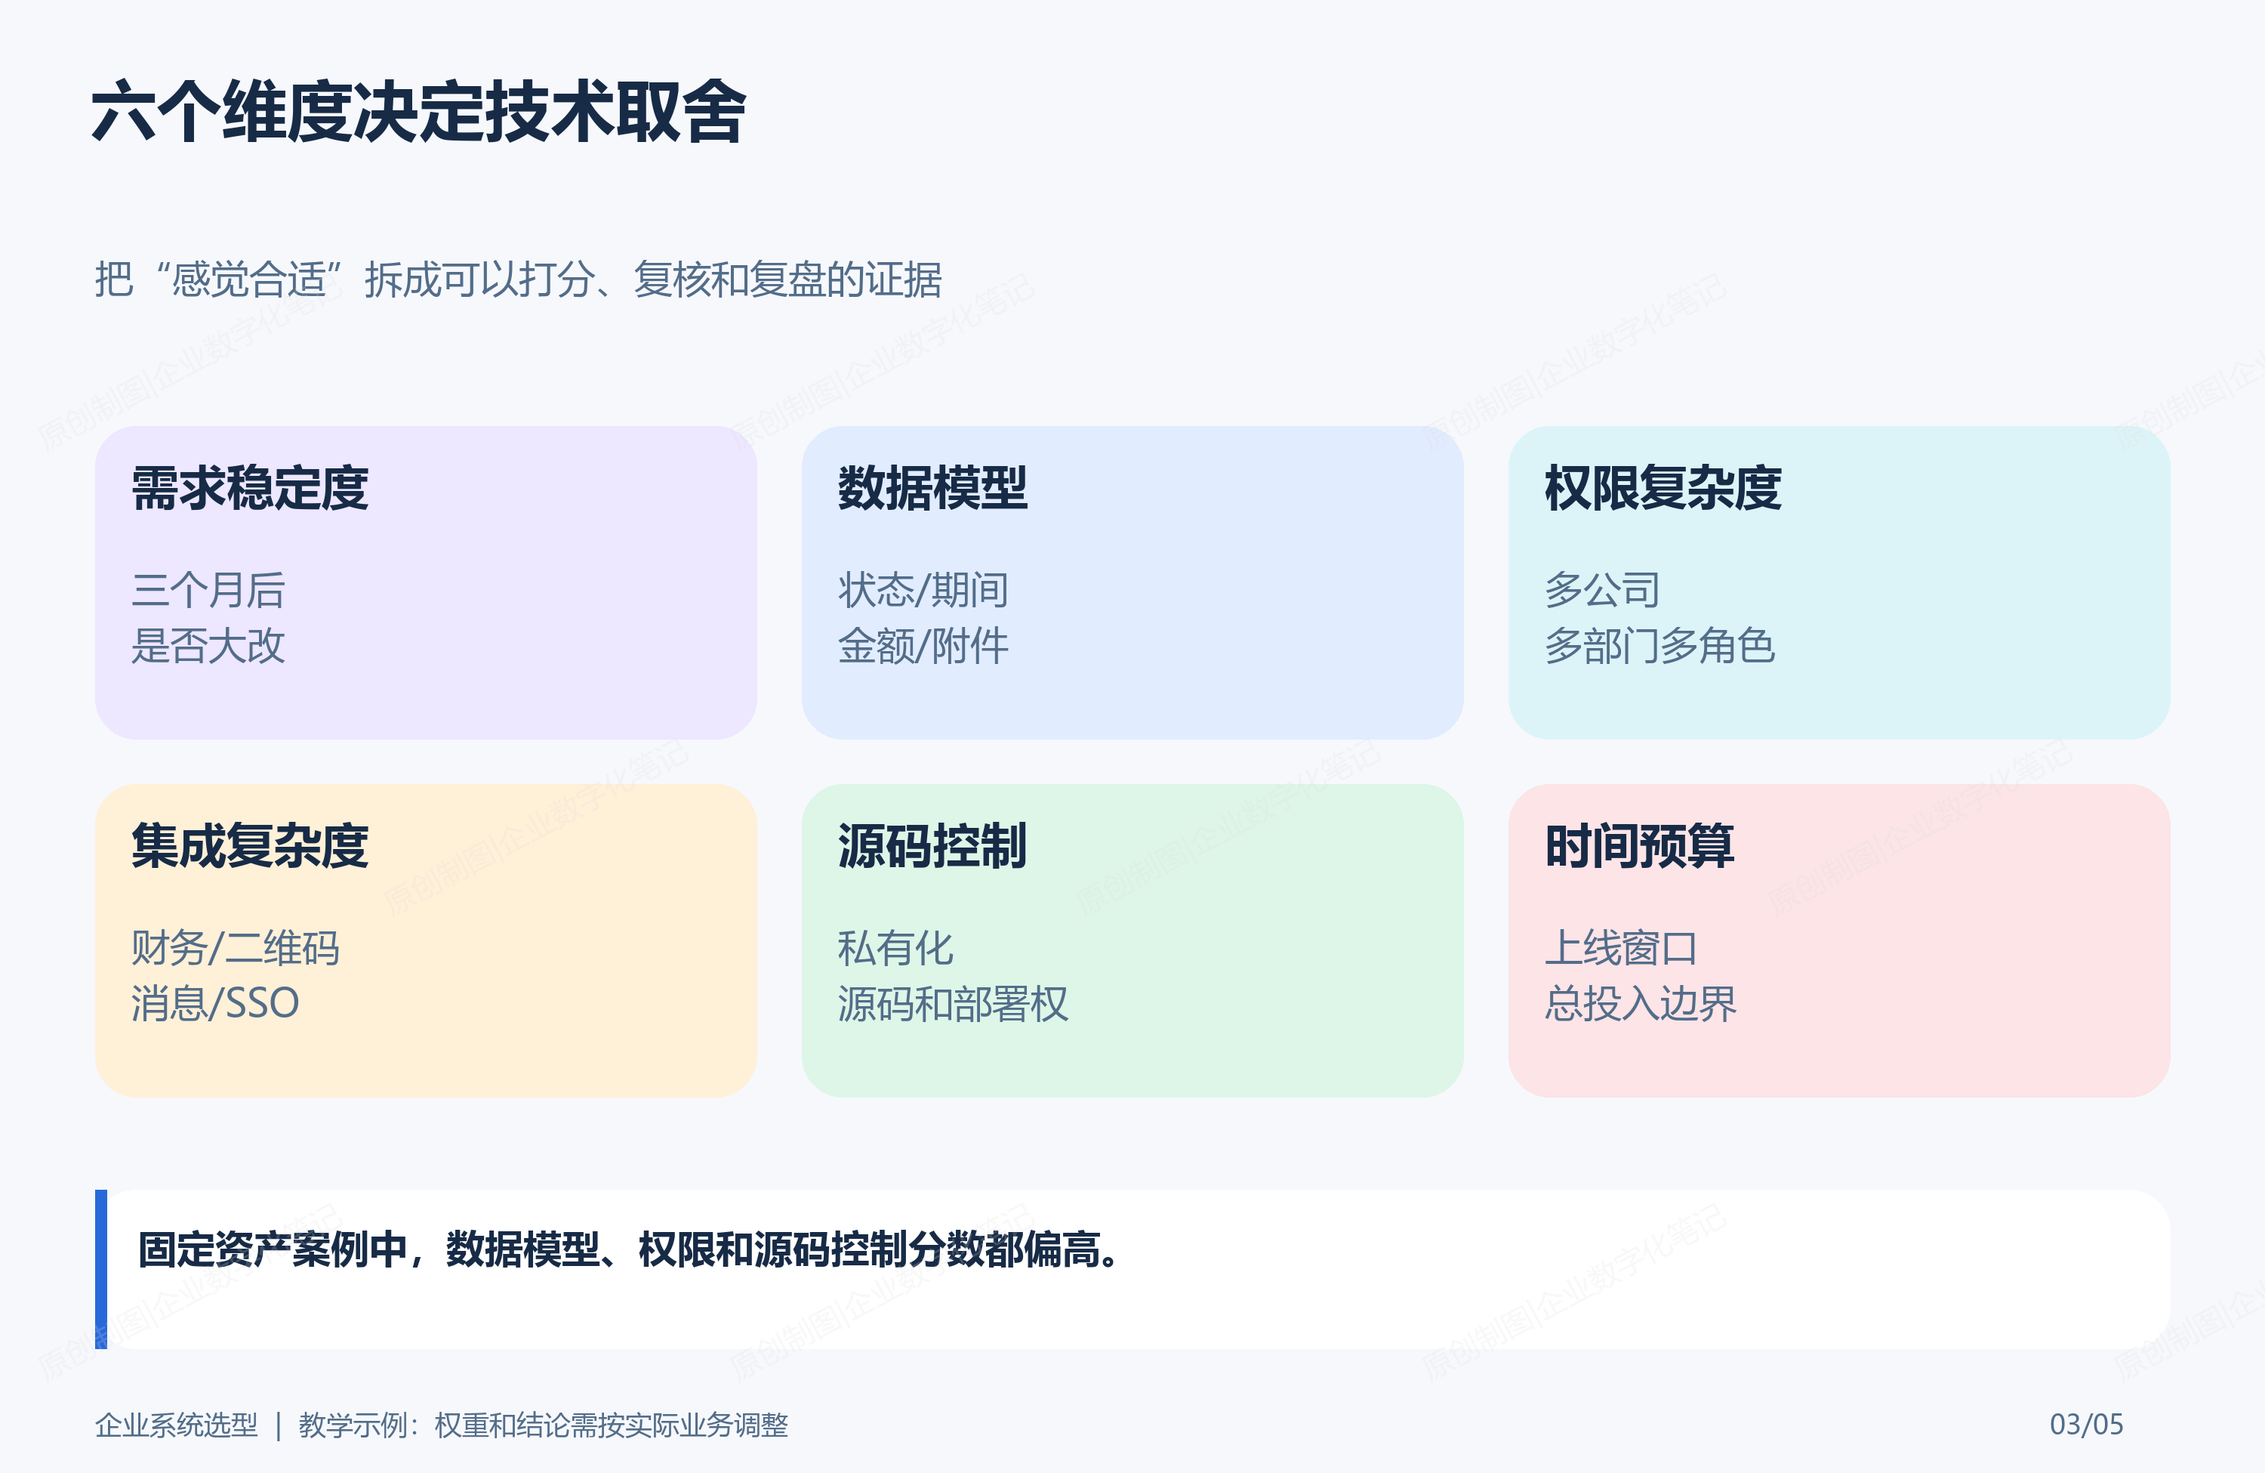
图3:评分维度把"感觉合适"变成可解释的技术判断。
四、MySQL表结构:选型单、评分项和决策快照
选型评估也应该落库。否则会议上说过的话、评估过的风险、最终推荐理由,很快就会变成口头记忆。
下面是一组最小表结构:
sql
CREATE TABLE solution_selection (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  selection_no VARCHAR(64) NOT NULL,
  project_name VARCHAR(128) NOT NULL,
  company_id BIGINT NOT NULL,
  current_stage VARCHAR(32) NOT NULL,
  recommended_solution VARCHAR(32) NULL,
  decision_reason VARCHAR(1000) NULL,
  request_key VARCHAR(64) NOT NULL,
  create_by BIGINT NOT NULL,
  create_time DATETIME NOT NULL,
  update_time DATETIME NULL,
  UNIQUE KEY uk_selection_no (company_id, selection_no),
  UNIQUE KEY uk_selection_request (request_key),
  CHECK (current_stage IN ('DRAFT','EVALUATING','CONFIRMED','REJECTED')),
  CHECK (recommended_solution IS NULL OR recommended_solution IN
    ('LOW_CODE','OPEN_SOURCE_CUSTOM','FULL_CUSTOM'))
);

CREATE TABLE solution_selection_score (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  selection_id BIGINT NOT NULL,
  dimension_code VARCHAR(64) NOT NULL,
  dimension_name VARCHAR(128) NOT NULL,
  score INT NOT NULL,
  evidence VARCHAR(1000) NOT NULL,
  create_time DATETIME NOT NULL,
  UNIQUE KEY uk_selection_dimension (selection_id, dimension_code),
  CHECK (score BETWEEN 1 AND 5)
);

CREATE TABLE solution_selection_result (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  selection_id BIGINT NOT NULL,
  low_code_score DECIMAL(8,2) NOT NULL,
  open_source_custom_score DECIMAL(8,2) NOT NULL,
  full_custom_score DECIMAL(8,2) NOT NULL,
  recommended_solution VARCHAR(32) NOT NULL,
  reason_snapshot JSON NOT NULL,
  create_time DATETIME NOT NULL,
  UNIQUE KEY uk_selection_result (selection_id)
);
三张表分别保存不同事实。
solution_selection 保存评估单主信息和最终结论。solution_selection_score 保存每个维度的分数和证据。solution_selection_result 保存计算后的三种方案得分和决策快照。为什么要保存快照?因为未来需求变化后,评分可能会调整;保留当时的输入和输出,才能解释当时为什么推荐这个方案。
这里不建议把评分维度塞进一个 JSON 字段。JSON 对快速原型很方便,但后续要统计"哪些项目最后没有选低代码、原因是什么""权限复杂度高的项目是否更容易超预算"时,结构化评分项更容易查询。
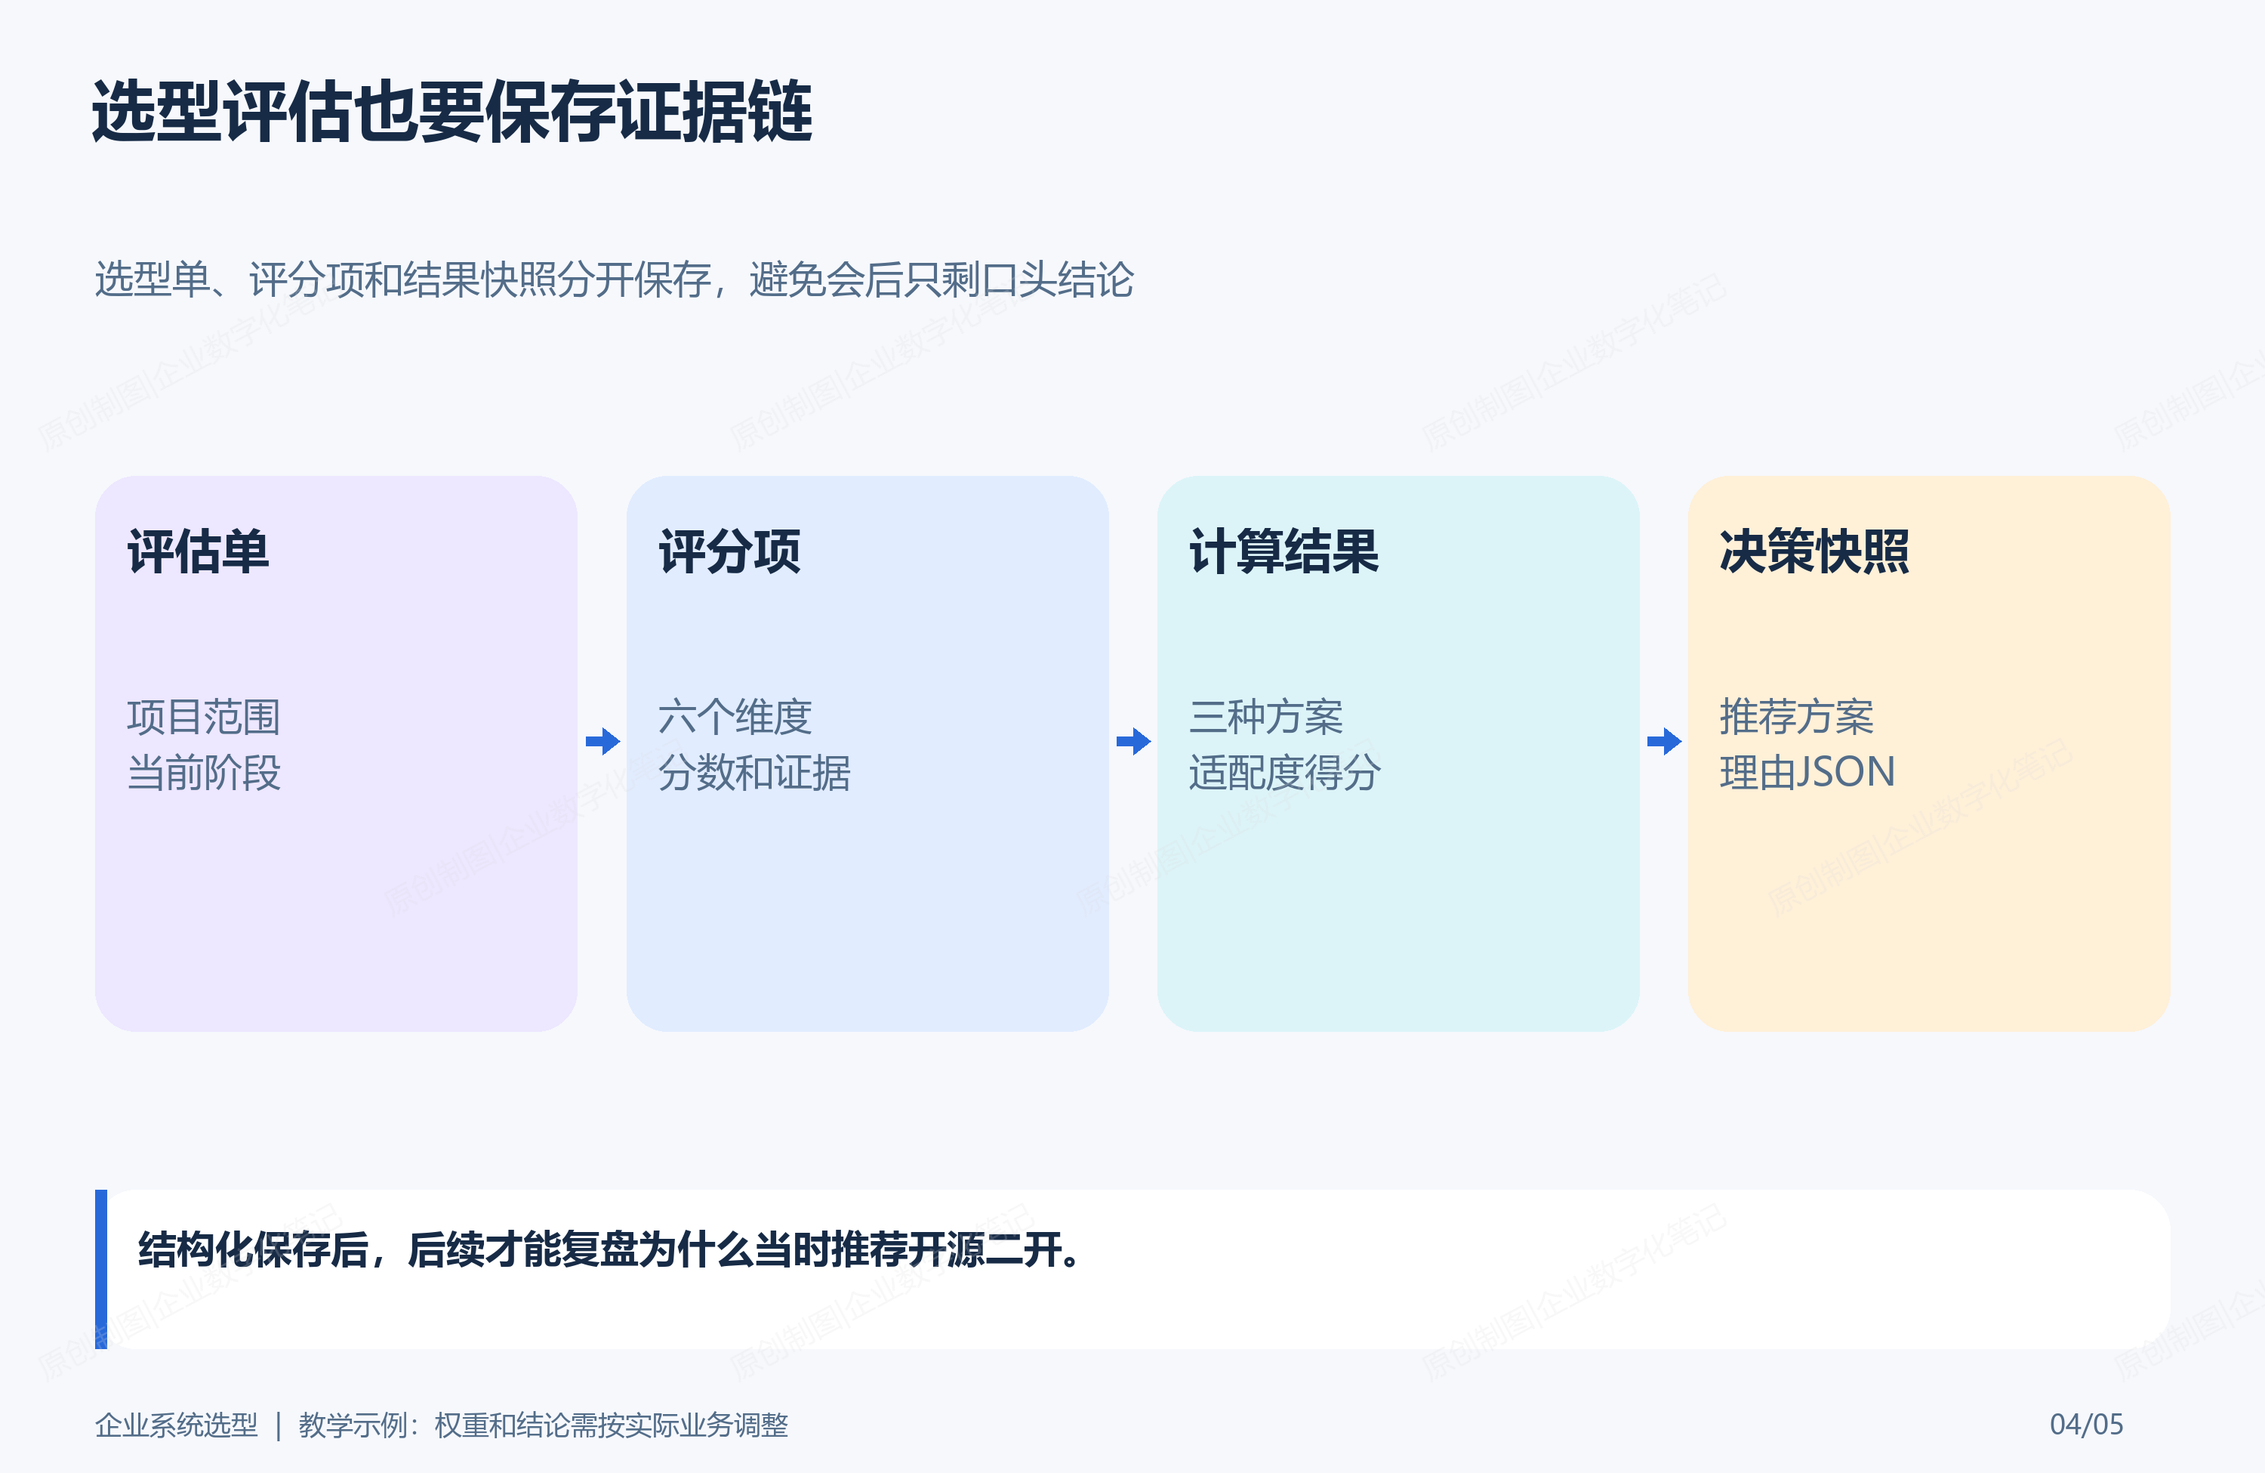
图4:选型单、评分项和结果快照分开保存,便于复核和复盘。
五、Java实现:按维度计算推荐方案
下面给出一个简化的服务层实现。它不是为了把选型变成机械公式,而是让推荐过程有一致的计算口径。
java
import java.math.BigDecimal;
import java.time.LocalDateTime;
import java.util.EnumMap;
import java.util.List;
import java.util.Map;
import org.springframework.transaction.annotation.Transactional;

public class SolutionSelectionService {

    private final SelectionRepository selectionRepository;
    private final ScoreRepository scoreRepository;
    private final ResultRepository resultRepository;

    public SolutionSelectionService(SelectionRepository selectionRepository,
                                    ScoreRepository scoreRepository,
                                    ResultRepository resultRepository) {
        this.selectionRepository = selectionRepository;
        this.scoreRepository = scoreRepository;
        this.resultRepository = resultRepository;
    }

    @Transactional(rollbackFor = Exception.class)
    public SelectionResult confirm(SelectionCommand command) {
        Selection selection = selectionRepository.lockByNo(
                command.companyId(), command.selectionNo())
                .orElseThrow(() -> new BizException("评估单不存在"));

        if (!"EVALUATING".equals(selection.stage())) {
            throw new BizException("只有评估中的选型单才能确认:" + selection.stage());
        }

        List<DimensionScore> scores = scoreRepository.listBySelectionId(selection.id());
        ensureRequiredDimensions(scores);

        Recommendation recommendation = calculate(scores);
        resultRepository.upsert(selection.id(), recommendation, LocalDateTime.now());
        selectionRepository.confirm(selection.id(),
                recommendation.solution().name(),
                recommendation.reason(),
                command.requestKey(),
                LocalDateTime.now());

        return new SelectionResult(selection.selectionNo(),
                recommendation.solution().name(),
                recommendation.reason(),
                recommendation.scores());
    }

    private Recommendation calculate(List<DimensionScore> scores) {
        Map<Dimension, Integer> value = new EnumMap<>(Dimension.class);
        for (DimensionScore score : scores) {
            value.put(Dimension.valueOf(score.dimensionCode()), score.score());
        }

        int change = value.get(Dimension.REQUIREMENT_CHANGE);
        int model = value.get(Dimension.DATA_MODEL);
        int permission = value.get(Dimension.PERMISSION);
        int integration = value.get(Dimension.INTEGRATION);
        int control = value.get(Dimension.SOURCE_CONTROL);
        int timeBudget = value.get(Dimension.TIME_BUDGET);

        BigDecimal lowCode = scoreLowCode(change, model, permission, integration, control, timeBudget);
        BigDecimal openSource = scoreOpenSourceCustom(change, model, permission, integration, control, timeBudget);
        BigDecimal custom = scoreFullCustom(change, model, permission, integration, control, timeBudget);

        Solution solution = Solution.OPEN_SOURCE_CUSTOM;
        BigDecimal best = openSource;
        if (lowCode.compareTo(best) > 0) {
            solution = Solution.LOW_CODE;
            best = lowCode;
        }
        if (custom.compareTo(best) > 0) {
            solution = Solution.FULL_CUSTOM;
        }

        String reason = buildReason(solution, change, model, permission, integration, control, timeBudget);
        return new Recommendation(solution, reason,
                Map.of("LOW_CODE", lowCode, "OPEN_SOURCE_CUSTOM", openSource, "FULL_CUSTOM", custom));
    }

    private BigDecimal scoreLowCode(int change, int model, int permission, int integration,
                                    int control, int timeBudget) {
        int score = 80;
        score -= (change - 1) * 8;
        score -= (model - 1) * 10;
        score -= (permission - 1) * 6;
        score -= (integration - 1) * 5;
        score -= (control - 1) * 10;
        score += (5 - timeBudget) * 4;
        return BigDecimal.valueOf(score);
    }

    private BigDecimal scoreOpenSourceCustom(int change, int model, int permission, int integration,
                                             int control, int timeBudget) {
        int score = 70;
        score += Math.min(change, 4) * 4;
        score += Math.min(model, 4) * 5;
        score += Math.min(permission, 4) * 4;
        score += Math.min(integration, 4) * 3;
        score += control * 5;
        score -= Math.max(timeBudget - 3, 0) * 3;
        return BigDecimal.valueOf(score);
    }

    private BigDecimal scoreFullCustom(int change, int model, int permission, int integration,
                                       int control, int timeBudget) {
        int score = 60;
        score += change * 5;
        score += model * 6;
        score += permission * 5;
        score += integration * 4;
        score += control * 4;
        score -= Math.max(4 - timeBudget, 0) * 8;
        return BigDecimal.valueOf(score);
    }

    private void ensureRequiredDimensions(List<DimensionScore> scores) {
        if (scores.size() < Dimension.values().length) {
            throw new BizException("评估维度不完整,不能生成选型建议");
        }
    }
}
这段代码有几个刻意设计。
第一,低代码不是一票否决。时间压力大、需求稳定、模型简单时,低代码分数可能最高。第二,开源二开不是默认正确。若源码质量差、许可证不适合、团队没有二开能力,实际项目仍可能失败。第三,定制开发也不是越复杂越推荐。预算和周期不足时,全定制的风险会明显上升。
代码里的分数不是财务报价,而是技术适配度。真正项目中可以把权重配置化,例如医疗、制造、集团企业对审计、权限和集成的权重会不同;小团队内部工具则可能更重视上线速度。
六、预期输出和JUnit测试
固定案例输入分数如下:
text
REQUIREMENT_CHANGE = 4
DATA_MODEL = 5
PERMISSION = 4
INTEGRATION = 3
SOURCE_CONTROL = 5
TIME_BUDGET = 3
预期输出:
text
recommended_solution = OPEN_SOURCE_CUSTOM
reason 包含:需求变化快、数据模型复杂、需要源码和部署控制
LOW_CODE 分数低于 OPEN_SOURCE_CUSTOM
FULL_CUSTOM 分数接近但受 45 天上线窗口影响
JUnit 测试可以这样写:
java
import static org.junit.jupiter.api.Assertions.assertEquals;
import static org.junit.jupiter.api.Assertions.assertTrue;
import static org.junit.jupiter.api.Assertions.assertThrows;

import org.junit.jupiter.api.Test;

class SolutionSelectionServiceTest {

    @Test
    void shouldRecommendOpenSourceCustomForAssetSystem() {
        Fixture fx = Fixture.assetSelection("SEL-20260920-004");
        fx.score("REQUIREMENT_CHANGE", 4, "三个月后新增折旧、盘点和权限");
        fx.score("DATA_MODEL", 5, "资产全生命周期需要历史和期间");
        fx.score("PERMISSION", 4, "三家公司十八个部门");
        fx.score("INTEGRATION", 3, "财务、二维码和消息提醒");
        fx.score("SOURCE_CONTROL", 5, "要求源码和部署可交接");
        fx.score("TIME_BUDGET", 3, "45天上线第一版");

        SelectionResult result = fx.service().confirm(
                new SelectionCommand(1L, "SEL-20260920-004", "REQ-04-001"));

        assertEquals("OPEN_SOURCE_CUSTOM", result.recommendedSolution());
        assertTrue(result.reason().contains("源码"));
        assertTrue(result.schemeScores().get("OPEN_SOURCE_CUSTOM")
                .compareTo(result.schemeScores().get("LOW_CODE")) > 0);
    }

    @Test
    void shouldRejectWhenRequiredDimensionMissing() {
        Fixture fx = Fixture.assetSelection("SEL-20260920-004");
        fx.score("DATA_MODEL", 5, "资产全生命周期复杂");

        BizException ex = assertThrows(BizException.class, () ->
                fx.service().confirm(new SelectionCommand(1L, "SEL-20260920-004", "REQ-04-002")));

        assertEquals("评估维度不完整,不能生成选型建议", ex.getMessage());
    }

    @Test
    void shouldPreferLowCodeWhenModelIsSimpleAndStable() {
        Fixture fx = Fixture.simpleSelection("SEL-20260920-005");
        fx.score("REQUIREMENT_CHANGE", 1, "字段稳定");
        fx.score("DATA_MODEL", 1, "单表登记");
        fx.score("PERMISSION", 1, "只有管理员维护");
        fx.score("INTEGRATION", 1, "不对接外部系统");
        fx.score("SOURCE_CONTROL", 1, "不要求源码交付");
        fx.score("TIME_BUDGET", 1, "一周内上线");

        SelectionResult result = fx.service().confirm(
                new SelectionCommand(1L, "SEL-20260920-005", "REQ-04-003"));

        assertEquals("LOW_CODE", result.recommendedSolution());
    }
}
这组测试不是为了证明某种方案永远正确,而是固定边界:复杂资产系统推荐开源二开,极简单登记工具可以推荐低代码,评分维度不完整时不能给出结论。
七、SQL验证:上线前怎么复核选型结论
第一,查评估单最终推荐:
sql
SELECT selection_no, project_name, current_stage, recommended_solution
FROM solution_selection
WHERE company_id = 1
  AND selection_no = 'SEL-20260920-004';
预期结果:
text
SEL-20260920-004 | 固定资产管理系统 | CONFIRMED | OPEN_SOURCE_CUSTOM第二,查六个评分维度是否齐全:
sql
SELECT dimension_code, score, evidence
FROM solution_selection_score
WHERE selection_id = 1001
ORDER BY dimension_code;
预期至少包含:
text
DATA_MODEL          | 5 | 资产全生命周期需要历史和期间
INTEGRATION         | 3 | 财务、二维码和消息提醒
PERMISSION          | 4 | 三家公司十八个部门
REQUIREMENT_CHANGE  | 4 | 三个月后新增折旧、盘点和权限
SOURCE_CONTROL      | 5 | 要求源码和部署可交接
TIME_BUDGET         | 3 | 45天上线第一版
第三,查三种方案得分:
sql
SELECT low_code_score,
       open_source_custom_score,
       full_custom_score,
       recommended_solution
FROM solution_selection_result
WHERE selection_id = 1001;
第四,查有没有已经确认但没有结果快照的评估单:
sql
SELECT s.selection_no, s.recommended_solution
FROM solution_selection s
LEFT JOIN solution_selection_result r ON r.selection_id = s.id
WHERE s.current_stage = 'CONFIRMED'
  AND r.id IS NULL;
这几组 SQL 的目的,是防止选型会后只留下一句"建议开源二开"。真正可复核的结论,应该能看到评分输入、推荐结果和理由快照。
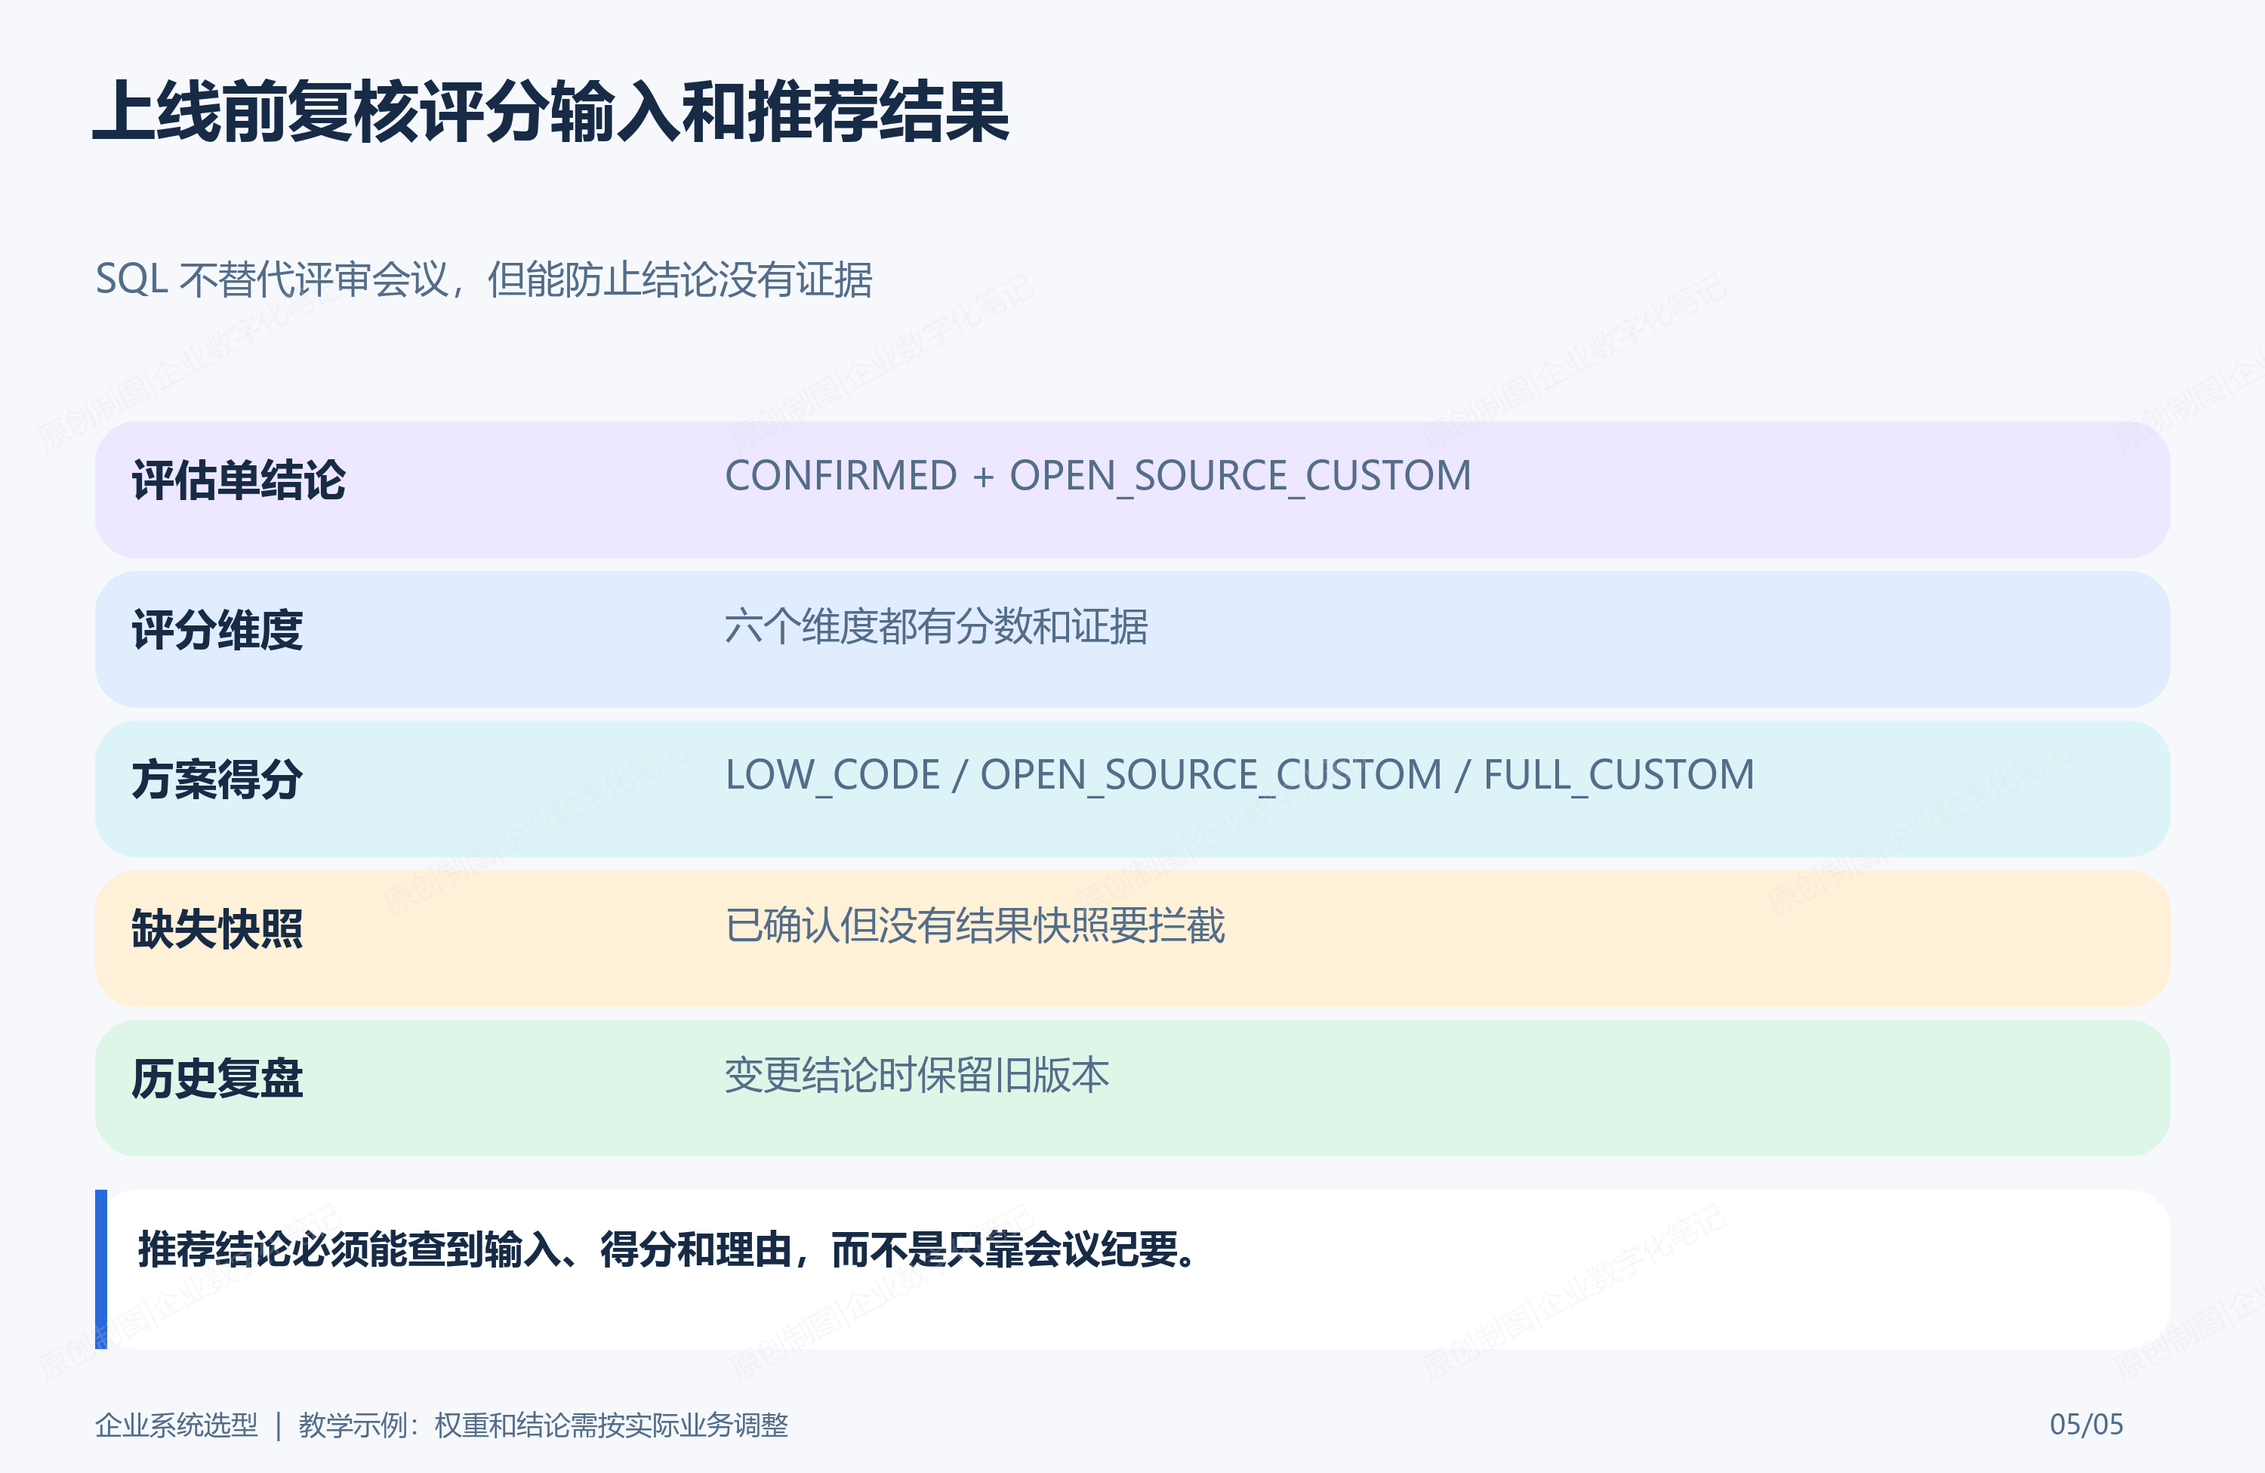
图5:评估单、评分项和结果快照都要能被 SQL 查出来。
八、异常边界和上线验收
选型评估不是写完一张表就结束,至少要检查这些边界:
| 异常 | 不能怎么做 | 应该怎么处理 |
|---|---|---|
| 评分维度缺失 | 不能生成推荐结论 | 阻断确认,提示缺少维度 |
| 证据为空 | 不能只填分数 | 要求填写原因或会议纪要 |
| 只比较报价 | 不能直接选最低价 | 同时比较源码、部署、权限、集成和维护责任 |
| 供应商不交源码 | 不能默认可二开 | 标记 SOURCE_CONTROL 高风险 |
| 开源许可证不清楚 | 不能进入生产决策 | 法务或技术负责人确认许可证边界 |
| 低代码平台锁定 | 不能忽略退出成本 | 评估数据导出、接口、私有化和二开能力 |
| 定制开发周期不足 | 不能承诺完整重做 | 拆分 MVP 和后续迭代边界 |
上线前建议按下面清单验收:
text
1. 固定资产系统的第一版和三个月后需求都已写入评估输入。
2. 六个评分维度都有分数和证据,不允许空证据确认。
3. 推荐结论能解释为什么不是纯低代码,也不是直接全定制。
4. 已明确开源系统的许可证、源码交付、部署方式和升级责任。
5. 已明确哪些模块复用开源后台,哪些模块必须定制。
6. 已明确数据模型归属,资产卡、折旧、盘点、权限不依赖黑盒配置。
7. 已明确第一版 MVP 范围和后续迭代清单。
8. 已明确二开边界、验收标准和交接材料。
9. SQL 能查到评分项、推荐结果和理由快照。
10. 评估结论变更时,保留历史快照而不是覆盖旧记录。
九、小结和延伸阅读
低代码、开源系统、定制开发不是简单的优劣排序,而是针对具体业务复杂度、变化速度、权限边界、集成要求和交付责任做取舍。固定资产系统这种长期使用的企业管理场景,最怕只看第一版页面快不快,而忽略数据模型和后续二开。
本文给出的结论是:在本案例输入下,更适合选择 OPEN_SOURCE_CUSTOM,也就是基于成熟开源后台或开源业务框架做二次开发,同时把资产核心模型、权限边界、折旧盘点和交付文档掌握在自己可控范围内。若需求只是单表登记,低代码可以更合适;若客户有非常强的行业流程和预算周期,全定制也可能更合理。关键是选型结论要有证据,而不是靠会议上的一句"这个看起来快"。
延伸阅读: