文章目录
- 前言
- 零、论文基本信息
- [一、背景:多模态 Agent 为什么需要另一种长期记忆](#一、背景:多模态 Agent 为什么需要另一种长期记忆)
-
- [1. 长上下文不能等价替代长期记忆](#1. 长上下文不能等价替代长期记忆)
- [2. 片段描述式 RAG 为什么仍然不够](#2. 片段描述式 RAG 为什么仍然不够)
- [3. 情景记忆与语义记忆承担不同职责](#3. 情景记忆与语义记忆承担不同职责)
- [二、相关工作:M3-Agent 位于哪条研究线上](#二、相关工作:M3-Agent 位于哪条研究线上)
-
- [1. LLM Agent Memory](#1. LLM Agent Memory)
- [2. 在线视频理解](#2. 在线视频理解)
- [3. 长视频问答 Agent](#3. 长视频问答 Agent)
- [三、M3-Agent 方法总览](#三、M3-Agent 方法总览)
- 四、长期记忆图:如何让脸、声音与知识围绕同一实体组织
-
- [1. 记忆节点](#1. 记忆节点)
- [2. 增量写入与冲突消解](#2. 增量写入与冲突消解)
- [3. 两种检索粒度](#3. 两种检索粒度)
- 五、记忆形成:从连续视频到情景记忆与语义记忆
- [六、控制过程:从单轮 RAG 到多轮记忆搜索](#六、控制过程:从单轮 RAG 到多轮记忆搜索)
-
- [1. 控制循环](#1. 控制循环)
- [2. 为什么使用 DAPO](#2. 为什么使用 DAPO)
- 七、M3-Bench:怎样评价"记住并推理"
-
- [1. 为什么现有 LVQA 基准不够](#1. 为什么现有 LVQA 基准不够)
- [2. 两个子集](#2. 两个子集)
- [3. 自动评价是否可信](#3. 自动评价是否可信)
- 八、实验设置
-
- [1. 训练数据](#1. 训练数据)
- [2. 对比方法](#2. 对比方法)
- 九、主实验:实体中心记忆与训练过的控制器是否有效
-
- [1. 总体提升](#1. 总体提升)
- [2. 为什么 Web 子集表现高于 Robot 子集](#2. 为什么 Web 子集表现高于 Robot 子集)
- [3. 哪些问题获益最大](#3. 哪些问题获益最大)
- 十、消融实验:性能究竟来自哪里
-
- [1. 记忆模型消融](#1. 记忆模型消融)
- [2. 控制模型消融](#2. 控制模型消融)
- [3. 语义记忆子类型与冲突投票](#3. 语义记忆子类型与冲突投票)
- 十一、记忆质量、扩展性与效率
-
- [1. 记忆模型本身是否真的更好](#1. 记忆模型本身是否真的更好)
- [2. 视频变长时会怎样](#2. 视频变长时会怎样)
- [3. 论文没有充分报告什么效率指标](#3. 论文没有充分报告什么效率指标)
- [十二、失败案例:M3-Agent 还会在哪里失效](#十二、失败案例:M3-Agent 还会在哪里失效)
-
- [1. 抽象知识与细节保存的矛盾](#1. 抽象知识与细节保存的矛盾)
- [2. 纯文本记忆不擅长空间关系](#2. 纯文本记忆不擅长空间关系)
- [3. 搜索失败与写入失败是两类问题](#3. 搜索失败与写入失败是两类问题)
- [十三、与 Agent Memory 系列方法的横向比较](#十三、与 Agent Memory 系列方法的横向比较)
- [十四、对 Coding Agent、Tool Agent 与 Multi-Agent 的工程启发](#十四、对 Coding Agent、Tool Agent 与 Multi-Agent 的工程启发)
-
- [1. Coding Agent:以实体为中心组织代码经验](#1. Coding Agent:以实体为中心组织代码经验)
- [2. Tool Agent:保存工具与对象身份,而不是只保存调用文本](#2. Tool Agent:保存工具与对象身份,而不是只保存调用文本)
- [3. Multi-Agent:共享世界图与私有经历并存](#3. Multi-Agent:共享世界图与私有经历并存)
- 十五、局限性
-
- [1. "世界知识"可能是被模型提前注入的知识](#1. “世界知识”可能是被模型提前注入的知识)
- [2. 依赖复杂且昂贵的外部组件](#2. 依赖复杂且昂贵的外部组件)
- [3. 频率投票难以处理真实变化](#3. 频率投票难以处理真实变化)
- [4. 隐私与伦理风险没有被充分展开](#4. 隐私与伦理风险没有被充分展开)
- [5. 基准仍是视频问答,不是行动闭环](#5. 基准仍是视频问答,不是行动闭环)
- [6. "无限记忆"尚未经过长期压力测试](#6. “无限记忆”尚未经过长期压力测试)
- 十六、我的理解与启发
-
- [1. M3-Agent 最重要的不是多模态,而是 identity first](#1. M3-Agent 最重要的不是多模态,而是 identity first)
- [2. 语义记忆既是性能来源,也是风险中心](#2. 语义记忆既是性能来源,也是风险中心)
- [3. 多轮检索实际上是在弥补固定索引的不足](#3. 多轮检索实际上是在弥补固定索引的不足)
- [4. 写入质量的上限比检索策略更重要](#4. 写入质量的上限比检索策略更重要)
- [5. 下一步不是存更多,而是学会遗忘与修订](#5. 下一步不是存更多,而是学会遗忘与修订)
- 十七、总结
- 参考资料
前言
在 Agent Memory 这条研究线上,A-MEM、MAGMA、CoM、ReMemR1、Mem²Evolve 等工作主要处理的是语言 Agent 的长期记忆:怎样把对话或执行轨迹写成记忆,怎样建立关联,怎样压缩、回看、检索和演化。
但真实世界中的 Agent 并不只接收文字。
一个家庭机器人可能先在厨房里看见 Alice 把咖啡放进杯子,随后只听见画外音说"早上没有它我不行";几天后,它又在另一个房间里看见同一张脸。要形成"Alice 早上喜欢喝咖啡"这条稳定知识,系统不仅要保存事件,还要解决三个更难的问题:
- 视觉中的脸与音频中的声音是否属于同一个人;
- 不同时间片里的"这个人"是否仍是同一个实体;
- 具体经历如何上升为能够复用的属性、关系和规则。
传统长视频理解往往把整段视频视为一个有限、离线的输入;普通 RAG 则把每个片段描述成文本,等问题出现后做一次检索。前者难以扩展到持续到来的无限流,后者虽然解决了存储长度,却没有真正解决人物身份的一致性、跨模态关联和世界知识积累。
M3-Agent 将问题重新定义为一个持续运行的闭环:Agent 一边看、一边听、一边把经历组织成长期记忆;收到问题后,再通过多轮搜索和推理从记忆中找答案。
本文的唯一核心增量可以概括为:
M3-Agent 将连续视听流转化为以实体为中心的多模态长期记忆图,把分散的脸、声音、情景事件和抽象语义知识绑定到稳定实体上,并训练控制模型通过多轮检索在这张图上完成推理。
M3-Bench、合成训练流程和强化学习都是为了验证或实现这一核心增量。论文真正改变的,不只是"给视频 Agent 加一个数据库",而是让多模态经历第一次能够围绕持续存在的实体被积累、纠错和调用。
零、论文基本信息
- 论文名称:Seeing, Listening, Remembering, and Reasoning: A Multimodal Agent with Long-Term Memory
- 发表平台:The Fourteenth International Conference on Learning Representations(ICLR 2026)
- 代码仓库 :ByteDance-Seed/m3-agent
- 作者:Lin Long, Yichen He, Wentao Ye, Yiyuan Pan, Yuan Lin, Hang Li, Junbo Zhao, Wei Li
一、背景:多模态 Agent 为什么需要另一种长期记忆
1. 长上下文不能等价替代长期记忆
把所有历史帧、音频和文字持续塞进上下文,看上去最完整,实际上有三个根本问题。
第一,真实环境是开放流。历史会无限增长,而上下文窗口总是有限的。即便窗口继续扩大,每次接到新指令都重新编码完整历史,计算成本也会不断增加。
第二,多模态历史的信息密度极不均匀。一小时视频里,真正与当前问题相关的可能只有几个画面、一句对话和一个人物身份线索。完整回放会让关键信号淹没在冗余观察中。
第三,原始历史只说明"发生过什么",不自动形成"世界是什么样"。机器人看见 Alice 多次早晨喝咖啡,只有经过归纳,才能得到"Alice 喜欢早晨喝咖啡"的语义知识。
因此,M3-Agent 的目标不是让模型一次看到更长的视频,而是把持续到来的观察变成可增长、可搜索、可复用的外部长期记忆。
2. 片段描述式 RAG 为什么仍然不够
Socratic Model 一类方法可以每 30 秒生成一段文字描述,再用向量检索回答问题。这种做法解决了原始视频过长的问题,却容易出现身份漂移。
例如,相邻片段可能分别写成:
- "一个穿蓝衣服的男人正在做饭";
- "一名男子说自己叫 Lucas";
- "画外音表示这是第二次尝试"。
如果三段描述没有共享的实体标识,检索系统很难确认它们都属于 Lucas。人物换衣服、离开画面,或者只剩声音时,基于自然语言外观描述的关联会更脆弱。
这也是 M3-Agent 强调 entity-centric 的原因:身份不是事后靠文本相似度猜出来,而是在记忆形成阶段就用脸和声音的持久 ID 建立锚点。
3. 情景记忆与语义记忆承担不同职责
论文借用了认知科学中 episodic memory 与 semantic memory 的区分。
- 情景记忆(Episodic Memory):保存具体事件、时间、场景、动作和对白,例如"Alice 接过咖啡,并说早上没有它不行"。
- 语义记忆(Semantic Memory):从具体经历中抽取较稳定的知识,例如"Alice 早晨喜欢喝咖啡"。
情景记忆保留证据,语义记忆提高检索与推理效率。只有情景记忆时,"Lucas 是否擅长做饭"很难通过关键词命中,因为证据可能散落在多次失败、他人指导和第二次尝试中;语义记忆可以把这些观察归纳成"Lucas 愿意学习,但烹饪尚不熟练"。
这两类记忆不是互相替代:前者负责可追溯性,后者负责可用性。
二、相关工作:M3-Agent 位于哪条研究线上
1. LLM Agent Memory
语言 Agent 的长期记忆通常保存对话、执行轨迹、摘要、向量表示或结构化知识。A-MEM 等工作进一步建立记忆间的动态联系,让记忆不再只是孤立条目。
M3-Agent 继承了"外部记忆 + 检索"的基本范式,但增加了语言系统没有的难点:同一实体会以脸、声音、对白和事件等不同模态出现,系统必须先完成跨模态身份对齐,才能构造可靠的上层知识。
2. 在线视频理解
MovieChat、MA-LMM、Flash-VStream 等方法通过滑动窗口、特征压缩或在线时序建模处理长视频。它们擅长在有限状态中保留视觉历史,却不一定显式形成"某个人是谁、与谁有什么关系、长期偏好是什么"这类世界知识。
M3-Agent 的分界线在于:视频不是一次性的理解对象,而是 Agent 持续生活在其中的经验来源。
3. 长视频问答 Agent
VideoAgent 等方法让模型主动选择片段、调用工具并回答问题,说明 agentic retrieval 能够缓解长视频中的信息定位问题。但如果底层记忆仍是互不关联的片段描述,控制策略再强也无法弥补身份混乱和高层知识缺失。
因此,M3-Agent 同时训练两个环节:memorization 决定"记忆里有什么",control 决定"怎样把记忆找出来"。
三、M3-Agent 方法总览
阅读 Figure 1 时,应把系统看成两个并行运行的进程,而不是先完整看完视频、再统一回答问题的离线流水线。
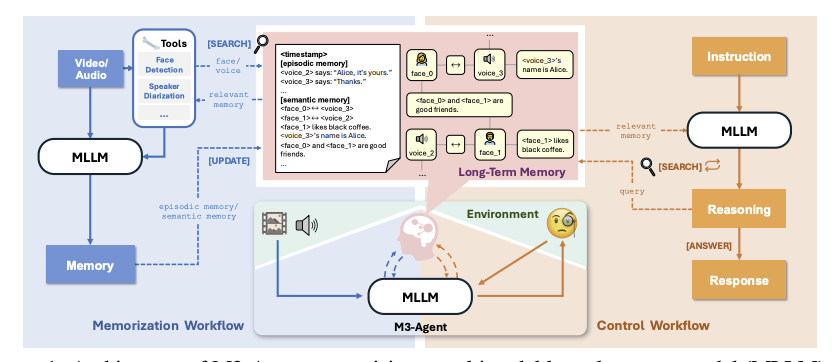
Figure 1:M3-Agent 总体架构。 左侧 memorization 持续把视听流写入长期记忆,右侧 control 根据指令进行多轮搜索与推理;中间的实体中心图将人脸、声音、事件和语义知识连接起来。
整个系统可以拆成三层:
- 感知与记忆生成层:视频按片段流式进入 MLLM,同时调用人脸识别、说话人识别等工具;模型生成情景记忆和语义记忆。
- 长期记忆层:文本、图像、音频节点被写入实体中心的多模态图,重复事实提高权重,冲突事实通过投票解决。
- 控制层:控制模型接收问题,决定继续搜索哪类记忆,或者输出最终答案;搜索结果会加入下一轮上下文。
这里有一个容易忽略的设计:memorization 和 control 并不是同一个模型。作者使用 Qwen2.5-Omni-7B 作为记忆模型的初始化,因为它原生支持视觉与音频;使用 Qwen3 系列作为控制模型的初始化,因为控制任务更依赖语言推理。论文承认概念上可以统一,但工程上先让两个策略专门化。
四、长期记忆图:如何让脸、声音与知识围绕同一实体组织
1. 记忆节点
M3-Agent 的长期记忆是外部数据库,其中每个节点是一条独立记忆。根据 Table 8,一个节点至少包含:
| 字段 | 含义 |
|---|---|
id |
节点的唯一标识 |
type |
模态类型,如文本、图像、音频 |
content |
原始文本、Base64 图像或 Base64 音频 |
embedding |
用于相似度检索的向量表示 |
weight |
节点当前的可信度或激活强度 |
extradata |
时间戳等附加元数据 |
Table 8:长期记忆节点字段。 节点同时保存原始多模态内容、检索向量、可信权重和时间信息,为语义、顺序与实体关联检索提供基础。
边表示记忆项之间的逻辑关系。属于同一实体的脸节点、声音节点和文本知识会被连接起来,因此从任意一种模态都可以访问同一人物的其他记忆。
2. 增量写入与冲突消解
新记忆到达时,系统先判断对应节点或关系是否已经存在:
- 已存在:重新激活该节点或边,并提高其权重;
- 不存在:创建新节点或新边。
如果某一次嘈杂片段把 <voice_3> 错误地连到 <face_2>,而多数清晰片段都把它连到 <face_0>,正确边会因反复激活获得更高权重。推理阶段采用权重投票,让高频证据优先于偶发冲突。
这个机制并没有真正进行逻辑层面的事实修订,它更接近一种频率加权的鲁棒聚合。优点是实现简单、对局部识别错误有容忍度;局限是"出现次数多"不一定等于"事实更新后仍正确",后文会继续讨论。
3. 两种检索粒度
论文提供两个核心搜索函数:
| 函数 | 输入与返回结果 | 适用问题 |
|---|---|---|
search_node |
接收文本、图像或音频查询,返回最相关的 top- k k k 节点;可限定模态 | 找人物、声音、属性或单条事实 |
search_clip |
返回最相关的 top- k k k 记忆片段;每个片段对应约 30 秒内的情景与语义记忆 | 找完整事件、上下文和多条关联证据 |
Table 3:长期记忆支持的搜索函数。 节点级搜索定位单项记忆,片段级搜索恢复一段时间内的情景与语义上下文。
文本节点使用 text-embedding-3-large 进行 Maximum Inner Product Search(MIPS)。实验统一设置 k = 2 k=2 k=2、相似度阈值 t = 0.5 t=0.5 t=0.5。片段级得分取该片段中最高的记忆条目相似度,再返回排名最高的片段。
这一设计优先保证检索稳定性,但也相当激进:一次只返回两个片段,能够减少噪声,却可能漏掉需要汇总三处以上证据的问题。论文把补救责任交给多轮控制策略------第一轮检索不够,就换查询继续搜。
五、记忆形成:从连续视频到情景记忆与语义记忆
1. 30 秒流式切片
M3-Agent 通常以 30 秒为单位处理视频流。每个片段的输入包括:
- 视频与原始音频;
- 人脸检测与聚类得到的 face ID;
- 说话人分离、ASR 与声纹聚类得到的 voice ID;
- 当前长期记忆中已有的实体表示。
模型输出一组情景记忆句子和一组语义记忆句子,每个涉及人物的条目都尽量使用 <face_i> 或 <voice_j>,而不是"穿红衣服的女人"这类不稳定描述。
2. 人脸与声音表示
人脸识别
系统以 5 fps 均匀采样视频帧,使用 InsightFace 的 buffalo_l 模型提取人脸框、身份向量与检测质量。异常宽高比或低置信度样本被丢弃,再用 HDBSCAN 聚类得到人物级人脸表示。
新片段中的人脸会与节点保存的代表性快照计算平均余弦相似度。最高相似度超过 0.3 0.3 0.3 时并入已有实体,否则新建 face 节点。
说话人识别
Gemini-1.5-Pro 先完成带时间戳的 ASR 和说话人切分,短于 2 秒的片段被过滤;ERes2NetV2 再编码声纹并聚类。新声纹与历史节点的匹配阈值为 0.6 0.6 0.6。
这里体现了 M3-Agent 很强的系统工程属性:所谓"端到端多模态记忆"并不是单个模型独立完成,而是由闭源模型、专用识别模型、聚类算法和开源 MLLM 共同支撑。
3. 为什么需要 face--voice 等价关系
人脸和声音即使各自聚类正确,也仍是两个 ID 空间。系统必须知道 <face_1> 与 <voice_3> 是否属于同一人。
直接让大模型在多人场景中判断并不可靠,因此作者构造了 progressive annotation algorithm:
- 对完整长视频建立全局 face ID 集合 F F F 和 voice ID 集合 V V V;
- 按关键帧把视频切成不超过 5 秒、视觉变化较小的短片段;
- 如果一个短片段恰好只有一个 face ID 和一个 voice ID,就把它视为高置信度 meta-clip;
- 统计所有 meta-clip 中 face--voice 共现次数,构成二分图;
- 删除只出现一次的边,并进行双向投票,得到 voice 到 face 的映射字典。
对某张脸 f f f,候选声音集合为 N f N_f Nf,保留最高频声音 v ∗ v^* v∗ 的条件可以写为:
v ∗ = arg max v i ∈ N f w ( f , v i ) v^*=\arg\max_{v_i\in N_f} w(f,v_i) v∗=argvi∈Nfmaxw(f,vi)
w ( f , v ∗ ) ∑ v i ∈ N f w ( f , v i ) ≥ p \frac{w(f,v^*)}{\sum_{v_i\in N_f}w(f,v_i)}\ge p ∑vi∈Nfw(f,vi)w(f,v∗)≥p
其中 w ( f , v ) w(f,v) w(f,v) 是 face--voice 对在 meta-clip 中的共现次数, p p p 是置信比例阈值。随后再从 voice 侧只保留权重最大的 face,使映射趋向一对一。
作者随机人工检查 48 个映射,准确率为 95.83%。这说明 meta-clip 是一种有效的弱监督来源,但样本量较小,且结论主要适用于说话者经常单独出镜的内容。
4. 情景记忆生成
训练标签不是人工逐句撰写,而是由 GPT-4o 与 Gemini-1.5-Pro 合成。
GPT-4o 接收以 0.5 fps 采样的帧,生成细粒度视觉描述;Gemini-1.5-Pro 接收完整音视频、face/voice ID、ASR 和 GPT-4o 描述,融合成最终情景记忆。这样组合是因为 GPT-4o 更擅长局部视觉细节,而 Gemini-1.5-Pro 可以直接处理音频并生成事件级叙述。
情景记忆要覆盖人物外观、动作、对白、互动、情绪和环境线索,但不得把未知人物名称强行写入;视觉证据使用 face ID,语音证据使用 voice ID。
5. 语义记忆生成
语义记忆不是普通摘要,而是从情景证据中抽取四类高层知识:
| 类型 | 内容 |
|---|---|
| 身份等价 | 不同模态身份是否属于同一个人物 |
| 人物属性 | 姓名、性格、职业、兴趣、背景、稳定行为特征 |
| 人际关系 | 社会角色、情绪倾向、权力关系、合作或冲突 |
| 情境与通用知识 | 场景类型、程序规范、常识、物体功能和可迁移规则 |
Table 10:M3-Agent 的记忆类型。 情景记忆保留具体经历,语义记忆则抽取身份、人物属性、关系以及情境规则。
同样地,GPT-4o 先根据帧和情景记忆提出初步结论,Gemini-1.5-Pro 再结合完整视频生成最终语义记忆。
这一步带来 M3-Agent 最重要的能力,也带来最大的风险:模型不再只是记录观察,而是在生成关于性格、关系和规则的推断。一旦推断错误,它会以"知识"形式进入长期记忆,并可能在未来被反复引用。
六、控制过程:从单轮 RAG 到多轮记忆搜索
1. 控制循环
给定问题 q q q、长期记忆 M M M、控制策略 π θ \pi_\theta πθ 和最大轮数 H H H,控制器每轮输出三个部分:
- reasoning:当前已有证据与缺失信息;
- action:
[Search]或[Answer]; - argument:搜索查询或最终答案。
若动作为 [Search],系统执行记忆检索,把结果加入轨迹,再进入下一轮;若动作为 [Answer],循环结束。实验中 H = 5 H=5 H=5。
可以把轨迹写成:
τ i ∼ π θ ( ⋅ ∣ τ < i ) \tau_i\sim\pi_\theta(\cdot\mid\tau_{<i}) τi∼πθ(⋅∣τ<i)
m i = Search ( M , a i ) , τ ← τ ∪ { τ i , m i } m_i=\operatorname{Search}(M,a_i),\qquad \tau\leftarrow\tau\cup\{\tau_i,m_i\} mi=Search(M,ai),τ←τ∪{τi,mi}
其中 a i a_i ai 是第 i i i 轮生成的搜索参数, m i m_i mi 是检索结果。关键不在公式本身,而在于查询可以随中间证据改变。
例如,问题询问 Tomasz 是否缺乏想象力:
- 第一轮先查 Tomasz 对应的 character ID;
- 第二轮查该人物与 imagination 相关的属性;
- 直接查询没有结果后,控制器把问题改写为 creative problem-solving methods;
- 检索到"对个人飞行技术具有创新和前瞻性"的语义记忆后,再给出答案。
单轮 RAG 只能用原问题搜一次,多轮控制则可以先做实体解析,再围绕新发现的概念继续检索。
2. 为什么使用 DAPO
作者先用 Qwen3 prompt 模式获得控制策略,再用 DAPO 强化学习训练 8B、14B 和 32B 模型。每个问题采样 G = 4 G=4 G=4 条轨迹,最终答案交给 GPT-4o evaluator 判断。
奖励是二元的:
R i = { 1 , Judge ( q , a , y i ) = T r u e 0 , otherwise R_i= \begin{cases} 1,&\operatorname{Judge}(q,a,y_i)=\mathrm{True}\\ 0,&\text{otherwise} \end{cases} Ri={1,0,Judge(q,a,yi)=Trueotherwise
其中 q q q 是问题, a a a 是参考答案, y i y_i yi 是第 i i i 条轨迹输出。组内优势估计为:
A ^ i = R i − mean ( R 1 , ... , R G ) std ( R 1 , ... , R G ) \hat A_i=\frac{R_i-\operatorname{mean}(R_1,\ldots,R_G)}{\operatorname{std}(R_1,\ldots,R_G)} A^i=std(R1,...,RG)Ri−mean(R1,...,RG)
DAPO 的目标仍是 clipped policy optimization:当新旧策略对某个生成 token 的概率比超过区间 1 − ϵ l o w , 1 + ϵ h i g h 1-\\epsilon_{low},1+\\epsilon_{high} 1−ϵlow,1+ϵhigh 时截断更新。论文只在模型生成的 token 上计算损失,并过滤全对或全错、没有组内差异的问题组:
0 < ∑ i = 1 G R i < G 0<\sum_{i=1}^{G}R_i<G 0<i=1∑GRi<G
这保证了一个训练组里同时有正负样本,组内相对优势才有信息量。
训练超参数为:batch size 32、学习率 10 − 6 10^{-6} 10−6、最大 5 轮、每组 4 个样本、总计 180 steps; ϵ l o w = 0.2 \epsilon_{low}=0.2 ϵlow=0.2, ϵ h i g h = 0.28 \epsilon_{high}=0.28 ϵhigh=0.28。32B 模型使用 32 张 80GB GPU,8B 与 14B 使用 16 张。
七、M3-Bench:怎样评价"记住并推理"
1. 为什么现有 LVQA 基准不够
传统长视频问答常测动作识别、时序定位或视觉细节,却不一定要求系统维护人物身份、抽取通用规则,或把语音与画面组合起来推理。M3-Bench 因此把问题设计为五类:
| 问题类型 | 主要能力 |
|---|---|
| Multi-evidence Reasoning | 汇总分散在多个片段中的多条证据 |
| Multi-hop Reasoning | 沿事件链逐步定位答案 |
| Cross-modal Reasoning | 联合视觉、语音等不同模态 |
| Person Understanding | 推断人物身份、情绪、性格或关系 |
| General Knowledge Extraction | 从具体事件抽取规则、常识或物体功能 |
Table 1:M3-Bench 的五类问题。 题目从证据聚合、跨片段推理、跨模态关联、人物理解和知识抽取五个角度检验长期记忆。
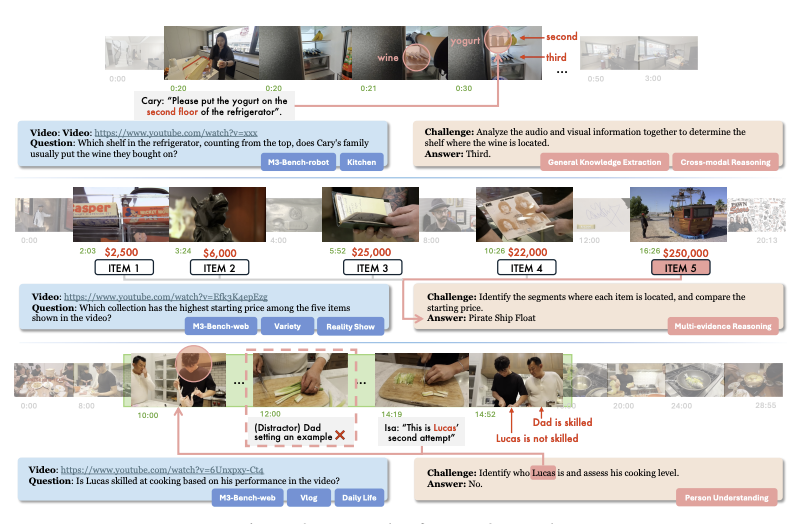
Figure 2:M3-Bench 问题样例。 样例分别要求联合语音与画面定位冰箱层数、汇总五件物品的价格,以及跨多个做饭片段判断 Lucas 的技能水平。
这些例子说明,题目并不只问"某一帧里有什么"。正确答案往往依赖身份跟踪、跨片段聚合或从行为归纳属性。
2. 两个子集
- M3-Bench-robot:100 段机器人第一视角视频,1,276 个 QA;覆盖客厅、厨房、卧室、书房、办公室、会议室和健身房等日常空间。视频由佩戴头戴相机的人类演员模拟机器人视角,共招募 67 名演员,在 51 个地点拍摄。
- M3-Bench-web:920 段 YouTube 视频,3,214 个 QA;覆盖 46 类场景,内容更多样。
正式 ICLR 版本使用 920 段 web 视频;较早页面或版本中出现过 929,写作时不能混用。
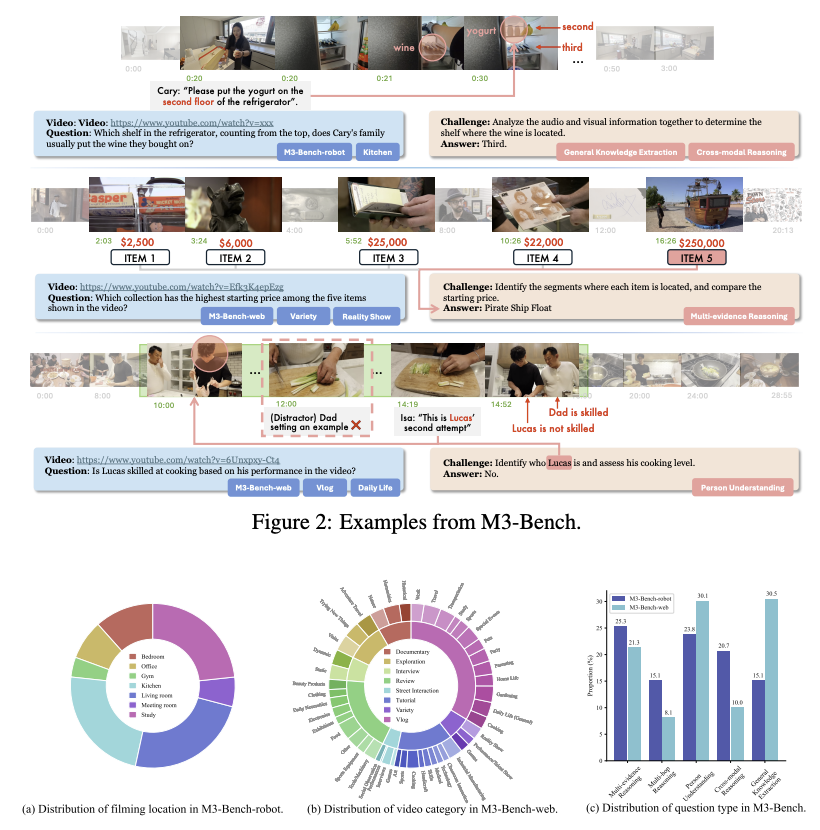
Figure 3:M3-Bench 数据统计。 展示机器人子集的拍摄地点、Web 子集的内容类别以及五类问题在两个子集中的分布。
M3-Bench-robot 的平均视频时长为 2,039.9 秒,M3-Bench-web 为 1,630.7 秒。前者更贴近具身 Agent 的连续日常经验,后者通过更广泛场景检验泛化。
3. 自动评价是否可信
开放式回答由 GPT-4o 判断是否与参考答案一致。作者随机抽取 100 个"问题---参考答案---模型回答"三元组,由三名作者独立判断,GPT-4o 与人类多数票的一致率为 96%。
附录又使用 Gemini-1.5-Pro 和 Qwen3-32B 重新评估所有系统,方法排序基本保持一致。自动评价因此具有一定稳健性,但它仍不是无偏的人工准确率:训练奖励和主指标都依赖模型裁判,可能把 evaluator 的偏好带入控制策略。
八、实验设置
1. 训练数据
训练集来自作者拥有训练许可的内部数据,包含:
- 500 个长视频;
- 26,943 个 30 秒片段;
- 2,736 个问答对;
- 10,752 条记忆训练样本和 200 条验证样本。
记忆模型在 16 张 80GB GPU 上训练 3 个 epoch,学习率 10 − 5 10^{-5} 10−5,batch size 16。
2. 对比方法
实验包含三类基线:
- Socratic Models:Qwen2.5-Omni-7B、Qwen2.5-VL-7B、Gemini-1.5-Pro 或 GPT-4o 生成片段描述,再由 GPT-4o 做单轮 RAG。
- 在线长视频理解:MovieChat、MA-LMM、Flash-VStream。
- Prompting Agent:Gemini-Agent 用 Gemini-1.5-Pro 负责记忆与控制;Gemini-GPT4o-Hybrid 用 Gemini 生成记忆、GPT-4o 做多轮控制。
此外,论文在 VideoMME-long 上测试通用长视频理解能力。所有 agent 方法最多执行 5 轮,search_clip 每次返回 2 个片段。
九、主实验:实体中心记忆与训练过的控制器是否有效
主结果可以重制为下面的总分表;完整论文还报告了五类问题的逐类结果。
| 方法 | M3-Bench-robot | M3-Bench-web | VideoMME-long |
|---|---|---|---|
| Qwen2.5-Omni-7B + RAG | 2.0 | 11.3 | 42.2 |
| Qwen2.5-VL-7B + RAG | 3.4 | 14.9 | 46.9 |
| Gemini-1.5-Pro + RAG | 8.0 | 23.2 | 38.0 |
| GPT-4o + RAG | 8.5 | 28.7 | 38.8 |
| MovieChat | 11.2 | 12.6 | 19.5 |
| MA-LMM | 24.4 | 24.3 | 17.3 |
| Flash-VStream | 19.4 | 23.6 | 25.0 |
| Gemini-Agent | 16.9 | 34.1 | 55.1 |
| Gemini-GPT4o-Hybrid | 24.0 | 41.2 | 56.5 |
| M3-Agent | 30.7 | 48.9 | 61.8 |
Table 4:三个长视频问答基准上的准确率。 M3-Agent 在机器人、Web 和 VideoMME-long 三个测试集上均取得最高总分。
1. 总体提升
M3-Agent 相对最强基线的绝对提升分别为:
- M3-Bench-robot:比 MA-LMM 高 6.3 个百分点;
- M3-Bench-web:比 Gemini-GPT4o-Hybrid 高 7.7 个百分点;
- VideoMME-long:比 Gemini-GPT4o-Hybrid 高 5.3 个百分点。
摘要写的是 robot 提升 6.7%,而正文 Table 4 按 30.7 − 24.4 计算为 6.3。正式笔记以表格可复算数字为准,并保留这一版本内部差异。
2. 为什么 Web 子集表现高于 Robot 子集
M3-Agent 在 Web 上达到 48.9,但 Robot 上只有 30.7。Robot 第一视角视频包含更多空间关系、画外声音、日常细节和视角移动,这些内容不容易被语言化记忆完整保存;Web 视频通常叙事更集中,人物和主题也更容易被文本摘要捕捉。
因此,结果并不意味着实体中心记忆已经解决了真实机器人记忆,而是说明它在强约束的长视频问答任务上比现有方案更有效。
3. 哪些问题获益最大
在 M3-Bench-robot 上,M3-Agent 的 Person Understanding 为 43.3,Cross-modal Reasoning 为 31.2;相对 MA-LMM 分别提升 4.2 和 8.5。
在 M3-Bench-web 上,相对 Gemini-GPT4o-Hybrid,Person Understanding 提升 15.5,Cross-modal Reasoning 提升 6.7。
这与论文机制高度一致:人物理解依赖长期身份一致性,跨模态推理依赖 face--voice--text 的连接。换句话说,提升集中出现在实体中心多模态图最有可能发挥作用的题型上,而不是均匀来自更大的语言模型。
但 General Knowledge Extraction 在 robot 子集上只有 19.1,低于 Gemini-GPT4o-Hybrid 的 23.1。这提醒我们,训练过的语义记忆并非在所有抽象知识问题上都优于闭源大模型;论文关于"全类型更强"的表述需要按具体列谨慎解读。
十、消融实验:性能究竟来自哪里
1. 记忆模型消融
| 记忆模型 | Robot | Web | VideoMME-long |
|---|---|---|---|
| Gemini prompt memory | 28.7 | 46.3 | 52.7 |
| Qwen2.5-Omni-7B prompt memory | 25.3 | 39.9 | 50.8 |
| 7B SFT memory(M3-Agent) | 30.7 | 48.9 | 61.8 |
| 去掉身份等价关系 | 19.5 | 39.7 | 52.1 |
| 去掉语义记忆 | 13.6 | 29.7 | 48.7 |
Table 5:记忆模型消融。 控制器固定为 32B RL,分别替换记忆生成方式、移除身份等价关系或移除语义记忆。
最强信号来自"去掉语义记忆":三个基准分别下降 17.1、19.2 和 13.1 个百分点。只保存发生过的事件远远不够,能否把事件归纳为属性、关系和规则,直接决定后续检索是否容易命中。
去掉 face--voice 等价关系也使 Robot 下降 11.2、Web 下降 9.2。这说明跨模态身份对齐不是装饰性模块,而是长期人物一致性的基础。
训练后的 7B 记忆模型甚至优于 Gemini prompt memory,尤其在 VideoMME-long 上高 9.1。这里证明的不是 7B 模型普遍强于 Gemini,而是任务定制的记忆格式和模仿学习比通用提示更适合下游检索。
2. 控制模型消融
| 控制模型 | Robot | Web | VideoMME-long |
|---|---|---|---|
| 8B Prompt | 16.4 | 35.7 | 45.3 |
| 8B RL | 24.6 | 40.5 | 50.8 |
| 14B Prompt | 18.3 | 36.9 | 49.1 |
| 14B RL | 28.2 | 46.9 | 56.0 |
| 32B Prompt | 20.7 | 40.9 | 52.5 |
| 32B DAPO(M3-Agent) | 30.7 | 48.9 | 61.8 |
| 32B GRPO | 30.0 | 47.7 | 58.7 |
| 32B RL,去掉轮间指令 | 20.2 | 43.1 | 55.9 |
| 32B RL,去掉 reasoning | 19.0 | 40.1 | 52.3 |
Table 6:控制模型消融。 DAPO 在不同模型规模上均提升表现,显式推理与每轮搜索后的指令提醒同样关键。
32B DAPO 相比 32B prompt 在三个数据集上分别提升 10.0、8.0 和 9.3。模型规模有帮助,但同规模下 RL 带来的增益同样显著。
去掉 reasoning 后分别下降 11.7、8.8 和 9.5;去掉每轮加入的 inter-turn instruction 后分别下降 10.5、5.8 和 5.9。多轮搜索不是简单循环调用检索器,控制器需要持续明确"已有信息是否足够、还缺什么、下一次查询如何与上一轮不同"。
3. 语义记忆子类型与冲突投票
| 方法 | Robot | Web | VideoMME-long |
|---|---|---|---|
| 去掉投票冲突消解 | 27.5 | 46.4 | 57.3 |
| 去掉人物属性 | 24.0 | 38.9 | 49.7 |
| 去掉人物关系 | 22.9 | 42.1 | 51.6 |
| 去掉规则知识 | 23.6 | 42.7 | 54.9 |
| 完整 M3-Agent | 30.7 | 48.9 | 61.8 |
Table 17:冲突消解与语义记忆子类型消融。 属性、人物关系和规则知识都贡献性能;频率投票也能缓解错误关联。
Robot 子集对人物关系最敏感,去掉后总分下降 7.8;Web 子集对人物属性最敏感,下降 10.0。不同视频分布需要的语义知识并不相同,未来系统不应把所有场景都压成固定模板。
十一、记忆质量、扩展性与效率
1. 记忆模型本身是否真的更好
作者在 200 条验证样本上用 AutoDQ 衡量记忆描述的 precision、recall 与 F1,并单独评价身份等价关系。训练 3 epoch 的模型取得:
- AutoDQ-F1:0.627;
- 身份等价 Precision / Recall / F1:0.836 / 0.856 / 0.846。
Gemini prompt memory 的对应 F1 为 0.606 和 0.595。SFT 模型的主要优势尤其体现在身份等价关系,而不仅是文字更长。
合成标签的人工抽检包含 353 个记忆条目,准确率 95.5%;主要错误来自背景噪声和重叠语音导致的对白遗漏或说话人误判。合成情景记忆平均 245.7 词,语义记忆平均 276.2 词,明显长于 Gemini-1.5-Pro 直接生成的 151.3 和 81.4 词。
"更长"不自动等于"更好",但结合下游消融和 AutoDQ,至少可以说明定制合成流程生成了更丰富且更可检索的记忆。
2. 视频变长时会怎样
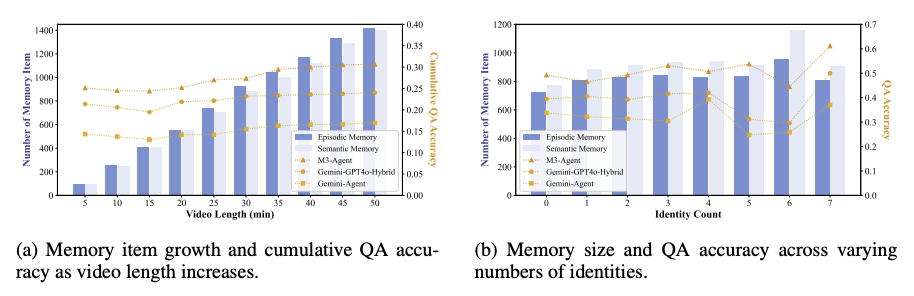
Figure 5:记忆规模与问答准确率的扩展趋势。 左图分析视频时长增加时的记忆条目和累计准确率,右图分析身份数量增加时的记忆规模和准确率。
随着视频时长增加,情景与语义记忆数量近似线性增长,但 M3-Agent 的累计 QA 准确率没有明显崩溃,并在各长度区间保持高于 Gemini-Agent 与 Gemini-GPT4o-Hybrid。
身份数量从 0 增至 7 时,记忆规模和准确率总体稳定;人物较多时,M3-Agent 与基线的差距反而更大。这支持实体中心结构在复杂人物场景中的价值。
不过 Figure 5 只覆盖约 50 分钟视频和最多 7 个身份,距离家庭机器人持续数月运行仍很远。"支持无限流"是架构层面的可增量写入能力,不是已通过无限时长实验验证的结论。
3. 论文没有充分报告什么效率指标
论文给出了训练 GPU 数量、片段长度、检索阈值和记忆增长趋势,但没有系统报告:
- 每分钟视频的记忆生成时延与费用;
- 人脸、声纹、Gemini ASR、GPT-4o 合成与 embedding API 的端到端成本;
- 随记忆增长的检索延迟;
- 在线实时处理能否跟上视频输入速率;
- 多轮控制相对单轮 RAG 的 token 与延迟开销。
因此,这篇论文证明了准确率和结构可扩展性,却没有完整证明部署效率。
十二、失败案例:M3-Agent 还会在哪里失效
作者随机分析 50 个失败样本,得到四类主要错误:
| 错误类型 | 比例 | 典型原因 |
|---|---|---|
| 细粒度细节推理 | 50% | 观察中的精确物体、动作或局部信息没有被记住 |
| 空间推理 | 20% | 语言记忆难以保存布局和空间变化 |
| 错误搜索策略 | 12% | 没有正确拆解问题或生成有效查询 |
| 缺失人物姓名 | 10% | 记忆形成阶段没有抽取回答所需姓名 |
| 其他 | 8% | 其他识别或推理错误 |
Table 19:M3-Agent 的失败类型。 一半错误来自细粒度信息损失,空间推理是第二大瓶颈,搜索策略与姓名抽取也会造成失败。
1. 抽象知识与细节保存的矛盾
语义记忆善于把多个事件压缩成稳定结论,却会牺牲一次性细节。例如"谁想吃火腿肠""帽子应该放在高衣架还是矮衣架"需要精确观察,但这些信息在写入时未必被判断为重要。
保存所有细节会造成认知过载,只保留摘要又会遗漏未来问题所需信息。论文提出未来引入 attention mechanism,让 Agent 根据任务学习选择性记忆;但在开放环境中,未来任务通常未知,这仍是尚未解决的长期记忆悖论。
2. 纯文本记忆不擅长空间关系
"杯子现在位于从上往下第二层还是第三层"需要跟踪物体位置变化。把场景转写成句子,会丢失几何关系、视角变化和相对位置。
作者建议保留更丰富的视觉快照。更进一步看,空间记忆可能需要显式 3D/拓扑表示,而不是给现有文本图多挂几张图片。
3. 搜索失败与写入失败是两类问题
12% 的错误是查询规划不当,可以通过更好的控制策略改善;但细节没写入、人物姓名没抽取时,再聪明的搜索也找不到答案。
工程上必须区分:
- memory absence:需要改进感知与写入;
- retrieval miss:需要改进索引、查询或召回;
- reasoning failure:证据齐全但结论错误。
只看最终准确率会把三者混在一起,难以定位系统瓶颈。
十三、与 Agent Memory 系列方法的横向比较
| 方法 | 主要输入 | 核心关注点 | 记忆组织/操作 | 与 M3-Agent 的区别 |
|---|---|---|---|---|
| A-MEM | 文本交互与经验 | 新记忆如何动态建立关联 | 基于内容生成链接与属性 | M3-Agent 的关联首先来自跨模态实体身份,而非只从文本语义形成 |
| MAGMA | Agent 的多类经验 | 不同功能、粒度记忆如何协同 | 多图或多层记忆组织 | MAGMA 强调记忆类型之间的组织,M3-Agent 强调脸---声音---事件---知识的实体接地 |
| CoM | 长程交互上下文 | 怎样压缩并延续长程信息 | 逐步压缩与上下文管理 | CoM 主要降低语言历史负担,M3-Agent 还需解决感知和跨模态身份一致性 |
| ReMemR1 | 阅读/写入过程中的历史记忆 | 写入时如何主动回访旧记忆 | callback retrieval 与可回访更新 | ReMemR1 强调"写新记忆前回看旧记忆",M3-Agent 则通过实体节点匹配和权重激活完成增量融合 |
| Mem²Evolve | 连续任务经验 | 记忆怎样随反馈自我演化 | 记忆生成、选择与更新闭环 | Mem²Evolve 更关注策略性演化,M3-Agent 的更新主要是新增、匹配与频率投票 |
| M3-Agent | 连续视频与音频 | 多模态经历如何成为可推理的长期世界知识 | 实体中心多模态图 + 情景/语义记忆 + 多轮控制 | 把 Agent Memory 从语言交互扩展到持续视听环境,并显式解决 face--voice 等价关系 |
这张表最重要的结论不是 M3-Agent "更全面",而是它补上了一个此前常被默认的前置环节:在多模态世界中,系统必须先知道不同观察指向谁,才谈得上记忆关联、更新和演化。
同时,M3-Agent 的记忆更新还相对初级。它依赖激活次数投票,没有像 ReMemR1 那样显式回看相关历史后重写,也没有充分处理时间有效性、事实撤销和人物偏好变化。实体接地解决了"同一个谁",却尚未完全解决"这个人的状态何时发生了变化"。
十四、对 Coding Agent、Tool Agent 与 Multi-Agent 的工程启发
以下是从论文机制出发的工程推演,不是论文直接验证的实验结论。
1. Coding Agent:以实体为中心组织代码经验
代码 Agent 的"实体"不一定是人,也可以是 repository、module、class、API、issue 和 test。相比只保存完整终端轨迹,可以构造:
- 情景记忆:某次修改了哪些文件、运行了什么测试、出现什么报错;
- 语义记忆:模块职责、隐含约束、常见故障模式、维护者偏好;
- 等价关系:重命名前后的符号、别名 API、生成文件与源文件的对应关系。
这样,查询"这个序列化 bug 为什么反复出现"时,控制器可以先找相关 class,再查历史 issue、测试失败和设计约束,而不是只检索相似错误文本。
但要避免把模型推断的"模块规则"直接当成事实。语义记忆应链接到代码位置、提交或测试证据,并在代码变化后降低旧节点权重。
2. Tool Agent:保存工具与对象身份,而不是只保存调用文本
工具 Agent 经常遇到同一对象在不同系统中有不同 ID:客户在 CRM、邮件和工单系统中的标识并不相同。这与 face--voice 等价关系非常相似。
可以建立跨工具 entity resolution:
- 将邮箱、CRM customer ID、ticket owner 和订单账户连接到同一实体;
- 情景记忆保存每次工具调用及结果;
- 语义记忆保存稳定偏好、权限、业务规则;
- 控制器先解析实体,再分别搜索事件和规则。
M3-Agent 的 meta-clip 思路也可迁移:利用同时出现两个标识的高置信度记录,自动构建跨系统映射,再通过多次共现投票降低误关联。
3. Multi-Agent:共享世界图与私有经历并存
多个 Agent 各自观察世界时,身份对齐是共享记忆的前提。Agent A 的 user_3、Agent B 的某个声纹节点和 CRM 中的客户 ID 可能是同一对象。
一个可行结构是:
- 每个 Agent 保留私有情景记忆,避免把全部原始轨迹广播给所有成员;
- 共享层只维护经证据支持的实体、关系和规则;
- 对跨 Agent 等价关系设置置信度和来源;
- 冲突时不仅看激活次数,还考虑来源可靠性、时间和权限。
这比简单共享向量库更接近可维护的团队记忆。
十五、局限性
1. "世界知识"可能是被模型提前注入的知识
语义记忆由 GPT-4o 与 Gemini-1.5-Pro 合成,最终 7B 模型模仿这些标签。系统表现出的常识与人物理解,部分来自教师模型已有知识,而不一定完全由视频经验中自主学习得到。
因此,更准确的说法是"从观察中生成并积累语义记忆",而不是严格意义上从零获得世界知识。
2. 依赖复杂且昂贵的外部组件
训练数据合成依赖 GPT-4o 和 Gemini-1.5-Pro;运行时语音处理仍使用 Gemini-1.5-Pro,文本向量使用 OpenAI embedding API,同时还需要人脸与声纹模型。系统不是完全本地、开源、端到端的 Agent。
组件中的任何误差都会沿记忆链传播:ASR 错误影响情景记忆,声纹聚类错误影响身份边,错误语义记忆又影响未来检索。
3. 频率投票难以处理真实变化
如果 Alice 过去常喝咖啡,后来因健康原因改喝茶,旧事实因为被多次激活可能拥有更高权重。频率投票适合消除偶发噪声,却会阻碍对概念漂移和最新状态的适应。
更成熟的机制需要同时考虑频率、时间衰减、证据来源、互斥关系和有效时间区间。
4. 隐私与伦理风险没有被充分展开
系统持续存储人脸、声纹、姓名、性格、关系和日常偏好,这些都是高度敏感数据。真实部署必须考虑知情同意、删除权、访问控制、身份误关联、加密以及语义推断带来的画像风险。
尤其是"性格""权力关系"等语义记忆,本质上可能是模型的主观推断,不应被当成确定事实长期保存。
5. 基准仍是视频问答,不是行动闭环
论文用长视频模拟 Agent 的感知流,最终任务仍是 QA。它没有验证错误记忆是否会导致机器人执行危险动作,也没有评价行动结果如何反过来修正记忆。
从"能根据记忆回答"到"能根据记忆安全行动",还差因果验证、风险控制与在线反馈更新。
6. "无限记忆"尚未经过长期压力测试
记忆条目随视频时长近似线性增长。线性增长比重复编码完整历史更可控,但并不意味着规模不受限制。论文没有测试数月、数年数据,也没有给出遗忘、归档、合并和垃圾回收机制。
十六、我的理解与启发
1. M3-Agent 最重要的不是多模态,而是 identity first
很多多模态记忆工作把图像、音频和文本都放进向量库,就称为多模态长期记忆。M3-Agent 更进一步:不同模态不是平行存储,而是先围绕实体建立等价关系,再把事件和知识挂到实体上。
这个顺序很重要:
先解决"这是同一个谁",再解决"关于它发生过什么",最后才解决"我们从这些经历中知道了什么"。
缺少第一步时,知识会分裂在多个身份下;缺少第二步时,语义结论没有证据;缺少第三步时,检索只能翻找大量原始事件。
2. 语义记忆既是性能来源,也是风险中心
消融显示,去掉语义记忆造成最大下降。这说明长期记忆的价值不在于存得更多,而在于把经历转化为更容易被未来任务使用的抽象。
但抽象是一种有损压缩,也是一次推断。人物"做饭不熟练"也许只在某个菜品上成立,"绿色垃圾桶用于回收"也许只适用于某个家庭。语义记忆如果缺少证据链接、适用范围和时间条件,就会把局部经验误写成永久规则。
更理想的节点不应只保存一句结论,还应包含:
- 支撑它的情景记忆 ID;
- 适用场景和时间范围;
- 置信度与来源;
- 反例和最近一次验证时间。
3. 多轮检索实际上是在弥补固定索引的不足
M3-Agent 的索引并不复杂:文本 embedding、top-2、固定阈值。强大之处来自控制器会根据结果改变查询。
这给工程实践一个重要启发:当一次检索难以覆盖复杂问题时,不一定先堆叠更复杂的 hybrid retriever;也可以训练 Agent 把检索当作可观察、可修正的行动。检索结果不是最终上下文,而是下一步计划的反馈。
4. 写入质量的上限比检索策略更重要
失败分析中,大多数问题并不是"搜不到已经存在的内容",而是细节、空间或姓名从未被正确写入。一个完美检索器无法恢复不存在的记忆。
Agent Memory 的评估因此应该分三层:
- write fidelity:原始观察中的信息是否被保存;
- memory validity:抽象知识是否正确、有证据、有时效;
- read utility:控制器能否在需要时取回并使用。
M3-Agent 已经分别评价了记忆模型和 QA,但未来还需要更细的端到端归因。
5. 下一步不是存更多,而是学会遗忘与修订
论文展示了如何增量增加节点、加强重复关系,却没有真正处理旧知识的失效。长期运行的 Agent 必须拥有删除、衰减、合并、分叉和版本化能力。
如果把 M3-Agent 与 ReMemR1、Mem²Evolve 的思想结合,一个自然方向是:新观察到来时,不只是找到相似实体并提高权重,而是主动检索相关旧结论,判断它们应被确认、限定、替换还是保留为历史状态。这样,多模态实体图才会从"不断增长的记忆库"变成"持续维护的世界模型"。
十七、总结
M3-Agent 将 Agent Memory 从文字交互推进到连续视听环境。它用人脸与声纹建立稳定实体,以情景记忆保存具体经历,以语义记忆抽取人物属性、关系和通用规则,再用经过强化学习的控制器进行最多五轮的迭代检索与推理。
实验表明,这套组合在 M3-Bench-robot、M3-Bench-web 和 VideoMME-long 上分别达到 30.7、48.9 和 61.8,整体优于在线长视频模型、单轮 RAG 和闭源模型 prompting agent。消融进一步说明,语义记忆、身份等价关系、冲突投票、多轮指令和显式 reasoning 都有实质贡献。
但论文的边界也很清楚:系统仍依赖多个闭源 API,效率报告不完整,细粒度与空间信息容易在语言化时丢失,频率投票无法妥善处理事实变化,视频问答也尚不能代表真实行动闭环。
一句话总结:
M3-Agent 的核心贡献,是让多模态 Agent 不再把视频切片当作彼此孤立的描述,而是围绕持续存在的实体,把看见的脸、听见的声音、经历的事件和归纳出的知识组织成一套能够被多轮推理调用的长期记忆。