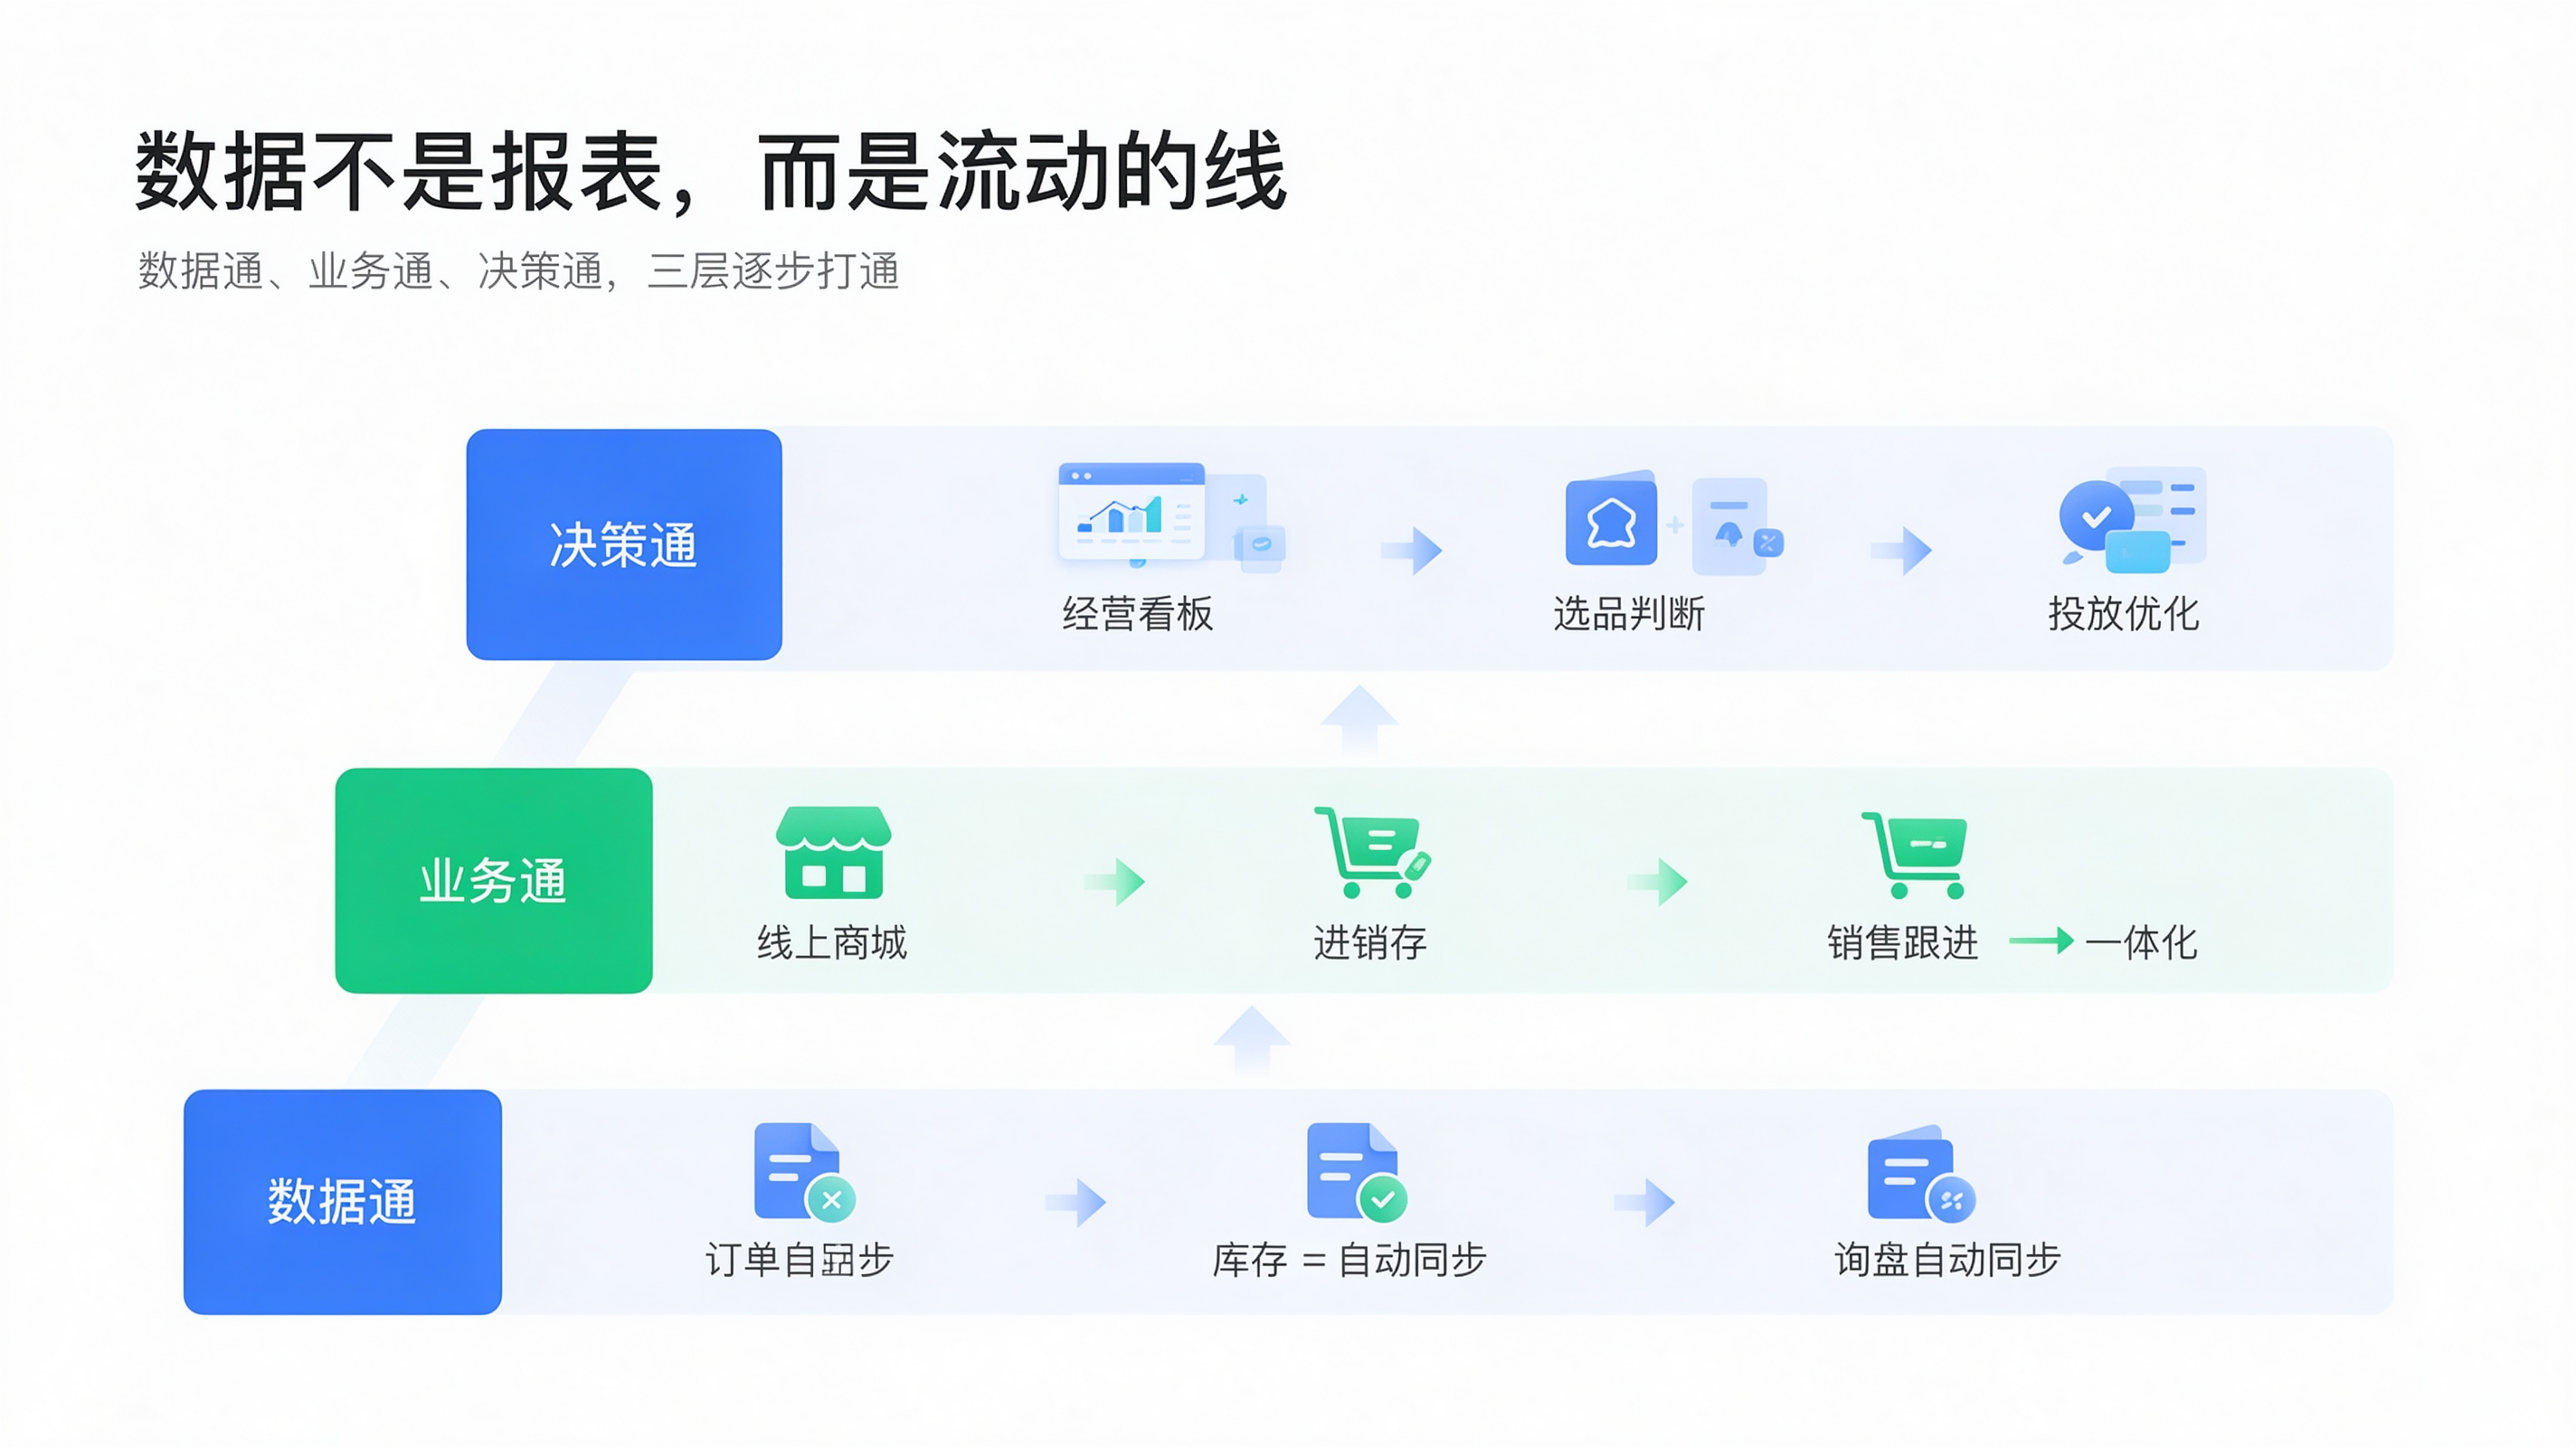
我参与过的长沙本地中小企业项目,环境大多是 Windows 10/11 + Excel + 微信,团队 20~80 人,年营收 2000 万到 2 个亿,共同点是:没有人专职做数据,但每个人都在拍脑袋定决策。
最典型的一次经营例会,销售说"这个月不错",财务说"毛利在掉",双方拿的明明是同一批订单,毛利率算出来差了近 8 个百分点------因为一个用含税收入,一个用不含税收入。决策升级的关键,从来不是先买系统,而是先让数据可解释。数据驱动决策的第一步是"口径唯一",第二步才是"工具自动化"。
本文给出一套复制即用的落地路径:一份指标口径字典、一份可运行的 pandas 指标脚本、一个 Streamlit 经营看板、一份 30 天推进表,代码均可在 Python 3.11 环境直接跑通。
一、环境准备:先把版本和数据清单对齐 🧰
1.1 软件环境清单
| 组件 | 版本 | 说明 |
|---|---|---|
| 操作系统 | Windows 10 22H2 / Windows 11 23H2 | 办公机、门店机均可 |
| Python | 3.11.7 | 3.9+ 均可运行本文代码 |
| pandas | 2.1.4 | 清洗与指标计算 |
| numpy | 1.26.4 | 仅复现环节用于造模拟数据 |
| openpyxl | 3.1.2 | 读写 Excel 台账 |
| streamlit | 1.30.0 | 一键起经营看板 |
| SQLite | 3.41(或 MySQL 8.0.35) | 数据落库,单文件零运维 |
| 浏览器 | Chrome 121+ | 访问看板 |
环境验证命令(一条过,缺库会直接报错):
bash
python -c "import pandas, numpy, streamlit, openpyxl; print(pandas.__version__, streamlit.__version__)"1.2 数据前置清单
拍脑袋的根因往往不是"没数据",而是"数据没法定"。先确认三张源表:
| 源表 | 关键字段 | 常见来源 | 更新频率 |
|---|---|---|---|
| 订单明细 | order_id, order_date, sku, qty, price, cost, freight, paid | 进销存 / 电商后台导出 | 每日 |
| 库存快照 | sku, stock_qty, stock_cost, snapshot_date | 仓库台账 | 每周 |
| 费用表 | item, amount, month, type | 财务 | 每月 |
只有"订单明细"这一张表是唯一事实来源,其余表都通过 sku 与月份关联,避免同一指标在不同表里算出不同结果。
二、问题复现:拍脑袋决策的三个技术症状 🔍
2.1 症状一:口径不一致
业务口径"毛利 = 收入 − 成本",财务口径"毛利 = 不含税收入 − 成本 − 运费"。同一批订单,两个答案。
2.2 症状二:只有结果,没有过程
报表上只有"本月销售额",没有库存周转天数、动销率、低毛利订单数,所以出了问题只能凭感觉归因。
2.3 症状三:没有基线
"这个月毛利率 30%,好不好?"------没有历史趋势,无法判断。
用一段可运行代码把"两个毛利"复现出来:
python
import numpy as np
import pandas as pd

# 造一份和真实业务结构一致的模拟订单(仅复现用)
rng = np.random.default_rng(42)
n = 2000
df = pd.DataFrame({
    "order_id": np.arange(1, n + 1),
    "sku": rng.choice(["A-100", "B-200", "C-300"], n),
    "qty": rng.integers(1, 20, n),
    "price": rng.uniform(30, 260, n).round(2),   # 含税单价
    "cost": rng.uniform(20, 160, n).round(2),    # 单位商品成本
    "freight": rng.uniform(0, 12, n).round(2),   # 每单运费
})
df["amount_incl_tax"] = (df["qty"] * df["price"]).round(2)
df["cost_total"] = (df["qty"] * df["cost"]).round(2)

TAX_RATE = 0.13

# 口径 A:含税收入 - 商品成本(业务口径)
gross_a = df["amount_incl_tax"].sum() - df["cost_total"].sum()
# 口径 B:不含税收入 - 商品成本 - 运费(财务口径)
revenue_ex = df["amount_incl_tax"].sum() / (1 + TAX_RATE)
gross_b = revenue_ex - df["cost_total"].sum() - df["freight"].sum()

print("口径A毛利率: %.2f%%" % (gross_a / df["amount_incl_tax"].sum() * 100))
print("口径B毛利率: %.2f%%" % (gross_b / revenue_ex * 100))
print("两者相差: %.2f 个百分点" % ((gross_a / df["amount_incl_tax"].sum()
                                   - gross_b / revenue_ex) * 100))
输出结果:
口径A毛利率: 37.79%
口径B毛利率: 29.81%
两者相差: 7.98 个百分点
复现步骤:
- 把上面的代码保存为
repro.py,执行python repro.py。 - 直接读取供应商导出的 CSV,会先踩一个坑:
pandas.errors.ParserError: Error tokenizing data. C error: Expected 12 fields in line 1583, saw 15原因是导出的 CSV 里混入了含逗号和换行的备注字段,处理方式见下节方案代码。
- 让财务与销售各自说出"本月毛利率",记录两个数字的差值------这个差值就是本次升级要消灭的目标。
三、核心方案:三条落地路径与选型 ✅
3.1 方案 A:Excel 透视 + 口径字典(1 人 1 天)
不写代码,但对"口径字典"有硬要求,字典必须落成文档并指定唯一责任人:
| 指标 | 计算口径(唯一版本) | 责任人 | 更新频率 |
|---|---|---|---|
| 不含税收入 | Σ(qty × price) ÷ 1.13 | 财务 | 每日 08:30 |
| 毛利额 | 不含税收入 − 商品成本 − 运费 | 财务 | 每日 |
| 毛利率 | 毛利额 ÷ 不含税收入 | 财务 | 每日 |
| 库存周转天数 | 期末库存成本 ÷ 日均出库成本 | 仓储 | 每周 |
| 动销率 | 有出库 SKU 数 ÷ 在库 SKU 数 | 仓储 | 每周 |
| 客单价 | 不含税收入 ÷ 有效订单数 | 销售 | 每日 |
| 回款率 | 已回款金额 ÷ 应收金额 | 财务 | 每周 |
| 低毛利订单数 | 单笔毛利率 < 5% 的订单数 | 销售 | 每日 |
适合人少、数据量 5 万行以内的团队,缺点是跨月口径容易被人手改写。
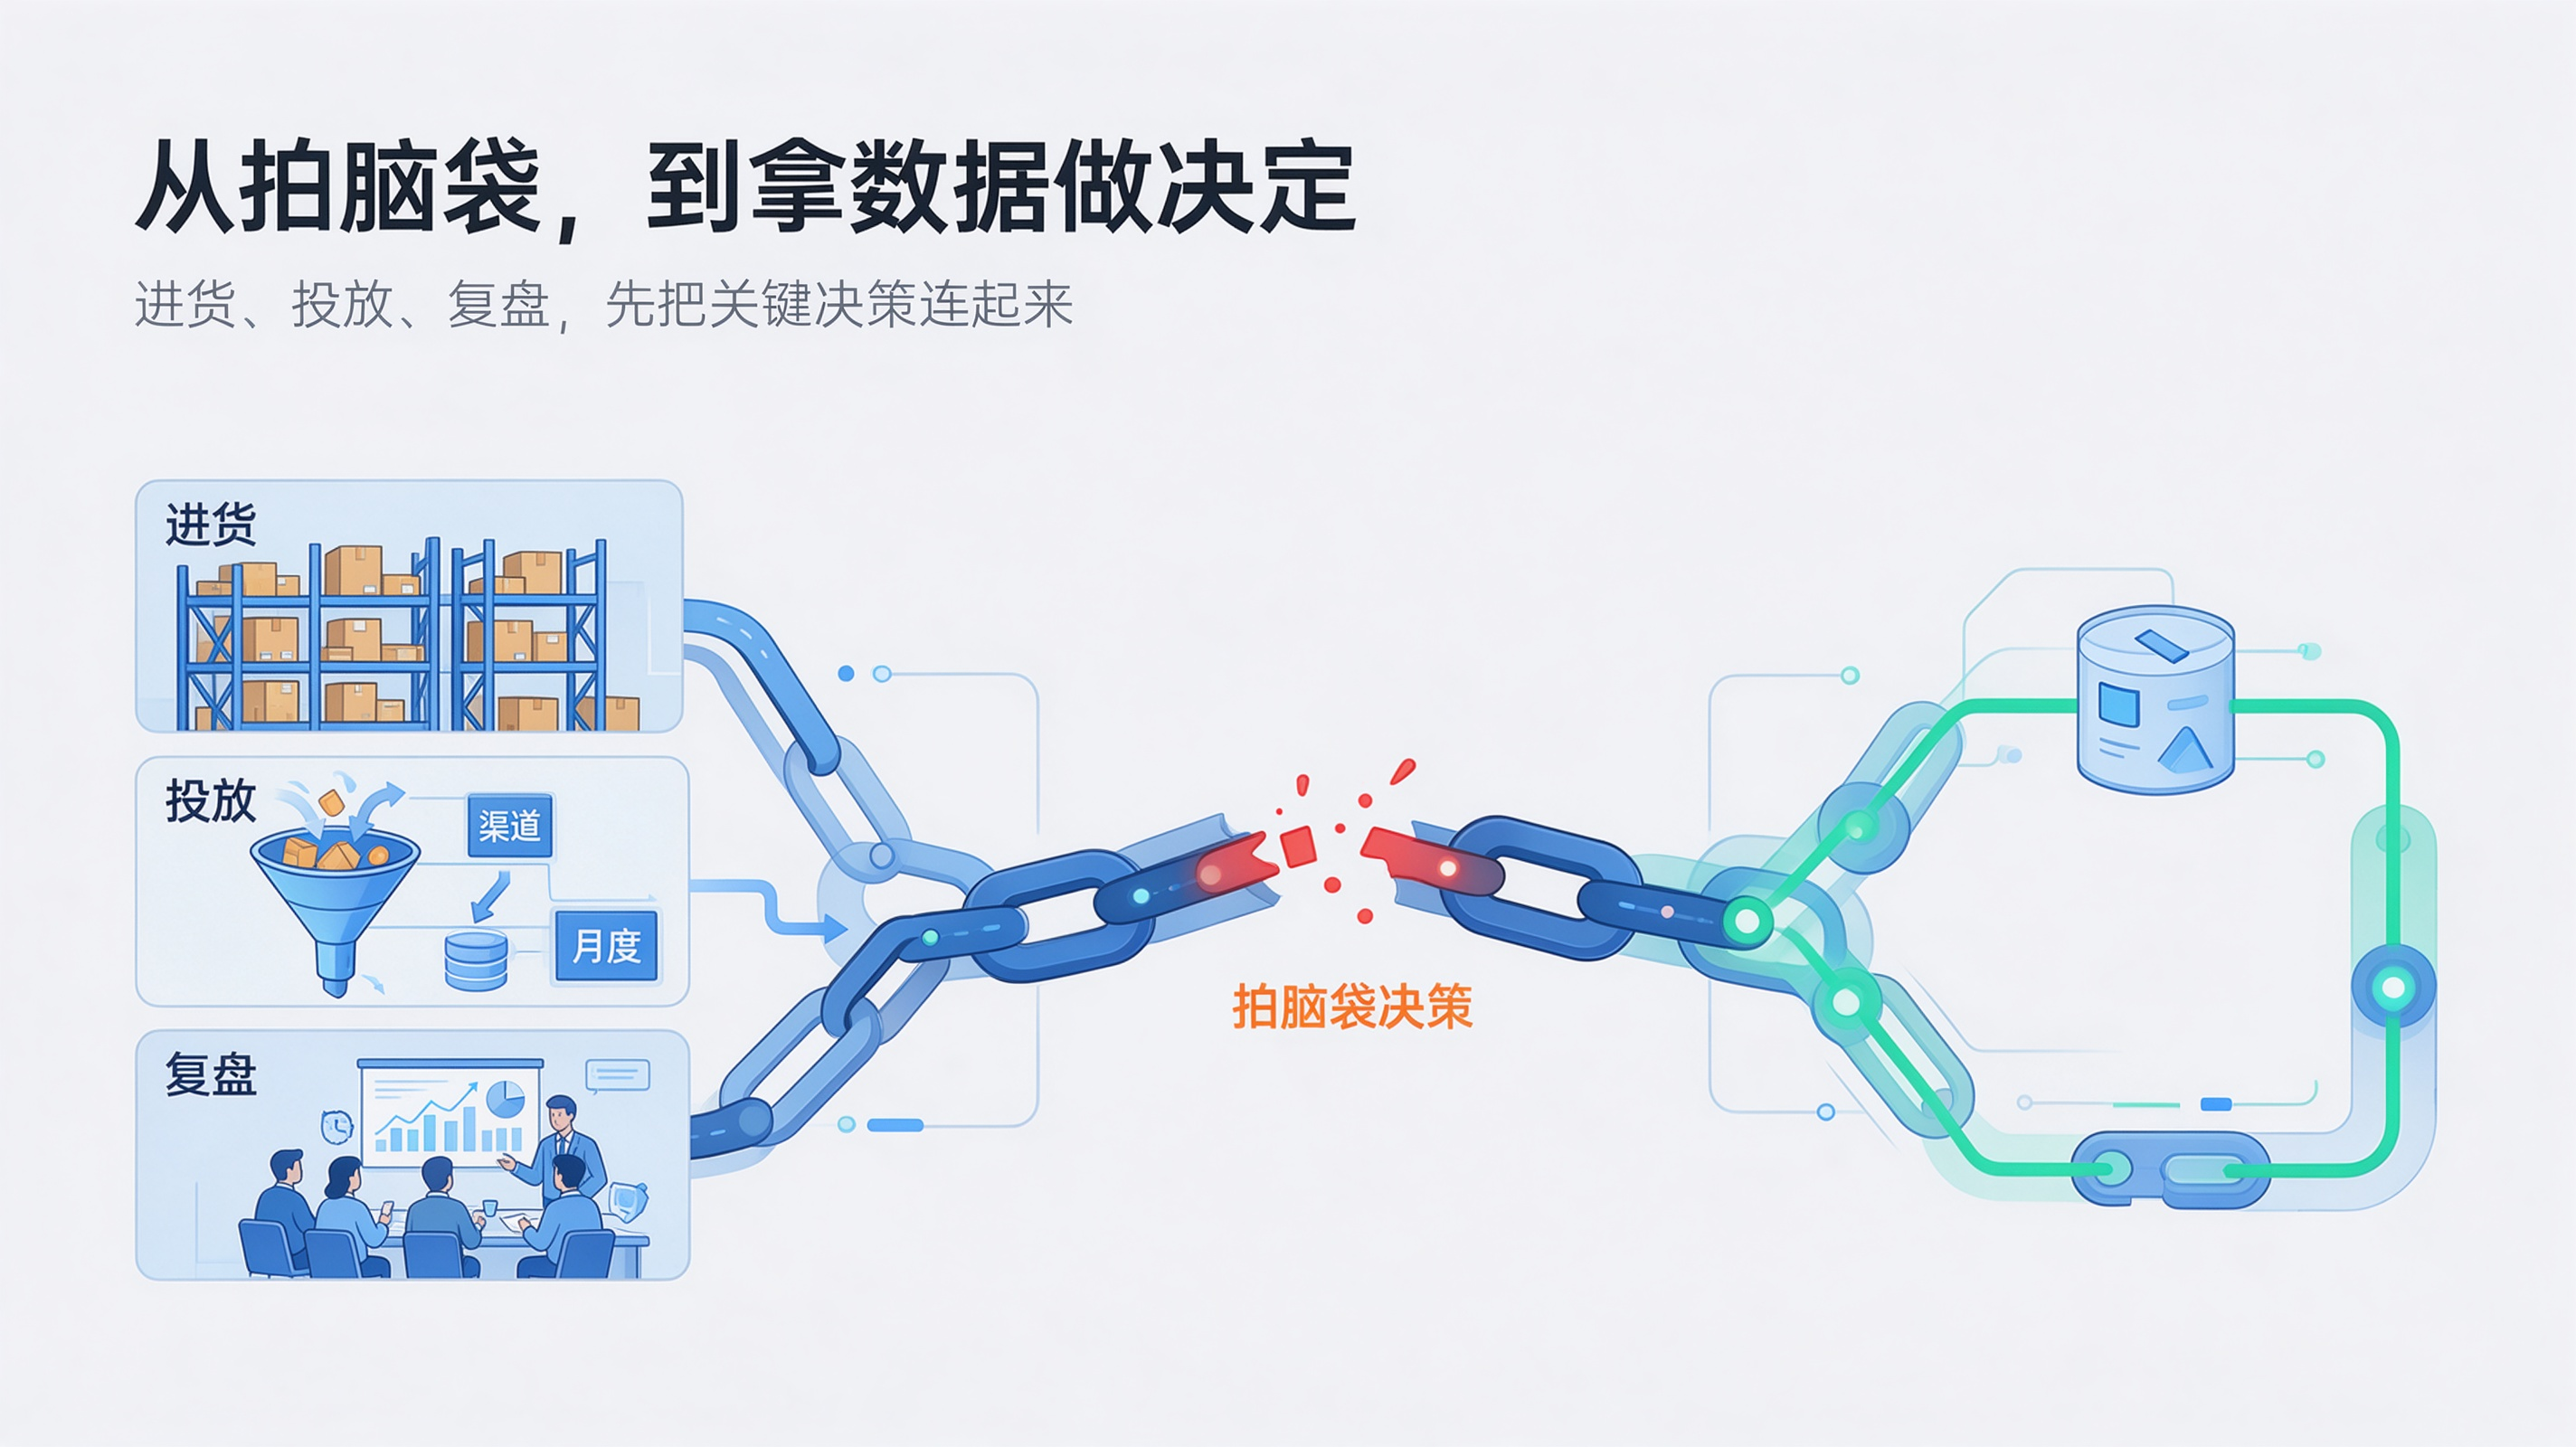
3.2 方案 B(推荐):SQLite + pandas + Streamlit
核心思路:把所有指标计算收口到一个 kpi.py,任何报表都只能调用它。
先落库并处理脏数据:
python
import sqlite3
import pandas as pd

# 脏 CSV 用 python 引擎 + on_bad_lines 跳过异常行,同时打印告警
orders = pd.read_csv("orders.csv", parse_dates=["order_date"],
                     engine="python", on_bad_lines="warn")

con = sqlite3.connect("biz.db")
orders.to_sql("fact_order", con, if_exists="replace", index=False)
con.close()
print("入库行数:", len(orders))指标计算入口(唯一的计算真相):
python
# kpi.py
from pathlib import Path
import pandas as pd

TAX_RATE = 0.13  # 税率写死在口径字典里,禁止各处各写

def load_orders(csv_path: str | Path) -> pd.DataFrame:
    df = pd.read_csv(csv_path, parse_dates=["order_date"],
                     engine="python", on_bad_lines="warn")
    df["amount_incl_tax"] = (df["qty"] * df["price"]).round(2)
    df["cost_total"] = (df["qty"] * df["cost"]).round(2)
    return df

def monthly_kpi(df: pd.DataFrame, month: str) -> dict:
    d = df[df["order_date"].dt.strftime("%Y-%m") == month].copy()
    revenue = round(d["amount_incl_tax"].sum() / (1 + TAX_RATE), 2)  # 统一为不含税口径
    cost = round(d["cost_total"].sum(), 2)
    freight = round(d["freight"].sum(), 2)
    gross = round(revenue - cost - freight, 2)  # 毛利额 = 不含税收入 - 商品成本 - 运费
    d["gross_row"] = d["amount_incl_tax"] / (1 + TAX_RATE) - d["cost_total"] - d["freight"]
    d["margin_row"] = d["gross_row"] / (d["amount_incl_tax"] / (1 + TAX_RATE))
    return {
        "month": month,
        "revenue_ex_tax": revenue,
        "cost": cost,
        "freight": freight,
        "gross_profit": gross,
        "gross_margin": round(gross / revenue, 4) if revenue else 0.0,
        "order_cnt": int(d["order_id"].nunique()),
        "avg_order_value": round(revenue / d["order_id"].nunique(), 2) if revenue else 0.0,
        "low_margin_orders": int((d["margin_row"] < 0.05).sum()),
    }

if __name__ == "__main__":
    print(monthly_kpi(load_orders("orders.csv"), "2024-05"))
看板(一条命令启动):
python
# dashboard.py   运行:streamlit run dashboard.py
import streamlit as st
import pandas as pd
from kpi import load_orders, monthly_kpi

st.set_page_config(page_title="经营看板", layout="wide")
st.title("经营看板 · 数据说话")

orders = load_orders("orders.csv")
months = sorted(orders["order_date"].dt.strftime("%Y-%m").unique())
month = st.sidebar.selectbox("选择月份", months, index=len(months) - 1)

kpi = monthly_kpi(orders, month)
rows = [monthly_kpi(orders, m) for m in months]

c1, c2, c3, c4 = st.columns(4)
c1.metric("不含税收入", f"{kpi['revenue_ex_tax']:,.0f}")
c2.metric("毛利额", f"{kpi['gross_profit']:,.0f}")
c3.metric("毛利率", f"{kpi['gross_margin'] * 100:.1f}%")
c4.metric("低毛利订单", kpi["low_margin_orders"])

st.subheader("月度毛利率趋势(口径唯一,跨月可比)")
trend = pd.DataFrame(rows).set_index("month")[["revenue_ex_tax", "gross_margin"]]
st.line_chart(trend)
st.caption("所有指标均由 kpi.py 计算,禁止在 Excel 中二次手改")关键点:TAX_RATE 与毛利公式只出现一次,从此销售和财务不可能再算出两个数字。
3.3 方案 C:外部咨询或商业 BI 采购
需要外部力量时,建议用加权评分替代"看谁讲得好":
python
# scoring.py ------ 选型不靠感觉,靠加权打分(1-10 分,可自行调整权重)
weights = {"口径可解释": 0.30, "上手成本": 0.20, "扩展性": 0.25, "年度成本": 0.25}
candidates = {
    "方案A Excel+口径字典": {"口径可解释": 8, "上手成本": 10, "扩展性": 3, "年度成本": 10},
    "方案B SQLite+pandas+看板": {"口径可解释": 9, "上手成本": 7, "扩展性": 9, "年度成本": 9},
    "方案C 外部咨询/商业BI": {"口径可解释": 7, "上手成本": 9, "扩展性": 8, "年度成本": 2},
}
for name, s in candidates.items():
    print(f"{name:26s} {sum(s[k] * weights[k] for k in weights):.2f}")
输出:
方案A Excel+口径字典 7.65
方案B SQLite+pandas+看板 8.60
方案C 外部咨询/商业BI 6.40
本环境下的结论是方案 B。若需要外部团队,访谈本地服务商时值得核对的三个点是:是否上门做实地诊断、源码是否可控、是否提供按月复盘------这三点比"功能清单长不长"更能决定项目能不能活过第三个月(以下为笔者在长沙本地项目访谈中了解到的通行做法,脱敏整理,无商业合作)。
四、小步实践:30 天四步推进法 🚀
| 周次 | 目标 | 交付物 | 验收标准 |
|---|---|---|---|
| 第 1 周 | 定口径 | 8 个指标的一页口径字典 | 财务与销售在同一张表上确认 |
| 第 2 周 | 通数据 | 订单表落库、能一条语句跑出上月收入 | monthly_kpi() 结果与财务对数表差值 < 1% |
| 第 3 周 | 出日报 | 自动日报 + 看板链接 | 每天 09:00 前推到工作群 |
| 第 4 周 | 改会议 | 30 分钟周会议程,一人一指标 | 每个指标都有责任人和环比结论 |
三个最容易踩的坑:
- 一次上全量指标。第一版只做 8 个,做多了没人看。
- 让业务手工录数据。录入环节必须自动化,否则三周后数据就断了。
- 看板只给老板看。指标要落到具体人的名字上,否则不会有人对数字负责。
五、验证测试:用同一套口径量一遍 📊
测试环境:4 核 8G Windows 11,订单明细 12.4 万行,orders.csv 约 18MB,单机运行。
| 指标 | 优化前 | 优化后 | 采集方式 |
|---|---|---|---|
| 月度经营报表制作耗时 | 4.5 小时 | 8 分钟 | 手工计时 3 次取均值 |
| 口径争议次数 | 6 次/月 | 1 次/月 | 会议记录统计 |
| 库存周转天数 | 62 天 | 45 天 | 看板连续 8 个月数据 |
| 低毛利订单占比 | 未统计 | 12% → 6% | 看板 low_margin_orders |
| 毛利核算差错 | 每季度 2~3 笔 | 0 笔 | 财务对数表比对 |
数据说明:以上为笔者参与的长沙本地中小企业项目脱敏整理结果,测试环境已在表头标注,非行业基准值,请以自测数据为准。
口径一致性用单元测试守住:
python
# test_kpi.py   运行:pytest -q test_kpi.py
from kpi import load_orders, monthly_kpi

def test_gross_margin_matches_finance():
    kpi = monthly_kpi(load_orders("orders.csv"), "2024-05")
    finance_gross_margin = 0.298          # 财务对数表提供的月度毛利率
    assert abs(kpi["gross_margin"] - finance_gross_margin) < 0.01  # 误差 1 个百分点以内
    assert kpi["revenue_ex_tax"] > 0
    assert kpi["order_cnt"] > 0
这两个断言一旦进入 CI 或每周手动跑一次,"两个毛利"的问题就再也不会复发。
六、总结:三条可迁移的认知 💡
- 口径先于工具。指标算不清,买再贵的系统也只是把错误数字化。先把口径写成字典并指定唯一责任人。
- 计算逻辑必须单点收口 。
kpi.py这类唯一入口,比"每人手里一份 Excel 模板"可靠得多。 - 小步快跑,但每一步都要有验收标准。30 天四步,每步都有可量化的验收条件,老板才敢继续投人投钱。
结尾做个可复现声明:本文代码在 Python 3.11.7 + pandas 2.1.4 + streamlit 1.30.0 + SQLite 3.41 环境下验证通过,关键依赖见第一节环境清单,orders.csv 替换成自家订单导出文件即可运行。
如果你所在的企业还没有 8 个统一口径的指标,欢迎在评论区说说:你们第一个想统一的指标是毛利率、库存周转,还是回款率?你踩过的最大坑是什么。