架构总览
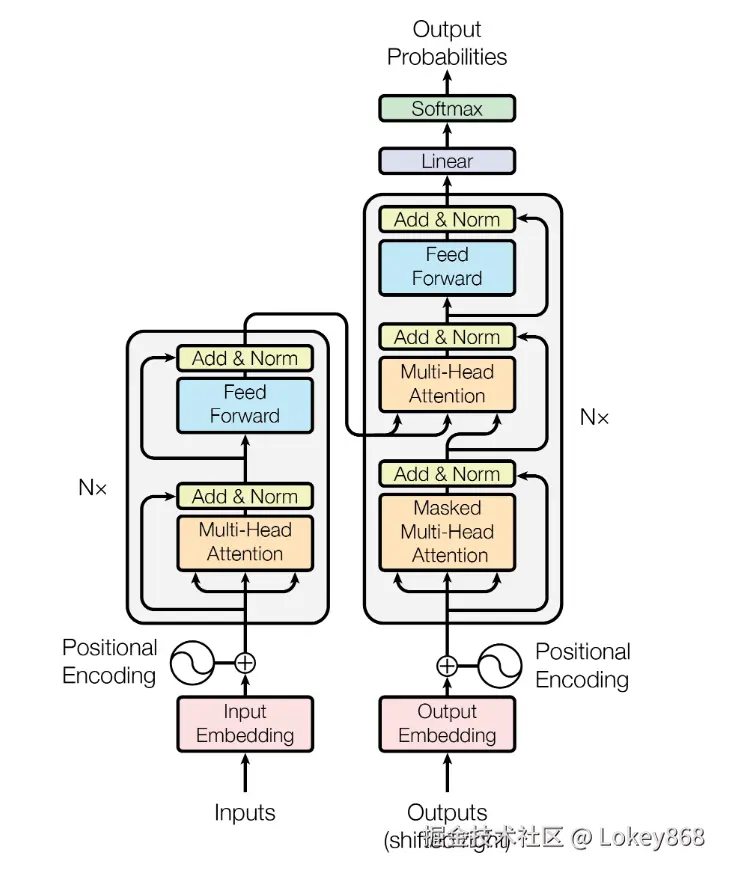
最经典的transformer的网络设计采用Encoder-Decoder架构,Encoder处理源序列,编码整个序列供Decoder查询,一次推理过程通常只需进行一次encode。Decoder通过Crosss-Attention机制关注Encoder的输出,逐词生成目标序列
Imput Embedding (词嵌入)
Embedding 把输入的 token id 序列 (B, L) 映射成 稠密向量 (B, L, d_model)。实现上是查表:权重矩阵形状 (vocab_size, d_model),每个 token id 取出对应行。数学上等价于 one-hot 向量乘权重矩阵,但用查表实现更高效。
python
class Embeddings(nn.Module):
    def __init__(self, d_model, vocab):
        super(Embeddings, self).__init__()
        self.lut = nn.Embedding(vocab, d_model)
        self.d_model = d_model

    def forward(self, x):
        return self.lut(x) * math.sqrt(self.d_model)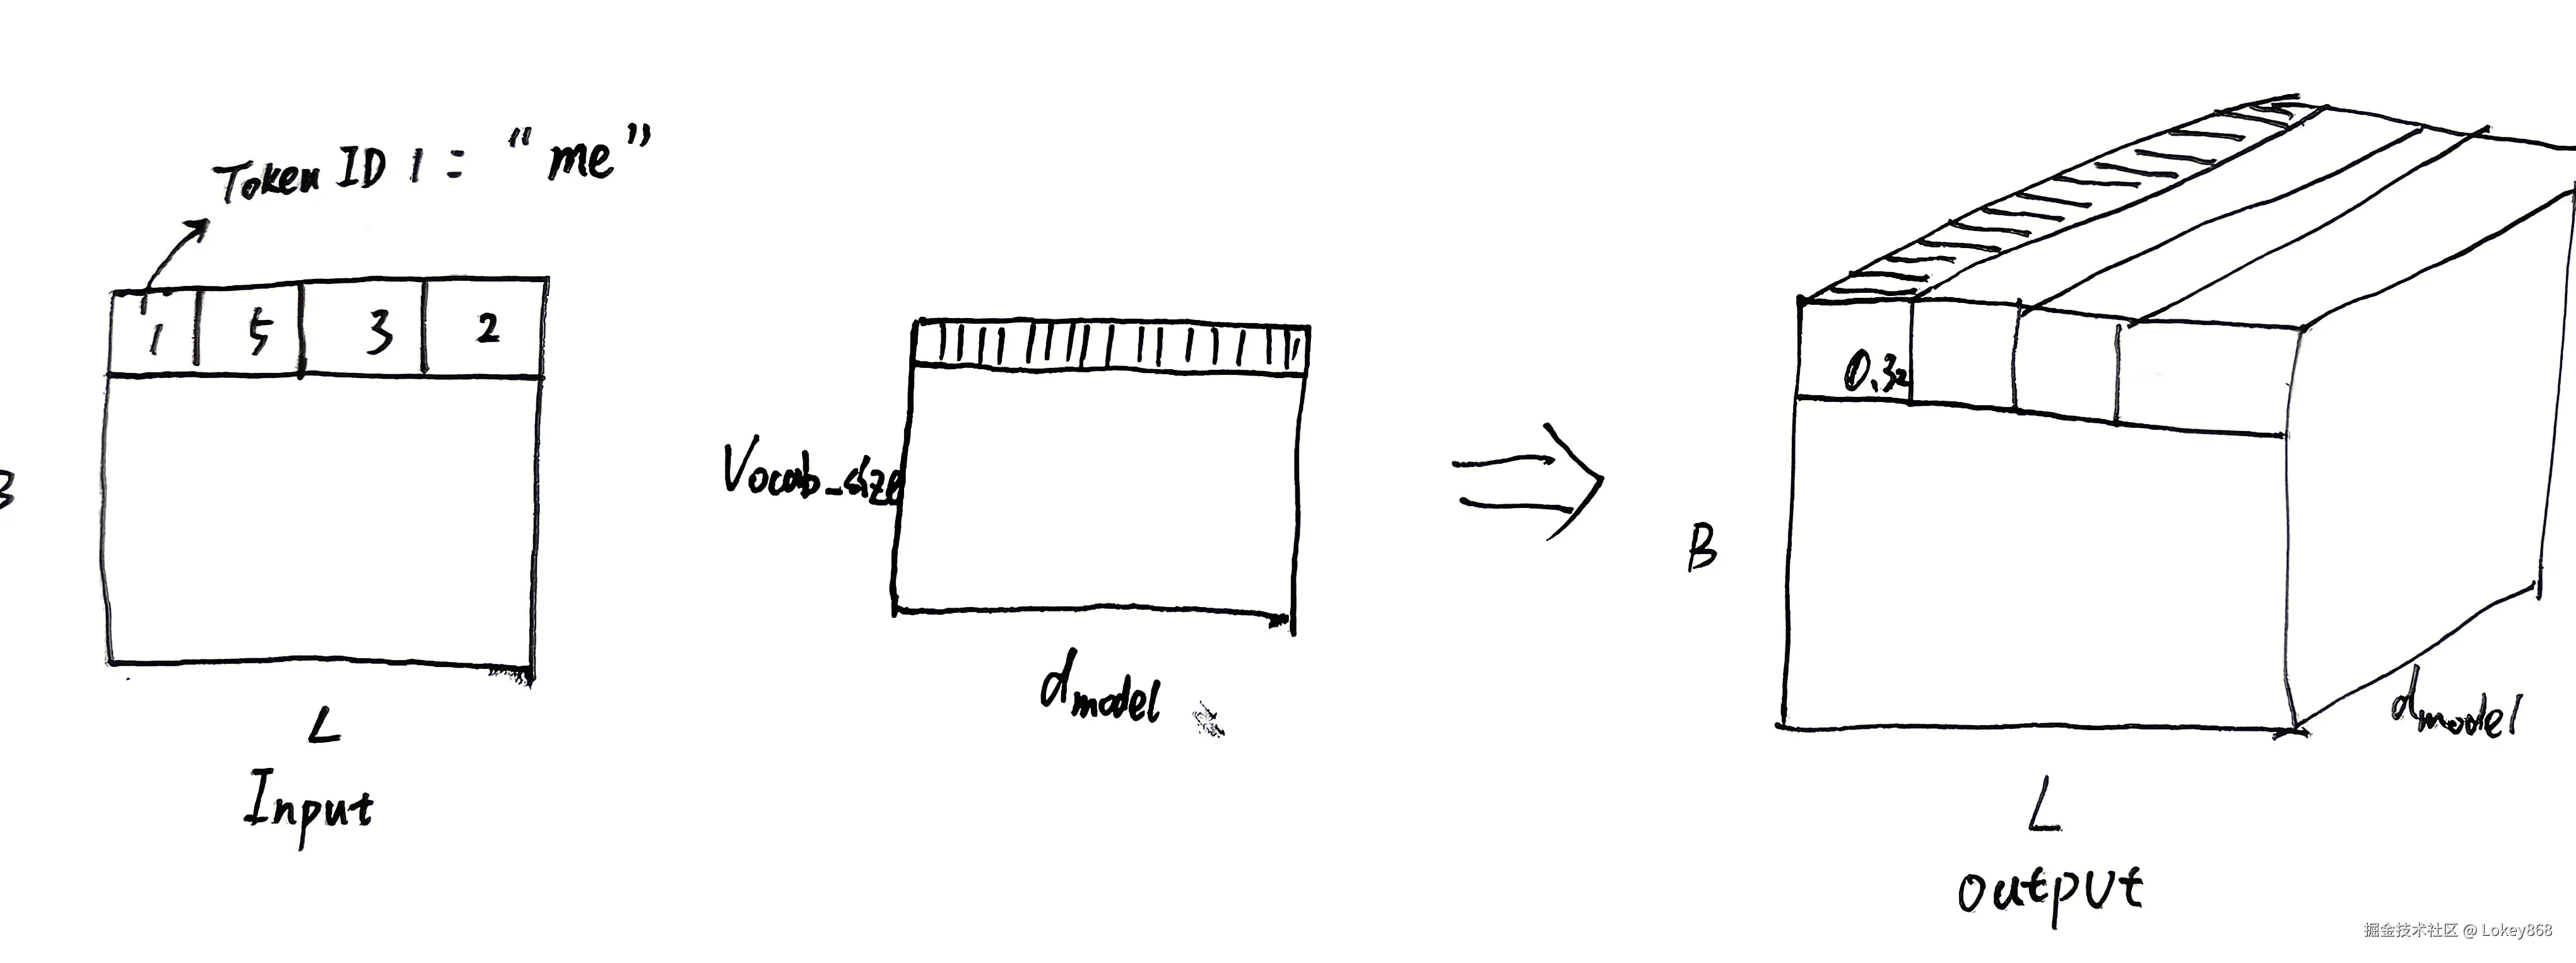
Generator
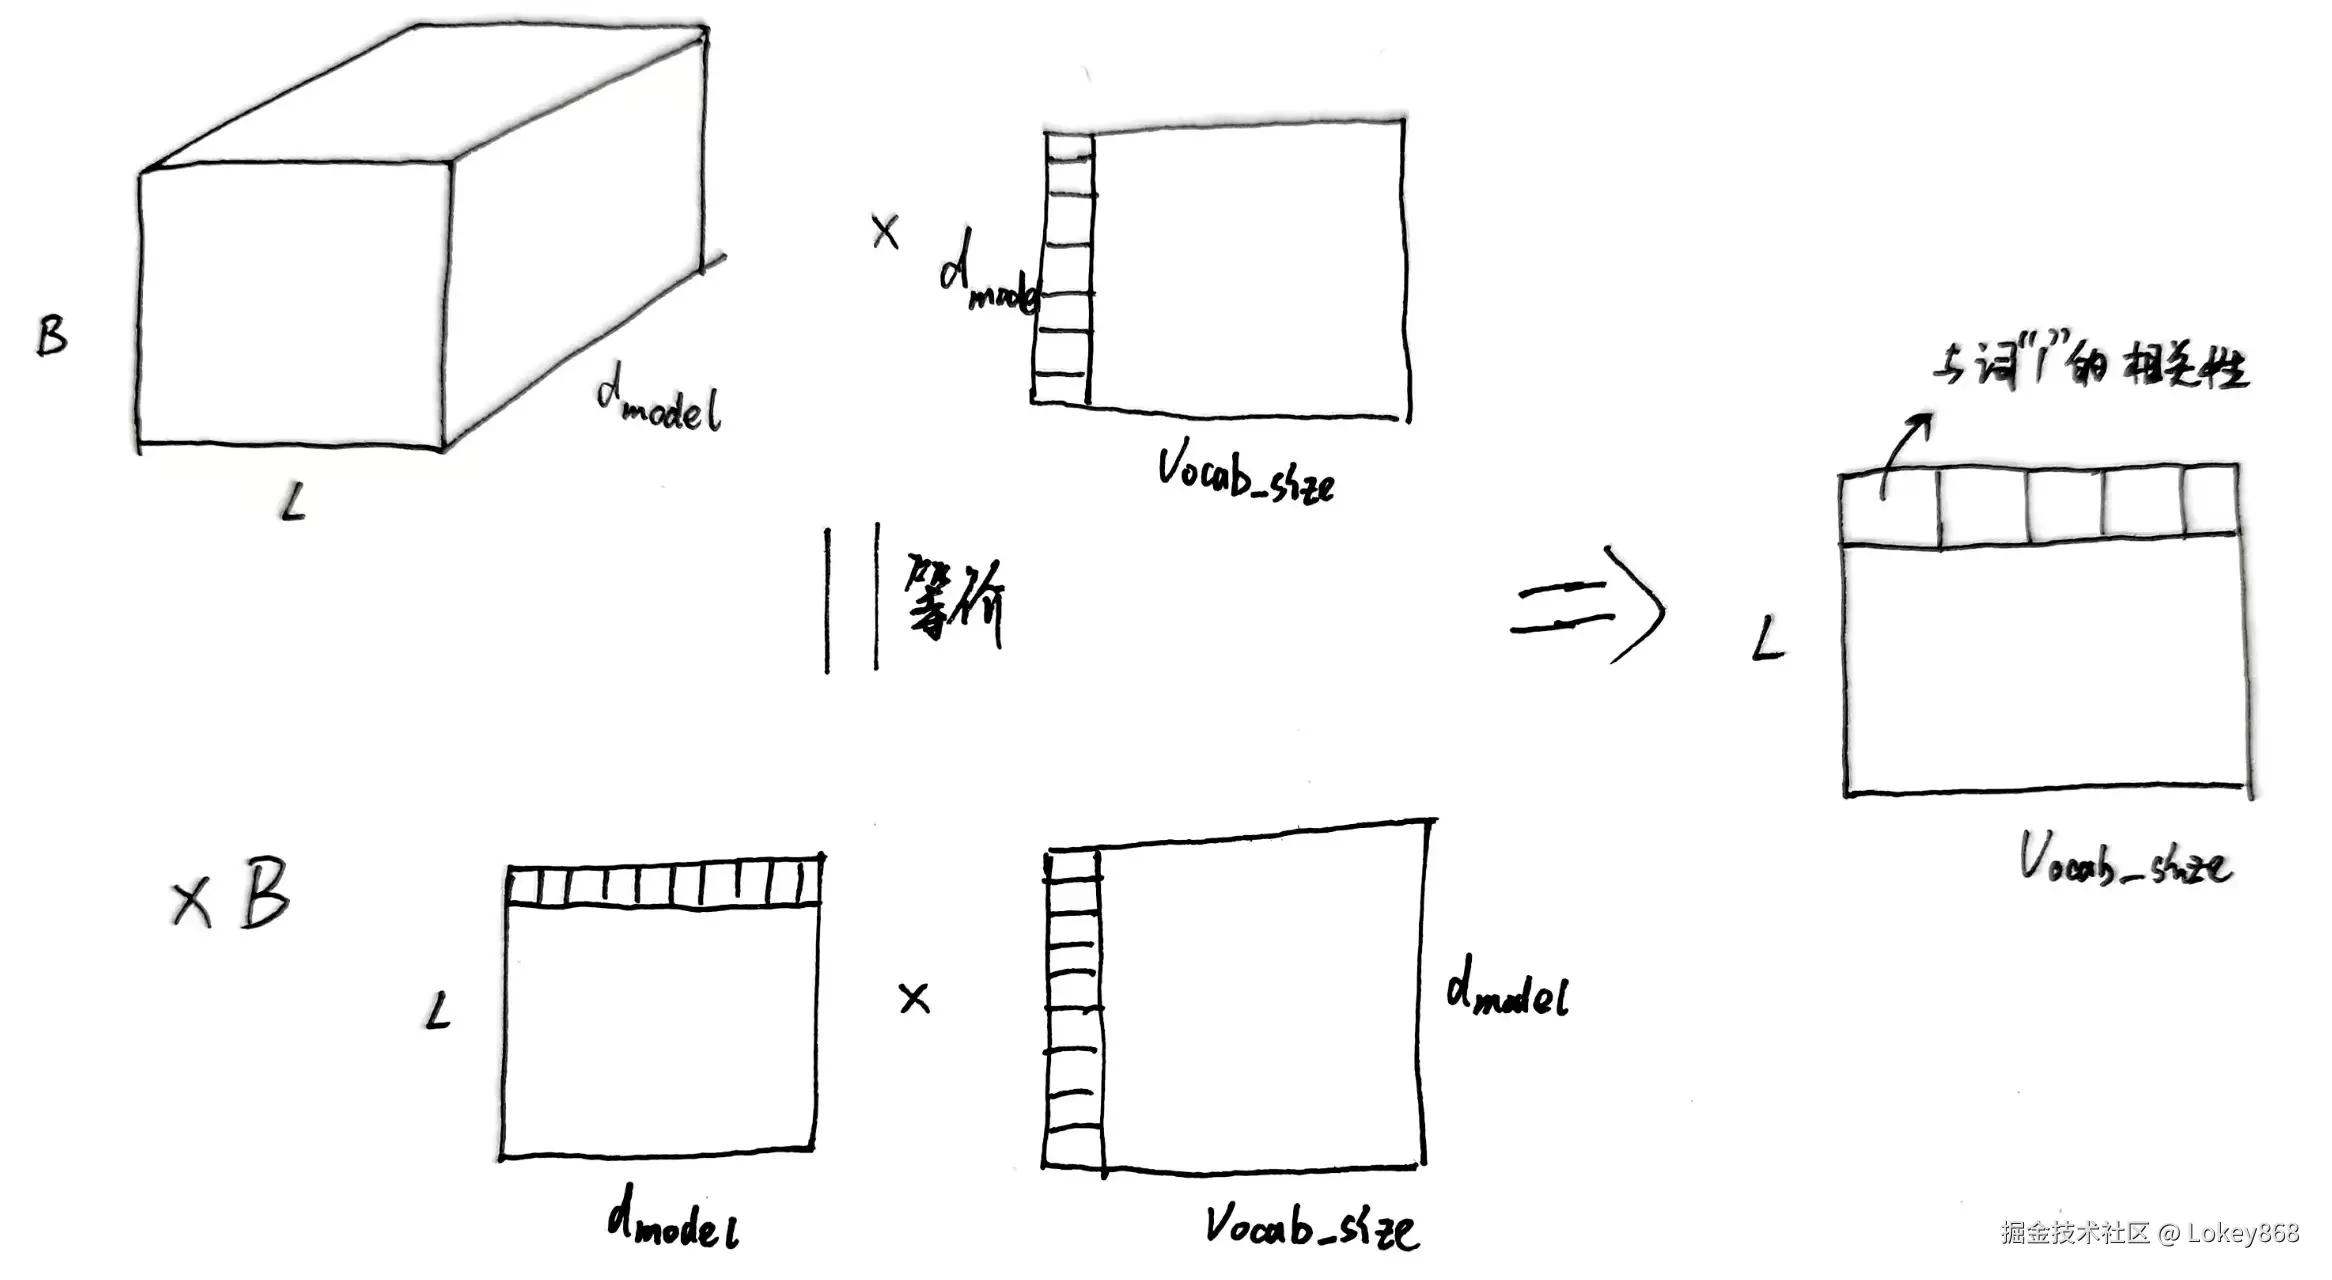
Generator 是 Decoder 最后的输出层,负责把 Transformer 的隐状态映射成词表上的分数。具体来说,它把输入 (B, L, d_model) 投影到 (B, L, vocab_size),得到每个位置、每个 token 的 logits。
python
class Generator(nn.Module):
  "Define standard linear + softmax generation step."

  def __init__(self, d_model, vocab):
      super(Generator, self).__init__()
      self.proj = nn.Linear(d_model, vocab)

  def forward(self, x):
      return log_softmax(self.proj(x), dim=-1)
实际操作是先经过一个线性层 nn.Linear(d_model, vocab_size),将维度从 (B, L, d_model) 变为 (B, L, vocab_size);之后再在最后一维(vocab 维)做 softmax,得到 token 的概率分布。
为了压缩参数量,通常让 Generator 使用 Embedding 权重 W(形状 (vocab, d_model))的转置 W^T(形状 (d_model, vocab))作为线性层权重。共享权重时,Generator 的线性层需要设置 bias=False,否则偏置无法与 Embedding 共享。
Generator 的实际计算是 logits = h @ W^T,其中:
input是隐状态,形状(B, L, d_model);W是 Embedding 权重,形状(vocab, d_model);W^T的形状是(d_model, vocab),每一列对应一个 token 的 embedding 向量。
因此:
logitsi,j=inputi,:⋅W:,j
即隐状态向量 input[i, :] 与 token j 的 embedding 向量做内积。内积越大,说明隐状态向量input[i,:] 与 token j 的语义越匹配。最后对 logits在最后一维做 softmax,就得到每个 token 的概率分布。
共享权重有效的直觉是:如果 Embedding 学到的语义空间能表示 token 的含义,那么在判断"当前上下文最匹配哪个 token"时,就可以复用同一个语义空间。形状对称只是能共享的前提,语义空间的复用才是共享有效的原因。
LayerNorm
LayerNorm是对每一个样本独立做归一化,用gamma和beta两个可学习的参数缩放平移分布:
μ=D1i=1∑Dxi,σ2=D1i=1∑D(xi−μ)2
然后归一化:
x^i=σ2+ϵ xi−μ
最后用两个可学习参数缩放和平移:
yi=γix^i+βi
其中 gamma 和 beta 形状都是 (D,),每个特征维度有独立的参数。输出形状仍是 (B, L, D),维度不变。
python
class LayerNorm(nn.Module):
    "Construct a layernorm module (See citation for details)."

    def __init__(self, features, eps=1e-6):
        super(LayerNorm, self).__init__()
        self.a_2 = nn.Parameter(torch.ones(features))
        self.b_2 = nn.Parameter(torch.zeros(features))
        self.eps = eps

    def forward(self, x):
        mean = x.mean(-1, keepdim=True)
        std = x.std(-1, keepdim=True)
        return self.a_2 * (x - mean) / (std + self.eps) + self.b_2
LayerNorm 的核心特点是:统计量只依赖当前样本自己,和 batch 无关。因此 batch=1 也能正常工作,训练和推理行为一致,适合变长序列和小 batch 场景,这也是 Transformer 选择它而不是 BatchNorm 的原因。
Feed Forward
FeedForward(FFN)是 Transformer block 里的第二个子层,紧跟在 self-attention 之后。它由两层线性层和一个激活函数组成,对每个位置独立作用。
python
class PositionwiseFeedForward(nn.Module):
    "Implements FFN equation."

    def __init__(self, d_model, d_ff, dropout=0.1):
        super(PositionwiseFeedForward, self).__init__()
        self.w_1 = nn.Linear(d_model, d_ff)
        self.w_2 = nn.Linear(d_ff, d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        return self.w_2(self.dropout(self.w_1(x).relu()))
结构如下:
FFN(x)=W2⋅Activation(W1x+b1)+b2
- 输入
x形状(B, L, d_model); W_1把维度从d_model升到d_ff;- 激活函数通常是 ReLU 或 GELU;
W_2把维度从d_ff降回d_model;- 输出形状仍是
(B, L, d_model)。
通常 d_ff = 4 * d_model,先升维再降维。它只做逐位置的非线性变换,不跨位置交互,跨位置交互由 self-attention 负责。