本文收录于专栏 agent智能体系列 ------ 专栏系统覆盖AI Agent 记忆、工具、插件与实战,点击订阅可跟踪后续更新。
你给 Agent 接外部能力时总会纠结:写个 SKILL.md,还是配个 MCP server?这篇给你两者的原理差异、功能对号入座表(状态归 MCP,知识归 Skill)、五条 token 节约手段、四套主流架构(Claude Code / Hermes / 腾讯 WorkBuddy / DSH)的配置写法,以及阿司匹林实查的双路径对比。读完你能直接判断手头需求该写 skill、挂 MCP、还是两者组合。
关键字:Agent Skills;MCP server;SKILL.md;Claude Code;DeepSeek Harness;渐进式披露;token 优化;功能选型
全文约 8.0 千字 | 预计阅读 20 分钟
官方文档:
| 资料 | 与本文关系 |
|---|---|
| Skills explained(Anthropic 官方博客,2026-03) | 官方对比框架与 token 数字出处 |
| Model Context Protocol 官网 | MCP 协议规范原文 |
| Claude Code MCP 文档 | .mcp.json 官方写法 |
| CodeBuddy/WorkBuddy Skills 文档 | 腾讯系 skill 结构与字段 |
核心公告与资料:
| 资料 | 为什么值得先读 |
|---|---|
| Introducing the Model Context Protocol(Anthropic,2024-11) | MCP 发布公告与设计动机 |
| Equipping agents for the real world with Agent Skills(Anthropic Engineering) | Skills 工程实现细节 |
一、场景痛点:接能力之前,先想清楚接的是什么
场景:你的 Agent 要查 PubChem、查 PubMed。既可以装 pubmed-mcp server,也可以写 pubchem-query 的 SKILL.md,两边教程都宣称自己是标准做法。
痛点:两者都能让 Agent "多会一件事",但成本结构不同------选错了,要么为简单 REST API 维护常驻进程,要么把需认证态的长连接服务硬塞进说明书(跑不起来)。
方案:Anthropic 官方博客说透了------MCP 负责连通数据,Skill 负责教模型怎么处理数据。
二、原理:一个是说明书,一个是插座
Skill = 程序性知识,物理形态就是一个文件夹:
skill-name/
├── SKILL.md        # 必需:frontmatter + Markdown 指令
├── scripts/        # 可选:可执行脚本
├── references/     # 可选:按需加载的参考文档
└── assets/         # 可选:输出模板
核心机制是渐进式披露(progressive disclosure):元数据(name + description)常驻上下文约 100 token,供模型判断触发时机;命中后才加载正文(<5k token);scripts/references 按需再读。关键一点:Skill 本身不执行代码------它是操作手册,模型读完后自己写代码(如 requests.get 打 REST API)完成任务。
MCP = 工具连接层。Anthropic 2024 年 11 月发布的开放协议,基于 JSON-RPC 2.0:server 把工具(名称 + 描述 + 输入 schema)暴露出来,client 连接后注册成模型的原生工具。模型看到与内置工具平级的真实 tool call,参数有类型校验。
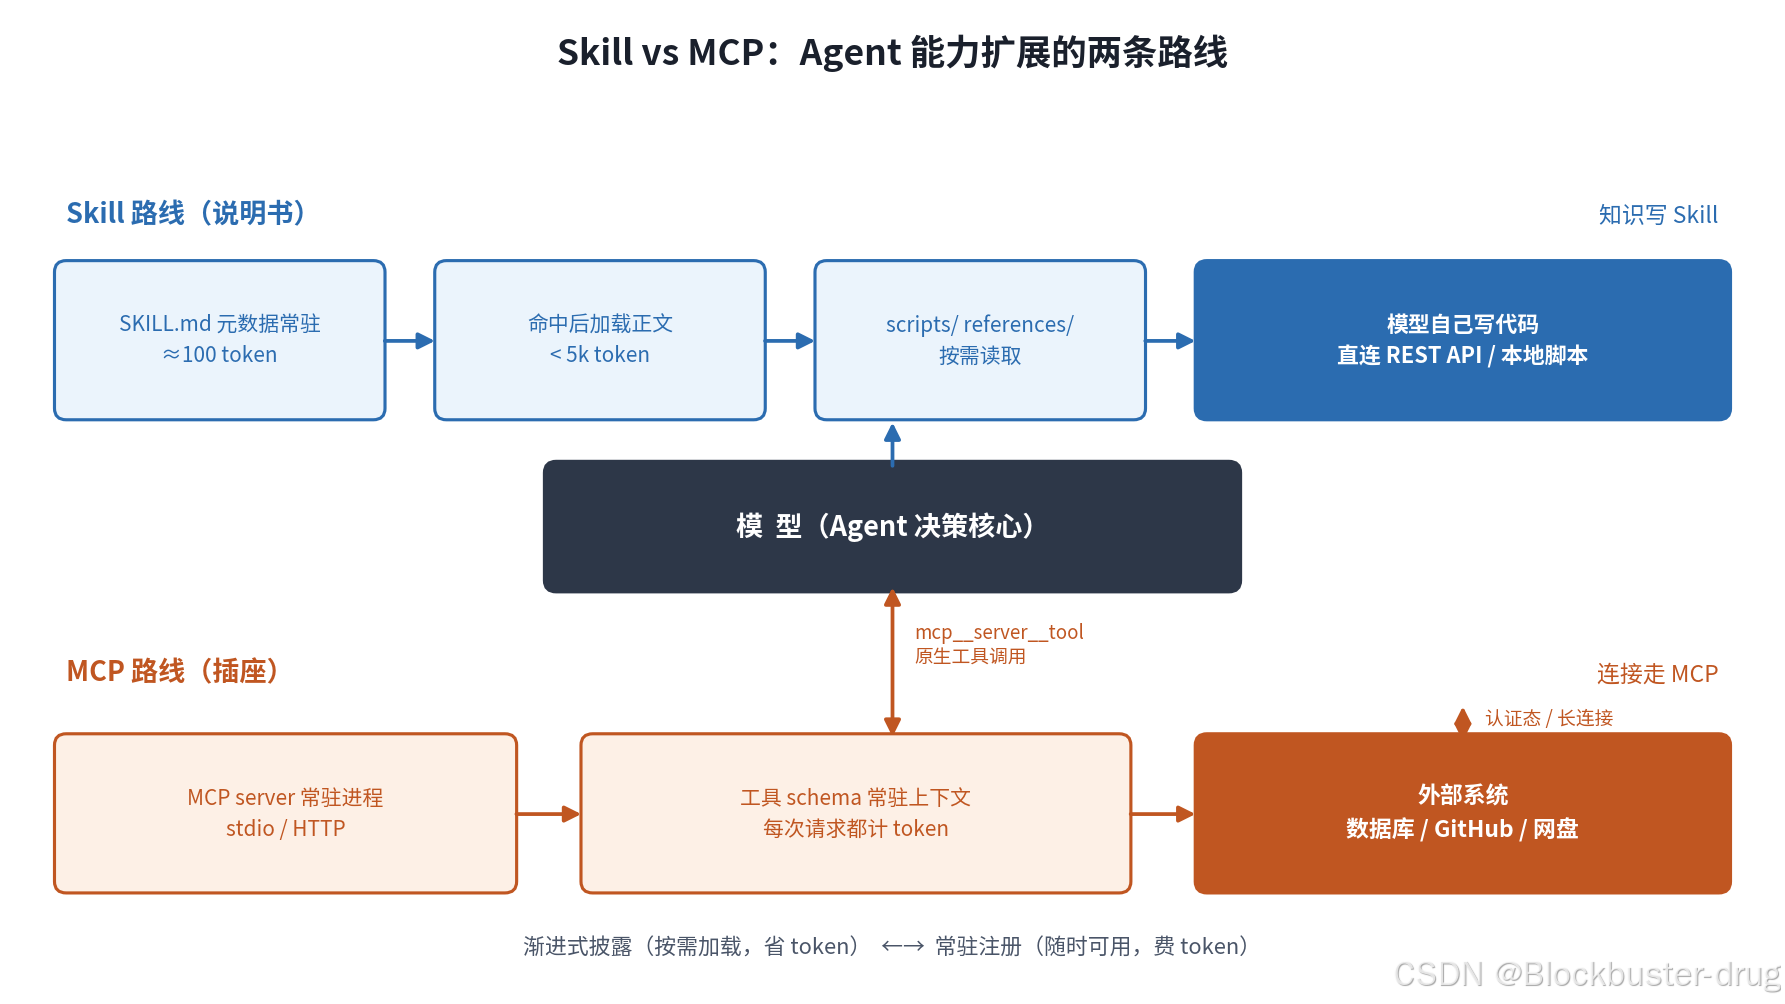 图 1:两条路线的加载时机与 token 成本对比(本文绘制)
三、操作:零安装 vs 常驻进程
Skill 侧:文件夹丢进约定目录即可,零安装零配置,改 Markdown 即生效。
MCP 侧:装 server(npm/pip/uvx)、配置文件声明、重启或热加载。以 DSH 的 cordis.yml 为例:
- id: mcp-github
  name: '@deepseek-ai/dsh-mcp-client'
  config:
    serverName: github
    transport: stdio
    command: npx
    args: ['-y', '@modelcontextprotocol/server-github']
注册后模型看到 mcp__github__create_issue 这样的工具------mcp__<server>__<tool> 命名与 Claude Code、Codex 同形。
四、效果:一次真实查询的双路径对比
本文写作时做了实查:阿司匹林的 PubChem 结构 + PubMed 文献。
Skill 路径:加载 pubchem-query 和 biomedical-literature-search 两个 skill → 模型按说明书在 bash 里用 requests 直连 PUG-REST 和 E-utilities → 拿到 CID 2244、分子式 C₉H₈O₄、MW 180.16,PubMed 两查询命中 6207 篇和 80600 篇,两次 bash 调用完成。
假设的 MCP 路径:装好 server 后每次请求都背着全部工具 schema,一次 mcp__pubchem__get_compound 拿结果;调用更干净,但想多要一个字段得看作者脸色。
Token 账本(数字来自 Anthropic 官方博客与 DSH README):
| 维度 | Skill | MCP |
|---|---|---|
| 常驻开销 | 元数据约 100 token/个 | 每个工具的完整 schema,每次请求都计 |
| KV cache | 加载正文打断前缀复用 | 工具集不变则前缀稳定,增删会失效 |
| 执行可靠性 | 靠模型现场写代码,可能写错参数 | schema 强校验,不易调错;但 server 可能弃坑 |
五、功能类型对号入座:哪些做 MCP server,哪些写 Skill 更稳妥
判断依据:功能的核心是"连接状态"还是"做法知识"。
| 功能特征 | 推荐 | 原因 |
|---|---|---|
| 需要认证态 / OAuth(GitHub、网盘、数据库) | MCP | 连接由 server 持有,凭证不进上下文 |
| 长连接 / 有状态会话(浏览器、DevTools、SSH) | MCP | 常驻进程,状态跨调用保持 |
| 复杂协议(GraphQL、gRPC、流式输出) | MCP | 协议细节封装在 server,模型只看干净 schema |
| 团队共用的工具入口 | MCP | 统一维护,一处升级全员生效 |
| 无状态公开 REST API(PubChem / PubMed) | Skill 或直连 | 一条 requests.get 就够,架 server 是过度工程 |
| 流程、规范、写作格式 | Skill | 本质是知识不是连接 |
| 易错的重复性代码 | Skill + scripts/ |
固化成确定性脚本,不靠模型现场发挥 |
| 快速迭代的经验规则 | Skill | 改 Markdown 即生效,不用发版 |
一句话:带状态的归 MCP,带知识的归 Skill;拿不准先写 Skill------成本低,日后可升级成 MCP。
六、四大主流架构的配置实测
四套架构都支持两种机制,目录约定趋于一致:
| 架构 | Skill 位置 | MCP 配置 | 备注 |
|---|---|---|---|
| Claude Code | ~/.claude/skills/ |
~/.claude.json / 项目级 .mcp.json |
机制首发方 |
| Hermes Agent | ~/.hermes/skills/(本机实测 36 个) |
配置文件挂 MCP server | 社区生态活跃 |
| 腾讯 WorkBuddy | 工作区 .codebuddy/skills/ |
官方文档单列"MCP 配置集成" | 含 allowed-tools 字段 |
| DeepSeek Harness(DSH) | ~/.dsh/skills/ |
cordis.yml 配 dsh-mcp-client 插件 |
双传输 + HMR 热重载 |
DSH 另有两个细节:配置改动触发重连而非重启,serverName 不变则工具名一致;README 把 token 与 KV cache 影响写进文档------工具列表不变则前缀稳定。
七、token 节约:五条立刻能用的手段
- Skill 元数据写准:description 常驻上下文(约 100 token),写清触发条件,含糊了白占位。
- 正文瘦身、细节下沉 :SKILL.md 控制体量,API 文档、长表格放进
references/按需加载。 - MCP server 按需挂载:每个工具的 schema 每次请求都计费,用不到的别挂。
- 工具集稳定保 KV cache:会话中途增删工具会打断前缀复用,批量任务开始前一次配好。
- 大结果先过滤再进上下文 :server 侧分页过滤,或在
scripts/里处理数据只回摘要------整坨 JSON 进上下文是最常见的浪费。
八、局限与注意事项
- Skill 的软肋在执行层 :模型现场写代码,写错参数、漏处理异常都常见;易错代码固化进
scripts/。 - MCP 的软肋在生态层:社区 server 质量参差、弃坑率高;schema 常驻上下文,挂多了吃掉几千 token。
- 两者都不是权限边界:skill 指令和 MCP 工具返回都会进上下文,敏感凭证走环境变量。
九、选取建议(决策树)
需求是什么?
├─ 教 Agent 一套流程/规范/领域知识 ────→ Skill
├─ 连上外部系统(DB/CRM/网盘) ──→ MCP
├─ 一次性查询公开 REST API ────→ 直连,啥都不用配
├─ 高频复用 + 需要认证态/长连接 ──→ MCP 管连接 + Skill 管用法
└─ 团队共享能力 ────→ MCP server(统一版本)+ Skill(统一流程)判断口诀:知识写 skill,连接走 MCP;能直连就别架桥。
总结与展望
Skill 与 MCP 不是竞争关系,而是 Agent 能力的两个正交维度------一个管"会做",一个管"能连"。四套架构的目录约定(SKILL.md + frontmatter)和工具命名(mcp__server__tool)正在收敛,迁移成本越来越低。
往后看两个趋势:一是融合------skill 的 scripts 调 MCP 工具、server 内嵌流程指引的混合形态;二是 token 效率竞赛,渐进式披露和 KV cache 友好注册会成为标配。两套机制都值得会,选哪边只是场景问题。
参考来源
- Skills explained: How Skills compares to prompts, Projects, MCP, and subagents------官方对比框架与 token 数字出处。
- Introducing the Model Context Protocol------MCP 发布公告(2024-11)。
- Claude Code MCP 文档------
.mcp.json配置说明。 - CodeBuddy Skills 文档------腾讯系 skill 结构说明。
- 阿司匹林实查数据:PubChem CID 2244、PubMed 命中数(本文实测)。
系列导航 :专栏全集 agent智能体系列
更多专栏: