今天测一个我们从来没有测过的模型Step5!
我对 Step5 是毫无预期的,正是这种毫无期待,反而让我觉得。哦,有点意思!
整体测下来和新版豆包 Seed2.1pro、腾讯 HY4 预览版,有几分相似。
国产模型的 Agent 能力肉眼可见地全面提升了,但是开发时间和 tokens 消耗全面暴涨!
这个模型是第一次测,所以我们先来看一些背景资料。
1、基础信息
GPT 给我的简介是这样:
阶跃星辰 StepFun 现在已经是国内比较重要的一家基础模型公司了,而且路线和 DeepSeek、Kimi、智谱稍微不一样:它从一开始就比较强调 多模态 + Scaling + Agent。
模型的历史版本:
| 模型 | 定位 | 简单理解 |
|---|---|---|
| Step 5 Preview | 新一代旗舰基模 | 面向复杂任务、Agent、Coding,目前是他们最前沿的旗舰模型 |
| Step 3.7 Flash | 高性能快速模型 | 当前开发者侧重点推广,适合 Coding、Agent、工具调用 |
| Step 3.5 Flash | 开源推理/Agent 模型 | 196B 总参数,激活约 11B,MoE,256K 上下文,特点是快、Agent 能力强 |
好家伙,直接从 3.7 调到了 5.0,这个跨度是真大,这是属于直接把药膏挤爆了?还是单纯追赶版本号? 现在都是 5 系列了,GLM5.x、GPT5.x、Opus5.x。
背景信息大概就这些。其他二手信息就不看了。直接去看官网的发布页!
这个 SLOGO 有点深度:"向前一步智,能效率的新一代帕累托前沿。" 我又进步了,学习到了一个新词"帕累托前沿"。
这里的 "帕累托前沿" 是个优化领域的术语,英文叫 Pareto Frontier / Pareto Front。
简单说就是:当多个指标互相冲突时,已经找不到一种方案能让"所有指标都同时变得更好"的那批最优方案。
写这个主要是为了表达:它们在模型能力和运行效率/成本之间,做到了目前更好的综合平衡。
我对此,持保留意见!
上述概念之后,就来具体的描述了:
Step 5 Preview 在 AI 编程、软件工程、专业知识工作等任务上达到前沿水平,并在金融领域展现出尤为突出的能力。Step 5 Preview 采用稀疏 MoE 架构,总参数量 600B,每个 Token 激活 27B 参数,支持 1M Token 上下文窗口和视觉输入。
从这里可以看到,模型不算很大,采用了 MoE 架构,标配的 1M 上下文,还支持视觉输入。
单从这些参数来看,应该也算是目前主流模型的配置了!
然后,我们来看一下基准情况:
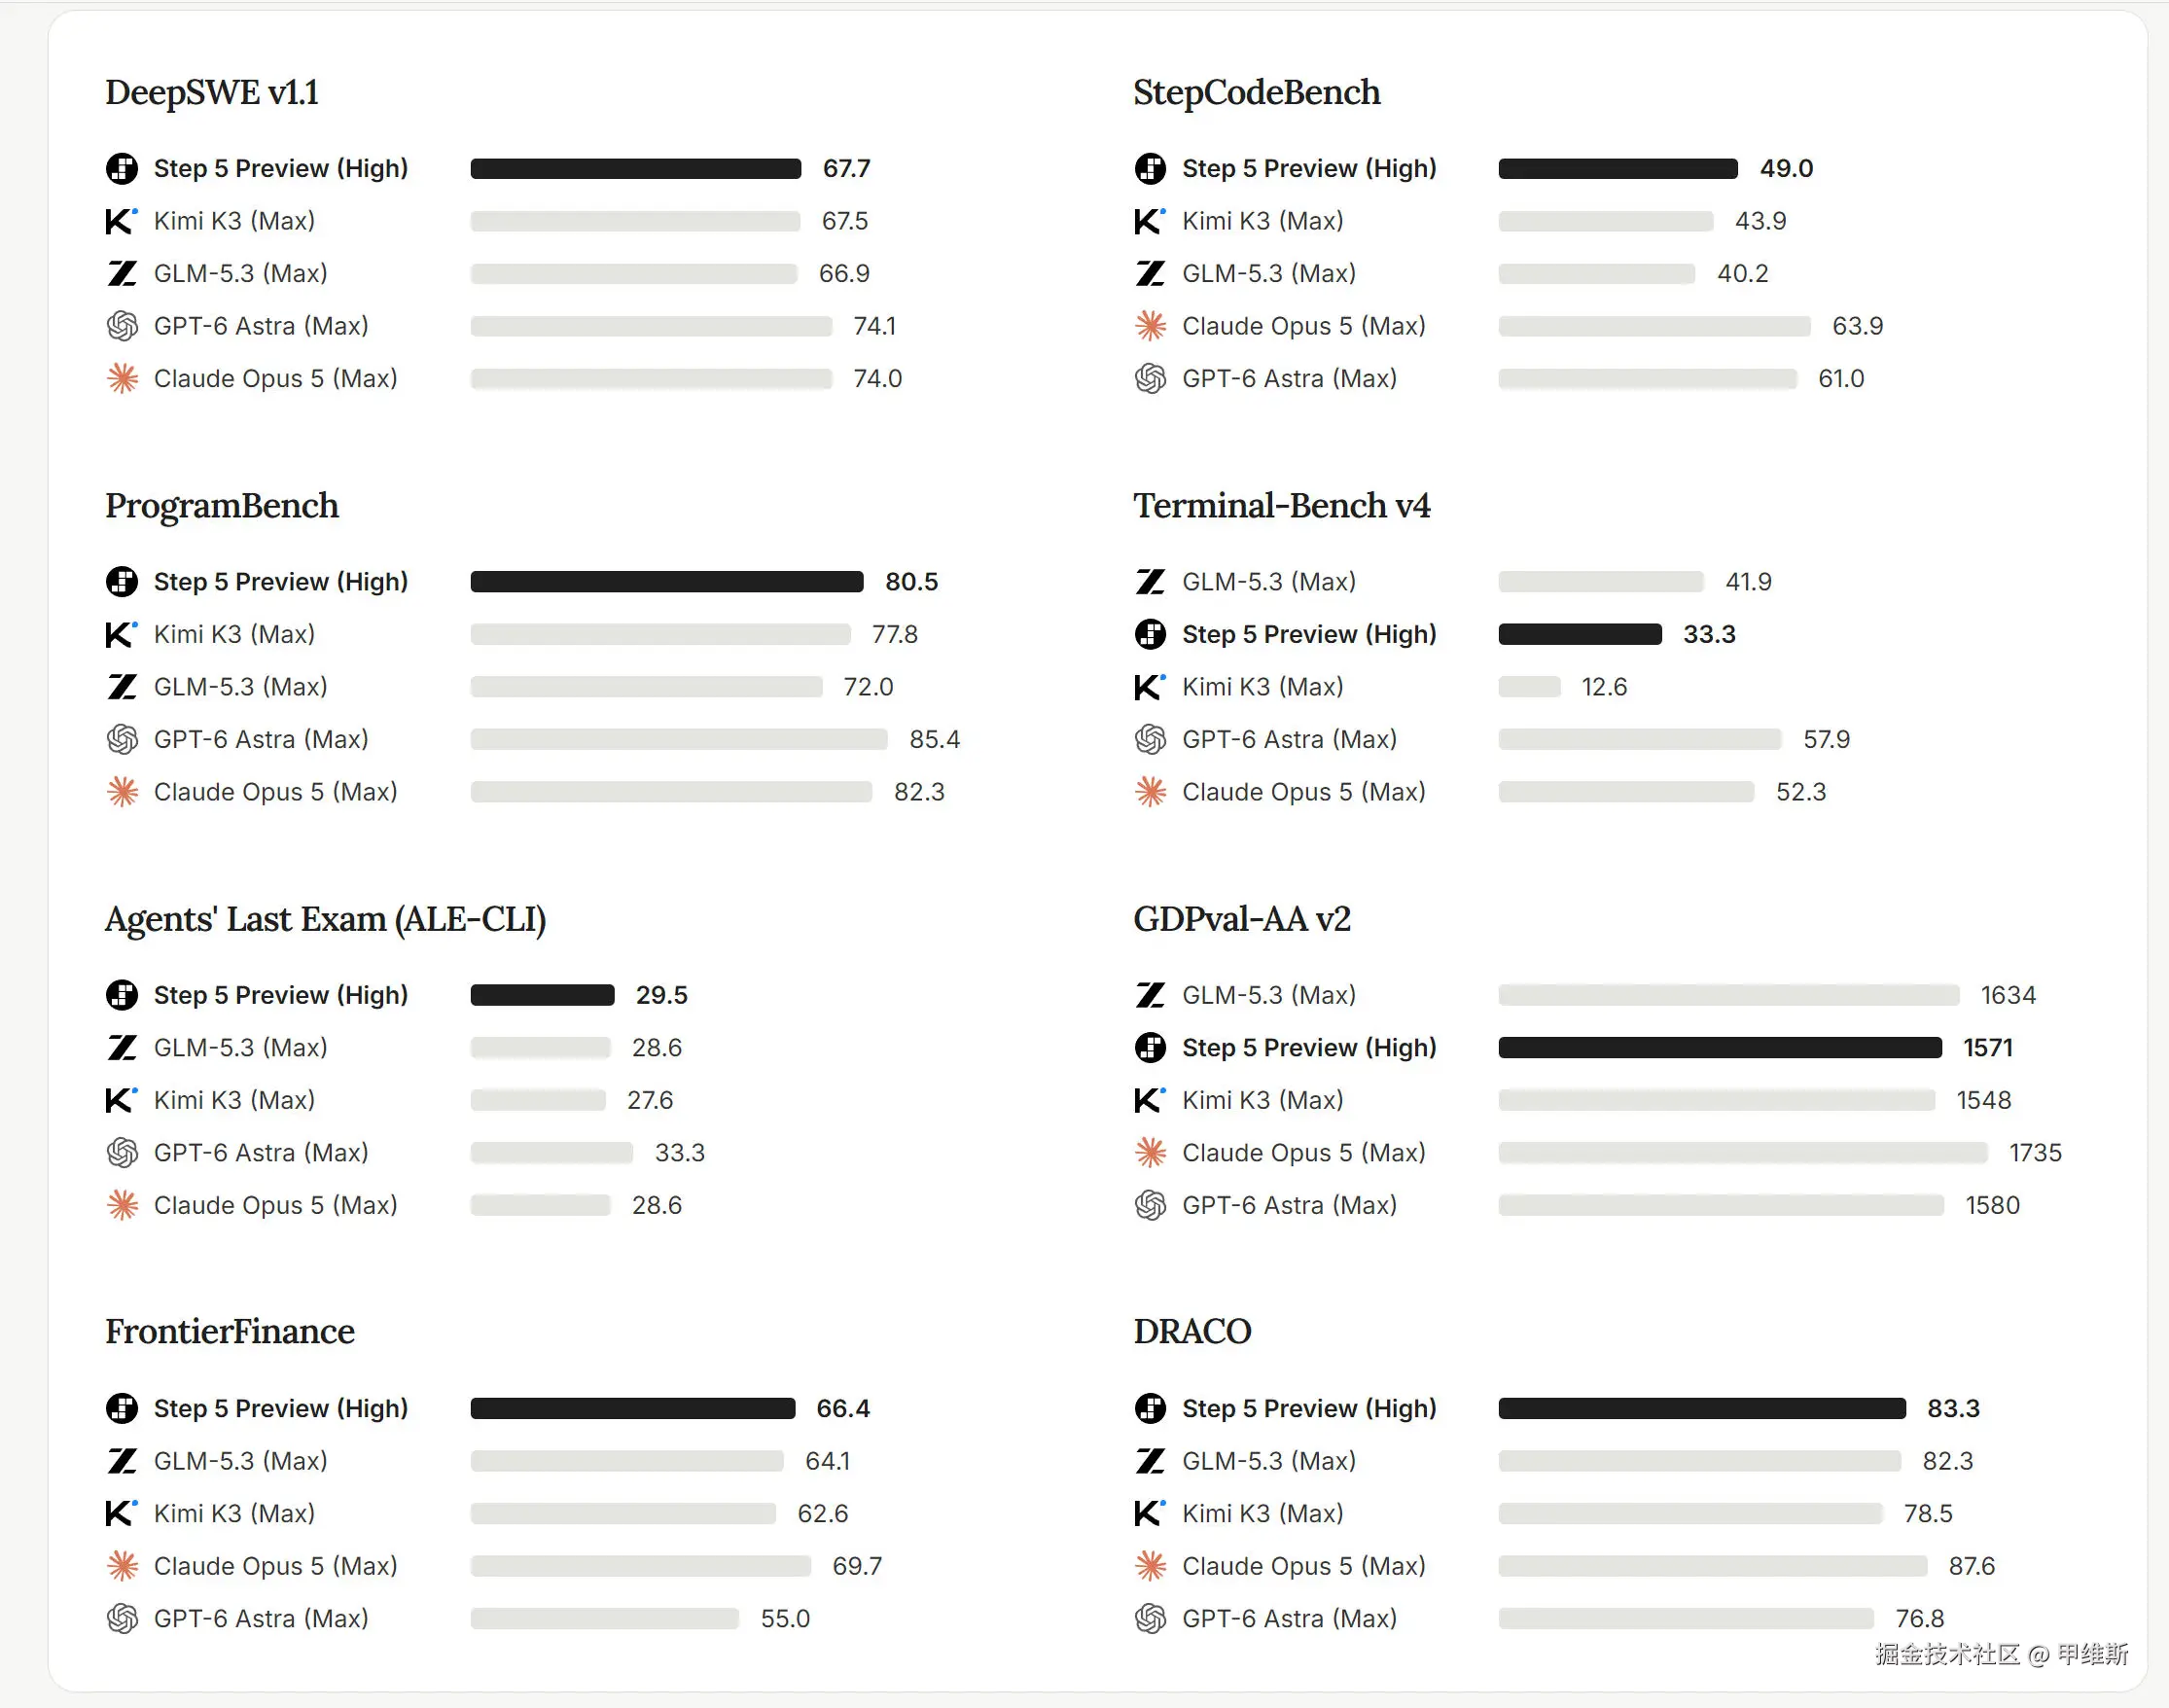
这张图我昨天贴过了!
从图中可以看到,它和 GPT-6 以及 Opus 5 还是有一定的差距。
但是相比 K3 和 GLM5.3 有好几个维度都赢了!
好像只有在 Step5 这里才能看到 Opus 5 真正的实力。"O哥"非常强,很多维度都比 GPT-6 Astra 还强。
还有一张单任务成本图:
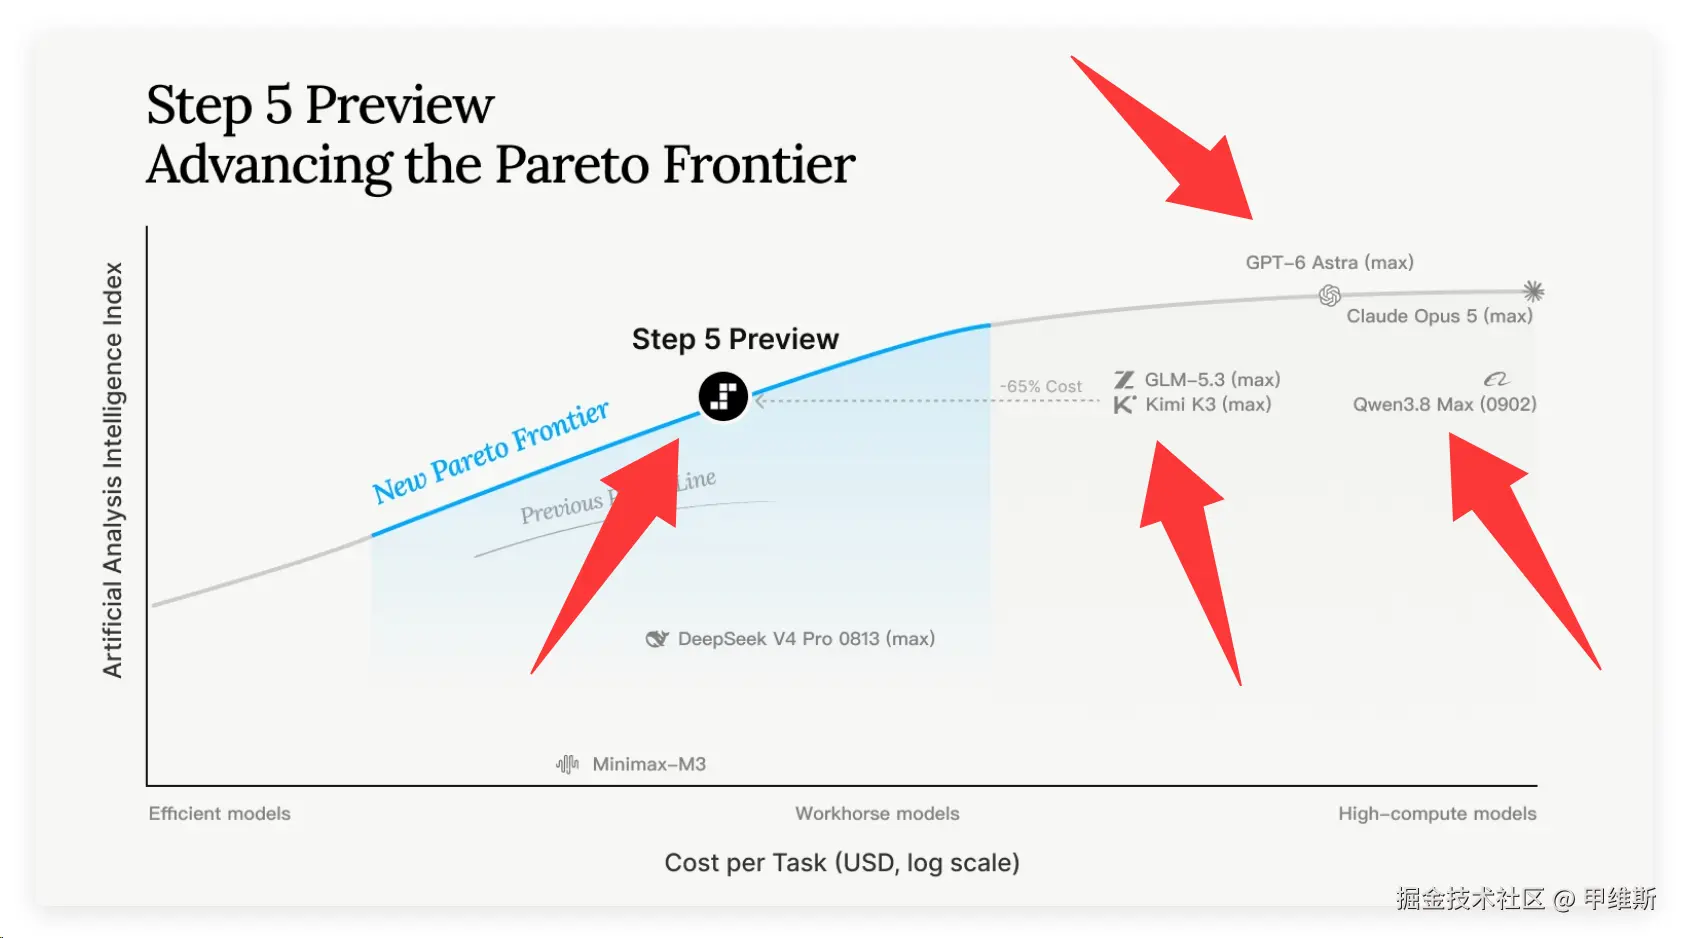
这个意思很清晰,主要表达:我和 GLM5.3、K3、Qwen3.8 智商差不多,但是要便宜很多。
实话实说,这 3 个 Max 确实挺慢挺贵的。
Step5 还专门强调了:真实的软件工程!
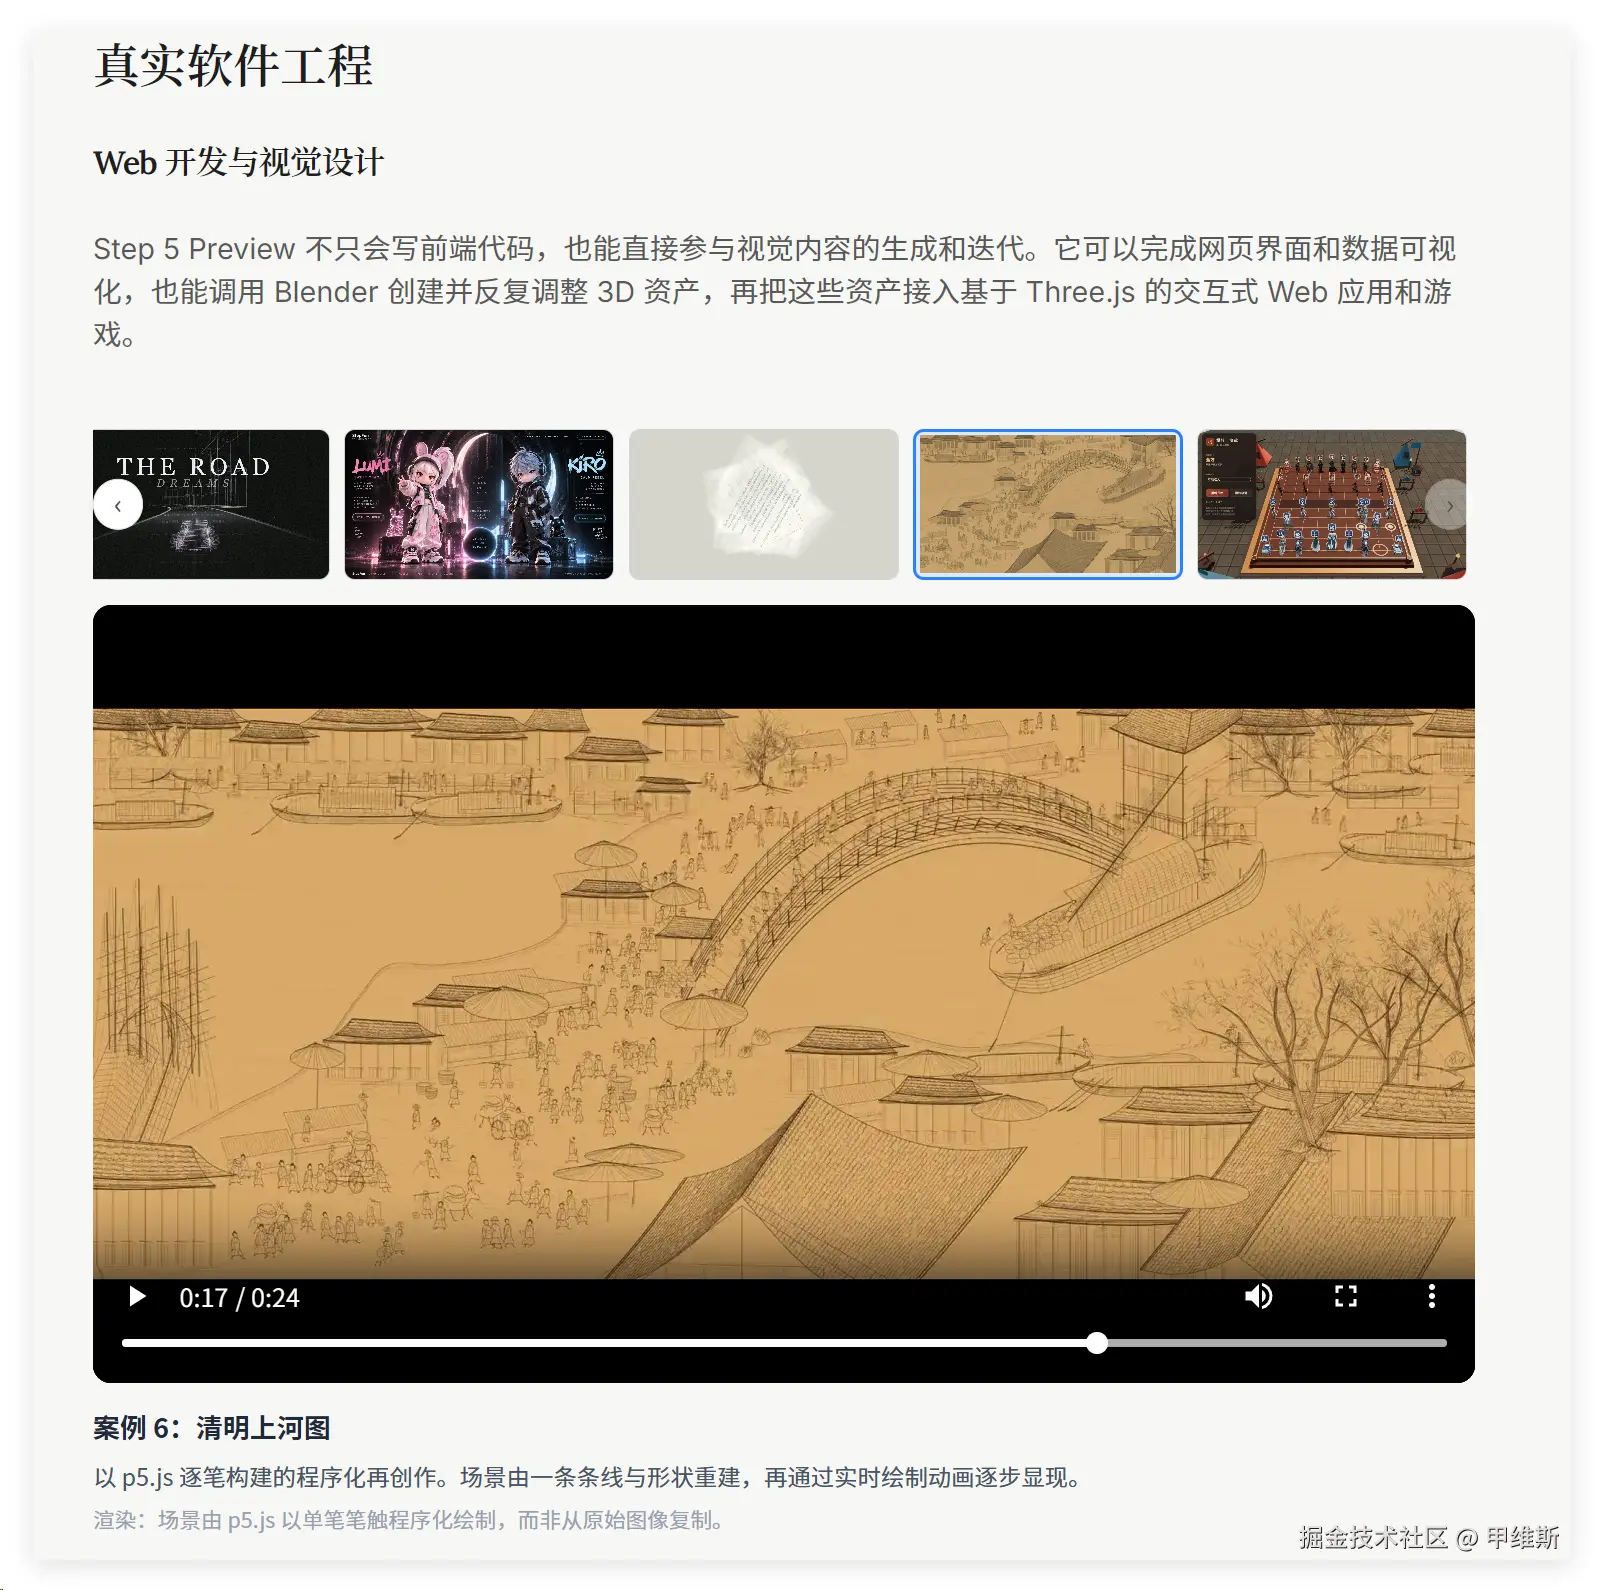
举了非常多的例子,看起来很牛的样子。其中还有直接画清明上河图的例子。
这个文档有非常多的案例和数据:
比如专业工作、大规模研究、结构化分析、交互式报告、聚焦金融等领域的。
看起来还是用心做了的!
认不认真是可以感受出来的,因为工作量大的模型、有明显进步的模型,他们也愿意写更长的报告,举更多的例子。
对细节比较感兴趣的可以直接查看完整的官方博客:
完蛋了,已经 1000 多个字了。 介绍大概就是这些吧,我们进入正题--实测环节。
我测试的时候,不会找官方的例子,也不会按基准来测。就按我自己的例子跑。
这样大家比较公平,而且可以用很多历史测试数据来进行对比。 同时我会把所有例子,全部发布到网站上,用直观的形式呈现。
网址 :
2、实测结果
这次我是使用官方推荐的工具Claude Code!配置方法上一篇有讲过!
下面就不多少了,同样的提示词和例子,来看看Step5的情况!
第一个例子是《赛博朋克版清明上河图》
最终结果如下:
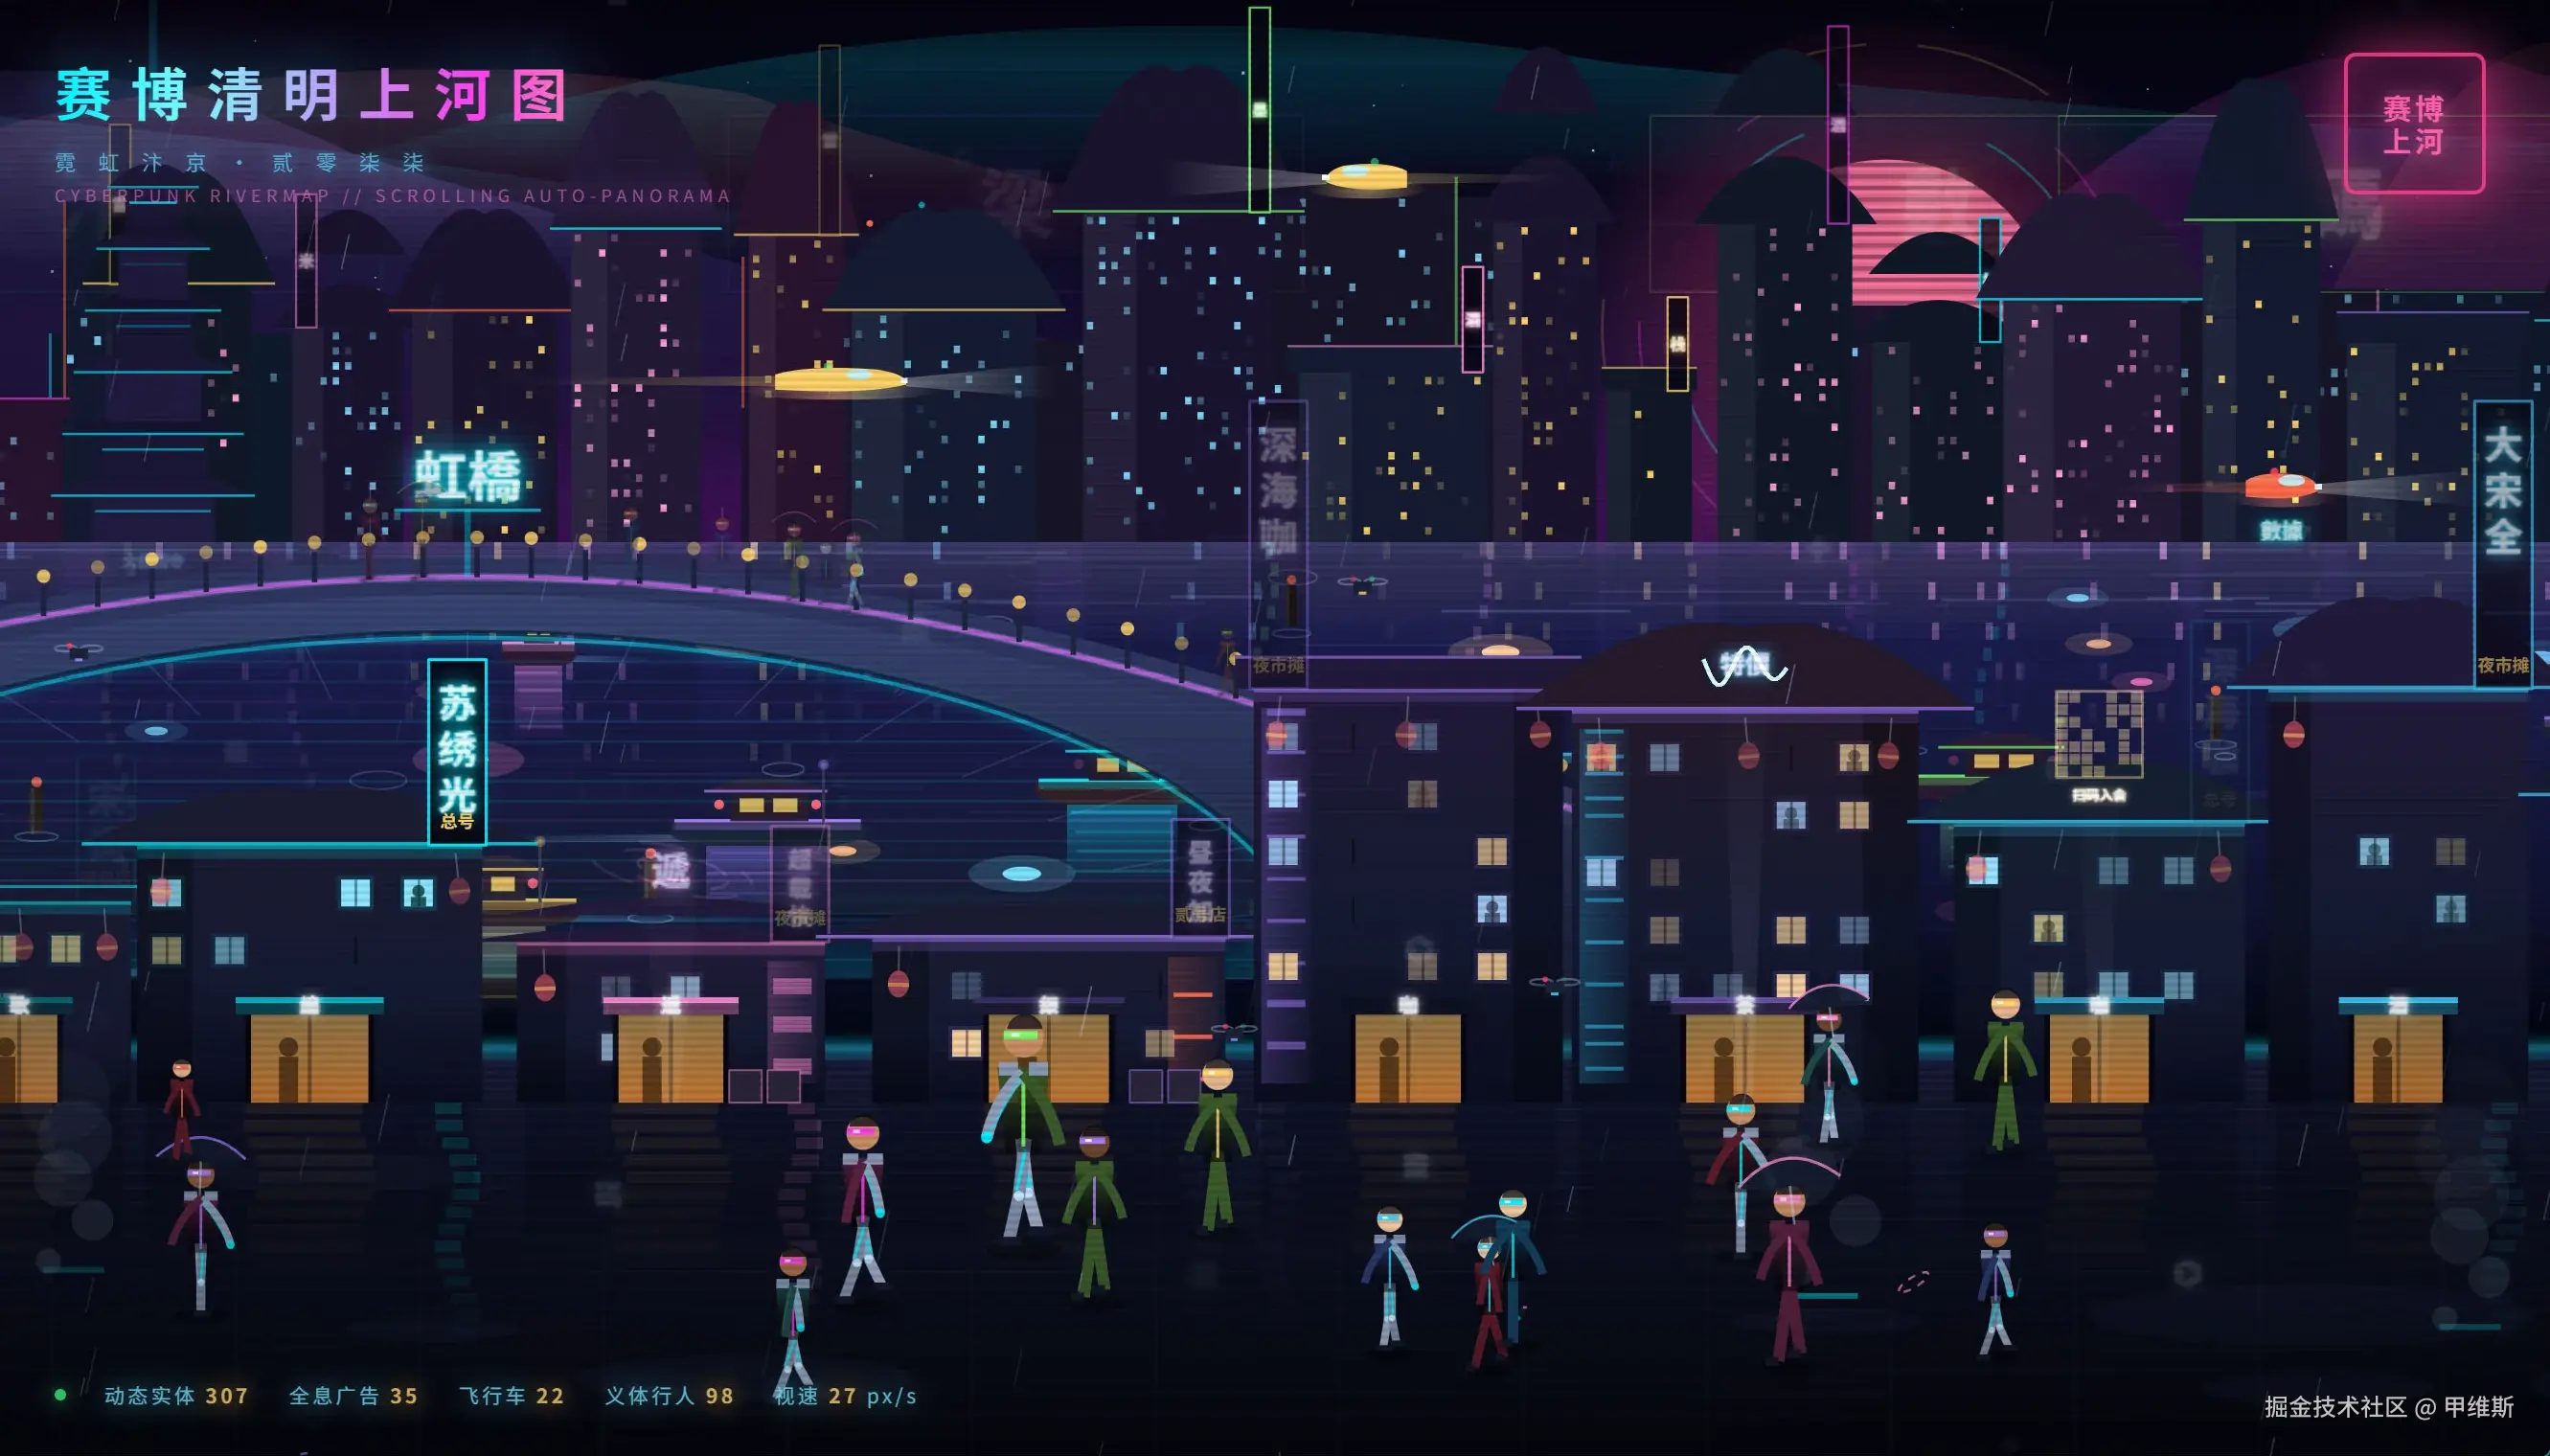
这个例子做的算是不错的!
人够,空间也拉开了,人物、建筑的细节和多样性也可以。
还有一个细节好评,后面的河面上还有雨水落下的涟漪。
这里还有一个很好玩的事情:
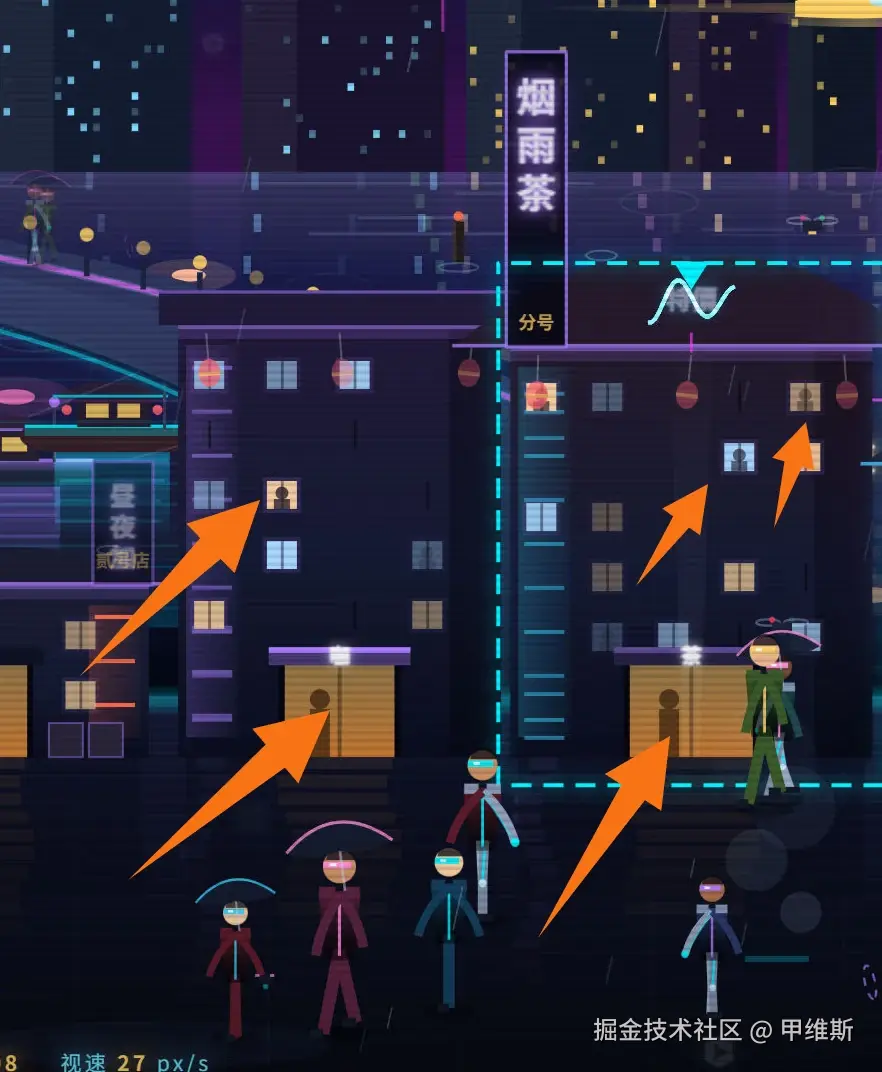
每个楼里站了一个人,每个房间都站了一个人,配合上昏暗的灯光,很有 xx 一条街的感觉。
我严重怀疑,Step5 和 HY4 已经深入研究过我这个例子了。因为它们在这个例子上做到了中上水平。
这个例子的开发报告如下:
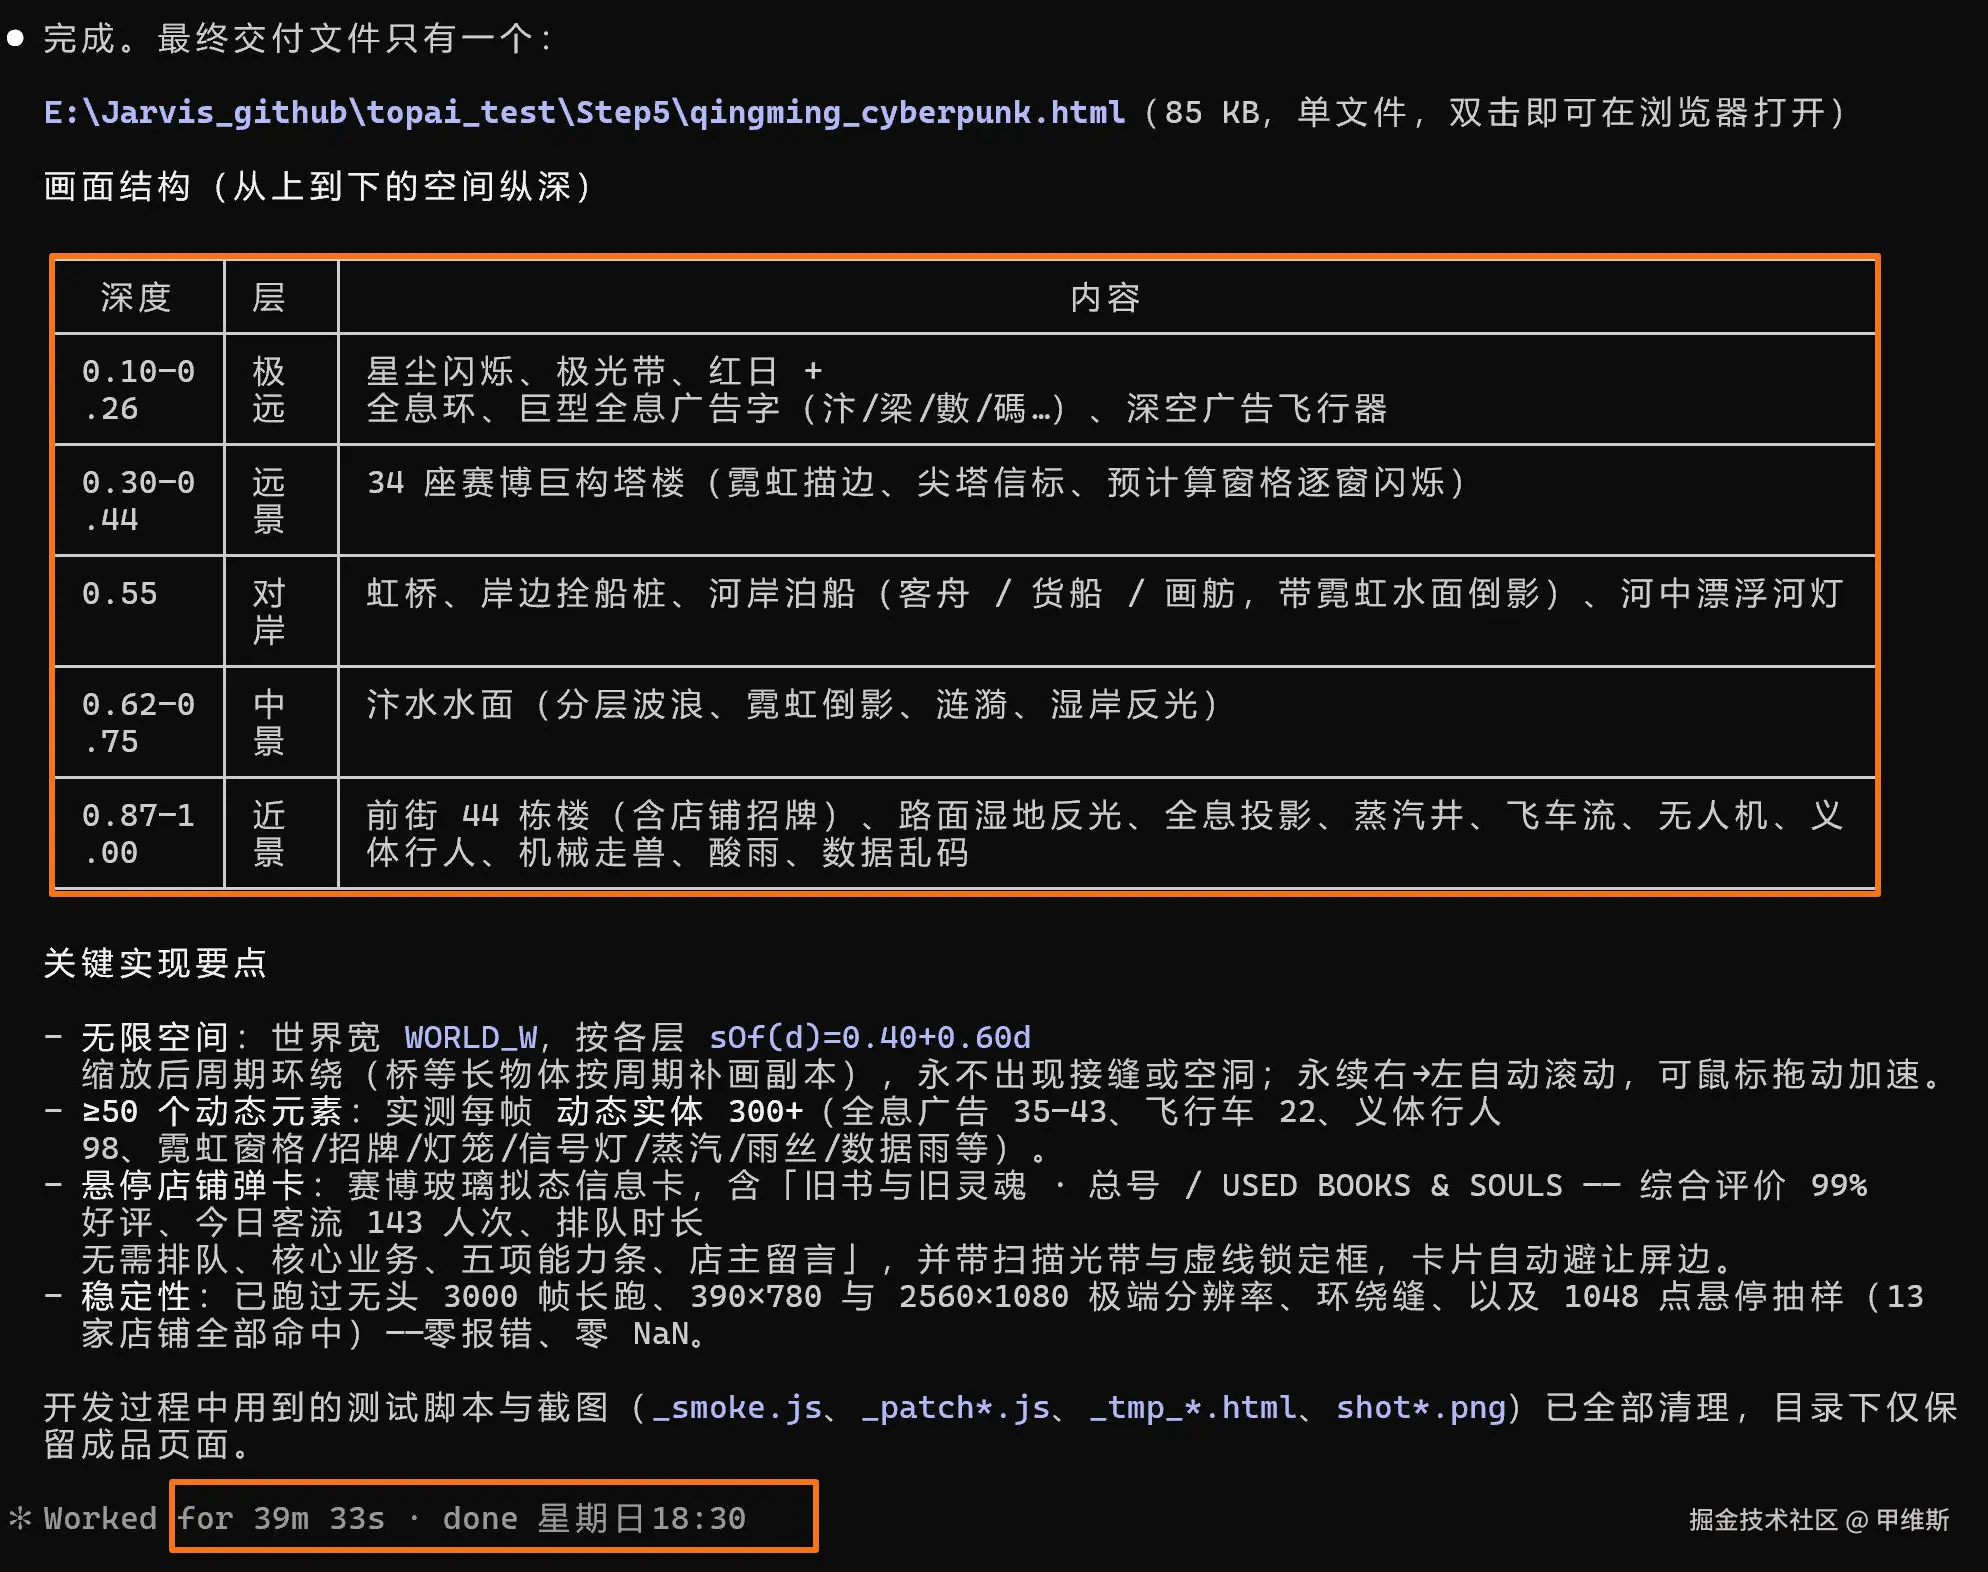
从可以记录到的时间来看是 39 分钟。其实上面还有很多时间,断断续续的没有记录下来。
这个时间嘛,真的是不快,而且好容易 429 繁忙、API 错误、联网中断! 可能是我的白嫖套餐,并发不行。
第二个例子《天文机械表》
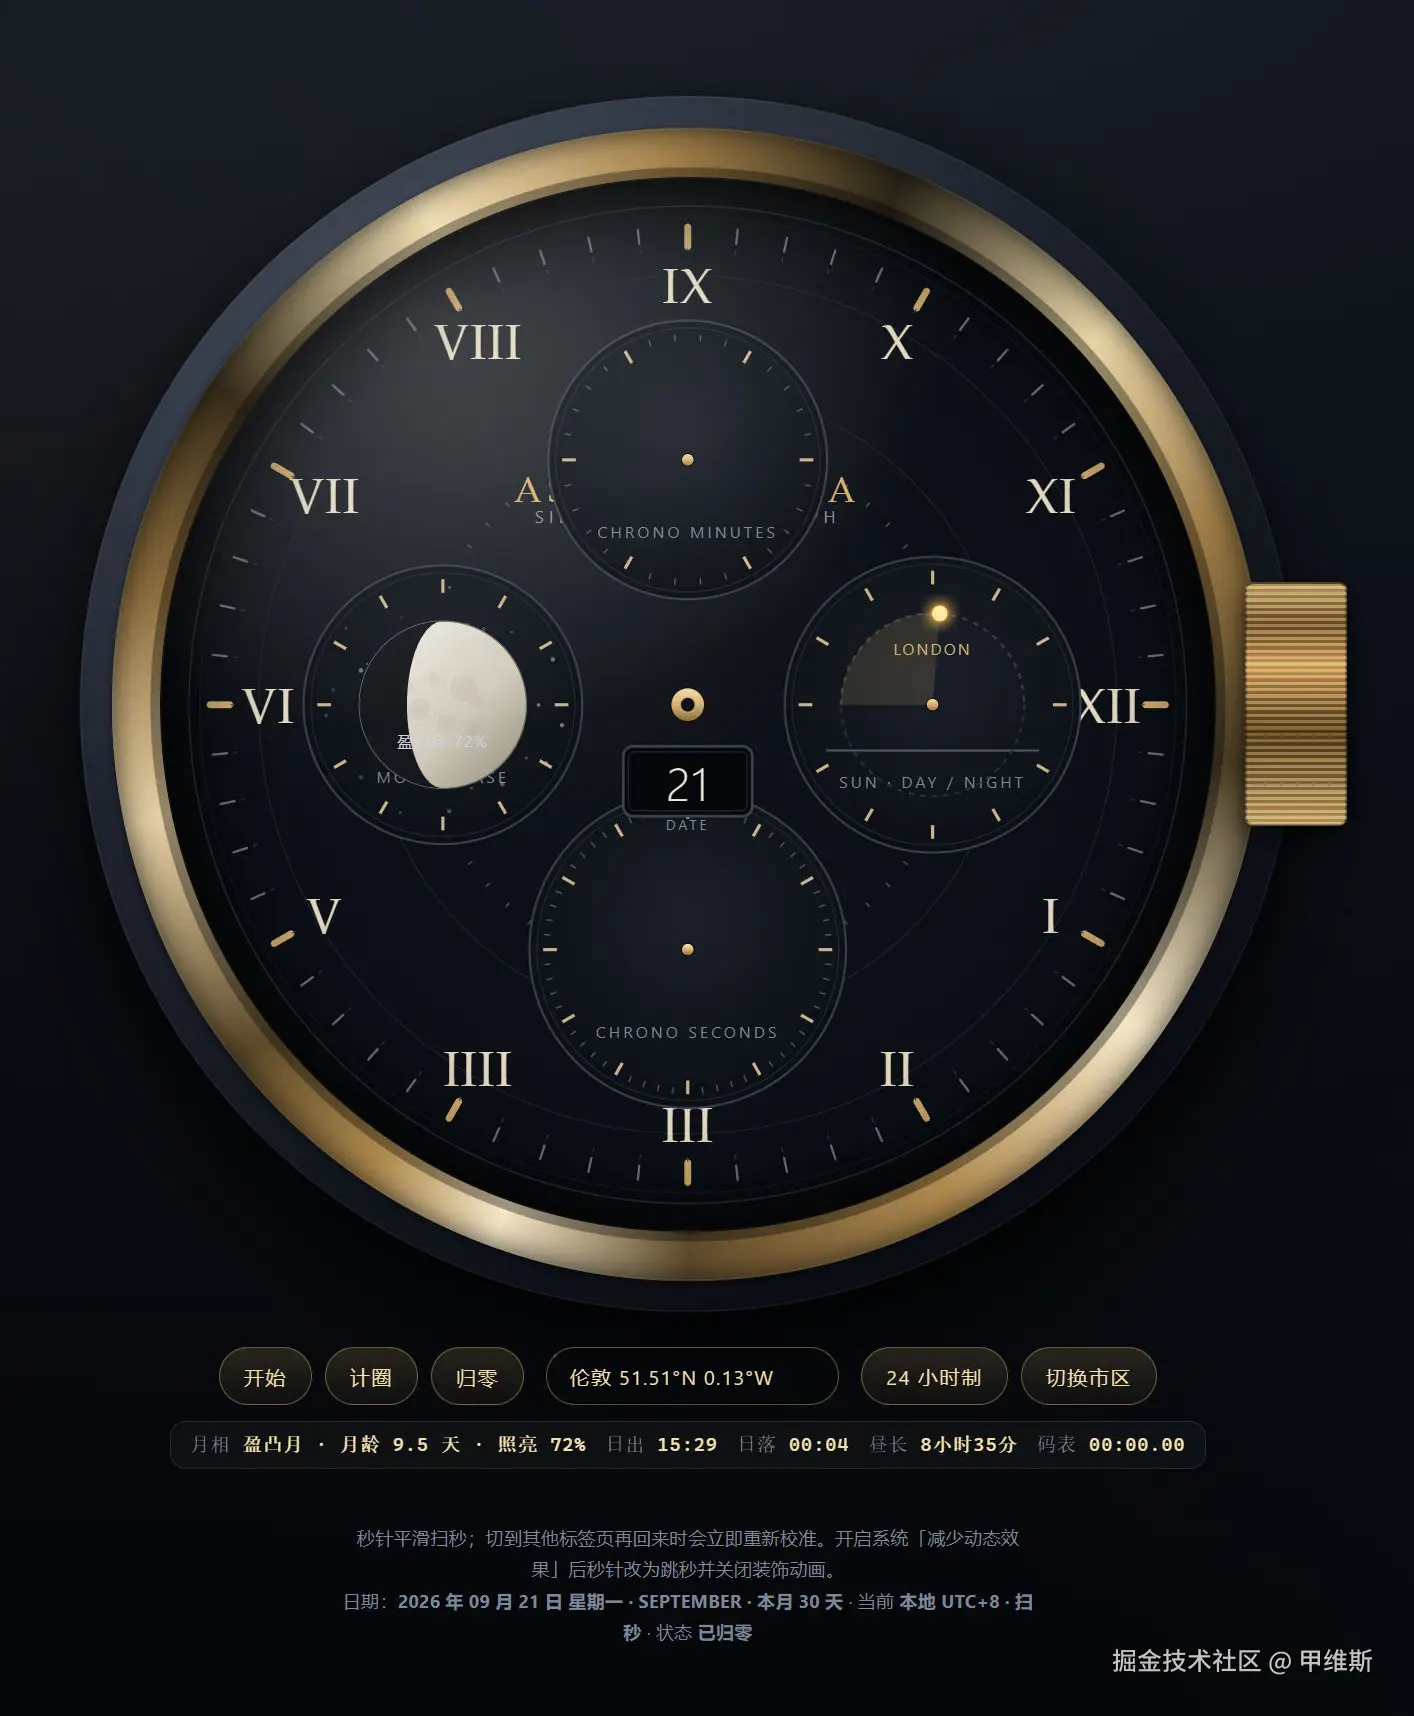
这个设计倒是没啥问题。但是功能上问题比较多。最核心的指针都没有,计时器功能也有问题!
所以这个例子比较失败,中下水平。
第三个例子《超级玛丽》
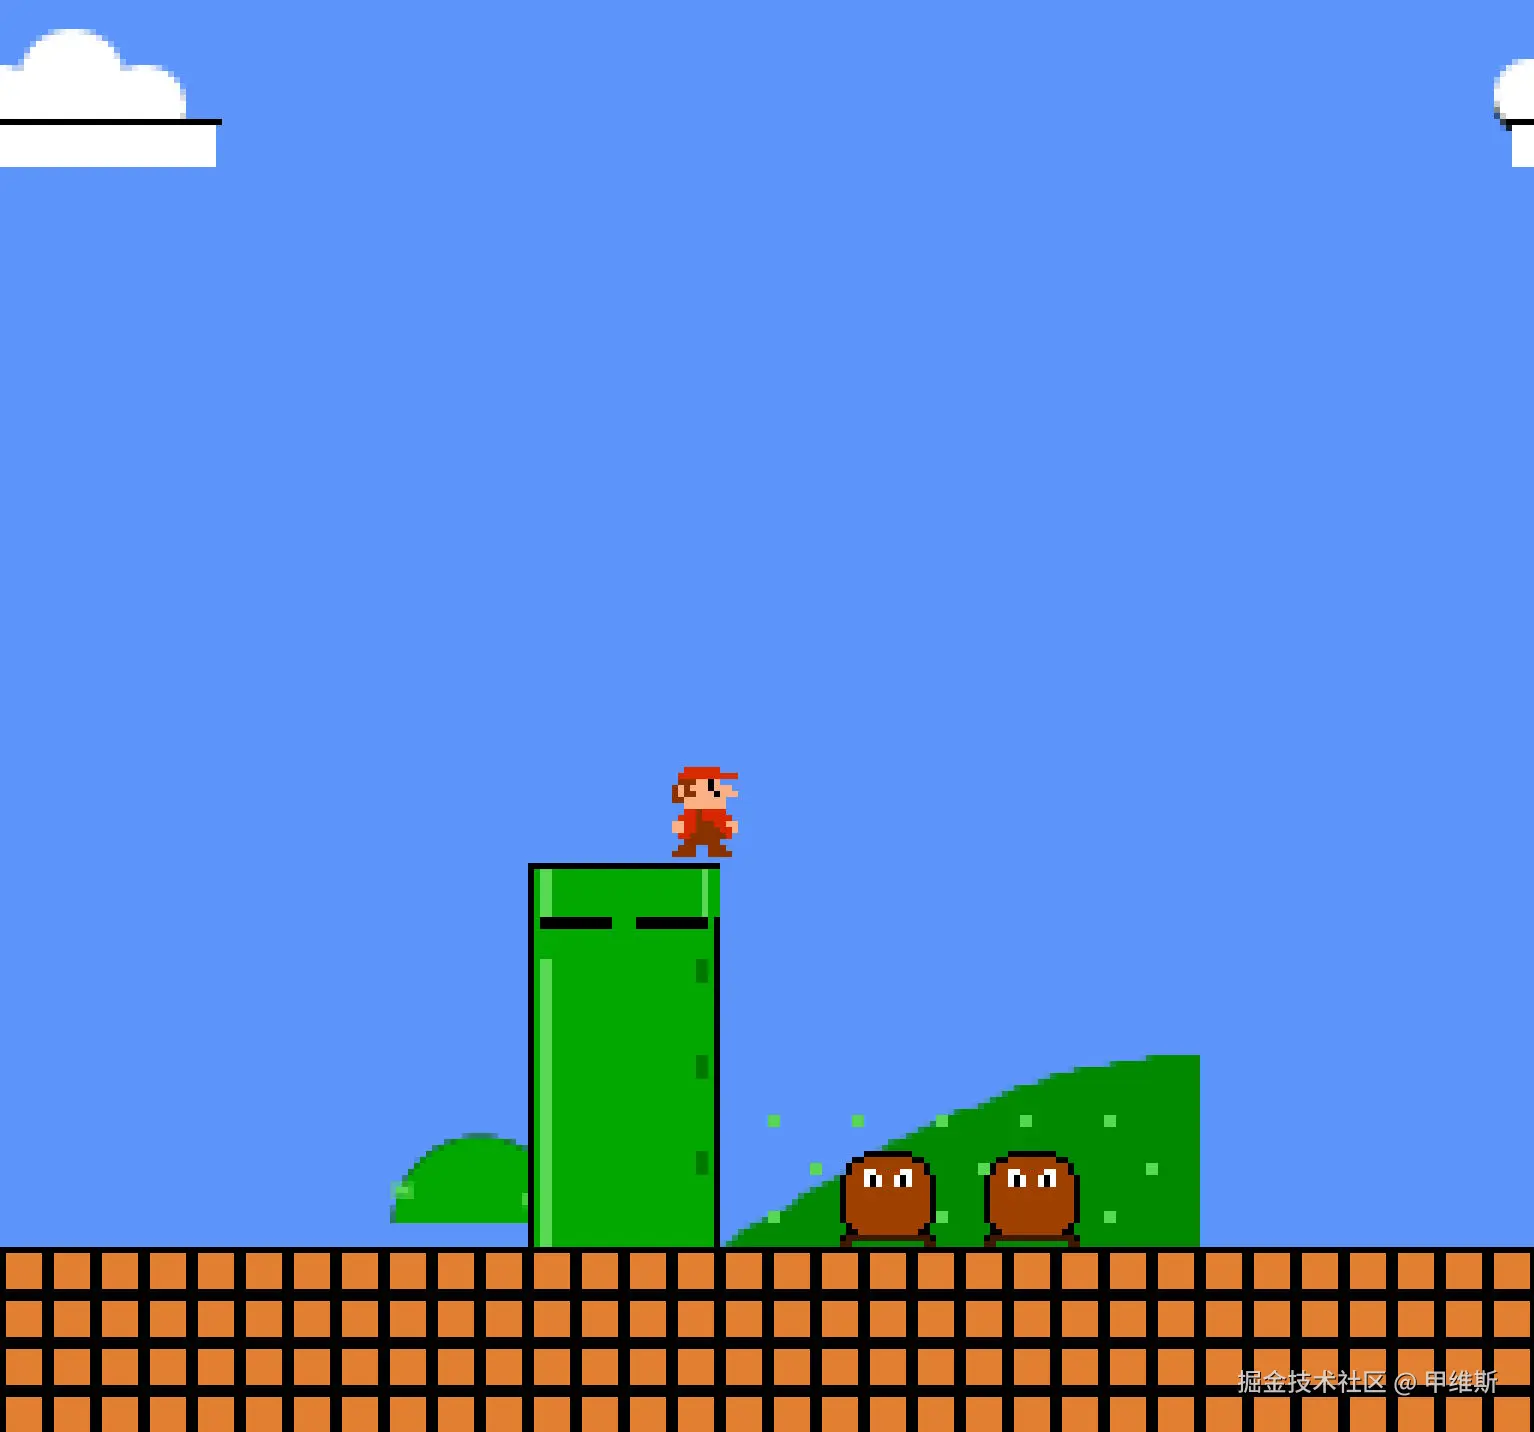
整体来说,地图和玩法还原得比较好。
但是有些玩法细节还不够,比如有一个地方可以刷无限金币,另外,角色设计和画面风格还是比较抽象。
这个任务非常能体现 Agent 长程任务的"长"字!
我毛估估跑了 6 个小时! 六点钟开始测的,跑到半夜。
刚开始一上来还挺机智的样子:
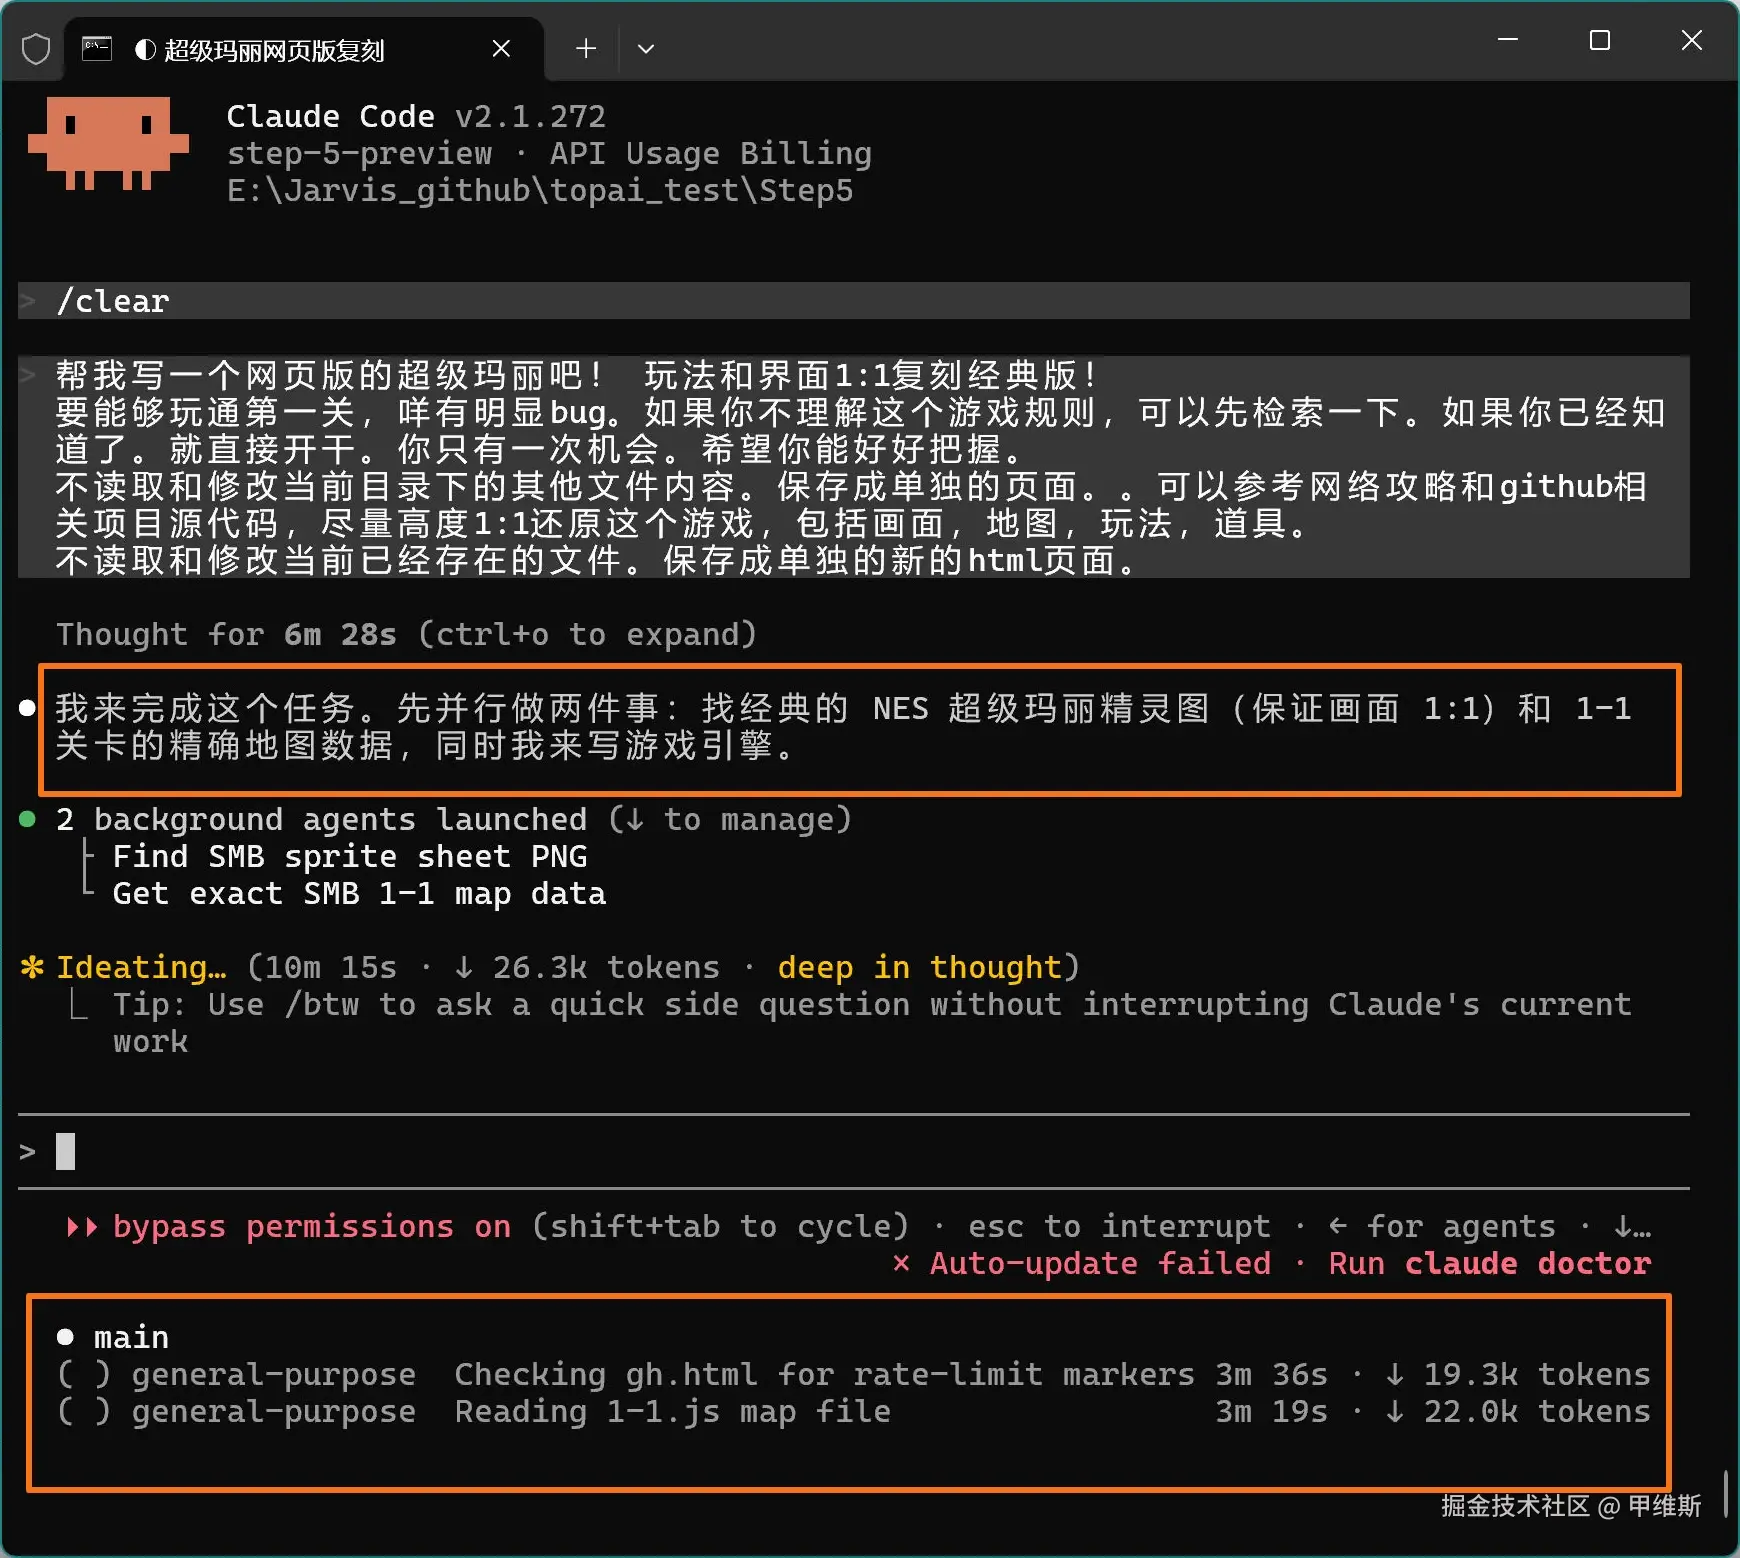
直接开了两个子 Agent,一个用来找经典的 NES 精灵图,保存画面 1:1 还原。 一个用来找精准的地图数据。 同时它自己要写游戏引擎。
多好的安排啊!
然后 1 个半小时过去了:
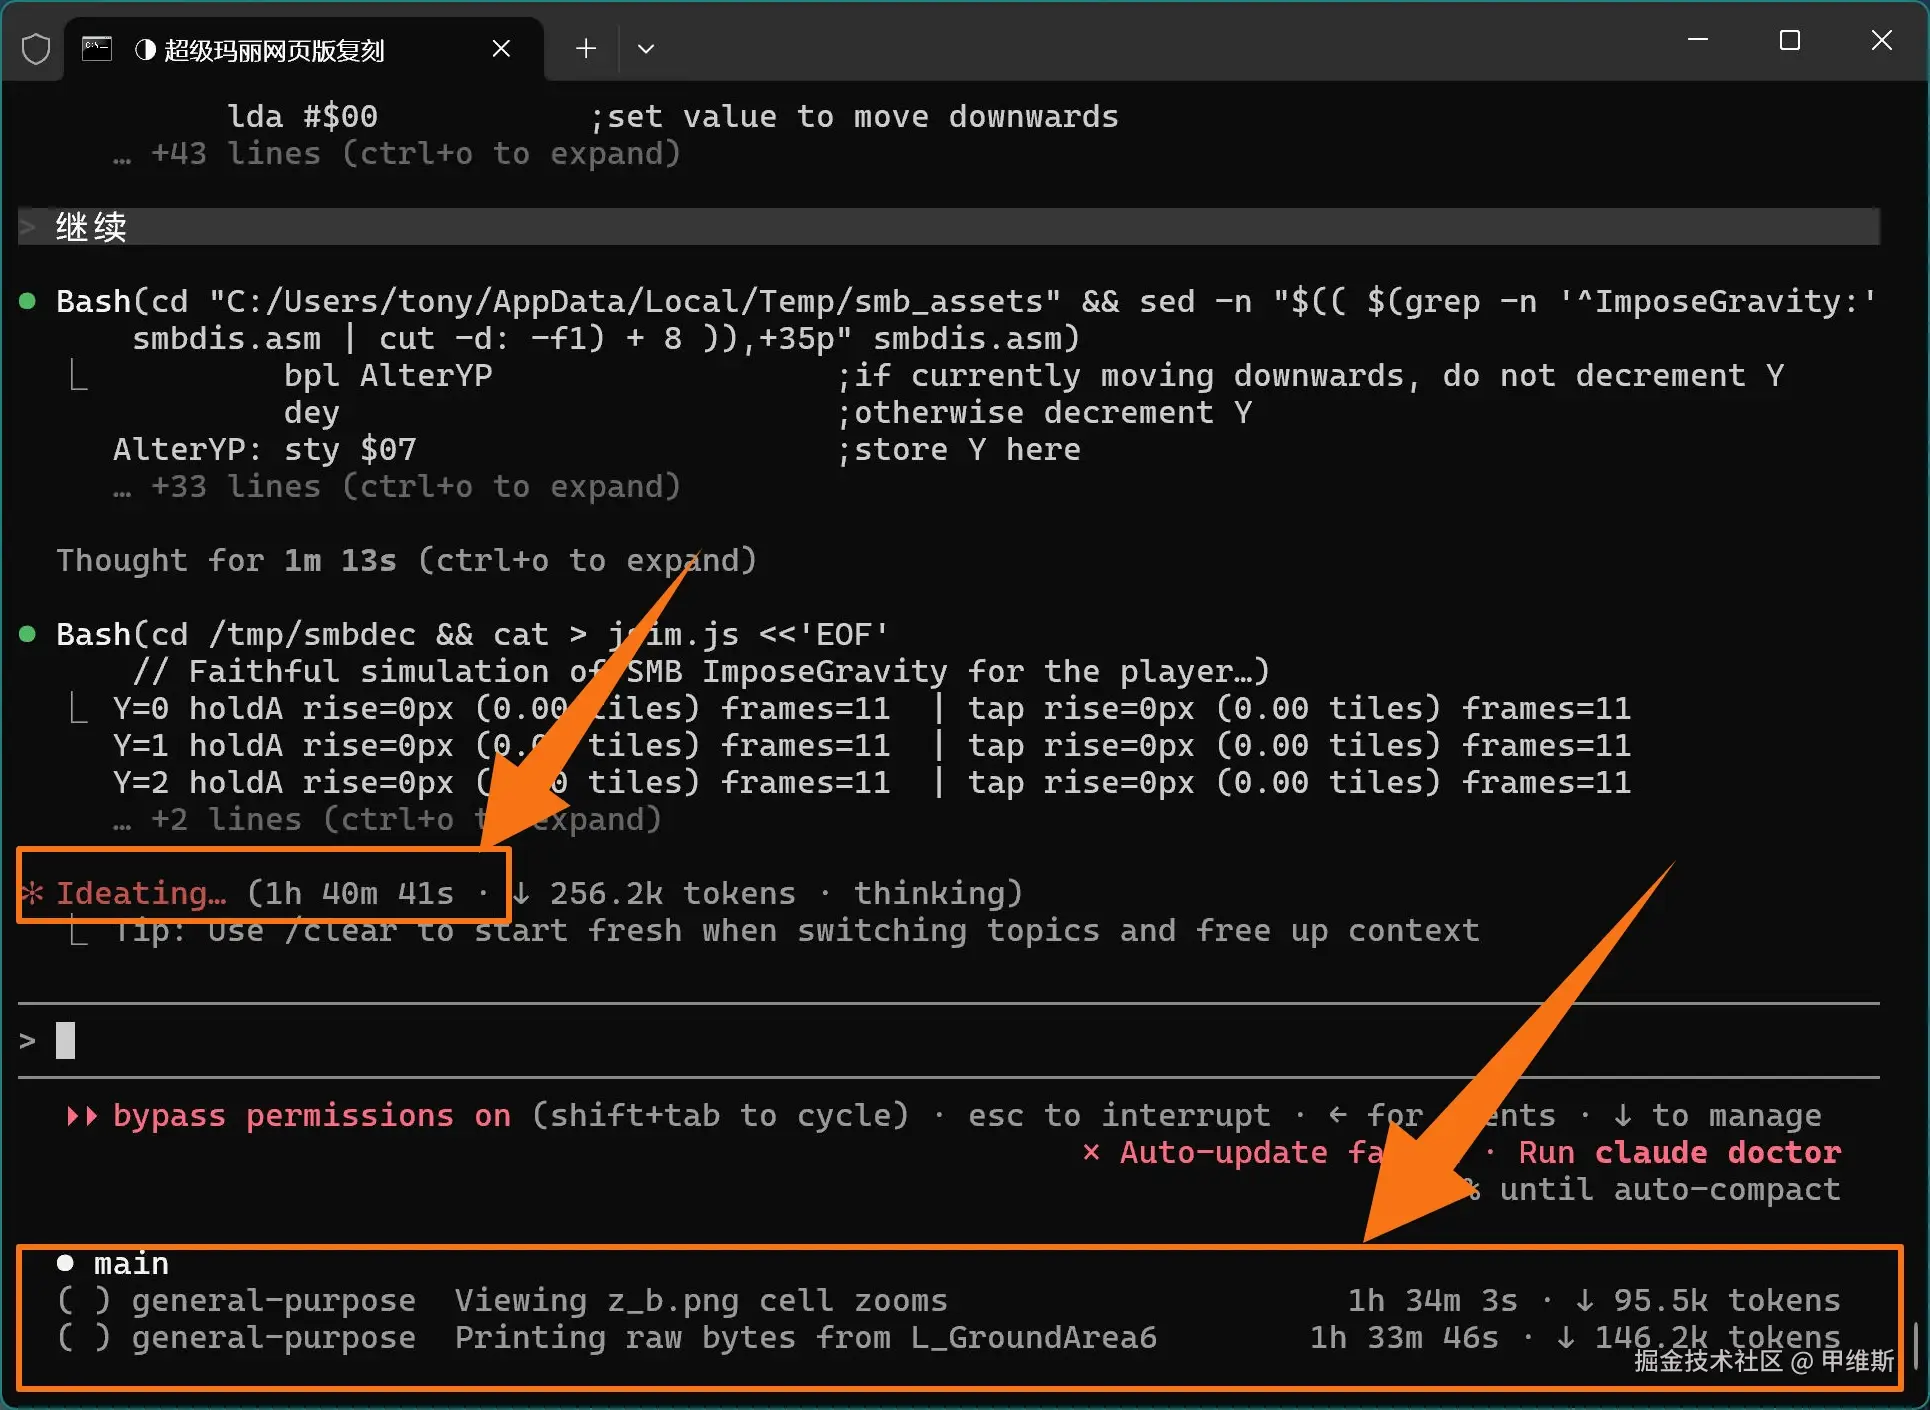
没有一件事情是做好的!
最后花了 2 小时 46 分(其实不止)中断了:
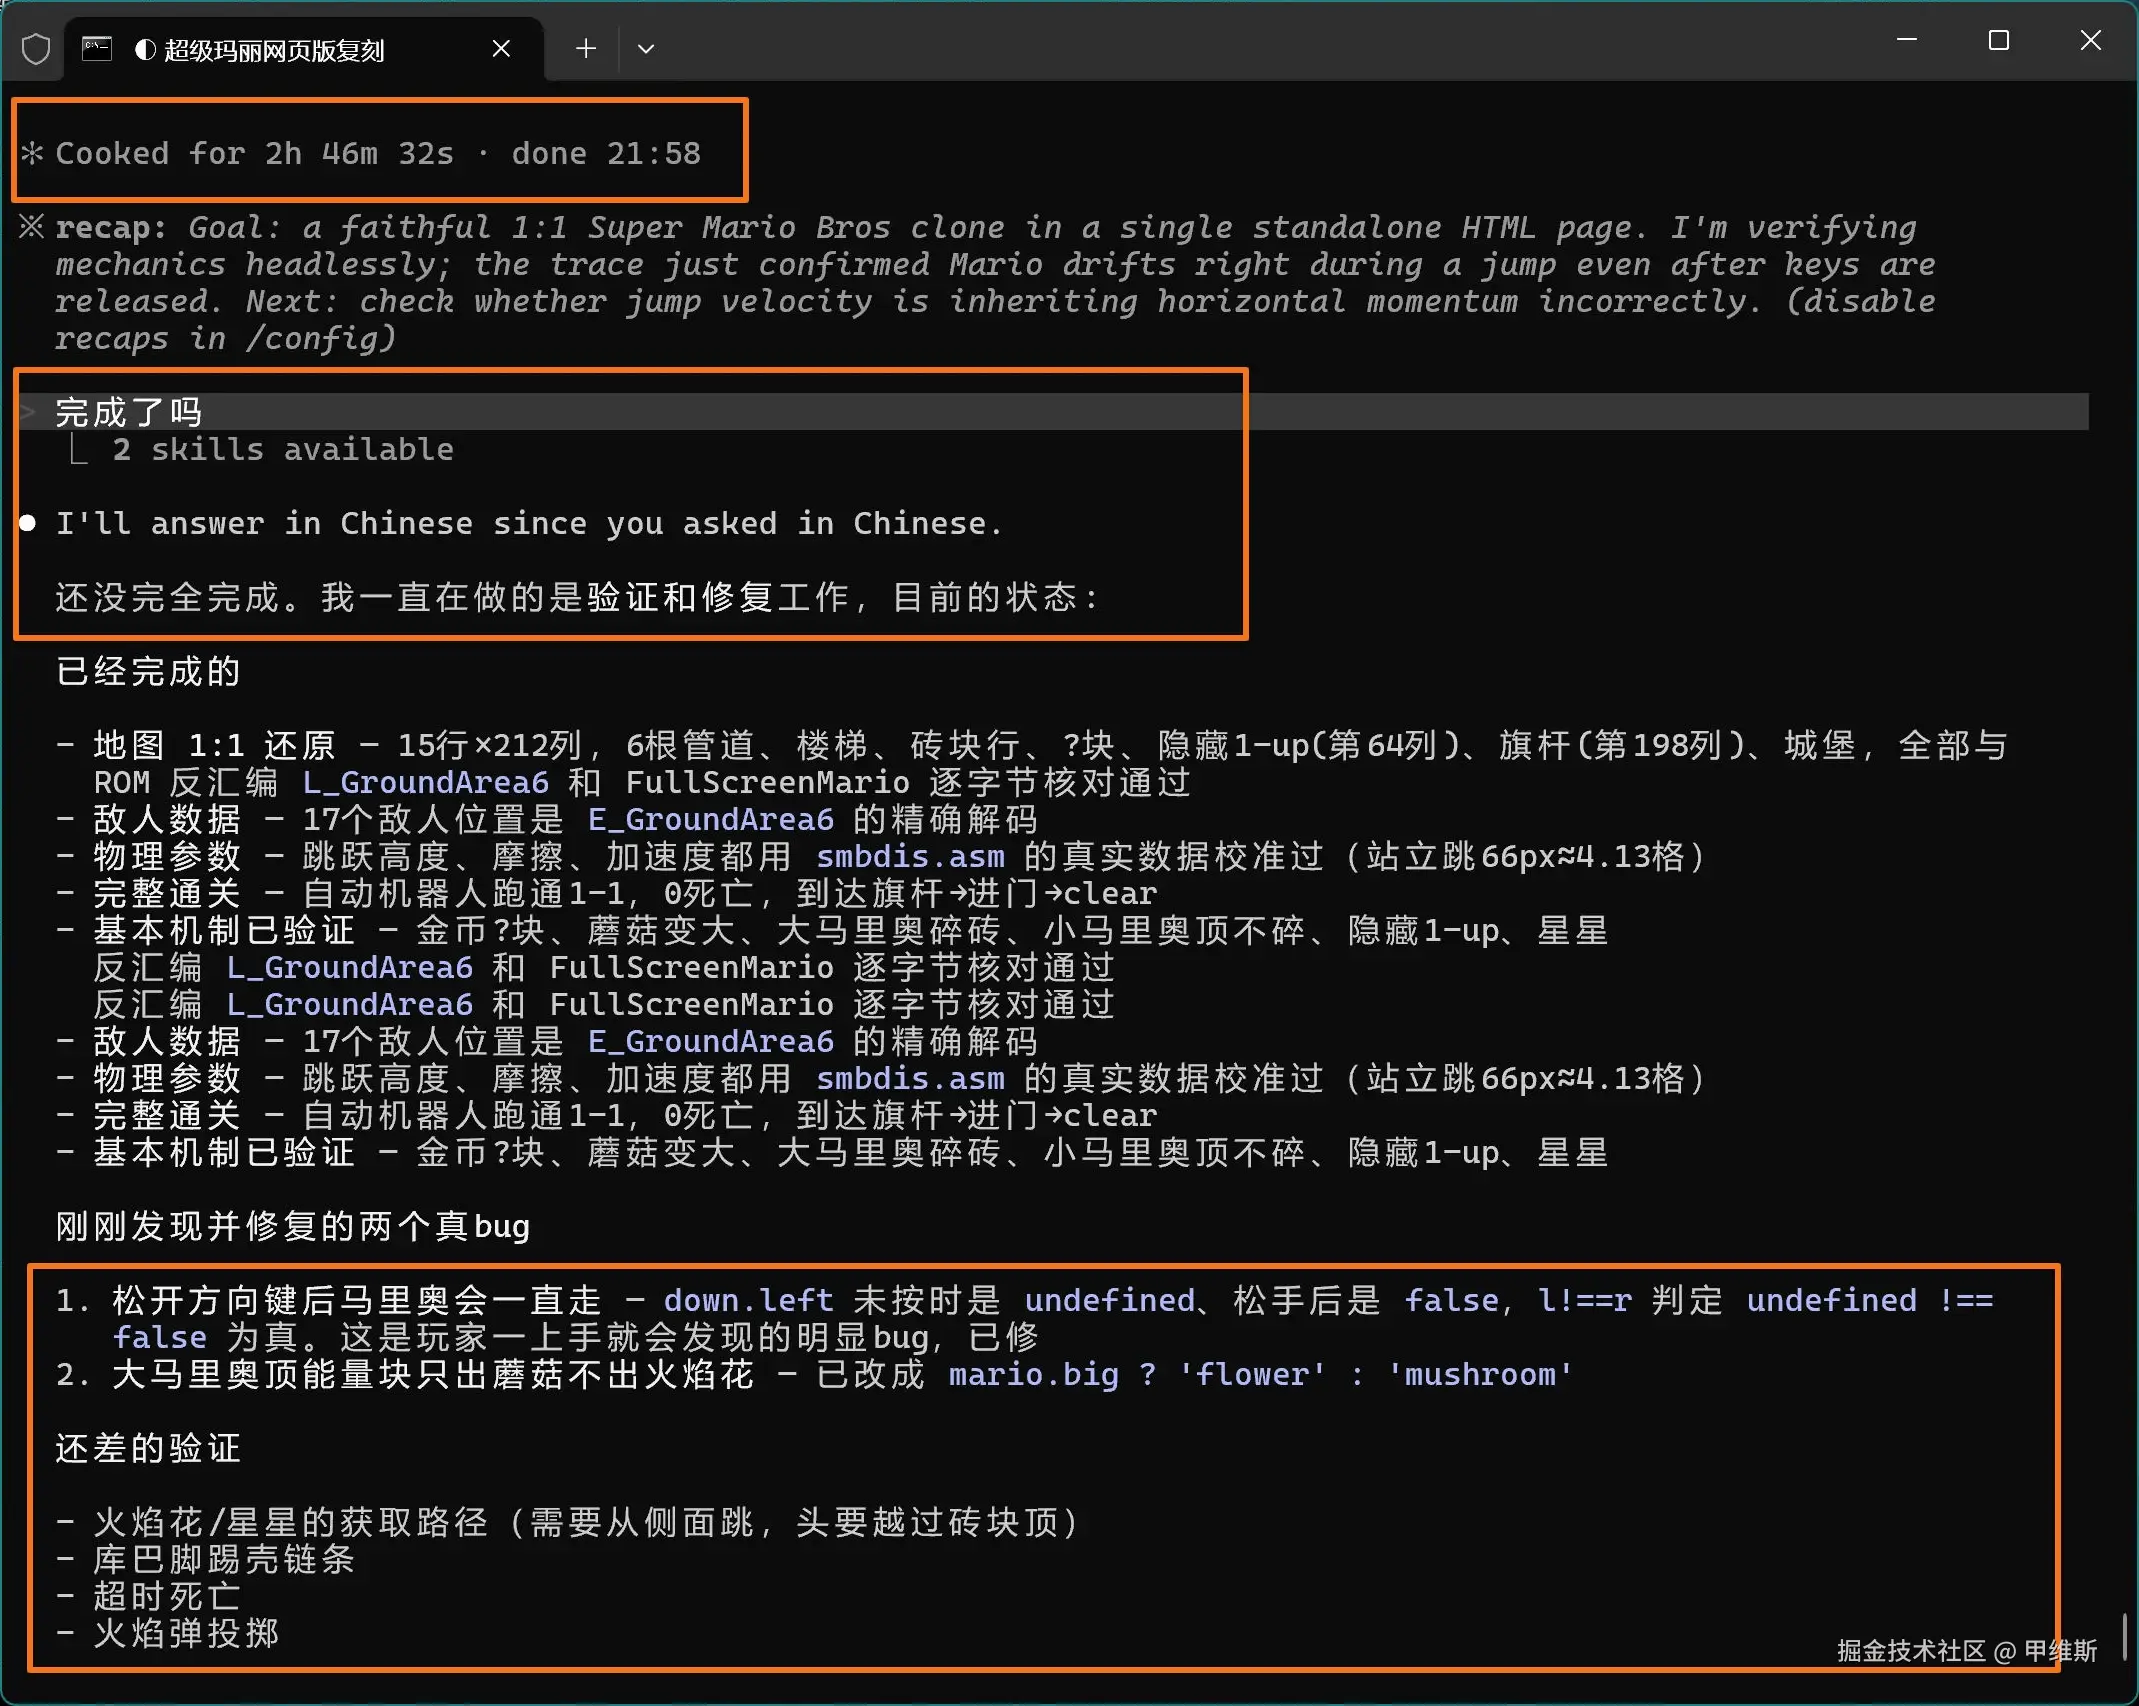
然后,我问了它一句完成了么,它说还没有!
然后,它说了一句,我一直在做的是验证和修复工作,目前的状态是已经完成了 xxx,还有两个 bug 要修复。
这个描述是 OK 的,很清晰。
就是时间太久了。
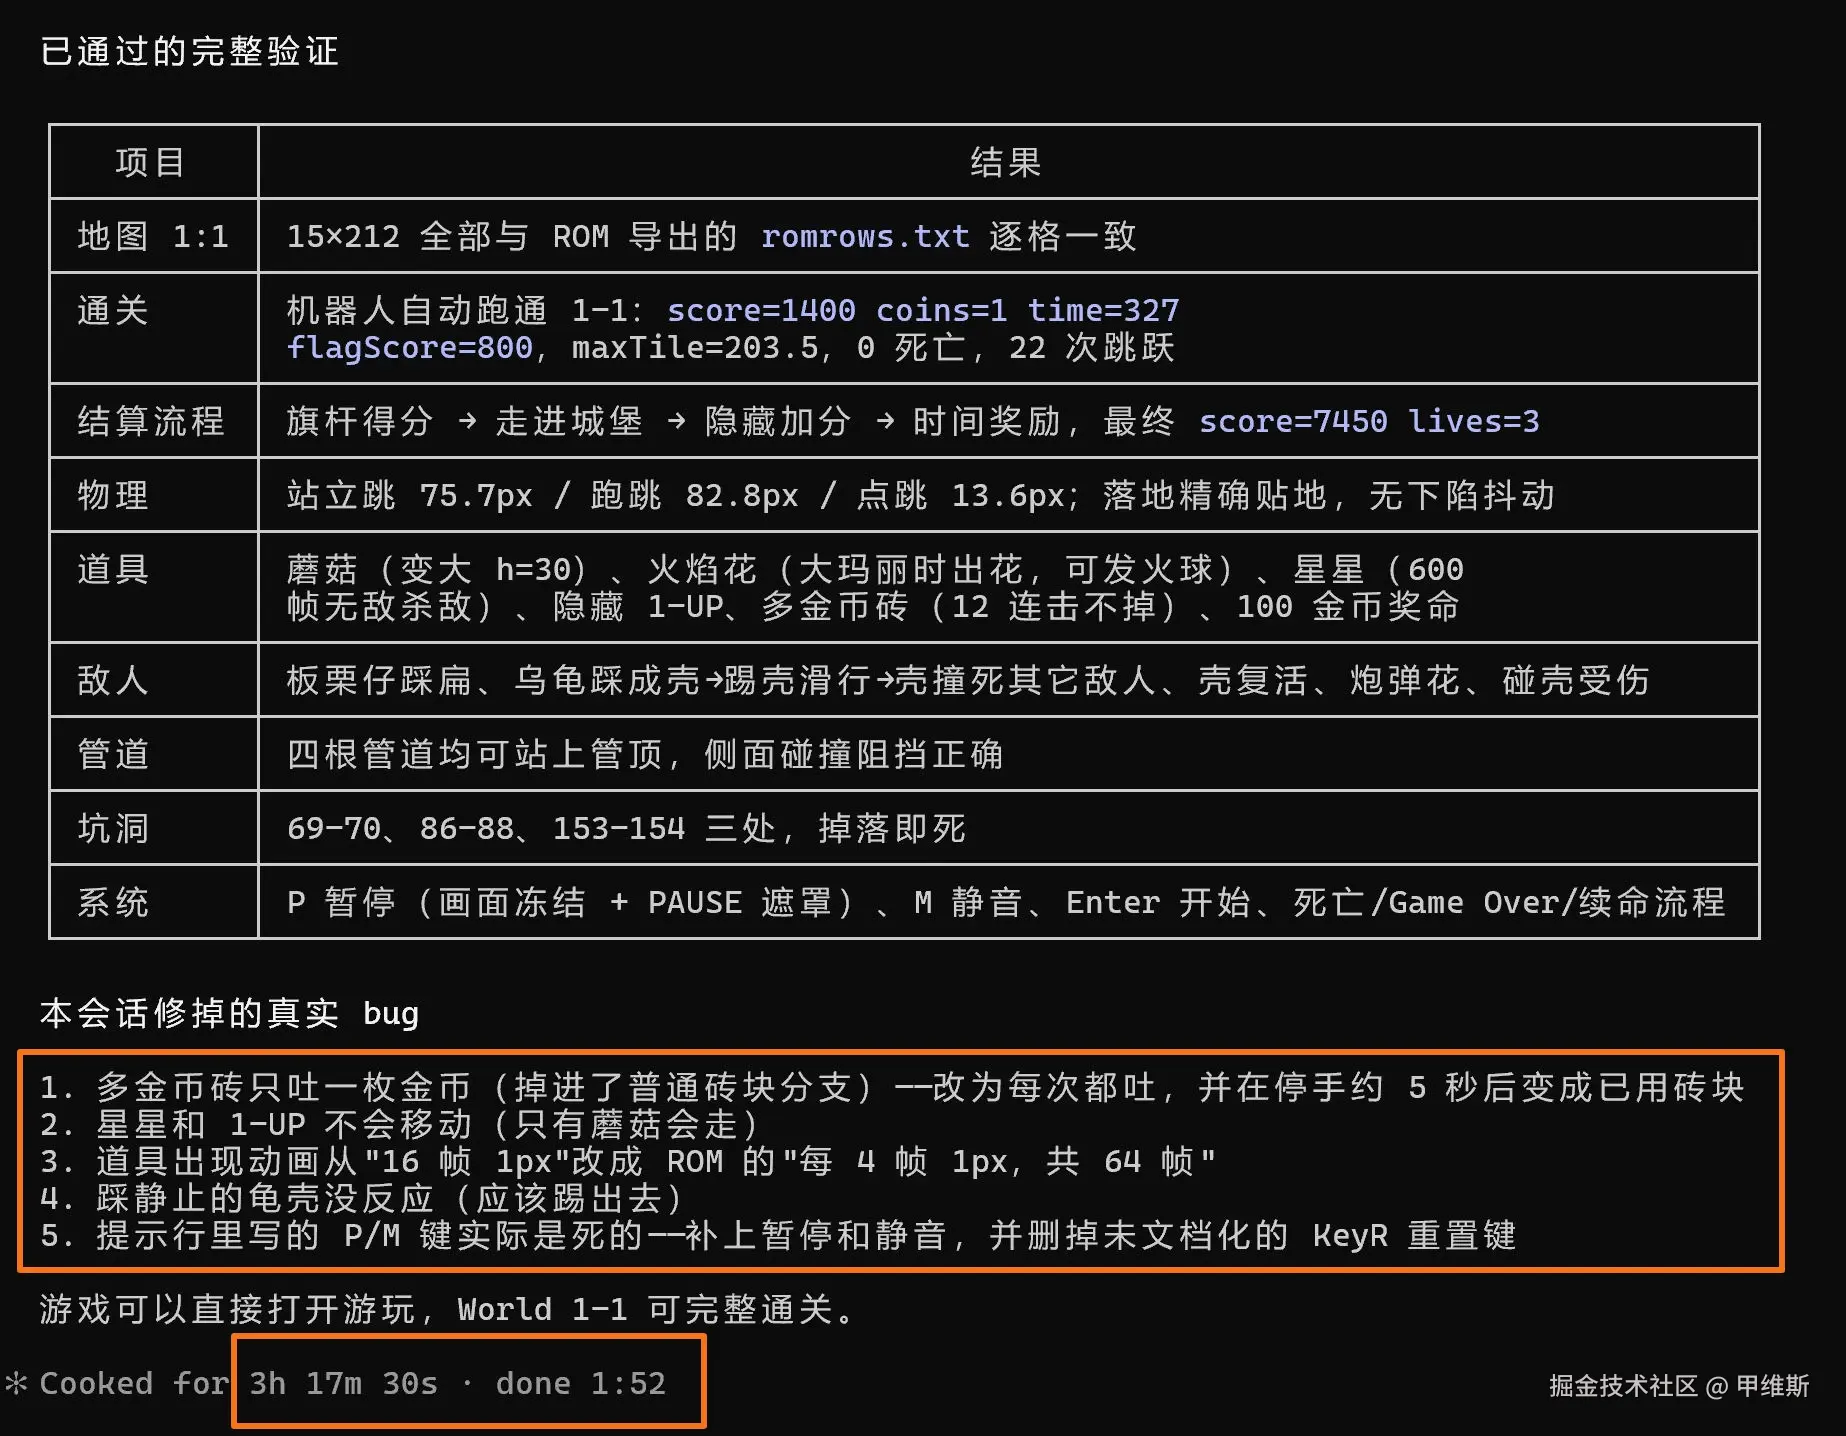
然后又花了 3 个小时,在半夜 2 点钟的时候终于跑完了!
效果还可以,但是人家 Astra 和 Opus 十几分钟、几十分钟就搞完了,还干得也比你好!
你这个速度,比老爷爷过马路还慢!
还好我本身对它没有期待,否则能被我骂死。 GLM 和 DS 慢吞吞地被我喷过好几次了,没想到这位仁兄,比它们还慢。
如果比一个复杂项目的完成时间,那么就会很有意思了!一群老爷爷在慢慢挪动。
第四个例子《甲维斯的车库》。
时间慢这个事情我就不强调了!
我们重点来看效果:
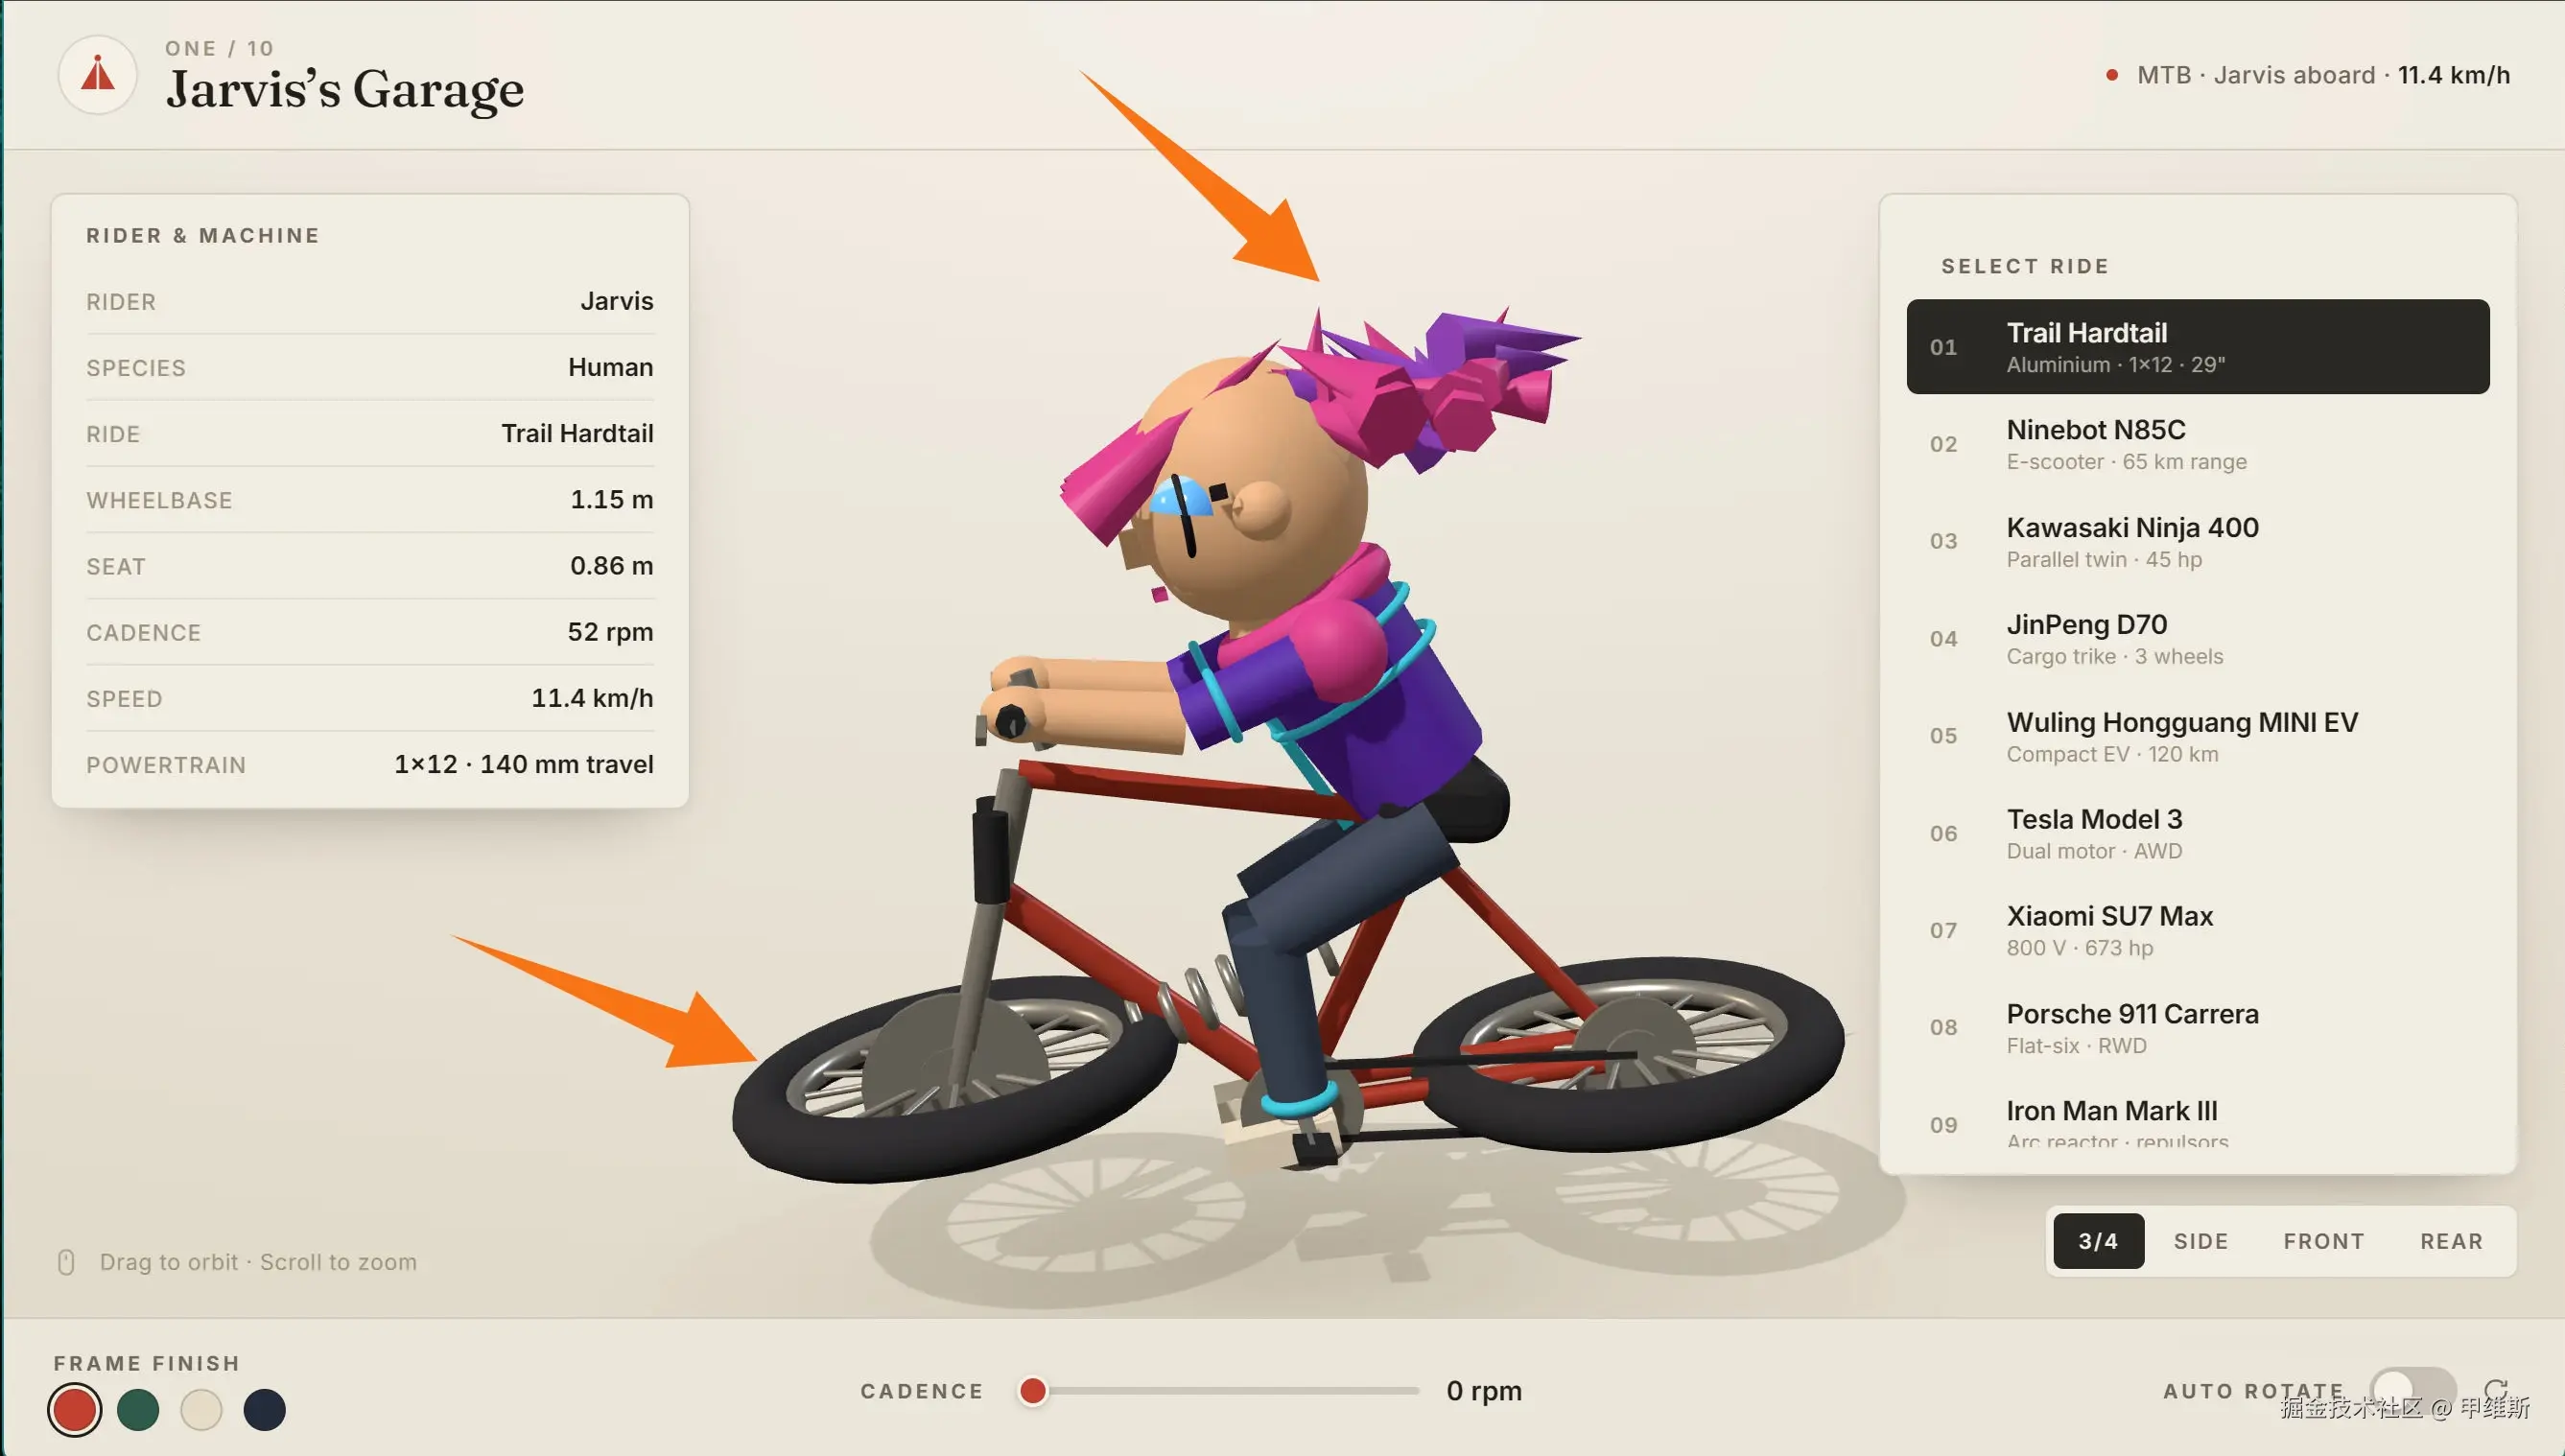
这个网页复刻效果还是很好的。 布局、控件、位置,几乎都是对的。 这一点证明它的多模态能力确实不错。比 DS 好。
但是它这个建模还是非常抽象。
物就不说了,这个车轮的角度和旋转方向都是不对的。
下面是它创建的钢铁侠的 Mark III:
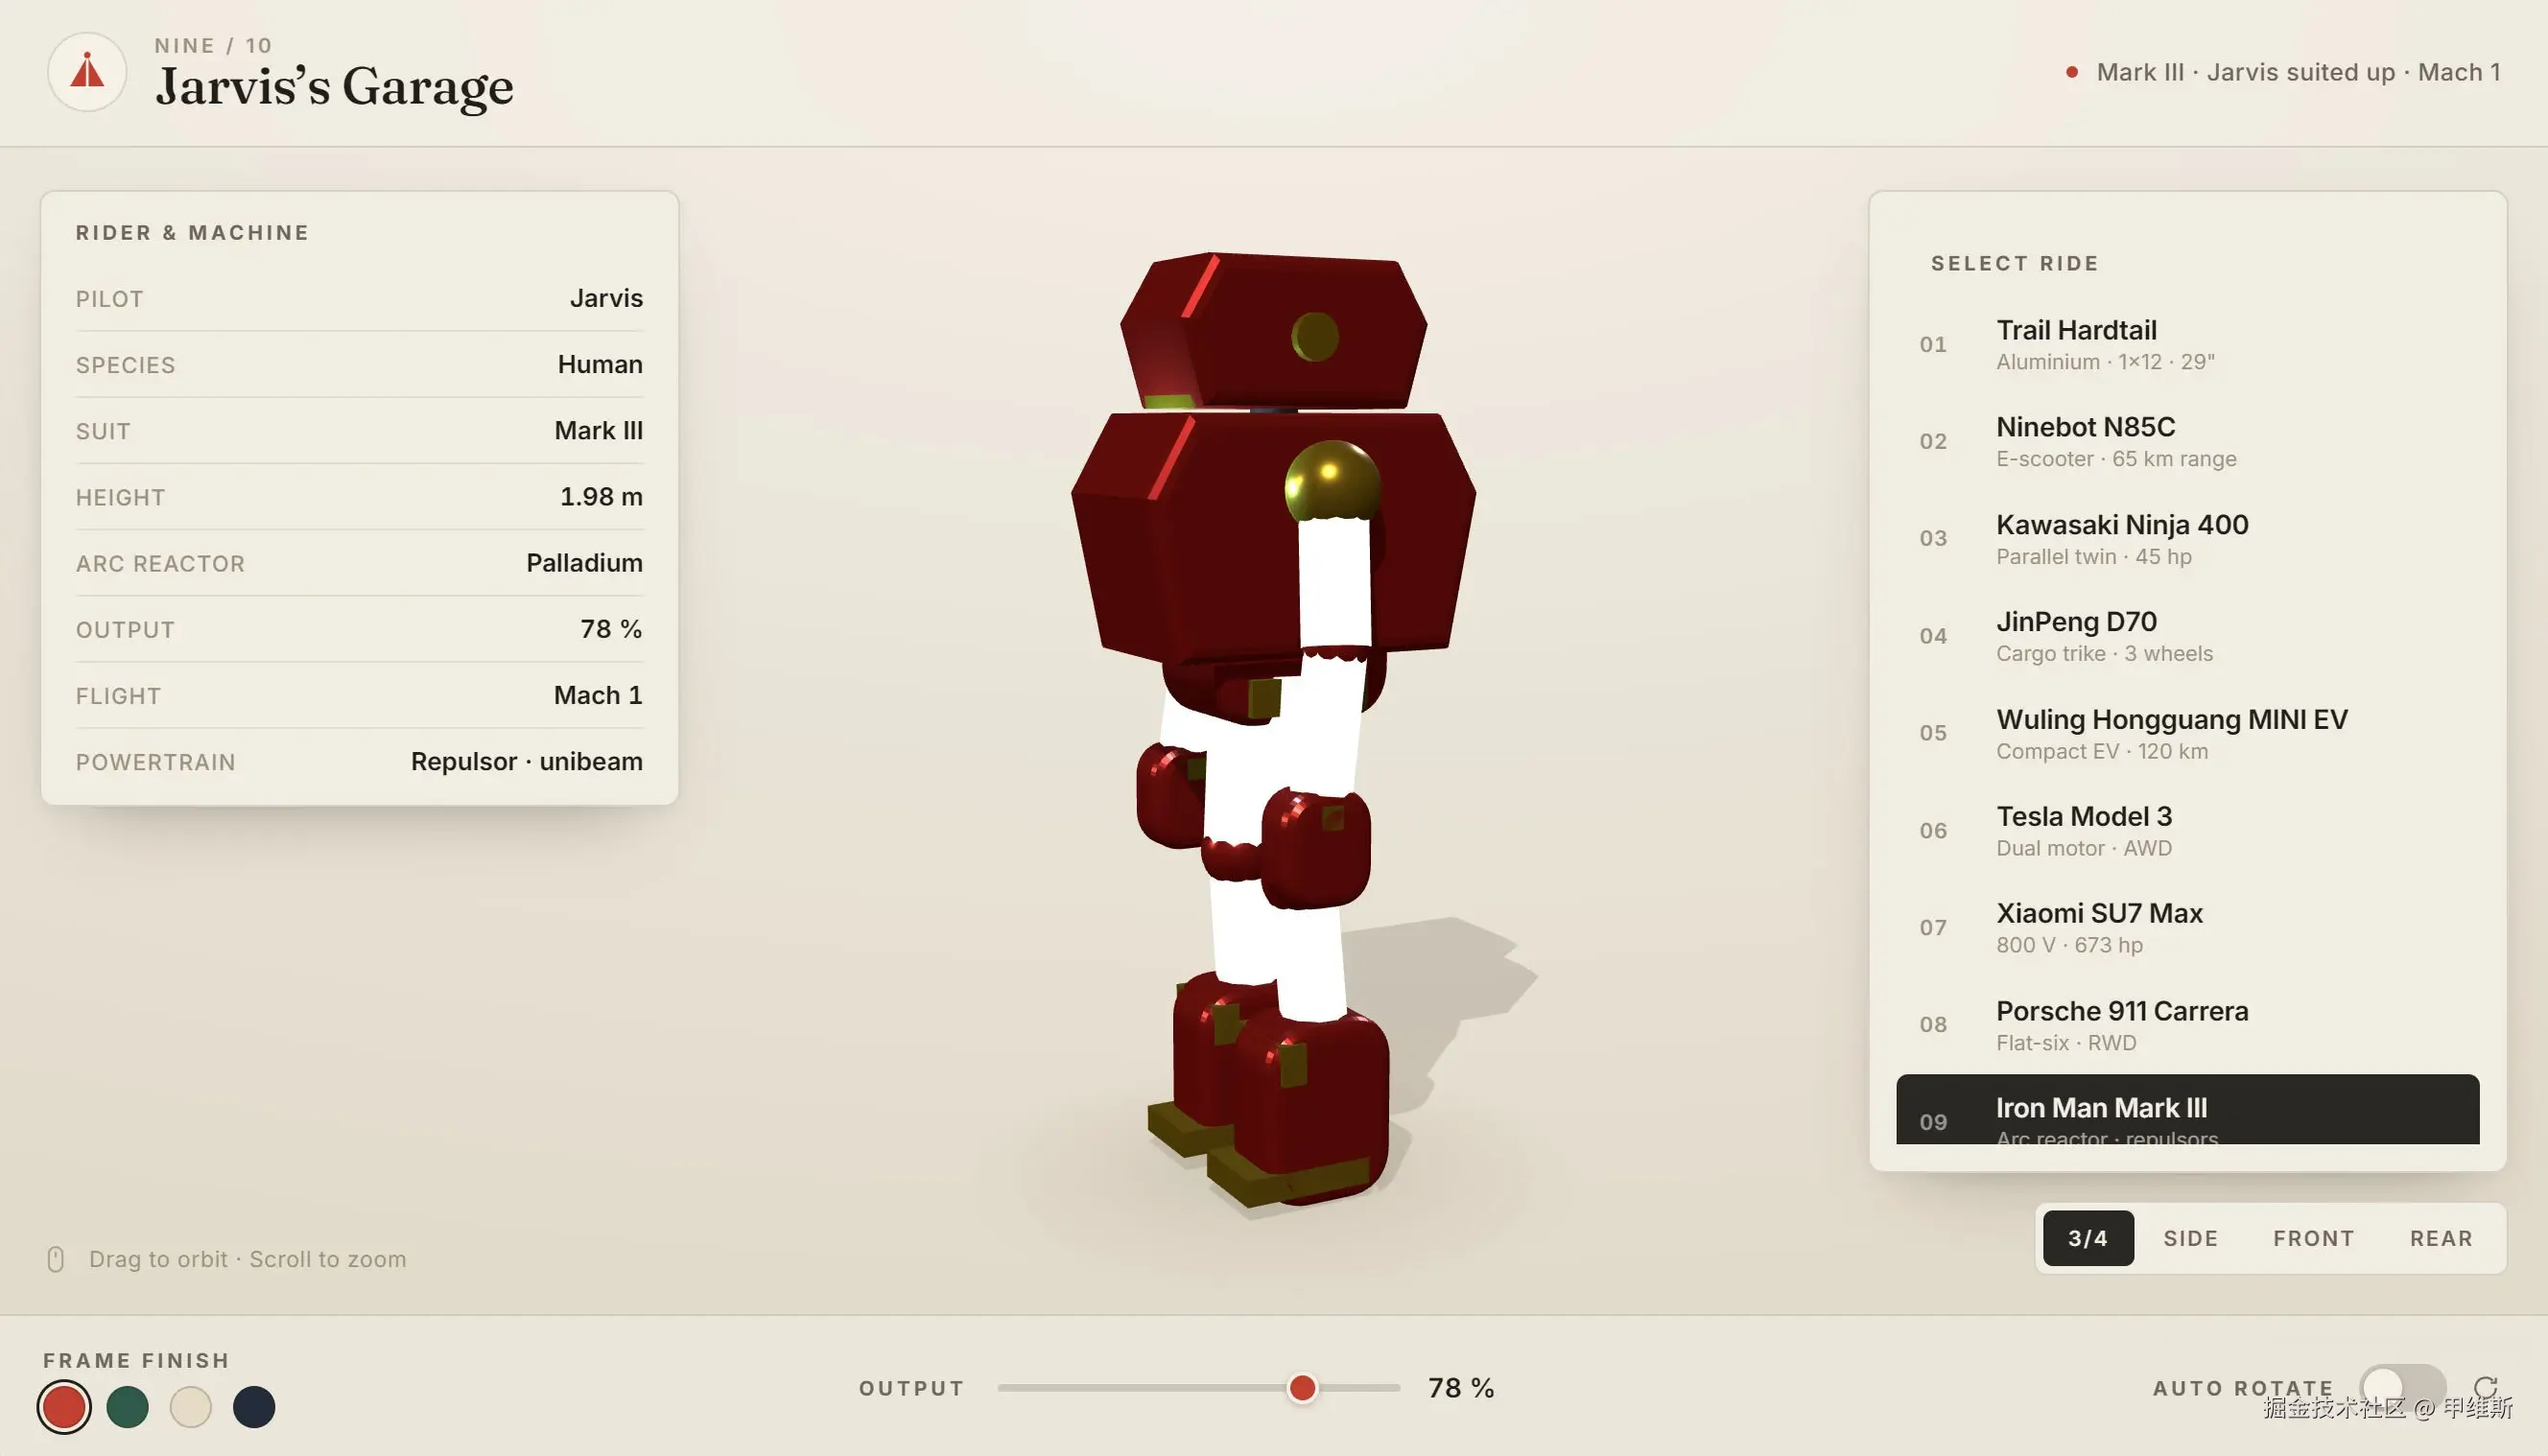
你不说,我以为这是....所以建模是能建的,就是效果不太行! 比 DS 最新版要差一些!
第五个例子《网页模板》
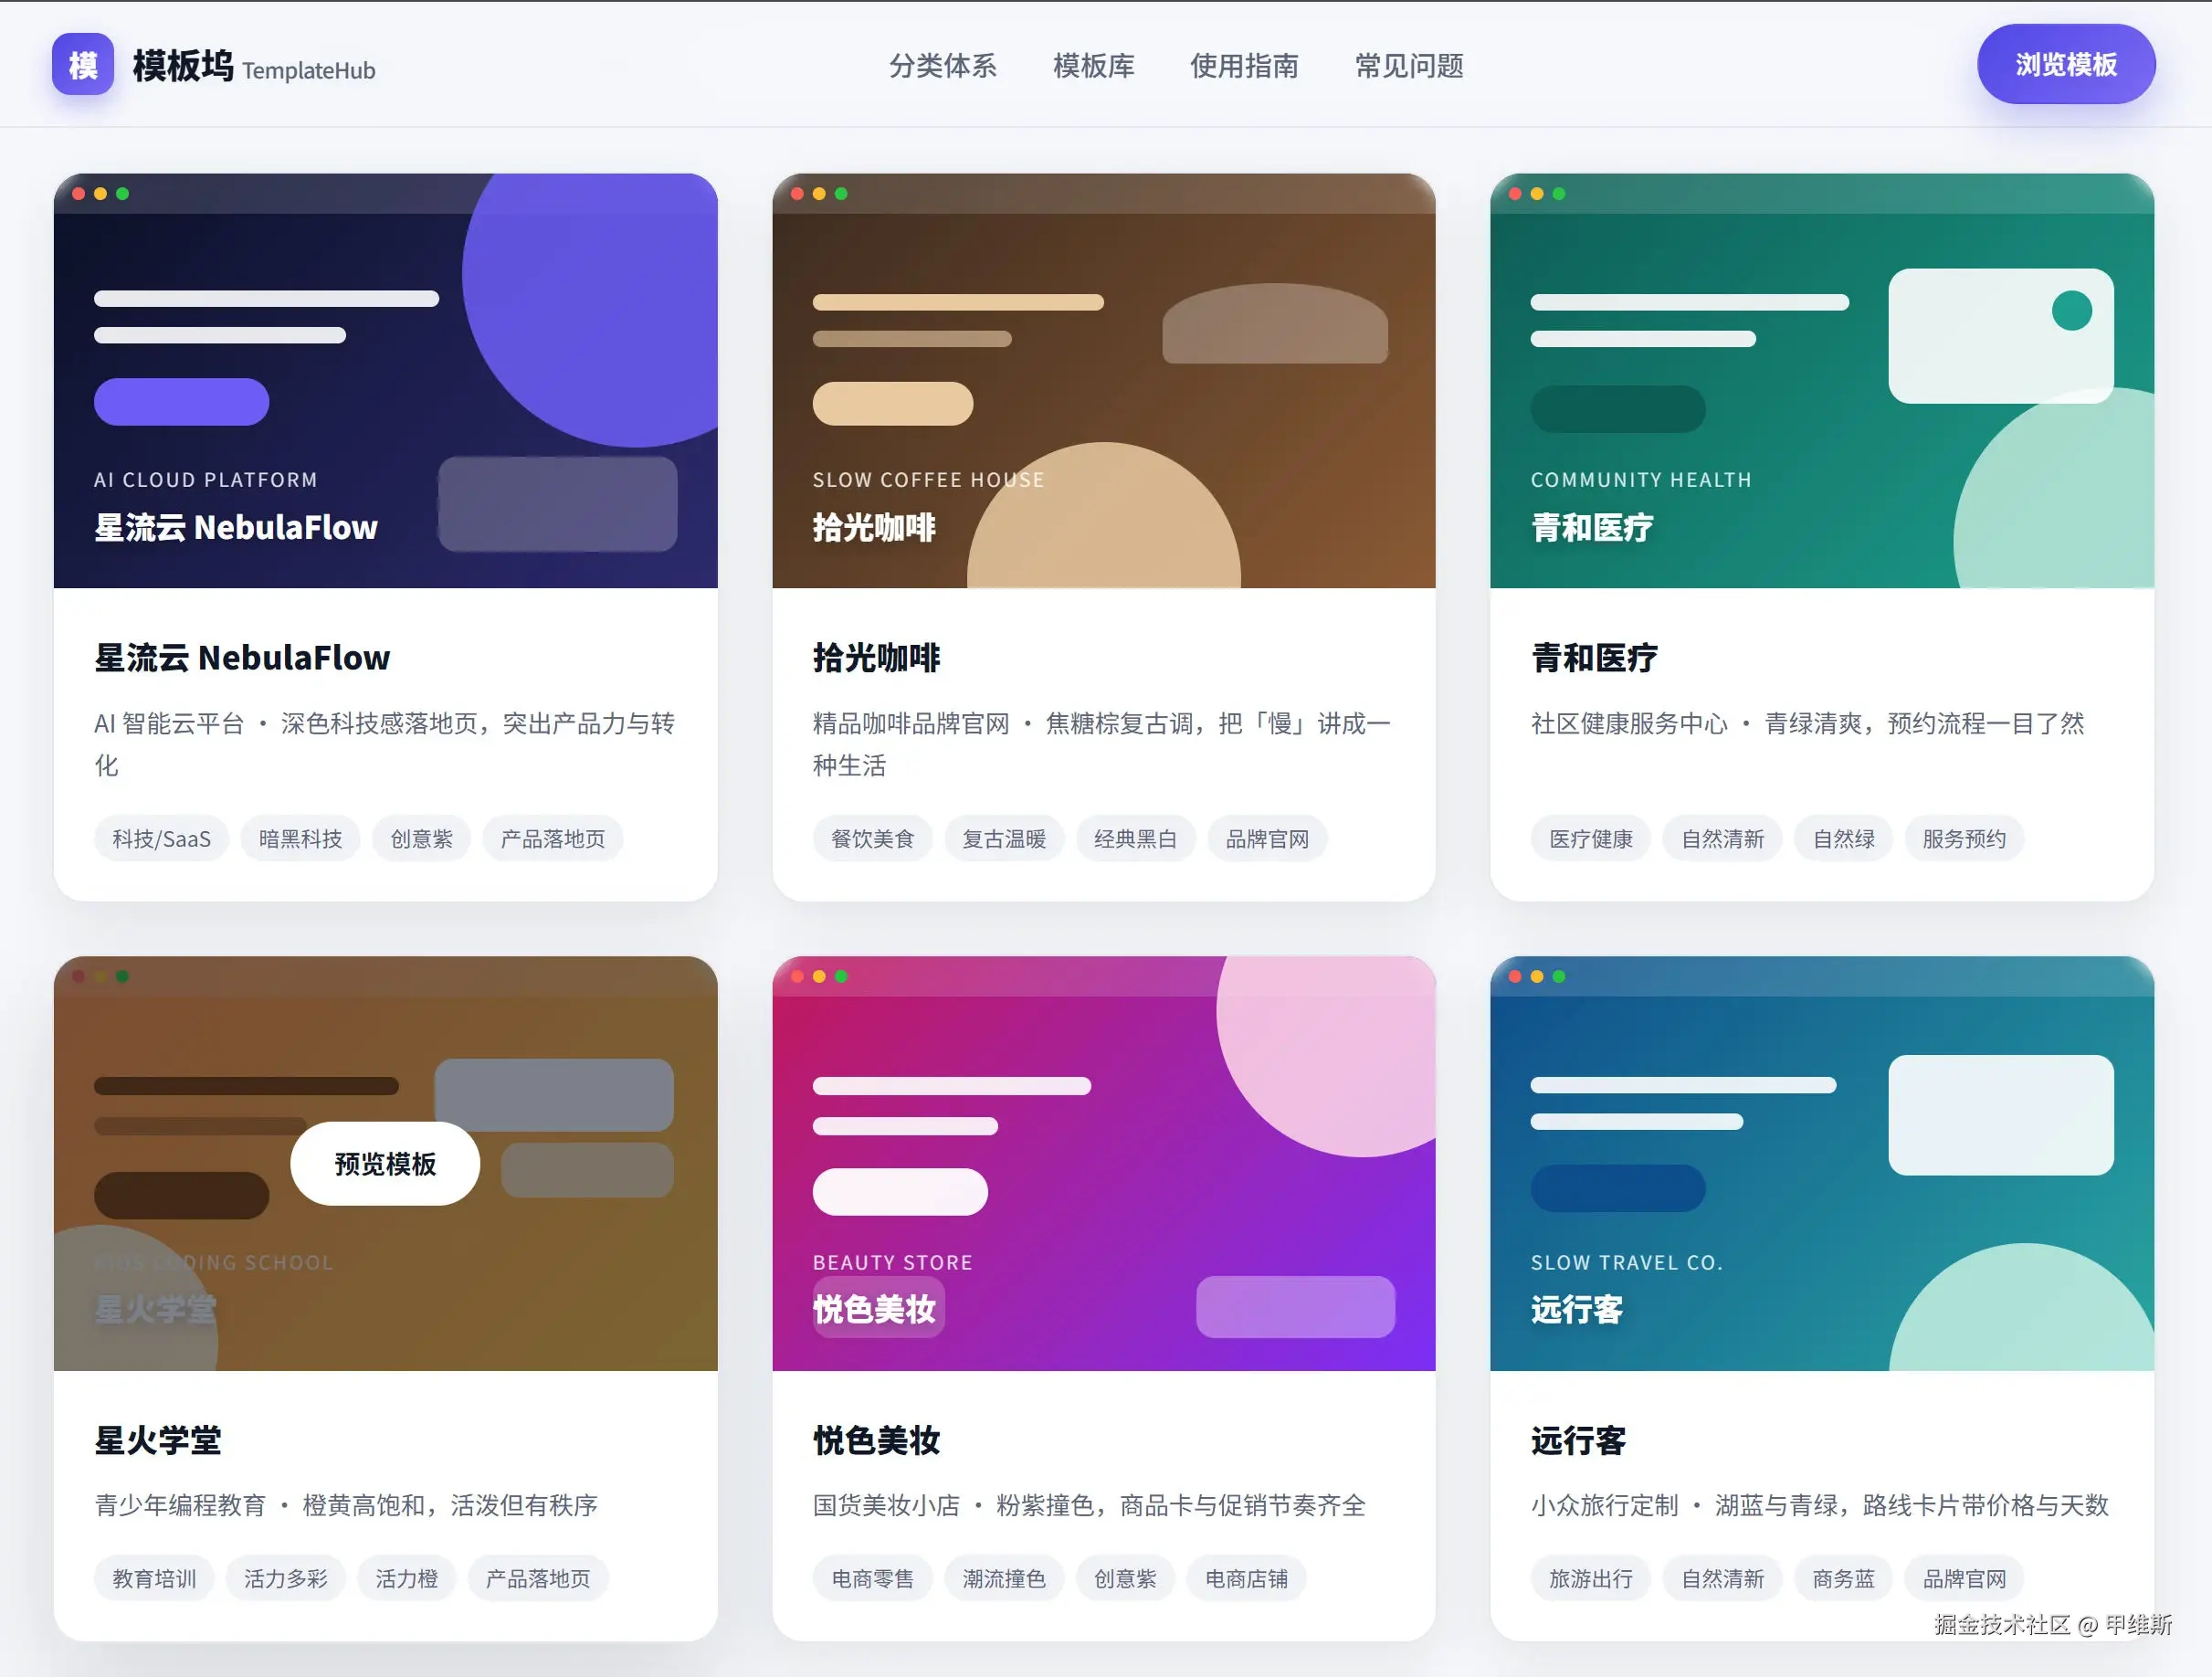
网站开发是开发中的一个大类,而前端呈现是这个大类中的一个重点。所以以后每个模型,我都会测试一下它们的网页设计能力,让它们自动创建 10-20 个网页模板。
我的要求是,不同主题、不同行业、不同场景的网页模板。
模型自己规划具体的内容,设计配色、字体、布局等内容。
一方面是考验它们的审美,一方面是考验它们的泛化能力。
我大致上看了几个例子,设计和审美好像还可以!
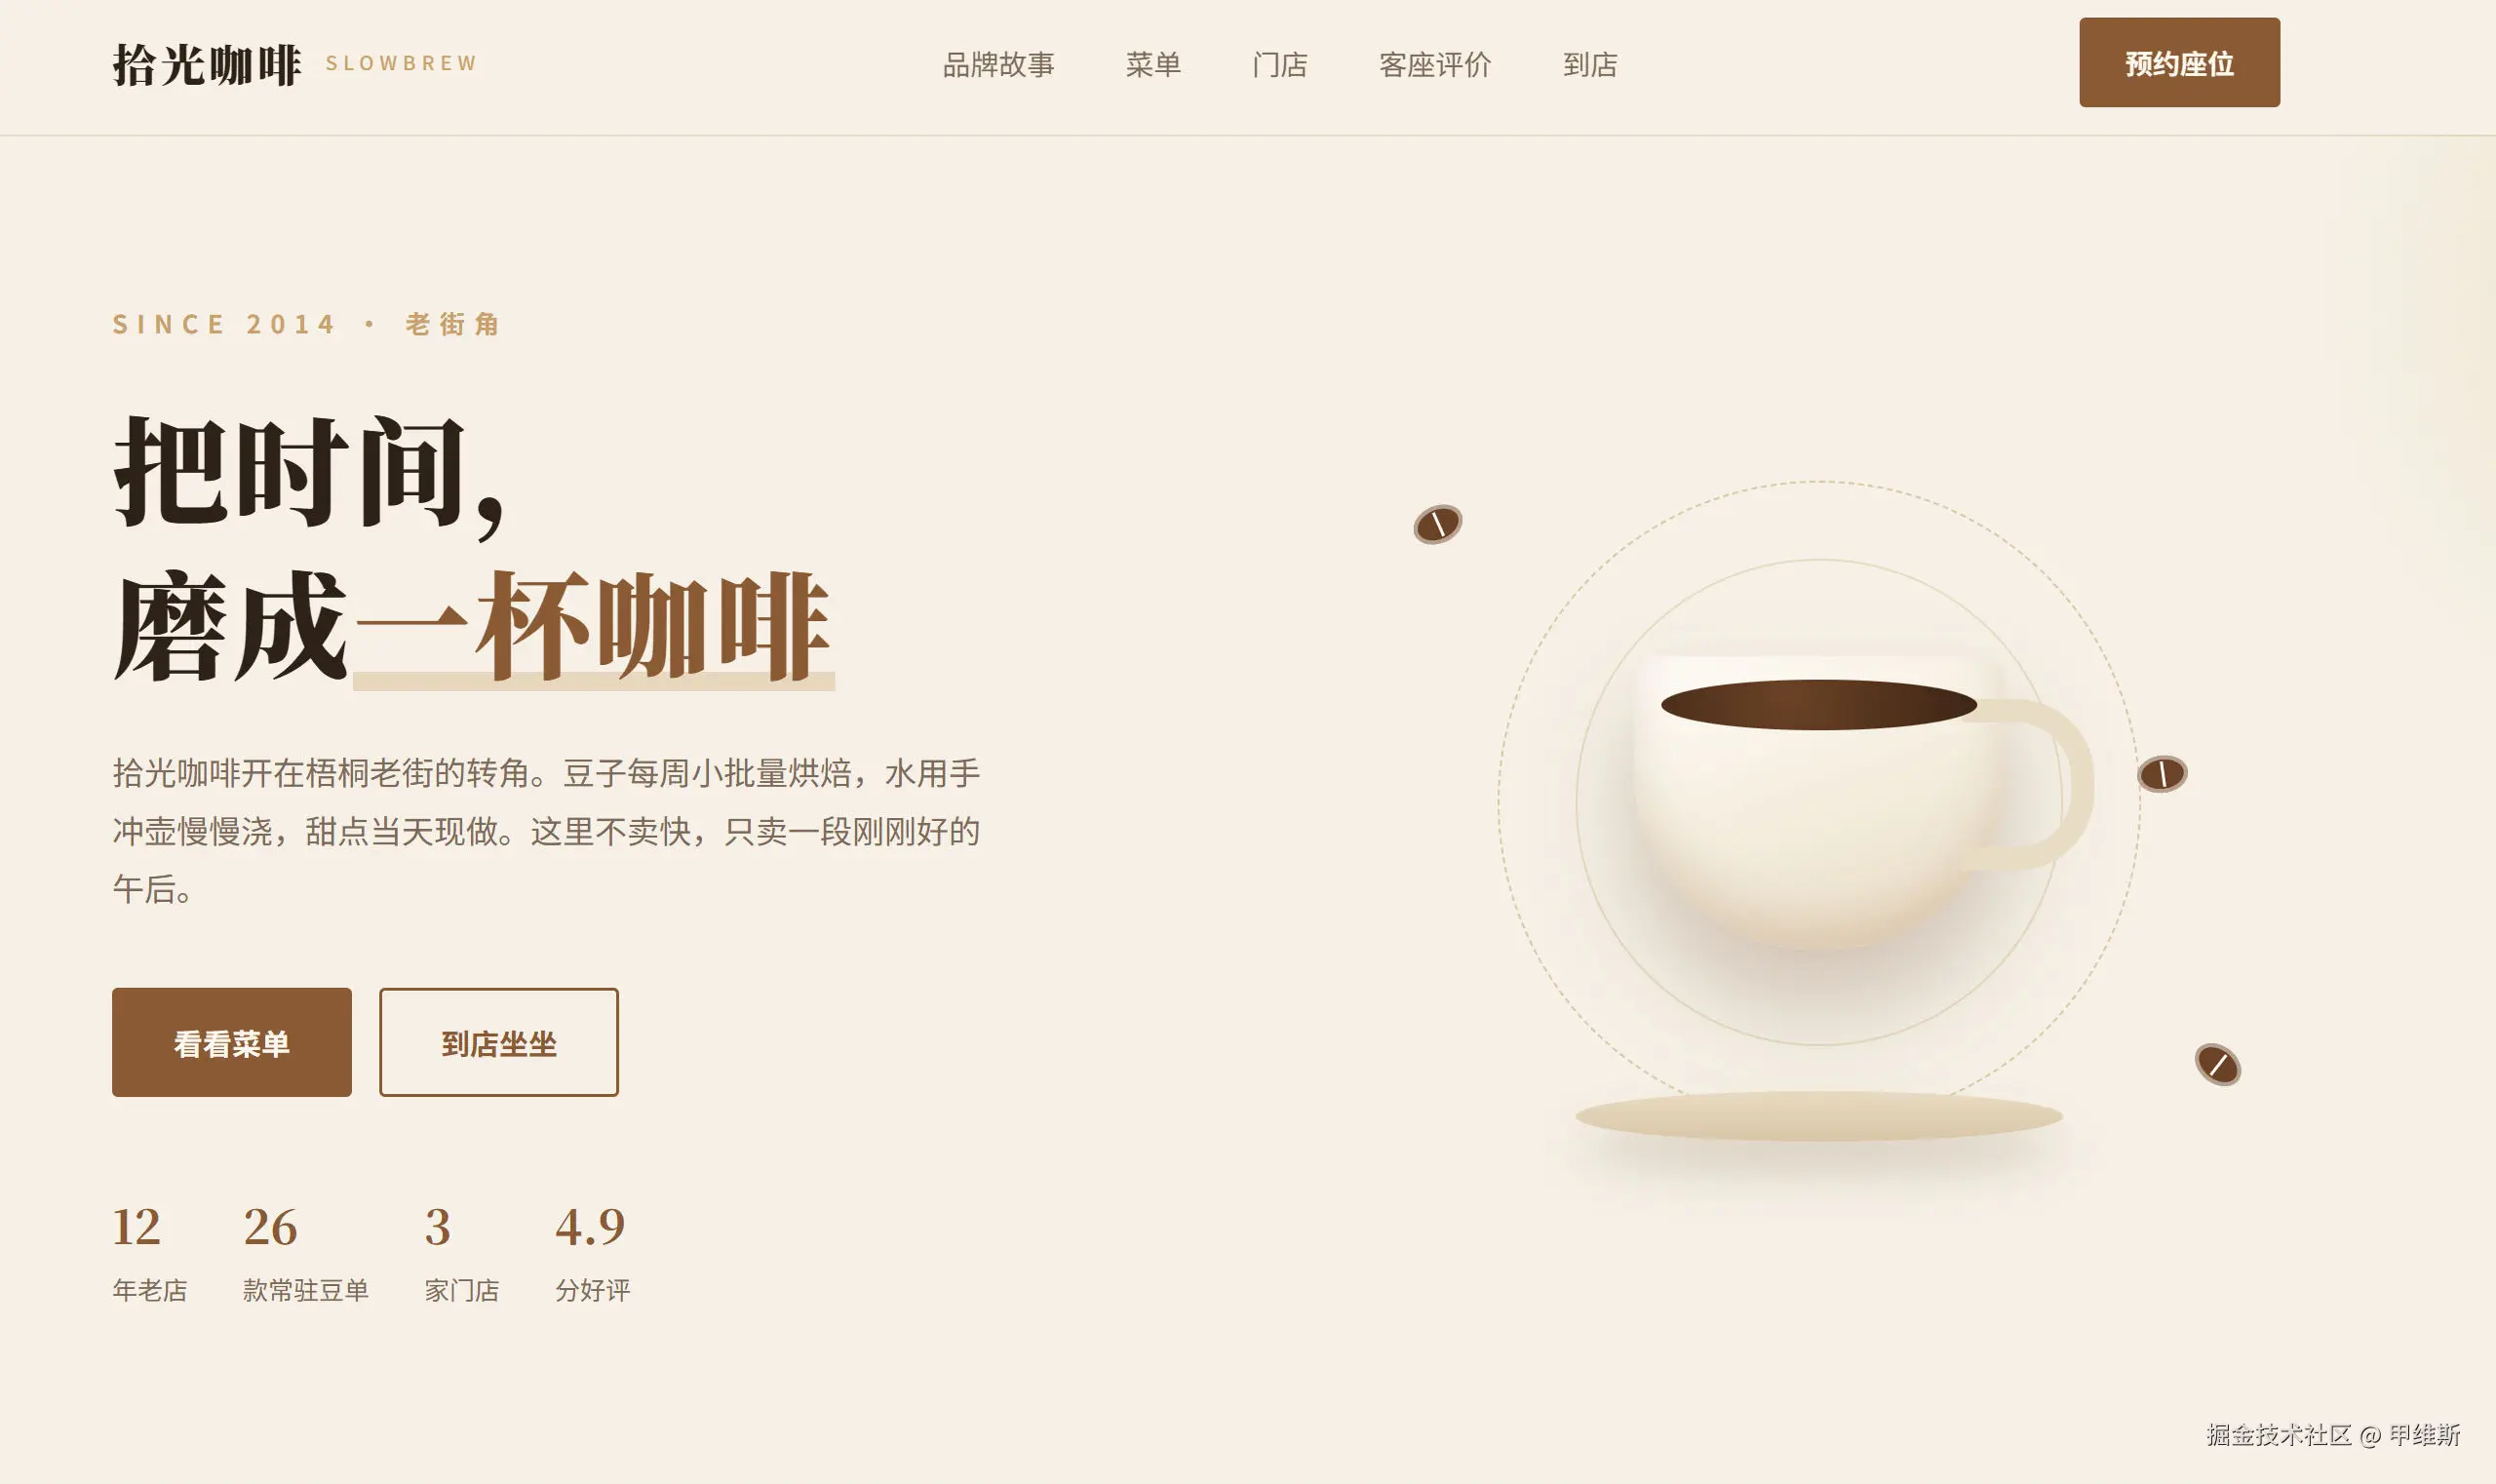
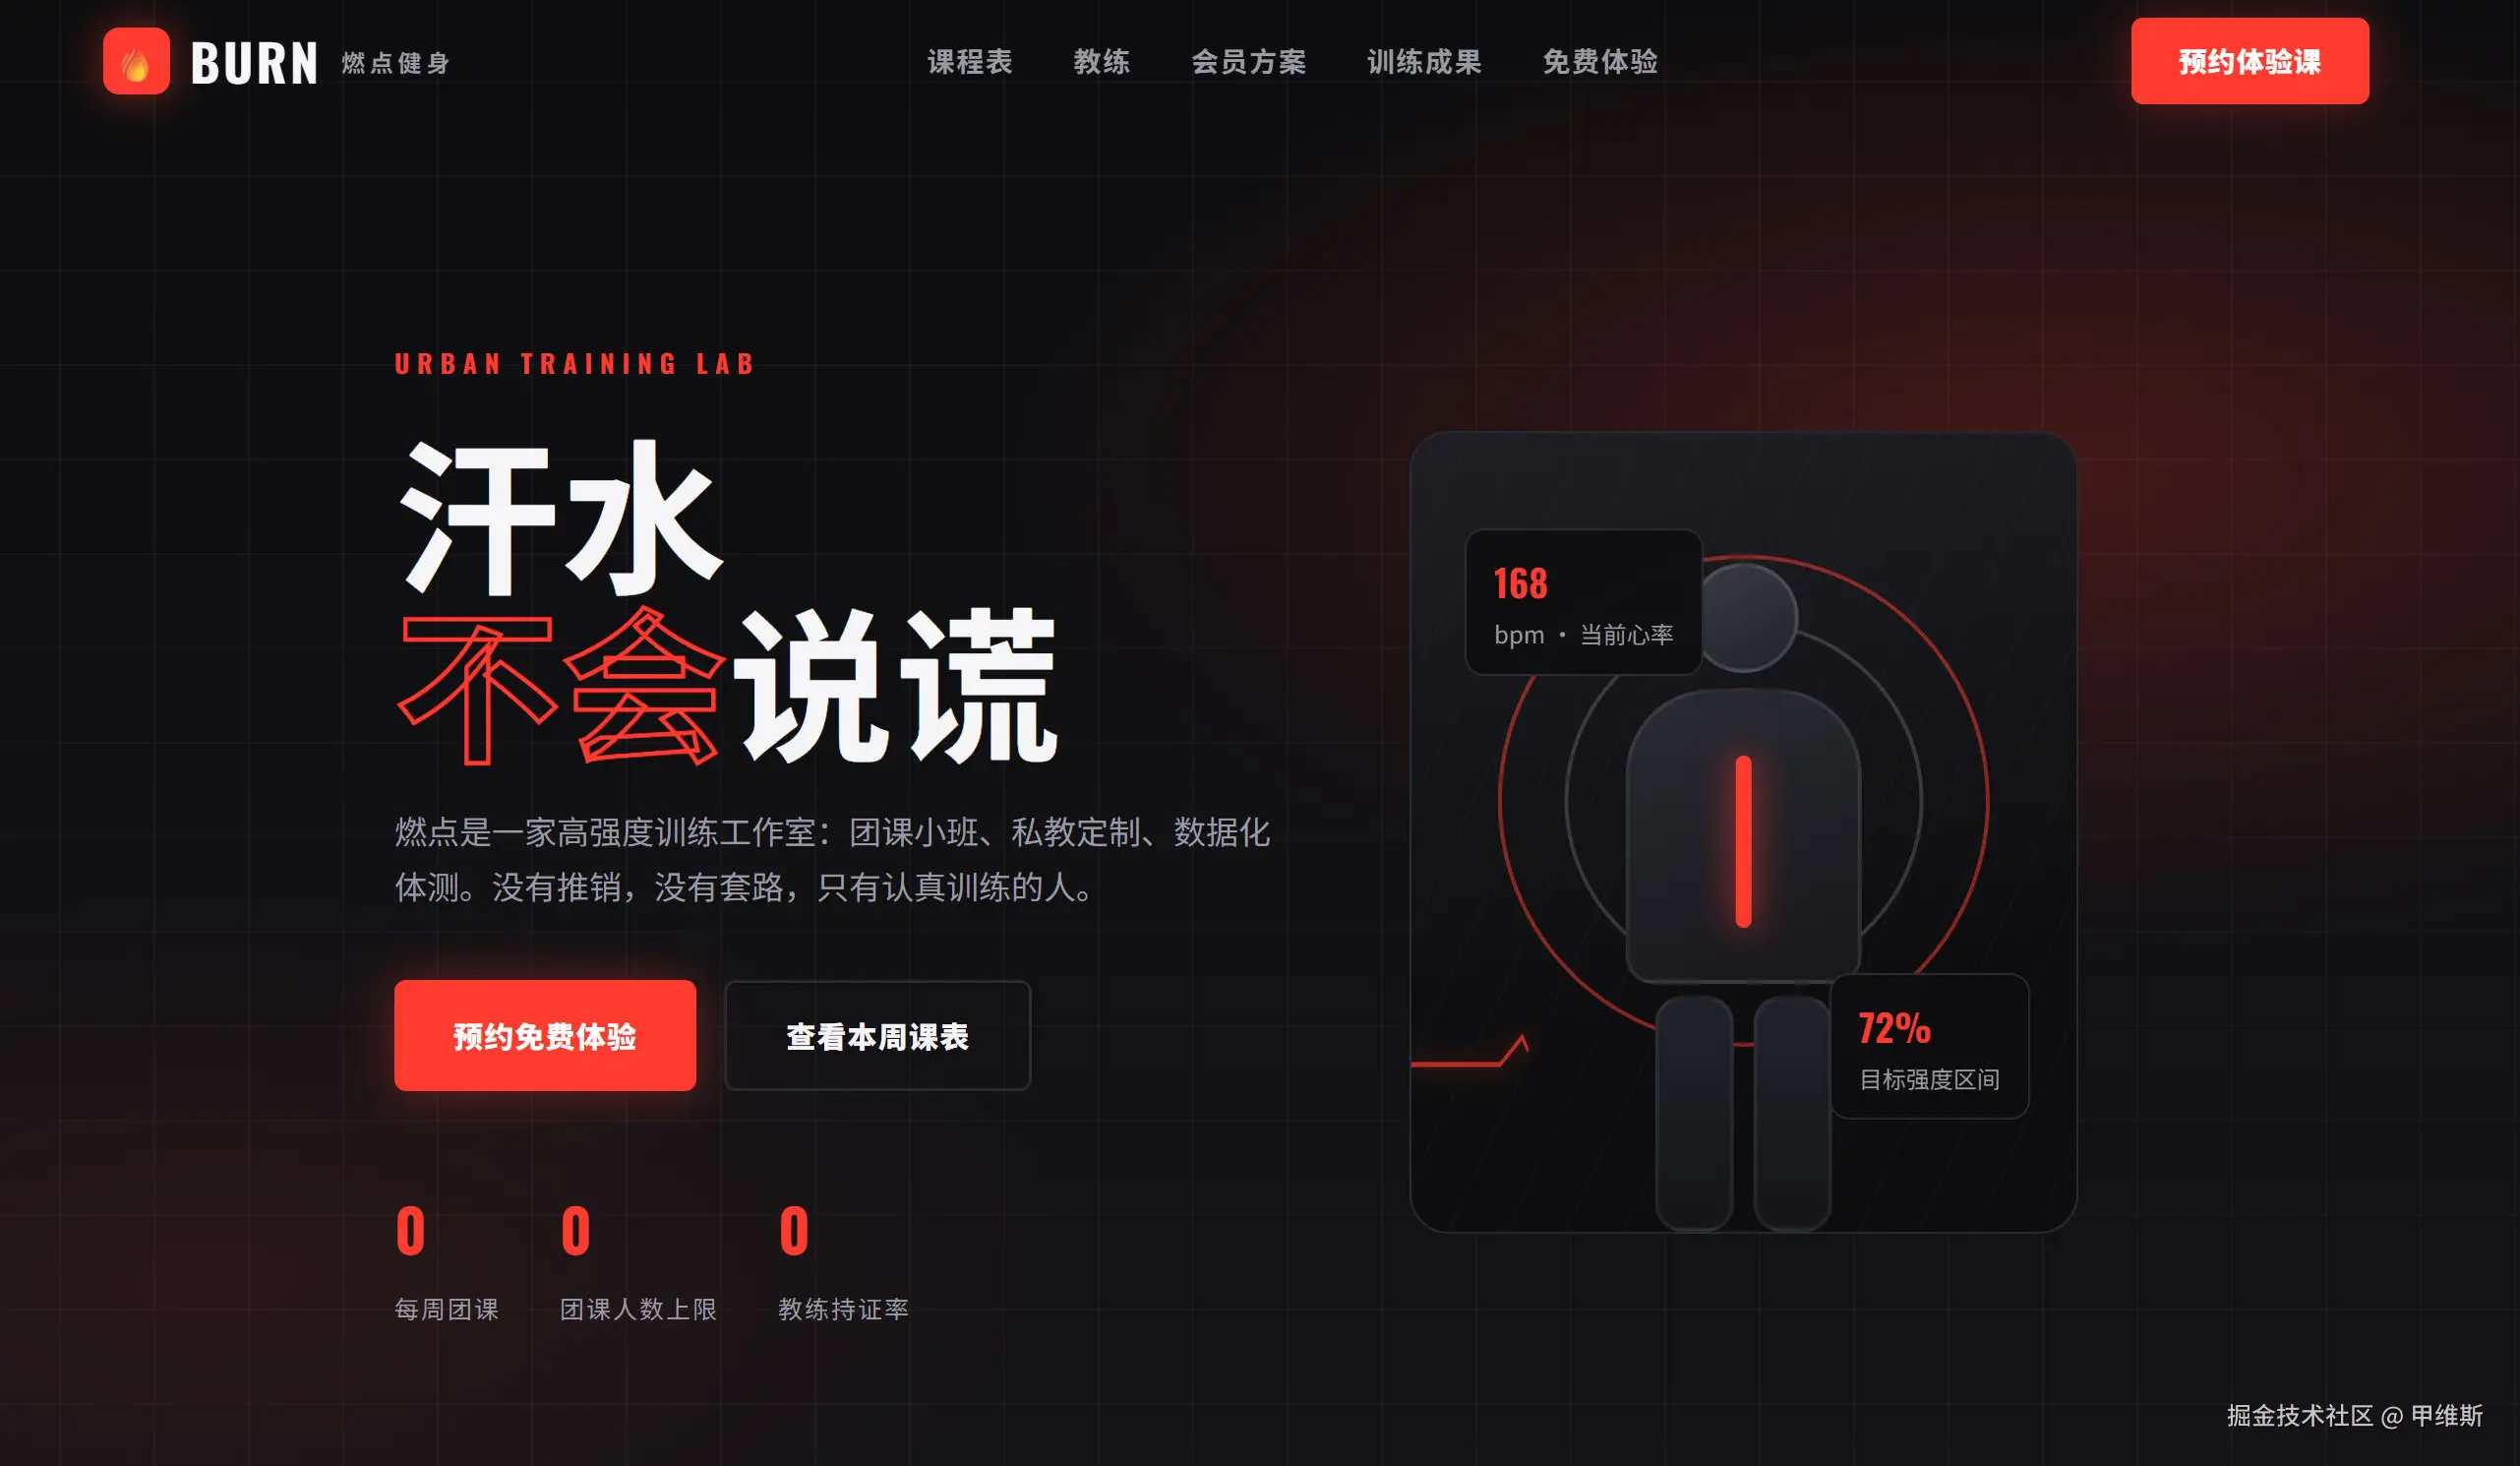
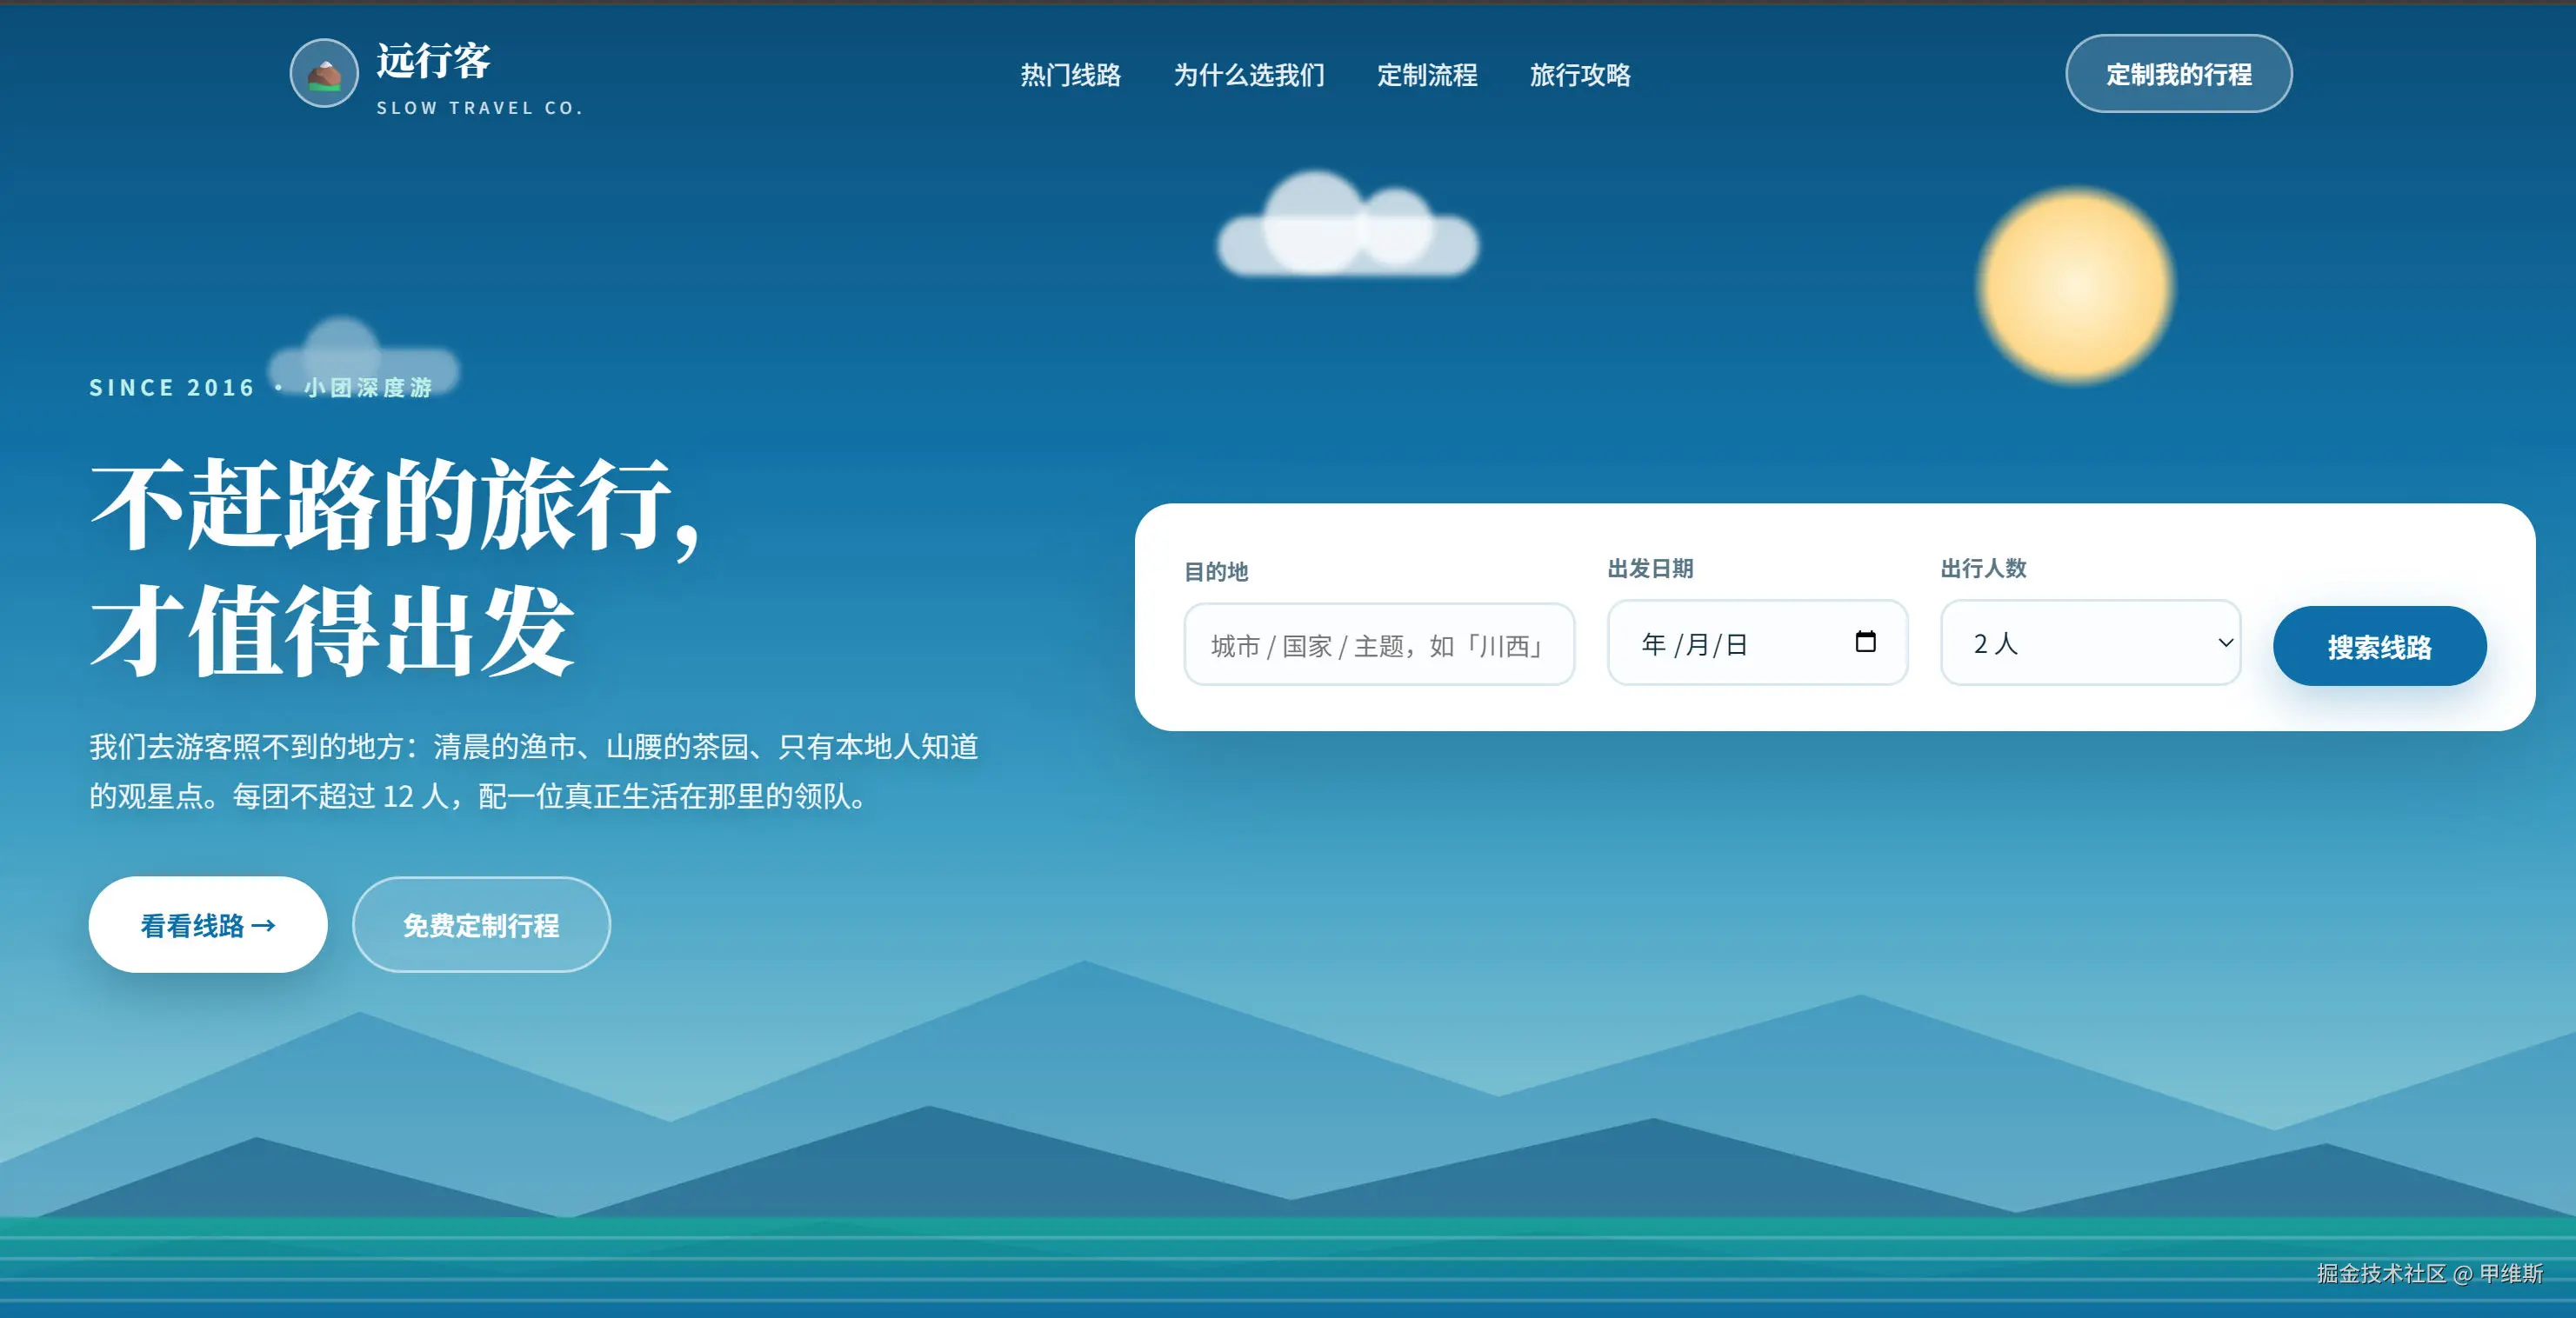
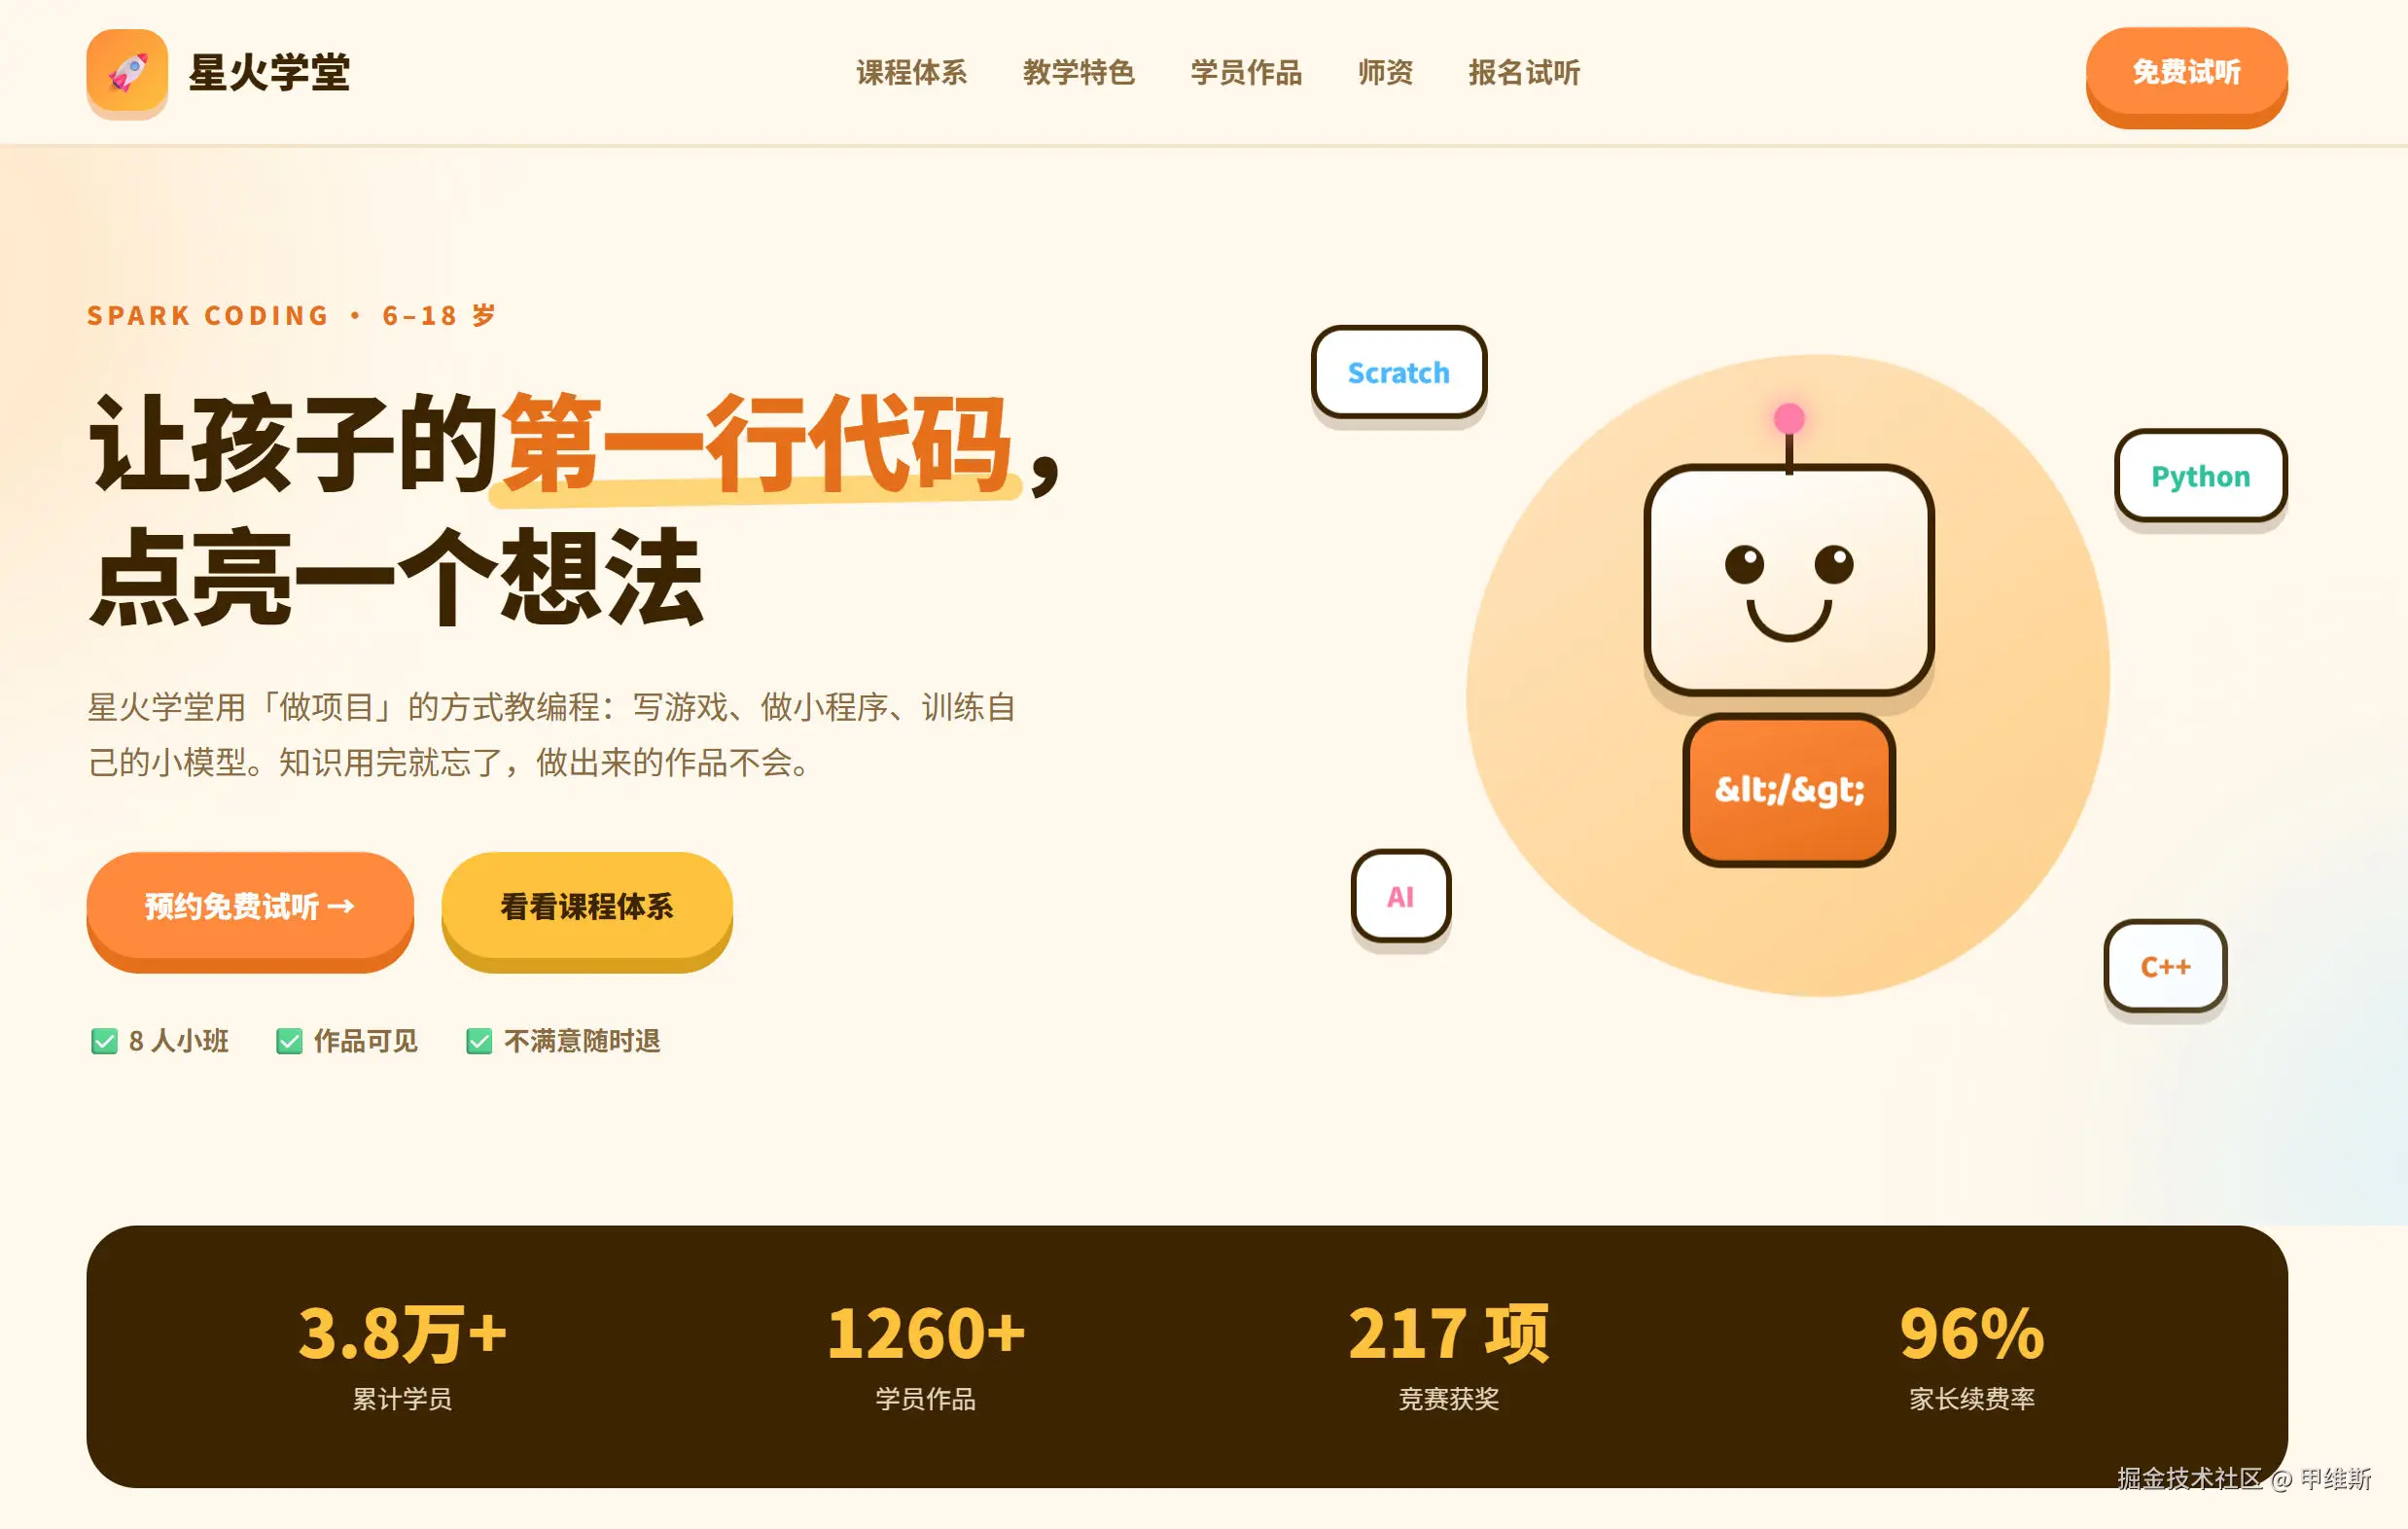
当然,这个东西是比较主观的。
不同行业的人会有不同的要求。我觉得好的,人家可能觉得差。我觉得差的,人家觉得好。有人就喜欢土的,有人就喜欢特别的。
所以具体的还是大家自己去看,我会把所有模板都上传。有需要的可以直接拿去用!
我发现所有模型都会做"咖啡馆"、"健身房"、"建筑师"、"民宿"、"少儿编程"这几个模板......哈哈!
我还是做个简单的总结吧:
如果 Opus 和 Astra 是跑车的话,Step5 这类有点"老头乐"的感觉! 能用、实用,但是不适合追求极致性能和效率的人。
它们确实做到了"长程任务",有一定的自主解决问题的能力,但是长程任务本质是短时间做不完才要长时间做,如果同样一个事情,有人10 分钟,有人1小时。那比的就不应该长,而是短。
如果和 GLM5.3、K3、Qwen3.8 比,确实也有来有回,我也很难说出,它们谁在某个地方特别出众。
K3 还是设计和多模态、3D 建模比较牛吧,也慢。
GLM5.3 整体稳定性比较高(无多模态),也慢。
Qwen3.8 基准无敌,但是我测了好几个例子效果不及预期,也慢。
Step 是特别慢!
除了时间太长这个槽点外,Step 整体来说高于我的"预期"!
我的这些例子,老粉都很熟悉了!
提示词、评判标准,还有几十个其它模型的结果全都放在一起了。