AI Agent 的 Skill 写了一堆,但不知道哪些真的好用?测试全靠手动,每次改一点就要重新跑一遍?skill-up 是阿里巴巴开源的 AI Agent Skill 评估和进化工具,它把"评估"和"进化"两个环节打通,让 Skill 能自动修复、自动迭代。
AI Agent Skills 的质量黑洞
开发过 AI Agent Skills 的人都知道一个痛点:你写了一个 Skill,感觉它"应该能用",但到底好不好用?怎么衡量?出了问题怎么修?
传统做法是手动测试:跑一遍,看结果,改 Skill,再跑一遍。这个循环耗时耗力,而且很难覆盖所有边界情况。更麻烦的是,当你的 Skill 越来越多,手动回归测试的成本会指数级增长。
skill-up 的出现就是为了解决这个问题:把评估变成代码,把进化变成自动化。
Github: github.com/alibaba/ski...
核心功能:评估 + 进化的双引擎
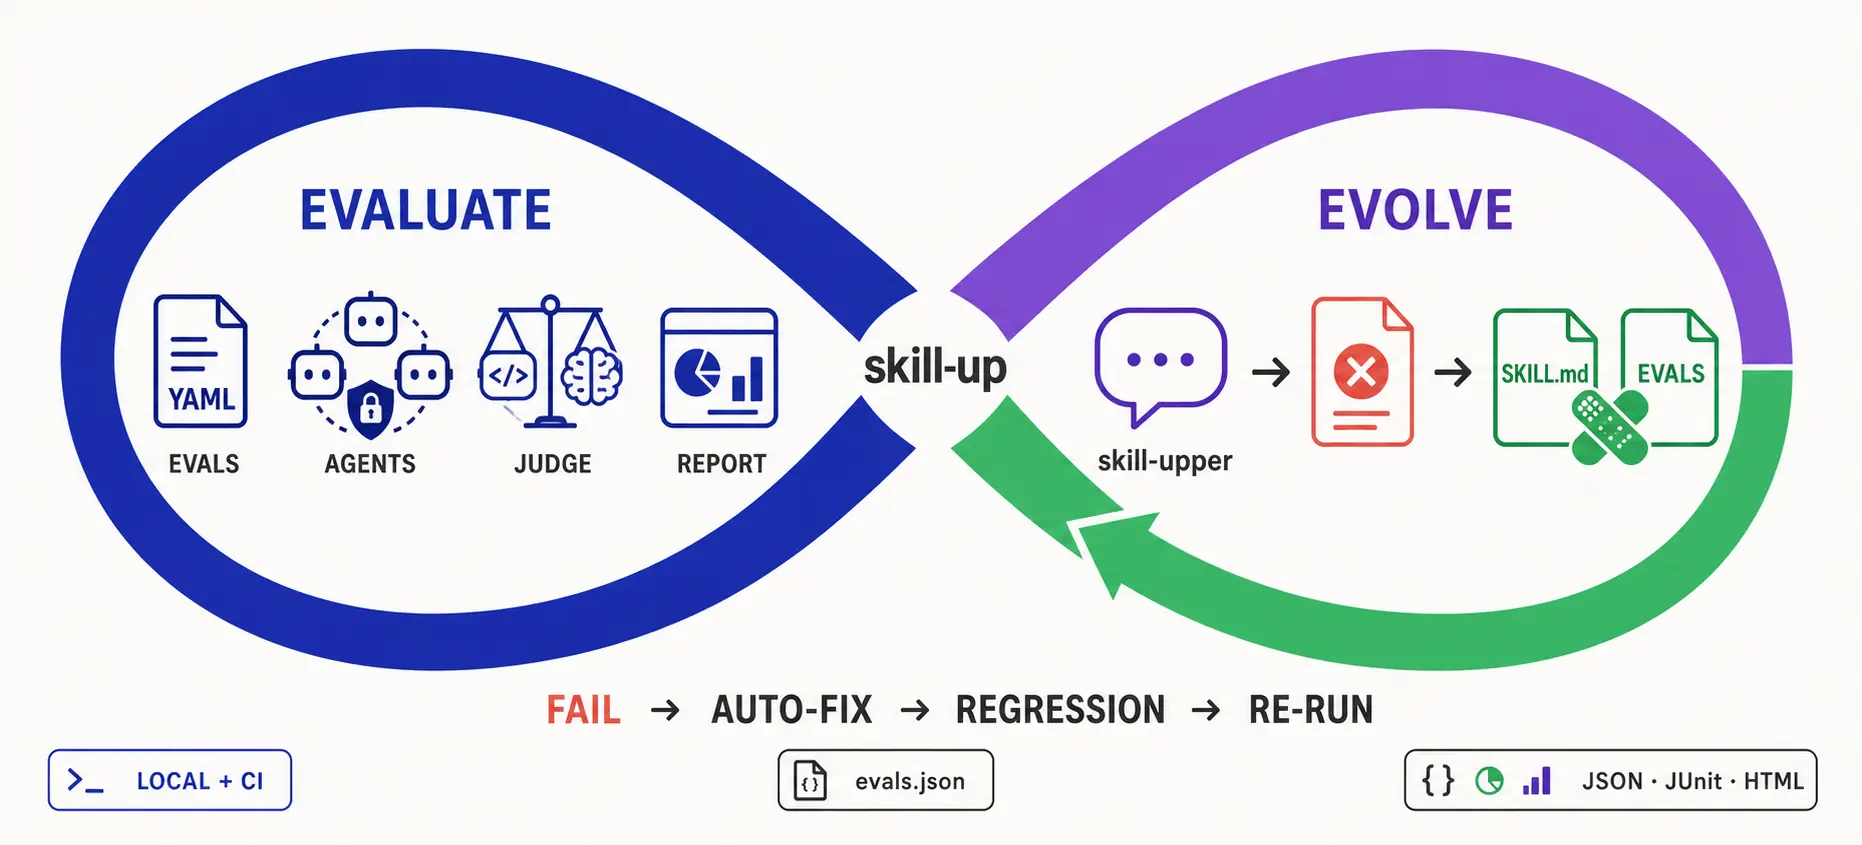
skill-up 的核心设计是把评估和进化两个环节打通,形成一个闭环:
| 功能模块 | 实现方式 | 效果 |
|---|---|---|
| 评估(Evaluation) | YAML 声明式配置 | 定义环境、引擎、模型、测试用例 |
| 进化(Evolution) | skill-upper 自动修复 | 诊断失败、修复 Skill、重新评估 |
| 多引擎支持 | Qoder CLI、Claude Code、Codex | 真实 Agent 环境下测试 |
| 灵活评判 | rule_based、script、agent_judge | 适配不同评估需求 |
| 结构化报告 | JSON、JUnit XML、HTML | CI/CD 集成友好 |
技术架构:YAML 驱动的评估体系
skill-up 的评估体系建立在两个核心概念上:eval.yaml(评估配置)和 case.yaml(测试用例)。
评估配置:eval.yaml
eval.yaml 是评估的入口配置,它声明了运行环境、Agent 引擎和模型、全局评分策略等。这种声明式设计让评估配置可读、可维护、可版本控制。
yaml
schema_version: v1alpha1

environment:
  type: none  # 普通文本 Skill 不需要隔离容器

engine:
  name: claude_code  # 使用 Claude Code 作为 Agent 引擎

cases:
  files:
    - evals/cases/hello-world.yaml
测试用例:case.yaml
case.yaml 定义了发送给 Agent 的提示词、期望输出和评分规则。这种结构化设计让测试用例清晰、可复用。
yaml
input:
  prompt: |
    Please generate a Hello World program

expect:
  must_contain:
    - "Hello"
    - "World"
  must_not_contain:
    - "error"
项目结构
skill-up 采用标准化的目录结构,让评估体系易于管理:
php
my-skill/
  SKILL.md              # Skill 定义文件
  evals/                # 评估根目录
    eval.yaml           # 入口配置
    cases/              # 测试用例
      basic-test.yaml
      edge-case.yaml
    fixtures/           # 可选测试资源
      repos/            # 仓库模板
      scripts/          # 评分脚本
创新亮点:skill-upper 的进化机制
skill-up 最让人眼前一亮的设计是 skill-upper------一个对话式的进化驱动器。它不是简单的测试工具,而是一个能主动诊断、修复、迭代的 AI Agent。
工作流程
skill-upper 的工作流程形成了一个完整的闭环:
- 创建评估:通过自然语言对话创建评估用例
- 运行评估:使用 skill-up 执行评估
- 诊断失败:分析失败原因,定位问题
- 修复 Skill:自动修复或扩展 Skill 代码
- 重新评估:再次运行评估,验证修复效果
- 迭代优化:持续循环,直到评估通过
这种"评估 → 诊断 → 修复 → 重新评估"的循环让 Skill 的进化变成了一个可重复的过程,而不是一次性修补。
自动化修复
当评估失败时,skill-upper 会自动分析失败原因,并尝试修复 Skill 代码或测试用例。这种自动化修复大大减少了人工干预的成本,让开发者可以专注于更高层次的设计决策。
兼容性:与 Anthropic 生态的无缝对接
skill-up 在设计上充分考虑了与 Anthropic 生态的兼容性:
- 导入支持 :可以通过
skill-up import导入 Anthropic 的 evals.json - 自动检测 :使用
--auto参数自动检测现有评估配置 - 输出格式:生成 Anthropic 兼容的 grading.json 和 benchmark.json
这种兼容性让已有的 Anthropic 生态用户可以平滑迁移到 skill-up,降低了采用门槛。
适用场景
| 场景 | 适合度 | 说明 |
|---|---|---|
| Skill 开发者 | ⭐⭐⭐⭐⭐ | 核心目标用户,需要持续评估和迭代 Skill |
| AI Agent 团队 | ⭐⭐⭐⭐⭐ | 团队协作开发 Skill 时的质量保障 |
| CI/CD 集成 | ⭐⭐⭐⭐ | 自动化测试和回归验证 |
| Skill 质量审计 | ⭐⭐⭐⭐ | 第三方评估 Skill 质量 |
| 教育研究 | ⭐⭐⭐ | 研究 Agent Skills 的评估方法论 |
局限性与挑战
1. 学习曲线
虽然 skill-up 采用了声明式配置,但对于不熟悉 YAML 和评估体系的开发者来说,仍然需要一定的学习成本。特别是评估策略的选择和配置,需要对 Agent Skills 有深入理解。
2. 引擎依赖
skill-up 的评估依赖于真实的 Agent 引擎(Claude Code、Codex、Qoder CLI)。如果这些引擎的 API 或行为发生变化,可能会影响评估结果的稳定性。
3. 评估覆盖度
自动化的评估很难覆盖所有边界情况。特别是对于需要复杂上下文理解的 Skill,自动评估可能无法完全替代人工评审。
Github: github.com/alibaba/ski...
总结
skill-up 解决了一个 AI Agent 开发中的核心问题:如何系统化地评估和改进 Skill 质量。通过"评估 + 进化"的双引擎设计,它把原本依赖人工的测试循环变成了可自动化、可重复、可扩展的工程流程。
如果你正在开发 AI Agent Skills,或者团队在协作构建 Skill 库,skill-up 值得认真考虑。它不仅能帮你发现 Skill 的问题,还能帮你自动修复这些问题,让 Skill 的进化变成一个持续的过程。
关注
如果这篇文章对你有启发,欢迎关注我们,获取更多技术产品的深度分析和开源项目的创意拆解。