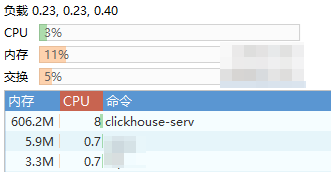
Clickhouse版本21.7.5.29,问题现象:长久占用CPU一直在100%以上,如下所示:
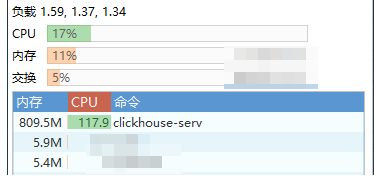
使用Hermes智能体连接上服务器分析,结论如下:
1. ClickHouse 错误日志(800MB!)
clickhouse-server.err.log 818 MB ← 当前活跃
err.log.0.gz 43 MB ← 2026-09-20 02:27
err.log.1.gz 43 MB
err.log.2-8.gz 每天 40+ MB
err.log 有 800MB + 9 个 40MB+ 历史文件 = 每天产生 ~50MB error 日志!
2. 重复错误 - Mutation 卡住
Cannot convert NULL value to non-Nullable type:
FUNCTION CAST(sourceKey :: 7, 'String' :: 9) -> CAST(sourceKey, 'String') String : 8
(while reading from part /var/lib/clickhouse/store/...)
DB::MergeTreeDataMergerMutator::mutateSomePartColumns
DB::StorageMergeTree::mutateSelectedPart
这是 ALTER ... DELETE/UPDATE mutation 操作 → 持续失败 → 持续重试 → 死循环!
3. 后台 thread top 1 = BgSchPool (Schedule Pool)
98798479 CPU ticks tid=24346 cmd=BgSchPool/DBgSchPool = ClickHouse 后台调度池,专门跑 mutation / merge / 复制。它持续在跑,但因为 mutation 一直失败,不断重试同一个失败任务。
4. stack trace 显示 mutation 卡在 part /var/lib/clickhouse/store/0e7/...
某个表的某个 part 数据有 NULL 字段 --- 但表 schema 不允许 NULL → mutation 100% 失败 → 重试 → 死循环
可选的修复方案(按风险递增)
方案 A: 看 mutation queue(最低风险)
SELECT * FROM system.mutations WHERE is_done = 0;智能体推荐了四种方案,我选择了A方案,执行结果如下:
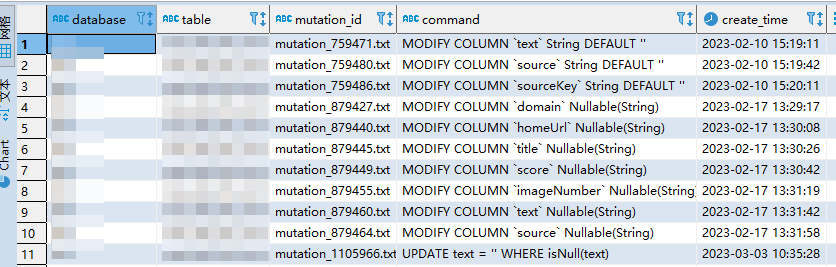
确实有很多。
让智能体自己修复,捣鼓了半天,没有修复成功,但是给出了建议,
发现 2022 年的坏 part 反复重试 → 物理删除它:
ALTER TABLE xx.xx_info_old DROP PARTITION 202212;执行删除了,CPU负载降下来了,然后清理了MUTATION文件:
KILL MUTATION WHERE mutation_id = 'xxx';(第一见这种直接KILL的SQL语句)