【Python】从零开始做一个重复文件查找工具------找出改名副本,生成核对报告
下载目录里同时放着"合同.pdf""合同(1).pdf"和"合同最终版.pdf",靠名称很难判断它们是不是同一份内容。按大小排序,也只能发现看起来相似的文件。一旦把项目素材、工作文件和备份混在一起,直接点"清理"又会担心删错。这个小项目从读取一个文件开始,逐步实现目录扫描、内容比较与报告导出。完成后,你可以给它一个目录,拿到重复组、完整路径和逻辑冗余字节数;整个程序只读取源文件,适合作为第一个能长期使用的 Python 命令行工具。
1. 要找的是内容副本,名字只是线索
先约定"重复"的含义:本文只识别字节内容完全相同的普通文件。同一张照片经过压缩、重新保存或修改拍摄信息,哪怕肉眼看不出差别,也可能不属于这个范围;两个文档只是意思接近,同样不会合并。这种定义看起来严格,却使结果容易验证,也让第一版的工程边界清楚。
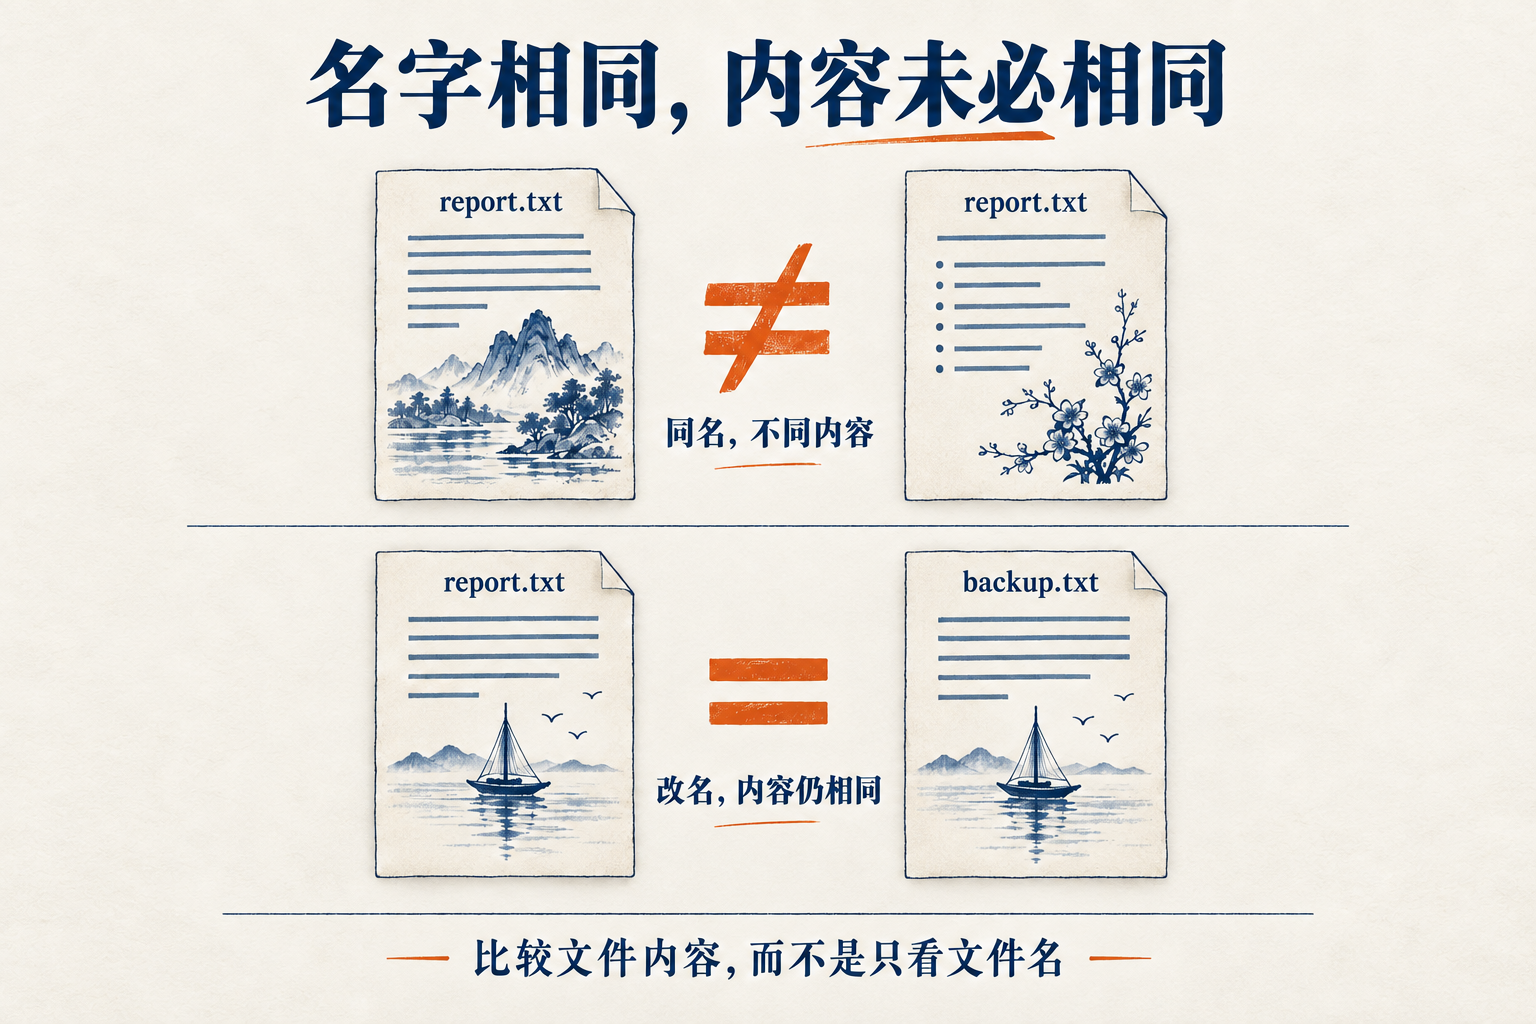
名称和扩展名都不参与最终判定。两个不同目录下的 report.txt 可能分别记录两个季度;一个文件改名成 backup.txt 后,字节内容完全没有变化。程序必须既能排除前者,也能识别后者。如果测试数据只有两个同名副本,错误的"按文件名分组"程序同样会通过,所以测试集需要刻意放入反例。
项目使用 Python 3.12 或更新版本,不需要安装第三方包。选择这个版本下限,是因为完整代码使用了 Path.is_junction 来识别 Windows 目录连接。本次实际运行环境为 Windows 11、Python 3.13.1。示例对本地、停止写入的个人目录设计;对持续写入的共享盘或需要严格一致性的业务存储,应另外使用快照机制。
准备一个空练习目录,把文末完整代码保存成 dupes.py。Windows 可以执行 py -3 --version 确认解释器;其他系统用对应的 python3 --version。先拿少量自己复制的文件试跑,看到报告字段与结果都能解释后,再扩大扫描范围。本文提供的自动实验只处理临时生成的文件,不扫描你的真实下载目录。
2. 从十几行代码开始:给文件计算摘要
读取文件时使用二进制模式。PDF、图片、压缩包不一定是文本;即使是文本,也可能使用不同编码或换行符。先按某种编码解码,再把内容拼回字符串,会无意间改变我们正在比较的对象。二进制读取把任务固定为同一串字节,解释起来更直接。
下面的函数可以独立运行。把同一个文件复制一份并改名,分别传入函数,两次输出应相同;修改其中任意一个字节后,输出通常会变化。
python
import hashlib
from pathlib import Path

def fingerprint(path, block=1024 * 1024):
    h = hashlib.sha256()
    with Path(path).open('rb') as f:
        while chunk := f.read(block):
            h.update(chunk)
    return h.hexdigest()

# print(fingerprint('sample.txt'))
关键是每次读取一块,并持续更新同一个摘要对象。连续 update 的结果对应这些块按顺序连接后的内容;循环结束再取十六进制摘要。块大小改变,不应改变最终摘要。如果把每个块的十六进制摘要直接连接起来,得到的就不是同一个算法结果。
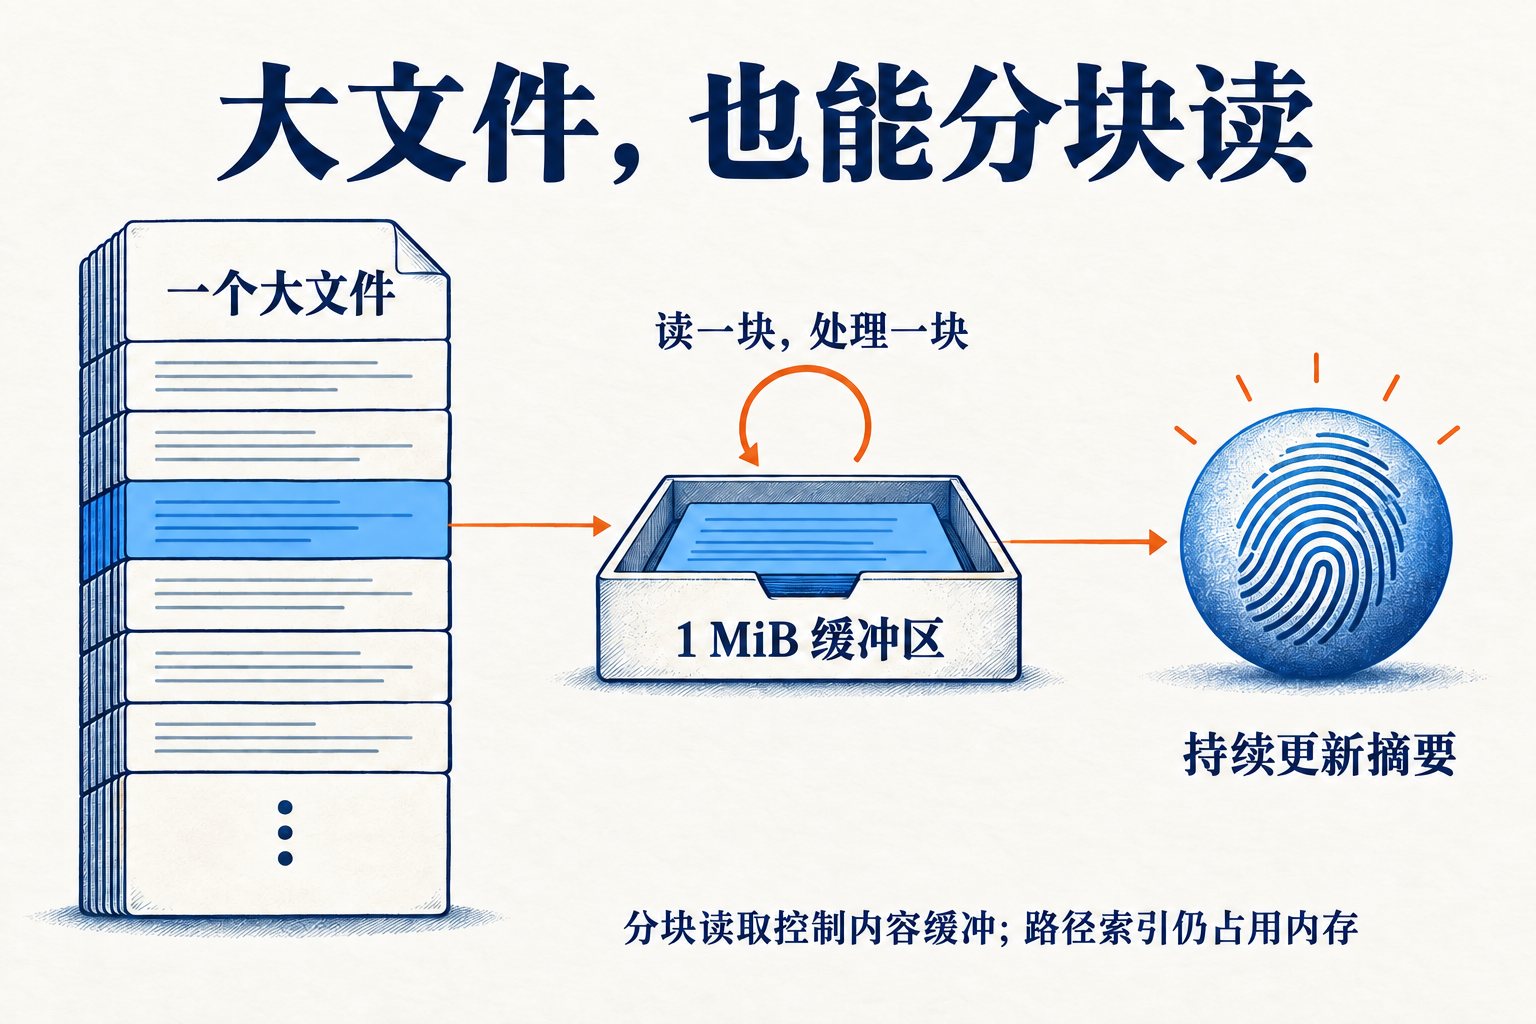
这里的默认块为一 MiB,表示每轮读取的量,不表示整个进程只用一 MiB 内存。字节比较时会同时持有两个块,扫描器还保存路径、元数据、分组和错误记录。分块读取解决的是单个大文件不需要整体进入内存;文件数量特别多时,路径索引仍然可能成为内存的主要来源。
哈希相同也不作为本文最终确认条件。摘要把任意长度的输入压缩到固定长度,不能从数学上承诺绝无碰撞。实际工程中可以用摘要迅速缩小范围,再对同一摘要组逐块比较字节。这样即使测试里故意让所有文件返回同一个假摘要,内容不同的文件仍然不会被判为重复。
3. 加上目录遍历:三轮筛选比两两比较划算
最直观的写法是让每个文件与其余所有文件比较。当文件数量增加,两两配对的数量会快速增长,而且很多比较一开始就没有必要。例如一个五字节文件和一个十七字节文件,不可能字节完全一致,连打开它们都可以省略。
第一轮只收集普通文件的大小,把相同大小的路径放入同一个桶。只有一个成员的桶直接跳过。第二轮读取剩余候选的完整内容,按大小与 SHA-256 摘要继续分组。第三轮在同摘要组内挑代表文件做分块字节比较,只有确认相同的路径才进入最终重复组。
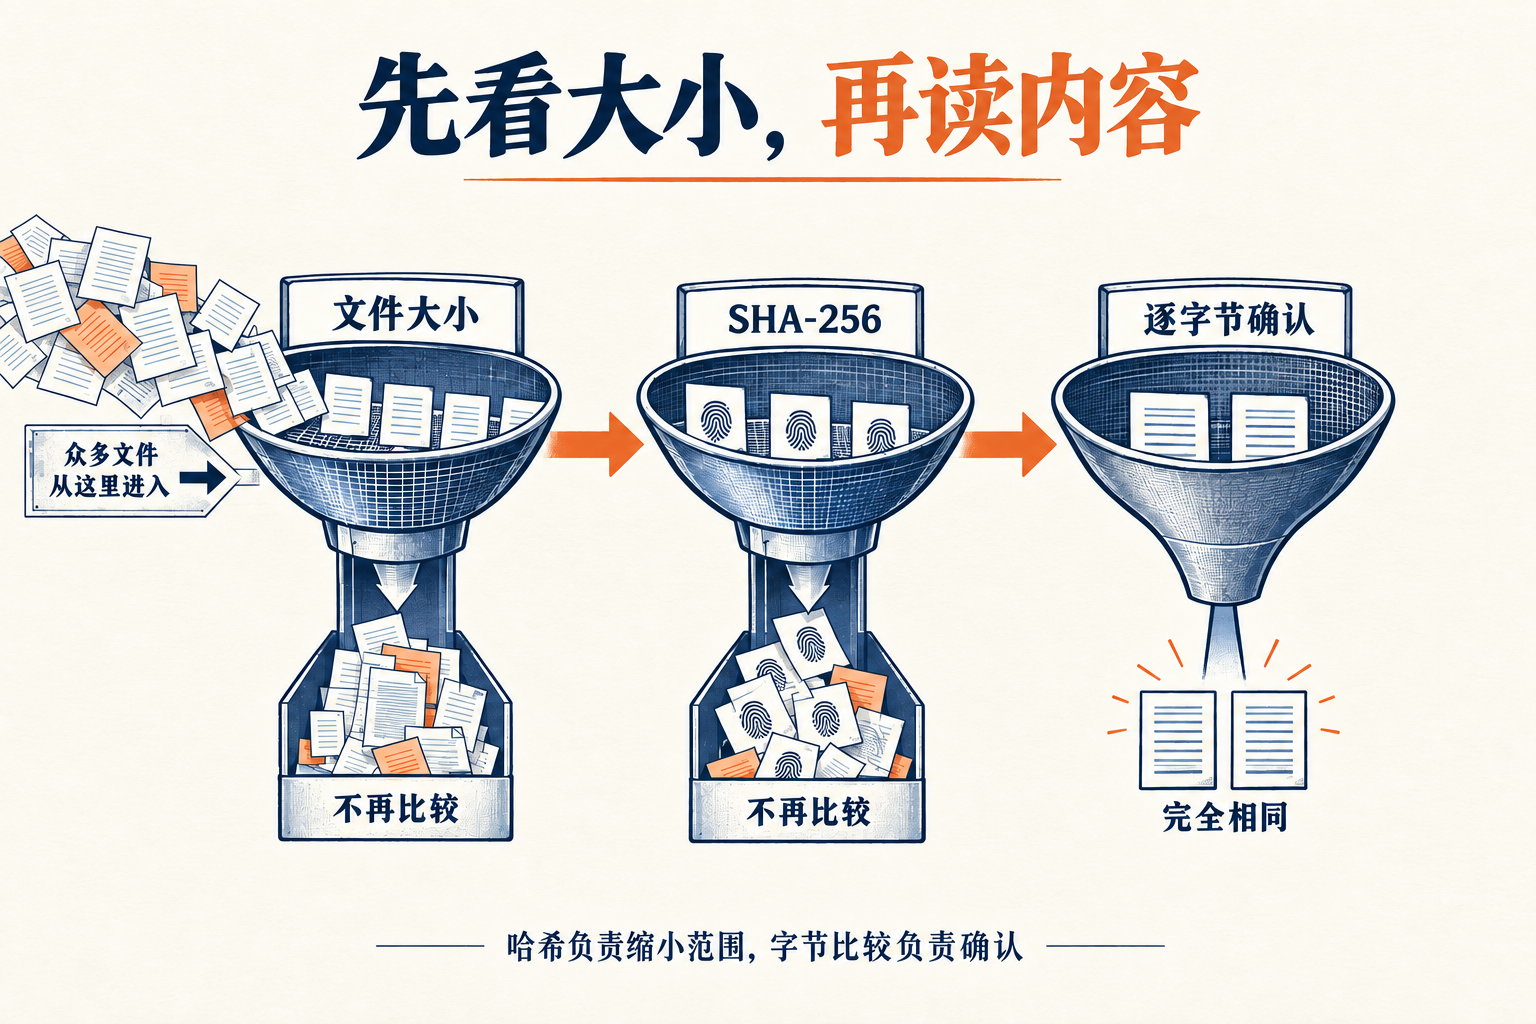
完整代码用 os.walk 枚举目录,用 defaultdict 保存桶。排序目录与文件名是为了让同一个静态样本的输出容易对比,不表示排序靠前的文件就是应该保留的原件。单成员桶不会读取正文,因此在尺寸差异明显的资料目录中,大小筛选能减少不必要的读取;如果整个目录的文件都一样大,这一轮几乎省不了工作。
候选组的统计也要讲清楚。程序中的 hashed_bytes 只累计成功完成摘要的文件逻辑长度,不包含最后逐字节确认的再次读取,也不是操作系统实际从磁盘读取的字节数。缓存、文件系统压缩和预读都会改变实际物理读量。要评价性能,至少需要区分枚举、哈希、字节比较三段时间,不能只看到候选少了,就写"速度提高十倍"。
先保持单线程,块大小默认一 MiB,最小文件大小默认一字节。若主要关注大视频,可以把 min-bytes 调高,让大量小文件在进入内容读取前退出;若关注重复配置或文本,就继续用默认值。机械硬盘上盲目增加并发可能增加寻道,网络盘则还受延迟和远端限流影响。参数应围绕数据分布和设备选择。
4. 路径会骗人:硬链接、空文件和正在变化的内容
两个路径不一定对应两份物理数据。硬链接可以让多个目录项指向同一个文件对象,如果直接按照路径数量乘文件大小,就可能把同一份存储重复计算。示例以设备标识与文件标识组成身份键;发现相同身份时,将后续路径写进 skipped,并标为 hardlink_alias。
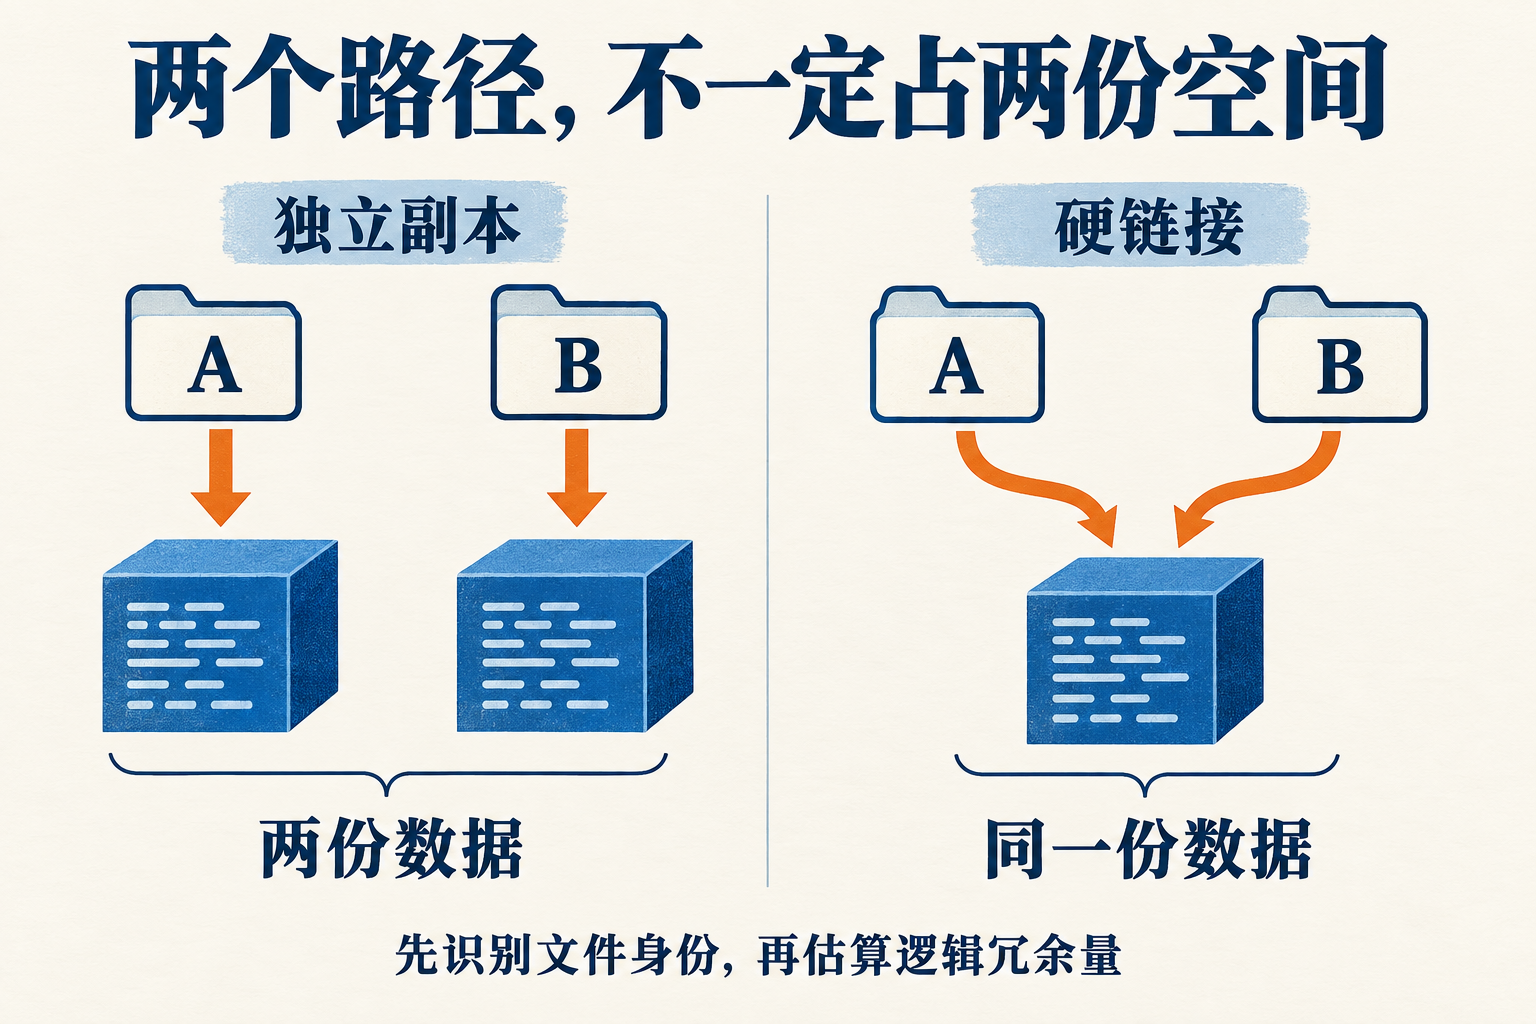
本次硬链接用例在本机实际通过。文件身份字段为零或底层文件系统不提供可靠身份时,这个办法有局限,代码会避免把所有零标识文件误合并,但不能据此声称识别了所有共享存储关系。压缩、稀疏文件、写时复制和文件系统自身去重,也都会让逻辑长度与物理占用不同。
因此报告采用"逻辑冗余字节数"这个名称。某组有三份独立副本,每份一千字节,在保留一份的假设下,逻辑冗余量是两千字节。它不等于执行删除以后一定释放两千字节,更不包含业务是否允许移除某份备份的判断。程序只算字节关系,把保留哪条路径留给读者根据用途决定。
空文件默认跳过,因为所有空文件内容都相同,列出几百个空占位文件通常没什么整理价值。若需要检查它们,可以设 --min-bytes 0;即使输出空文件重复组,冗余量仍然是零。符号链接和目录连接则跳过,防止把另一处目录带入预期之外的扫描范围。当前机器创建符号链接所需权限不足,这个集成用例记录为未完成,不算进通过项。
文件还可能在扫描时变化。程序先记录身份、大小和纳秒修改时间,打开后核对句柄身份,读取结束再核对一次,最终输出组之前重新检查路径。发现变化就记录错误,排除不可靠结果。这能发现常见写入竞争,却不提供原子快照:文件被改动后恢复原大小与时间等情况仍可能逃过检查。因此请对停止写入的数据运行它,不能把报告当作数据库事务里的稳定快照。
文件系统 扫描器 文件系统 扫描器 #mermaid-svg-egA2F1DWRaXZg0oI{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-egA2F1DWRaXZg0oI .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-egA2F1DWRaXZg0oI .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-egA2F1DWRaXZg0oI .error-icon{fill:#552222;}#mermaid-svg-egA2F1DWRaXZg0oI .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-egA2F1DWRaXZg0oI .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-egA2F1DWRaXZg0oI .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-egA2F1DWRaXZg0oI .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-egA2F1DWRaXZg0oI .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-egA2F1DWRaXZg0oI .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-egA2F1DWRaXZg0oI .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-egA2F1DWRaXZg0oI .marker{fill:#333333;stroke:#333333;}#mermaid-svg-egA2F1DWRaXZg0oI .marker.cross{stroke:#333333;}#mermaid-svg-egA2F1DWRaXZg0oI svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-egA2F1DWRaXZg0oI p{margin:0;}#mermaid-svg-egA2F1DWRaXZg0oI .actor{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-egA2F1DWRaXZg0oI text.actor>tspan{fill:black;stroke:none;}#mermaid-svg-egA2F1DWRaXZg0oI .actor-line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-egA2F1DWRaXZg0oI .innerArc{stroke-width:1.5;stroke-dasharray:none;}#mermaid-svg-egA2F1DWRaXZg0oI .messageLine0{stroke-width:1.5;stroke-dasharray:none;stroke:#333;}#mermaid-svg-egA2F1DWRaXZg0oI .messageLine1{stroke-width:1.5;stroke-dasharray:2,2;stroke:#333;}#mermaid-svg-egA2F1DWRaXZg0oI #arrowhead path{fill:#333;stroke:#333;}#mermaid-svg-egA2F1DWRaXZg0oI .sequenceNumber{fill:white;}#mermaid-svg-egA2F1DWRaXZg0oI #sequencenumber{fill:#333;}#mermaid-svg-egA2F1DWRaXZg0oI #crosshead path{fill:#333;stroke:#333;}#mermaid-svg-egA2F1DWRaXZg0oI .messageText{fill:#333;stroke:none;}#mermaid-svg-egA2F1DWRaXZg0oI .labelBox{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-egA2F1DWRaXZg0oI .labelText,#mermaid-svg-egA2F1DWRaXZg0oI .labelText>tspan{fill:black;stroke:none;}#mermaid-svg-egA2F1DWRaXZg0oI .loopText,#mermaid-svg-egA2F1DWRaXZg0oI .loopText>tspan{fill:black;stroke:none;}#mermaid-svg-egA2F1DWRaXZg0oI .loopLine{stroke-width:2px;stroke-dasharray:2,2;stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-egA2F1DWRaXZg0oI .note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-egA2F1DWRaXZg0oI .noteText,#mermaid-svg-egA2F1DWRaXZg0oI .noteText>tspan{fill:black;stroke:none;}#mermaid-svg-egA2F1DWRaXZg0oI .activation0{fill:#f4f4f4;stroke:#666;}#mermaid-svg-egA2F1DWRaXZg0oI .activation1{fill:#f4f4f4;stroke:#666;}#mermaid-svg-egA2F1DWRaXZg0oI .activation2{fill:#f4f4f4;stroke:#666;}#mermaid-svg-egA2F1DWRaXZg0oI .actorPopupMenu{position:absolute;}#mermaid-svg-egA2F1DWRaXZg0oI .actorPopupMenuPanel{position:absolute;fill:#ECECFF;box-shadow:0px 8px 16px 0px rgba(0,0,0,0.2);filter:drop-shadow(3px 5px 2px rgb(0 0 0 / 0.4));}#mermaid-svg-egA2F1DWRaXZg0oI .actor-man line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-egA2F1DWRaXZg0oI .actor-man circle,#mermaid-svg-egA2F1DWRaXZg0oI line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;stroke-width:2px;}#mermaid-svg-egA2F1DWRaXZg0oI :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} alt 发现变化或读取失败 核对通过 记录文件身份、大小和修改时间 打开文件并核对身份 分块读取内容 再查元数据和路径 记录 errors,排除不可靠结果 继续分组与字节确认
实现时还遇到一个本机兼容问题:把 ctime 也放进路径与句柄的统一签名后,Windows 上某些静态文件被误判为变化。诊断输出显示两种查询的该字段值不同,最终签名使用身份、大小和 mtime。这个例子提醒我们,文件时间字段的具体含义与平台有关,多加一个字段未必让程序更可靠。
5. 跑完整工具:输出一份可以复核的报告
把完整代码保存后,选一个练习目录,在它外面指定新的报告路径。目录包含空格时用引号包住整个参数。示例命令如下,使用时将路径替换为你的练习位置。
powershell
py -3 dupes.py "D:\Demo\files" --out "D:\Demo\duplicates.json"运行结束会打印重复组数量、错误数量和报告位置。完整报告有 groups、errors、skipped 和 counters 四个主要部分:groups 保存经过字节确认的结果,errors 保存无法可靠处理的对象,skipped 解释主动排除的路径,counters 帮助判断工作主要发生在哪一步。
如果报告已经存在,程序拒绝覆盖;如果报告放在被扫描目录内部,程序也拒绝运行。前一条避免弄丢上一次核对记录,后一条防止下次扫描时把自己的输出当作输入。只打印到终端虽然代码更短,但无法清楚区分读取失败和没有重复,后续复核也不方便,所以这里保留结构化结果。
可以从报告中抽取一组检查:确认 size、路径数量以及每条完整路径是否符合你的样本。SHA-256 字段用于追踪本次内容摘要,路径列表只是排序后的成员,不自动指定原件。源目录有错误时程序仍输出其他成功结果,但返回退出码二;没有读取错误时返回零。需要接入批处理时,除了看报告,还要检查进程退出码。
内容比较不会上传到网络,报告也只写本地。不过报告里包含绝对路径,可能暴露项目名、用户名或客户文件名。把报告发到讨论区之前,应复制出必要的例子并隐去无关路径,而不是把整份磁盘目录清单直接公开。
6. 用七个文件检查:重复组到底是怎么来的
自动实验在临时目录创建七个普通文件。其中三个五字节文件分别是 ALPHA、ALPHA、OMEGA:前两份放在不同目录并使用不同名字,第三份与第一份同名但内容不同。再创建两份相同的一千零二十四字节二进制数据、一份十七字节的唯一文件和一个空文件。
预期结果是两个重复组。第一组只有两份 ALPHA,第三个五字节文件不能混入;第二组是两份二进制副本。唯一大小的十七字节文件不必读取内容,空文件因默认阈值跳过。这个样本很小,却同时覆盖了同名误判、改名漏报、同大小异内容和单成员桶优化。
| 检查项 | 本次结果 |
|---|---|
| 重复组 | 2 |
| 逻辑冗余 | 1,029 字节 |
| 完成摘要的文件 | 5 |
| 摘要阶段内容量 | 2,063 字节 |
| 逐字节确认次数 | 2 |
本次输出为两组,逻辑冗余量一千零二十九字节,五个文件完成摘要,摘要阶段处理两千零六十三字节,逐字节确认发生两次。这里没有提供耗时排行榜:这么小的样本主要用于查正确性,执行时间容易被进程启动、缓存与后台任务影响,用它推断扫描整块硬盘的速度没有意义。
除此之外,测试还把摘要函数替换成固定字符串,验证碰撞候选最终会按字节拆开;模拟某个文件读取抛出权限错误,检查错误是否进入报告、其余结果是否仍然保留;在记录签名后改写文件,检查它是否被拒绝。权限错误是测试注入,不能写成本机真实权限配置实验。
最终十七项检查通过,包括中文空格路径、调整块大小结果不变、最小大小过滤、硬链接去重、已有报告保护、扫描目录内输出拦截,以及样本内容在查重前后保持一致。测试建立和清理的是它自己的临时文件,工具本身没有删除功能。代码和原始结果随素材包提供,读者可运行 python experiment.py 重做这组验证。
7. 六种失败现象,沿着报告往回查
第一种,照片明明相同却没有命中。先确认要求是原始字节一致,还是视觉相似。同一张照片缩放、重新压缩或改写元数据后,内容可能变化。要做相似图片检索,应使用图像特征或感知哈希,那是另一个项目,不能放宽本工具的字节定义来冒充已经解决。
第二种,文件同样大小,结果却分开。大小只是候选条件。检查摘要和真实字节,通常会发现内容不同;若只比较文件前几块,也可能错把相同文件头当成整个文件相同。当前实现计算完整摘要,并对候选再次确认。
第三种,大文件扫描看起来很慢。查看 candidate_files 和 hashed_bytes;当大量文件大小相同,就需要读取更多正文。先缩小扫描根目录、提高最小大小阈值,再考虑是否需要采样过滤或持久化摘要缓存。采样只能排除明显不同,采样相同仍要回到全量比较。
第四种,有些文件完全没出现在重复组中。先看 errors 和 skipped,而不是立刻认定程序漏报。文件可能低于阈值、属于同一硬链接身份、是符号链接、读取失败,或在过程中发生变化。即使没有任何重复组,只要 errors 不为空,也不能写成"目录已经全部检查,无重复"。
第五种,报告生成失败。核对输出是否在扫描目录外、父目录是否存在、是否已有同名报告,以及当前账号是否能写入。程序故意不用自动覆盖,把新报告改成带日期的名称,就能保留前后对比记录。输入不存在或参数为负数等情况会在入口报错,不必等到扫描中途。
第六种,报告说有冗余,磁盘可用空间却没有对应变化。程序没有执行清理,本来就不会腾出空间;即使后续人工整理,硬链接、快照、回收站和文件系统分配方式也会影响可用空间。把"可核对的逻辑冗余"与"已经释放的物理空间"分开,才能正确解释工具能力。
#mermaid-svg-uHlx3E7jXxDaPhmt{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-uHlx3E7jXxDaPhmt .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-uHlx3E7jXxDaPhmt .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-uHlx3E7jXxDaPhmt .error-icon{fill:#552222;}#mermaid-svg-uHlx3E7jXxDaPhmt .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-uHlx3E7jXxDaPhmt .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-uHlx3E7jXxDaPhmt .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-uHlx3E7jXxDaPhmt .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-uHlx3E7jXxDaPhmt .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-uHlx3E7jXxDaPhmt .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-uHlx3E7jXxDaPhmt .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-uHlx3E7jXxDaPhmt .marker{fill:#333333;stroke:#333333;}#mermaid-svg-uHlx3E7jXxDaPhmt .marker.cross{stroke:#333333;}#mermaid-svg-uHlx3E7jXxDaPhmt svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-uHlx3E7jXxDaPhmt p{margin:0;}#mermaid-svg-uHlx3E7jXxDaPhmt .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-uHlx3E7jXxDaPhmt .cluster-label text{fill:#333;}#mermaid-svg-uHlx3E7jXxDaPhmt .cluster-label span{color:#333;}#mermaid-svg-uHlx3E7jXxDaPhmt .cluster-label span p{background-color:transparent;}#mermaid-svg-uHlx3E7jXxDaPhmt .label text,#mermaid-svg-uHlx3E7jXxDaPhmt span{fill:#333;color:#333;}#mermaid-svg-uHlx3E7jXxDaPhmt .node rect,#mermaid-svg-uHlx3E7jXxDaPhmt .node circle,#mermaid-svg-uHlx3E7jXxDaPhmt .node ellipse,#mermaid-svg-uHlx3E7jXxDaPhmt .node polygon,#mermaid-svg-uHlx3E7jXxDaPhmt .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-uHlx3E7jXxDaPhmt .rough-node .label text,#mermaid-svg-uHlx3E7jXxDaPhmt .node .label text,#mermaid-svg-uHlx3E7jXxDaPhmt .image-shape .label,#mermaid-svg-uHlx3E7jXxDaPhmt .icon-shape .label{text-anchor:middle;}#mermaid-svg-uHlx3E7jXxDaPhmt .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-uHlx3E7jXxDaPhmt .rough-node .label,#mermaid-svg-uHlx3E7jXxDaPhmt .node .label,#mermaid-svg-uHlx3E7jXxDaPhmt .image-shape .label,#mermaid-svg-uHlx3E7jXxDaPhmt .icon-shape .label{text-align:center;}#mermaid-svg-uHlx3E7jXxDaPhmt .node.clickable{cursor:pointer;}#mermaid-svg-uHlx3E7jXxDaPhmt .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-uHlx3E7jXxDaPhmt .arrowheadPath{fill:#333333;}#mermaid-svg-uHlx3E7jXxDaPhmt .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-uHlx3E7jXxDaPhmt .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-uHlx3E7jXxDaPhmt .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-uHlx3E7jXxDaPhmt .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-uHlx3E7jXxDaPhmt .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-uHlx3E7jXxDaPhmt .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-uHlx3E7jXxDaPhmt .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-uHlx3E7jXxDaPhmt .cluster text{fill:#333;}#mermaid-svg-uHlx3E7jXxDaPhmt .cluster span{color:#333;}#mermaid-svg-uHlx3E7jXxDaPhmt div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-uHlx3E7jXxDaPhmt .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-uHlx3E7jXxDaPhmt rect.text{fill:none;stroke-width:0;}#mermaid-svg-uHlx3E7jXxDaPhmt .icon-shape,#mermaid-svg-uHlx3E7jXxDaPhmt .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-uHlx3E7jXxDaPhmt .icon-shape p,#mermaid-svg-uHlx3E7jXxDaPhmt .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-uHlx3E7jXxDaPhmt .icon-shape .label rect,#mermaid-svg-uHlx3E7jXxDaPhmt .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-uHlx3E7jXxDaPhmt .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-uHlx3E7jXxDaPhmt .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-uHlx3E7jXxDaPhmt :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 否
是
是
否
报告没有预期副本
errors 是否为空
先查权限与正在变化的文件
skipped 是否包含目标
核对大小阈值与链接记录
检查扫描根目录和内容差异
8. 把工具用起来,再决定下一步怎么扩展
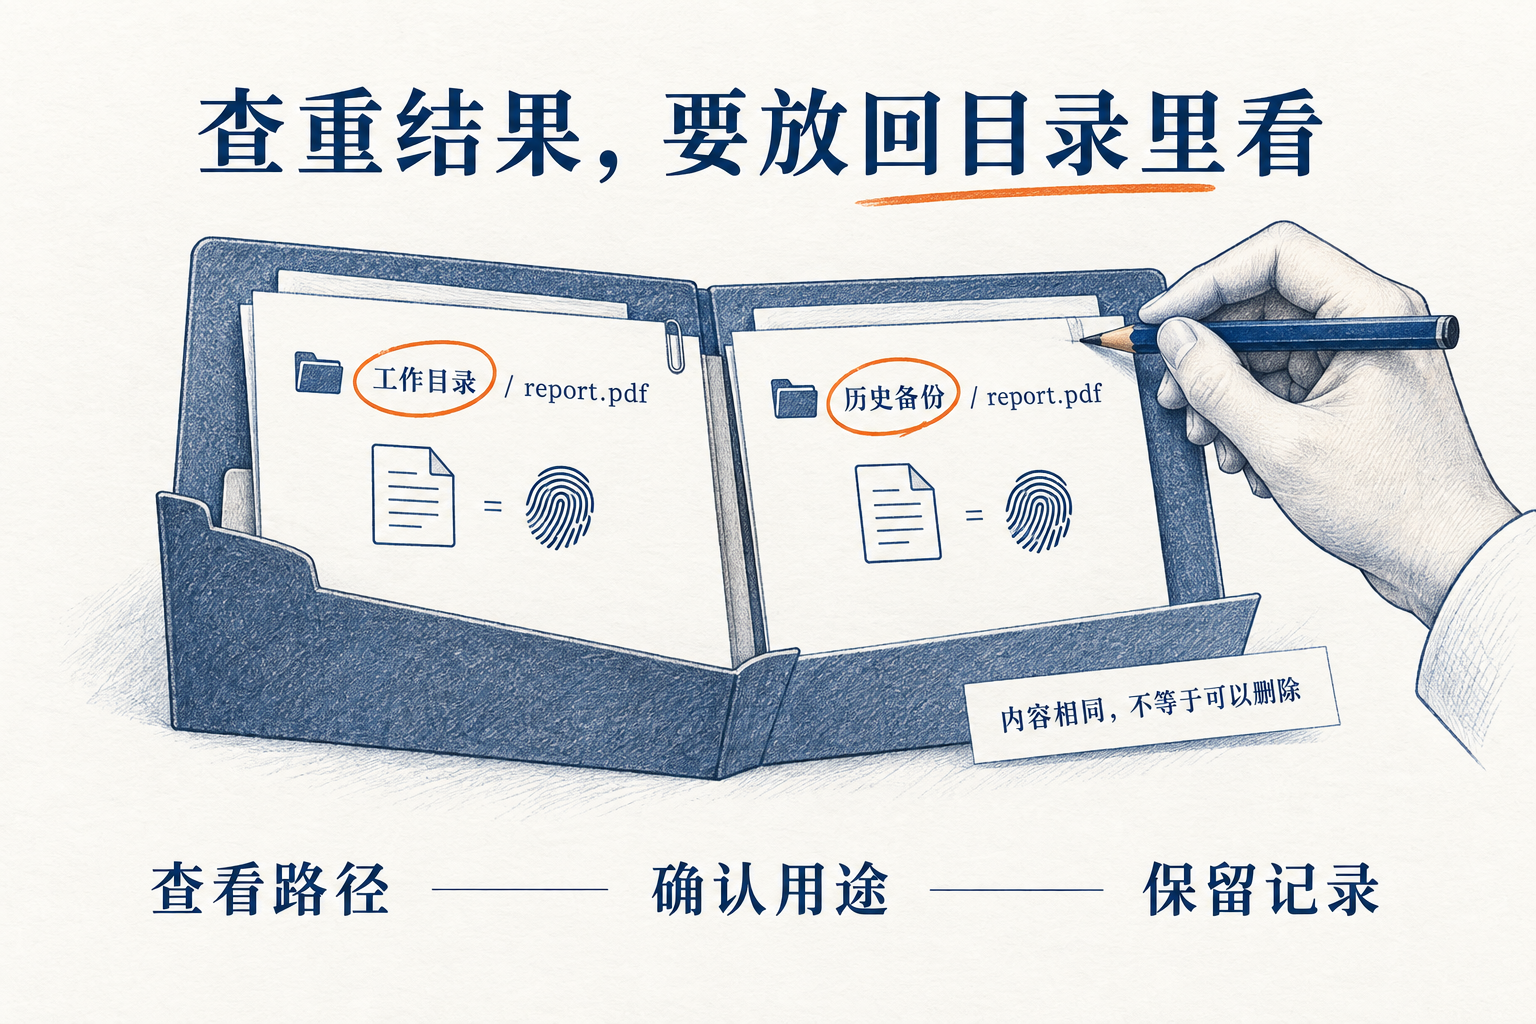
最适合练手的真实场景,是一个已经停止下载和同步的资料目录。先扫描一小层,打开报告中最大的重复组,逐条检查路径所处位置。一个文件位于当前项目,另一个属于历史交付备份,即使内容一致,也可能都有保留理由。报告建立的是内容关系,不能推断业务生命周期。
文件数量达到几十万时,当前内存字典会变大;即使内容读取保持分块,路径和错误记录也无法忽略。下一步可以把索引写入 SQLite,按大小分批处理。需要重复扫描时,再考虑缓存,但缓存键要同时考虑文件身份与变化状态,并为不可靠时间戳准备重新读取策略。按路径永久复用旧摘要,会让文件改写后仍被当成旧内容。
若后续加入整理能力,建议单独设计计划文件,列明来源、目标、理由和生成时间。执行前重新确认内容,将移动与删除作为独立操作记录。不要直接在当前 groups 循环里加一行 unlink,因为生成报告和真正执行之间可能相隔几小时,文件位置和用途都可能变化。
发布或交给同事前,至少完成这几项核对:解释器满足版本要求;两个改名副本能识别;同名异内容不能合并;errors 与 skipped 可以解释;报告保留绝对路径;逻辑冗余没有被宣传为释放容量;结果清单对应停止写入的那一批文件。读者如果用它扫描自己的资料,最值得反馈的是哪个重复组最难决定保留位置,这能帮助下一版选择真正有价值的功能。
附录:完整可运行程序
将下面代码保存为 dupes.py。它只读取输入文件,报告写到扫描目录外,不执行删除。
python
"""Read-only duplicate finder for a quiescent personal directory; Python 3.12+."""
import argparse
import hashlib
import json
import os
import stat
from collections import defaultdict
from pathlib import Path

BLOCK = 1024 * 1024


def signature(s):
    return s.st_dev, s.st_ino, s.st_size, s.st_mtime_ns


def checked_open(path, expected):
    if path.is_symlink() or path.is_junction():
        raise OSError("link replaced a file")
    f = path.open("rb")
    if signature(os.fstat(f.fileno())) != expected:
        f.close()
        raise OSError("file changed since enumeration")
    return f


def unchanged(path, f, expected):
    if signature(os.fstat(f.fileno())) != expected or signature(path.lstat()) != expected:
        raise OSError("file changed during scan")


def digest(path, expected, block):
    h = hashlib.sha256()
    with checked_open(path, expected) as f:
        while chunk := f.read(block):
            h.update(chunk)
        unchanged(path, f, expected)
    return h.hexdigest()


def same_bytes(a, b, snapshots, block):
    with checked_open(a, snapshots[a]) as fa, checked_open(b, snapshots[b]) as fb:
        while True:
            x, y = fa.read(block), fb.read(block)
            if x != y:
                equal = False
                break
            if not x:
                equal = True
                break
        unchanged(a, fa, snapshots[a])
        unchanged(b, fb, snapshots[b])
    return equal


def scan(root, min_bytes=1, block=BLOCK):
    root = Path(root)
    if root.is_symlink() or root.is_junction():
        raise ValueError("root must not be a link/junction")
    root = root.resolve(strict=True)
    if not root.is_dir() or min_bytes < 0 or block < 1:
        raise ValueError("expected directory, min_bytes >= 0, block >= 1")
    by_size, snapshots, identities = defaultdict(list), {}, set()
    errors, skipped = [], []
    counters = dict(regular_paths=0, eligible_files=0, candidate_files=0,
                    hashed_files=0, hashed_bytes=0, compared_pairs=0)

    def error(path, exc):
        errors.append({"path": str(path), "error": str(exc)})

    for base, dirs, files in os.walk(root, followlinks=False,
                                    onerror=lambda e: error(e.filename, e)):
        keep = []
        for name in sorted(dirs):
            p = Path(base) / name
            try:
                if p.is_symlink() or p.is_junction():
                    skipped.append({"path": str(p), "reason": "directory_link"})
                else:
                    keep.append(name)
            except OSError as exc:
                error(p, exc)
        dirs[:] = keep
        for name in sorted(files):
            p = Path(base) / name
            try:
                s = p.lstat()
                if not stat.S_ISREG(s.st_mode) or p.is_symlink():
                    skipped.append({"path": str(p), "reason": "not_regular"})
                    continue
                counters["regular_paths"] += 1
                if s.st_size < min_bytes:
                    skipped.append({"path": str(p), "reason": "below_min_bytes"})
                    continue
                identity = (s.st_dev, s.st_ino)
                if s.st_ino and identity in identities:
                    skipped.append({"path": str(p), "reason": "hardlink_alias"})
                    continue
                if s.st_ino:
                    identities.add(identity)
                snapshots[p] = signature(s)
                by_size[s.st_size].append(p)
                counters["eligible_files"] += 1
            except OSError as exc:
                error(p, exc)

    output = []
    for size, paths in sorted(by_size.items()):
        if len(paths) < 2:
            continue
        counters["candidate_files"] += len(paths)
        hashes = defaultdict(list)
        for p in paths:
            try:
                key = digest(p, snapshots[p], block)
                hashes[key].append(p)
                counters["hashed_files"] += 1
                counters["hashed_bytes"] += size
            except OSError as exc:
                error(p, exc)
        for key, bucket in hashes.items():
            groups = []
            for p in bucket:
                try:
                    for group in groups:
                        counters["compared_pairs"] += 1
                        if same_bytes(group[0], p, snapshots, block):
                            group.append(p)
                            break
                    else:
                        groups.append([p])
                except OSError as exc:
                    error(p, exc)
            for group in groups:
                if len(group) < 2:
                    continue
                try:
                    if any(signature(p.lstat()) != snapshots[p] for p in group):
                        raise OSError("group changed before reporting")
                except OSError as exc:
                    error(group[0], exc)
                    continue
                output.append({"size": size, "sha256": key,
                               "paths": sorted(map(str, group)),
                               "redundant_logical_bytes": size * (len(group) - 1)})
    return {"root": str(root), "mode": "report-only", "groups": output,
            "redundant_logical_bytes": sum(g["redundant_logical_bytes"] for g in output),
            "counters": counters, "errors": errors, "skipped": skipped}


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("root", type=Path)
    parser.add_argument("--out", required=True, type=Path)
    parser.add_argument("--min-bytes", type=int, default=1)
    parser.add_argument("--block-kib", type=int, default=1024)
    args = parser.parse_args()
    try:
        root = args.root.resolve(strict=True)
        out = args.out.resolve()
        if out == root or root in out.parents:
            parser.error("--out must be outside the scanned directory")
        if out.exists():
            parser.error("report already exists; choose a new filename")
        report = scan(args.root, args.min_bytes, args.block_kib * 1024)
        with out.open("x", encoding="utf-8") as f:
            json.dump(report, f, ensure_ascii=False, indent=2)
        print(json.dumps({"groups": len(report["groups"]),
                          "errors": len(report["errors"]),
                          "report": str(out)}, ensure_ascii=False))
        return 2 if report["errors"] else 0
    except (ValueError, OSError) as exc:
        parser.error(str(exc))


if __name__ == "__main__":
    raise SystemExit(main())
创建可复现的练习样本
保存下面代码为 make_demo.py,与主程序放在同一位置。它只允许创建新的样本目录,不覆盖已有目录。
python
"""Create a new demonstration directory; refuses existing destinations."""
import argparse
from pathlib import Path

p = argparse.ArgumentParser()
p.add_argument('directory', type=Path)
root = p.parse_args().directory
root.mkdir(parents=True, exist_ok=False)
samples = {'a/report.txt':b'ALPHA','b/backup.txt':b'ALPHA',
           'c/report.txt':b'OMEGA','photo.bin':b'B'*1024,
           'copy/photo.bin':b'B'*1024,'unique.bin':b'C'*17,'empty':b''}
for name, content in samples.items():
    target = root/name
    target.parent.mkdir(parents=True, exist_ok=True)
    target.write_bytes(content)
print(root.resolve())
powershell
py -3 make_demo.py demo-files
py -3 dupes.py demo-files --out demo-report.json
首次运行应得到两组重复。再次实验时使用新的样本目录和报告名称。