9月17日,华为全联接大会2026在上海举办。华为副董事长、轮值董事长汪涛正式发布昇腾960超节点。
以下是关于昇腾960超节点的几个关键数字:全球首个采用NPO近封装光学技术的超节点,单节点4096张算力卡,FP8峰值算力8 EFLOPS,FP4算力16 EFLOPS,1PB HBM内存容量。5500个Hi-ONE光引擎替代传统方案所需的4.8万颗800G光模块,整体功耗降低超过550千瓦,系统可用度99.8%。液冷版本计划2027年第三季度上市。
本文从核心参数、灵衢互联、Hi-ONE光引擎、正交架构与液冷、芯片路线图、产业链六个维度做技术拆解。
一、核心参数:4096卡、8EFLOPS、1PB HBM
算力层面,FP8精度下8 EFLOPS,FP4精度下16 EFLOPS。这个算力规模直接对应十万亿参数级大模型的训练和推理需求。
卡数层面,单节点4096张算力卡。相比上一代昇腾950超节点的1024卡规模,单节点卡数扩展了4倍。
内存层面,单超节点HBM容量1PB。结合灵衢总线的内存统一编址,这1PB内存对软件而言是一块统一编址的连续地址空间,不是分散在4096张卡上的独立显存。
可靠性层面,系统无故障运行时间提升一倍,系统可用度达到99.8%。在4096卡规模下,任何一个部件故障都可能影响整个集群运行,99.8%的可用度意味着系统设计在故障隔离和快速恢复上做了大量工程优化。
这些参数不是孤立的数字。4096卡规模决定了互联架构必须重构,8 EFLOPS算力决定了功耗密度必须靠液冷解决,1PB统一内存决定了互联协议必须支持内存统一编址。每一个参数背后,都是一整套系统级工程设计。
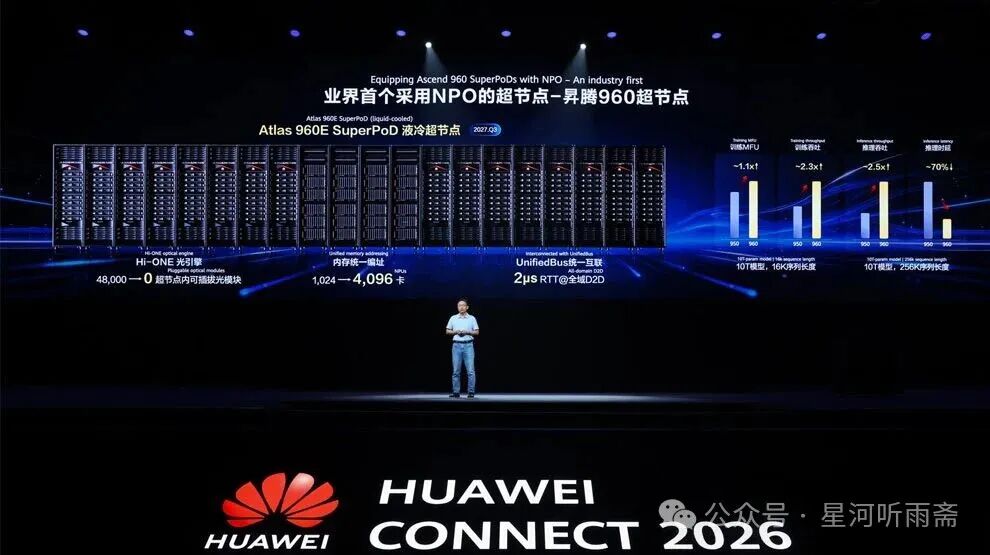
图1:华为全联接大会2026现场,汪涛发布Atlas 960E液冷超节点
二、灵衢互联协议:内存统一编址与全对等互联
昇腾960超节点的互联架构是华为自研的灵衢(UnifiedBus)协议。
灵衢解决三个关键问题。
第一,跨柜长距离稳定互联。传统AI集群中,GPU之间通过交换机网络连接,跨柜通信延迟高、带宽瓶颈明显。灵衢协议突破了传统电互联和光互联的局限,实现多机柜之间的长距离稳定连接。华为公布的数据显示,跨柜卡间互联带宽相比传统方案提升5倍,端到端延迟降至2.1微秒以内。这个延迟水平已经接近机柜内部互联的量级。
第二,内存统一编址。这是灵衢最核心的设计。传统架构中,每张GPU的显存是独立编址的,跨卡访问需要通过网络协议栈,软件栈开销大,延迟高。灵衢实现了整个超节点内存池的统一编址,任意一张卡可以直接访问其他卡的内存,不需要经过复杂的协议转换。1PB的HBM内存池,对上层软件而言就是一块巨大的连续地址空间。
第三,全对等平等互联。灵衢采用全对等(Peer-to-Peer)架构,任意两张卡之间平等通信,不存在主从关系。华为将这套架构定义为Peerium计算架构,通过嵌套并行、统一内存寻址和平等互联,支撑百万级处理器像一台计算机一样协作。
内存统一编址的技术意义怎么强调都不过分。它把AI算力集群从"多台服务器通过网络连接"变成了"一台拥有数千个计算核心的超级计算机"。对于MoE大模型,这意味着"一卡一专家"的理想架构可以落地,4096张卡可以组成一个整体协同完成大模型推理和训练。
灵衢2.0的技术规范已经全面开放,从协议架构、硬件设计到操作系统组件开源。这意味着华为不只是在自用灵衢,而是在推动整个行业基于这套互联协议构建生态。
三、Hi-ONE光引擎:7.2T NPO的技术拆解
昇腾960超节点最核心的技术升级,是首次在大规模算力集群中量产采用NPO光引擎Hi-ONE。
Hi-ONE是华为自研的高密度光互联节点引擎(High-density Optical-interconnect Node Engine),也是全球首个量产的NPO产品。几个关键技术指标:单引擎传输容量7.2Tb/s,是目前行业传输能力最大的NPO产品,也是唯一实现内置光源的NPO产品。产品覆盖VCSEL和硅光两条技术路线:VCSEL版本3.2T(32×112G),硅光版本7.2T(36×224G)。
硅光版本的技术细节:采用SiN-SOI硅光技术平台,核心由InP多路共享光源芯片、36通道收发集成硅光芯片、多路高带宽电芯片和高密度光电封装构成。发送和接收侧各配置36条200Gb/s电通道,单向带宽7.2Tb/s。通过WDM波分复用,将36个发送通道和36个接收通道分别汇聚至18根发送光纤和18根接收光纤,大幅压缩光纤数量。内置共享光源芯片由片上耦合/分光器向不同调制通道分配连续光,减少了外部光纤连接,提升了系统可靠性和集成度。
整个超节点用了5500个Hi-ONE光引擎,替代传统方案所需的4.8万颗800G可插拔光模块,折算下来一个Hi-ONE光引擎替代约9颗800G光模块。
这个替代带来三个直接效果:
功耗降低超过550千瓦。原因在于NPO把光引擎靠近交换芯片,缩短了PCB走线上的电信号传输距离,减少了信号驱动功耗;同时光模块数量从4.8万颗减少到5500个,光模块本身的功耗也大幅下降。
可靠性提升。光模块数量减少近90%,故障点大幅减少。系统无故障运行时间提升一倍,可用度达到99.8%。在4096卡规模下,可靠性是我们应该尤为关注的关键指标。
带宽密度提升。NPO缩短电信号路径后,可以支持更高的单通道速率和更大的通道密度,为未来向更高带宽代际升级预留了空间。
Hi-ONE还集成了StarSensor星云智检功能,对光引擎的工作状态进行实时监测和故障预警。这是NPO产品从实验室走向规模部署的必要配套。
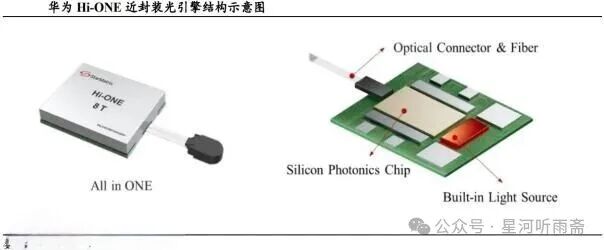
图2:华为Hi-ONE近封装光引擎结构示意图,内置共享光源与硅光芯片集成
四、正交架构与全液冷:工程设计的系统级优化
昇腾960超节点采用正交架构和全液冷设计,这两个工程决策对系统性能和可靠性同样关键。
正交架构是指计算单元和互联单元在物理布局上呈垂直正交通过高速连接器对插,无中间背板。计算单元负责算力,互联单元负责光互联。这种架构的优势在于:计算单元和计算单元之间的互联走线最短,从物理层面保证高速互联信号的传输质量。
全液冷设计是功耗密度提升后的必然选择。4096卡规模的算力集群,功耗密度远超传统风冷散热的极限。8 EFLOPS的FP8算力,必须靠液冷才能有效散热。液冷不仅解决散热问题,还降低了机房PUE,对大规模算力部署的长期运营成本影响显著。
华为公布的功耗降低550千瓦,是NPO光引擎替代可插拔模块和液冷设计共同作用的结果。正交架构则保证了系统架构的高可靠性和低时延互联。这三个工程设计决策不是孤立的,而是互相配合,共同支撑4096卡规模超节点的稳定运行。
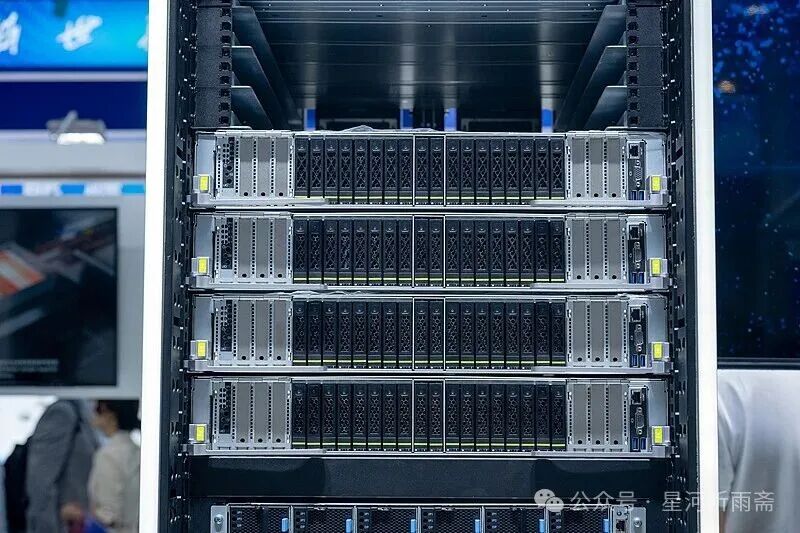
图3:华为液冷超节点机柜内部实拍,全液冷设计
五、昇腾960芯片:HiF4数据格式与路线图
超节点的性能不仅取决于互联架构,还取决于底层芯片。昇腾960超节点搭载的是华为自研的昇腾960 AI处理器。
根据华为公布的路线图,昇腾960芯片相比上一代950,在算力、内存访问带宽、内存容量、互联端口数等关键规格上全面翻倍。芯片分两个版本:960DT预计2027年第一季度就绪,960PR预计要到2027年第三季度。搭载昇腾960PR的液冷超节点计划2027年第三季度上市。
昇腾960的另一个关键技术亮点是支持华为自研的HiF4数据格式。华为称这是业界最优的4bit精度实现方案,在4bit低精度推理场景下,推理精度优于业界通用的FP4方案。
数据格式对AI推理效率至关重要。FP8是当前主流训练精度,FP4是下一代推理精度的竞争焦点。每降低一个比特数,算力需求和内存带宽需求都大幅下降。华为自研HiF4格式,用更低的比特数实现更好的精度保持,直接关系到推理成本和效率。在超节点1PB统一内存池的架构下,数据格式的效率直接影响整个系统的推理吞吐。
需要客观看待的是,单卡性能的提升虽然重要,但在超节点架构下,系统级性能才是核心竞争力。灵衢总线的全对等互联、Hi-ONE光引擎的高带宽互联、内存统一编址的池化调度,这些系统级设计把单卡的性能瓶颈通过架构创新部分对冲掉了。这正是华为超节点策略的核心逻辑:不拼单芯片极限,拼系统级整合。
图4:昇腾960芯片渲染图
六、产业链:NPO光引擎、液冷、光模块
昇腾960超节点的发布,对产业链各环节都有明确的信号意义。
NPO光引擎:从验证走向规模量产
Hi-ONE是昇腾960超节点最核心的新增部件。5500个光引擎替代4.8万颗800G光模块,NPO在华为超节点中的渗透率接近100%。
这意味着NPO不再是实验室技术,而是大规模算力集群的实际部署方案。光通信产业链需要从传统可插拔光模块的设计能力,转向NPO光引擎的设计和制造能力。硅光芯片、InP光源、高密度光电封装、WDM波分复用等上游环节的价值占比将持续提升。
Hi-ONE同时覆盖VCSEL和硅光两条路线,VCSEL 3.2T面向短距场景,硅光7.2T面向更高带宽场景。这种双路线布局说明NPO不是只有单一技术方案,而是可以根据不同距离和带宽需求选择不同光技术路线。
光模块:从可插拔向光引擎转型
4.8万颗800G光模块被替代,这个数字对传统光模块厂商是明确的信号。在超节点架构中,传统可插拔光模块的角色正在被NPO光引擎替代。光模块厂商需要向光引擎、硅光芯片、光器件等上游环节延伸,而不是停留在传统模块组装。
但这并不意味着可插拔光模块会立刻消失。在非超节点架构的传统AI集群中,800G和1.6T可插拔光模块仍然是主流。NPO替代的是超节点内部的短距互联场景,不是全部光互联市场。
液冷:从可选变必选
全液冷设计在4096卡规模超节点中已经是必选项。冷板、CDU、冷却液、快速接头、管路系统等液冷产业链环节,将随着超节点规模部署而快速成熟。PUE优势也使液冷成为新建AI数据中心的标准配置。
机柜与供电
4096卡规模超节点对机柜供电、散热、布线都提出了极高要求。大规模集群部署需要专门设计的AI数据中心厂房,供电系统、UPS、配电都需要重新规划。
七、产业趋势分析
第一,AI算力竞争主战场已从单芯片转向系统架构。单芯片性能受限于制程微缩的物理极限,提升空间越来越小。通过互联架构创新,把数千张卡高效组织成统一计算资源,系统级算力仍有巨大提升空间。华为昇腾超节点的架构很清晰:灵衢总线解决互联效率,Hi-ONE光引擎解决光互联瓶颈,正交架构解决高可用性,全液冷解决功耗散热。
第二,NPO光互联的商业化窗口已经打开。昇腾960超节点是全球首个大规模量产采用NPO的算力集群,5500个光引擎替代4.8万颗800G光模块,功耗降低550千瓦。这个数据直接证明了NPO的商业价值。光通信产业链中,具备硅光集成、InP光源、高密度封装能力的厂商将率先受益。传统可插拔光模块在超节点场景中的份额将逐步下降。
第三,内存统一编址是超节点架构的核心壁垒。灵衢实现的1PB统一编址内存池,不是简单的高速网络连接,而是从硬件层面把整个超节点的内存变成一块统一地址空间。这个架构需要芯片、总线、软件栈的深度协同设计,不是买现成的光模块和交换芯片就能实现的。它构成了华为超节点的核心技术壁垒。
第四,全栈自研是国产算力的必选项。昇腾960超节点从芯片(昇腾960)、互联协议(灵衢)、光引擎(Hi-ONE)、液冷设计到软件栈,全部自研。这种全栈模式使华为在外部限制环境下仍能持续推出有竞争力的产品。对于整个国产算力产业链,全栈自研不是选择题,而是必答题。
第五,超节点规模将持续扩大。从1024卡到4096卡,卡数量每代翻倍。背后的驱动力是大模型参数规模的持续增长。当大模型走向十万亿参数级别,单机架甚至单机房的算力都不够用,必须通过超节点架构把更多卡组织成统一计算资源。灵衢2.0开源、Peerium计算架构支持百万级处理器协作,说明华为的目标不只是4096卡,而是百万卡级的超大规模集群。
昇腾960超节点的发布,表面是一次产品迭代,实质上可以看作是一种AI算力竞争范式的转移。当制程微缩逼近物理极限,单芯片性能的边际收益递减,系统级架构创新成为算力增长的主引擎。谁能把更多卡更高效地组织成统一计算资源,谁就能在AI算力竞争中占据主动。(完)
免责声明:本文仅用于半导体、AI算力、光互联及数据中心基础设施相关技术研究与产业分析,不构成任何投资、证券或金融产品相关建议,不作为投资参考。文中数据以华为官方发布及权威第三方报道为准。
星河听雨斋
每天一份高质量研报,持续聚焦芯片半导体、AI基础设施、AI智能硬件、具身智能、光通信等硬科技方面的行业研究、产业链分析与技术拆解。欢迎您的关注!