laya:不做生成、只做决策的非自回归引擎,六天两万星
- 它不生成文本 :单次前向对
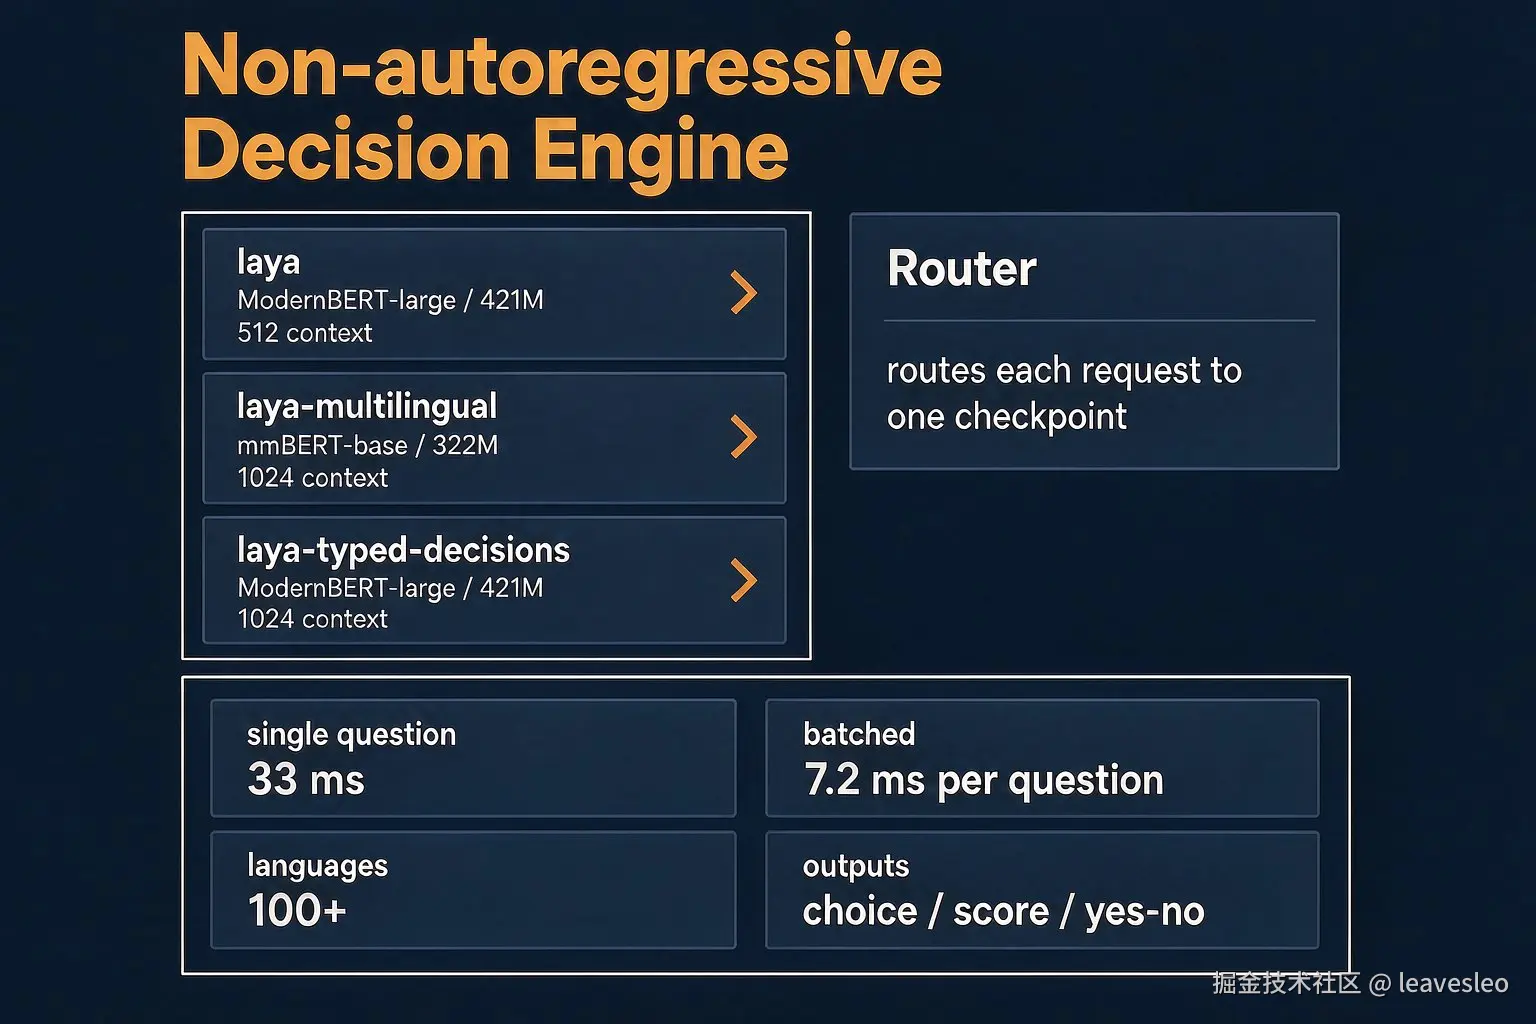
choice/score/noul三类带类型的问题给出答案,没有输出可解析,也就没有输出可幻觉- 延迟 :单问 33 ms ,批量 7.2 ms/问(T4 实测口径)
- 三个 checkpoint + 一个 Router :按请求挑合适的那个,
Router.predict_batch还能把异构请求分组共享前向- 规模 :421M / 322M 参数级,100+ 语言,Apache-2.0,Python
- 训练方式 :用严格适当评分规则做 RL(RLCD) ,主打置信度校准而不是流畅度
- 什么时候不该用它:需要生成、需要多步推理链、需要解释理由的场景
NandhaKishorM/laya 在 2026 年 9 月 18 日创建,到撰稿时 ★20,612、fork 1,759 ,Apache-2.0,Python。它的自我定位很明确:非自回归的 System 1 决策引擎 ------对任意文本状态(文档、邮件、工单、JSON)在单次前向 里回答带类型的决策问题,支持 100+ 语言,并用一个 Router 为每个请求挑合适的 checkpoint。
同赛道已经长出了一片:mizorewww/laya-mlx(★5,974,created 9-19,M3 Max 上 7--14 ms )、wfzyx/von(★588,created 9-18,sub-15ms,自称 TypeSafe Jev 的替代)。注意这三款的创建日期各不相同,不能笼统写成"同日开源"。
这篇文章讲清一类被生成式能力盖住的东西:当你只需要一个判断时,用生成模型是浪费的------不只是浪费算力,还在引入一整类不该存在的失败模式。
一、为什么"只做决策"是一类独立的模型
日常业务里,绝大多数所谓"AI 调用"其实不是生成任务,而是判断任务:
| 任务 | 输入 | 输出 | 需要生成吗 |
|---|---|---|---|
| 意图分类 | 用户消息 | 从 N 个意图里选一个 | 不需要 |
| 工单路由 | 工单正文 | 目标队列 | 不需要 |
| 相关性打分 | 查询 + 文档 | 一个分数 | 不需要 |
| 是否触发人工 | 对话上下文 | 是 / 否 | 不需要 |
| 情绪判定 | 文本 | 类别 + 强度 | 不需要 |
用生成模型做这些事,会引入一个绕不开的环节:解析 。模型输出 "我认为应该归类为退款",你得写正则或约束解码把它变成 refund。这个环节带来的问题有三个:
- 解析失败是新的一类错误------而且它和"判断错了"混在一起,排查时分不清是模型没判断对还是解析没写对;
- 输出可能合理但不合法------生成了标签列表里不存在的类别;
- 成本与延迟按生成 token 数计费------判断一个二分类问题要认真吐完一句解释。
laya 的路径是把"输出空间"直接收窄成受约束的答案。 它支持三类问题:
choice:从给定选项里选;score:给出一个分数;noul:是 / 否(或一对标签)的判定。
输出空间被约束之后,"幻觉"这个概念在这类调用上就不成立了 ------没有自由文本可以偏离事实,答案必然落在候选集合里。这是它最大的工程价值:把一类错误从系统里整体删掉,而不是降低它的概率。
二、非自回归:延迟从哪省下来
传统生成模型的推理是自回归的:一个 token 一个 token 地吐,每个 token 都要一次前向(实际实现里有 KV cache 与批处理优化,但序列结构不变)。因此延迟大致与输出长度成正比。
laya 走的是单次前向 :编码器读完输入,直接在分类头上给出答案。延迟不再与"答案长度"相关。
官方给出的口径是:单问 33 ms,批量 7.2 ms/问(T4 上测得)。
批量 7.2 ms 这个数字比 33 ms 更值得注意 ,它揭示了这类模型的成本结构:单次前向可以容纳多个样本,因为输入是固定长度的编码,不存在"生成到一半长度不一致"的问题------批处理效率接近硬件的算力上限。
对比一下生成模型在同一场景的开销 (典型调用场景,量级估算):要输出一个 3 个字母的标签,至少需要 3 次前向解码(实际还会包含提示词处理);而单次前向的分类只需要 1 次。即便不考虑 KV cache 与采样开销,前向次数就差数倍,再叠上批处理效率的差异,量级差异就出来了。
对成本敏感的场景,这个差值决定了架构选择:
| 延迟量级 | 能支撑的用法 |
|---|---|
| 10--30 ms | 同步拦截在用户交互路径上(发消息前先判定) |
| 100--300 ms | 可以在服务端做前置过滤,用户感知不明显 |
| 1 s 以上 | 只能异步或离线做 |
能在 10--30 ms 档位做判断,意味着这类模型可以放到"每一次交互"的路径上,而不是攒成批处理。这是设计空间上的质变:以前因为延迟而必须攒批的判断,现在可以实时做。
三、三个 checkpoint 与 Router:一种务实的多模型策略
laya 的做法不是"一个大模型包打全部",而是三个 checkpoint + 在请求级选路:
| checkpoint | 编码器 | 参数量 | 上下文 | 定位 |
|---|---|---|---|---|
laya |
ModernBERT-large | 421M | 512 | 英文 |
laya-multilingual |
mmBERT-base | 322M | 1024 | 100+ 语言 ,官方称约 2 倍快 |
laya-typed-decisions |
ModernBERT-large | 421M | 1024 | 带类型的决策工作流 |
这个设计里最有信息量的是参数量的差异:多语言版反而更小(322M vs 421M)。 通常多语言能力需要更大的词表与更多参数,这里反过来,说明多语言版用的是不同的编码器底座(mmBERT-base)而不是在英文模型上扩词表。代价是英文任务上可能不如专用版,收益是延迟更低、覆盖更广。
Router 在请求级选路,是做多模型策略的正确粒度。 常见错误是按"产品"或"租户"选模型(一锤定音,改起来麻烦),或者按"批次"选(一批里混着多种语言就只能取一个)。按请求选路意味着可以细到"这条请求是中文还是英文、是短文本还是长文本"------而这些信息在请求到达时就是已知的,判断成本极低。
新版还加了 Router.predict_batch(requests) :把一批异构请求按 checkpoint 与问题集分组 ,每组共享一次前向,并保证结果与逐条调用一致。"结果一致"这条约束很关键------批处理优化最常见的坑就是为了吞吐牺牲语义(比如把不同类别的样本混在一起算),导致离线测试与线上行为不一致。
还有两个工程细节值得记:
- 加载时间从约 22 秒降到约 2 秒 :checkpoint 不再做一次无用的随机初始化。同一个 checkpoint 起第二个 Agent 只需约 0.5 秒 (复用已解析的 tokenizer)。冷启动从 22 秒到 2 秒,决定了它能不能用在需要弹性伸缩的在线服务里。
import laya不再加载 torch:路由、语言检测、文本清理可以在轻量进程里跑,torch 在真正用到模型时才导入。这让"只做语言检测"这类操作不必付出加载整个深度学习栈的代价。
四、RLCD:为什么这类模型要按"评分规则"训练
laya 的模型用 RLCD (用严格适当评分规则做强化学习)训练,官方强调的是置信度校准而非流畅度。
"严格适当评分规则"(strictly proper scoring rule)是一个统计学概念 :在这类评分规则下,如实报告自己的真实概率分布,是期望得分最高的策略 。换句话说,它奖励"诚实地表达不确定",而不是奖励"自信地说出答案"。
这条对决策模型是核心的。 因为下游系统需要用的不只是答案,还有**"这个答案有多可信"**:
| 下游用法 | 依赖什么 |
|---|---|
| 高置信才自动处理,低置信转人工 | 分数要可校准(置信度 0.8 意味着约 80% 正确) |
| 阈值调优 | 分数分布要稳定,换数据集不能整体漂移 |
| 多模型投票 / 集成 | 各模型的分数要可比 |
生成模型的置信度通常来自 token 概率(perplexity 类指标),而它与"答案正确"的相关性很弱 ------模型可以把一个错误答案说得非常流利。用评分规则直接训练打分头,是把"置信度"变成一等输出,而不是事后从概率里猜。
判断你的场景需不需要这种可校准性,看一个问题 :你的下游有没有一个阈值? 如果有(比如"分数低于 0.6 就转人工"),那么分数能不能校准直接决定这个阈值好不好调;如果下游只用 top-1 结果、不看分数,那这部分能力的价值就有限。
五、什么时候不该用它
这是最需要说清楚的一段,因为"成本低、延迟低、没有幻觉"听起来像无脑正确。
五类明确不适用的情况:
| 场景 | 为什么不行 |
|---|---|
| 需要生成内容 | 它的输出空间是选项/分数/是否,没有自由文本出口 |
| 需要多步推理链 | 单次前向的结构决定了没有中间推理过程,多跳推理能力有上限 |
| 需要解释理由 | 决策不附带论证,审计场景缺可追溯性 |
| 答案集合开放 | choice 要求候选集已知且有限;开放问答不属于它的设计目标 |
| 输入极长且需全局理解 | 上下文窗口在 512--1024 量级,长文档要配合切片与检索 |
最后一条尤其要注意 :512 / 1024 的上下文窗口意味着它不能直接喂一整篇长文档 。要处理长文本,需要先做检索或摘要,把相关信息压缩到窗口内------这一步的复杂度会被加回到系统里 。所以"用轻量模型省成本"这件事,在长文本场景下往往伴随着"多一层切片与召回管线"的成本,要一起算账。
另外一条实务提醒 :它对输入格式和清洗是敏感的。 README 里专门提到对"超大邮件与状态"做边界处理、纯 ASCII 德语会被路由到多语言 checkpoint 这类细节------说明实际部署中,语言识别与文本预处理的边界情况是需要自己验证的部分,不能假定路由永远正确。
六、上手路径与判断规则
bash
pip install -U laya

# 三条路径按需选
laya.load()                     # 常规加载
laya.load(..., fast=True)       # TileLang GPU 快路径
Agent(compile=True)             # 启用 torch.compile
laya.onnx_agent.ONNXAgent       # ONNX Runtime 导出运行
自托管还有 Jev 兼容的 HTTP server (pip install "laya[serve]" 后 laya-serve)、可选 MCP server 、以及 LangChain / LangGraph 集成。"Jev 兼容"这个设计意图很明显: 让已经在用同类决策模型的服务可以平替,降低了迁移成本------这是一个成熟开源项目才会考虑的收尾工作。
最后给一条判断规则 :如果你现在有一类调用是"输入是文本,输出是几个固定选项之一或一个分数,并且这个调用处在用户交互路径上 ",那它大概率该从生成模型迁到这类决策引擎上------省的不只是钱和延迟,还有一整条解析与容错链路的代码。
如果你的调用需要产出任何自由文本,那就不是它该解决的问题。把决策和生成分开,是这类模型带出的最大启发:很多系统里两件事被混在一个调用里,代价是既要承担生成的成本,又要处理生成带来的不确定性。