我在折腾 DeepSeek Harness(DSH)的会话日志,想做一个"Agent 到底改了什么文件"的审计工具,结果撞上一个很硬的墙:
DSH 的日志每次 append 都是一个独立的 zstd 帧。一个 20 MiB 的文件,是 34,729 个帧拼起来的。而 Node 的 zlib 只能解出第一帧。
这篇不是"我用 xx 库解决了问题",而是我选择不用解码器,自己读帧结构的完整过程,附实测数据和踩坑清单。
阅读前提:知道 zstd 是什么,帧格式细节我下面会展开。
一、先把现象复现出来
不用信我,这段代码 3 秒能跑:
js
import { zstdCompressSync, zstdDecompressSync, createZstdDecompress } from 'node:zlib'

const f = (t) => zstdCompressSync(Buffer.from(t, 'utf8'))
const cat = Buffer.concat([f('{"a":1}\n'), f('{"b":2}\n')])

// 1. 同步 API
console.log(zstdDecompressSync(cat).toString())
// => {"a":1}          ← 第二帧被静默丢弃

// 2. 流式 API
const s = createZstdDecompress()
const out = []
s.on('data', (c) => out.push(c))
await new Promise((r) => { s.on('end', r); s.on('error', r); s.end(cat) })
console.log(Buffer.concat(out).toString())
// => {"a":1}          ← 一样,读完第一帧就 end 了
Node v24.16.0 实测输出:
swift
sync   -> "{\"a\":1}\n"
stream -> "{\"a\":1}\n"
不报错、不警告、静默丢数据 ------这是最坑的地方。如果你的日志解析代码是 zstdDecompressSync(fs.readFileSync(log)),那你在一个 5 万条记录的日志上只会拿到第一条。
二、别人的解法,和我的选择
DSH 官方是怎么绕的?私有 zstd handle + koffi FFI 调 libzstd。有效,但有两个代价:
- 引入原生依赖(koffi 要装二进制)
- 它仍然不知道帧边界在哪------只是把整条流喂给解码器
我想要的其实是"帧在哪里开始、在哪里结束"。而 Zstandard 的帧格式(RFC 8878)是完全公开的结构化格式。那我为什么要问解码器?
三、帧结构拆解(核心部分)
ini
Magic_Number               4 字节   0xFD2FB528(小端,即 28 B5 2F FD)
Frame_Header               2~14 字节
  Frame_Header_Descriptor  1 字节
      bit7-6 Frame_Content_Size_flag
      bit5   Single_Segment_flag
      bit4   未使用
      bit3   Reserved ← 置位就是非法帧,可以直接判损坏
      bit2   Content_Checksum_flag
      bit1-0 Dictionary_ID_flag
  Window_Descriptor        0~1 字节  仅当 Single_Segment_flag = 0
  Dictionary_ID            0/1/2/4 字节
  Frame_Content_Size       0/1/2/4/8 字节
Data_Blocks                直到 Last_Block
  每块 Block_Header        3 字节(小端)
      bit0    Last_Block
      bit1-2  Block_Type  0=Raw 1=RLE 2=Compressed 3=Reserved(非法)
      bit3-23 Block_Size
  Raw / Compressed        后跟 Block_Size 字节
  RLE                     只跟 1 字节(解出 Block_Size 个重复字节)
Content_Checksum 0~4 字节(由 Content_Checksum_flag 决定)走一遍这个结构,就能在不解压一个字节的前提下拿到精确边界。
必须知道的坑:DSH 的帧不带 content size
这是真正决定 API 形状的细节。我 dump 了真实日志的前 1 MiB:
sql
first 1MiB: 2865 frames, 0 declare a content size2,865 个帧里,0 个声明解压后长度。
所以 Frame_Content_Size 必须当可选字段处理。任何"从头部读出解压后大小再分配缓冲区"的实现,在真实 DSH 日志上会直接失效。(这也是为什么 Node 的 maxOutputLength 之类的参数在这里帮不上忙。)
两种边界判断
- RLE 块 :Block_Size 是解压后的长度,磁盘上只有 1 字节 → 游标前进 1
- Raw / Compressed 块 :Block_Size 就是磁盘上的字节数 → 游标前进 Block_Size
我第一版就在这上面栽了,把 RLE 也当成 Block_Size 前进,导致后面全部错位。
四、实现:172 行的遍历器
核心函数就一个·walkFrameAt(buf, offset),返回四种结果:
ts
export type FrameWalk =
  | { kind: 'frame'; span: FrameSpan }                                  // 完整帧
  | { kind: 'incomplete'; start: number; needBytes: number }            // 还差多少字节
  | { kind: 'corrupt'; start: number; reason: string }                  // 损坏,可以重同步
  | { kind: 'eof' }
incomplete 这个返回值是整个设计的关键。 日志是边写边读的,"缓冲区在帧中间结束"是正常状态而不是错误------这个区分让崩溃安全和增量读变成自然结果,而不是补丁。
帧头解析:
ts
const descriptor = buf[offset + 4]!
if ((descriptor & 0x08) !== 0) {
  return { kind: 'corrupt', start: offset, reason: 'reserved bit set' }
}
const fcsFlag = (descriptor >> 6) & 0x03
const singleSegment = (descriptor & 0x20) !== 0
const hasChecksum = (descriptor & 0x04) !== 0
const dictIdFlag = descriptor & 0x03

// FCS 字段宽度,注意 flag=0 时取决于 Single_Segment
const fcsWidth = fcsFlag === 0 ? (singleSegment ? 1 : 0)
               : fcsFlag === 1 ? 2 : fcsFlag === 2 ? 4 : 8
块循环:
ts
for (;;) {
  if (cursor + 3 > buf.length) return { kind: 'incomplete', ... }
  const header = readU24LE(buf, cursor)
  const lastBlock = (header & 0x01) !== 0
  const blockType = (header >> 1) & 0x03
  const blockSize = header >>> 3
  cursor += 3

  if (blockType === 3) return { kind: 'corrupt', reason: 'reserved block type' }
  const payload = blockType === 1 ? 1 : blockSize   // RLE 只占 1 字节
  if (cursor + payload > buf.length) return { kind: 'incomplete', ... }
  cursor += payload
  if (lastBlock) break
}
if (hasChecksum) cursor += 4
五、换来的三个属性(实测)
1. 增量:检查点是一个字节偏移
js
const tailer = new SessionLogTailer(logPath, { from: savedCheckpoint })
const batch = await tailer.poll()
savedCheckpoint = batch.bytesConsumed // 持久化这个,崩了就从这儿续实测:从检查点恢复,读取 0 字节、吐出 0 条重复记录。
2. 有界内存:不随文件增大
js
// 全量读取但完全不保留,测的是"驻留"而不是"分配"
for (;;) {
  const b = await tailer.poll()
  count += b.records.length
  if (global.gc) global.gc()          // 关键:量驻留堆,不是量垃圾
  retained = Math.max(retained, process.memoryUsage().heapUsed - before)
  if (b.atEnd) break
}| 输入 | 记录数 | 驻留堆峰值 |
|---|---|---|
| 20.05 MiB | 53,671 | 34.63 MiB |
| 100.25 MiB(5×,同一份帧拼 5 遍) | 268,355 | 34.99 MiB |
放大 5 倍输入,内存 1.01 倍。 注意测法:不调 global.gc() 量到的是没回收的垃圾(我第一次就量出 107 MiB 的假警报),必须量驻留。
3. 崩溃安全:尾帧暂存 + 损坏重同步
js
// 写一半的尾帧:暂存,检查点停在它的起点
check('checkpoint sits at the partial frame', first.bytesConsumed === one.length)
// 写完之后:读一次,且只读一次
check('partial frame read exactly once when completed', second.records.length === 1)中部损坏时扫下一个帧魔数(28 B5 2F FD)重同步:把 4096 字节清零后再读,损坏前 5,479 帧、损坏后的记录都正常恢复 ,同时报出 1 条 corrupt 诊断。
六、往上叠:执行图谱 + Merkle 完整性
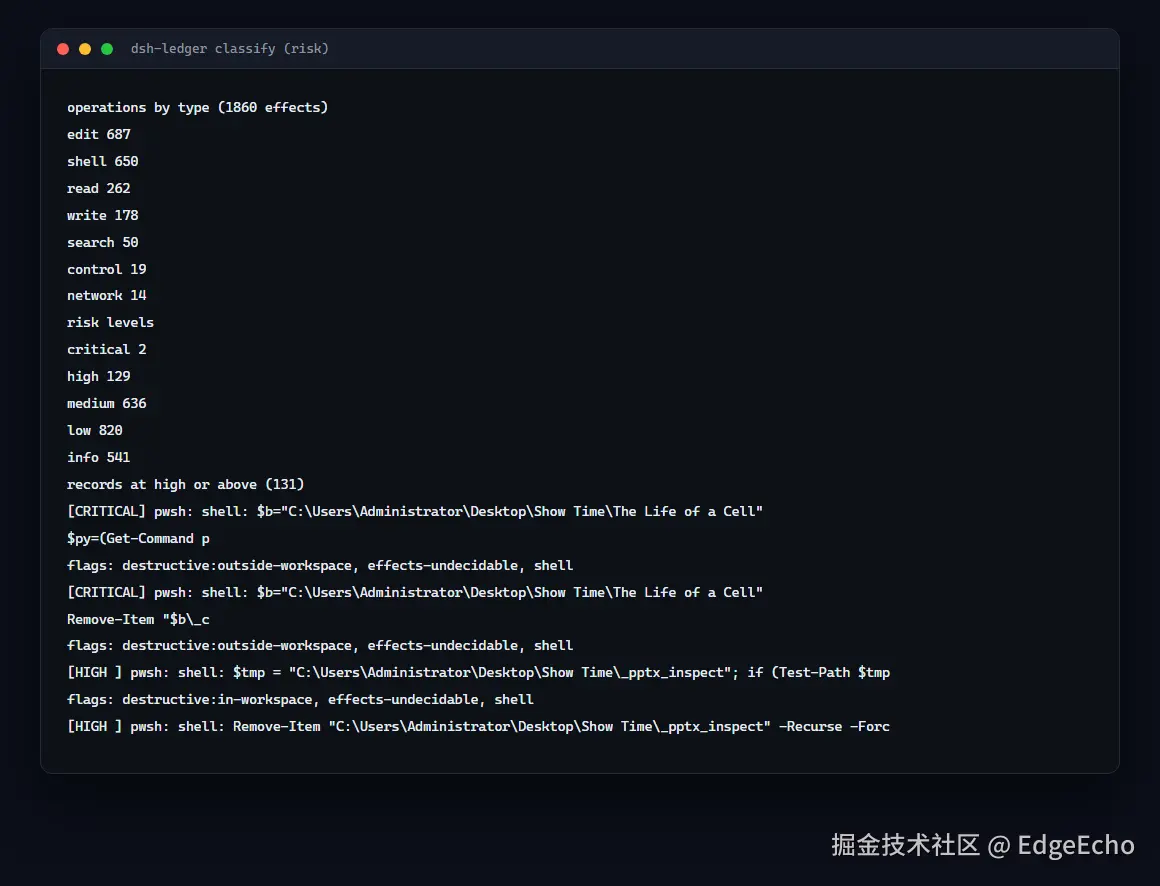
执行图谱(53,671 条记录 → 结构化):
sql
turns=133  calls=1860  paired=1860  errors=72  anomalies=116  files=177
usage: input=1001273 output=2133150 cacheRead=725243008 reasoning=974409
[PASS] every tool call is paired with its result --- 1860/1860
[PASS] every tool call yields an effect --- 1860/1860
[PASS] no tool fell through to unknown --- 0 unknown
Merkle 完整性 (RFC 6962,叶子 SHA-256(0x00‖data)、节点 SHA-256(0x01‖l‖r))。
域分隔那 0x00/0x01 不是装饰:没有它,"把两个子节点的哈希当成叶子提交"就能伪造证明,这是常见的"奇数节点直接上提"实现允许的攻击。我专门写了测试打它:
js
test('a leaf hash cannot be forged from an internal node', () => {
  const node = hashNode(hashLeaf(Buffer.from('a')), hashLeaf(Buffer.from('b')))
  assert.ok(!MerkleTree.verify({ ... }, node, tree.root))
})选择性披露------我觉得最实用的能力:
js
const { manifest, recordTree, records } = await buildManifest(logPath)
const proof = recordTree.prove(index)   // 只要这一条的证明

// 发布:树根 + 记录总数 + 那一条原文 + 证明
MerkleTree.verify(proof, hashLeaf(recordBytes), Buffer.from(manifest.recordRoot, 'hex'))
实测输出:
python
disclosure: 1570 bytes of proof (0.0075% of the log) from 53671 records1,570 字节的证明,覆盖 20 MiB 日志里的某一条记录,其余 53,670 条保持机密。
篡改检测:20 MiB 里翻转 1 字节 → 立刻被发现。同长度换序、截断、追加也都覆盖了。
七、踩坑清单(含 4 个我自己的 bug)
| 坑 | 症状 | 原因 |
|---|---|---|
| 空转死循环 | 测试超时 240s | while (carry.length < budget) 在恰好填满预算时既不读也不消费 |
| 预算边界 | 同上 | 改为"每轮至少读一块",保证前进 |
| 污染判定假阴性 | 650 次 shell 调用 → 判出 0 条污染链 | 判定条件太窄(只在同一 step 内算),真实数据一跑就露馅 |
| 重复解码 | 15.4s → 6.2s | 图表和记录树各解了一遍文件;合并成单遍后 Merkle 根不变(反过来证明语义没改) |
| RLE 块游标 | 后面全部错位 | 把 RLE 的 Block_Size 当成磁盘字节数 |
| 内存测法 | 假警报 107 MiB | 没调 global.gc(),量到的是垃圾不是驻留 |
「Merkle 根不变」这个交叉验证方式我强烈推荐:性能优化前后对比哈希输出,比看一遍 diff 可靠得多。
八、还有哪些没解决
- shell 效应原理上不可判定 :650 次
pwsh全部标undecidable,代价是 177 条文件版本链有 58 条被标"污染"。从命令字符串反推文件效应是把猜测当证据,我没做 - 解码吞吐 ~8 MiB/s :Node 每次
zstdDecompressSync新建上下文(约 45 µs/帧)。4 个 worker +SharedArrayBuffer实测只有 2.0×,没接进去。好在完整性计算不需要解码 edit只有 partial 保真度:日志里没有文件其余部分
九、用法
bash
npm i @edge-echo/dsh-ledger
js
import { readLedger, renderSummary, findSessionLogs, attest, verifyManifest } from '@edge-echo/dsh-ledger'

const [log] = await findSessionLogs()      // 最新的会话日志
const ledger = await readLedger(log.path)
console.log(renderSummary(ledger))

const manifest = await attest(log.path)    // 可发布、可签名、可事后验证
const result = await verifyManifest(suspectPath, manifest)
result.ok         // 任何一个字节被改/被增/被删 → false
result.mismatch   // 'frameRoot' | 'recordRoot' | 'bytes' | 'frames' | 'records'
零原生依赖,Node ≥ 22。
bash
npm run build     # tsc
npm test          # 28 项单测
npm run verify    # 33 项真实日志验收(需 --expose-gc)
总结
- 多帧 zstd 在 Node 里没有现成解法,官方用 FFI 绕,我选了解析帧结构
- 不解压定位边界 → 换来增量、有界内存(5× 输入 1.01× 驻留)、崩溃安全
- DSH 的帧不带 content size,这是真实数据才能发现的坑