前言
现在 Agent 技术的发展日新月异,从通用助手到垂直领域的落地应用,开发者们都在思考:究竟能用它来解决什么真实的痛点?
我想到的一个场景是:传统的"哑巴英语"和枯燥的背诵早已无法满足现代职场的需求。于是,我把目光投向了高沉浸式的英语陪练------让大模型动态生成多种职场英语场景,让练习者与陪练 Agent 进行实时对话;同时,配合教学助理 Agent 在后台对训练者的应答进行多维评估,判断其是否符合特定语境、用词是否得体。通过这种方式,将学习者置身于真实的商务环境中,培养不同场景所需的专业英语表达能力。
那么,这样一个集成了多场景动态切换、Web 语音交互、WebSocket 实时流式响应、业务步骤关卡校验的英语陪练 Agent,究竟是如何从 0 到 1 落地实现的?接下来,我将带大家完整拆解这套系统的架构设计与核心代码实现。
架构设计
业务逻辑
-
行业场景库搭建: 针对不同专业情景建立专属剧本(如:旅游大类对应酒店入住、前台咨询;商务大类对应商务接待、邮件电话沟通;制造大类对应设备故障英文汇报)。
-
AI角色扮演(Role-play) :Agent扮演客户、外国同事或上司,练习者通过语音/输入文字与AI进行多轮对话,消除大庭广众之下开口说英语的羞怯感,提供一个"允许犯错"的安全练习空间。
-
得体度与准确度双维点评:不仅纠正语法错误,还针对职场场景纠正语气(例如将过于生硬的"Give me the report"优化为更地道的"Could you please provide the report?")。
业务流程
-
用户在前端下拉框切换场景 → 配置模块生效。
-
前端切断旧 WebSocket 并以新
scenario_id重新建连 → 通信模块触发。 -
后端识别新会话,双 Agent 模块启动,下发该场景的欢迎语。
-
前端以流式打字机效果渲染欢迎语,并调用 TTS 模块朗读出来。
-
用户点击麦克风通过 ASR 模块语音输入,发送给后端。
-
后端 Agent 校验模块 判断回答达标,通过 WebSocket 返回新通关状态 → 前端状态看板实时点亮下一个 Step
最终效果图
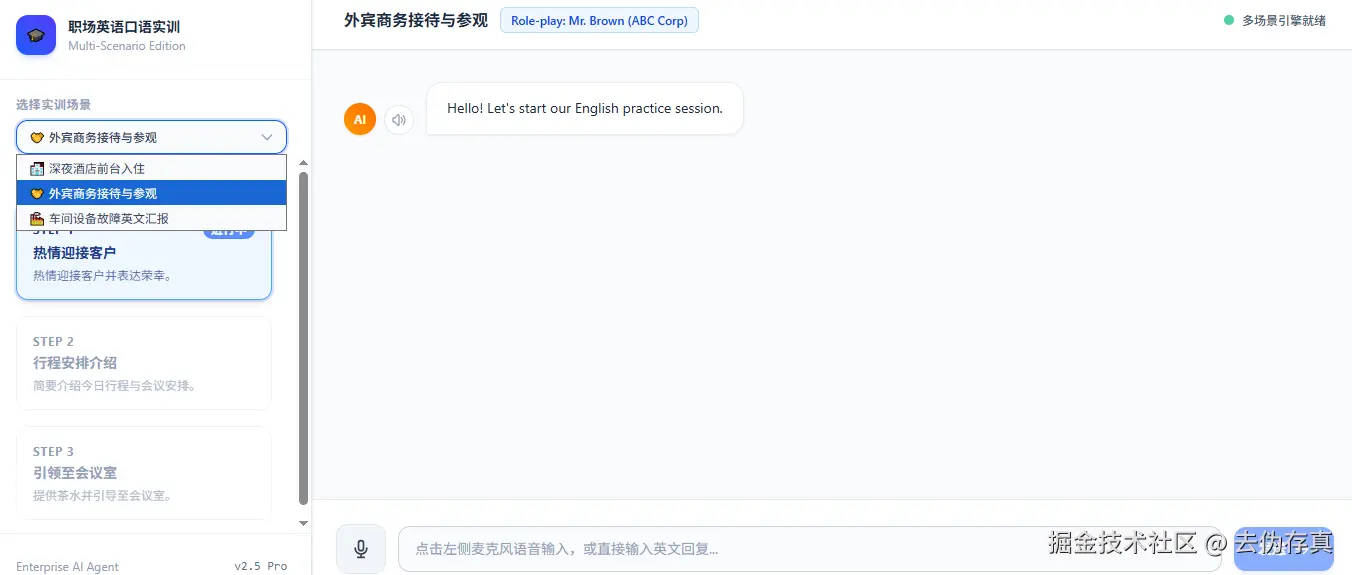
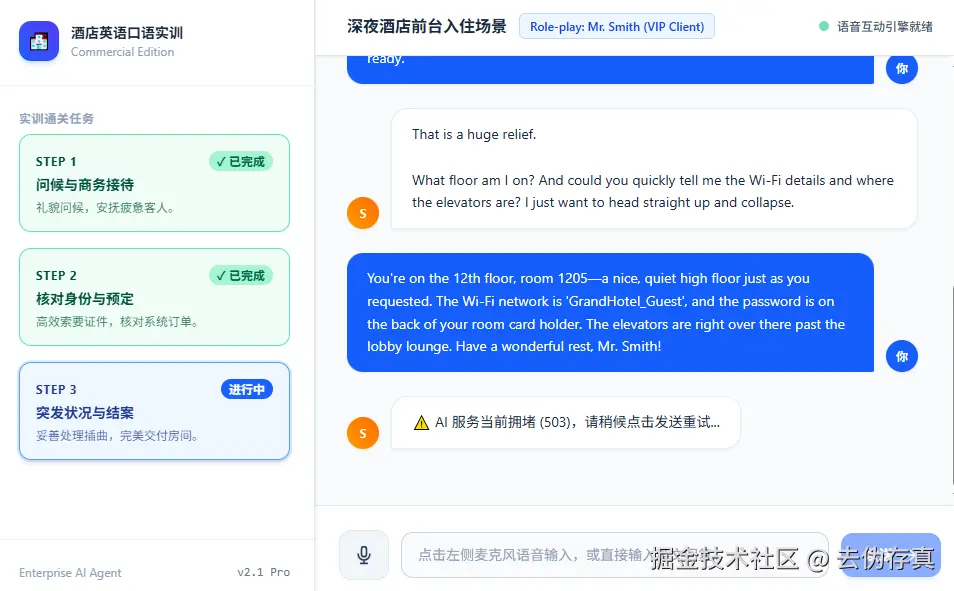
总体架构
先看看整体分层,分为三层, 从上到下为 前端展示层 -> 后端业务层 -> AI能力层,前端展示层和后端业务层通过websocket交互,后端业务层和AI能力层通过API调用通信。
scss
┌──────────────────────────────────────────────────────────────┐
 |                    前端展示层 (React + Tailwind CSS)           |
 |  ┌───────────────┐ ┌────────────────┐ ┌───────────────────┐  |
 |  │ 多场景状态控制 │ │ 语音交互/UI渲染  │ │ 通关任务/进度看板   │  |
 |  └───────────────┘ └────────────────┘ └───────────────────┘  |
 └──────────────────────────────▲───────────────────────────────┘
                                │ WebSocket (双向实时流式通信)
                                ▼
 ┌──────────────────────────────────────────────────────────────┐
 |                    后端业务层 (Python / FastAPI)             |
 |  ┌────────────────────────────────────────────────────────┐  |
 |  │                    WebSocket 路由控制器                 │  |
 |  │  - 动态路由分配 (/ws/chat/{scenario_id}/{user_id})     │  |
 |  │  - 会话状态隔离与上下文管理                            │  |
 |  └───────────────▲────────────────────────▲───────────────┘  |
 |                  │                        │                  |
 |                  ▼                        ▼                  |
 |  ┌──────────────────────────┐   ┌─────────────────────────┐  |
 |  │     陪练对话 Agent       │   │    教学助理校验 Agent   │  |
 |  │ (Role-play 角色扮演驱动) │   │ (任务关卡与业务逻辑判断)  │  |
 |  └──────────────────────────┘   └─────────────────────────┘  |
 └──────────────────────────────▲───────────────────────────────┘
                                │ API 调用
                                ▼
 ┌──────────────────────────────────────────────────────────────┐
 |                    大模型与AI能力层                            |
 |         (LLM Core Engine / TTS & Speech Recognition)         |
 └──────────────────────────────────────────────────────────────┘
核心模块实现
为了让你在撰写技术文章时有血有肉,下面我将结合我们在开发过程中实际编写的代码片段(以 Python/FastAPI 后端和 React 前端为核心),为你深度剖析各个核心功能模块的具体实现逻辑与代码细节。
3.1 场景与状态切换
1. 核心逻辑
后端需要维护一套标准的场景元数据(Metadata),包含每个场景的唯一标识、角色设定(Persona)、初始欢迎语(Initial Greeting)以及通关步骤。当客户端请求建立连接时,后端通过该配置来"初始化"大模型的对话上下文。
2. 代码实现(Python / FastAPI )
Python
# 后端场景配置与初始化数据
SCENARIOS = {
    "factory_fault": {
        "name": "车间设备故障英文汇报",
        "persona": "You are a strict plant supervisor. Listen to the worker's report and evaluate if they follow the standard emergency protocol.",
        "initial_greeting": "Hello! Urgent notice: Line 2 main machine suddenly stopped working and the control panel is showing error code E-404!",
        "steps": [
            {"id": 1, "name": "紧急汇报异常", "desc": "向主管紧急汇报设备异常状况。"},
            {"id": 2, "name": "解释初步原因", "desc": "分析并说明初步故障原因。"},
            {"id": 3, "name": "提出维修方案", "desc": "提出维修方案与预计恢复时间。"}
        ]
    },
    # 其他场景配置...
}
3.2 实时全双工通信模块
1. 核心逻辑
为了实现大模型输出的"打字机流式效果(Streaming)",我们不能使用传统的 HTTP 短连接,必须采用 WebSocket。后端通过 FastAPI 的路由动态捕获 scenario_id 和 user_id,建立持久化双向通道。
2. 代码实现(后端 WebSocket 路由接收与下发)
Python
from fastapi import FastAPI, WebSocket, WebSocketDisconnect

@app.websocket("/ws/chat/{scenario_id}/{user_id}")
async def websocket_endpoint(websocket: WebSocket, scenario_id: str, user_id: str):
    await websocket.accept()

    # 1. 根据 scenario_id 加载对应场景配置
    scenario = SCENARIOS.get(scenario_id)

    # 2. 发送初始欢迎语的流式响应
    await websocket.send_json({"type": "start"})
    for chunk in stream_llm_response(scenario["initial_greeting"]):
        await websocket.send_json({"type": "chunk", "content": chunk})
    await websocket.send_json({"type": "end", "current_step": scenario["steps"][0]})

    try:
        while True:
            # 3. 接收用户输入并持续交互
            data = await websocket.receive_text()
            # 处理用户输入、调用 Agent 校验、返回流式响应...
    except WebSocketDisconnect:
        print(f"User {user_id} disconnected from {scenario_id}")
3. 前端 WebSocket 监听与重连联动
前端通过监听 selectedScenario 的变动,在用户切换场景时自动销毁旧连接并创建新连接:
js
useEffect(() => {
  const uniqueUserId = `student_${selectedScenario}`;
  const ws = new WebSocket(`ws://localhost:8000/ws/chat/${selectedScenario}/${uniqueUserId}`);

  ws.onmessage = (event) => {
    const data = JSON.parse(event.data);
    if (data.type === "start") {
      setIsStreaming(true);
      setMessages((prev) => [...prev, { role: "assistant", content: "" }]);
    } else if (data.type === "chunk") {
      // 实时拼接流式文本,实现打字机效果
      setMessages((prev) => {
        const lastMsg = prev[prev.length - 1];
        const updated = [...prev];
        updated[updated.length - 1] = { ...lastMsg, content: lastMsg.content + data.content };
        return updated;
      });
    } else if (data.type === "end") {
      setIsStreaming(false);
      // 触发朗读或步骤更新
    }
  };

  return () => ws.close();
}, [selectedScenario]);
3.3 双 Agent 协同与关卡校验模块
1. 核心逻辑
传统的聊天机器人是"无状态"的。而英语陪练 Agent 需要扮演双重角色:
-
角色扮演(Role-play) :用 Prompt 约束大模型表现出对应岗位的语气(如严厉的主管)。
-
任务校验(Evaluation) :暗中判断用户的回答是否命中了当前 Step 的业务关键词(例如是否说出了"error code E-404"或"maintenance plan")。如果达标,则在
type: "end"时返回下一个current_step。
2. 代码实现(后端逻辑判断与状态流转伪代码)
Python
def evaluate_user_response(user_input, current_step_id):
    # 利用轻量级大模型或规则匹配校验用户的回答是否符合当前关卡要求
    if current_step_id == 1 and ("stopped" in user_input.lower() or "broken" in user_input.lower()):
        return {"passed": True, "next_step": 2}
    elif current_step_id == 2 and ("reason" in user_input.lower() or "cause" in user_input.lower()):
        return {"passed": True, "next_step": 3}
    return {"passed": False, "next_step": current_step_id}
3.4 多模态语音交互模块(ASR & TTS 闭环)
1. 核心逻辑
为了彻底摆脱纯文字聊天的枯燥感,我们利用浏览器原生的 Web APIs(无需引入复杂的第三方 SDK),打通了前端的"语音转文字(ASR)"与"文字转语音(TTS)"闭环。
2. 代码实现(前端 Web Speech API 集成)
- 语音输入(ASR - 麦克风识别) :
js
const startListening = () => {
  const SpeechRecognition = window.SpeechRecognition || window.webkitSpeechRecognition;
  if (!SpeechRecognition) {
    alert("您的浏览器不支持语音识别");
    return;
  }
  const recognition = new SpeechRecognition();
  recognition.lang = 'en-US'; // 设置识别英文
  recognition.onresult = (event) => {
    const transcript = event.results[0][0].transcript;
    setUserInput(transcript); // 自动填入输入框
  };
  recognition.start();
};- 语音输出(TTS - AI 自动朗读) :
js
const speakText = (text) => {
  if ('speechSynthesis' in window) {
    window.speechSynthesis.cancel(); // 停止之前的朗读
    const utterance = new SpeechSynthesisUtterance(text);
    utterance.lang = 'en-US';
    utterance.rate = 1.0; // 语速
    window.speechSynthesis.speak(utterance);
  }
};
当 WebSocket 收到后端传来的 type: "end" 信号时,自动调用 speakText(lastMsg.content),从而实现"AI 说完话 → 用户按麦克风说英语 → 后端校验并流式回复 → AI 自动语音朗读"的完美全双工闭环。
结语
单纯调用大模型 API 并不难,难的是如何通过工程化手段,将文本交互包裹进具备业务逻辑、正向反馈和沉浸式体验 的产品壳子中。大模型时代的真正魅力,在于让开发者能够将创意快速转化为高价值的 AI 原生应用。希望这篇从 0 到 1 的技术拆解,能为你构建自己的垂直 Agent 提供有价值的启发与代码参考。完整代码已上传到码云,欢迎交流。