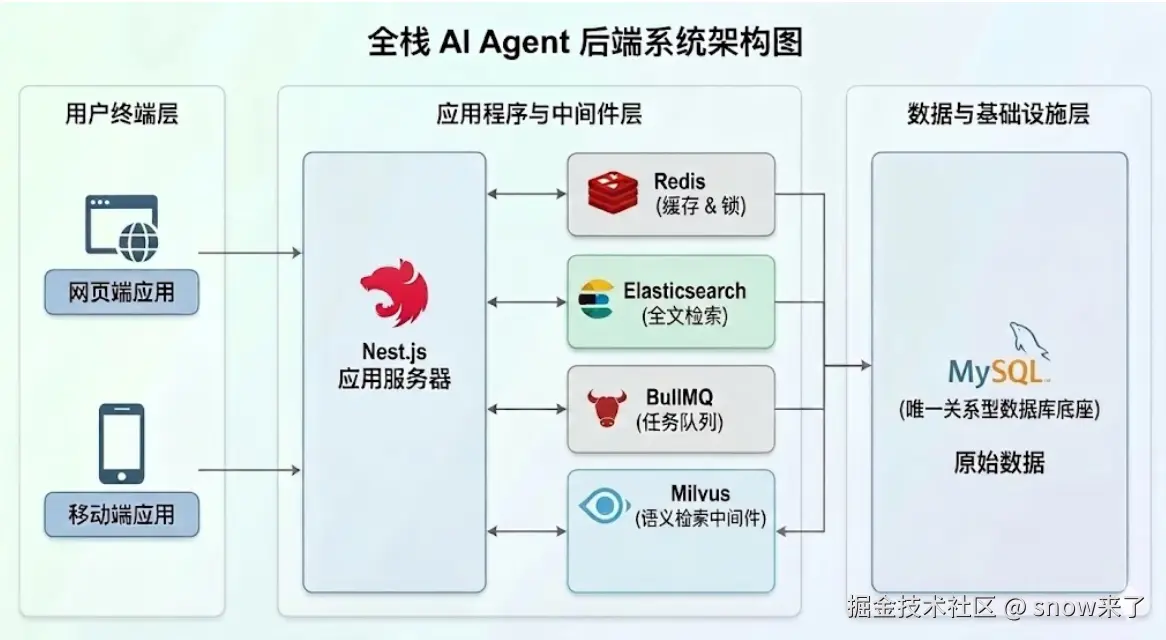
在开发 agent 的时候遇到两个数据库:mysql 和 milvus。
如果说数据库是业务的基石,负责持久化存储原始业务数据,比如 MySQL 存用户信息,milvus存储公司文档。核心要求是稳健、不丢失。
那么数据库和业务代码之间就需要一个中间件去跑腿,把数据库里面的数据快速且安全地在两方之间进行搬运,用来弥补数据库和业务代码的不足。这个中间件就是Elasticsearch 和 Redis。
而 redis 专门做缓存、es 做全文检索、milvus 做语义检索、、bullmq 做消息队列,是用于专门的用途,各司其职、专精专用,它们不是原始数据,丢了也不影响数据完整性。
-
检索补足:
MySQL不擅长全文模糊搜索,我们就引入Elasticsearch专门做高性能检索 -
性能不足:核心数据库读写磁盘太慢,我们就用
Redis这种内存级中间件来做高速缓存 -
异步补足:业务逻辑处理太耗时,我们就用
RabbitMQ或BullMQ这类消息队列中间件来做任务缓冲和解耦。
一.Docker Compose是什么?
Docker Compose = 用一份配置文件,定义并管理一组 Docker 容器。
- Docker:管单个容器
- Docker Compose:管多个容器之间的关系
一个项目要运行起来需要数据库,后端服务,前端服务等诸多应用,在docker里面,如果你一个一个run 那么,他很容易出错。
Docker Compose 把这些需要启动的应用对应的端口号,位置等信息,全部写进一个文件里面进行管理。只要运行这个文件,系统里面对应的应用就能按照一定的顺序,挨个启动起来。
Docker Compose的好处
✅ 一键启动整个系统
✅ 自动创建网络(容器之间可直接用服务名通信)
✅ 管理启动顺序(depends_on)
✅ 数据持久化(Volume)
✅ 环境变量集中管理
✅ 本地开发 / 测试环境一致性
docker-compose.yml
在项目里面你创建一个文件:docker-compose.yml,写上类似下面的代码,你可以在package.json里面配置具体的运行命令,然后用npm运行即可。
js
version: "3.9"

services:
  web:
    image: my-app:latest
    ports:
      - "8080:8080"
    depends_on:
      - es

  es:
    image: docker.elastic.co/elasticsearch/elasticsearch:8.13.0
    environment:
      - discovery.type=single-node
    ports:
      - "9200:9200"
    volumes:
      - es_data:/usr/share/elasticsearch/data

volumes:
  es_data:
为什么生产环境最终要上 Kubernetes?
核心原因一句话:Docker Compose 解决的是"怎么把多个容器跑起来",Kubernetes 解决的是"怎么让这些容器在生产环境里长期、稳定、自动地跑下去"。
对比 docker 和 Kubernets之间的区别。
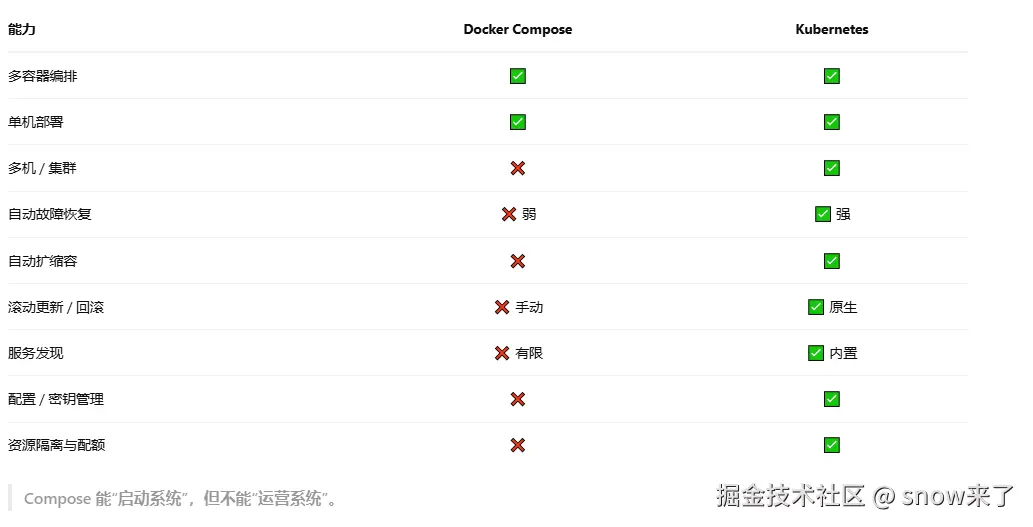
Kubernetes 持续做一件事:"让集群的实际状态,无限逼近你期望的状态。"
K8s 是 Kubernetes 的缩写
Docker Compose 是"把系统跑起来",Kubernetes 是"让系统在生产环境里活着、活好、活稳"。当服务数量、流量、可用性要求超过单机能力时,Kubernetes 就是自然选择。
二.ElasticSearch是什么?
Elasticsearch(简称 ES)是一个开源的分布式搜索与分析引擎 ,最核心的能力是:让你在海量数据里快速全文检索、过滤、聚合统计 ,并且能水平扩展、高可用。它底层基于 Apache Lucene ,但把 Lucene 的复杂性包装成了易用的 REST API。
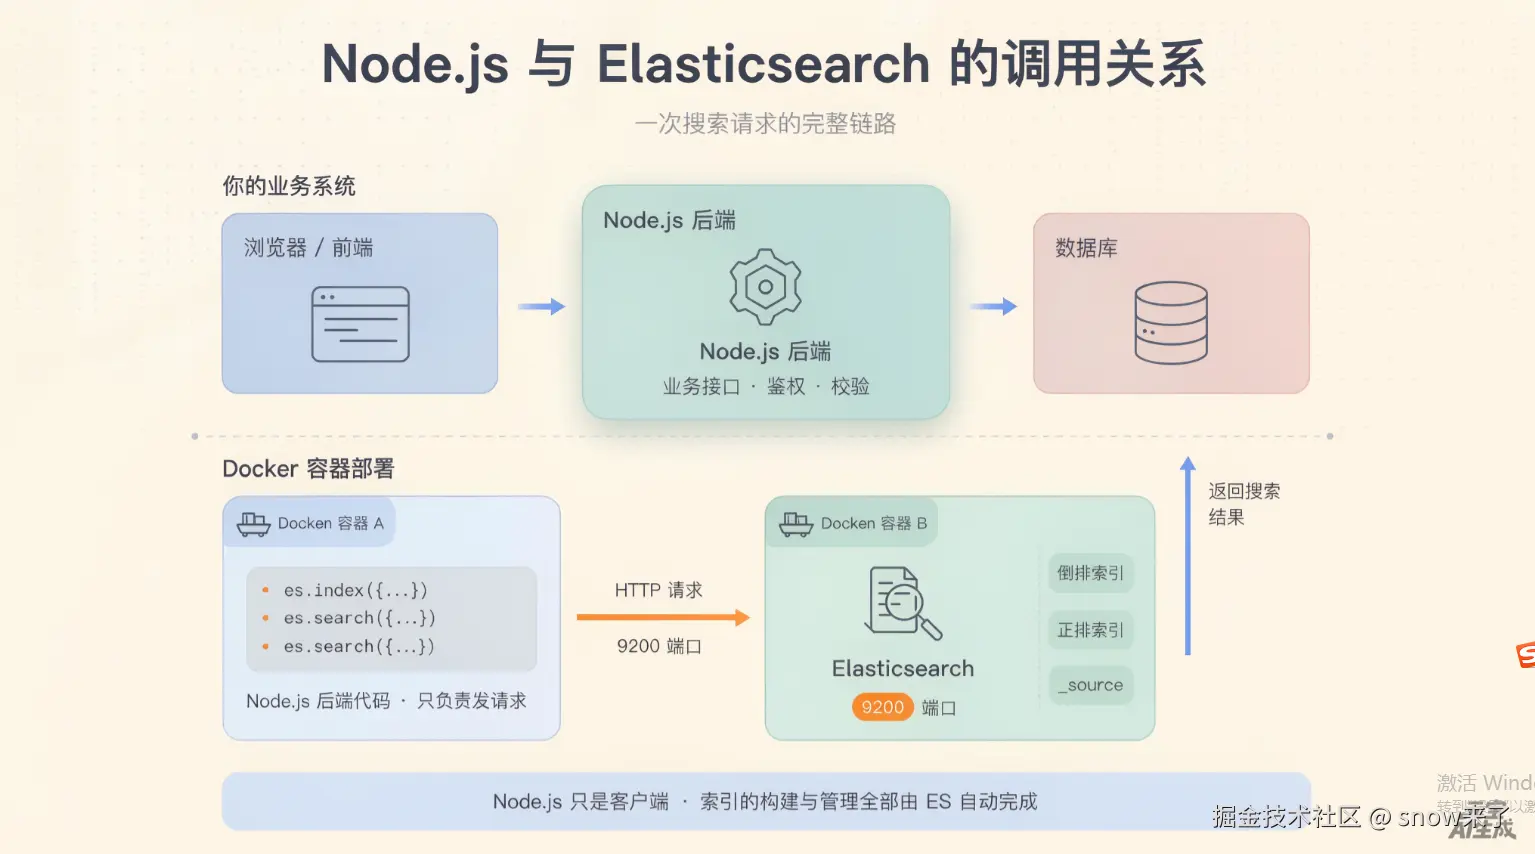
ES 是 Elasticsearch 的缩写,说白了他就是一个独立的 ,端口号是 9200 的 Web 服务。nodejs业务代码要想用它就发送htpp请求就好了。
Elasticsearch = 分布式的、实时的、支持全文检索的数据存储 + 分析系统。
1.Elasticsearch的特点
- 像 数据库(能存数据、能查数据)
- 但更擅长 模糊搜索、全文检索、相关性排序
- 同时又像一个 实时分析引擎(聚合、统计、监控)
2.Elasticsearch 能做什么
由于普通
MySQL使用的是正向索引:以一行为单位存储完整数据,检索文本内容时,需要逐行遍历、逐个字段匹配内容。数据量越大、文本越长,模糊 / 全文搜索就越慢,性能极差,并不适合大范围关键词检索。为了解决这个问题,就产生了 ES。
Elasticsearch采用倒排索引机制,会自动对text类型字段进行分词处理,拆解为一个个独立词条,再以「词条」为核心,反向关联所有包含该词条的文档。
"倒排"是相对"正排"说的------正排是"按文档找词"(这是文档里有哪些词),倒排是"按词找文档"(这个词在哪些文档里)。
ES 是一个独立运行的服务 ,跟你的 Node.js等 后端代码是彻底解耦的两回事。所以不管后端语言怎么换,都不影响ES的运行。
如何理解后端业务代码、ES、数据库之间的关系?
你把 ES 想成一个专门干搜索的"外包团队" :
- 你(Node.js)只需要把资料交给它,再向它问问题
- 它内部怎么建目录、怎么归档、怎么查档案,你完全不用管
- 你们之间只有一个对接窗口(9200 端口的 HTTP 接口)
所以说,ES 装在 Docker 里独立运行,它产生的那一堆倒排索引、正排索引、原始 JSON,全部由 ES 自己管理,跟 Node.js 后端代码没有任何关系。 。
3.ES流水线组成部分
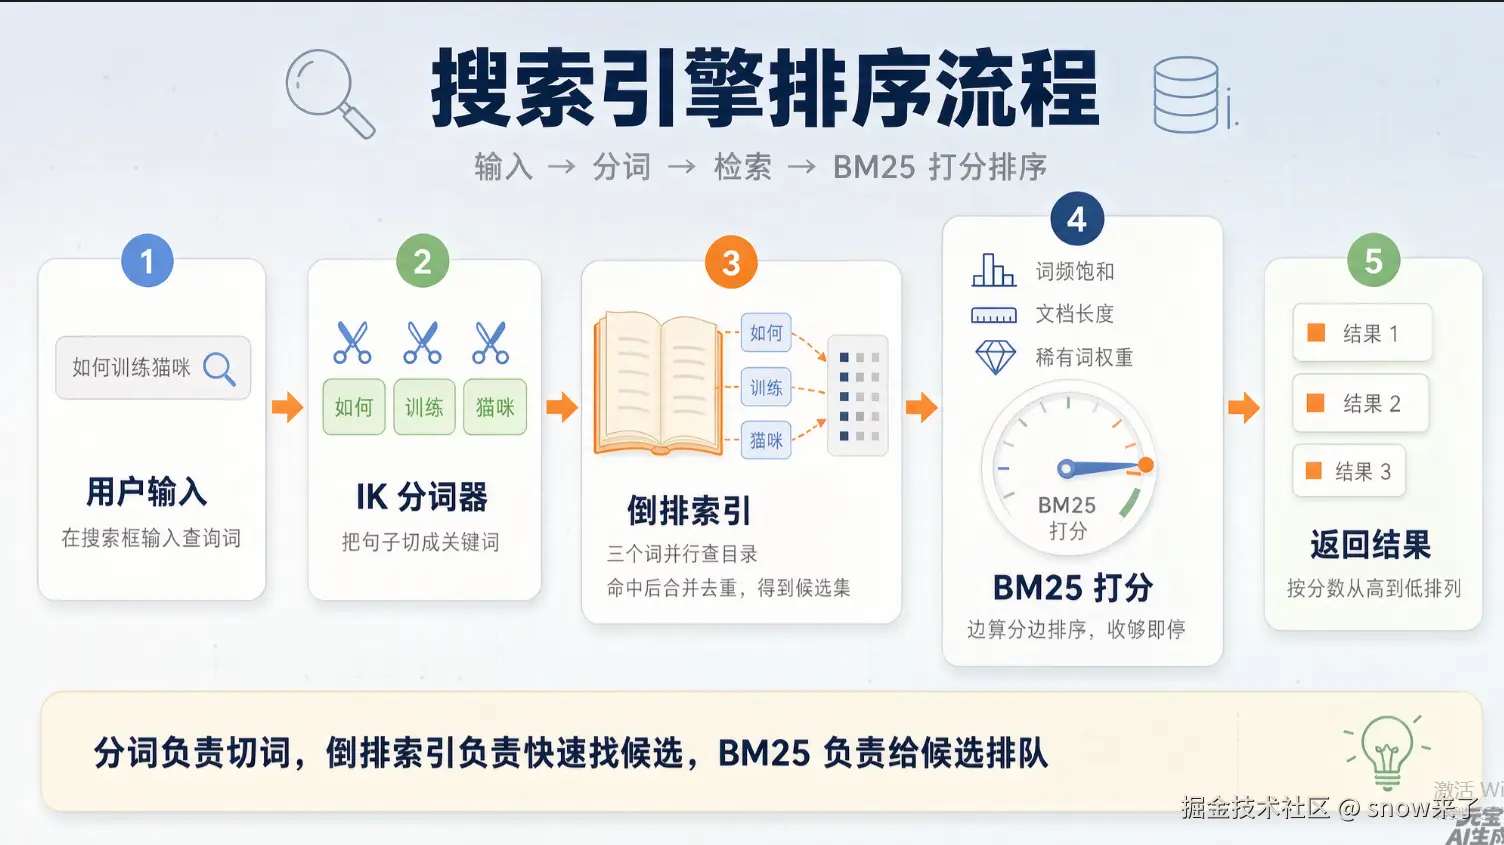
在ES流水线上:IK 分词器、倒排索引、BM25 是理解 ES 的"铁三角",也是这条流水线上的三个工位:
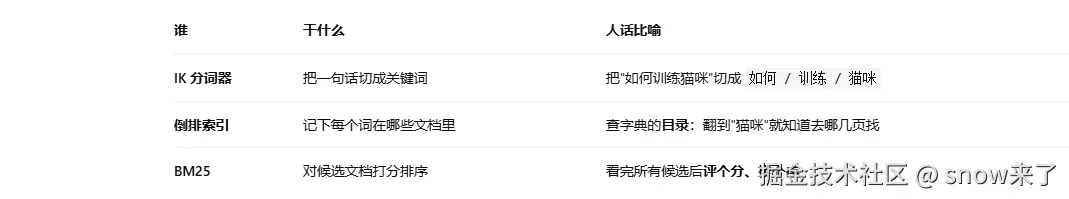
举个例子:你在搜索框输入"如何训练猫咪" → IK 分词器 把它切成"如何 / 训练 / 猫咪" → 拿着这三个词同时 去倒排索引查目录,各自拿到一批文档,合并去重 → 拿到一批候选后,BM25 在收集的过程中就按"词频会腻、长文打折、稀有词值钱"给每条算分,分数高的先收 → 收够就停,最终按分数从高到低排给你。
上面说的"倒排索引查目录"这个目录是存数据的时候是 Elasticsearch 自己建的,那张表是在你存数据那一刻就生成好的,之后一直躺在磁盘上。当你存数据的时候,Elasticsearch就已经把这条信息的关键信息,搜录到他的目录里面了,目的就是为了你在搜索的时候能够快速搜出来。
案例流程图如下:
4.如何使用ES
4.1 安装docker,
4.2 拉取ES
js
docker pull elasticsearch:8.15.04.3 运行ES
js
docker run -d -p 9200:9200 --name es \
  -e "discovery.type=single-node" \
  -e "xpack.security.enabled=false" \
  elasticsearch:8.15.0
验证是否起来了
js
curl localhost:92004.4 安装 IK 插件
因为 ES 对中文的分词效果不好,他会将"连衣裙"分成"连""衣""裙",一个汉字一组,所以用 IK 插件。
js
docker exec -it es bin/elasticsearch-plugin install \
  https://release.infinilabs.com/analysis-ik/stable/elasticsearch-analysis-ik-8.15.0.zip
docker restart es
4.5创建索引
js
curl -X PUT "localhost:9200/articles" -H "Content-Type: application/json" -d '{
  "mappings": {
    "properties": {
      "title":   { "type": "text", "analyzer": "ik_max_word" },
      "content": { "type": "text", "analyzer": "ik_max_word" },
      "author":  { "type": "keyword" }
    }
  }
}'
4.6 在nodejs里面使用
js
npm install @elastic/elasticsearch

import { Client } from '@elastic/elasticsearch'

const es = new Client({
  node: 'http://localhost:9200',   // ES 的地址
  // 如果 ES 设了密码:
  // auth: { username: 'elastic', password: 'xxx' }
})

await es.ping()   // 探活,能通就说明对接成功
4.7 在nodejs里面进行增删改查操作
BM25是ES内部自己做的,当ES查询返回数据的时候,他就会把BM25返回的评分值返回出来。
js
//添加
await es.index({
  index: 'articles',
  id: '1',                         // 可选,不传 ES 自动生成
  document: {
    title: '如何训练猫咪',
    content: '训练猫咪需要耐心,正向强化比惩罚更有效。',
    author: '小明'
  }
})

await es.indices.refresh({ index: 'articles' })  // 强制刷新,让刚存的能立刻搜到

//搜索
const { hits } = await es.search({
  index: 'articles',
  query: {
    match: { content: '如何训练猫咪' }   // 会自动分词,再去倒排表查
  },
  size: 10,                             // 只要前 10 条
  highlight: { fields: { content: {} } } // 让关键词在结果里高亮
})

hits.hits.forEach(hit => {
  console.log(hit._score, hit._source.title)  // _score 就是 BM25 算出来的分
})
5.ES的数据存在哪里?
ES运行在docker里面,他的数据存在docker内部的/usr/share/elasticsearch/data
如果docker重启后,ES的数据会怎么样?
| 操作 | 数据是否保留 | 原因 |
|---|---|---|
docker restart es(重启) |
✅ 不丢 | 同一个容器,内部文件系统原封不动 |
docker stop / start |
✅ 不丢 | 同上 |
docker rm es 后重新 run |
❌ 丢了 | 旧容器被删,新容器是全新的,data 目录跟着没了 |
| 宿主机重启 | ✅ 不丢 | 只要容器没被删除 |
ES 数据默认写在容器内
/usr/share/elasticsearch/data,容器重启不丢、删除就丢。生产环境必须用 **-v 卷名:/usr/share/elasticsearch/data** 挂个数据卷,把数据落到宿主机,这样哪怕容器整个删了重建,数据也还在。
三. 嵌入模型
在实际的大模型应用里面,RAG的语义检索并不好用,搜出来的结果差强人意,为了弥补这个不足,我们用ElasticSearch 关键词检索来配合,打出一套组合拳。这就是混合检索框架。
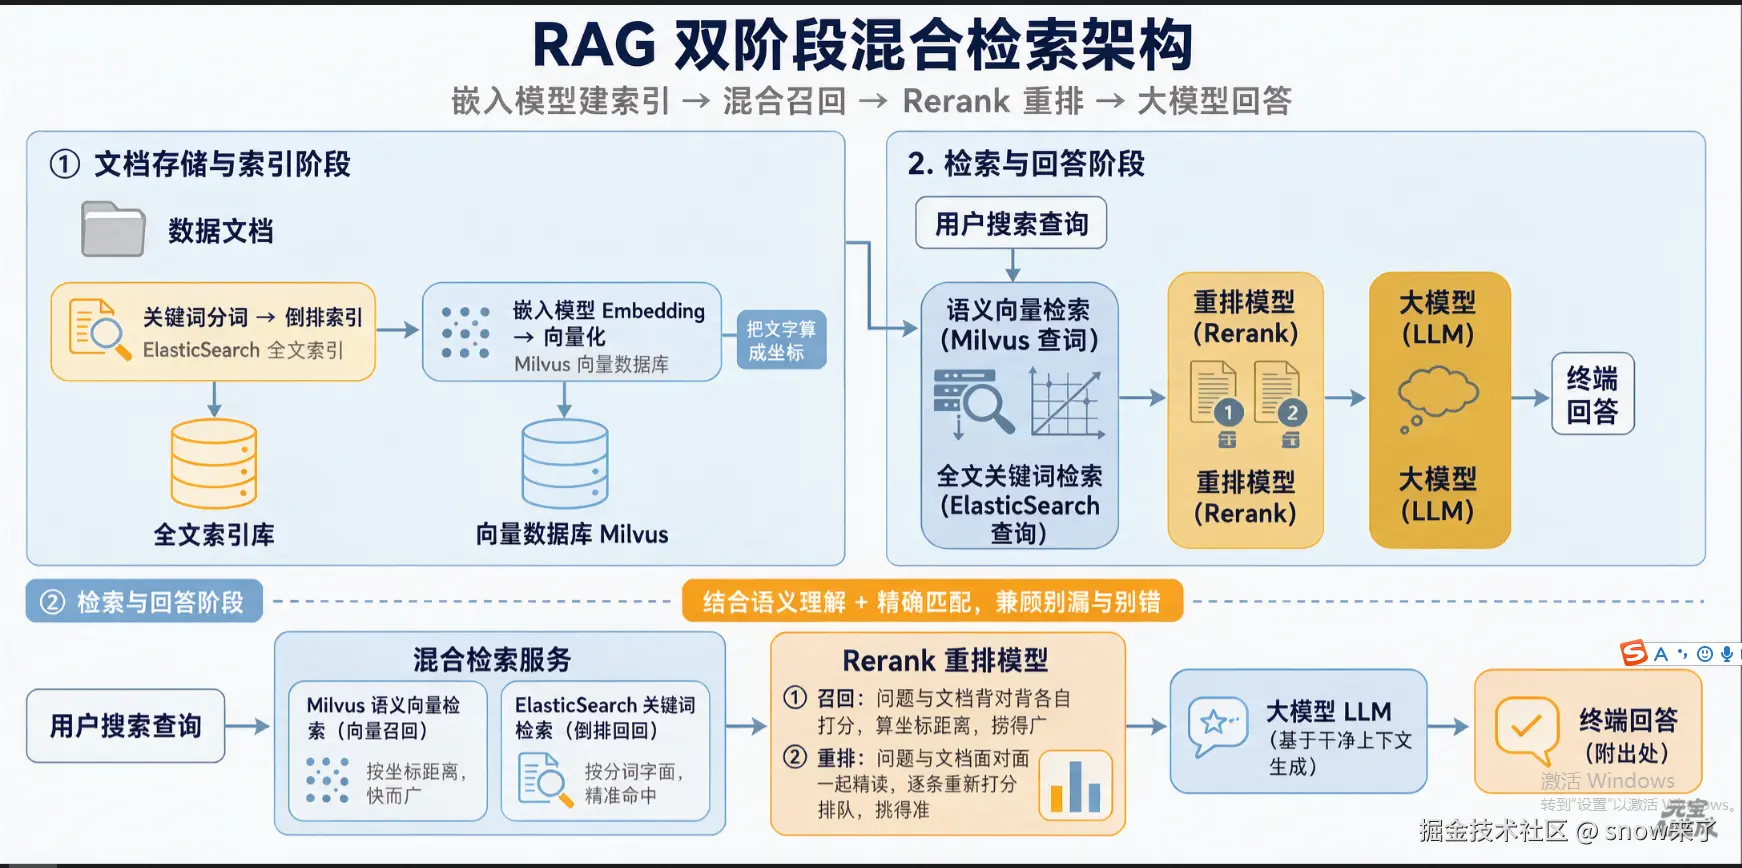
解释嵌入模型
首先需要搞清楚的是:老版本的milvus里面存储的是向量和文档id,不存储文档,文档是在mysql里面存储的。也就是说我通过余弦相似度拿到文档id以后,去mysql里面搜id对应的文档,然后把文档给大模型思考。
现在的新版本milvus3.0支持text类型,可以往里面存储文档,所以你的文档是可以放在text里面的,这样就少了一步通过id去mysql里面搜索文档的过程。
一般企业应用里面用的都是将文档存在mysql里面,这样的好处是减轻milvus的压力,方便文档更新。
在一般案例里面你可以将文档直接存到milvus里面,方便学习,但是当数据量很大的时候,向量数据库的体积增大,读写的开销就会变大。
嵌入模型是 Embedding,他是做语义理解的。
嵌入模型在大模型和milvus之间会用到两次,一次是保存数据的时候,一次是milvus查询的时候。
向milvus保存数据的步骤
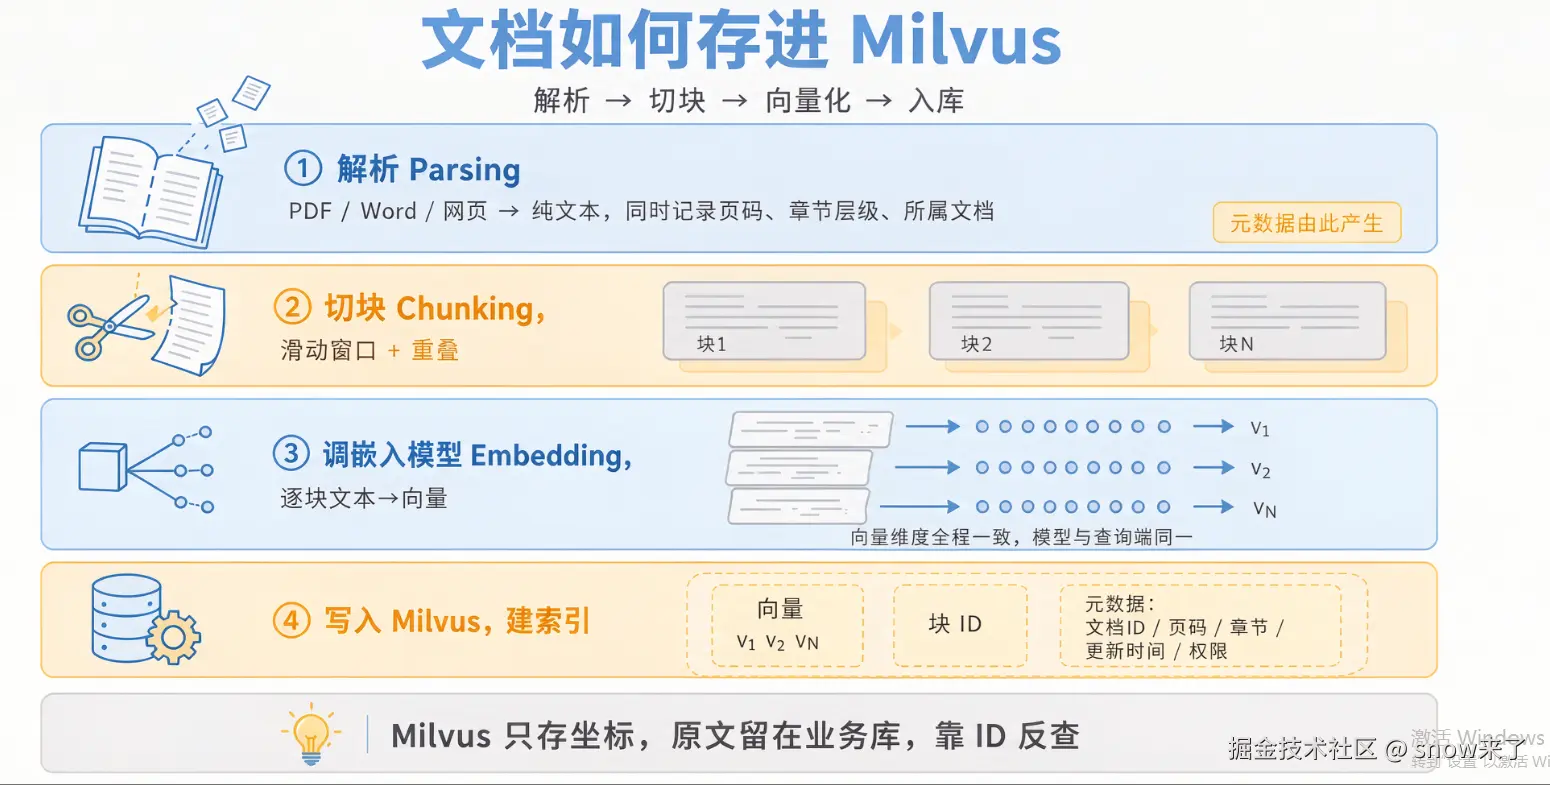
1.将文件转化成纯文本
利用下面工具将各种形式的文件提取成纯文本。
pnpm add pdf-parse mammoth xlsx unzipper
js
// document-parser.service.ts
import { Injectable, Logger } from '@nestjs/common';
import * as pdfParse from 'pdf-parse';
import * as mammoth from 'mammoth';
import * as xlsx from 'xlsx';
@Injectable()
export class DocumentParserService {
private readonly logger = new Logger(DocumentParserService.name);
async parse(buffer: Buffer, mimeType: string): Promise<string> {
try {
switch (mimeType) {
case 'application/pdf':
return this.parsePdf(buffer);
case 'application/vnd.openxmlformats-officedocument.wordprocessingml.document':
return this.parseDocx(buffer);
case 'application/vnd.openxmlformats-officedocument.spreadsheetml.sheet':
return this.parseXlsx(buffer);
case 'text/html':
return this.parseHtml(buffer);
case 'text/markdown':
case 'text/plain':
return buffer.toString('utf-8');
default:
throw new Error(`不支持的文件类型: ${mimeType}`);
}
} catch (err) {
this.logger.error(`解析失败 [${mimeType}]: ${err.message}`);
throw err;
}
}
private async parsePdf(buffer: Buffer): Promise<string> {
const result = await pdfParse(buffer);
return result.text;
}
private async parseDocx(buffer: Buffer): Promise<string> {
const { value: html } = await mammoth.convertToHtml({ buffer });
return html
.replace(/<table[\s\S]*?<\/table>/g, '\n[表格]\n')
.replace(/<[^>]+>/g, '\n')
.replace(/\n{2,}/g, '\n')
.trim();
}
private parseXlsx(buffer: Buffer): string {
const wb = xlsx.read(buffer);
return wb.SheetNames
.map(name => {
const sheet = wb.Sheets[name];
return `=== ${name} ===\n` + xlsx.utils.sheet_to_csv(sheet);
})
.join('\n');
}
private parseHtml(buffer: Buffer): string {
return buffer
.toString('utf-8')
.replace(/<script[\s\S]*?<\/script>/g, '')
.replace(/<style[\s\S]*?<\/style>/g, '')
.replace(/<[^>]+>/g, '\n')
.replace(/ /g, ' ')
.replace(/\s{2,}/g, ' ')
.trim();
}
}2.切片
利用工具给文本切片,一般会切成500字一块,前后50字和上面切片重复,以免对不上号。
将ids更新到mysql的事情也是在这里做的。
pnpm add @langchain/textsplitters
js
// chunker.service.ts
import { Injectable } from '@nestjs/common';
import { RecursiveCharacterTextSplitter } from '@langchain/textsplitters';

@Injectable()
export class ChunkerService {
  // 图上说的"500字一块,重叠50字"正好对应这两个参数
  private readonly splitter = new RecursiveCharacterTextSplitter({
    chunkSize: 500,      // 每块目标字符数(≈字数)
    chunkOverlap: 50,    // 相邻块重叠字符数,防止句子被劈断
  });

  async split(text: string): Promise<string[]> {
    return this.splitter.splitText(text);
  }
}
3.用嵌入模型生成向量
调嵌入模型的embedding_model.encode,将文本块生成向量值,id,还有章节信息,他们都是数组。
文章片段的权限,对应的章节等信息都是在这一节处理好,保存到milvus里面的。
js
// 逐块向量化
const vectors = [];
for (const chunk of chunks) {
  const vector = await embedding_model.encode(chunk.text);
  vectors.push(vector);
}

// 组装 ids 与 payloads
const ids = [];
const payloads = [];
for (let i = 0; i < chunks.length; i++) {
  const chunk = chunks[i];

  ids.push(`${chunk.document_id}_${i}`);
  payloads.push({
    document_id: chunk.document_id, // 自己带的
    page:         chunk.page,        // 解析时记下的
    chapter:      chunk.chapter,    // 解析时记下的
    updated_at:   now(),            // 代码现打的
    permission:   get_acl(chunk),   // 查权限系统
  });
}
4.向 Milvus写入数据
第三步骤生成了三个数组,他们的下标都是一样的,所以直接塞进insert里面即可。
js
// 写入 Milvus,
milvus.insert([ids, vectors, payloads]);
他们会一组一组地进入数据。 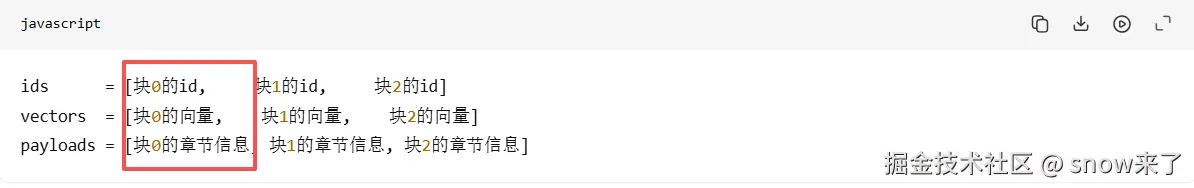
查询milvus的步骤
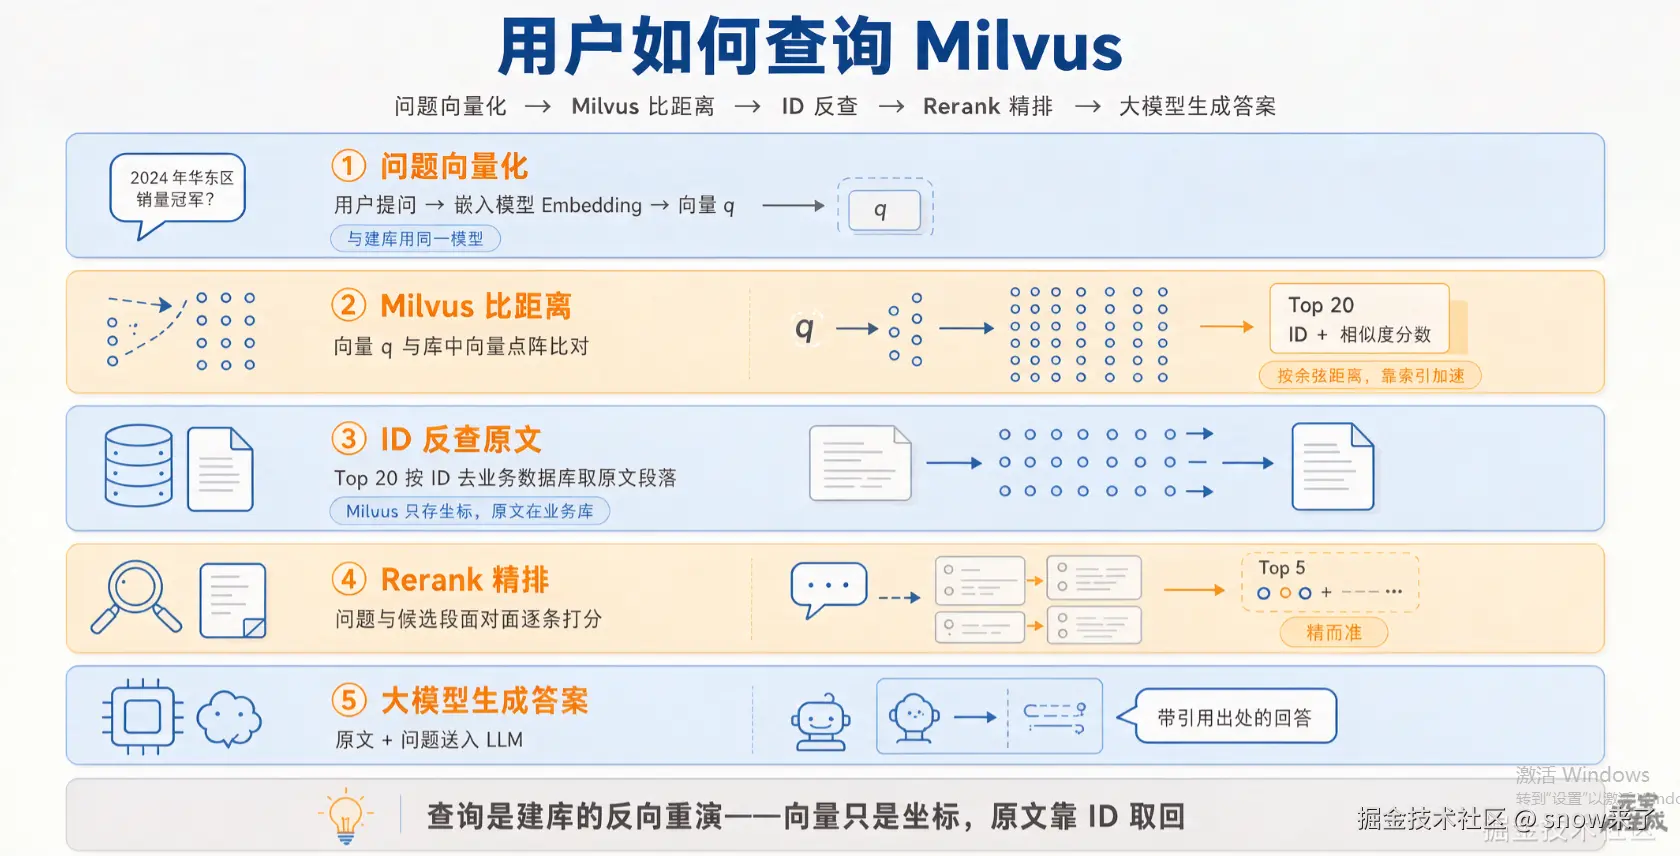
我们还没有学习重排模型可以直接跳过。流程就变成了,用户输入问题,嵌入模型将问题转化成向量,利用milvus的api去向量数据库里面搜索对应的值。他会返回一组符合条件的 id 数组,我们根据id数据去mysql拿对应的文档。拿到文档都给大模型处理就好了
1.向量化问题
利用嵌入模型将问题向量化
js
const queryVector = await embedding_model.encode("2024年华东区销量冠军是哪款?");
// 输出: [0.12, -0.45, 0.88, ...]  1536 维
2.利用milvus的api搜索相似值
Milvus 里的真实动作:不是"搜索",是"比距离",利用相似性给出对应文档的id
js
const searchResult = await client.search({
  collection_name: COLLECTION_NAME,
  data: [queryVector],        // 注意是数组,支持一次搜多个向量
  limit: 20,                  // 只要前 20 条
  output_fields: ['document_id', 'page', 'chapter', 'permission'],
  filter: 'permission == "public"',  // 可以先过滤,比如只搜有权限的
});
返回的数据如下:
js
searchResult = [
  {
    id: "doc_001_17",      // 命中的是 doc_001 的第 17 块
    score: 0.87,            // 相似度分数,越接近 1 越像
    document_id: "doc_001",
    page: 23,
    chapter: "第三章 > 第二节",
    permission: "public"
  },
]
3.拿文档
js
const ids = searchResult.map(r => r.id);

// 去mysql里面拿文档
const contents = await db.query(
  'SELECT id, text, title FROM document_chunks WHERE id = ANY($1)',
  [ids]
);
四.重排模型
重排模型是什么
重排的意义是嵌入模型漏掉了正确答案 ,重排负责把它捡回来
- 嵌入模型(Bi-Encoder) :问题和文档各走各的编码器,互不看对方,最后比距离
- 重排模型(Cross-Encoder) :把问题跟文档拼成一条输入,一起送进同一个编码器,模型能注意到两者的每个词之间的关联
重排模型 = 把问题和每条候选拼一起精读打分。 它比嵌入模型准得多,但因为它必须逐条配对计算、所以慢且贵,只能放在嵌入模型粗筛之后当「最后一公里」用------把 Top 100 里的正确答案顶到 Top 5。
重排是拿着问题和嵌入模型搜出来的答案一个一个地再次核对,提高准确性。重排模型是输入用户问题 + 一段文档,输出一个相关度分数
专门用来给 RAG 做去噪、筛选、重新排顺序,体量小、推理快、成本极低
为什么要用重排模型
- 混合召回(向量 + 关键词)会带来大量冗余信息
- 大模型上下文窗口有限,不能把所有文档都塞进去
- 噪声太多会让模型答非所问、逻辑混乱、幻觉增加
- 先过滤、再精简,才能让回答更精准
重排模型怎么用
js
// 伪代码,以 Cohere / Jina 的 API 为例
async function rerank(query, candidates) {
  const res = await fetch(RERANK_ENDPOINT, {
    method: 'POST',
    headers: { 'Content-Type': 'application/json', 'Authorization': `Bearer ${API_KEY}` },
    body: JSON.stringify({
      model: 'bge-reranker-v2-m3',
      query: query,
      documents: candidates.map(c => c.text),
      top_n: 5,           // 只留最相关的 5 条
    }),
  });

  const data = await res.json();
  // 返回:[{ index: 2, score: 0.93 }, { index: 0, score: 0.81 }, ...]
  return data.results
    .sort((a, b) => b.score - a.score)
    .map(r => candidates[r.index]);  // 按新分数重排
}

// 在检索链里的位置
const queryVector = await embedder.encode(query);                    // ① 问题向量化
const candidates  = await milvus.search(queryVector, { limit: 50 }); // ② 粗筛 50 条
const contents    = await db.findMany(candidates.map(c => c.id));   // ③ ID 反查原文
const top5        = await rerank(query, contents);                  // ④ 精排
const answer      = await llm.generate(query, top5);                // ⑤ 生成
那嵌入模型给多少条数据,要重排模型重排后答案最合理呢?
常见重排模型怎么选
- bge-reranker-v2-m3:BAAI 出品,多语言(含中文),效果好,可本地部署
- jina-reranker-v2:Jina AI,支持长文本
- Cohere Rerank:API 调用,省事但要付费
- GTE-Reranker:阿里达摩院,中文场景表现不错
千问重排
获取apiKey
一般我们用阿里的重排模型:bailian.console.aliyun.com/cn-beijing/...
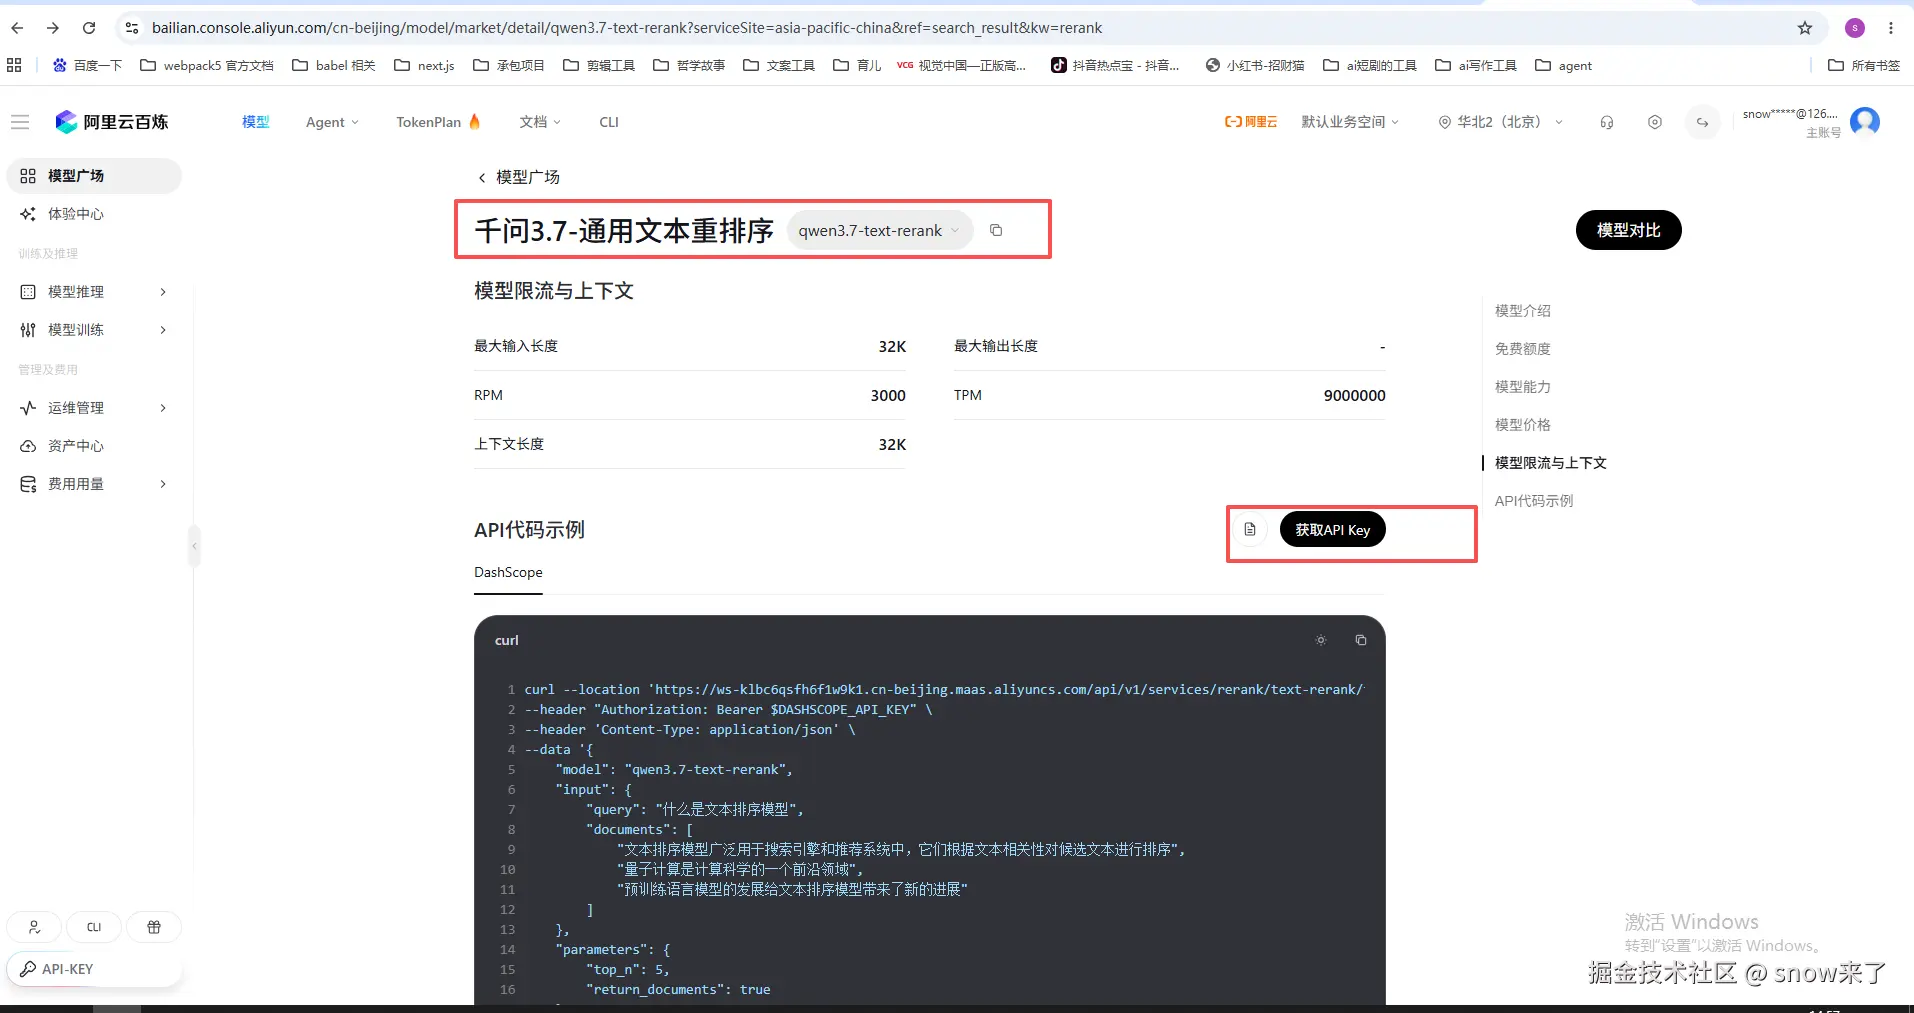
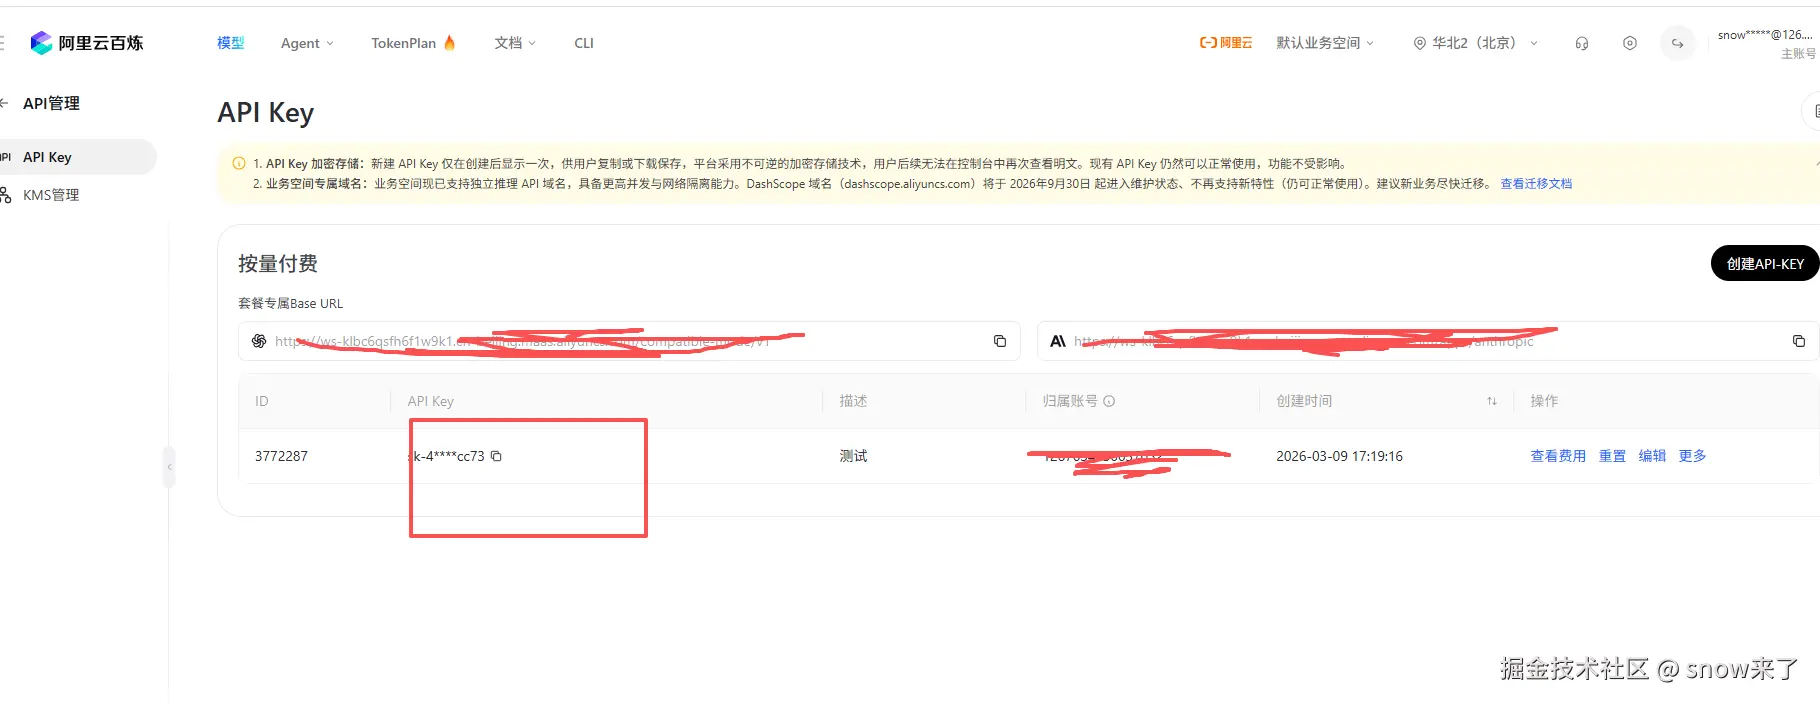
点击重排模型,然后下拉点击获取apiKey
curl测试
利用官网里面给的curl测试命令,测试通不通,在Windows shell里面运行。将命令行里面"你的apikey"替换成你实际的apikey
js
curl.exe --location 'https://ws-klbc6qsfh6f1w9k1.cn-beijing.maas.aliyuncs.com/api/v1/services/rerank/text-rerank/text-rerank' `
--header "Authorization: Bearer 你的apikey " `
--header 'Content-Type: application/json' `
--data '{
    "model": "qwen3.7-text-rerank",
    "input": {
        "query": "什么是文本排序模型",
        "documents": [
            "文本排序模型广泛用于搜索引擎和推荐系统中,它们根据文本相关性对候选文本进行排序",
            "量子计算是计算科学的一个前沿领域",
            "预训练语言模型的发展给文本排序模型带来了新的进展"
        ]
    },
    "parameters": {
        "top_n": 5,
        "return_documents": true
    }
}'
nodejs测试
安装包
js
pnpm install @langchain/core @langchain/openai @langchain/langgraph @langchain/community dotenv zod @zilliz/milvus2-sdk-node.env配置
js
OPENAI_API_KEY=sk-xx
OPENAI_BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
RERANK_URL=https://dashscope.aliyuncs.com/api/v1/services/rerank/text-rerank/text-rerank
MODEL_NAME=qwen-plus
RERANK_MODEL=qwen3-rerank
重排
封装重排的方法
js
import "dotenv/config";
import { BaseDocumentCompressor } from "@langchain/core/retrievers/document_compressors";

export class DashScopeRerank extends BaseDocumentCompressor {

  constructor({ apiKey, model = "qwen3-rerank", topN = 3, baseUrl } = {}) {
    super();
    this.apiKey = apiKey;
    this.model = model;
    this.topN = topN;
    this.baseUrl = baseUrl ?? process.env.RERANK_URL;
  }

  async compressDocuments(documents, query, _callbacks) {
    const res = await fetch(this.baseUrl, {
      method: "POST",
      headers: {
        Authorization: `Bearer ${this.apiKey}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify({
        model: this.model,
        input: {
          query,
          documents: documents.map((d) => d.pageContent),
        },
        parameters: {
          return_documents: false,
          top_n: this.topN,
        },
      }),
    });

    const json = await res.json();
    if (!res.ok) {
      throw new Error(
        `DashScope rerank ${res.status}: ${JSON.stringify(json)}`,
      );
    }

    const results = json?.output?.results;
    if (!Array.isArray(results)) {
      throw new Error(`unexpected rerank response: ${JSON.stringify(json)}`);
    }

    return results.map((item) => documents[item.index]);
  }
}
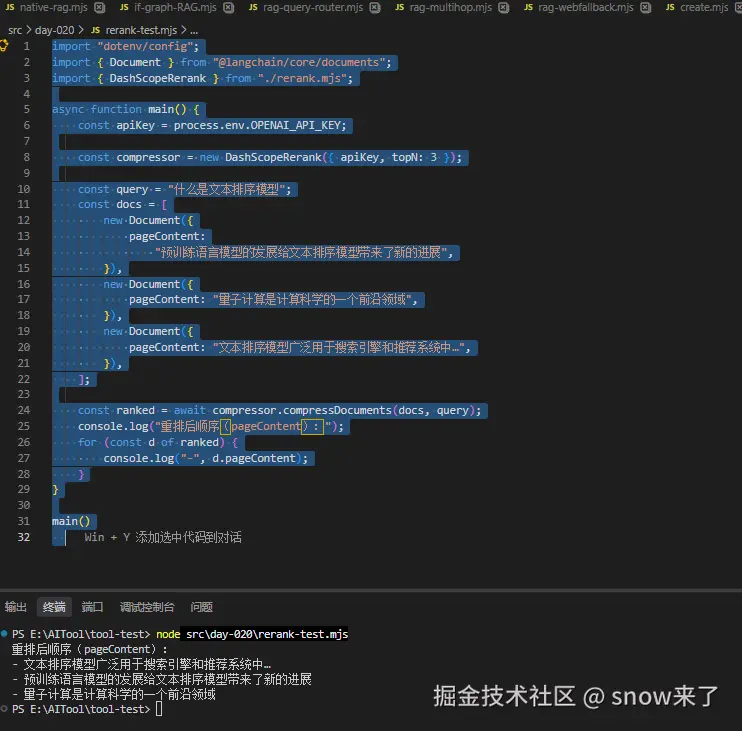
测试重排
js
import "dotenv/config";
import { Document } from "@langchain/core/documents";
import { DashScopeRerank } from "./rerank.mjs";

async function main() {
    const apiKey = process.env.OPENAI_API_KEY;

    const compressor = new DashScopeRerank({ apiKey, topN: 3 });

    const query = "什么是文本排序模型";
    const docs = [
        new Document({
            pageContent:
                "预训练语言模型的发展给文本排序模型带来了新的进展",
        }),
        new Document({
            pageContent: "量子计算是计算科学的一个前沿领域",
        }),
        new Document({
            pageContent: "文本排序模型广泛用于搜索引擎和推荐系统中...",
        }),
    ];

    const ranked = await compressor.compressDocuments(docs, query);
    console.log("重排后顺序(pageContent):");
    for (const d of ranked) {
        console.log("-", d.pageContent);
    }
}

main()
测试如下
五.多路召回
多路召回包含以下方式:
- 向量检索(Milvus)
- 关键词检索(ES)
- 过滤召回(权限、时间、类型)
- 精确匹配(编号、型号)
- 知识图谱检索
最常见的混合检索 就是ES + Milvus 两路并行是多路召回中,最简单的一种方式。
所以说多路召回包含混合检索,但不等于混合检索。
只用语义检索 → 向量检索
只用关键词检索 → ES 搜索
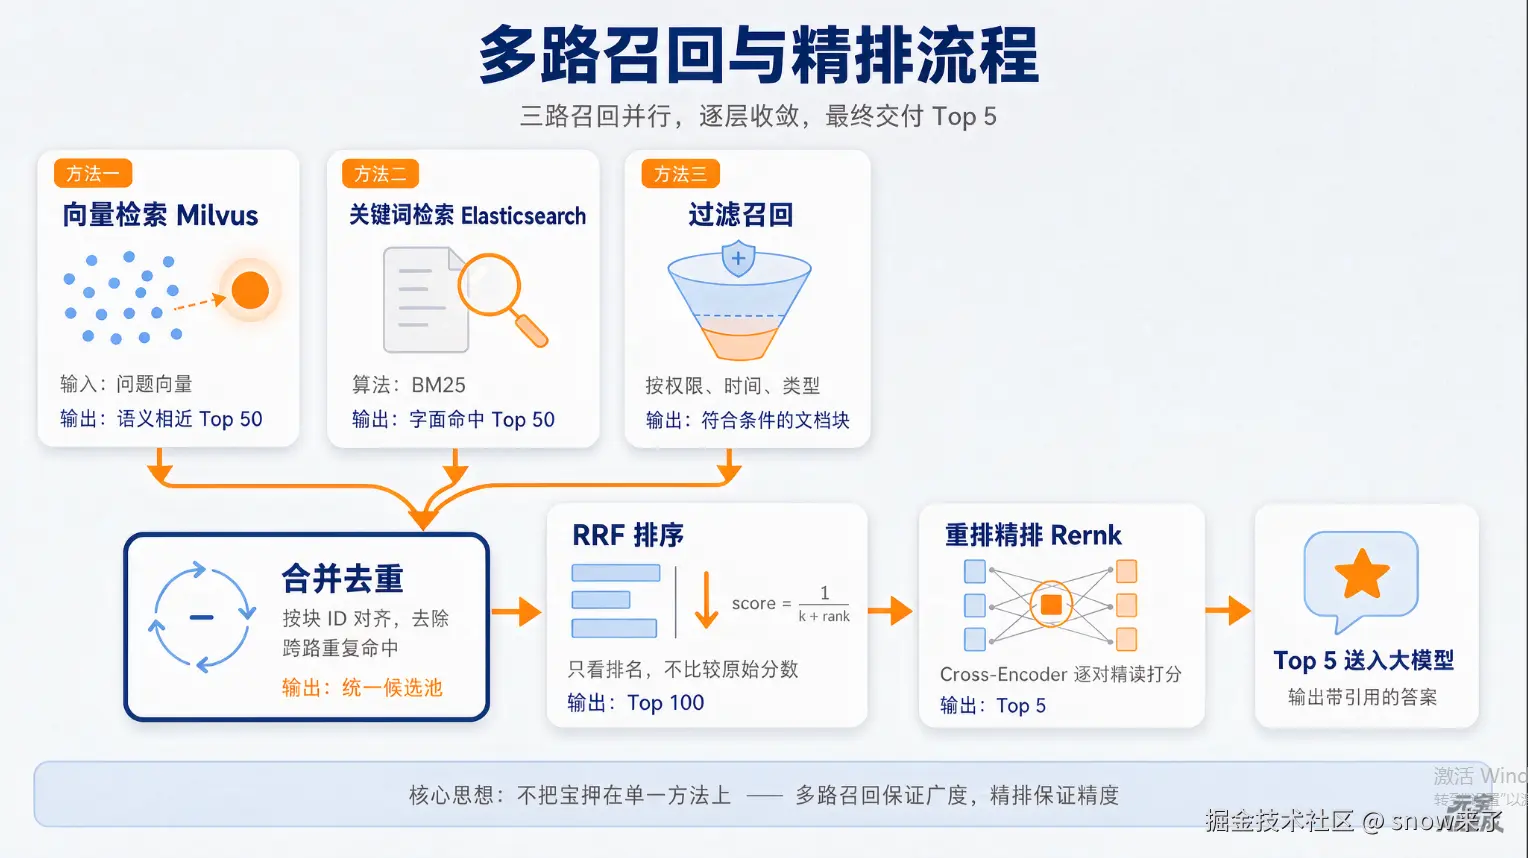
两路一起跑 → 各有各的命中,再合并去重,就能同时覆盖「同义词」和「精确型号」。
「多路召回」是架构层面的事,就是用不同的方式把切当数据全部搜索出来。
「重排」是召回之后的事情,就是把召回的数据按照特定的打分机制重新排序。从而精简大模型的思考范围,以免答非所问
- 多路召回负责数据的广度:尽量把正确答案捞进候选池
- 重排负责精度:把正确答案顶到最前面
一句话总结:多路召回就是用向量、关键词、过滤等多种方法各搜一遍,合并去重,再用 RRF 或加权融合统一排序,最后交给重排精排。 核心思想是别把宝押在单一方法上。
多路召回的好处
既能找得全、又能找得准,过滤掉无关杂音,减少大模型瞎编,生产用完全没问题。
多路召回用「多一点延迟」换「几乎不漏掉正确答案」,本质是拿冗余换较高的准确性。
1.加权求和
js
const merged = new Map();

// 第一路:向量,分数 0~1
for (const hit of vectorHits) {
  merged.set(hit.id, { ...hit, score: hit.score * 0.6 });
}

// 第二路:关键词,BM25 分数可能上千
for (const hit of bm25Hits) {
  const normalized = hit.score / MAX_BM25;  // 先归一化到 0~1
  if (merged.has(hit.id)) {
    merged.get(hit.id).score += normalized * 0.4; // 加权累加
  } else {
    merged.set(hit.id, { ...hit, score: normalized * 0.4 });
  }
}

// 去重合并后按总分排序
const combined = [...merged.values()].sort((a, b) => b.score - a.score).slice(0, 100);
权重 0.6 / 0.4 是经验值,具体按你的数据调整。
2. RRF(倒数排名融合)
RRF 的好处是完全不关心各路分数的量级,只看谁排得靠前,工业界用得更多。
js
// RRF 公式:score = Σ 1 / (k + rank),k 通常取 60
function rrf(hits, k = 60) {
  return hits.reduce((acc, hit, rank) => {
    acc[hit.id] = (acc[hit.id] || 0) + 1 / (k + rank + 1);
    return acc;
  }, {});
}

const fused = {};
for (const id in rrf(vectorHits)) fused[id] = (fused[id] || 0) + rrf(vectorHits)[id];
for (const id in rrf(bm25Hits))   fused[id] = (fused[id] || 0) + rrf(bm25Hits)[id];
六. 多问题改写 + 混合检索 + 重排模型
多问题改写 + 混合检索 + 重排模型是当前企业级落地标准的完善版 RAG 方案。
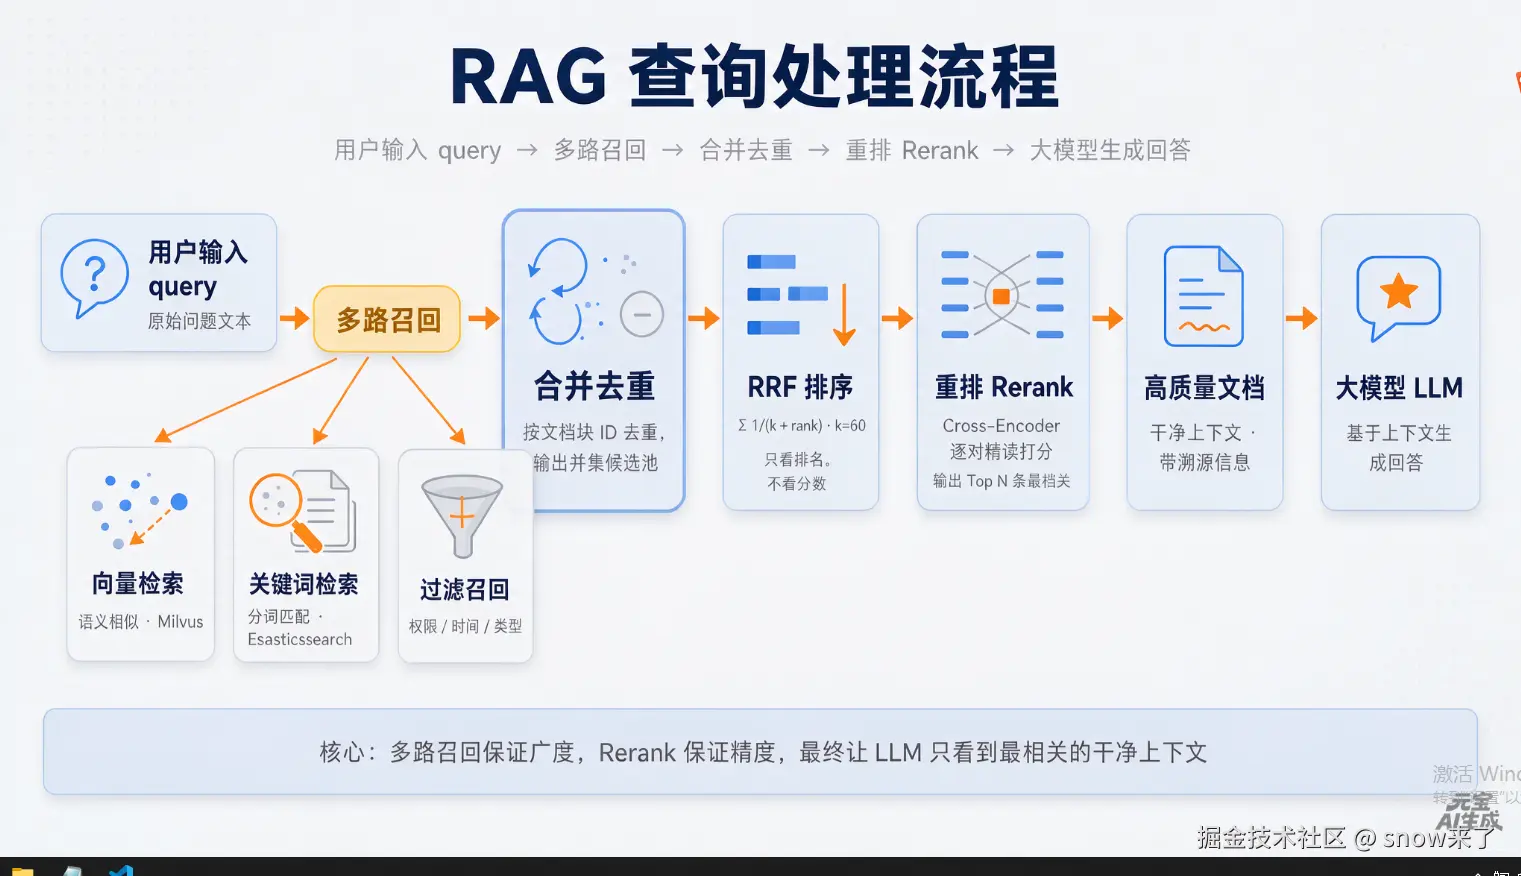
先多路召回,然后合并去重,之后重排关键信息,最后将评分高的数据给大模型,给出最准确的答案。
安装包
js
pnpm install @langchain/core @langchain/openai @langchain/langgraph @langchain/community dotenv zod @zilliz/milvus2-sdk-node.env配置
js
OPENAI_API_KEY=sk-xx
OPENAI_BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
RERANK_URL=https://dashscope.aliyuncs.com/api/v1/services/rerank/text-rerank/text-rerank
MODEL_NAME=qwen-plus
RERANK_MODEL=qwen3-rerank
查询扩展
就是在我们问问题的时候,对方的回答恰好对上了,可是因为你问的不对,却没有匹配到这个刚刚好的解决方案,怎么办?
比如我问:iPhone 15 Pro 充不进电怎么办?
就是将问题从不同的角度拆分成多个问题,比如下图,我们问的是:
iPhone 15 Pro 充不进电怎么办?大模型帮我转化成了三个比较合理的问题。这样能够匹配到正确答案的几率就会增大。这就是所谓的查询扩展。
查询扩展的目的就是提高命中率。
查询扩展又叫
多问题改写
js
原问:iPhone 15 Pro 充不进电怎么办
   ├─ 角度1(换说法):iPhone 15 Pro 无法充电的解决方法
   ├─ 角度2(换角度):iPhone 15 Pro 充电无反应排查步骤
└─ 角度3(加限定):iPhone 15 Pro 充电口故障或电池问题大模型的prompt里面需要有一些字样:可改写说法、换提问角度、或略加限定词;专有名词、型号、订单号等必须保留原样。
代码如下:
js
/**
 * 用大模型根据用户问题生成恰好 3 条不同角度的检索问句;每条问句各自走 ES / Milvus,最后合并去重。
 */
import { ChatPromptTemplate } from "@langchain/core/prompts";
import * as z from "zod";

export const QueryAugmentationSchema = z.object({
  queries: z
    .array(z.string())
    .length(3)
    .describe(
      "恰好 3 条中文检索问句:不同角度改写或扩写;保留订单号、品牌等字面信息;不要编造事实",
    ),
});

const AUGMENT_PROMPT = ChatPromptTemplate.fromMessages([
  [
    "system",
    `用户会给出一句中文问题。请另外写出恰好 3 条检索用的问句(与原意一致、角度尽量不同),便于搜索引擎或向量库分别召回:
可改写说法、换提问角度、或略加限定词;专有名词、型号、订单号等必须保留原样。
只输出结构化字段 queries(长度为 3 的字符串数组)。`,
  ],
  ["human", "{query}"],
]);

function normalizeThreeQueries(original, list) {
  const out = (list ?? [])
    .map((s) => (typeof s === "string" ? s.trim() : ""))
    .filter(Boolean);
  while (out.length < 3) out.push(original);
  return out.slice(0, 3);
}


export async function augmentQuery(chatModel, query) {
  const structured = chatModel.withStructuredOutput(QueryAugmentationSchema);
  const chain = AUGMENT_PROMPT.pipe(structured);
  try {
    const raw = await chain.invoke({ query });
    return { queries: normalizeThreeQueries(query, raw.queries) };
  } catch {
    return { queries: normalizeThreeQueries(query, []) };
  }
}

/** 原始问题在前,其后接 LLM 生成的问句;不做去重,顺序固定;每条各跑一次 ES、Milvus */
export function retrievalQueryStrings(original, augmentation) {
  return [original, ...(augmentation?.queries ?? [])]
    .map((s) => (typeof s === "string" ? s.trim() : ""))
    .filter(Boolean);
}
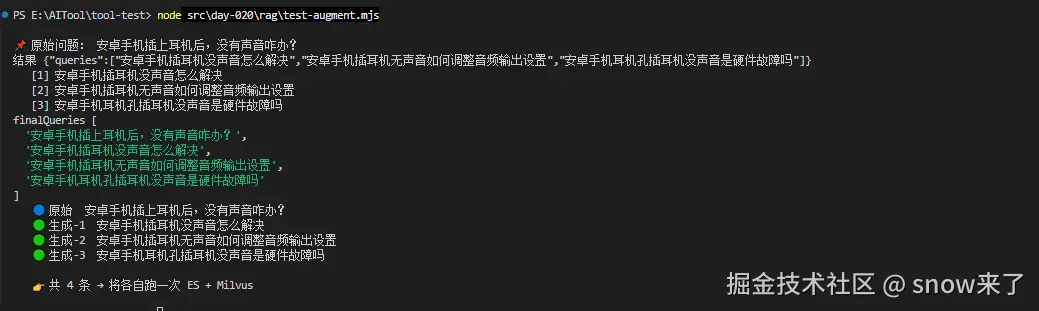
实现以下augmentQuery和retrievalQueryStrings的测试代码如下:
js
import { ChatOpenAI } from "@langchain/openai";
import { augmentQuery, retrievalQueryStrings } from "./query-augment.mjs";


const chatModel = new ChatOpenAI({
  modelName: "qwen3.7-plus",
  apiKey: "你的api",
  temperature: 0,
  configuration: {
    baseURL: "https://dashscope.aliyuncs.com/compatible-mode/v1"
  }
})

async function main() {

    const original = '安卓手机插上耳机后,没有声音咋办?'

    console.log("\n📌 原始问题:", original);
    const augmentation = await augmentQuery(chatModel, original);


    augmentation.queries.forEach((q, idx) => {
      console.log(`   [${idx + 1}] ${q}`);
    });


    const finalQueries = retrievalQueryStrings(original, augmentation);

    console.log("finalQueries", finalQueries);
    finalQueries.forEach((q, idx) => {
      const tag = idx === 0 ? "🔵 原始" : `🟢 生成-${idx}`;
      console.log(`   ${tag}  ${q}`);
    });

    console.log(`\n   👉 共 ${finalQueries.length} 条 → 将各自跑一次 ES + Milvus\n`);
  }


main().catch(console.error);
测试结果
实现问题改写 + 多路召回 + 重排
js
/**
 * 混合检索:LLM 重写为 3 条多角度问句 → 每条问句分别 ES + Milvus → 全量合并去重 → Rerank → LLM 作答。
 * LangGraph:START → query_augment → es_recall ∥ milvus_recall → merge → rerank → generate_answer → END。
 */
import "dotenv/config";
import { Client } from "@elastic/elasticsearch";
import { Document } from "@langchain/core/documents";
import { ChatPromptTemplate } from "@langchain/core/prompts";
import { Milvus } from "@langchain/community/vectorstores/milvus";
import { ChatOpenAI, OpenAIEmbeddings } from "@langchain/openai";
import { Annotation, END, START, StateGraph } from "@langchain/langgraph";
import { DashScopeRerank } from "../rerank/dashscope-rerank.mjs";
import {
  augmentQuery,
  retrievalQueryStrings,
} from "./query-augment.mjs";

const INDEX = "life_notes";

const HybridRetrievalState = Annotation.Root({
  query: Annotation(),
  queryAugmentation: Annotation(),
  esHits: Annotation(),
  milvusHits: Annotation(),
  merged: Annotation(),
  topDocuments: Annotation(),
  answer: Annotation(),
});

function docFromEsHit(hit) {
  const s = hit._source ?? {};
  const text = [s.note_title ?? s.title, s.note_body ?? s.content]
    .filter(Boolean)
    .join("\n");
  return new Document({
    pageContent: text,
    metadata: { id: hit._id, source: "es", ...s },
  });
}

/** ES 与 Milvus 结果拼接后仅按 metadata.id 去重,保留首次出现(通常 ES 在前) */
function merge(esDocs, milvusDocs) {
  const combined = [...(esDocs ?? []), ...(milvusDocs ?? [])].filter(
    (d) => d?.pageContent,
  );
  return dedupeDocsById(combined);
}

/** 去重键仅为 metadata.id(trim 后非空);无 id 丢弃,不按正文去重;保留首次出现顺序 */
function dedupeDocsById(docs) {
  const seen = new Set();
  const out = [];
  for (const d of docs ?? []) {
    if (!d?.pageContent) continue;
    const id =
      d.metadata?.id != null ? String(d.metadata.id).trim() : "";
    if (!id) continue;
    if (seen.has(id)) continue;
    seen.add(id);
    out.push(d);
  }
  return out;
}

function printDocs(label, docs) {
  console.log(`\n=== ${label} (${docs?.length ?? 0} 条) ===`);
  for (let i = 0; i < (docs ?? []).length; i++) {
    const d = docs[i];
    const preview = (d.pageContent ?? "").slice(0, 200).replace(/\n/g, " ");
    console.log(`[${i}] ${preview}${d.pageContent?.length > 200 ? "..." : ""}`);
    console.log(`    metadata:`, d.metadata ?? {});
  }
}

/** 打印 LLM 生成的多角度检索问句及逐条检索列表 */
function printQueryRewrite(original, augmentation) {
  const qs = augmentation?.queries ?? [];
  const forRetrieval = retrievalQueryStrings(original, augmentation);

  console.log(`\n--- 查询扩展(LLM 生成 ${qs.length} 条检索问句)---`);
  console.log("原始 query:", original ?? "");
  for (let i = 0; i < qs.length; i++) console.log(`  [${i + 1}] ${qs[i] ?? ""}`);
  console.log(
    `\n逐条 ES + Milvus(共 ${forRetrieval.length} 条检索串,含原始问题):`,
  );
  for (let i = 0; i < forRetrieval.length; i++) {
    console.log(`  [${i + 1}] ${forRetrieval[i] ?? ""}`);
  }
}

function stringifyMessageContent(content) {
  if (typeof content === "string") return content;
  if (!Array.isArray(content)) return String(content ?? "");
  return content
    .map((c) =>
      typeof c === "string" ? c : typeof c?.text === "string" ? c.text : "",
    )
    .join("");
}

function formatDocsAsContext(docs) {
  return (docs ?? [])
    .map((d, i) => {
      const meta = d.metadata ?? {};
      const src = meta.source ?? "";
      const id = meta.id != null ? String(meta.id) : "";
      const head = id ? `[${i + 1}] id=${id}${src ? ` source=${src}` : ""}` : `[${i + 1}]`;
      return `${head}\n${d.pageContent ?? ""}`;
    })
    .join("\n\n---\n\n");
}

const ANSWER_PROMPT = ChatPromptTemplate.fromMessages([
  [
    "system",
    `你是阅读用户「生活笔记」知识库并作答的助手。
规则:
- 只根据下方「检索片段」推断答案;片段里没有的信息不要编造。
- 若片段不足以回答,明确说明「笔记里未提到」,并可给出一句保守建议。
- 回答简洁有条理,可使用简短列表;口吻自然中文。`,
  ],
  [
    "human",
    `用户问题:{query}

检索片段:
{context}`,
  ],
]);

const NO_CONTEXT_PROMPT = ChatPromptTemplate.fromMessages([
  [
    "system",
    `你是阅读用户「生活笔记」知识库并作答的助手。当前没有检索到任何片段。
请用一两句话说明无法从笔记中回答,并礼貌询问用户是否换个说法或补充关键词。`,
  ],
  ["human", "用户问题:{query}"],
]);

export function compileHybridRetrievalGraph(esClient, milvus, reranker, chatModel) {
  const ES_K = 15;
  const MILVUS_K = 15;

  return new StateGraph(HybridRetrievalState)
    .addNode("query_augment", async (state) => ({
      queryAugmentation: await augmentQuery(chatModel, state.query ?? ""),
    }))
    .addNode("es_recall", async (state) => {
      const qs = retrievalQueryStrings(state.query, state.queryAugmentation);
      const n = Math.max(1, qs.length);
      const kEach = Math.max(2, Math.ceil(ES_K / n));
      const batches = await Promise.all(
        qs.map((q) =>
          esClient.search({
            index: INDEX,
            size: kEach,
            query: {
              multi_match: {
                query: q,
                fields: ["note_title^2", "note_body", "title", "content"],
                type: "best_fields",
                analyzer: "ik_smart",
              },
            },
          }),
        ),
      );
      const flat = batches.flatMap((res) =>
        (res.hits?.hits ?? []).map(docFromEsHit),
      );
      return { esHits: dedupeDocsById(flat) };
    })
    .addNode("milvus_recall", async (state) => {
      const qs = retrievalQueryStrings(state.query, state.queryAugmentation);
      const n = Math.max(1, qs.length);
      const kEach = Math.max(2, Math.ceil(MILVUS_K / n));
      const batches = await Promise.all(
        qs.map((q) => milvus.similaritySearch(q, kEach)),
      );
      const flat = batches.flat();
      return { milvusHits: dedupeDocsById(flat) };
    })
    .addNode("merge", async (state) => ({
      merged: merge(state.esHits, state.milvusHits),
    }))
    .addNode("rerank", async (state) => {
      const merged = state.merged ?? [];
      if (!merged.length) return { topDocuments: [] };
      const topDocuments = await reranker.compressDocuments(merged, state.query);
      return { topDocuments };
    })
    .addNode("generate_answer", async (state) => {
      const query = state.query ?? "";
      const docs = state.topDocuments ?? [];
      if (!docs.length) {
        const chain = NO_CONTEXT_PROMPT.pipe(chatModel);
        const msg = await chain.invoke({ query });
        return { answer: stringifyMessageContent(msg.content).trim() };
      }
      const chain = ANSWER_PROMPT.pipe(chatModel);
      const msg = await chain.invoke({
        query,
        context: formatDocsAsContext(docs),
      });
      return { answer: stringifyMessageContent(msg.content).trim() };
    })
    .addEdge(START, "query_augment")
    .addEdge("query_augment", "es_recall")
    .addEdge("query_augment", "milvus_recall")
    .addEdge(["es_recall", "milvus_recall"], "merge")
    .addEdge("merge", "rerank")
    .addEdge("rerank", "generate_answer")
    .addEdge("generate_answer", END)
    .compile();
}

const esClient = new Client({ node: "http://localhost:9200" });
const embeddings = new OpenAIEmbeddings({
  model: "text-embedding-v3",
  apiKey: process.env.OPENAI_API_KEY,
  configuration: {
    baseURL: "https://dashscope.aliyuncs.com/compatible-mode/v1",
  },
});
const milvus = await Milvus.fromExistingCollection(embeddings, {
  url: "http://localhost:19530",
  collectionName: INDEX,
  textField: "doc_text",
  vectorField: "embedding",
});
const reranker = new DashScopeRerank({
  apiKey: process.env.OPENAI_API_KEY,
  model: "qwen3-rerank",
  topN: 3,
  baseUrl:
    "https://dashscope.aliyuncs.com/api/v1/services/rerank/text-rerank/text-rerank",
});

const chatModel = new ChatOpenAI({
  model: process.env.LLM_MODEL_NAME ?? "qwen-turbo",
  apiKey: process.env.OPENAI_API_KEY,
  temperature: 0.2,
  configuration: {
    baseURL:
      process.env.OPENAI_BASE_URL
  },
});

/** 示例用户 query(字符串列表) */
const SAMPLE_QUERIES = [
  // "PO-20250409-K9 滤芯订单",
  "家里无线老是断断续续的咋整啊",
  // "那个黑凉粉粉怎么冲不结块",
  // "明火炖太久汤汁又黏又涩,起锅前要怎么处理才不腻",
];

const graph = compileHybridRetrievalGraph(esClient, milvus, reranker, chatModel);

const drawable = await graph.getGraphAsync();
console.log(drawable.drawMermaid());
console.log();

for (const query of SAMPLE_QUERIES) {
  console.log(`query: ${query}`);

  const state = await graph.invoke({ query });

  printQueryRewrite(state.query, state.queryAugmentation);
  console.log("\n(原始 JSON)", JSON.stringify(state.queryAugmentation));

  printDocs("Elasticsearch 检索", state.esHits);
  printDocs("Milvus 检索", state.milvusHits);
  printDocs("重排后保留", state.topDocuments ?? []);

  console.log("\n=== 大模型生成回答 ===\n");
  console.log(state.answer ?? "");
}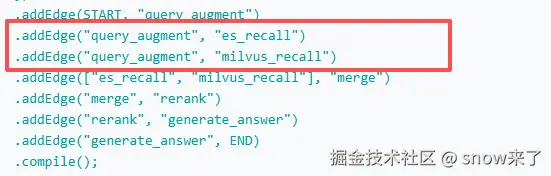
从上述图谱看ES查询和milvus检索是2个并行的工作。但是js是单线程的语言,他的内部会用await等待,就是说先可能做es,es做完以后拿着结果,等待milvus检索,等他们俩都实现了,一起将结果交给merge做合并处理。这个过程很像Promise.all。
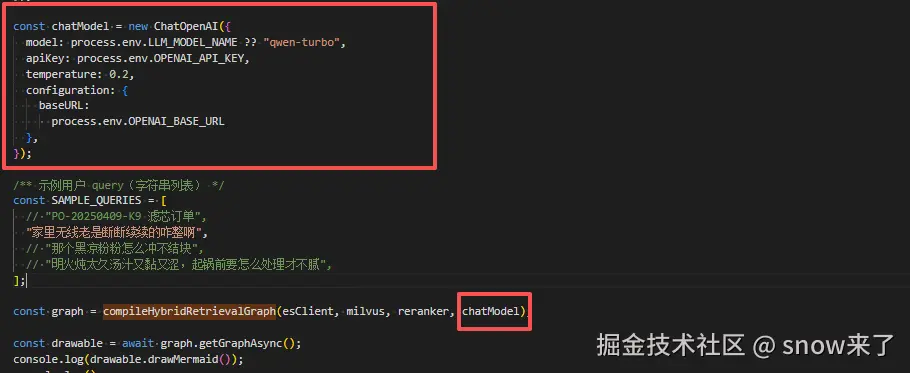
langgraph里面只能初始化图谱,并没有大模型。
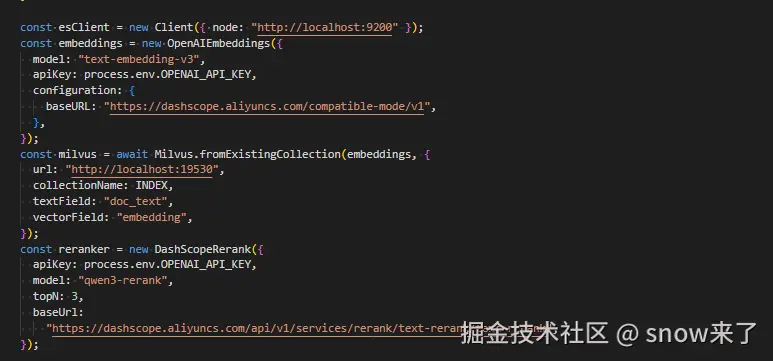
上面这个是es,milvus,rerank的连接方式。连接es,milvus的前提是需要在docker上启动起来。