Rust 一向以难学出名,但大部分难点都集中在几个概念上。理解它们,后面的内容就容易上手了。
在 Stack Overflow 的开发者调查里,Rust 年年都是最受喜爱的语言。
可很多开发者跟编译器较劲一周,就放弃了。
这两件事听起来很矛盾是吧,实则不然,因为 Rust 把难点放在了前面。
它要求你提前想清楚内存、所有权和错误处理,这样得到的好处是,在代码运行之前就帮你排除一整类问题。
这篇文章会介绍其中最关键的 7 个概念。
所有权:一个值,一个所有者
Rust 中的每个值都有一个所有者。所有者离开作用域时,这个值就会被释放。不需要垃圾回收器,也不用手动调用 free。
rust
fn main() {
    let a = String::from("hello");
    let b = a; // ownership moves from a to b

    // println!("{a}"); // error: borrow of moved value: `a`
    println!("{b}");
}
把 a 赋给 b,并没有复制字符串,而是转移了所有权。此后,a 就不能再使用了。这避免了重复释放、释放后使用等 C/C++ 中常见的内存错误。
整数这样的简单类型实现了 Copy,行为就和我们平时预期的一样:
rust
let x = 5;
let y = x; // copied, both still valid
println!("{x} {y}");
如果确实需要复制一份堆上的字符串数据,就显式调用 .clone()。Rust 让这类有成本的操作在代码里清楚地体现出来。
自定义类型也能 Copy 吗
可以。
自定义结构体实现 Copy 后,赋值和按值传参也会隐式复制,原变量仍然可以使用:
rust
#[derive(Clone, Copy)]
struct Point {
    x: i32,
    y: i32,
}

fn main() {
    let a = Point { x: 1, y: 2 };
    let b = a; // 隐式复制,a 仍然可用

    assert_eq!(a.x, b.x);
    assert_eq!(a.y, b.y);
}
注意,这里实现的是 Copy trait,不是自己写一个叫 copy() 的方法。Copy 没有方法,编译器直接复制值,也不会调用 clone()。
不过,结构体的所有字段都必须实现 Copy,而且类型本身不能实现 Drop。所以,含有 String、Vec 等字段的结构体不能实现 Copy。另外,Copy 要求类型同时实现 Clone,通常像上面这样一起派生。
那实现 Copy 之后,还能主动选择 move 吗?
不能针对某一次赋值或按值传参,强制让原变量因 move 而失效。
对于实现了 Copy 的类型,这些操作都会隐式复制。即使使用 move 闭包,捕获这类值时也是复制,闭包外的原变量仍然可用。
如果希望显式选择"移动还是复制",就只实现 Clone,不实现 Copy:
rust
#[derive(Clone)]
struct Point {
    x: i32,
    y: i32,
}

fn main() {
    let a = Point { x: 1, y: 2 };
    let b = a; // move,之后不能再使用 a
    let c = b.clone(); // 显式复制,b 仍然可用

    assert_eq!(b.x, c.x);
    assert_eq!(b.y, c.y);
    // println!("{}", a.x); // 取消注释后会报错:使用了已移动的值
}
这样,普通赋值默认转移所有权,需要复制时就明确调用 .clone()。
借用:使用引用,不转移所有权
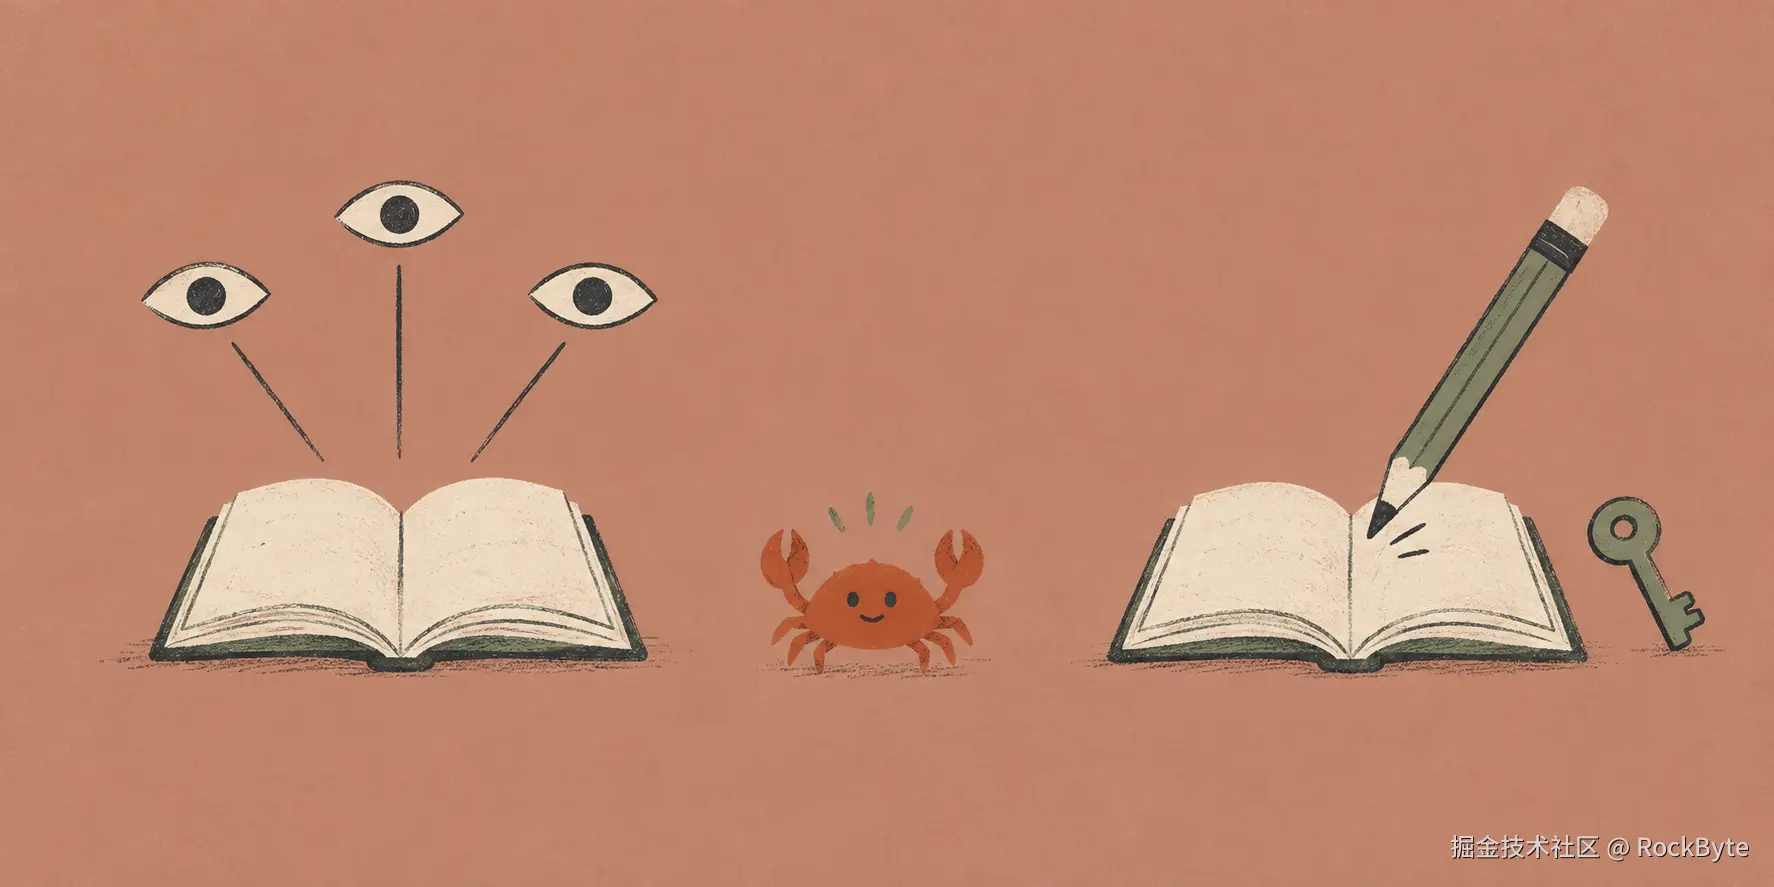
总是转移所有权会很麻烦,所以 Rust 允许我们通过引用借用一个值。
rust
fn length(s: &str) -> usize {
    s.len()
}

fn shout(s: &mut String) {
    s.push('!');
}

fn main() {
    let mut msg = String::from("hello");

    println!("{}", length(&msg)); // immutable borrow
    shout(&mut msg);              // mutable borrow
    println!("{msg}");            // hello!
}
这里有一条核心规则:
对于同一份数据,在借用有效期间,要么有一个或多个共享引用(&T),要么有一个独占的可变引用(&mut T),两者不能同时存在。
rust
let mut v = vec![1, 2, 3];
let first = &v[0];  // immutable borrow
v.push(4);          // error: mutable borrow while `first` is alive
println!("{first}");
这段代码无法编译,因为 push 可能导致 vector 重新分配内存,让 first 指向已经释放的内存。在允许这种操作的语言里,这可能是一个运行时错误;在 Rust 中,编译器就会拦住它。
生命周期:证明引用始终有效
生命周期听起来有点吓人,用起来也可能复杂,但它要解决的问题其实很直接:
编译器需要确认,引用不会比它指向的数据活得更久。
大多数时候,编译器可以自行推断,有时则需要我们提供一点信息:
rust
fn longest<'a>(a: &'a str, b: &'a str) -> &'a str {
    if a.len() >= b.len() { a } else { b }
}
这里的 'a 表示,返回引用的有效期不能超出两个输入引用都有效的那段时间。没有这个标注,编译器无法从函数签名确定返回引用与两个输入引用的生命周期关系。生命周期标注描述的是引用之间的关系,不会改变任何数据实际存活的时间。
枚举与模式匹配
Rust 的枚举可以携带数据,比许多语言中只表示一组常量的枚举能做更多事情。
rust
enum Shape {
    Circle { r: f64 },
    Rect { w: f64, h: f64 },
}

fn area(s: &Shape) -> f64 {
    match s {
        Shape::Circle { r } => std::f64::consts::PI * r * r,
        Shape::Rect { w, h } => w * h,
    }
}
match 必须覆盖所有可能的情况。新增一个 Triangle 变体后,没有覆盖它的 match 就会编译失败;如果已有通配分支,则仍然可以编译。那些在其他语言中可能悄悄引入问题的重构,在这里会变成编译器列出的待处理项。
空与错误
Rust 的普通引用不能为 null。对于可能不存在的值,通常用 Option 表示:
rust
let names = vec!["ada", "grace"];

match names.get(5) {
    Some(n) => println!("found {n}"),
    None => println!("nobody home"),
}
可能失败的操作可以返回 Result,用 ? 运算符就能向调用方传播错误,不必重复写提前返回的代码:
rust
use std::num::ParseIntError;

fn add_ports(a: &str, b: &str) -> Result<u32, ParseIntError> {
    let a: u32 = a.parse()?; // returns early on error
    let b: u32 = b.parse()?;
    Ok(a + b)
}
这里的 Result 只涵盖解析错误,没有处理 u32 加法溢出:启用溢出检查时,溢出会触发 panic;关闭检查时则会回绕。
失败的可能性直接体现在函数签名里,调用方需要面对这个结果。不过,类型系统并不强制你妥善处理每一个错误:直接丢弃 Result 通常会产生警告,也可以用 let _ = ... 显式忽略它。
Trait 与泛型:共享行为
Trait 类似于其他语言中的接口,用来定义类型可以实现的行为:
rust
trait Summary {
    fn summarize(&self) -> String;
}

struct Post {
    title: String,
    author: String,
}

impl Summary for Post {
    fn summarize(&self) -> String {
        format!("{} by {}", self.title, self.author)
    }
}

fn print_summary(item: &impl Summary) {
    println!("{}", item.summarize());
}
print_summary 可以接收任何实现了 Summary 的类型。编译器会为使用到的具体类型生成对应的代码,这个过程叫单态化(monomorphization)。这样就能使用抽象,而不必为动态分派付出运行时成本。
闭包和迭代器也建立在这些机制之上。
写到这里,Rust 开始显得顺手了:
rust
let total: i32 = (1..=10)
    .filter(|n| n % 2 == 0)
    .map(|n| n * n)
    .sum();

println!("{total}"); // 220
在开启优化后,这串调用通常可以编译成与手写循环相近的机器码。
无畏并发
无畏到底什么意思? 这里指的是:写并发代码时,一类隐蔽、难复现的错误,编译器会提前帮你拦住,你可以更有底气地写和修改代码。不过,编译通过不代表运行就一定没问题,死锁和并发逻辑错误仍然需要自己处理。
所有权和借用不仅能避免内存错误。结合 Send、Sync 等约束,它们还能在安全 Rust 中防止数据竞争。下面是一个由 8 个线程共享的计数器:
rust
use std::sync::{Arc, Mutex};
use std::thread;

fn main() {
    let counter = Arc::new(Mutex::new(0));
    let mut handles = vec![];

    for _ in 0..8 {
        let counter = Arc::clone(&counter);
        handles.push(thread::spawn(move || {
            for _ in 0..1000 {
                *counter.lock().unwrap() += 1;
            }
        }));
    }

    for h in handles {
        h.join().unwrap();
    }

    println!("{}", *counter.lock().unwrap()); // 8000
}
Arc 提供跨线程的共享所有权,Mutex 保护对数据的修改。如果把 Arc 换成非线程安全的 Rc,这段代码就无法编译,因为 Rc 没有实现 Send。
在 Java 等没有这类所有权检查的语言中,如果误把非线程安全的对象交给多个线程共享修改,问题可能跟着代码一起上线,然后凌晨三点系统报警,你不得不起床看日志。
而 Rust 会在编译时拒绝上面把 Rc 传给另一个线程的代码。
一点想法
这 7 个概念其实都是在表达 Rust 的一个核心思想:
尽量让问题在编译期暴露。
- 所有权和借用帮助安全 Rust 避免内存安全错误。
- 枚举和
match要求覆盖所有可能的情况。 Option和Result把值的缺失和操作失败放进类型里。- Trait 配合泛型,可以提供不需要动态分派的抽象。
Send/Sync等约束帮助安全 Rust 防止数据竞争。
刚开始学 Rust,你可能觉得编译器处处跟你作对。
一旦你掌握了其中的诀窍,它更像一位永远不会疲倦的资深代码专家。