- 一个开关省一半显存 :KV cache 从 FP8 走到 NVFP4 ,每 token 显存降到约 56% ,同显存可多放 约 1.78 倍 上下文
- 越长越赚 :解码吞吐 +37% / +58% / +78% ,对应 32K / 160K / 1M 上下文
- 省的是带宽不是算力------这就是为什么短上下文几乎没收益
- 精度近乎无损 :Qwen3.5-397B-A17B 上 GPQA-Diamond 与 AIME 2025 均与 FP8 持平
- 配方三项:NVFP4 两级缩放 + 解码期 kernel 内反量化 + 分页 KV cache
- 上线命令 :
--kv-cache-dtype nvfp4,但非 Blackwell 无收益,别手痒
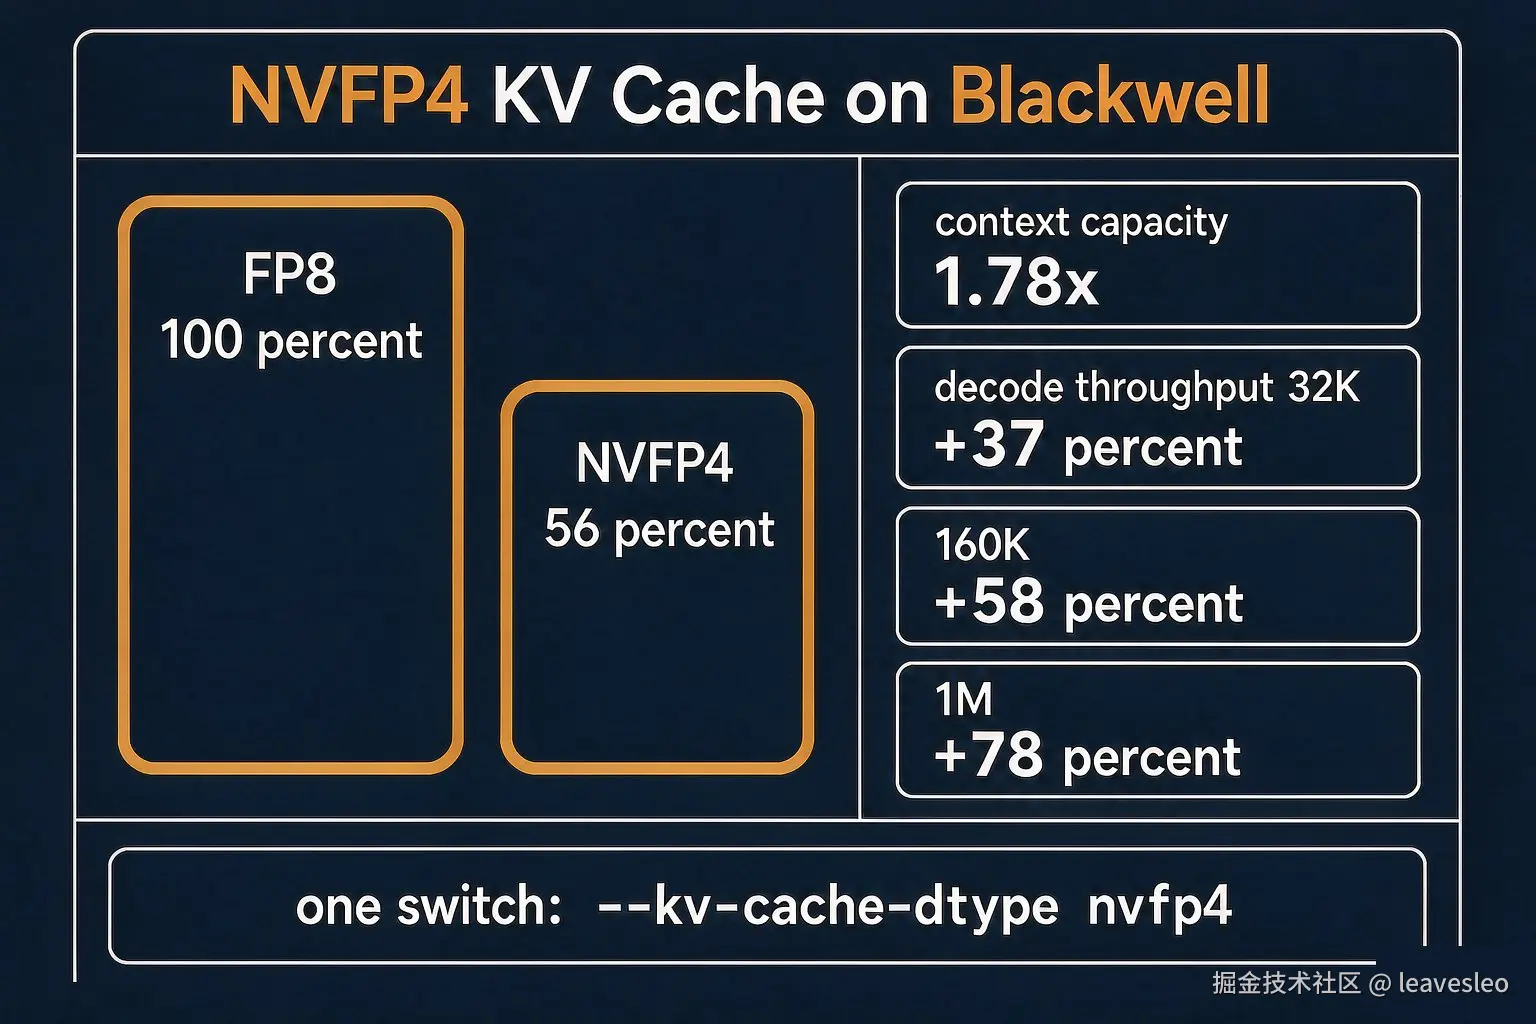
SGLang 官方博客公布了在 NVIDIA Blackwell 平台上的 KV cache 量化结果:把 KV cache 从 FP8 压到 NVFP4 (4bit 浮点),在 Qwen3.5-397B-A17B 上,每个 token 的 KV 显存降到 FP8 的约 56% ,同样显存下可容纳约 1.78 倍 的上下文;解码吞吐在三档上下文长度上分别提升 +37%(32K)、+58%(160K)、+78%(1M)。相关工作由 LMSYS、阿里云 Qwen 与 NVIDIA 联合完成。
这个结果的意义不在"又一个量化技巧",而在于它把长上下文与 Agent 推理里最贵的一项------KV cache 显存------直接砍掉近一半。下面拆它的配方、收益曲线的形状,以及什么情况下开了反而白开。
一、先算清 KV cache 到底吃掉多少显存
全注意力模型推理时,显存占用大致分三块:模型权重、KV cache、以及运行时开销(激活、通信缓冲)。前两块的关系决定了长上下文的可用性。
KV cache 的规模与这些量成正比:
bash
KV bytes = 2 (K 与 V) × 层数 × KV 头数 × 头维度 × 序列长度 × 每元素字节数 × 批大小关键在最后两项 :序列长度和批大小都是你想要的量------上下文越长、并发越高,KV cache 涨得越快,而它是线性涨的。模型权重是固定的,KV cache 不是。
用公开的 397B-A17B 规模做一次量级估算(典型调用场景,非实测):在 FP8 下,单条 100 万 token 的序列,KV cache 占用已经在几十 GB 量级;把每元素字节数从 1 降到 0.5 附近,同一张卡能同时服务的请求数、或单请求能容纳的上下文长度,都会抬升一档。
这就解释了为什么 NVFP4 的收益随上下文长度增加而变大------短上下文时 KV cache 占总显存的比例很小,省下的一半本来也不多。
二、配方三项:为什么不是简单的"缩到 4bit"
把 KV cache 量化得能用于生产,需要同时解决三个问题:
| 环节 | 做法 | 解决什么 |
|---|---|---|
| 量化格式 | NVFP4 两级缩放(block 级 + 张量级 scale) | 4bit 的动态范围很窄,单一缩放会让异常值主导误差 |
| 反量化时机 | 解码期在 kernel 内反量化 | 避免把量化数据读出显存再转 float,否则省下的显存被带宽吃掉 |
| 内存布局 | 分页 KV cache | 变长序列与高并发下的碎片与浪费 |
第一项是精度的关键。 4bit 浮点能表示的数值区间有限,KV 张量里又总有几个离群的通道(某些维度数值明显偏大)。全局一个缩放系数的话,为了不裁掉异常值,只能把整体精度牺牲掉。两级缩放的本质是"分组管理动态范围"------粗粒度对齐整体范围,细粒度照顾局部离群值。
第二项是性能的关键。 量化的收益有两处:省显存、省带宽。如果实现方式是"把 4bit 读进寄存器、转成 float 再算",那显存是省了,但多了一次转换开销 ,短上下文下这笔开销会抵消收益。kernel 内反量化意味着反量化融进矩阵乘的读取路径,不额外产生一轮内存往返。
第三项决定能否规模化。 分页 KV cache(把 KV 按块管理而不是整段连续分配)在 FP8 下已经是长上下文服务的标配;换成 4bit 后每个块的字节数变小,页表项的密度和管理开销变得更敏感------这也是为什么 4bit KV 不是一个纯精度问题。
三、收益曲线的形状:为什么越长越赚
把三档数据放在一张表里看:
| 上下文长度 | 解码吞吐提升 | 判断 |
|---|---|---|
| 32K | +37% | 已有收益,但不算颠覆 |
| 160K | +58% | 收益明显放大 |
| 1M | +78% | 接近翻倍 |
单调递增的曲线,本身就是一条诊断结论 :它说明省下的是显存带宽 而不是计算量。解码阶段是 memory-bound 的,每生成一个 token 都要把整份 KV cache 读一遍------上下文越长,这次读取的量越大,带宽成为瓶颈的比例越高。把每个元素从 1 字节压到 0.5 字节,能省的正是这段读取时间。
反过来说,如果你的业务跑在 8K--16K 上下文,这条曲线的收益很薄 。省下的半份 KV 显存换不来多少吞吐,反而多担了一次量化的风险。所以这个开关不是"打开了就一定快",而是上下文长度决定的。
怎么判断自己该不该开,用一个比值:
bash
KV 显存 / 单卡显存 > 0.3 → 值得评估低于这个比例,说明你的显存主要被权重和激活占着,压 KV 属于优化错地方;高于它,说明 KV 已经是主要矛盾,压 4bit 的收益会跟着上下文长度继续放大。
四、精度:持平意味着什么,不意味着什么
官方公布的结果是:在 Qwen3.5-397B-A17B 上,GPQA-Diamond 与 AIME 2025 的分数与 FP8 持平。
"持平"在这两个基准上有实际含义 :GPQA-Diamond 是研究生级科学问答,AIME 是数学竞赛题,两者都对中间推理链的稳定性敏感------量化如果破坏了长链推理里某些关键位置的注意力分布,这两项会先掉分。它们没掉,说明在常规推理负载下,4bit KV 没有引入可观测的质量损失。
但"持平"不等于"无损",两点必须分清楚:
- 测的是分数不是分布。 benchmark 是平均值,量化的误差往往集中在长尾------某些特定类型的输入(极长文档、特殊格式的结构化数据、需要精确回溯原始 token 的任务)可能比平均情况更敏感。上生产前用自家的长尾样本复测,比抄 benchmark 有意义。
- 这是官方在自家模型上测的。 换成另一套权重,离群通道的分布不同,两级缩放的参数就要重估。同一套配方不代表同一份收益。
五、Agent 场景:为什么缓存命中率决定能不能线性扩展
官方还提到一个对 Agent 推理更关键的观察:在 AgentX 场景中,NVFP4 因为缓存命中率更高,吞吐能继续线性扩展,而 FP8 在这个场景下提前触到了资源瓶颈。
这条比吞吐曲线更值得琢磨。 Agent 请求的形状和普通对话差别很大:
- 请求高度重复前缀(同一份系统提示、同一份工具定义、同一段代码上下文)
- 单请求极长,但新增内容很少
- 并发请求成组出现(一个任务里的多次工具调用)
这种形状下,能否把重复前缀的 KV 留在显存里,直接决定实际算力消耗 。而"能不能留下"取决于显存够不够------KV 每 token 占得越少,能同时驻留的前缀就越多,缓存命中率就越高,省下的是整段前缀的重复计算。
所以 FP8 在 AgentX 里"提前触到瓶颈",触的不是算力墙,而是显存墙导致的缓存换出 ------前缀被换出去,下一轮请求重新算,吞吐就上不去了。4bit KV 在这里的价值,一半在省显存,一半在把缓存守住。
六、上线路径与三条失效模式
上手只要一个开关:
bash
python -m sglang.launch_server \
  --model-path <你的模型> \
  --kv-cache-dtype nvfp4 \
  --attention-backend <Blackwell 可用后端>
三条必须提前知道的失效模式:
| 失效模式 | 症状 | 处置 |
|---|---|---|
| 硬件不匹配 | 非 Blackwell 上无加速甚至更慢 | 先确认卡型,NVFP4 的收益依赖对应代的低精度能力 |
| 短上下文 | 吞吐提升接近噪声 | 按上面那个 0.3 的比值判断值不值得开 |
| 长尾精度 | 平均值正常,特定任务异常 | 用自家长尾样本做 A/B,不只看 benchmark |
综合判断 :如果你的推理服务已经跑到 100K 以上上下文、并且并发受限于显存 ,这个开关值得排一次 A/B 实验------收益上限接近翻倍,成本是配置里多一行。如果你的负载主要在 32K 以内,把它记在"待上下文变长时再回头看"的清单上就够了。长上下文这件事上,省显存的手段和提升质量的手段往往是同一批工程努力的两面------这次是显存那头先松了口。