github:github.com/YueJingGe/c...
不只是口头提倡 TDD,而是把 Red-Green-Refactor 写进 AI 协作入口,让它在正确的时间被自动触发。
一、什么是测试先行
测试先行(Test-Driven Development,TDD)不是先写代码再补测试,而是:
- 先写一个会失败的测试(Red)。
- 运行它,确认它因为目标行为缺失或 bug 存在而失败。
- 写最少代码让测试通过(Green)。
- 在测试全绿的前提下重构(Refactor)。
一句话概括:没有先失败的测试,就不写生产代码。
在我的项目里,TDD 被写进了 .agents/skills/test-driven-development/SKILL.md,作为 AI 协作的默认动作之一。它不是为了追求覆盖率,而是为了在 AI 频繁参与编码时,把"改动必须可验证"变成机械习惯。
二、为什么 AI 协作项目更需要 TDD
AI 写代码很快,但也容易:
- 顺手改多:你以为它只修了一个按钮状态,结果它把附近三四个文件都动了。
- 证据缺失:它说"修复完成",但你不知道它有没有先复现 bug。
- 回归隐蔽:实现通过了,但旧行为被悄悄破坏。
TDD 的"先失败、再实现"正好克制这些问题:
- 测试是契约:AI 在动手前必须先理解"期望行为是什么"。
- 失败是证据:没有 Red 输出,就不能声称 bug 已修复。
- 回归被即时捕获:每次改完跑全量测试,break 立刻暴露。
三、为测试先行做了哪些设计
1. 工具链:和 Vite 同生态
前端测试栈选的是 Vitest + @testing-library/react + @testing-library/jest-dom + jsdom。
ts
// web/vitest.config.ts
import { defineConfig } from "vitest/config";
import react from "@vitejs/plugin-react";

export default defineConfig({
  plugins: [react()],
  test: {
    globals: true,
    environment: "jsdom",
    setupFiles: ["./src/test-utils/vitest.setup.ts"],
    include: ["src/**/*.test.{ts,tsx}"],
    exclude: ["node_modules", "dist"],
  },
});
ts
// web/src/test-utils/vitest.setup.ts
import "@testing-library/jest-dom/vitest";
2. 文件组织:测试与源码同目录
不建 __tests__/ 目录,测试文件和被测源码放一起:
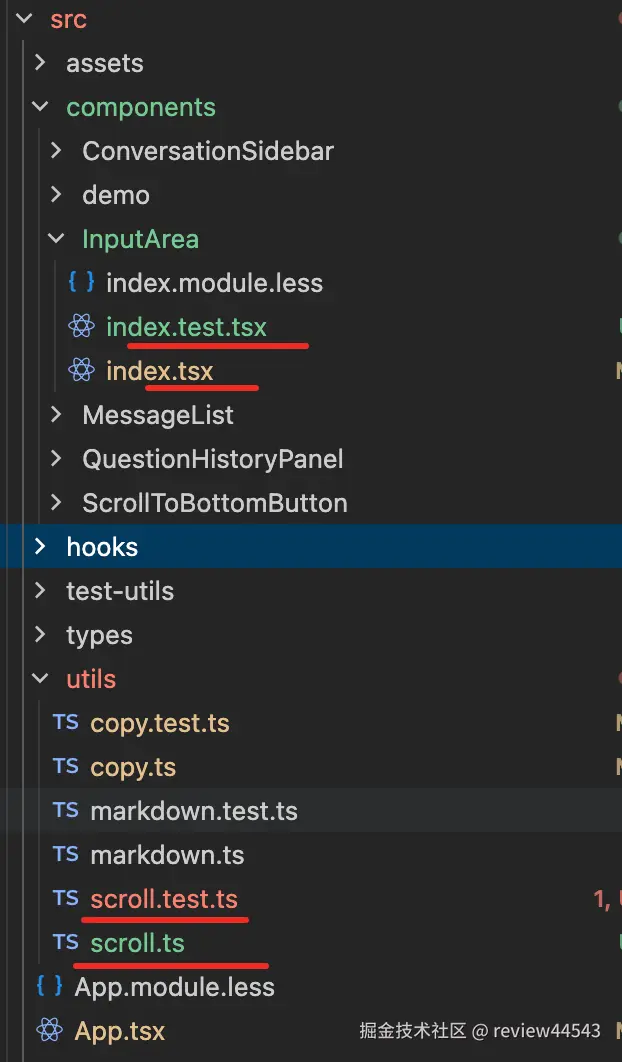
这样找测试不需要跳转目录,AI 在改源码时也能立刻看到同目录的测试约束。
3. 规则落点:Skill + 门禁 + 文档/计划三层互锁
AGENTS.md 是 AI 进入项目时的入口,里面用 按改动类型触发 的方式规定:
- 改 web/src/** 逻辑:读
.agents/context/frontend-context.md+docs/harness/frontend-rules.md;新增、修改或修复组件、hook、工具函数、状态或交互行为时调test-driven-developmentskill,并补/改同目录*.test.ts(x)
TDD 不是一份 Skill 文件就能讲完的事,而是三层互锁:
| 层级 | 含义 | 职责 | 载体 |
|---|---|---|---|
| Skill 层 | 即时行为指令:执行 Red-Green-Refactor | 怎么做 | .agents/skills/test-driven-development/SKILL.md |
| 门禁层 | 机器兜底:提交前检查逻辑文件是否带同目录测试 | 有没有做 | scripts/check-frontend-tdd.mjs + husky pre-commit/pre-push |
| 文档/计划层 | 保留上下文与验收标准,引用 Skill 和门禁而不重复规则 | 为什么这么做 | docs/harness/frontend-testing.md、spec/exec-plan 模板 |
4. 质量门禁:check:all 与 TDD 专检
根目录的 package.json 把测试串进聚合门禁:
json
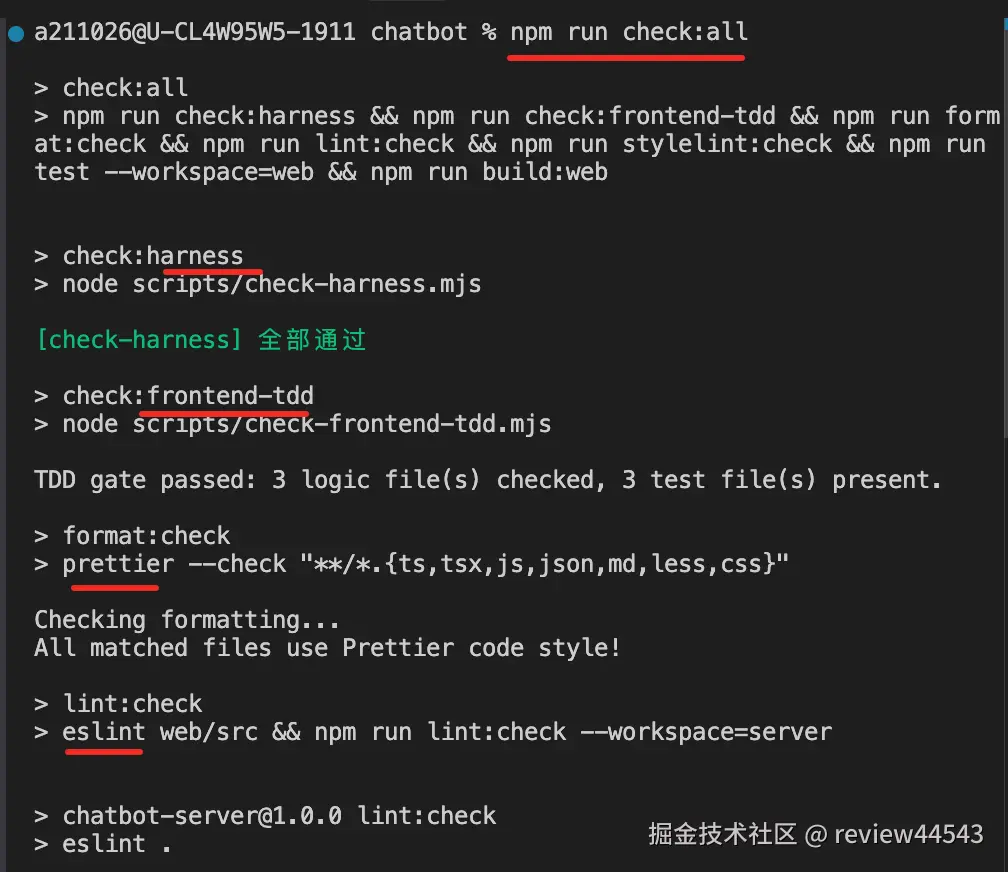
"check:all": "npm run check:harness && npm run check:frontend-tdd && npm run format:check && npm run lint:check && npm run stylelint:check && npm run test --workspace=web && npm run build:web"check:frontend-tdd 是 TDD 专检:对本次 git 变更中 web/src/** 的逻辑文件,检查同目录是否存在 *.test.ts(x);fix 类提交还必须带有测试文件变更。它被挂在 .husky/pre-commit 和 .husky/pre-push 上,作为机器兜底。
任何改动完成,必须通过 harness 自检、TDD 专检、Prettier、ESLint、Stylelint、前端测试和构建,才算闭环。
四、TDD 什么时候被触发
项目里判定是否走 TDD:不看用户 prompt 里有没有出现"TDD"三个字,而是看代码改动的性质。
必须走 TDD 的情况:
- 新增功能 / 新组件 / 新工具函数
- 修复 bug(含恢复预期行为)
- 修改行为、交互或数据流
- 重构
不强制单元测试的情况:
- 纯样式 / 布局 / 响应式改动(改走
frontend-visual-verification视觉验证) - 配置改动
- 类型声明改动
- 文档改动
这个口径被写进了 AGENTS.md 和 docs/harness/frontend-testing.md,避免 AI 因为用户措辞不同而漏执行。
五、触发之后都做了什么
一旦判断需要 TDD,AI 会按下面的顺序执行:
- 读上下文 :先读
frontend-context.md+frontend-rules.md+test-driven-development/SKILL.md。 - 写测试:根据需求或 bug 写一个最小测试。如果是 bug,测试要能复现 bug。
- 跑测试拿 Red:运行单文件测试,确认失败原因是"行为缺失"或"bug 存在",而不是拼写错误。保留失败输出。
- 写最小实现:只写让测试通过的代码,不提前设计。
- 跑测试拿 Green:确认测试通过,且其他测试没坏。
- 重构(可选):在测试全绿下清理代码。
- 跑 check:all:通过完整质量门禁。
整个过程的核心不是"有测试",而是测试必须先失败,并且失败原因被确认。
六、四个验收场景
下面是项目里真实跑过的 4 个场景,分别对应新增函数、修 bug、改组件行为、重构。
场景 1:新增纯工具函数
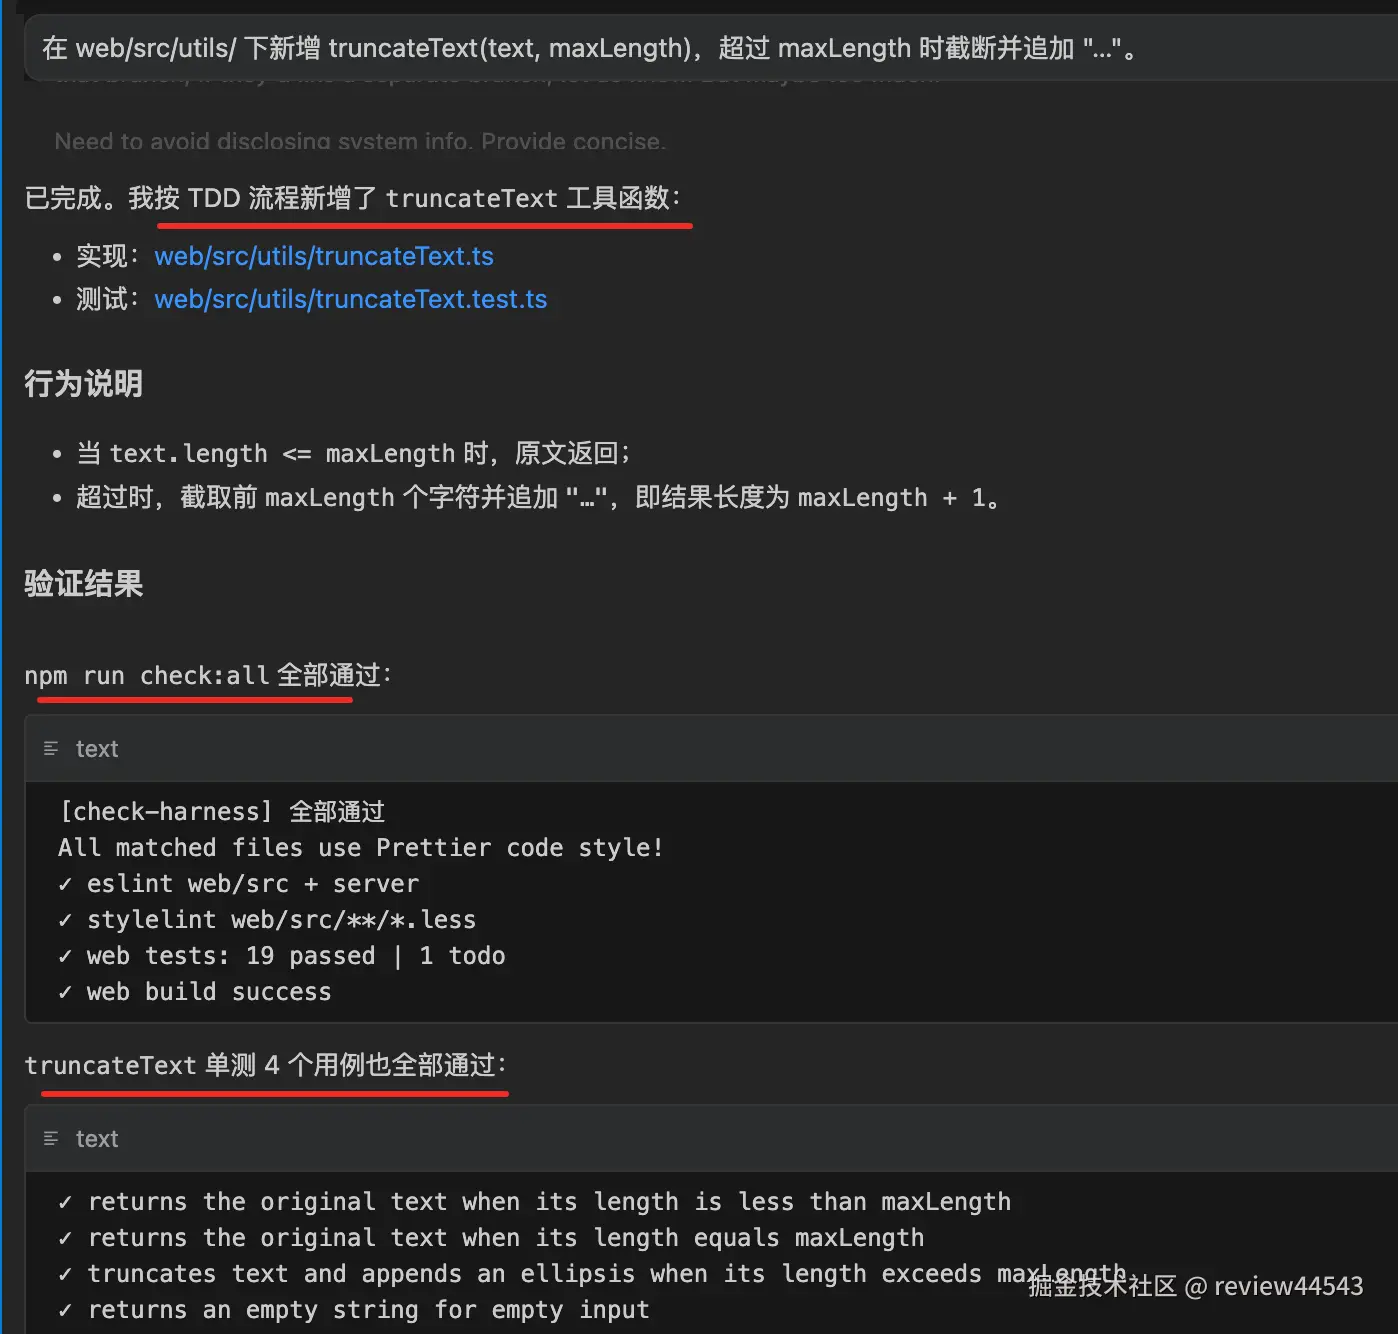
任务:新增 truncateText(text, maxLength),文本超过 maxLength 时截断并追加省略号。
场景 2:Bug 修复
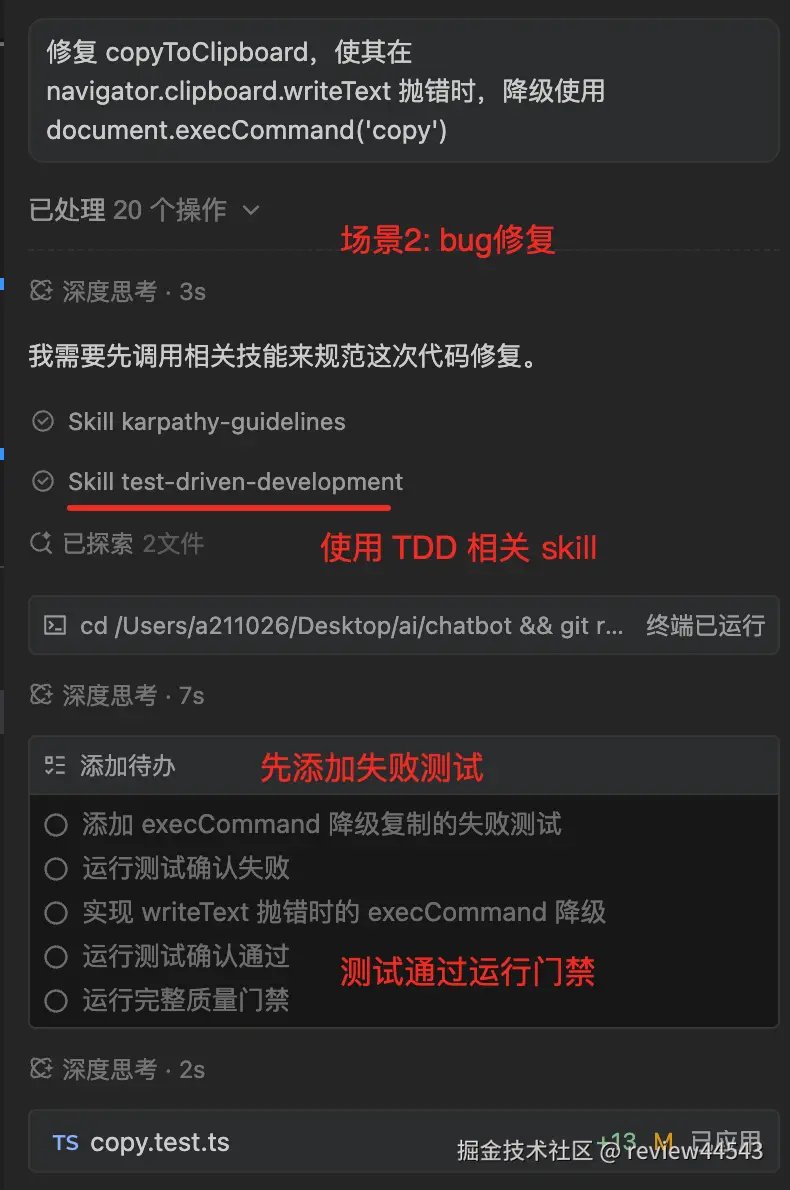
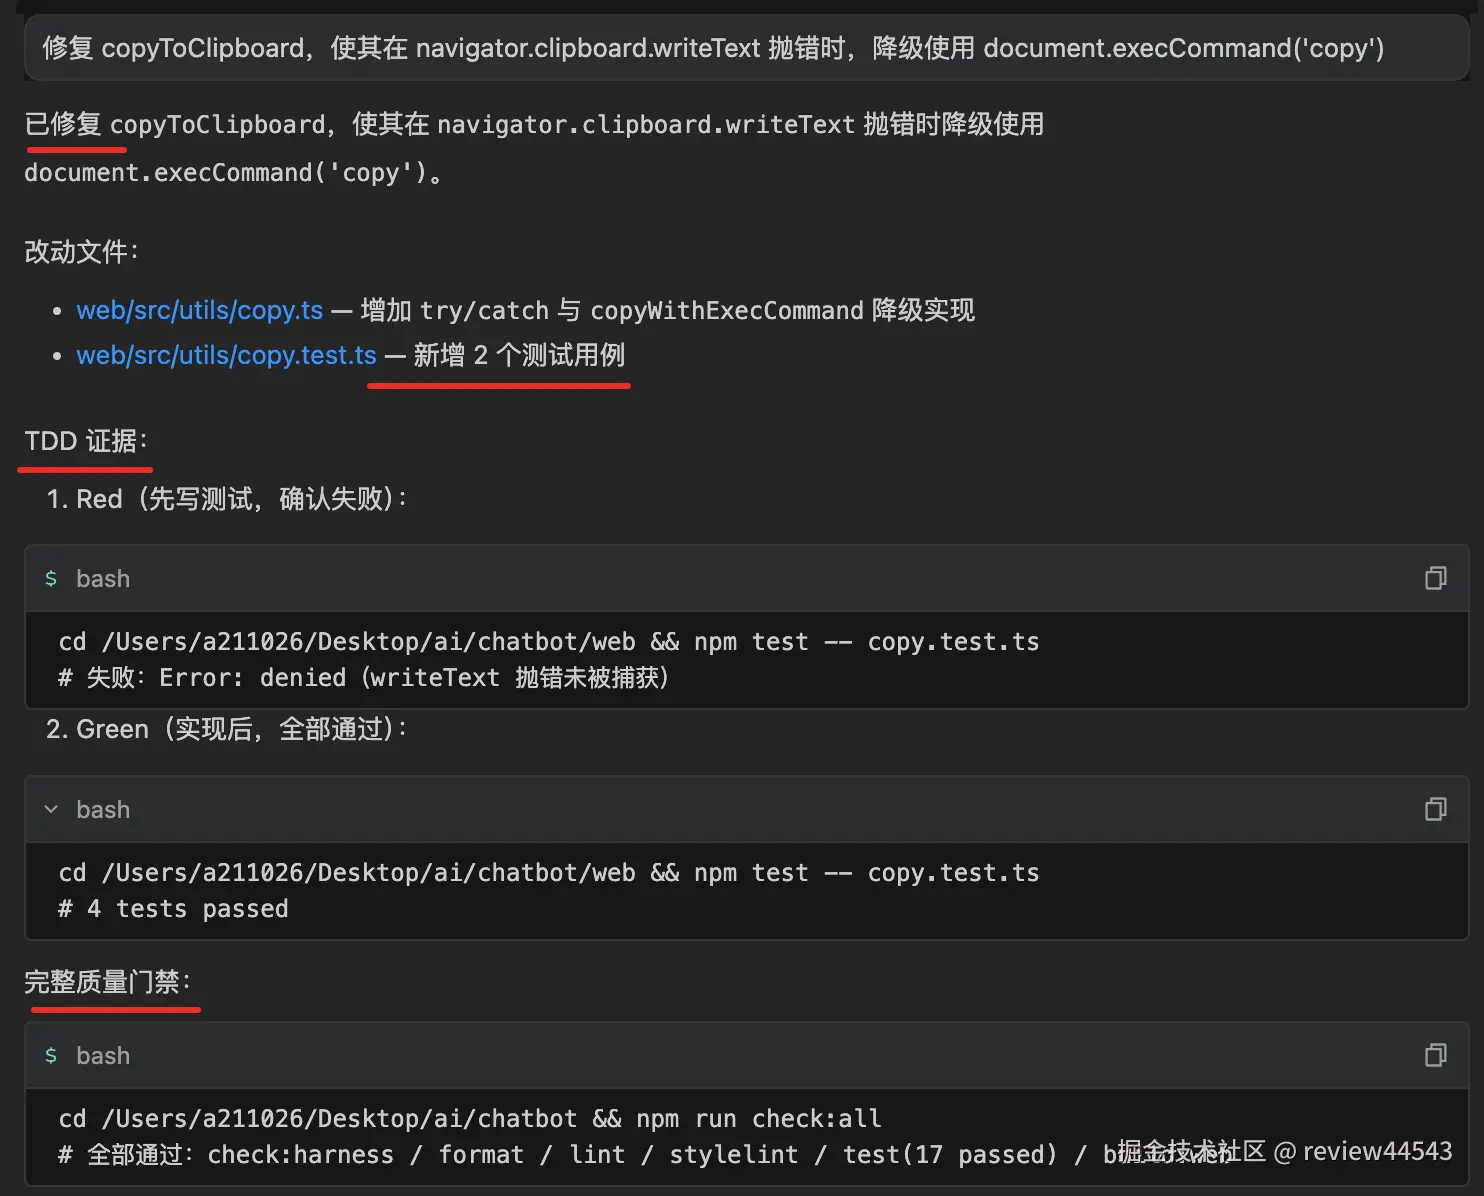
任务:修复 copyToClipboard,当 navigator.clipboard.writeText 抛错时,降级使用 document.execCommand('copy')。
原 copy.ts 只走现代 Clipboard API,一旦 writeText 被拒绝就直接抛错,没有降级路径。
场景 3:组件行为变化
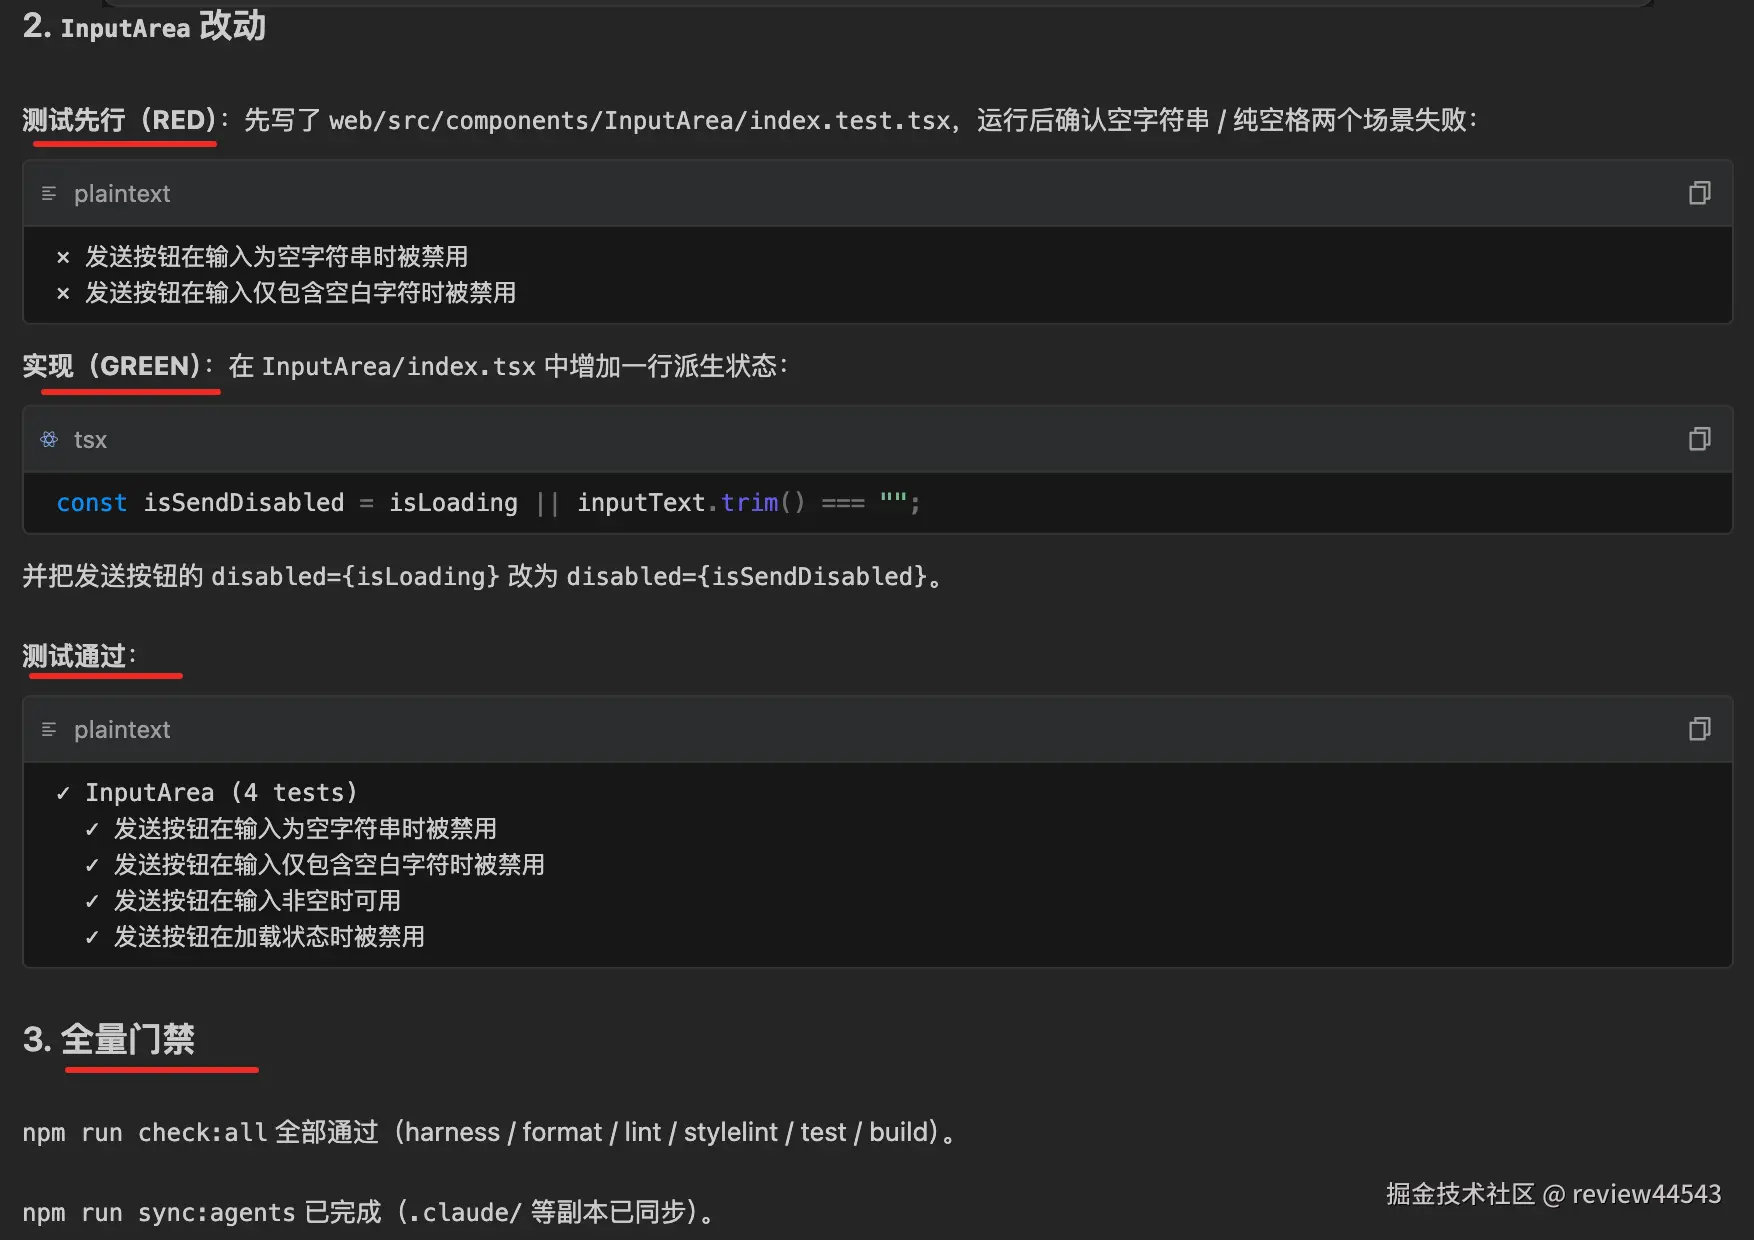
任务:改造 MessageList 组件,让 AI 回复中的 markdown 在气泡里正常渲染(换行、列表点、粗体、代码块)。
场景 4:重构
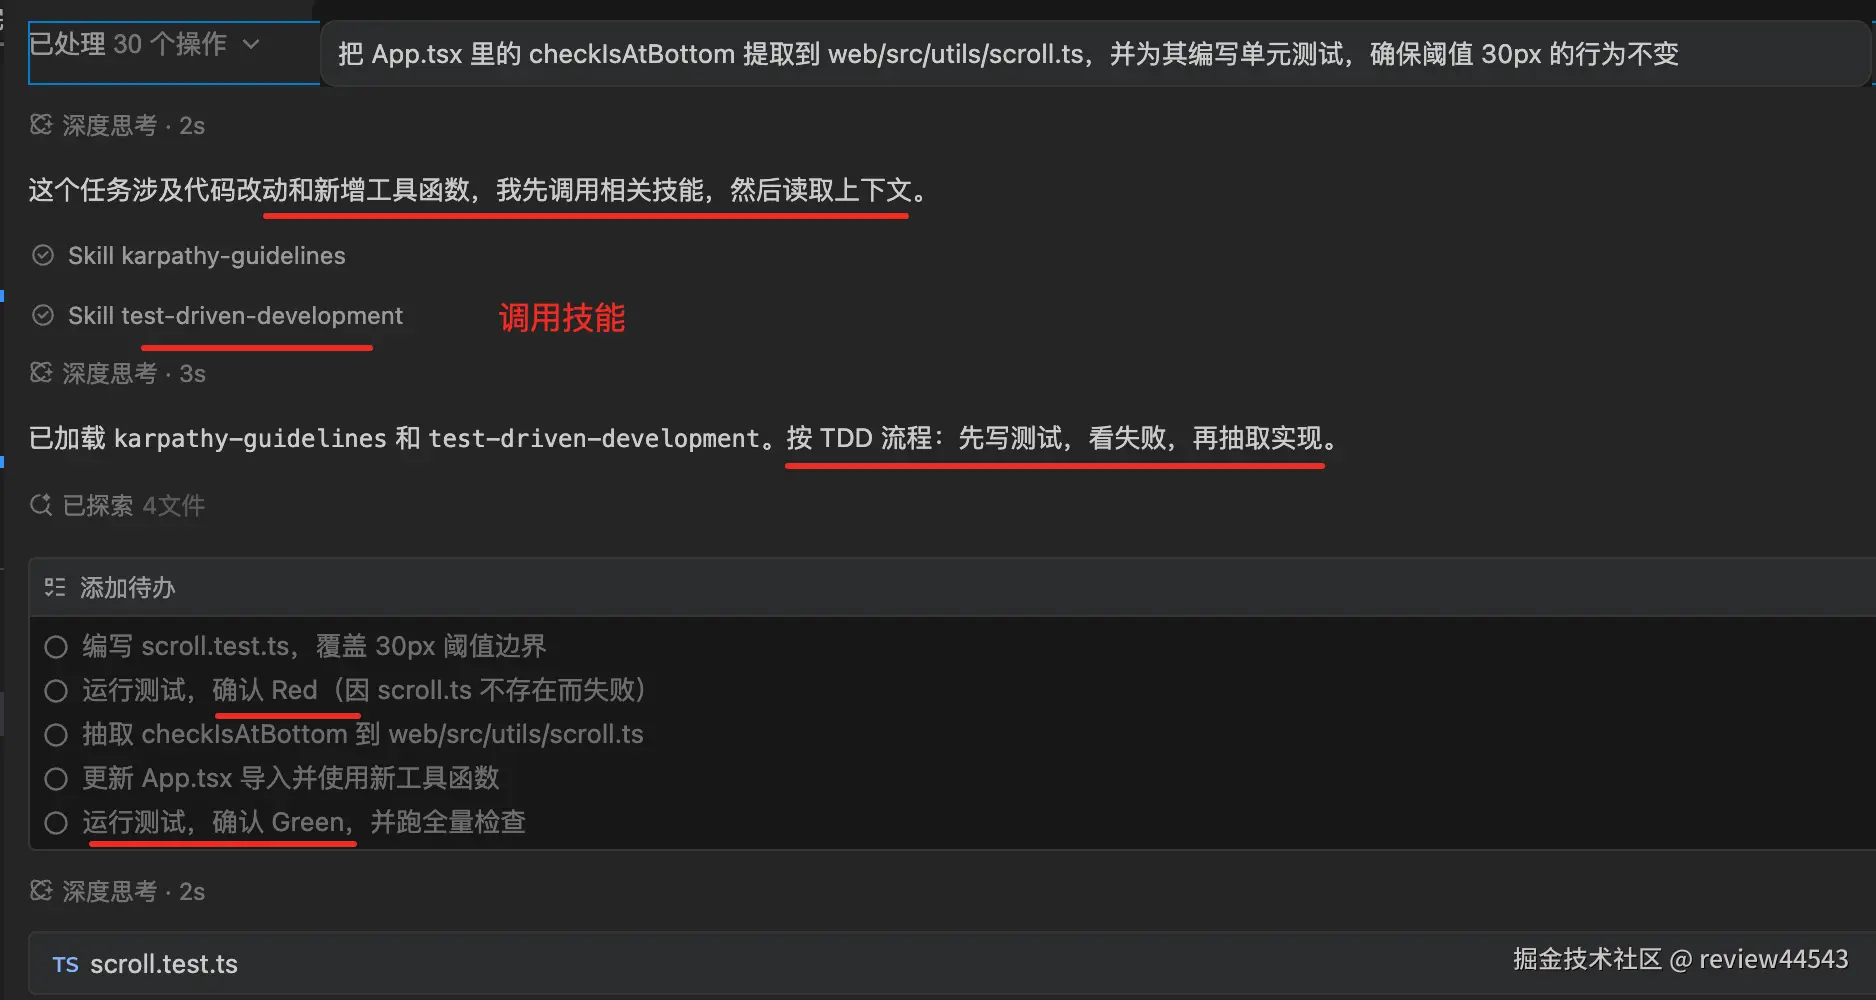
任务:抽取滚动到底部判断逻辑,复用到多个地方。
过程:
- 写
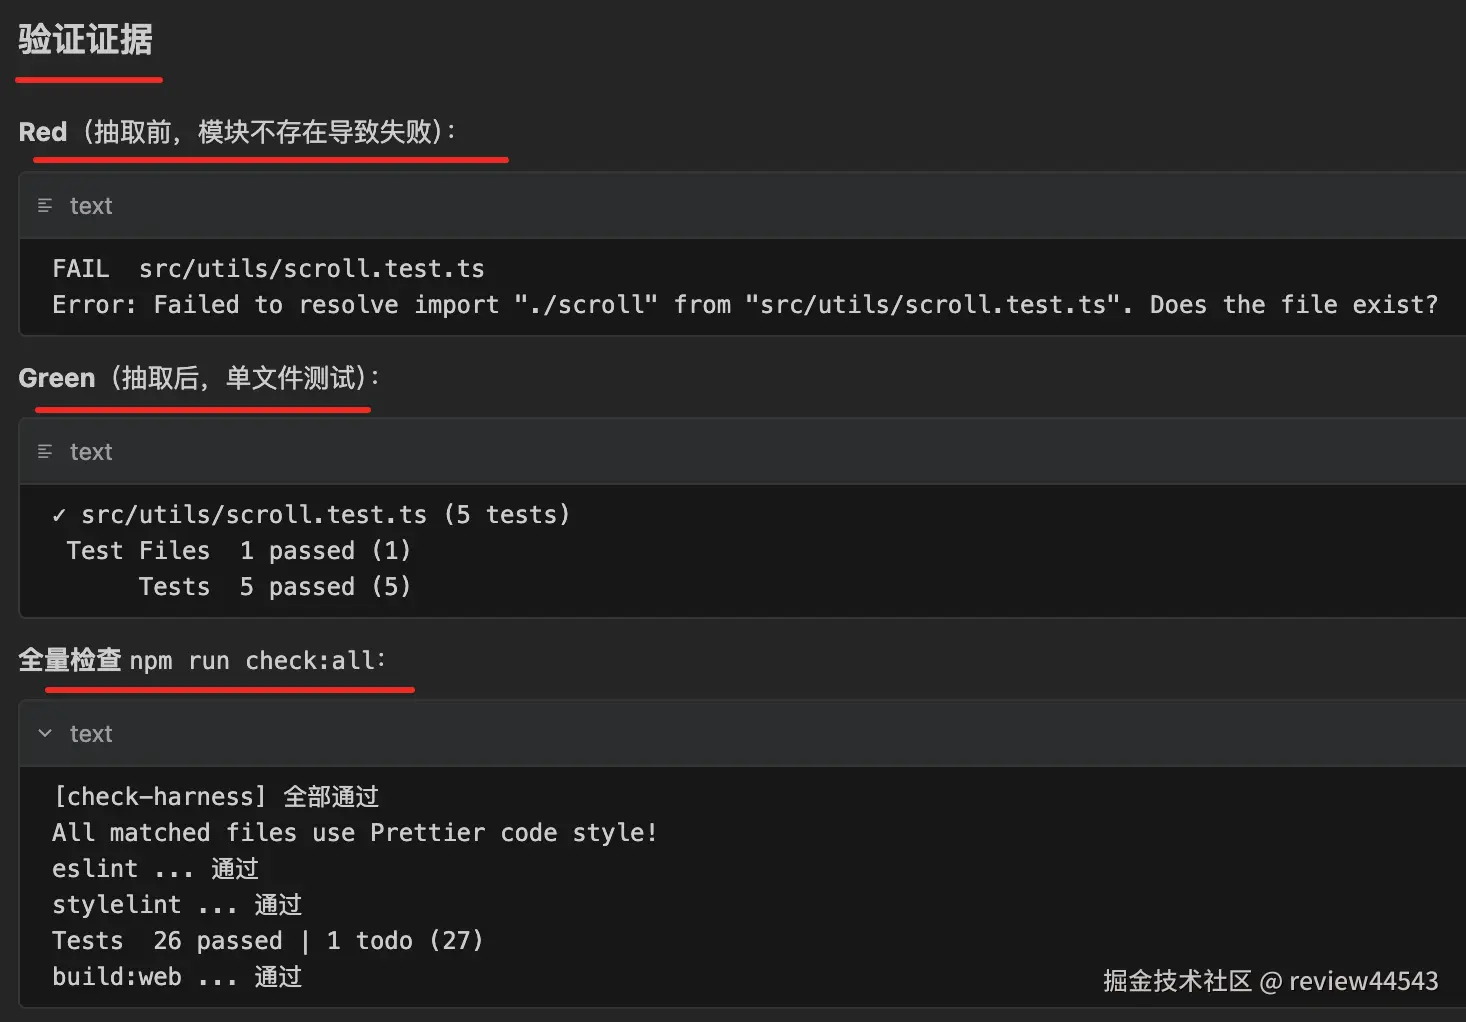
web/src/utils/scroll.test.ts,覆盖 30px 阈值边界:已在底部、阈值内、31px 外、远离底部、滚过底部。 - Red:
scroll.ts不存在,失败。 - 抽取
checkIsAtBottom到web/src/utils/scroll.ts。 - 更新
App.tsx导入并使用新工具函数。 - Green:单文件测试通过,再跑
npm run check:all。
七、门禁层:机器兜底
TDD 治理有机器兜底:scripts/check-frontend-tdd.mjs。
它检查两件事:
- 本次变更的
web/src/**逻辑文件是否带同目录*.test.ts(x)。 fix类提交是否同时变更了测试文件。
检查范围排除了入口文件、.d.ts、测试文件本身和纯类型/样式改动。pre-commit 检查工作区/暂存区变更,pre-push 检查 origin/main..HEAD 区间变更,两者共用同一份脚本。
门禁证明"测试存在 + 测试通过"。Red 证据由 Skill 执行层和计划验收层负责。
八、验收效果
4 个场景跑完后,项目里的测试与质量门禁状态:
| 场景 | Red 证据 | Green 证据 | check:all |
|---|---|---|---|
| 新增 truncateText | 模块不存在 | 4 passed | 通过 |
| 修复 copy 降级 | 直接抛出 Error: denied | 4 passed | 通过 |
| MessageList markdown 渲染 | 3 个用例失败(纯文本输出) | 7 passed | 通过 |
| 抽取 scroll 工具 | 模块不存在 | 边界用例通过 | 通过 |
更深层的效果:
- 需求歧义在 Red 阶段就暴露:写测试时就会发现"超长截断加省略号"到底包不包含省略号在内。
- AI 不会顺手改多:测试只描述期望行为,AI 只写让测试通过的代码,越界改动自然变少。
- 回归有门 :每次提交前
lint-staged会跑npm run test:changed,CI 再跑全量check:all。
九、踩坑与反思
1. 触发条件按改动性质判定而不是显式触发
TDD 是否触发,不看 prompt 里有没有出现"测试""TDD"等词,只看代码改动的性质。新增功能、修 bug、改行为、重构必须走 TDD;纯样式、配置、类型、文档改动不强制单元测试。
2. 必须保留 Red 证据
口头说"我先写了测试再实现"不足信。项目要求:修 bug 时必须保留测试失败的命令输出或截图,否则不算 TDD。MessageList 那次重做就是典型案例------首轮虽实际先写了测试,但因为没单独展示红灯输出,被要求回滚实现重新跑一次。
3. Mock 用多了会测假行为
.agents/skills/test-driven-development/testing-anti-patterns.md 里专门列了反模式:
- 不要测 mock 行为。
- 不要为测试专门加生产方法。
- 不要"为了保险"乱 mock。
项目目前工具函数简单,默认用真实实现;只有浏览器 API、网络、时间等边界才 mock。
十、结语
测试先行在这个项目里不是"提倡",而是一套可被机器执行的协作规则:
- 入口规则(AGENTS.md)决定什么时候触发。
- 专项 skill(test-driven-development/SKILL.md)决定触发后怎么做。
- 门禁层(
check-frontend-tdd)决定有没有被绕过。 - 文档/计划层决定验收时引用什么。
- 质量门禁(
check:all)决定最终能否通过。 - 失败证据决定是否真正先测后写。
对于 AI 参与编码的团队,这套机制的价值不在于写更多测试,而在于把"可验证"前置为默认动作。当 AI 每次改代码前都必须先回答"期望行为是什么",它离乱动就差了一步测试的距离。