Redis 常见的数据类型及底层结构
摘要:从 String 的 SDS、List 的 quicklist,到 Set 的三态转换、ZSet 的跳表 + 哈希表、Hash 的渐进式 rehash,逐层讲清 Redis 五种数据类型"为什么这样选底层结构",主线是内存与性能之间的平衡。
目录
- [首先简单介绍一下什么是 Redis 数据库?](#首先简单介绍一下什么是 Redis 数据库? "#heading-2")
- [Redis 常见的数据类型与底层数据结构的对应关系](#Redis 常见的数据类型与底层数据结构的对应关系 "#heading-3")
- [String 字符串类型](#String 字符串类型 "#heading-4")
- [String 类型中的底层数据结构](#String 类型中的底层数据结构 "#heading-5")
- [String 的三种编码](#String 的三种编码 "#heading-6")
- [String 类型总结](#String 类型总结 "#heading-7")
- [List 列表类型](#List 列表类型 "#heading-8")
- [List 类型的常见操作](#List 类型的常见操作 "#heading-9")
- [List 类型的应用场景](#List 类型的应用场景 "#heading-10")
- [List 类型的底层数据结构](#List 类型的底层数据结构 "#heading-14")
- [quicklist 的主要配置](#quicklist 的主要配置 "#heading-15")
- [List 操作的时间复杂度](#List 操作的时间复杂度 "#heading-16")
- [List 类型总结](#List 类型总结 "#heading-17")
- [Set 集合类型](#Set 集合类型 "#heading-18")
- [Set 类型的常见操作](#Set 类型的常见操作 "#heading-19")
- [Set 类型的应用场景](#Set 类型的应用场景 "#heading-20")
- [Set 类型的底层数据结构](#Set 类型的底层数据结构 "#heading-25")
- [Set 操作的时间复杂度](#Set 操作的时间复杂度 "#heading-29")
- [Set 类型总结](#Set 类型总结 "#heading-30")
- [ZSet 有序集合类型](#ZSet 有序集合类型 "#heading-31")
- [ZSet 类型的常见操作](#ZSet 类型的常见操作 "#heading-32")
- [ZSet 类型的应用场景](#ZSet 类型的应用场景 "#heading-33")
- [ZSet 类型的底层数据结构](#ZSet 类型的底层数据结构 "#heading-37")
- 什么是跳表
- [为什么 Redis 使用跳表而不是 B+ 树?](#为什么 Redis 使用跳表而不是 B+ 树? "#heading-43")
- [为什么 ZSet 同时使用 skiplist 和 dict](#为什么 ZSet 同时使用 skiplist 和 dict "#heading-44")
- [ZSet 操作的时间复杂度](#ZSet 操作的时间复杂度 "#heading-45")
- [ZSet 使用时的注意点](#ZSet 使用时的注意点 "#heading-46")
- [ZSet 类型总结](#ZSet 类型总结 "#heading-47")
- [ZSet 和 Set 的区别](#ZSet 和 Set 的区别 "#heading-48")
- [Hash 哈希类型](#Hash 哈希类型 "#heading-49")
- [Hash 类型的常见操作](#Hash 类型的常见操作 "#heading-50")
- [Hash 类型的应用场景](#Hash 类型的应用场景 "#heading-51")
- [Hash 类型的底层数据结构](#Hash 类型的底层数据结构 "#heading-55")
- [为什么 Hash 要使用两种数据结构](#为什么 Hash 要使用两种数据结构 "#heading-58")
- [Hash 使用时的注意点](#Hash 使用时的注意点 "#heading-59")
- [Hash 类型总结](#Hash 类型总结 "#heading-60")
- 各数据类型底层结构总结
首先简单介绍一下什么是 Redis 数据库?
- Redis 数据库是一种键值类型数据库,理解这一点非常重要
- 因为 Redis 数据库是一种键值类型数据库,所以它存储的都是 key-value 形式
- Redis 提供了各种类型的数据模型,也就是本章介绍的重点 ------ 常见的数据类型
- 纯内存运行(In-Memory): Redis 将数据全部存储在内存中,读写速度极快,这是它性能强劲的关键。
- 支持持久化(Persistence): 尽管数据在内存中,但 Redis 提供了 RDB (快照)和 AOF(追加日志)两种机制,可以将内存中的数据定期保存到硬盘中,防止数据丢失。(不是本章介绍的内容,可以先跳过,这里持久化的理解可以想一想 MySQL,MySQL 都是将数据存储在磁盘上。)
- 单线程模型: 这里的"单线程"指的是命令执行是单线程的,因此单条命令天然具有原子性。需要注意,Redis 6.0 起网络 I/O 已经支持多线程,只有命令执行仍然是单线程。
- 高可用与分布式
以上内容不需要全部掌握,在本章你只需要理解并掌握前面两点即可。
Redis 常见的数据类型与底层数据结构的对应关系
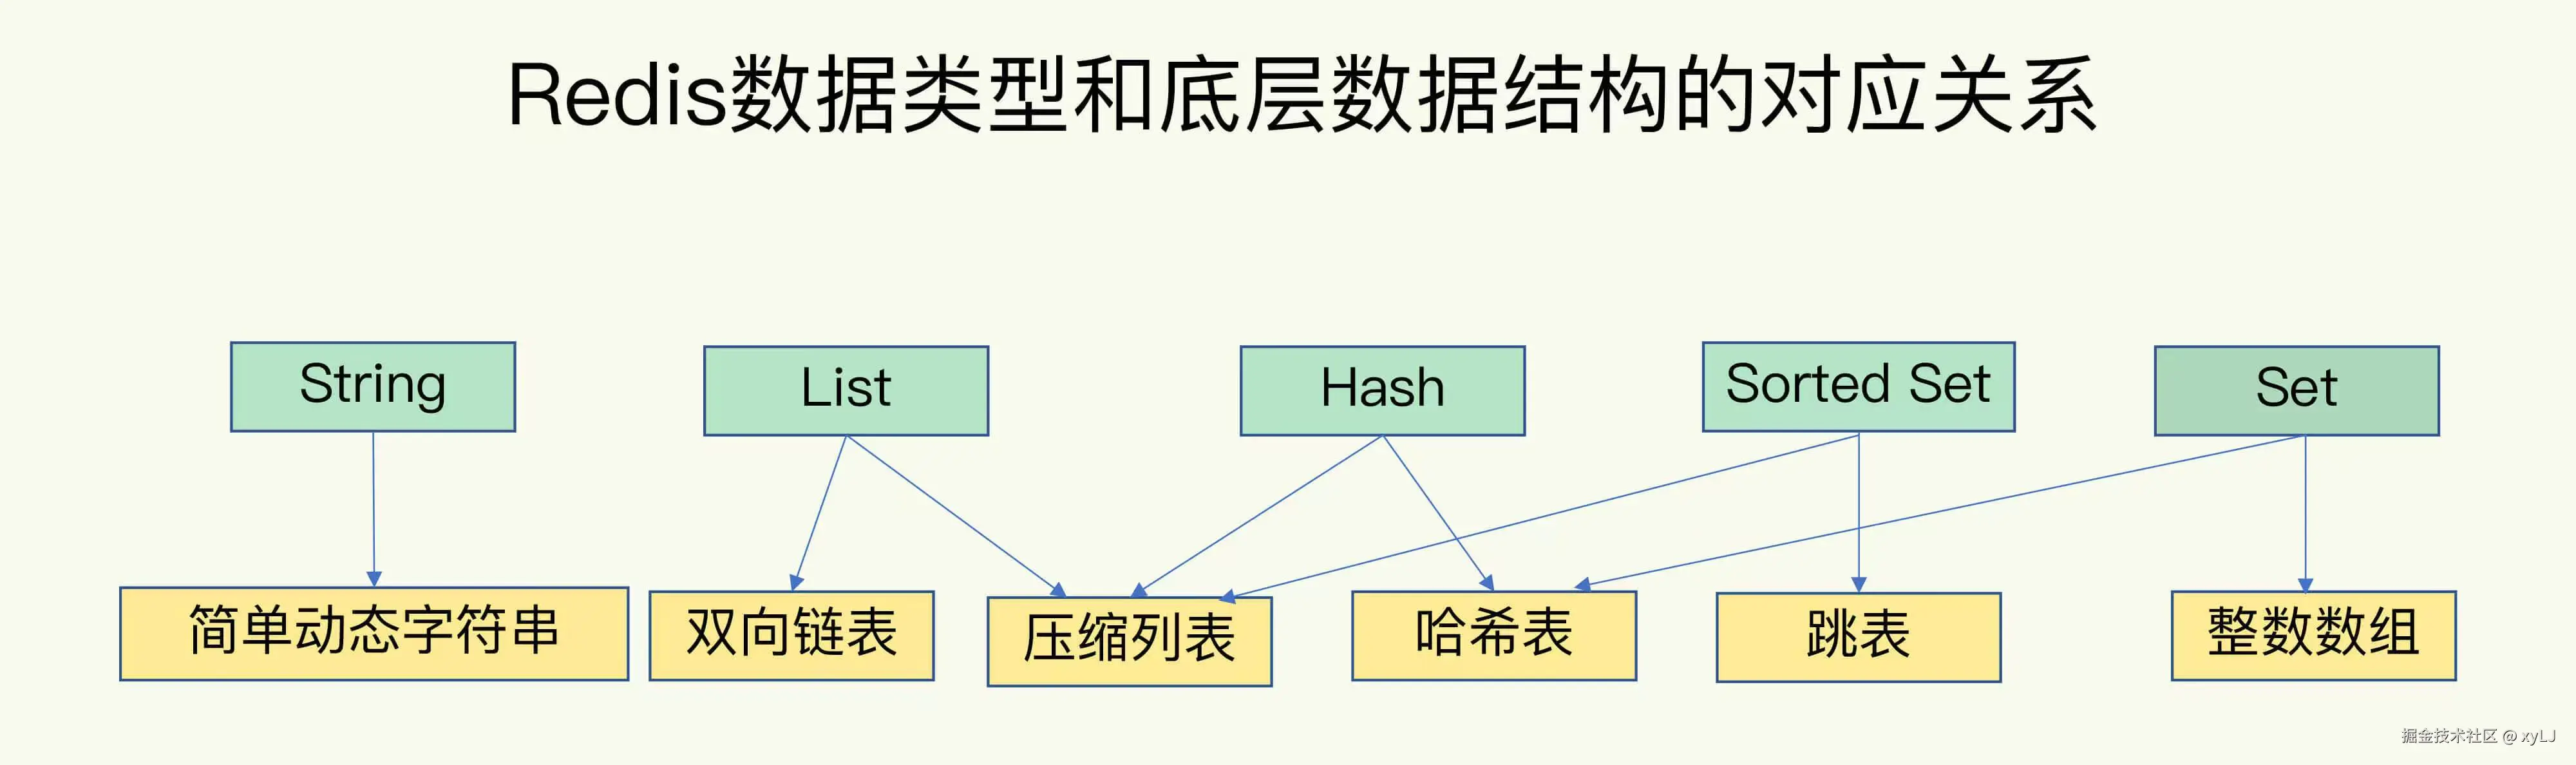
上述图片借鉴于极客时间,后续我们会以本章图片为展开点,逐步介绍 Redis 常见的数据类型以及对应的数据结构。上述图片表明一个数据类型可能使用了两种数据结构。为什么底层有两种数据结构?直接原因还是数据量的不同,使用不同的数据结构就是在时间和空间上达到一个平衡点。
String 字符串类型
-
String 类型里面可以存储的是字符串、整数、或者浮点数。
需要注意:Redis 的字符串是二进制安全 的,底层统一按字节序列保存,"整数"和"浮点数"更多是命令语义 上的概念 ------ 比如
INCR会把值当整数解析,INCRBYFLOAT会当浮点数解析。 -
String 类型常见的操作如下
- 添加元素:
SET key value - 获取元素:
GET key - 自增:
INCR key - 自减:
DECR key - 将 Key 对应的数字加上指定的整数:
INCRBY key n
- 添加元素:
-
String 类型的应用场景
-
缓存对象:我们可以把对象序列化成 JSON 字符串存进去,加速读取。通常用来缓存经常被访问的信息。
-
常规计数 :因为 Redis 的命令执行是单线程的,并且
INCR命令是原子操作,所以天然适合高并发下的点赞数、阅读数。下面是一个代码示例。bash# 文章 998 的阅读数加 1 INCR article:998:views -
分布式锁 :利用
SET key value NX EX 10(NX= not exist,EX= expire),只有不存在才能设置成功,保证互斥,并且设置了过期时间为 10s。需要注意:
value必须是一个唯一标识(例如 UUID + 线程 ID)。释放锁时要先比对 value 是否一致,再删除 key,否则可能误删别人持有的锁。 -
共享 Session:微服务架构下,多个服务共享同一个用户的登录状态,也就是状态的共享,查东西都用 Redis 里面的数据。
-
上面说明了 String 数据类型以及 String 数据类型常见的操作和用途,接下来说一下 String 类型的底层数据结构。
String 类型中的底层数据结构
- String 类型的底层是由简单动态字符串(SDS,Simple Dynamic String)来实现的
- 什么是动态字符串,为什么要用简单动态字符串?
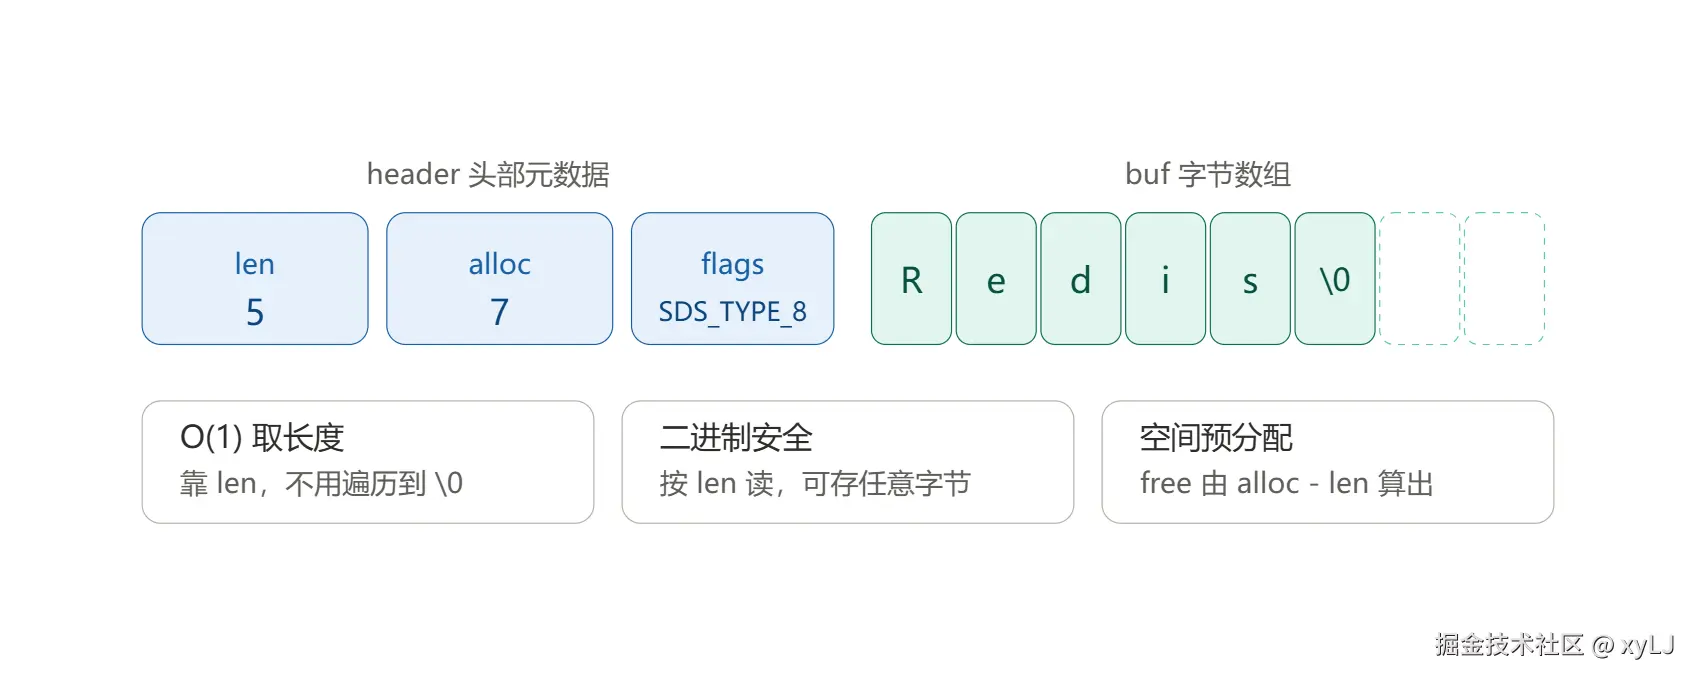
由上图可以看出简单动态字符串由四部分组成:
-
len :记录了字符串长度,如图中 Redis 一共占了五个字符,所以字符串的长度就是 5。需要注意的是,这个
'\0'并不计入字符串的长度,它代表字符串结束的标志。这样就可以很自然地理解 SDS 相对于 C 语言中字符串的第一个好处:
- 可以使用 O(1) 的时间复杂度获取字符串的长度。
-
二进制安全 :这个二进制安全是指,相对于 C 语言字符串,判断字符串是否结束不需要通过
'\0'来判断。上面图中之所以加上\0,是因为要兼容部分 C 语言的标准库函数。举一个简单例子:假设我们要存一段二进制数据,这个二进制数据是
0x41 0x42 0x00 0x43 0x44。在 C 语言眼里,当它读到0x00的时候,就认为数据已经读到末尾了,所以这个二进制数据就会被截断,这就是非二进制安全。而 Redis 处理数据的时候只认长度,不认特殊字符,从而保证存进去的数据是什么样,拿出来数据就是什么样,这就是二进制安全。 -
alloc:分配给字符串数组的空间长度。
图片中
buf[]数组一共有 8 个格子,而alloc的值是 7 ------ 多出来的那 1 个格子就是末尾终止符'\0'。也就是说alloc记录的是实际分配给buf的容量,它不包含末尾的'\0'。Redis 分配源码里,也通过加 1 来预留末尾终止符'\0':csh = s_malloc(hdrlen + alloc + 1); /* 这个 +1 就是 \0 */当修改字符串的时候,比如追加操作,可以通过
alloc - len来获取剩余空间free的大小,如果free不够用的时候会进行扩容,直到满足所需的大小,这样有一个好处:-
不会发生缓冲区的溢出:当我们使用 C 语言字符串的时候,这个缓冲区的大小是由我们程序员来指定的,当我们一直追加写,程序内部不会自己判断空间是否足够,就可能导致缓冲区溢出。代码示例:
c#include <stdio.h> #include <string.h> int main() { /* 1. C 语言中没有 string 类型,必须声明为 char 数组 这里的数组大小为 20 字节 */ char buffer[20] = "Hello"; printf("初始字符串: %s\n", buffer); printf("字符串实际长度 (strlen): %zu\n", strlen(buffer)); /* 输出 5 */ printf("数组占用的内存空间 (sizeof): %zu 字节\n", sizeof(buffer)); /* 输出 20 */ printf("\n--- 进行字符串追加 ---\n"); /* 2. 危险做法(不安全): strcat(buffer, " World! Welcome to C!"); 如果把上面这行解禁,由于拼接后的字符串超过了 20 字节, 就会导致严重的【缓冲区溢出】! */ /* 3. 安全做法:使用带长度限制的 strncat 明确告诉函数,目标 buffer 最多还能接收多少字节 (20 - 5 - 1 = 14) */ char append_str[] = " World!"; size_t free_space = sizeof(buffer) - strlen(buffer) - 1; /* 留 1 字节给 '\0' */ strncat(buffer, append_str, free_space); printf("拼接后的字符串: %s\n", buffer); printf("拼接后的长度: %zu\n", strlen(buffer)); /* 输出 12 */ return 0; }
-
-
flags:用来表示不同类型的 SDS。
一共有 5 种 SDS 类型,分别适应不同长度的字符串。这个字段存在的意义有以下几点:
- 类型识别 :
flags只占一个字节,低三位 用来标识当前 SDS 的类型(SDS_TYPE_5 / 8 / 16 / 32 / 64),而类型决定了len和alloc这两个字段各占几个字节。读取时先看flags,就能知道该按哪种头部格式解析,从而快速定位。 - 内存优化:配合 5 种不同的头部类型,让不同长度的字符串使用最合适的大小,减少分配大的头部导致的空间浪费。
- 类型识别 :
String 的三种编码
除了 SDS 自身的头部类型,Redis 在对象层面还会根据内容选择不同的编码。这也是"一个数据类型可能对应多种底层结构"的体现:
- int :值是可以用
long表示的整数时,直接把数字存在ptr指针的位置上,不额外分配内存。 - embstr :长度不超过 44 字节 的字符串,SDS 与 redisObject 分配在同一块连续内存中,只需要一次内存分配。
- raw:长度超过 44 字节的字符串,SDS 与 redisObject 分开分配,需要两次内存分配。
因此,对一个 int 编码的值执行 APPEND,或对 embstr 编码的值执行修改类命令时,编码会转换为 raw。
String 类型总结
Redis String 是二进制安全的字符串,底层使用 SDS,通过 len、alloc、flags 三个字段实现了 O(1) 取长度、二进制安全和内存优化;在对象层面又有 int、embstr、raw 三种编码,进一步兼顾内存与性能。
List 列表类型
Redis 的 List 类型可以理解为一个有序、可重复的字符串序列。它支持从列表左边或右边添加、删除元素,因此既可以实现队列,也可以实现栈。
List 类型的常见操作
- 从左侧添加元素:
LPUSH key element [element ...] - 从右侧添加元素:
RPUSH key element [element ...] - 从左侧弹出元素:
LPOP key - 从右侧弹出元素:
RPOP key - 获取指定范围的元素:
LRANGE key start stop - 获取指定下标的元素:
LINDEX key index - 获取列表长度:
LLEN key - 阻塞式弹出元素:
BLPOP key timeout、BRPOP key timeout
下面通过一个简单示例理解 List:
bash
# 从左边依次插入 Java、MySQL、Redis
LPUSH study:list Java MySQL Redis

# 查看整个列表
LRANGE study:list 0 -1

# 从右边弹出一个元素
RPOP study:list需要注意:LPUSH study:list Java MySQL Redis 会依次从左边插入,因此最终顺序是 Redis、MySQL、Java。
List 类型的应用场景
1. 消息队列
生产者从一端插入消息,消费者从另一端取出消息:
bash
LPUSH order:queue order-1001
BRPOP order:queue 0
BRPOP 中的 0 表示一直阻塞等待,当然我们也可以设定具体等待时间,比如 BRPOP order:queue 30 就是将等待时间设置为 30 秒。当队列中没有消息时,消费者不会不断轮询,从而避免浪费 CPU。
但是 List 做消息队列存在明显不足:
- 消息弹出后就从 List 中删除,消费者处理失败时可能丢失消息。
- 没有完善的 ACK 确认机制。
- 不支持消费者组和消息回溯。
因此,List 更适合简单的轻量队列;如果需要消费者组、ACK、消息重试和历史消息查询,通常应使用 Redis Stream。
2. 栈
同一端进入、同一端取出,就是先进后出(LIFO)的栈:
bash
LPUSH stack a
LPUSH stack b
LPOP stack
最后插入的 b 会最先被取出。
3. 最新消息列表
例如只保留某个用户最新的 100 条动态:
bash
LPUSH user:1001:feed new-message
LTRIM user:1001:feed 0 99
LPUSH 添加最新消息,LTRIM 只保留下标 0~99 的数据,从而避免列表无限增长。
List 类型的底层数据结构
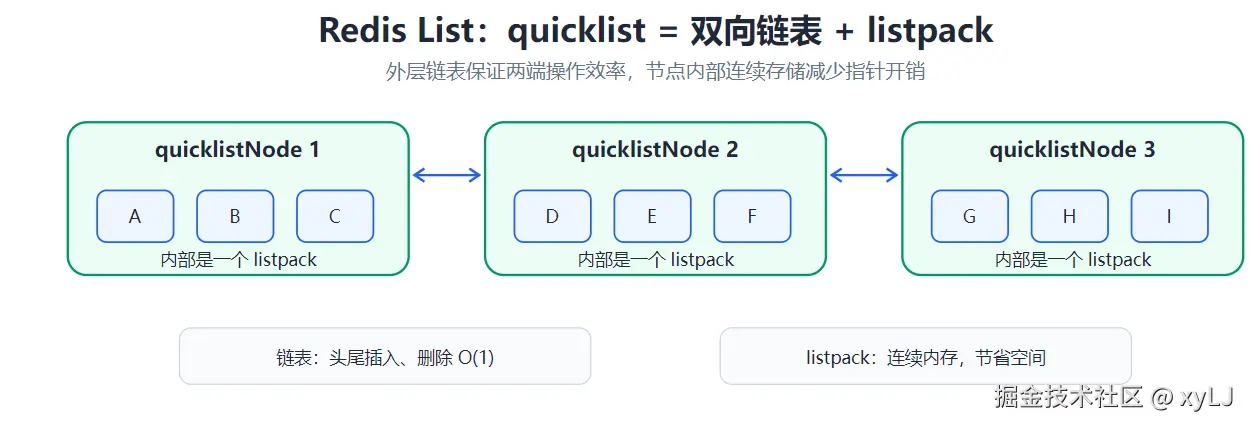
Redis 3.2 以后,List 的底层主要使用 quicklist 。在 Redis 7.0 以后,quicklist 的每个节点内部主要存放 listpack ;在 Redis 6.2 及以前,节点内部常见的是 ziplist。
可以把 quicklist 理解为:
quicklist = 双向链表 + listpack
什么是 ZipList(压缩列表)?
- ZipList 是 Redis 为了节省内存而设计的一种连续内存块组成的顺序型数据结构。
ZipList 的数据结构是什么样的,为什么 ZipList 更省内存?
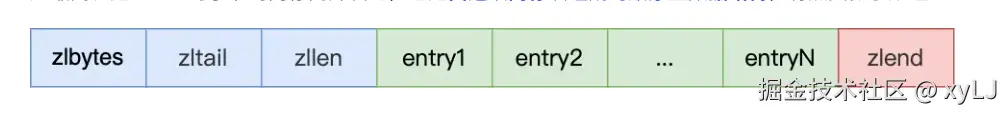
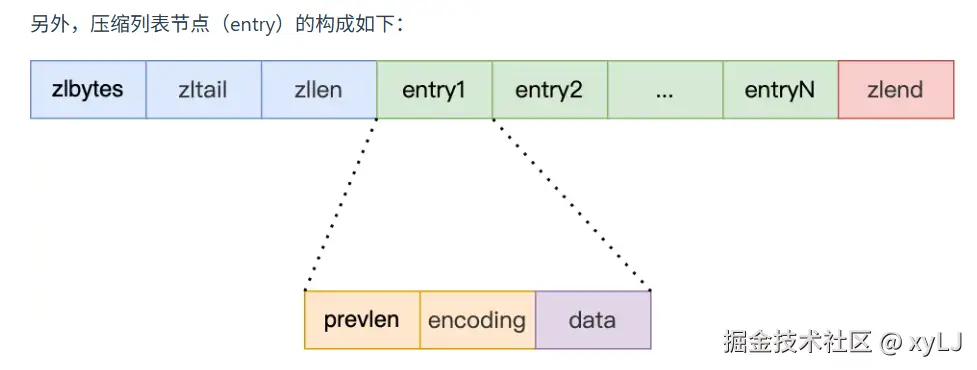
上面两张图分别展示了 ZipList 的数据结构和压缩列表节点的数据结构(图片来源于小林 coding)。
-
ZipList 由四部分组成
zlbytes:记录整个压缩列表占用的内存字节数zltail:记录最后一个节点距离 ZipList 起始地址的字节偏移数zllen:记录压缩列表包含的节点数量zlend:标记压缩列表的结束点,固定值0xFF
-
entry 由图中可知由三部分组成
prevlen:前一个节点的长度encoding:当前数据编码与长度data:数据内容
-
举一个例子:
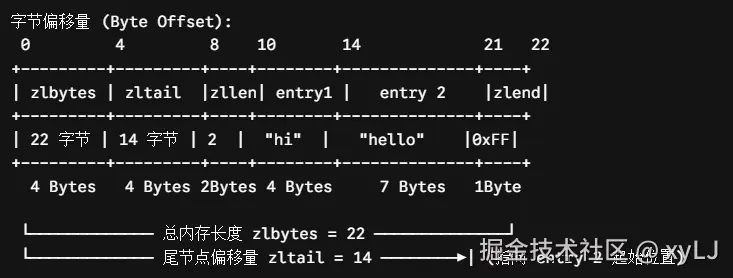
上面图片我们存储了两个节点,分别是 hi 和 hello 这两个字符串,hi 的 entry 存储就是这样的:
prevlen(前一个节点长度):因为它是第一个节点,前面没有节点,所以它占用一字节来存储 0encoding(当前数据编码与长度):字符串 "hi" 长度为 2,占一个字节data(数据内容):"hi" 的 ASCII 码占两个字节
根据上面分析我们就可以得出为什么压缩列表节省空间:
- 它不需要像双向链表那样为每个节点存储前驱指针和后继指针。在 64 位系统中,这两个指针要占用 16 个字节,而 ZipList 通过
prevlen和encoding就能定位相邻节点。 - ZipList 不会为字段分配固定大小的空间,而是根据字段长度分配最合适的空间长度。
压缩链表有什么缺点,为什么 Redis 7.0 以后使用 listpack?
- 压缩链表有一个很明显的缺点就是连锁更新 问题。为什么会导致连锁更新呢?归根结底是因为
prevlen字段,prevlen字段存储了上一个节点的长度。如果某个节点的总长度发生了变化,就会导致下一个节点的prevlen长度发生变化,从而一直传递下去,如图所示
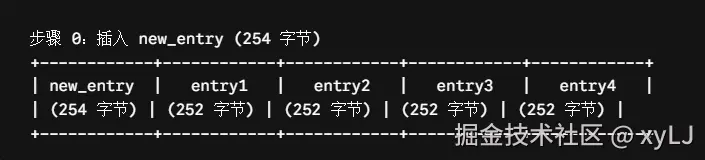
prevlen 占用的字节数是变长的:
- 当前一个节点的长度小于 254 时,
prevlen用 1 个字节 保存,最大能表示 253。(为什么是 253?因为 254 和 255 是保留值:255 表示 ZipList 的结束标志zlend,254 表示"后面还有 4 个字节才是真正的长度",所以 1 字节实际能表示的范围是 0~253。) - 当前一个节点的长度大于等于 254 时,
prevlen需要 5 个字节保存。
假设我们插入一个新节点,大小为 254,那么 entry1 的 prevlen 本来只用 1 个字节,现在必须扩展成 5 个字节,于是 entry1 的总长度增加了 4 个字节。如果 entry1 原本的总长度是 252,扩展后就变成 256,又超过了 253 的边界,那么 entry2 的 prevlen 也必须跟着扩展......就这样一个接一个传递下去,这就是连锁更新问题。所以 ZipList 只用于保存的节点数量不多的场景,避免大范围的更新。
为了解决这个问题引入了 listpack(紧凑列表),什么是 listpack?
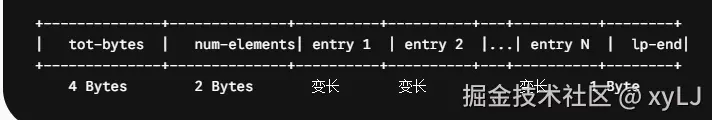
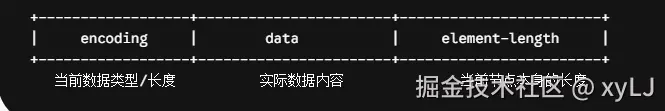
上面两张图片给出了 listpack 的数据结构和节点结构:
- listpack 结构
tot-bytes:listpack 的总字节数num-elements:listpack 的元素数量
- 节点结构
encoding:当前数据类型 / 长度data:实际数据内容element-length:当前节点本身长度
我们可以发现没有 prevlen,于是我们添加一个新节点或者一个节点的变化,不会影响相邻节点,于是解决了连锁更新问题。至于从后往前遍历的实现这里不做过多阐述,本质还是计算偏移量并且利用连续存储空间的性质。
为什么不直接使用普通双向链表?
如果每一个元素都是单独的链表节点,那么每个元素都需要额外保存 prev 和 next 两个指针。假设 List 中保存的是很多短字符串,指针占用的空间甚至可能比数据本身还大。
为什么不只使用一整块 listpack?
listpack 使用连续内存,非常节省空间,但是数据量很大时,在中间插入或删除元素可能需要移动后面的数据,内存扩容时也可能需要重新分配一整块连续空间。
所以 Redis 做了一个平衡:
- 外层使用双向链表,方便从头尾快速插入和删除。
- 每个链表节点内部使用 listpack,一次存放多个元素,减少指针和内存碎片。
quicklist 的主要配置
Redis 可以通过下面两个配置控制 quicklist:
bash
list-max-listpack-size -2
list-compress-depth 0list-max-listpack-size:控制每个 quicklist 节点中的 listpack 大小。默认值-2表示每个节点大约限制为 8KB。(Redis 7.0 之前,这个配置叫list-max-ziplist-size。)list-compress-depth:控制 quicklist 中间节点是否压缩。默认值0表示不压缩;设置为1表示头尾各保留一个节点不压缩,中间节点可以压缩。
之所以通常不压缩头尾节点,是因为 List 最常见的操作就是从头尾插入和删除。如果头尾也压缩,每次操作前都要解压,反而会影响性能。
List 操作的时间复杂度
LPUSH、RPUSH、LPOP、RPOP:O(1)LLEN:O(1)LINDEX:O(N)LRANGE:O(S + N),其中 S 是到起始位置的距离,N 是返回的元素数量LREM:O(N)
List 的优势在于两端操作 ,而不是随机访问。它不像数组一样可以根据下标直接定位元素,因此对一个很长的 List 执行 LINDEX key 50000,需要沿着链表逐步查找。
List 类型总结
Redis List 是一个有序、可重复的字符串序列,底层使用 quicklist,在双向链表和连续内存之间取得平衡。它适合实现栈、简单队列和最新消息列表,但不适合频繁随机访问,也不适合对可靠性要求很高的消息队列。
Set 集合类型
Redis 的 Set 类型可以理解为一个无序、元素唯一的字符串集合。
它与 List 的主要区别是:
- List 中的元素有顺序,并且允许重复。
- Set 中的元素没有固定顺序,并且不允许重复。
Set 类型的常见操作
- 添加元素:
SADD key member [member ...] - 删除元素:
SREM key member [member ...] - 判断元素是否存在:
SISMEMBER key member - 获取全部元素:
SMEMBERS key - 获取集合元素数量:
SCARD key - 随机获取元素:
SRANDMEMBER key [count] - 随机弹出元素:
SPOP key [count] - 求交集:
SINTER key [key ...] - 求并集:
SUNION key [key ...] - 求差集:
SDIFF key [key ...]
例如,给文章添加标签:
bash
SADD article:1001:tags Java Redis Backend
SADD article:1001:tags Redis
SCARD article:1001:tags
虽然 Redis 被添加了两次,但集合中只会保存一份,因此 SCARD 的结果是 3。
Set 类型的应用场景
1. 去重
例如统计访问过某篇文章的独立用户:
bash
SADD article:1001:visitors user-1
SADD article:1001:visitors user-2
SADD article:1001:visitors user-1
SCARD article:1001:visitors
同一个用户重复访问时,成员不会重复保存,因此可以天然实现去重。
2. 共同关注和共同好友
bash
SINTER user:1:follows user:2:follows两个用户关注集合的交集,就是共同关注。
3. 抽奖
bash
SRANDMEMBER lottery:users 3SRANDMEMBER 只随机读取成员,不会删除;如果希望抽中后不再参与,可以使用 SPOP。
4. 点赞用户集合
bash
SADD article:1001:likes user-100
SISMEMBER article:1001:likes user-100
SCARD article:1001:likes
可以快速判断某个用户是否点过赞,并统计点赞人数。
Set 类型的底层数据结构
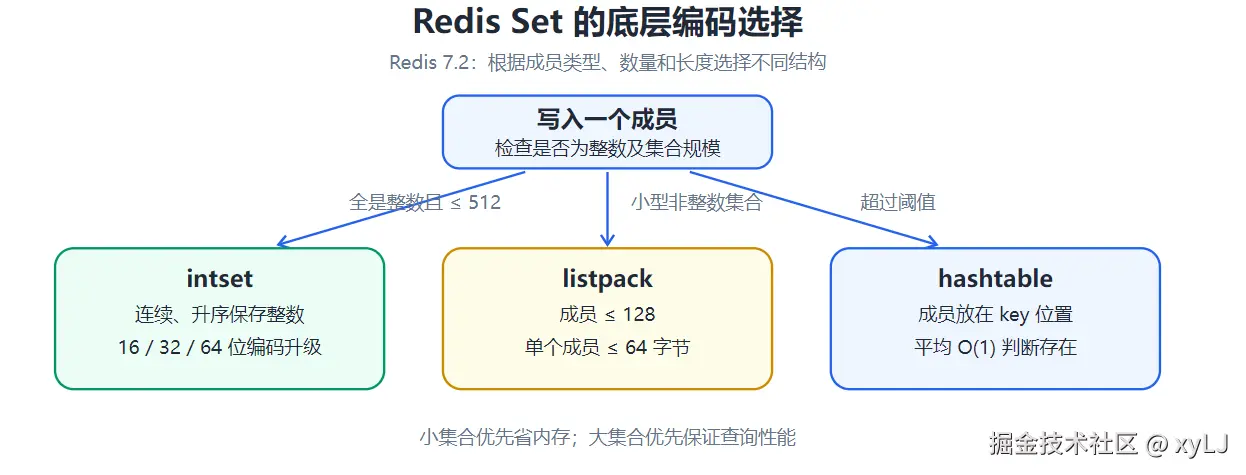
Set 的底层结构与成员内容、成员数量以及 Redis 版本有关。
1. intset:整数集合
当 Set 中的成员全部可以表示为整数,并且成员数量不超过配置阈值时,Redis 会优先使用 intset。
bash
set-max-intset-entries 512默认情况下,纯整数 Set 的成员数量不超过 512 时,可以使用 intset。
intset 的特点:
- 使用一块连续内存保存整数,没有对象指针开销。
- 内部元素从小到大排列,可以使用二分查找。
- 会根据整数范围选择 16 位、32 位或者 64 位编码。
- 当加入更大的整数时,可能发生编码升级,例如从 16 位升级为 32 位。
intset 的升级是整体升级:Redis 需要把原来的每个元素转换为更宽的整数格式。升级后的 intset 通常不会再自动降级。
2. listpack:紧凑列表
Redis 7.2 开始,小型且包含非整数成员的 Set 也可以使用 listpack:
bash
set-max-listpack-entries 128
set-max-listpack-value 64
默认情况下,成员数量不超过 128,并且单个成员长度不超过 64 字节时,可以使用 listpack。
listpack 把多个成员连续存放在一块内存中,不需要为每个成员分别创建完整的 Redis 对象,因此比较节省内存。但查找一个成员需要顺序扫描,时间复杂度是 O(N)。因为只有小集合才使用 listpack,所以 N 较小时这种代价通常可以接受。
3. hashtable:哈希表
当成员数量超过阈值、单个成员太大,或者当前条件不适合继续使用紧凑编码时,Set 会使用哈希表。
哈希表中,Set 的成员保存在 key 的位置,而 value 不需要保存有效数据。通过哈希表查找成员,平均时间复杂度可以达到 O(1)。
这就是 Set 为什么可能有多种底层结构:
- 数据少并且全是整数:intset 最省内存。
- 数据少但包含非整数成员:Redis 7.2 以后可以使用 listpack。
- 数据多或者成员较大:hashtable 保证查询效率。
本质上仍然是在空间和时间之间进行平衡。紧凑编码节省内存,但查询需要扫描;哈希表占用更多内存,但查询速度更稳定。
Set 操作的时间复杂度
SADD、SREM、SISMEMBER:使用哈希表时平均 O(1)SCARD:O(1)SMEMBERS:O(N)SINTER、SUNION、SDIFF:与参与运算的集合大小有关
在生产环境中要谨慎对大 Set 执行 SMEMBERS,因为它会一次返回全部成员。数据量很大时,应该考虑使用 SSCAN 分批遍历。
Set 类型总结
Redis Set 是一个无序、不可重复的字符串集合。小型纯整数集合使用 intset,小型且包含非整数成员的集合在 Redis 7.2 以后可以使用 listpack,大型集合使用 hashtable。它适合去重、共同好友、标签、点赞和抽奖等场景。
ZSet 有序集合类型
ZSet 也叫 Sorted Set,可以理解为一个有序、成员唯一的集合。
ZSet 中每个成员都对应一个 score 分数:
text
member       score
张三          90
李四          85
王五          95
成员 member 不能重复,但不同成员的 score 可以相同。Redis 先按照 score 从小到大排序;score 相同时,再按照 member 的字典序排序。
ZSet 类型的常见操作
- 添加成员:
ZADD key score member [score member ...] - 获取成员分数:
ZSCORE key member - 获取成员排名:
ZRANK key member - 获取倒序排名:
ZREVRANK key member - 按排名范围查询:
ZRANGE key start stop [WITHSCORES] - 按分数范围查询:
ZRANGEBYSCORE key min max [WITHSCORES] - 增加成员分数:
ZINCRBY key increment member - 删除成员:
ZREM key member [member ...] - 获取成员数量:
ZCARD key
补充:Redis 6.2 之后,
ZREVRANGE和ZRANGEBYSCORE推荐改用统一的ZRANGE写法 ------ZRANGE key start stop REV(倒序按排名)、ZRANGE key min max BYSCORE(按分数)。旧命令仍然可用。
例如保存游戏积分排行榜:
bash
ZADD game:rank 100 user-1
ZADD game:rank 200 user-2
ZINCRBY game:rank 50 user-1
ZRANGE game:rank 0 -1 WITHSCORES
ZREVRANGE game:rank 0 9 WITHSCORES
ZSet 类型的应用场景
1. 排行榜
把用户 ID 作为 member,把积分作为 score:
bash
ZINCRBY rank:score 10 user:1001
ZREVRANGE rank:score 0 9 WITHSCORES
2. 延迟队列
把任务执行时间的时间戳作为 score:
bash
ZADD delay:queue 1790474006 order:1001
ZRANGEBYSCORE delay:queue -inf 1790474006
消费者定期读取 score 小于等于当前时间的任务,然后执行并删除。
需要注意,多个消费者并发处理延迟任务时,还需要使用 Lua 脚本等方式保证"查询并删除"的原子性,不能只依赖两条普通命令。
3. 时间线和带权重的任务
把时间戳、优先级或者综合权重作为 score,就可以按照时间或权重获取数据。
ZSet 类型的底层数据结构
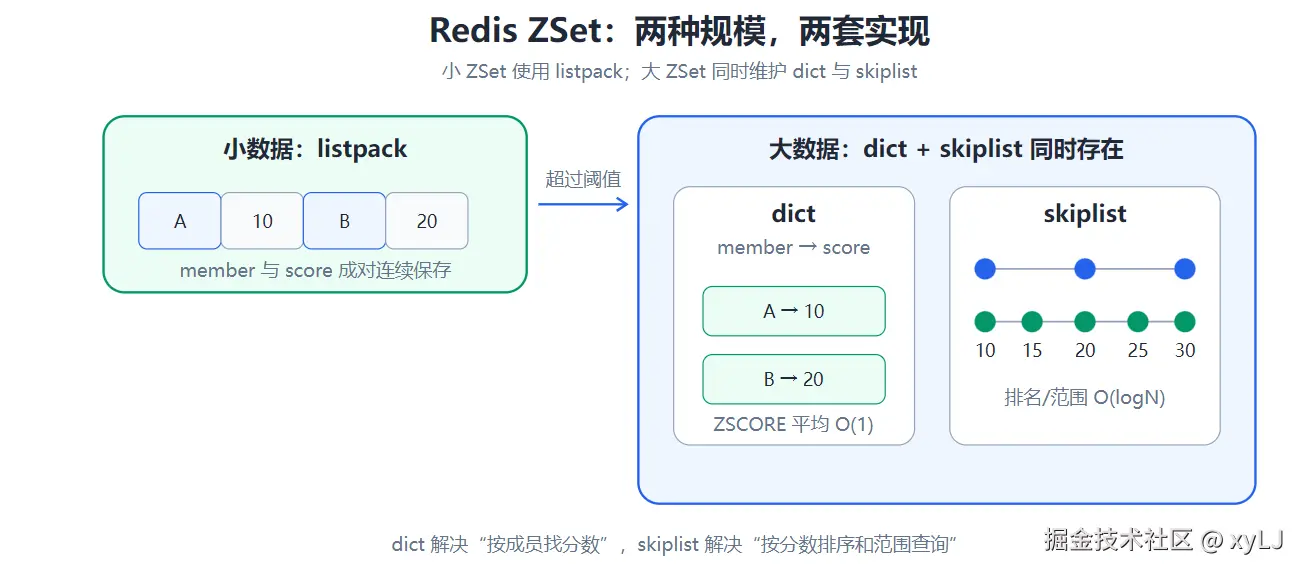
Redis 7.0 以后,ZSet 主要使用两种编码:
- 数据较小时使用 listpack。
- 数据较大时同时使用 skiplist 和 dict。
Redis 6.2 及以前,小 ZSet 常用 ziplist;Redis 7.0 以后改为 listpack。
1. listpack
小型 ZSet 会把 member 和 score 成对连续存放:
text
[member1][score1][member2][score2][member3][score3]默认配置如下:
bash
zset-max-listpack-entries 128
zset-max-listpack-value 64
默认情况下,元素数量不超过 128,并且单个 member 的长度不超过 64 字节时,可以使用 listpack。
因为元素数量较少,即使插入时需要移动数据、查询时需要扫描,代价也可以接受,同时还能节省大量指针和节点开销。
2. skiplist + dict
当 ZSet 中的数据量变大后,仅靠 listpack 就无法保证查询效率,此时 Redis 会同时使用:
- dict(哈希表) :保存
member -> score的映射。 - skiplist(跳表) :按照
score + member的顺序保存成员。
这两种结构不是二选一,而是同时存在、各自负责不同的操作。
dict 负责什么
当执行下面的命令时:
bash
ZSCORE rank user:1001Redis 可以通过哈希表根据 member 直接找到 score,平均时间复杂度是 O(1)。
skiplist 负责什么
当执行排名或范围查询时:
bash
ZRANK rank user:1001
ZRANGE rank 0 9
ZRANGEBYSCORE rank 80 100
Redis 通过跳表按 score 有序查找,查找、插入和删除的平均时间复杂度为 O(logN),范围查询还能从起始节点继续向后遍历。
什么是跳表
普通单向链表只能一层一层向后查找,查找一个元素的时间复杂度是 O(N)。跳表会在原始链表上增加多级索引,类似一个多层的有序链表,结构图如下所示:
text
Level 3 (最高层)
+----------------+                                                  +-----------------------+
| Header (头节点) | -----------------------------------------------> | member: "user:C"      | ---> NULL
|                |                                                  | score:  20.0          |
+----------------+                                                  +-----------------------+
        |
 Level 2 (中间层)
+----------------+                                 +-----------------------+   |   +-----------------------+
| Header (头节点) | ------------------------------> | member: "user:B"      | --+-> | member: "user:C"      | ---> NULL
|                |                                 | score:  10.0          |   |   | score:  20.0          |
+----------------+                                 +-----------------------+   |   +-----------------------+
        |
 Level 1 (最底层,包含全部数据与完整成员信息)
+----------------+   +-----------------------+   +-----------------------+   |   +-----------------------+
| Header (头节点) | <-> | member: "user:A"      | <-> | member: "user:B"      | <-+-> | member: "user:C"      | ---> NULL
|                |   | score:  5.0           |   | score:  10.0          |   |   | score:  20.0          |
+----------------+   +-----------------------+   +-----------------------+   |   +-----------------------+
                                                                              |
                             【如果 Score 相同,按 Member 字典序排序】 --------+
这里对跳表中包含的字段及其含义用 C 语言中的一个结构体来表示:
c
typedef struct zskiplistNode {
    sds ele;                        /* 存储成员字符串(member,例如 "user:A") */
    double score;                   /* 存储权重/分值(score,例如 5.0) */
    struct zskiplistNode *backward; /* 后退指针(仅在 Level 1,用于倒序遍历) */
    struct zskiplistLevel {
        struct zskiplistNode *forward;  /* 前进指针 */
        unsigned long span;             /* 跨度(用于计算 RANK 排名) */
    } level[];                      /* 层级数组 */
} zskiplistNode;
Redis 的跳表节点除了保存多层前进指针,还保存跨度 span。跨度可以表示两个节点之间跨过了多少个元素,因此 Redis 可以高效计算成员排名。
跳表的查找和插入流程:
| 操作 | 核心步骤 | 复杂度 |
|---|---|---|
| 查找 | 从顶层开始,右节点小则向右,右节点大则下沉,遇到相同则匹配成功。 | 平均 O(logN) |
| 插入 | 1. 查找插入位置并用 update[] 记录沿途前驱节点 ;2. 概率随机生成层高 ;3. 沿着 update[] 路径修正 1 到 K 层的指针连入新节点。 |
平均 O(logN) |
跳表的层高是如何设计的呢?
text
Header 节点 (最大 32 层)
+------------------------+
| Level 32: forward ---> | NULL
| Level 31: forward ---> | NULL
| ...                    | ...
| Level  2: forward ---> | NULL
| Level  1: forward ---> | NULL
+------------------------+
| score:  0 (不存实际值)  |
| member: NULL           |
+------------------------+- 跳表是随机确定 新节点的层高的:创建节点时会随机生成一个 0,1 的随机数,如果这个随机数小于 0.25,则层高加一层,直到随机数大于 0.25 为止。对应 Redis 源码中的
ZSKIPLIST_P = 0.25。 - 跳表在创建头结点的时候,会直接创建最大层高的头结点 。Redis 中最大层高是
ZSKIPLIST_MAXLEVEL = 32(不是 64)。这样做的目的主要是用一个极小的固定内存开销(32 层 × 每层 16 字节 = 512 字节,每层包含一个 8 字节的forward指针和一个 8 字节的span),彻底避免了动态扩容头结点的复杂逻辑,保证了跳表插入、删除操作代码的简洁、高效。 - 同时跳表还保存了实际的层高,这样可以提高查询效率,直接从有数据的层开始查找。
为什么 Redis 使用跳表而不是 B+ 树?
- 内存与物理磁盘介质的差异:B+ 树通过降低树的高度,从而减少磁盘的 I/O 次数,但是 Redis 是纯内存操作,在内存中操作速度非常快,差异并不明显,所以通过压缩树高来减少磁盘 I/O 的优势无法在内存中发挥。
- 复杂性与可维护性:B+ 树的维护十分复杂,而跳表代码非常简洁,利于维护,方便扩展,同样因为无需维护复杂结构而提升写入速度。
- 跳表的内存利用率高:B+ 树在插入数据的时候可能会发生页分裂问题,这样会导致页的填充率下降(产生内部碎片),同样也会降低写入的速度,导致性能抖动。
为什么 ZSet 同时使用 skiplist 和 dict
这是 ZSet 最重要、也是面试中最常问的问题。
如果只使用哈希表:
- 可以通过 member 快速找到 score。
- 但是哈希表是无序的,无法高效完成排名和范围查询。
如果只使用跳表:
- 可以按 score 排序并完成范围查询。
- 但是根据 member 查询 score 不如哈希表直接。
所以 Redis 同时保留两种索引:
text
根据 member 查 score  -> dict      -> 平均 O(1)
根据 score 查排名范围 -> skiplist  -> 平均 O(logN)
它的代价是需要额外的索引空间,但 member 数据本身不会简单地复制两份,两种结构会关联同一个成员对象,从而尽量减少重复存储。
ZSet 操作的时间复杂度
ZADD:O(logN)ZREM:O(logN)ZSCORE:平均 O(1)ZRANK、ZREVRANK:O(logN)ZRANGE:O(logN + M),M 是返回元素的数量ZINCRBY:O(logN)
ZSet 使用时的注意点
- ZSet 成员不能重复,再次添加同一个 member 会更新其 score。
- 大范围执行
ZRANGE 0 -1会一次返回全部数据,需要避免。 - 排行榜通常按分数从高到低读取,因此经常使用
ZREVRANGE。 - 使用时间戳实现延迟队列时,ZSet 只负责排序,不会主动唤醒消费者,消费者仍然需要轮询或配合通知机制。
ZSet 类型总结
Redis ZSet 是一个有序、成员唯一的集合。小 ZSet 使用 listpack 节省内存;大 ZSet 同时使用 dict 和 skiplist,dict 负责根据成员快速查询分数,skiplist 负责排序、排名和范围查询。
ZSet 和 Set 的区别
- Set 是无序的,而 ZSet 通过分数来维持一个有序集合。在此基础上 ZSet 有了许多基于分数的排序操作,比如范围查询、排名等,我们根据不同的场景使用 Set 或 ZSet 即可。
Hash 哈希类型
Redis 的 Hash 类型可以理解为一个字段和值组成的键值对集合。
Redis 本身已经是 key-value 数据库,而 Hash 是在一个 Redis key 内部继续保存多组 field-value:
text
user:1001
├── name  -> 张三
├── age   -> 20
└── city  -> 北京
因此 Hash 很适合保存对象。
Hash 类型的常见操作
- 添加或修改字段:
HSET key field value [field value ...] - 获取字段值:
HGET key field - 获取多个字段:
HMGET key field [field ...] - 获取全部字段和值:
HGETALL key - 删除字段:
HDEL key field [field ...] - 判断字段是否存在:
HEXISTS key field - 获取字段数量:
HLEN key - 数值自增:
HINCRBY key field increment - 遍历 Hash:
HSCAN key cursor
例如保存一个用户对象:
bash
HSET user:1001 name "张三" age 20 city "北京"
HGET user:1001 name
HINCRBY user:1001 age 1
HGETALL user:1001
Hash 类型的应用场景
1. 缓存对象
可以把对象的每个属性保存为一个 field:
bash
HSET product:1001 name "机械键盘" price 299 stock 100与直接把整个对象序列化为 JSON 字符串相比,Hash 可以只读取或修改某个字段:
bash
HINCRBY product:1001 stock -1如果使用 JSON 字符串,通常需要先读取整个对象、反序列化、修改字段,再重新序列化并写回。
2. 购物车
可以使用商品 ID 作为 field,购买数量作为 value:
bash
HSET cart:user:1001 product:10 2
HINCRBY cart:user:1001 product:10 1
HDEL cart:user:1001 product:10
3. 统计对象中的多个指标
例如统计文章的阅读数、点赞数和评论数:
bash
HINCRBY article:1001:count views 1
HINCRBY article:1001:count likes 1
HINCRBY article:1001:count comments 1
Hash 类型的底层数据结构
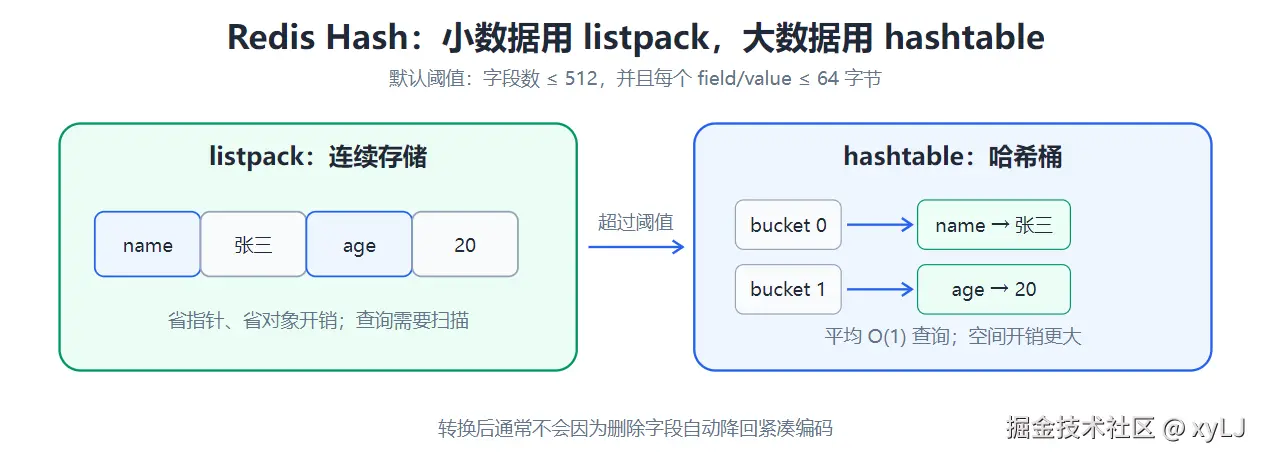
Redis 7.0 以后,Hash 主要使用两种编码:
- 数据较小时使用 listpack。
- 数据较大时使用 hashtable。
Redis 6.2 及以前常见的是 ziplist + hashtable;Redis 7.0 使用 listpack 替换了 ziplist。
1. listpack
当 Hash 中的 field 和 value 都比较少、比较小时,Redis 将它们紧凑地连续保存:
text
[field1][value1][field2][value2][field3][value3]相关默认配置如下:
bash
hash-max-listpack-entries 512
hash-max-listpack-value 64
默认情况下,Hash 的字段数量不超过 512,并且每个 field 和 value 的长度都不超过 64 字节时,可以使用 listpack。
listpack 的优点:
- 连续内存,内存局部性较好。
- 不需要为每个 field 和 value 保存哈希表节点和指针。
- 小数据量时非常节省内存。
它的缺点是查询 field 时通常需要顺序扫描,时间复杂度是 O(N)。但是因为只在小 Hash 中使用,所以实际扫描的元素数量有限。
2. hashtable
当字段数量超过阈值,或者某个 field/value 太大时,Redis 会把 Hash 转换为 hashtable。
哈希表通过哈希函数把 field 映射到桶中,平均情况下可以用 O(1) 的时间完成查找、添加和删除。
Redis 的字典内部会保存两个哈希表,扩容或缩容时采用渐进式 rehash:
- 不会一次性迁移全部数据,避免长时间阻塞主线程。
- 每次执行增删改查时,顺便迁移一部分桶。
- 当旧表的数据全部迁移到新表后,完成 rehash。
这也是 Redis 单线程模型中的一个重要设计:把一次大操作拆成许多次小操作,降低单次阻塞时间。
为什么 Hash 要使用两种数据结构
如果 Hash 一开始就使用哈希表,每个字段都需要哈希表节点、指针和内存对齐空间。对于只有几个短字段的小对象来说,这些额外开销可能比真正的数据还大。
因此 Redis 选择:
- 小 Hash:使用 listpack,优先节省内存。
- 大 Hash:使用 hashtable,优先保证查询性能。
当 Hash 超过配置阈值后,会从 listpack 转为 hashtable。正常操作过程中,即使后来删除了部分字段,通常也不会自动转回 listpack,避免频繁转换带来的额外开销。
Hash 使用时的注意点
- 不要对特别大的 Hash 随意执行
HGETALL,因为它会一次返回全部字段和值,可以使用HSCAN分批读取。 - Hash 的过期时间默认设置在整个 Redis key 上,不能简单地把每一个 field 当作完全独立的 key 使用。(Redis 7.4 起提供了
HEXPIRE等命令,可以为单个 field 设置过期时间。) - Hash 适合字段较固定的对象;如果对象需要嵌套结构,通常要自行序列化,或者重新设计 Redis key。
Hash 类型总结
Redis Hash 是一个 field-value 集合,非常适合保存对象和同一业务主体的多个属性。小 Hash 使用 listpack 节省内存,大 Hash 使用 hashtable 保证平均 O(1) 的查询效率。
各数据类型底层结构总结
| Redis 数据类型 | 小数据量使用的结构 | 大数据量使用的结构 | 核心特点 |
|---|---|---|---|
| String | int(整数)、embstr(≤ 44 字节) | raw(> 44 字节) | 二进制安全,可存字符串、整数、浮点数 |
| List | quicklist 节点内部使用 listpack | 仍然是 quicklist,但会增加更多节点 | 两端操作快、有序、允许重复 |
| Set | intset;Redis 7.2 起还可使用 listpack | hashtable | 无序、成员唯一、适合集合运算 |
| Hash | listpack | hashtable | field-value,适合保存对象 |
| ZSet | listpack | skiplist + dict | member 唯一,按照 score 排序 |
为什么同一种 Redis 类型可能对应多种底层数据结构?
根本原因是在内存占用和操作性能之间取得平衡:
- 数据少时,使用连续、紧凑的结构,减少指针和对象开销。
- 数据变多时,转换为哈希表或跳表,避免线性扫描带来的性能下降。
- ZSet 的 skiplist 和 dict 会同时存在,因为一种结构无法同时兼顾 member 查询和 score 排序。
一句话总结:
Redis 对外提供稳定的数据类型,对内根据数据规模和操作特点选择最合适的数据结构,从而做到小数据省内存、大数据保性能。