老炮踩坑录 · F08 · 翻车现场系列
· 基于「企业融合平台」真实源码
· 关键词:Executors · 无界队列 · OOM · ThreadPoolExecutor · 阿里规约
阿里 Java 开发手册,并发处理 这一节的第4条规约,几乎所有面试都会考:
线程池不允许使用
Executors去创建,而是通过ThreadPoolExecutor的方式。
原因写得很清楚:Executors 返回的几种线程池,要么队列无界(FixedThreadPool、SingleThreadExecutor),要么线程无界(CachedThreadPool),都有 OOM 风险。
这条规约我背得滚瓜烂熟,面试的时候还曾经拿它当杀手锏------毕竟,能说出 LinkedBlockingQueue 无界队列导致 OOM 的候选人,一看就是"有深度"的。
然后我翻开了自己 2022 年写的项目代码。
3 处 Executors.newFixedThreadPool(5),一字不差,整整齐齐。
规约第一页,我就没做到。
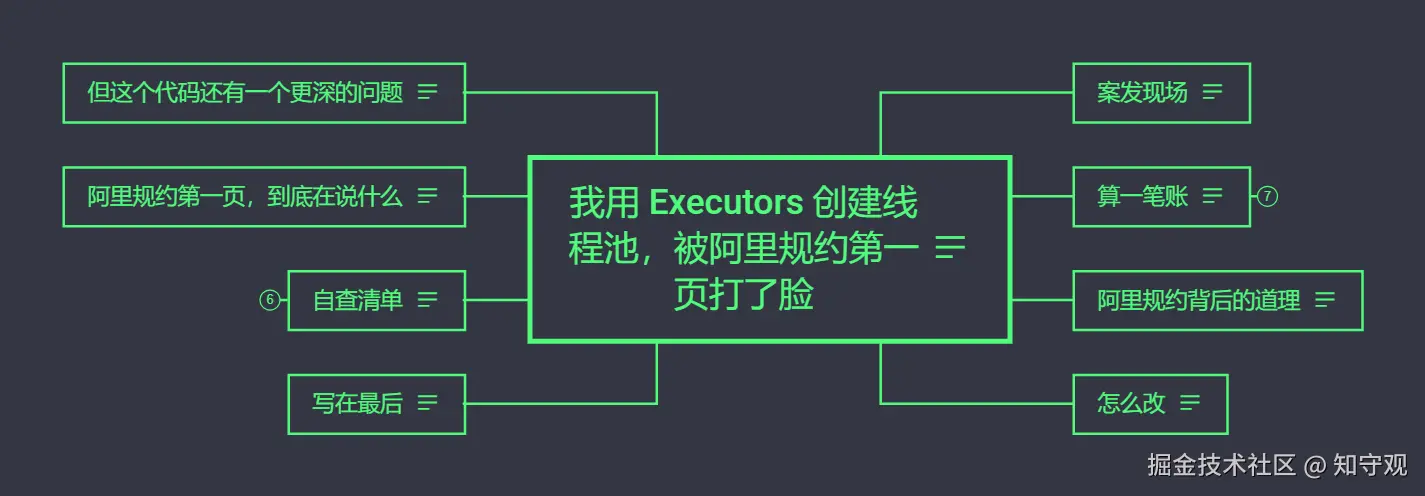
本文思路大纲见下图:
案发现场
这个项目的文件上传走的是华为云 OBS(对象存储),大文件用分片上传------把一个文件切成 5MB 一块,5 个线程并行上传,最后合并。
创建线程池的代码,3 个文件里各有一份,几乎一模一样:
java
// AsyncElecServiceImpl.java L414
// HyunFileServiceImpl.java L114
// HOBSFileServiceImpl.java L51

ExecutorService executorService = Executors.newFixedThreadPool(5);
然后往线程池里塞任务:
java
long partSize = 5 * 1024 * 1024L;  // 5MB 一块
long partCount = file.length() % partSize == 0
    ? file.length() / partSize
    : file.length() / partSize + 1;

for (int i = 0; i < partCount; i++) {
    long offset = i * partSize;
    long currPartSize = (i + 1 == partCount) ? file.length() - offset : partSize;
    executorService.execute(new PartUploader(file, file.length(), offset,
        currPartSize, i + 1, uploadId, partETags, obsClient, objectKey, bucketName));
}

executorService.shutdown();
while (!executorService.isTerminated()) {
    executorService.awaitTermination(10, TimeUnit.SECONDS);
}
逻辑很清楚:算出分片数,每个分片一个 PartUploader(实现 Runnable),提交给线程池,等全部完成,合并分片。
看起来没什么问题,对吧?
5 个线程,固定大小,上传完就 shutdown。干净利落。
直到我把 application.yml 打开:
yaml
spring:
  servlet:
    multipart:
      max-file-size: 1024MB
      max-request-size: 1024MB
允许上传 1024MB 的文件。
算一笔账
1024MB 的文件,按 5MB 一块切:
ini
partCount = 1024 / 5 = 205 块205 个 PartUploader 任务提交给 newFixedThreadPool(5)。
5 个线程同时跑,同一时刻只有 5 个任务在执行。剩下的 200 个任务呢?
打开 Executors.newFixedThreadPool 的源码:
java
public static ExecutorService newFixedThreadPool(int nThreads) {
    return new ThreadPoolExecutor(nThreads, nThreads,
        0L, TimeUnit.MILLISECONDS,
        new LinkedBlockingQueue<Runnable>());  // 看这里
}LinkedBlockingQueue------无界队列。 没有指定容量,默认是 Integer.MAX_VALUE(约 21 亿)。
200 个 PartUploader 对象安静地排在队列里,每个持有:
- 一个
File引用(文件句柄) offset、partSize、partNumber等 long/int 字段- 一个
ObsClient引用 - 一个
List<PartEtag>的共享引用
单个 PartUploader 对象不大,大约几百字节。200 个也就几十 KB------看起来不多。
但你别忘了:
- 每个
PartUploader持有File对象的引用。 虽然File对象本身不大,但底层关联的文件描述符是操作系统资源。200 个任务排队,意味着 200 个读操作等待。 - 如果多个用户同时上传呢? 每次调用
uploadFile都new一个新的线程池。10 个用户同时上传 100MB 以上的文件,就是 10 个线程池、2000 个排队任务。 - 更关键的是------这不是"会不会 OOM"的问题,而是"该不该这么写"的问题。
阿里规约说的不是"一定会 OOM",而是**"你不应该把命运交给一个无界队列"**。
阿里规约背后的道理
Executors 的几种快捷创建方式,问题各不相同:
| 方法 | 风险 | 原因 |
|---|---|---|
newFixedThreadPool |
队列无界 | LinkedBlockingQueue 无容量上限,如果任务堆积 → 报OOM |
newSingleThreadExecutor |
队列无界 | 同上,只是只有一个线程 |
newCachedThreadPool |
线程无界 | maximumPoolSize = Integer.MAX_VALUE,疯狂创建线程 → OOM |
newScheduledThreadPool |
队列无界 | 同 newFixedThreadPool |
四种方法,四种都可能导致 OOM 。区别只是死法不同:前三种是"任务堆死",CachedThreadPool 是"线程撑死"。
核心思想只有一个:资源必须有上限。
线程数要有上限,队列长度也要有上限。你无法预测未来会有多少任务进来,但你可以规定"最多排队多少,超了就拒绝"。系统的稳定性,永远排在第一位。
ThreadPoolExecutor 的 7 个参数,本质上就是在回答这 7 个问题:
| 参数 | 回答的问题 |
|---|---|
corePoolSize |
常驻几个线程? |
maximumPoolSize |
最多几个线程? |
keepAliveTime |
空闲线程多久回收? |
unit |
时间单位是什么? |
workQueue |
排队用什么队列?最多排多少? |
threadFactory |
线程怎么创建?(名字、优先级) |
handler |
队列满了怎么办?(拒绝策略) |
Executors 帮你回答了前 4 个,但把最关键的"队列上限"和"拒绝策略"藏起来了。 你用了它,就等于默认了"队列无限长"和"永远不拒绝"------在生产环境里,这两个默认值就是定时炸弹。
怎么改
把 Executors.newFixedThreadPool(5) 换成 ThreadPoolExecutor:
java
// 改之前
ExecutorService executorService = Executors.newFixedThreadPool(5);

// 改之后
ExecutorService executorService = new ThreadPoolExecutor(
    5,                              // 核心线程数
    5,                              // 最大线程数(和核心一样 = 固定大小)
    0L, TimeUnit.MILLISECONDS,
    new LinkedBlockingQueue<>(200), // 关键:队列有上限了
    new ThreadFactoryBuilder()      // 给线程起名字,排查问题时方便
        .setNameFormat("obs-upload-%d")
        .build(),
    new ThreadPoolExecutor.CallerRunsPolicy()  // 队列满了,调用者自己跑
);
三个关键变化:
1. 队列从"无界"变成了"有界"(200)。
1024MB / 5MB = 205 块,留 200 的队列可能还不够。但这就是重点------你需要根据业务算出一个合理的上限,而不是默认 21 亿。如果文件最大 100MB(100/5=20 块),队列设 50 就够了。
2. 拒绝策略选了 CallerRunsPolicy。
队列满了怎么办?4 种策略:
| 策略 | 行为 | 适用场景 |
|---|---|---|
AbortPolicy(默认) |
抛 RejectedExecutionException |
不能丢任务,让调用方处理 |
CallerRunsPolicy |
提交任务的线程自己执行 | 允许降速,但不能丢 |
DiscardPolicy |
静默丢弃 | 任务可丢 |
DiscardOldestPolicy |
丢弃最老的任务 | 新任务优先 |
文件上传不能丢分片,所以选 CallerRunsPolicy------队列满了,上传主线程自己干,相当于自动降速。
3. 线程有了名字。
java
new ThreadFactoryBuilder()
    .setNameFormat("obs-upload-%d")
    .build()
出问题时 dump 线程栈,看到的是 obs-upload-0、obs-upload-1,而不是 pool-3-thread-2。排查效率提升 10 倍。
但这个代码还有一个更深的问题
改完 API,我回头又看了一遍这段代码,发现了一个比"用错 API"更严重的问题:
每次上传都创建一个线程池。
java
public void uploadFile(File file, ...) {
    ExecutorService executorService = Executors.newFixedThreadPool(5);
    // ... 上传逻辑 ...
    executorService.shutdown();
}
uploadFile 每被调用一次,就 new 一个线程池。5 个线程创建 → 用完 → 销毁。
如果 10 个用户同时上传文件,就是 10 个线程池、50 个线程同时存在。线程是操作系统资源,创建和销毁都有开销。 5 个线程的线程池,创建 + 销毁大概需要几毫秒------听起来不多,但这是完全可以避免的浪费。
正确的做法是把线程池提升为类级别的单例:
java
@Service
public class ObsFileServiceImpl {

    private final ExecutorService uploadExecutor = new ThreadPoolExecutor(
        5, 5, 60L, TimeUnit.SECONDS,
        new LinkedBlockingQueue<>(200),
        new ThreadFactoryBuilder().setNameFormat("obs-upload-%d").build(),
        new ThreadPoolExecutor.CallerRunsPolicy()
    );

    public void uploadFile(File file, ...) {
        // 直接用 uploadExecutor,不创建新的
        // ...
    }

    @PreDestroy
    public void destroy() {
        uploadExecutor.shutdown();
    }
}
线程池跟着 Bean 的生命周期走,应用启动时创建,应用关闭时销毁。中间不管上传多少次,都是同一池线程在干活。
这才是"资源池"的本意------"池"就是用来复用的。 每次 new 一个用完就丢,那不叫线程池,叫 "线程是一次性商品"。
阿里规约第一页,到底在说什么
回头看这条规约,它表面上是在说"不要用 Executors",实际上是在说三件事:
第一,资源必须有上限。
无界队列 = 没有上限。你不能假设"任务不会太多"------万一来了一个大文件呢?万一并发高了呢?代码里的"不会",在生产环境里就是"会"。
第二,默认值不等于安全值。
LinkedBlockingQueue 的默认容量是 Integer.MAX_VALUE。这个默认值是为了"通用性"------它假设你不知道该设多少。但在生产代码里,"不知道"不是借口------你必须根据业务算出来。
第三,便捷 API 是陷阱。
Executors.newFixedThreadPool(5) 一行代码搞定线程池,多方便。但方便的东西往往把关键决策藏起来了。ThreadPoolExecutor 的 7 个参数看着烦,但每一个都在逼你想清楚一个关键问题。
烦,是因为重要。
自查清单
如果你项目里也有 Executors,按这个清单排查:
- 全局搜
Executors.new,看有几处 - 每处确认:任务量有没有上限?队列该设多大?
- 线程池是"每次 new"还是"单例复用"?每次 new 的一定要改成单例
- 拒绝策略选了什么?任务能丢吗?不能丢就选
CallerRunsPolicy - 线程有没有名字?dump 线程栈时能不能一眼认出来?
- 线程池有没有正确关闭?
shutdown()在 finally 里吗?
写在最后
阿里规约这条规则,我面试时背过无数次。但在自己的项目里,我用了 3 次 Executors,用了 4 年,从来没觉得有问题。
直到今天写这篇文章,我才认真去看了 newFixedThreadPool 的源码------原来它用的是无界队列。
以前只知道"不能用",不知道为什么不能用。知道"不能用"和知道"为什么不能用",差距就在这几行源码里。
面试背规约,能让你拿到 offer。理解规约背后的道理,能让你少踩一次 OOM。
规约第一页,不是写给面试官看的,是写给凌晨三点被 OOM 报警叫醒的你看的。
如果这篇文章帮你少踩一个坑,就是它最大的价值体现。
本文同时发于公众号「Java老炮踩坑录」,欢迎品鉴。
下期预告:《加了 @Transactional 就万事大吉?吞掉异常后事务根本没回滚》 我是老炮,18 年 Java 老兵,仍在一线。关注「Java老炮踩坑录」,不错过每一篇真实案例,少踩坑。