引言
这个项目一开始的目标很朴素------做一款「技术支持 Agent」。根源是客户经常咨询已经写在文档里、或曾经反复咨询过的问题。主要需要解决的问题是:
- 约束先于选型------离线交付、个人 Token
- 技术文档要混合检索------语义管同义,词法管 API 标识符,不只靠向量
- 检索是主能力,LLM 是增强层------没 token 也能查;有 token 再增强,来源必须可追溯
做完后和朋友一聊,对方回:「这不就是个 RAG 吗?」
一、什么叫 RAG?
RAG(Retrieval-Augmented Generation,检索增强生成)------学界常见出处是 Lewis 等人 2020 年的工作------核心是:先从外部知识库捞出依据,再让生成过程受这些依据约束。大模型落地之后,这套做法被更广泛地用来对私域知识库降幻觉。
基于 LLM 的 RAG,主要对准三类问题:
- 幻觉:模型对不确定的知识会编造
- 知识过期 / 冲突:参数里背的和最新文档不一致
- 私域不可见:公共模型接触不到你的内部文档
而这个产品的主流程就是:用户提问 → 从文档/质保库里找 → 用材料组织成答案。要解决的产品问题是:
- 客户反复问文档里已有的内容
- 答案要有据可查,不能凭空发挥
- 降低技术支持的重复劳动
换一层视角,产品诉求和技术语言就对上了:
| 我们关心的(产品语言) | RAG 关心的(技术语言) | 其实是同一件事 |
|---|---|---|
| 答案必须能点开来源 | 幻觉------没依据就编 | 答案必须有据可查 |
| 客户问的是自家文档里的内容 | 私域------公共模型没见过 | 知识在自己的库里,得先检索再答 |
| 降低技术支持重复劳动 | 检索 +(可选)生成 | 机器先找片段;人只处理检索搞不定的 |
立项时想的是「少重复劳动、不让客户干等」;RAG 框架是「不瞎编、用私域知识约束生成」。表述不同,但链路一样:
- 把文档切好、建好索引(离线)
- 用户提问时,先从知识库捞出最相关的片段(检索)
- 把片段塞进 Prompt,让模型「照着材料写」(增强生成)------没 Key 时,检索直出也能完成大部分 FAQ
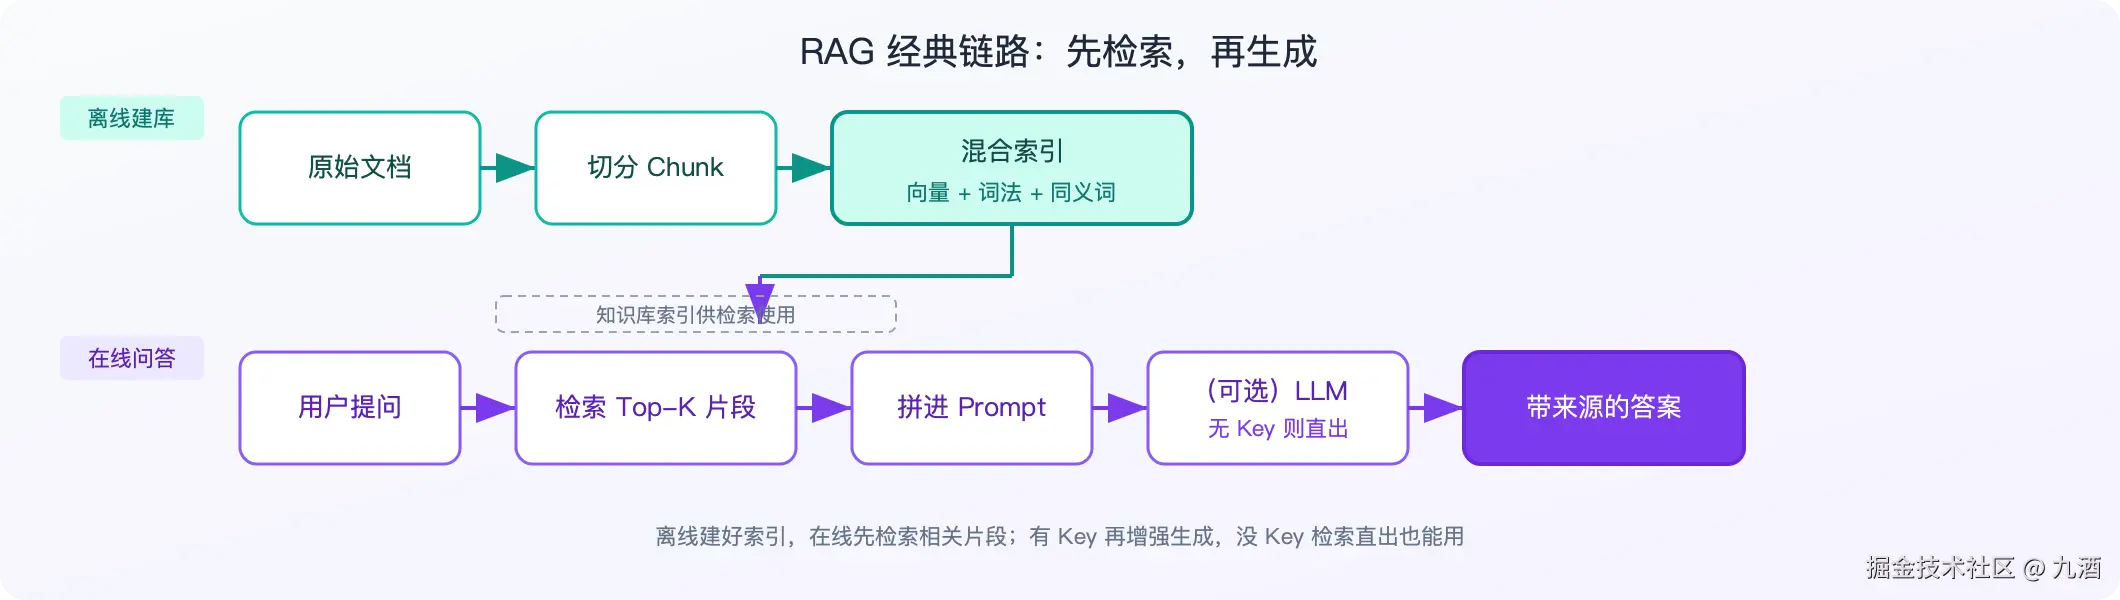
我们的技术支持 Agent 完全走这条路:知识库约 2000+ 篇文档 (离线文档包 + 质保 CSV),切分后 1 万+ 个 Chunk;桌面端本地检索、本地可选 Embedding,不依赖外网也能跑检索直出模式。
二、业务背景:两条硬约束,框定所有技术选型
概念对齐之后,真正决定方案长什么样的,不是向量库品牌,而是业务约束。
做企业技术支持 Agent,技术方案不是从「Milvus 还是 pgvector」开始讨论的,而是先对齐业务能不能用、成本谁买单。下面两条约束,几乎一票否决了「云端 SaaS 问答」路线。
2.1 知识要以离线包到达一线,而不是运行时拉外网
公开文档可以镜像,但一线场景往往还有更硬的边界:
- 运行环境可能在内网 / 受限网络,不能假设随时能打外部知识库 API;
- 即使文档本身可公开,也不适合把整库原文 上传到公有云大模型 做长上下文问答;
- 合规上常见要求:建库在可控环境完成,运行时本机检索,不回写业务系统。
所以我们选的是 离线建库 + 索引随安装包分发:
- 建库阶段:在可控环境把「离线文档部署包 + 经审核的质保列表」打成索引产物;
- 运行阶段:桌面端只读离线索引,检索完全在本机,不依赖外部知识库 API。
这不是「为了离线而离线」,而是 交付形态决定了知识只能以离线包的形式到一线手里。
2.2 个人 Token 限额:企业按人控费,LLM 不能是准入门槛
另一条同样现实的约束:企业对个人的大模型 Token 有配额(按日/月、按项目、按角色)。很难保证「每个人都配好 Key、额度永远够用」。
如果产品设计成「没 Key 不能用」,会出现:
- 同一团队有人能问、有人不能问,体验割裂;
- 简单 FAQ 也走一遍完整生成,白白烧额度;
- 额度用尽时产品直接不可用,比答错更伤信任。
因此架构上必须默认:检索是主能力,LLM 是增强层------没 Key 也能查文档、看片段、看来源;有 Key 再综合、再润色、再做长期记忆提炼。
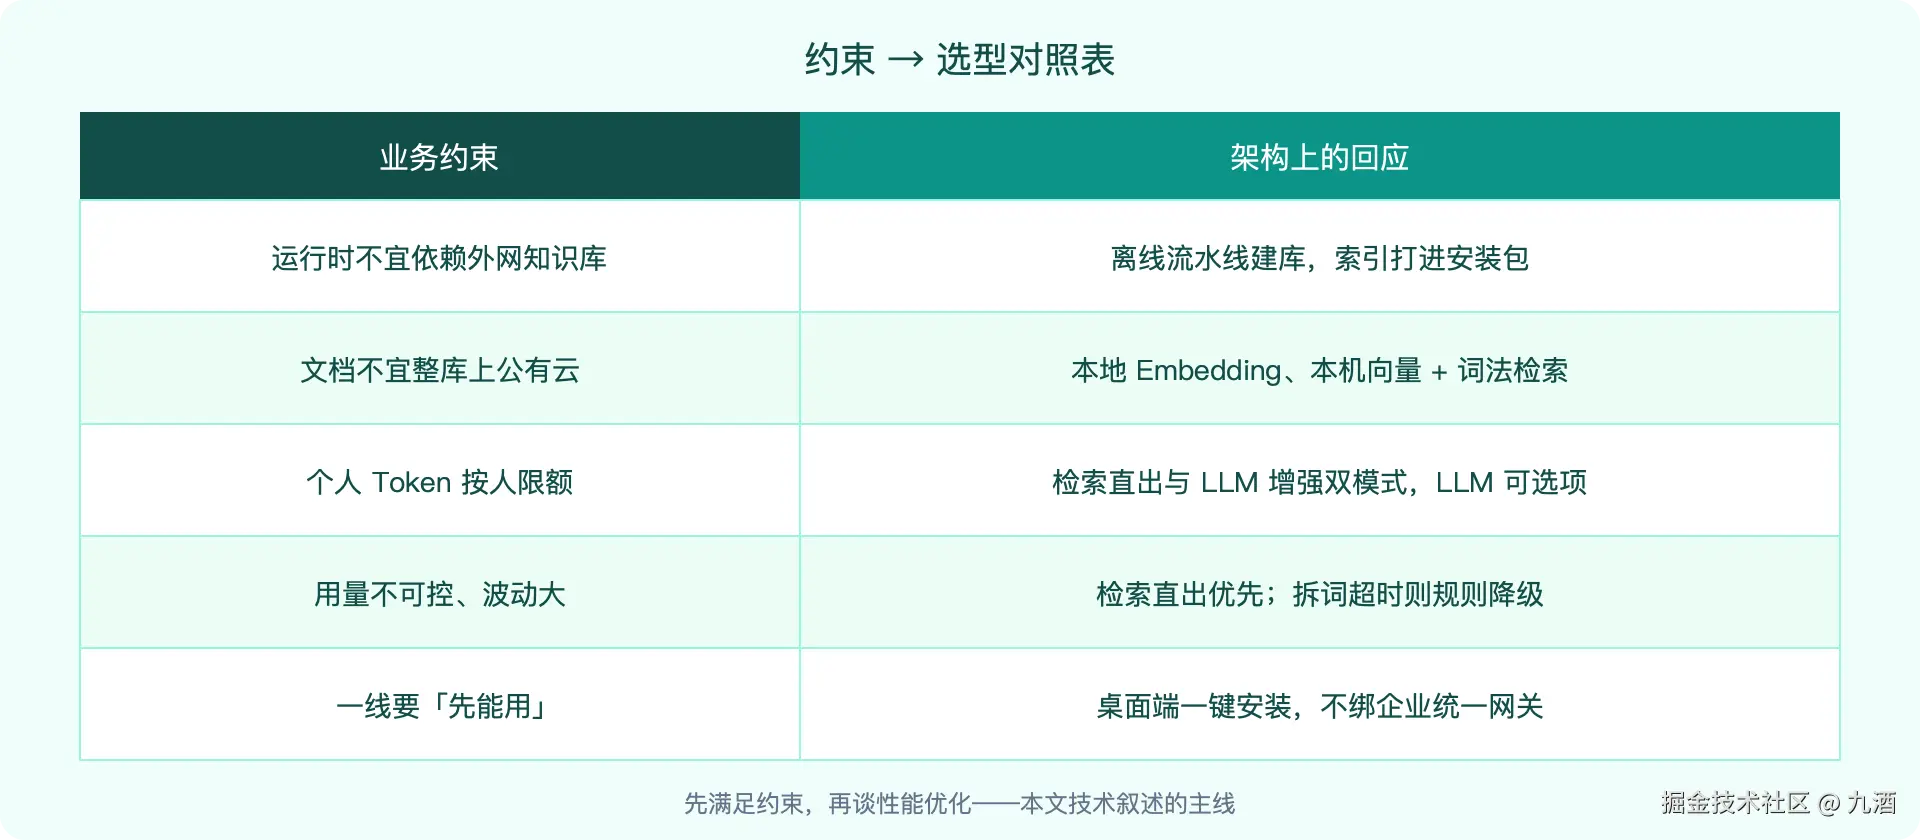
2.3 约束 → 选型:一张对照表
| 业务约束 | 架构上的回应 |
|---|---|
| 运行时不宜依赖外网知识库 | 离线流水线建库,索引打进安装包 |
| 文档不宜整库上公有云 | 本地 Embedding、本机向量 + 词法检索 |
| 个人 Token 按人限额 | 检索直出与 LLM 增强双模式,LLM 可选项 |
| 用量不可控、波动大 | 检索直出优先;拆词超时则规则降级 |
| 一线要「先能用」 | 桌面端一键安装,不绑企业统一网关 |
三、为什么要 RAG,而不是「直接把文档丢给 GPT」?
纯 LLM 方案在技术支持场景有以下硬伤:
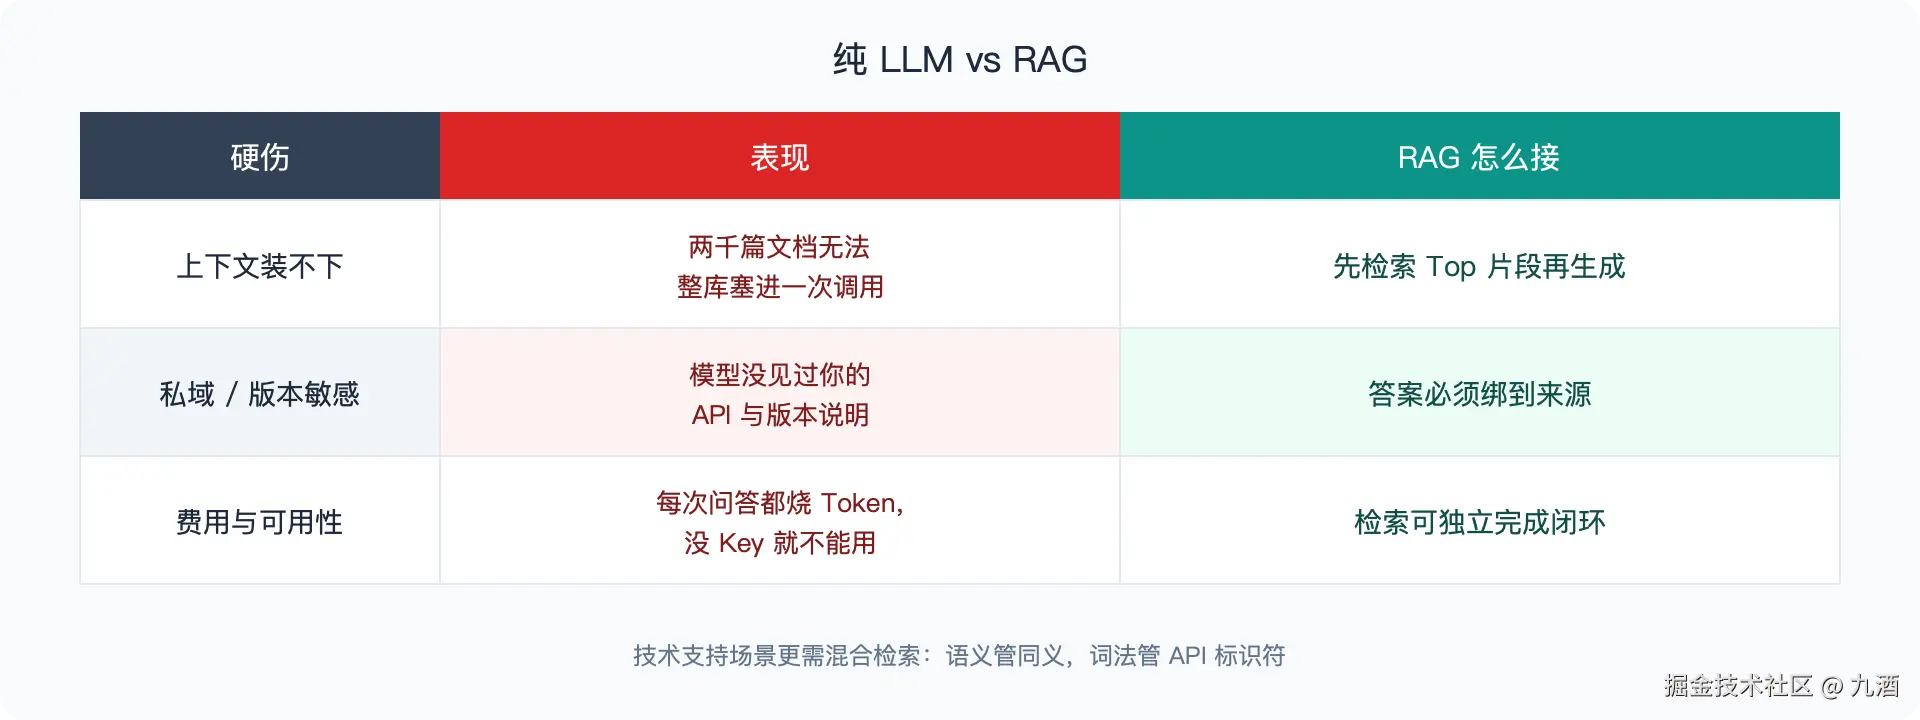
| 硬伤 | 表现 | RAG 怎么接 |
|---|---|---|
| 上下文装不下 | 两千篇文档无法整库塞进一次调用 | 先检索 Top 片段再生成 |
| 私域/版本敏感 | 模型没见过你的 API 与版本说明 | 答案必须绑到来源 |
| 费用与可用性 | 每次问答都烧 Token,没 Key 就不能用 | 检索可独立完成闭环 |
当前场景更特殊:文档里有大量 API 标识符(如 jssdk.native.xxx)、产品别名。用户问「相机权限怎么调」,光靠语义相似度经常漏召;光靠关键词又抓不住「它怎么用」这种追问。所以我们的 RAG 不是朴素「向量库 + Prompt」,而是 混合检索 + 多路召回。
一个典型反差(同类问题在工程里反复出现):
| 路线 | 「JSSDK 怎么调用相机权限?」常见结果 |
|---|---|
| 只靠语义向量 | 容易召到「权限」「相机」相关说明,精确 API 名对不齐 |
| 只靠关键词 | 能命中标识符,但「怎么调用 / 它怎么用」这类说法容易空 |
| 混合 + 多路 | 原问走混合检索,关键词/近义词再补词法路,按文档去重合并 |
四、系统架构:一张图看懂全局
桌面壳 + 本地 Agent 服务 + 聊天前端。核心链路是:意图识别 → 检索 →(可选)生成 → 来源展示。
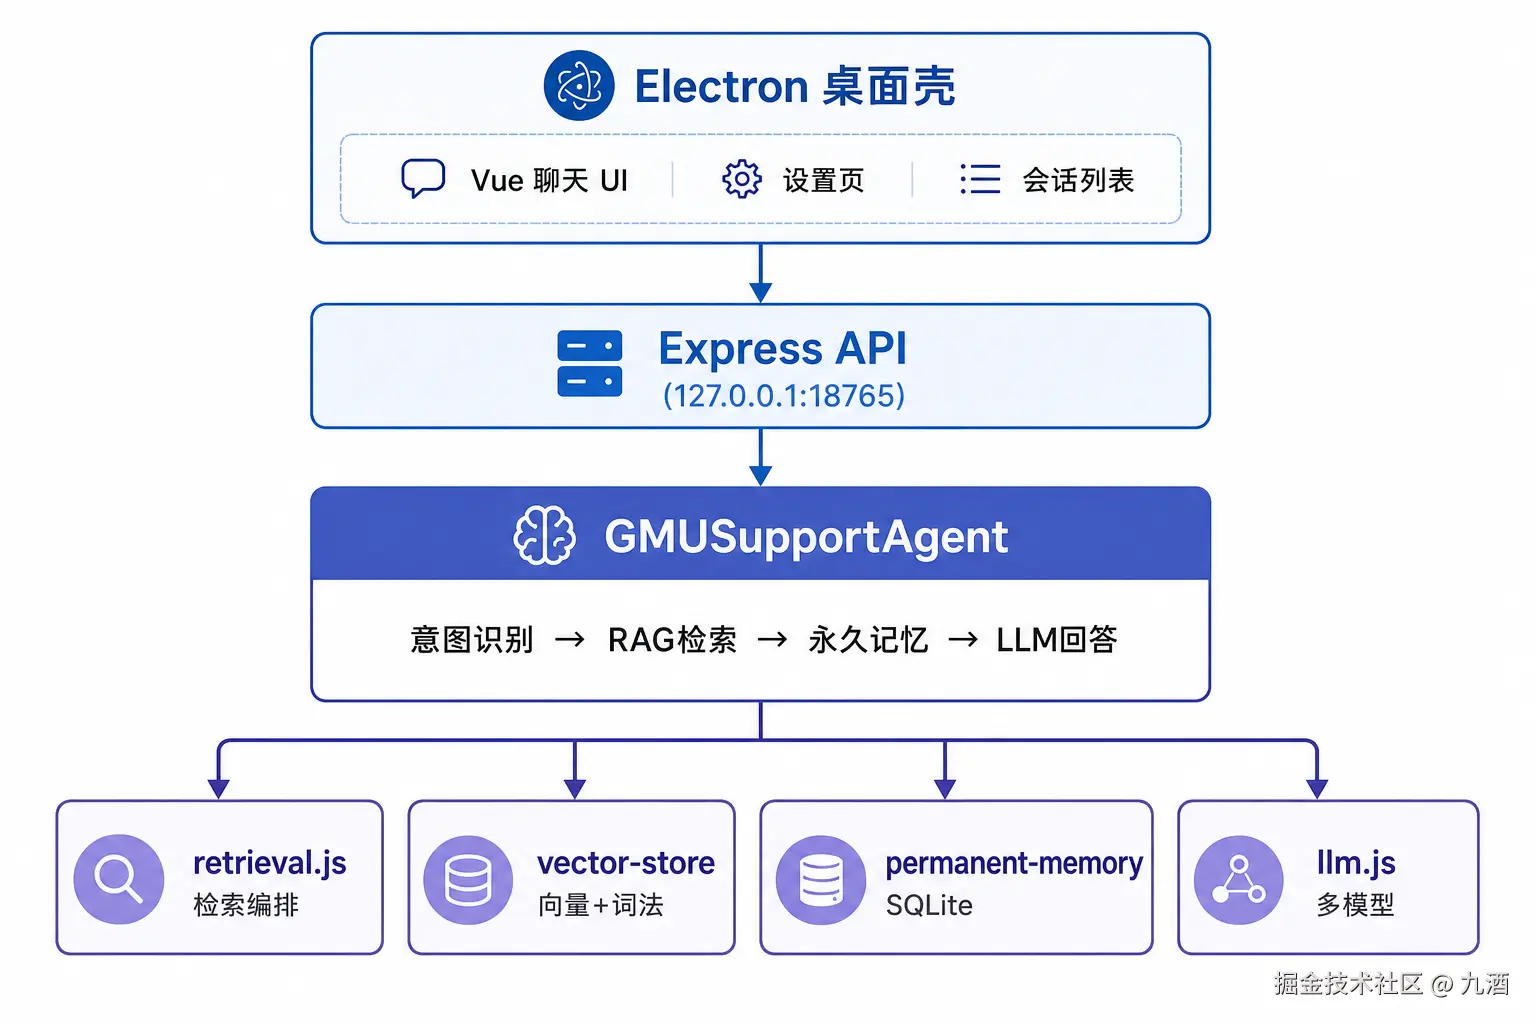
知识库跟用户数据分离:知识索引随安装包只读分发;用户 Key、会话、记忆都在本机,适合内网桌面部署。
五、离线流水线:知识库怎么建出来的?
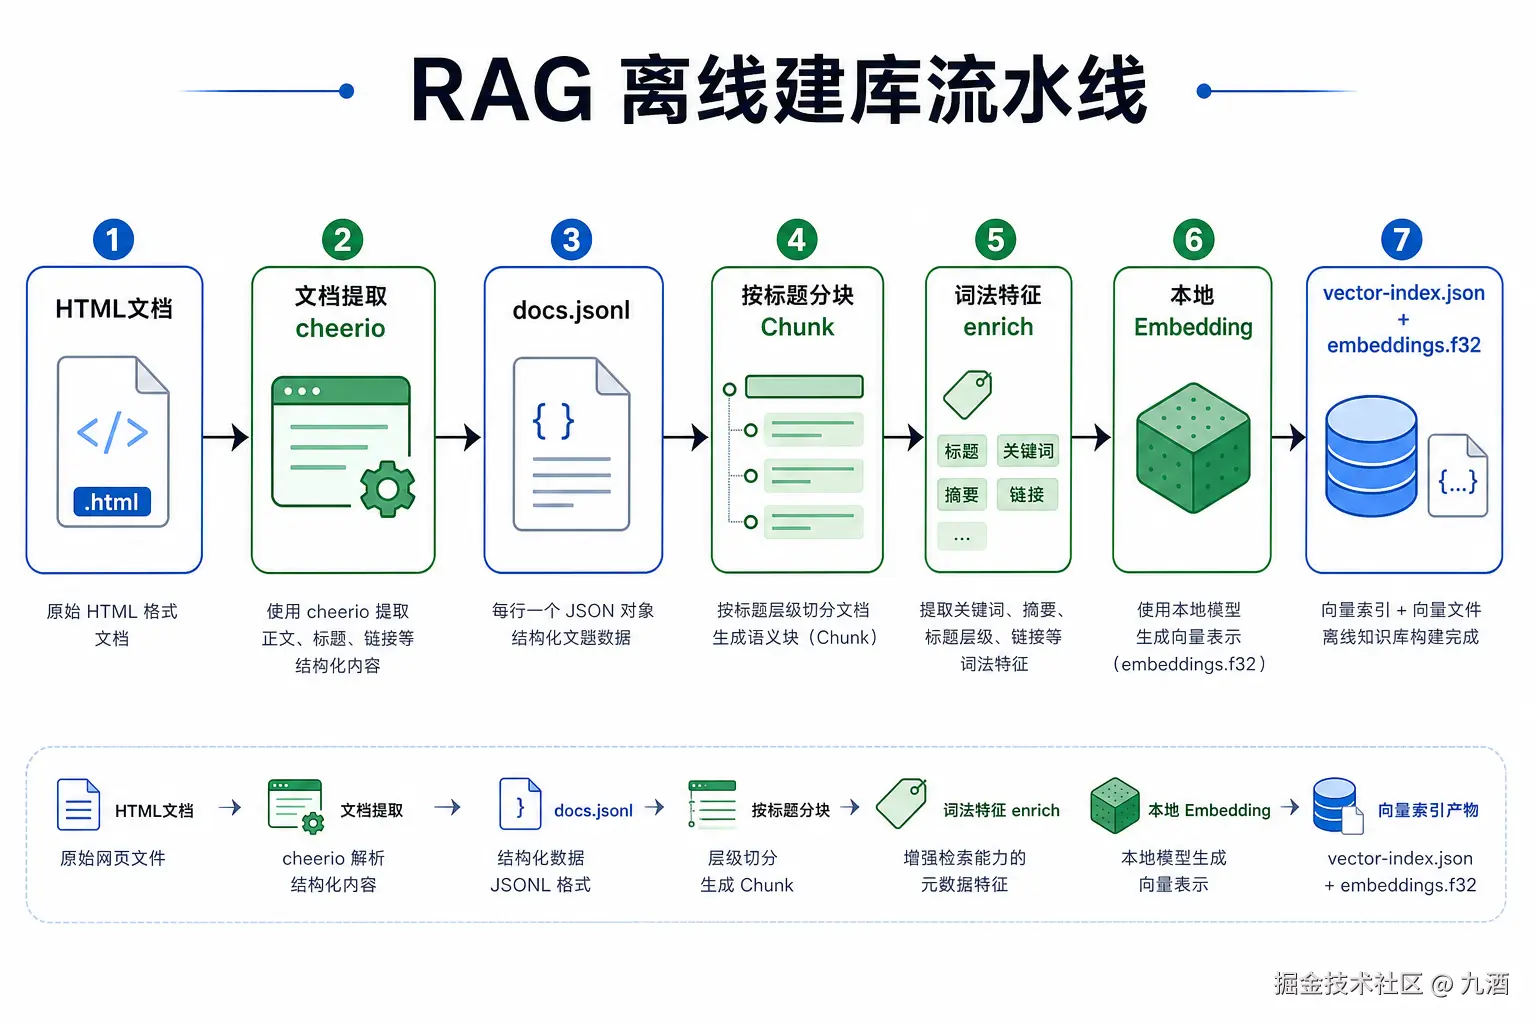
RAG 效果上限,很大程度卡在建库------分块是否切断 API 说明、标签是否齐全、词法特征有没有建好。离线流水线本身也是交付约束的产物:问答时不能现查现拉外网文档站,只能提前脱敏、提取、分块、建索引,再随桌面端分发。
5.1 文档提取
输入:离线 HTML 文档包 + 质保数据列表。
做法 :在可控环境解析正文,保留标题层级、代码块、列表;同时打上产品线、文档分类等标签(如 h5,app,JSSDK、JSNative、命令行工具等),便于检索时过滤。
产出:结构化文档清单(一篇一行),供后续分块与建索引。
5.2 分块(Chunking)
按标题和段落边界切,单块上限约 1500 字。技术文档标题结构清晰,按标题切比固定字数切更利于「一整段 API 说明不被拦腰截断」。
5.3 建索引
参考规模(全量建库后):
| 产物 | 作用 | 规模量级 |
|---|---|---|
| 词法/元数据索引 | Chunk 元数据 + 词法 token | ~186MB / 1.1 万条 |
| 稠密向量文件 | 数百维向量 | ~17MB |
| 术语同义词索引 | 领域别名与近义扩展 | ~58MB |
| 原始文档清单 | 建库输入快照 | ~2000 篇 |
支持增量更新索引,不用每次全量重跑,再同步进桌面安装包。
六、在线检索:混合检索 + 多路召回
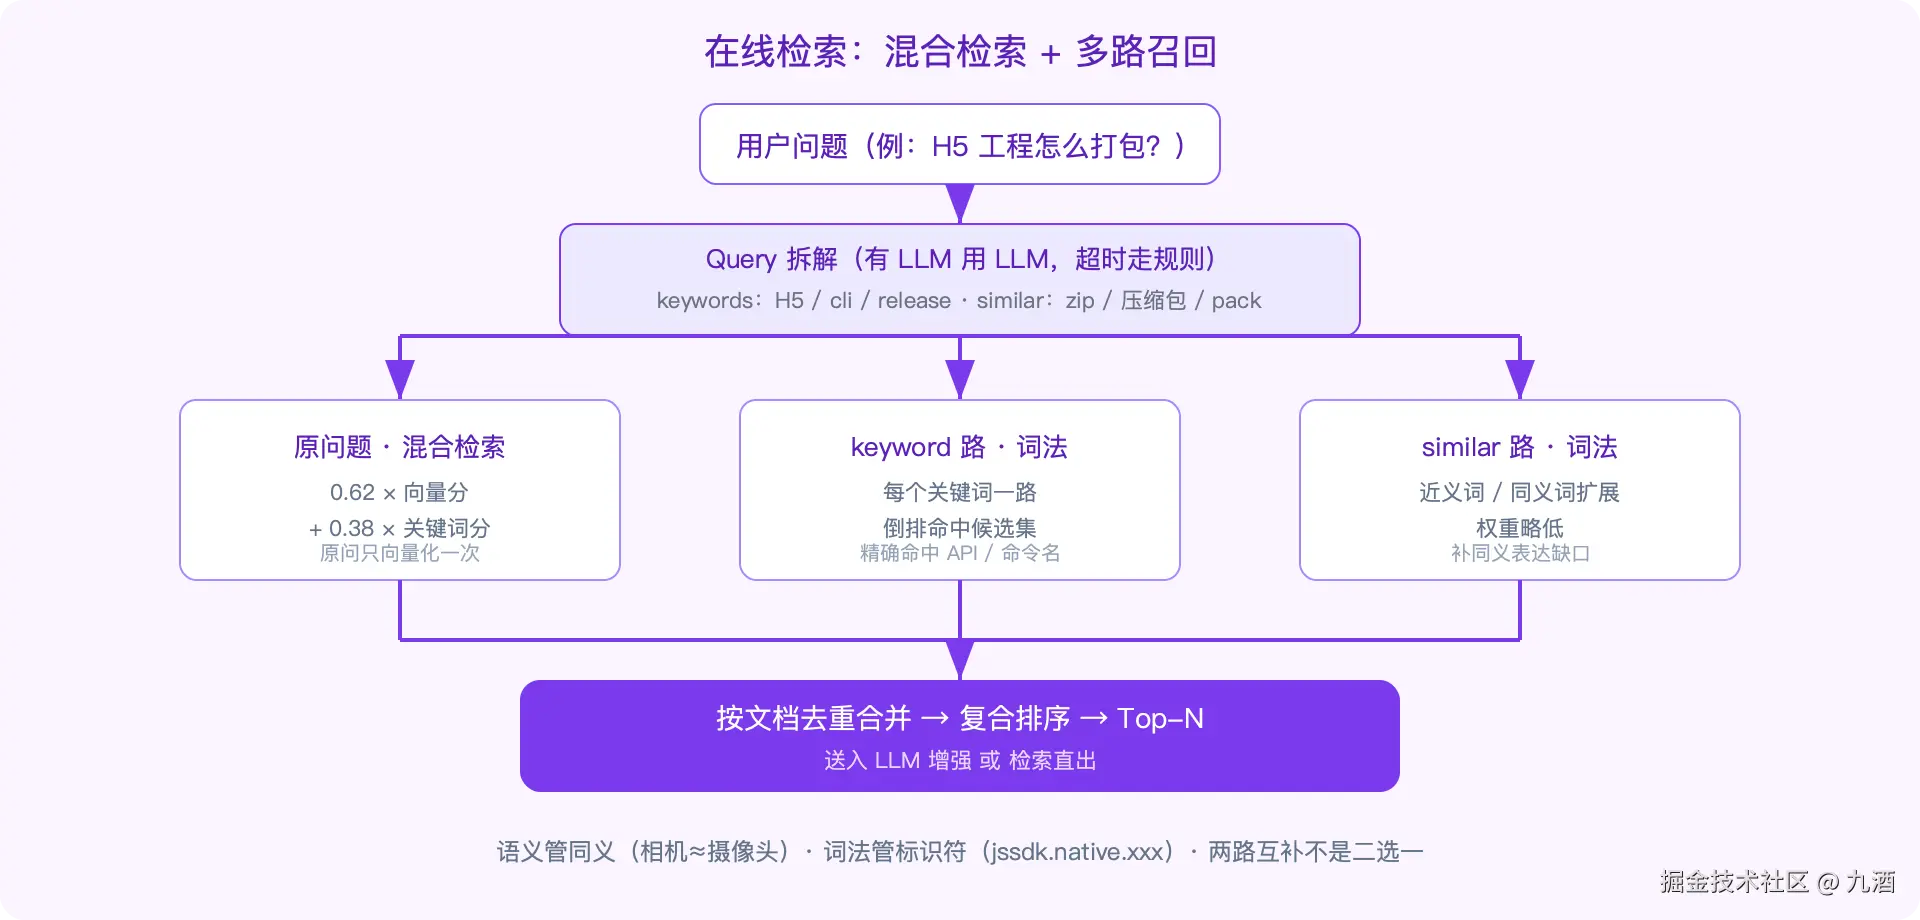
整条检索链路默认不调用大模型做向量计算;拆词有 LLM 增强,但超时即规则降级。向量与词法计算全在本机完成。
6.1 两路互补,不是二选一
| 类型 | 实现要点 | 擅长 |
|---|---|---|
| 稠密向量 | 本地多语言小模型paraphrase-multilingual-MiniLM-L12-v2,384 维,本地 ONNX |
语义相近:「相机」≈「摄像头」 |
| 词法索引 | 倒排 + 中文 n-gram + 领域词典 | 精确命中:API 标识符、命令名 |
有向量时走混合打分:向量分与关键词分加权融合(关键词权重不可忽略,如我们的是0.62 × 向量分 + 0.38 × 关键词分)。
为什么不能五五开?在技术文档场景,API 名精确匹配的价值很高,但纯关键词又抓不住同义表达。具体比例要按自己的样例调,不可直接复用别人的。
Embedding 选型理由很务实:要能离线跑、中英多语言够用、384 维体积小、ONNX 推理成本可接受。它不是「理论最优」,只是我们的场景适合。
6.2 Query 拆解:把一个问题拆成多路检索
用户问:「H5 工程怎么打包?」
检索前先做拆词(有 LLM 用 LLM,没有走规则降级):
| 字段 | 示例 |
|---|---|
| keywords | H5、cli、release、zip、打包 |
| similar | zip、压缩包、release、pack |
然后 多路并行检索:
- 原问题(混合检索一路)
- 每个 keyword 一路(词法)
- 每个 similar 一路(词法,权重略低)
- 按文档去重合并 → 复合排序
同义词库和静态别名表会再扩一层(如「zip包」→ zip、压缩包)。
性能上的小心机:原问题只做一次向量化,多路复用;关键词路只扫倒排命中的候选集,避免全库暴力扫描。
6.3 检索与回答分两阶段 + 追问补全
两阶段不是「检索完全不看历史」,而是有节制地用历史:
| 阶段 | 用什么 | 做什么 |
|---|---|---|
| 阶段一 · 检索 | 默认只用本轮原问题拆词检索 | 不让 LLM 拿整段对话历史自由改写检索句 |
| 追问补全(检索前) | 有历史,且含指代词,或拆词为空且很短 | 用上一轮用户原话规则补全(启发式,不保证主语正确) |
| 阶段二 · 回答 | 对话历史 + 长期记忆 + 检索片段 | 理解指代、组织答案、列出来源 |
用户追问「它怎么用?」------若让 LLM 自由做指代补全,检索句可能跑偏。所以默认不猜;需要补全时,用可预期的规则,借用上一轮用户原话(纯指代则复用;有新实体词则「上轮 + 新词」),避免空 Query 全库乱搜。
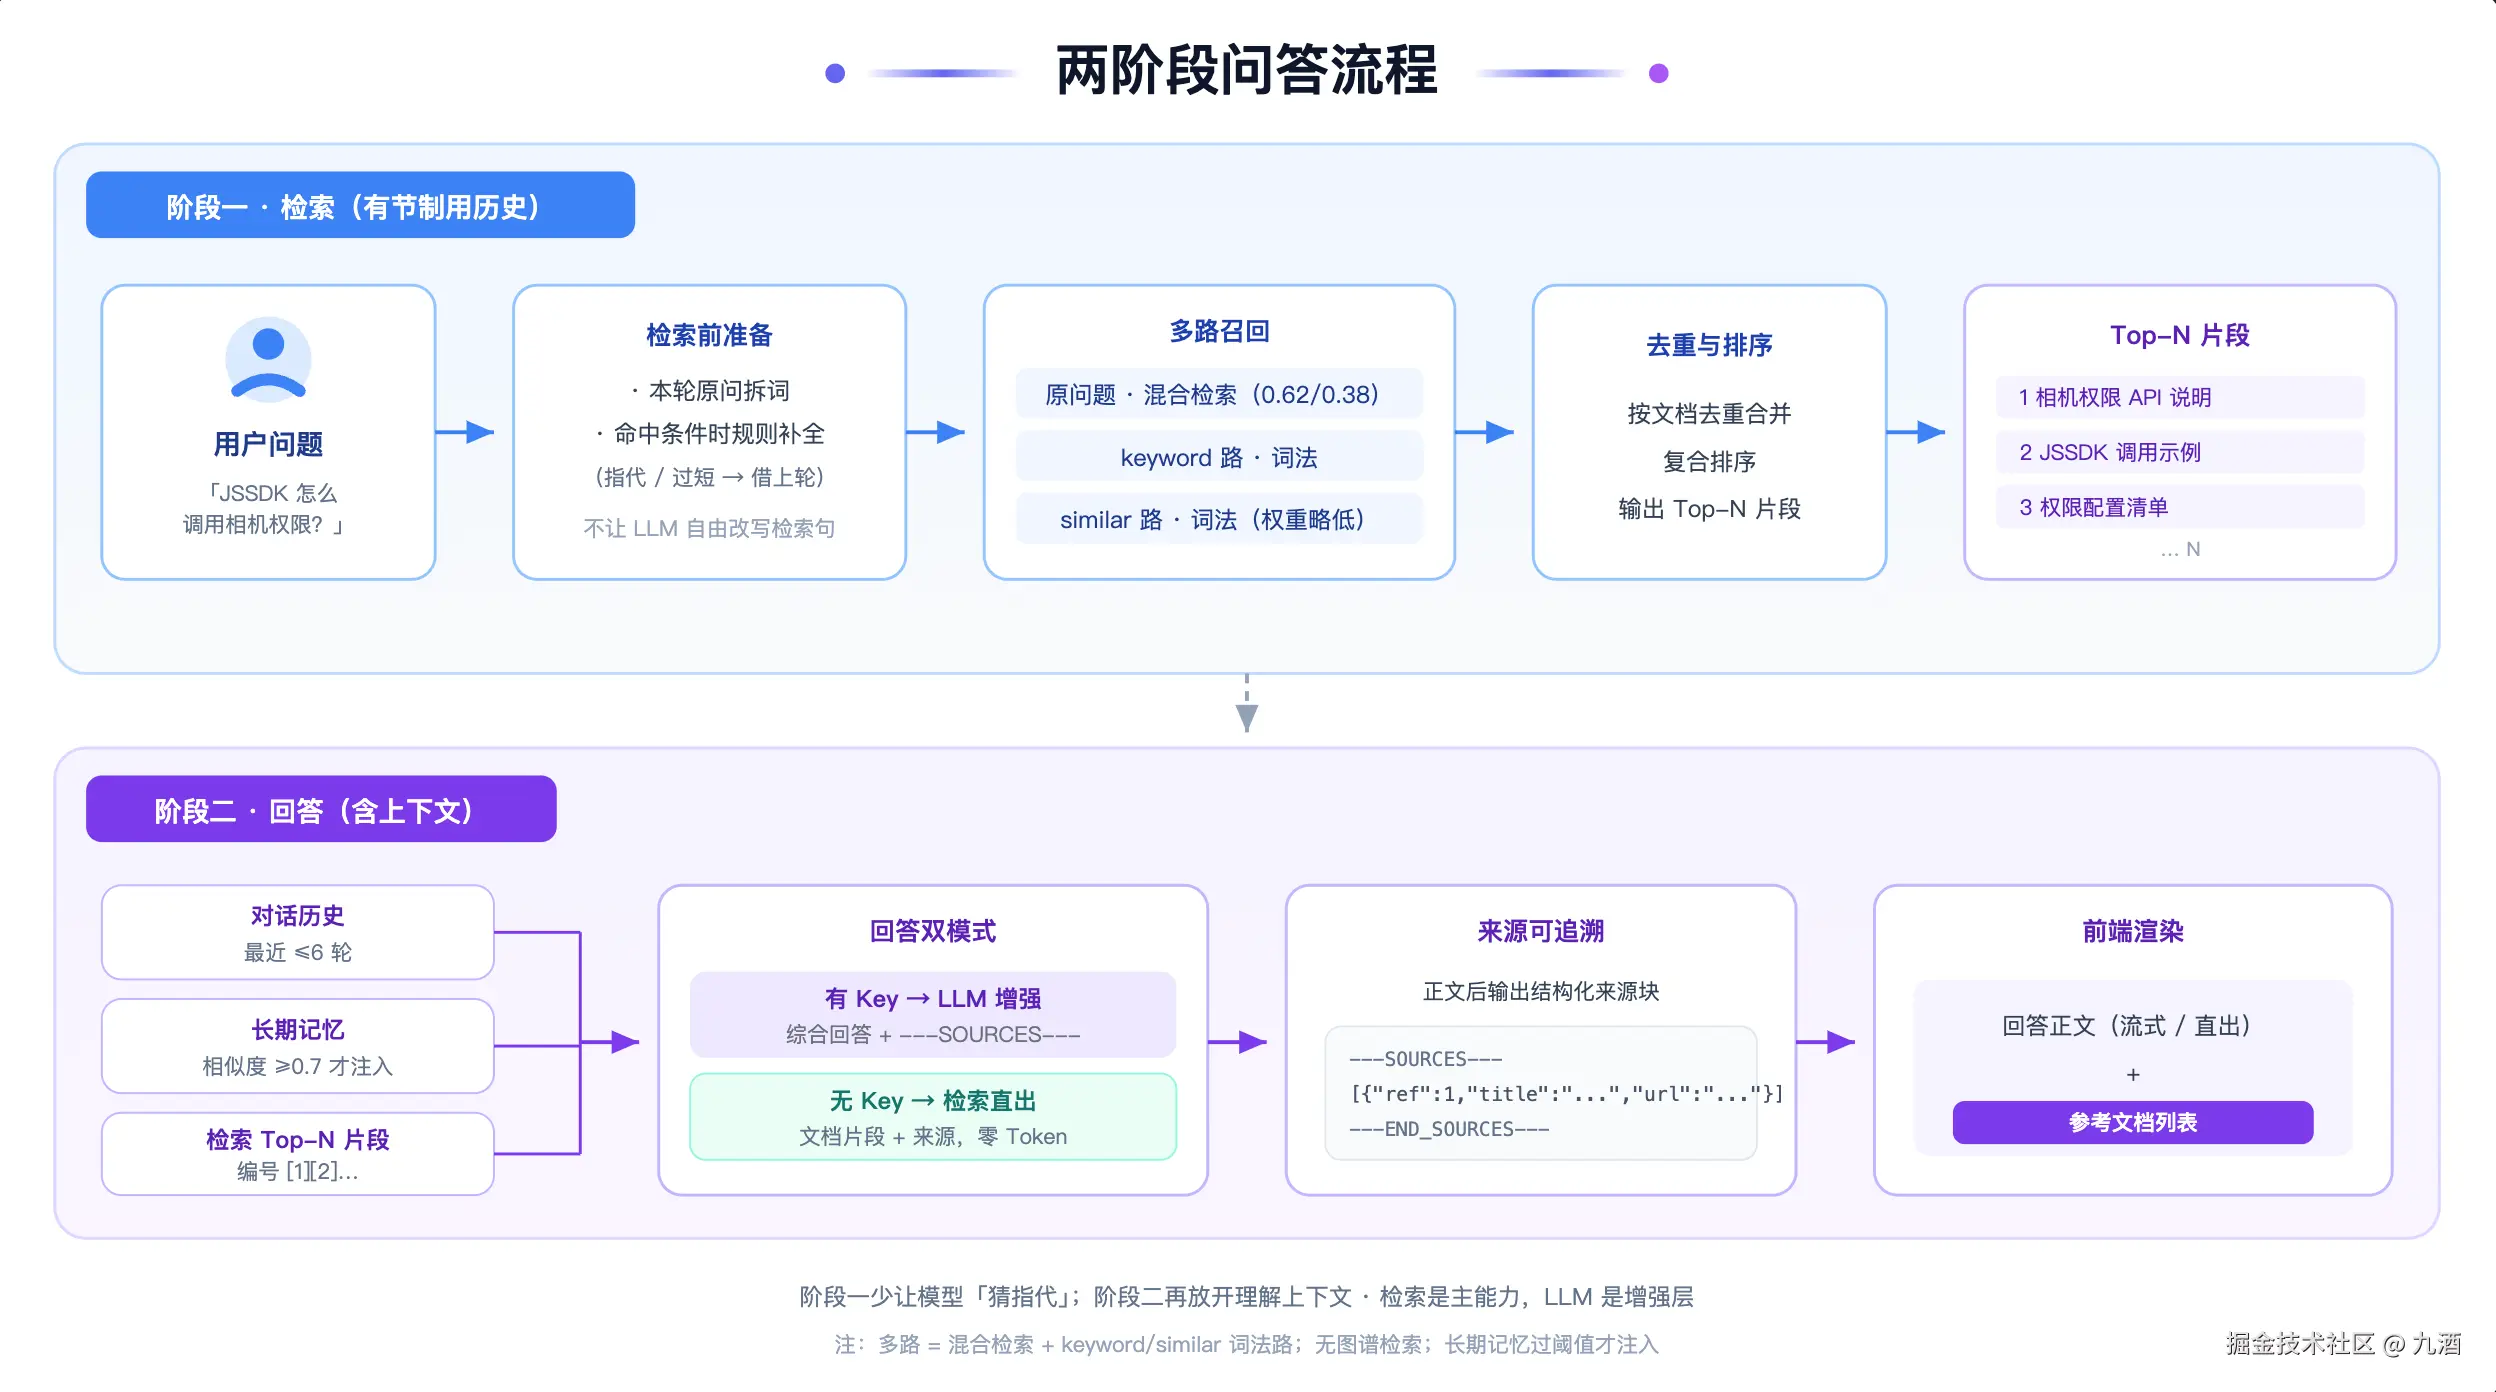
检索阶段少让模型「猜指代」;回答阶段再放开理解上下文。
七、回答阶段:LLM 可选,但来源必须可追溯
检索完成后,进入回答阶段。有 LLM 时,上下文拼装顺序大致是:
markdown
系统 Prompt(角色 + 输出格式)
  + 对话历史(最近 ≤6 轮)
  + 长期记忆(跨会话提炼,相似度 ≥ 0.7 才注入)
  + 检索 Top-N 文档片段(编号 [1][2]...)
  + 本轮用户问题
LLM 必须在正文后输出结构化来源块(---SOURCES---)
css
---SOURCES---
[{"ref":1,"title":"...","url":"https://xxxx.xx.com/..."}]
---END_SOURCES---前端单独渲染「参考文档」列表------没有来源的回答,在产品上是不完整的。
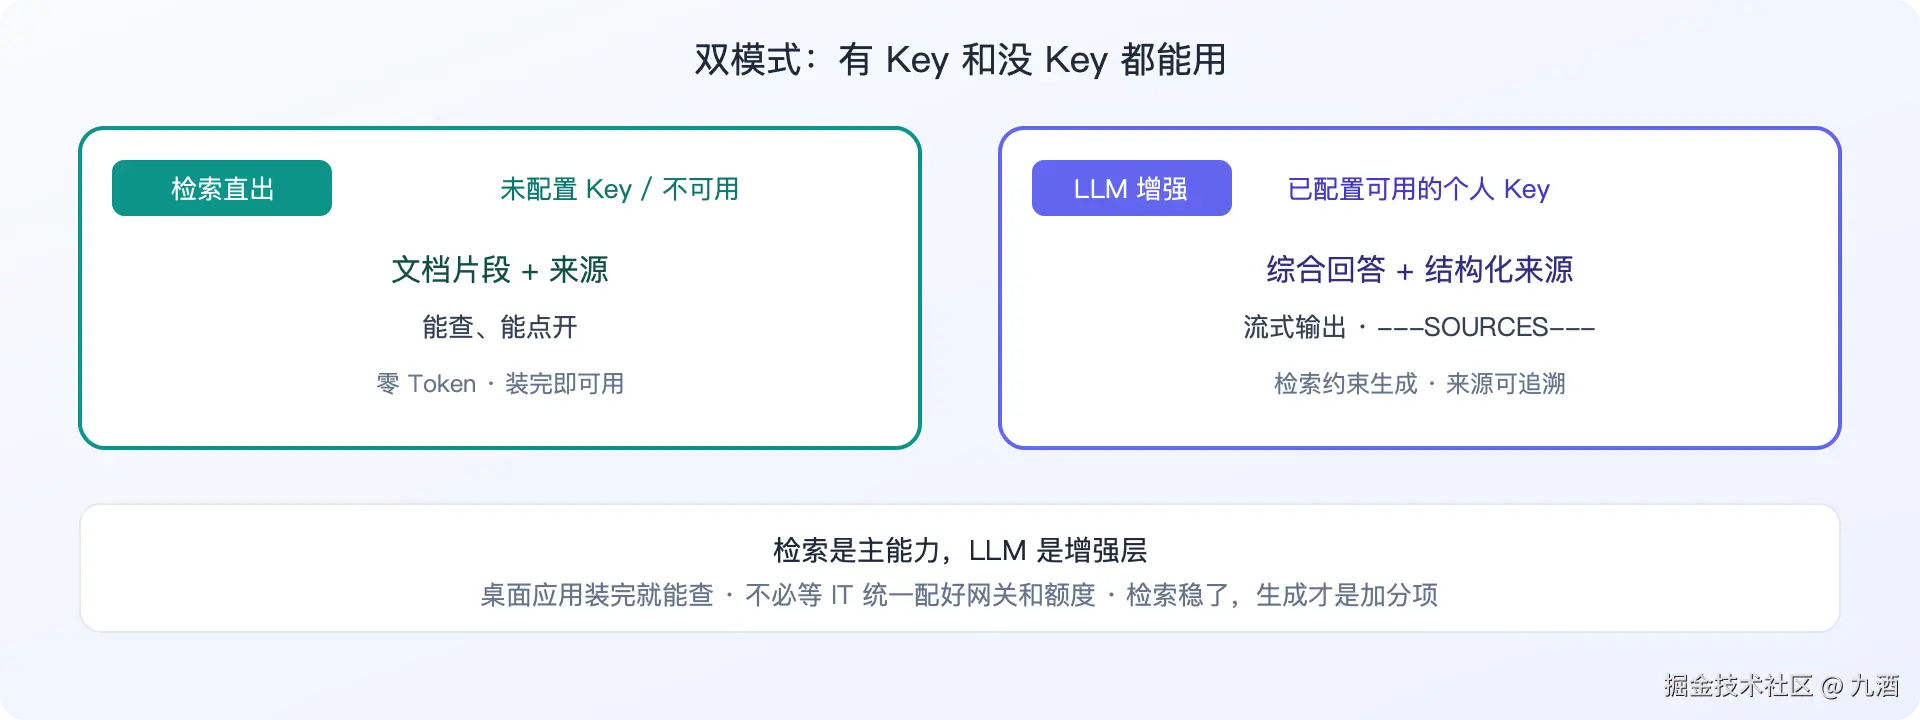
双模式:有 Key 和没 Key 都能用
| 模式 | 何时 | 用户得到什么 |
|---|---|---|
| 检索直出 | 未配置 Key / 不可用 | 文档片段 + 来源,能查、能点开 |
| LLM 增强 | 已配置可用的个人 Key | 综合回答 + 结构化来源 |
桌面应用装完就能查,不必等 IT 统一配好网关和额度;后面再按需接大模型。
检索稳了,生成才是加分项。
八、记忆系统:会话记忆 + 长期记忆
RAG 解决「文档里有什么」;记忆解决「上次聊过什么」。
8.1 会话记忆
每个会话一个 JSON:{ id, title, messages, createdAt, updatedAt },最多 50 条。侧栏展示历史会话,首问可自动生成 ≤15 字标题。
8.2 长期记忆
会话结束(新建 / 切换)时,异步提炼技术要点写入本地库。下次提问按文本相似度 n-gram 检索,超过阈值才注入,避免无关记忆污染上下文。
长期记忆的写入和读取,依赖 LLM 时质量明显更好;无 LLM 时有规则降级,但偏粗糙。相似度也比主检索链路更朴素------这是有意分层:主路径把预算花在文档召回上;记忆层先求「别乱注入」。
这是 RAG 之上的增强层,不是 RAG 本体,但对连续技术支持场景很实用。
九、技术选型:在业务约束下,为什么用这些而不是「业界标配」?
产品背景的硬约束,落到技术栈上就是:少外部依赖、零运维、LLM 可插拔。
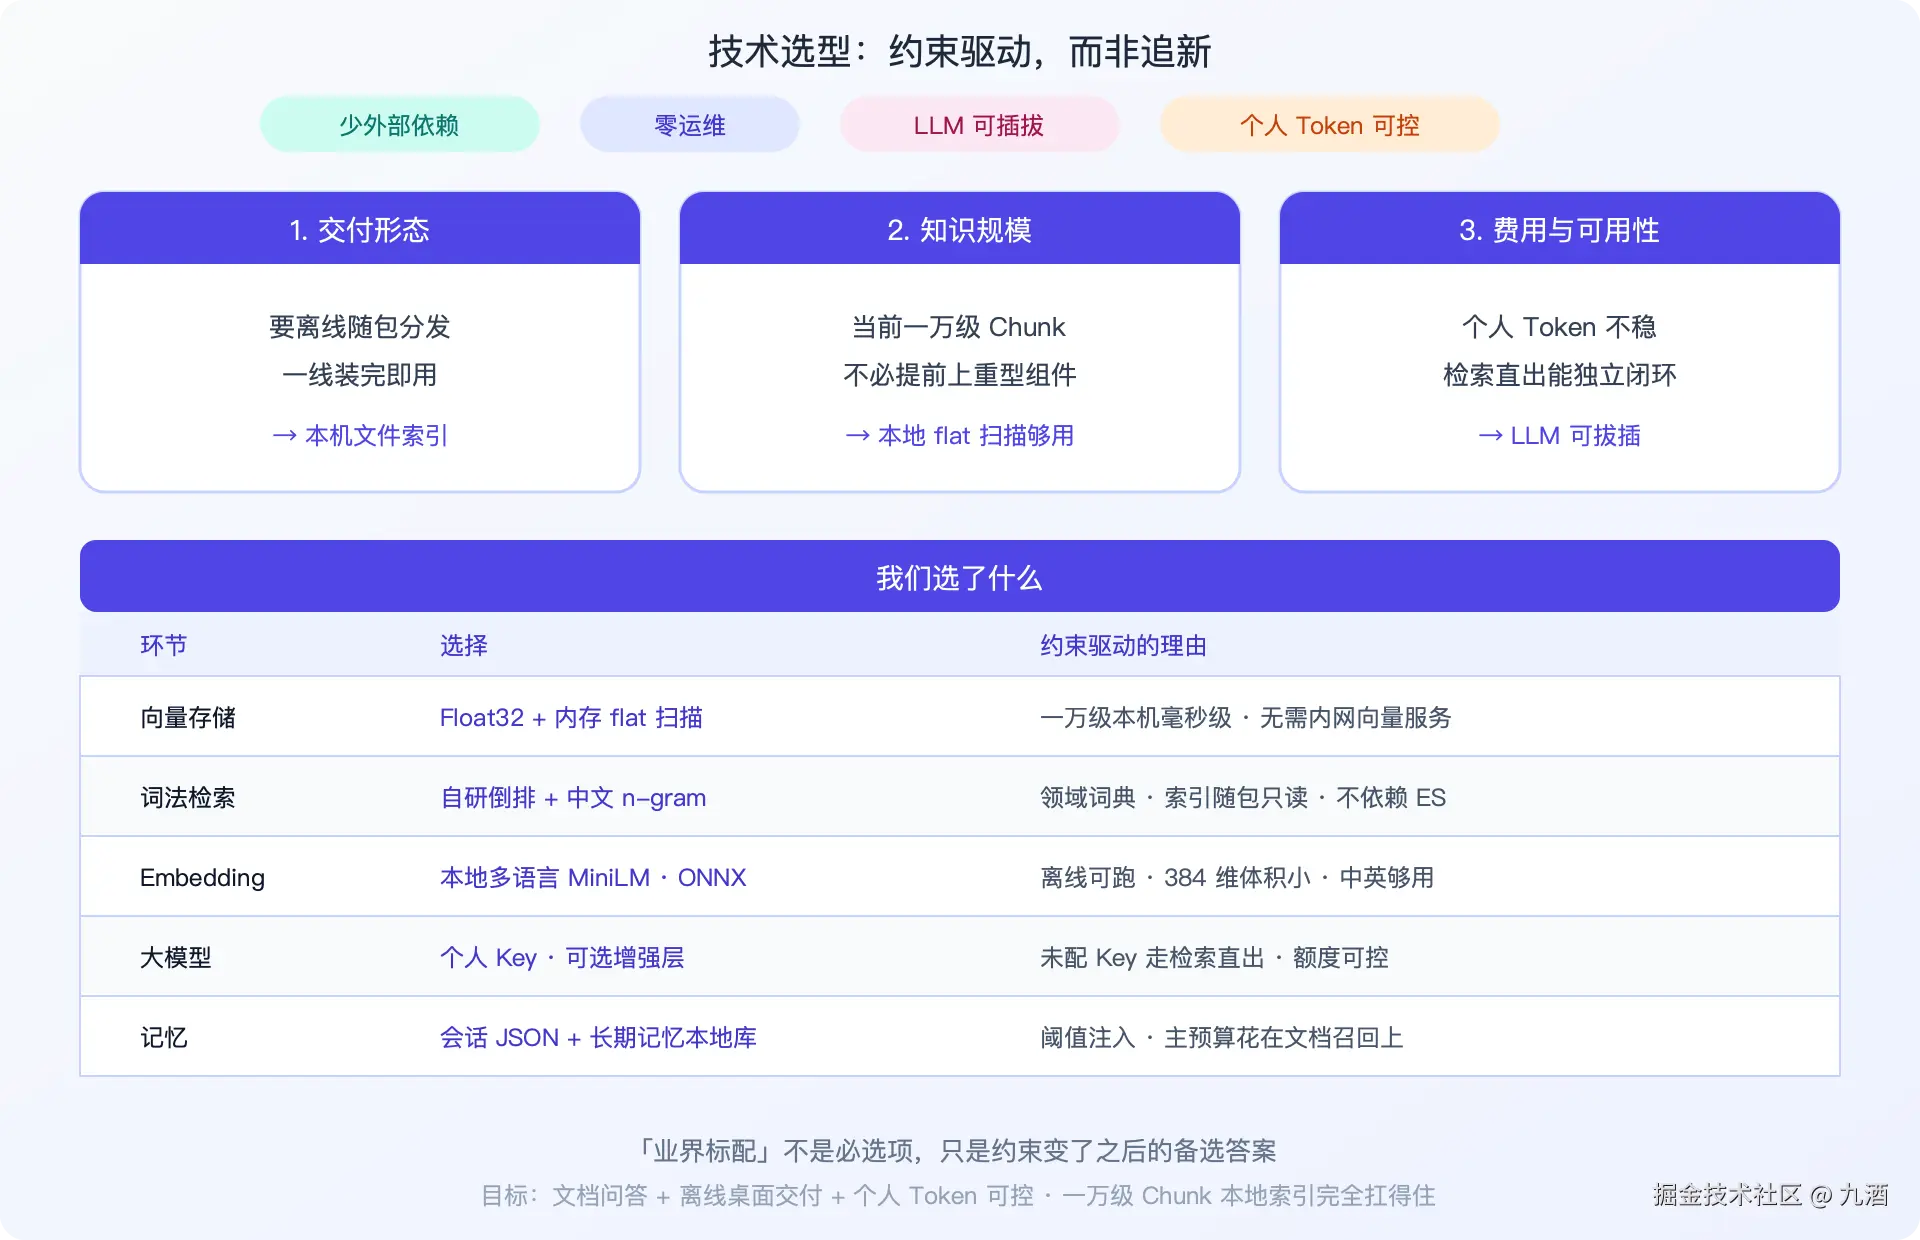
坦白说:这不是互联网大厂亿级文档的架构,不需要先对标那一套。我们的目标是「文档问答 + 离线桌面交付 + 个人 Token 可控」,一万级 Chunk 用本地文件索引完全扛得住。
选型怎么定?还是回到约束本身,按场景裁剪:
- 交付形态:要离线随包分发、一线装完即用 → 本机文件索引更贴约束;若已有统一向量集群与模型网关,再考虑中心化检索
- 知识规模:当前一万级 Chunk → 不必为尚未到来的百万级提前上重型组件;规模真上去了再演进
- 费用与可用性:个人 Token 不稳 → LLM 可拔插、检索直出能独立闭环;额度统一且充足时,再加重生成侧能力
「业界标配」不是必选项,只是约束变了之后的备选答案。
十、总结
回头看,「先做产品、再发现自己在做 RAG」未必是坏事。真正决定能不能上线的,往往不是用哪个向量数据库,而是以下能力:
- 离线:提取 → 分块 → 混合索引 → 增量更新
- 在线:拆词 →命中条件时规则补全→ 多路召回 → 检索/回答分离 → 来源可追溯
- 增强:会话记忆 + 长期记忆 + 无 LLM 降级(有 token 再开生成)
RAG 不是魔法。它解决不了「文档本身就没写」的问题,但能系统性降低大模型胡编的概率,让技术支持类 Agent 从 Demo 变成「敢给一线用」的工具。
如果你也在做类似项目,不必纠结「这算不算 RAG」,当你把整条链路跑通之后,你大概率也会像我们一样:对着经典 RAG 流程图说一句,原来这就是 RAG。