集合帮你自动去重,有序集合还能帮你排个名------排行榜、共同好友、标签系统,Set / Sorted Set 一把搞定!
本次导航
- Set:无序、唯一
- Sorted Set:带分数的 Set,按分数排序
- 核心命令:
SADD、SINTER、ZADD、ZRANGE、ZRANK - 内部编码:intset vs hashtable,ziplist vs skiplist
- 实战场景:共同好友、用户标签、实时排行榜、延时队列
- 图解:交并差集 & 排行榜结构
发车前提醒:Set 和 Sorted Set 是 Redis 里"算法感"最强的两个结构,但用起来特别爽。
一、Set------无序且唯一
Set 就是一个自动去重的集合,里面的元素没有顺序,也不重复。你可以往里塞一堆东西,Redis 帮你保证每个元素只出现一次。
内部编码:
- 元素都是整数且数量少 →
intset(紧凑数组,省内存) - 其他情况 →
hashtable(和 Hash 一样)
常用命令
| 命令 | 功能 |
|---|---|
SADD key member [member...] |
添加一个或多个元素 |
SREM key member [member...] |
移除元素 |
SISMEMBER key member |
判断是否存在 |
SMEMBERS key |
获取所有元素(慎用,可能慢) |
SCARD key |
获取元素个数 |
SINTER key1 key2 |
取交集 |
SUNION key1 key2 |
取并集 |
SDIFF key1 key2 |
取差集(key1 里有但 key2 没有的) |
SRANDMEMBER key count |
随机取 count 个元素 |
SPOP key |
随机弹出一个元素 |
动手试试:
bash
SADD fruits "apple" "banana" "orange"
SADD tropical "banana" "mango" "coconut"

# 取交集(既是水果又是热带水果)
SINTER fruits tropical   # 返回 "banana"

# 取并集
SUNION fruits tropical   # "apple","banana","orange","mango","coconut"

# 取差集(水果里不属于热带的)
SDIFF fruits tropical    # "apple","orange"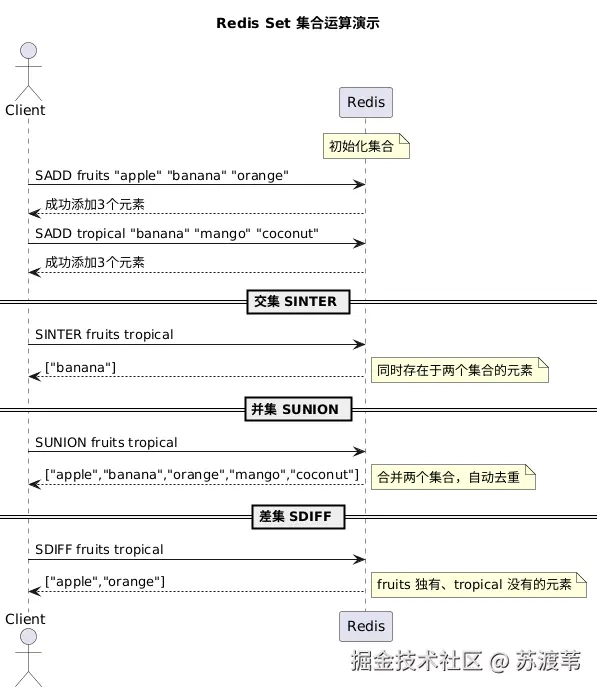
上图很直观的表达了集合关系。
二、Set 实战场景
场景1:共同好友(社交应用)
假设用户 A 的好友集合是 friends:A,用户 B 的是 friends:B:
bash
SADD friends:A "U1" "U2" "U3" "U4"
SADD friends:B "U3" "U4" "U5" "U6"

# 共同好友
SINTER friends:A friends:B   # U3, U4

# A 可能认识的人(B 的好友减去 A 的好友)
SDIFF friends:B friends:A    # U5, U6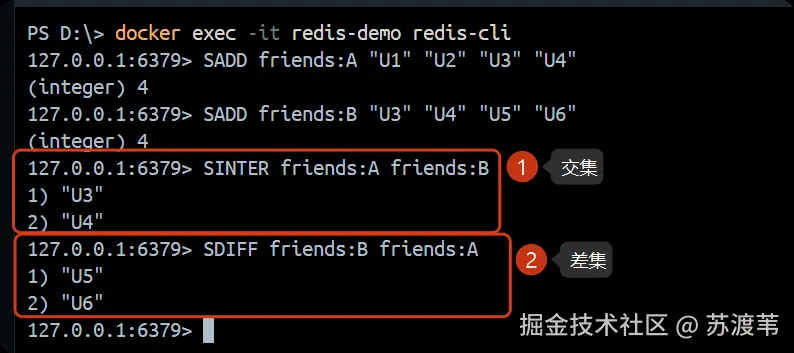
场景2:用户标签 / 兴趣推荐
给用户打标签,然后根据标签交集推荐内容:
bash
SADD user:1001:tags "tech" "gaming" "music"
SADD user:1002:tags "gaming" "sports" "movie"

# 相同标签
SINTER user:1001:tags user:1002:tags   # "gaming"

# 推荐:取 user:1002 有但 user:1001 没有的标签
SDIFF user:1002:tags user:1001:tags    # "sports","movie"
场景3:抽奖 / 随机抽样
抽奖活动场景使用率相当的高,比如从参与用户集合里随机抽一个:
bash
SADD lottery "user1" "user2" "user3" "user4" "user5"
SRANDMEMBER lottery 1        # 随机抽一个,不删除
SPOP lottery                 # 随机抽一个并移除(中奖后出局)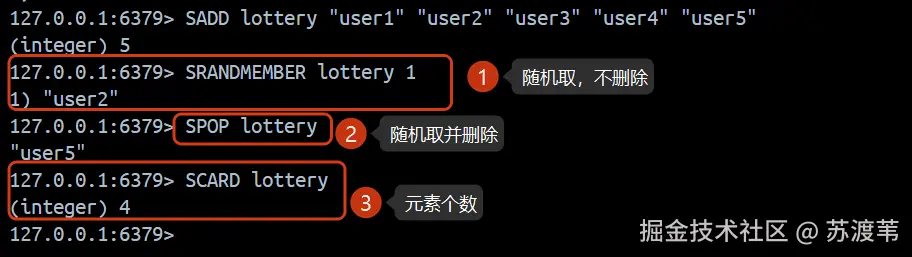
三、Sorted Set------带排名的 Set
Sorted Set(有序集合)在 Set 的基础上,给每个元素绑定了一个 score(分数),然后按照分数从小到大排序。
分数相同则按字典序。
内部编码:
- 元素少且分数相近 →
ziplist(压缩列表) - 元素多时 →
skiplist + hashtable(跳表保证有序,哈希表保证快速查找)
常用命令
| 命令 | 功能 |
|---|---|
ZADD key score member [score member...] |
添加元素并指定分数 |
ZRANGE key start stop [WITHSCORES] |
按分数升序取指定范围 |
ZREVRANGE |
按分数降序取 |
ZRANK key member |
获取元素排名(从0开始,升序) |
ZREVRANK |
获取元素排名(降序) |
ZSCORE key member |
获取元素分数 |
ZINCRBY key increment member |
增加元素分数 |
ZREM key member |
删除元素 |
ZCOUNT key min max |
统计分数在区间内的元素数量 |
ZRANGEBYSCORE |
按分数区间取元素 |
动手试试:
bash
# 游戏排行榜:玩家分数
ZADD leaderboard 100 "Alice" 200 "Bob" 150 "Charlie"

# 按分数从低到高取全部(带分数)
ZRANGE leaderboard 0 -1 WITHSCORES
# 1) "Alice" 2) "100" 3) "Charlie" 4) "150" 5) "Bob" 6) "200"

# 按分数从高到低(排名靠前的)
ZREVRANGE leaderboard 0 2 WITHSCORES
# "Bob" 200, "Charlie" 150, "Alice" 100

# 查看 Alice 的排名(升序排名,0表示第一名)
ZRANK leaderboard "Alice"     # 0
ZREVRANK leaderboard "Alice"  # 2(倒数第一)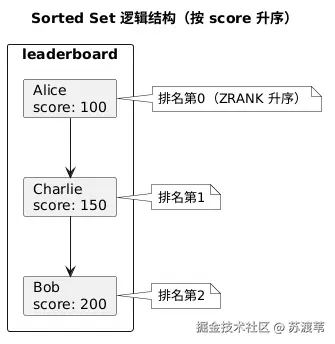
四、Sorted Set 实战场景
场景1:实时排行榜(游戏、热度)
每次玩家得分,就用 ZINCRBY 增加分数:
bash
# 玩家 Bob 获得 50 分
ZINCRBY game_scores 50 "Bob"

# 获取 Top 5
ZREVRANGE game_scores 0 4 WITHSCORES
场景2:延时队列(拿分数当时间戳)
把任务作为 member,执行时间戳作为 score。消费者定期用 ZRANGEBYSCORE 取到期的任务:
bash
# 添加延时任务:当前时间戳 + 延迟秒数
ZADD delay_queue 1735689600 "send_email:user1001"
ZADD delay_queue 1735690000 "clean_cache"

# 消费者(每隔几秒执行)
# 取出当前时间戳之前的所有任务
ZRANGEBYSCORE delay_queue 0 1735689700
# 然后删除取出的任务(ZREM)
场景3:商品热度 / 滑动窗口限流
用 Sorted Set 存储用户在某时间窗口内的访问记录,score 是时间戳:
bash
# 用户 1001 在时间戳 1735689600 访问了一次
ZADD rate_limit:1001 1735689600 "req_1"

# 清理 60 秒前的记录
ZREMRANGEBYSCORE rate_limit:1001 0 1735689540

# 统计最近 60 秒内的请求数
ZCOUNT rate_limit:1001 1735689540 +inf
五、Set vs Sorted Set 选择指南
| 需求 | 用哪个 | 理由 |
|---|---|---|
| 只要去重,不要排序 | Set | 内存更省,操作更快 |
| 需要判断元素是否存在 | Set | O(1) 时间复杂度 |
| 需要按分数排序 | Sorted Set | 自带排序,支持范围查询 |
| 需要频繁取 Top N | Sorted Set | ZREVRANGE 极快 |
| 需要按时间戳排序做队列 | Sorted Set | 用 score 存时间戳 |
| 需要集合运算(交并差) | Set | Sorted Set 不支持直接集合运算 |
📢 觉得有用?
热烈欢迎:
- 点赞 + 在看 支持一下
- 关注公众号,接收第一首博客文章
- 留言告诉我 你遇到过哪些有意思的排行榜 / 去重场景
我们下期见!🚀