一、引言
Spark 已经是大数据批处理和 SQL 分析的事实标准之一,但在数据规模继续增长后,传统逐行处理方式容易带来较高 CPU 延迟,并逐渐成为查询性能瓶颈,因此需要通过 vectorized execution 改善执行效率。
向量化执行的基本思想,是一次处理一批数据而不是一行一行处理。这样可以减少函数调用次数,并利用 SIMD 指令在 CPU 层面批量处理数据;Apache Auron 将这一思路与 Apache Arrow-DataFusion 和 Spark 结合,让 Spark 的部分物理计划转换为等价的原生执行计划。
可以把它理解为 Spark 执行链路中的"原生执行加速层":
yaml
传统 Spark SQL 执行路径

SQL / DataFrame
      |
      v
Spark Catalyst 优化
      |
      v
Spark 物理计划
      |
      v
JVM 执行引擎
      |
      v
结果输出
引入 Auron 后,支持的算子会进入原生向量化路径:
yaml
Spark + Auron 执行路径

SQL / DataFrame
      |
      v
Spark Catalyst 优化
      |
      v
Spark 物理计划
      |
      +-------------------------+
      | Auron 检查可支持算子     |
      +-------------------------+
             | 支持
             v
   转换为 Auron / DataFusion 执行计划
             |
             v
   Rust Native Engine + Arrow Columnar Batch
             |
             v
          结果返回 Spark
Auron 并不是一个独立 SQL 引擎,也不是 Redis、Alluxio 那类缓存层,而是嵌入 Spark/Flink 执行生命周期的原生计算加速组件。
二、Auron 的架构原理
Apache Auron 的核心流程:它从 Spark 获取已经优化好的物理计划,将其映射为原生引擎中的等价执行计划,然后在 Spark 的分布式环境中执行。在 Spark 场景中,Auron 会检查并转换 Spark 物理计划中受支持的算子,生成原生执行计划,再通过 JNI 调用传递给底层 Native Engine,由 DataFusion 框架执行。
整体架构如下图表示:
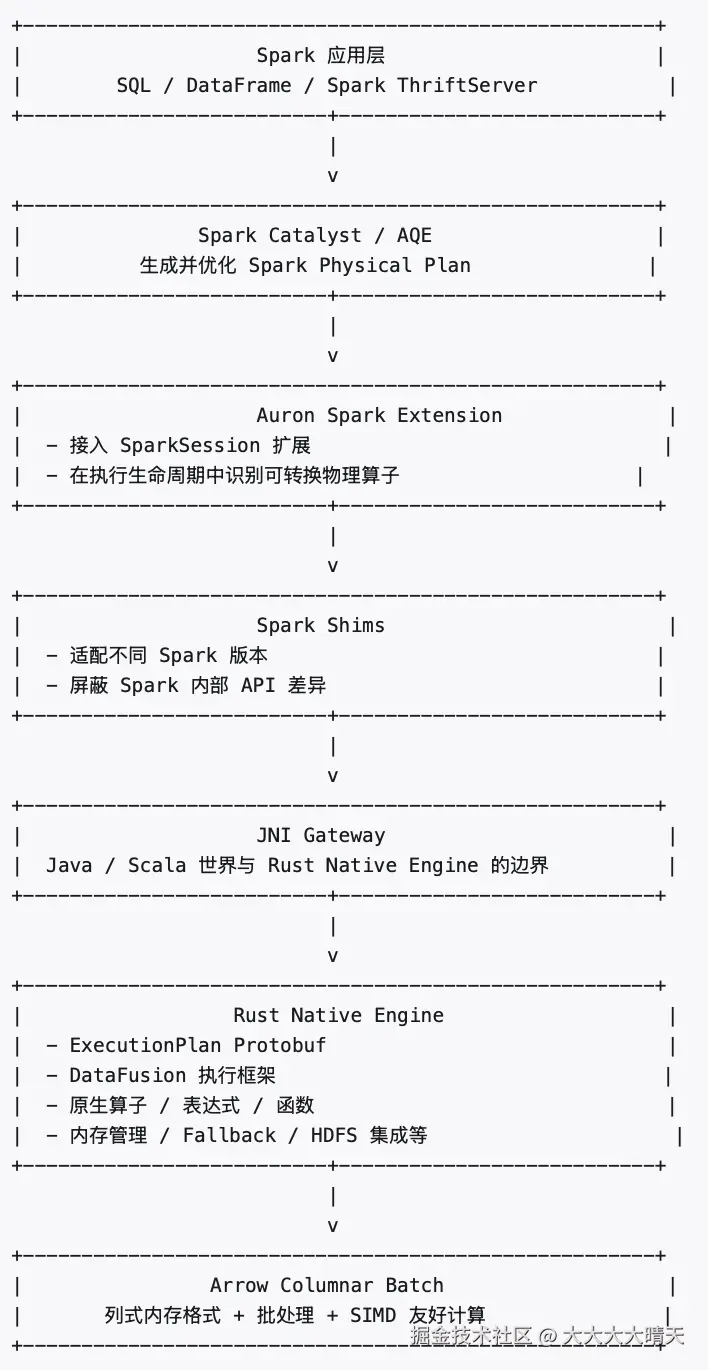
Auron 核心模块可以拆为三个:Spark Extension、Spark Shims 和 Native Engine。Spark Extension 负责把加速器接入 Spark 执行生命周期;Spark Shims 用于适配不同 Spark 版本;Native Engine 由 Rust 实现,包含 ExecutionPlan protobuf、JNI gateway、基于 DataFusion 的自定义算子、表达式和函数,以及内存管理、fallback、HDFS 集成等通用模块。
Native Engine 的关键意义在于,它让 Spark 中可支持的计算片段离开 JVM 执行路径,进入 Rust + DataFusion + Arrow 的执行模型:
yaml
Spark Physical Plan
      |
      |  算子转换
      v
Auron Native Plan
      |
      |  DataFusion 执行
      v
Arrow RecordBatch
      |
      |  向量化处理
      v
Native Operator Pipeline
三、核心功能特性
diff
+-----------------------------+
|       生态集成层             |
| Spark Extension / Flink 集成 |
+-----------------------------+
|       计划转换层             |
| Physical Plan -> Native Plan |
+-----------------------------+
|       原生执行层             |
| Rust / DataFusion / JNI      |
+-----------------------------+
|       数据表示层             |
| Apache Arrow Columnar Format |
+-----------------------------+
Auron 的第一类能力是原生执行。Auron 由 Rust 实现,通过消除 JVM overhead 获得更可预测的性能表现 。这并不意味着 Spark 被移除,而是 Spark 仍负责任务调度、分布式执行环境和上层 SQL 生态,Auron 接管其中可转换的计算执行片段。
第二类能力是向量化计算。Auron 基于 Apache Arrow 的列式格式构建,利用 SIMD 指令进行批处理计算。这类设计特别适合分析型查询,因为 SQL 过滤、投影、聚合、排序、Join 等操作通常可以在列式批数据上获得更好的 CPU cache locality 和批处理效率。
第三类能力是可插拔架构。Auron 可以无缝集成 Spark,同时设计上也为未来扩展到其他引擎预留空间;截至当前Auron 显著扩展了 Flink 集成,包括 Flink Auron adaptor、表达式转换框架、Native Calc operator 和 Flink assembly 部署 JAR。
第四类能力是生产环境优化。Auron 包含多级内存管理、紧凑 Shuffle 格式和自适应执行策略等来自大规模部署的优化。例如内存管理、Shuffle 失败重试、Spark UI 指标、Join 正确性、Native function 覆盖、Spark 版本兼容性等持续增强。
四、支持的算子与回退机制
Auron 不是把所有 Spark 逻辑都强制改为原生执行,它会支持未实现算子 fallback 到 Spark 执行,因此包含不支持算子的 SQL 仍然可以成功执行;但 fallback 会带来额外成本,如果 fallback 太多,执行速度会变慢。
当前支持的 Native Operator 覆盖了 Parquet/ORC 扫描、ShuffleExchange、BroadcastExchange、Project、Filter、Sort、Limit、Union、Window、Generate、HashAggregate、SortAggregate、BroadcastJoin、ShuffledHashJoin、SortMergeJoin、BroadcastNestedLoopJoin 等类别。
可以把执行过程理解为"能转就转,不能转就回退":
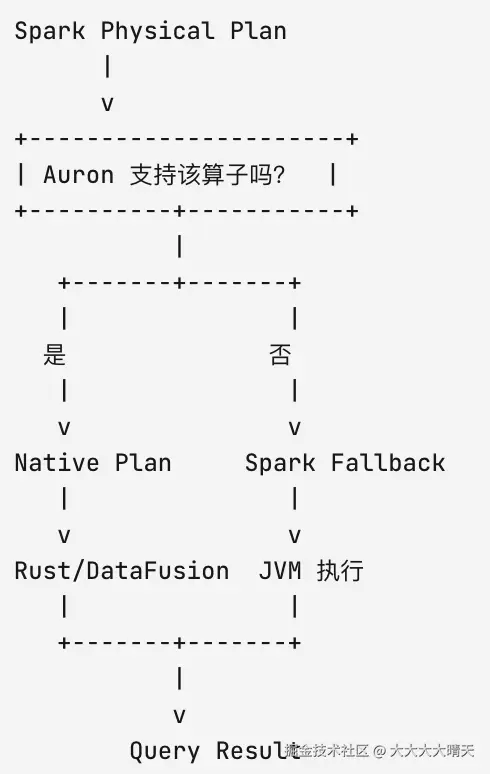
这种机制降低了试用门槛,但也带来一个实践判断:如果你的 SQL 中大量使用复杂 UDF、UDTF、非标准表达式或当前尚未覆盖的算子,那么 Auron 可能仍能执行成功,但加速效果会被 fallback 稀释。另外,Auron 支持表达式级 fallback,某些不支持表达式如 UDF/UDTF 可以回退到 Spark 执行。
五、Auron 的优势
Auron 的第一项优势是减少 JVM 执行开销。Rust 原生执行路径使部分计算不再由 JVM 承担,官方直接将 "eliminating JVM overhead" 列为 Native execution 的关键收益。对 CPU 密集型 SQL 来说,这一点尤其重要,因为执行开销通常不仅来自 I/O,也来自表达式求值、聚合、排序和 Join 的 CPU 时间。
第二项优势是列式批处理能力。Auron 建立在 Arrow 列式格式之上,面向批量数据处理,并利用 SIMD 指令优化计算。这与 OLAP 查询的访问模式天然契合,尤其适合扫描大量列式文件、做过滤、投影、聚合和 Join 的场景。
第三项优势是与 Spark 生态的兼容性。用户可以把 Auron 作为 Spark client extension 安装,安装后多数 SQL 查询无需修改即可运行得更快并节省集群资源。这意味着它不像迁移到新引擎那样需要重写作业、重建调度体系或改变主要开发接口。
第四项优势是版本和生态扩展在持续推进。7.0.0-incubating 增加了 Spark UI 集成、更多 Native Functions、Spark 3.5.8 和 Spark 4.0.2 支持、JDK 21 支持,以及新的模块拆分;8.0.0-incubating 进一步扩展了 Flink、Kafka source、Iceberg、Hudi、Paimon、Native JSON/Protocol Buffers 反序列化和更多表达式/函数覆盖。
六、适用场景
最适合 Auron 的,是以 Spark SQL/DataFrame 为主的分析型工作负载。官方目标用户就是希望加速 Spark SQL/DataFrame 查询的人群,并强调 Auron 可作为 Spark client extension 安装。如果你的任务主要是 TPC-DS 类 SQL、宽表扫描、复杂聚合、多表 Join、批量离线分析,Auron 值得优先验证。
第二类场景是 Parquet/ORC 等列式文件读取与计算。官方支持的 Native Operator 包含 NativeParquetScan 和 NativeOrcScan,同时配置文档也列出了 Parquet/ORC 扫描开关、Parquet bloom filter、page filtering、metadata cache 等参数。如果查询瓶颈集中在列式文件扫描、过滤和批处理计算,Auron 的设计方向与这类场景匹配。
第三类场景是 Shuffle 压力较大的 SQL。Auron 提供 NativeShuffleExchange,它可以集成 Remote Shuffle Services,目前支持 Apache Celeborn 和 Apache Uniffle。在大规模 Join、聚合、排序任务中,结合远程 Shuffle 服务可能有助于提升 Shuffle 稳定性和扩展性。
不太适合的场景也要说明。大量依赖自定义 UDF/UDTF、复杂非标准函数、强行要求完全 Spark 语义一致但未充分验证的作业,应先做灰度和正确性回归。虽然支持 fallback,但也明确提醒 fallback 有额外成本,fallback 太多会拖慢执行。
七、部署与使用
Auron 的源码构建需要 Rust nightly 和 JDK,基本部署路径如下:
yaml
下载 / 编译 Auron
      |
      v
生成 fat JAR
      |
      v
放入 Spark 客户端 classpath
      |
      v
配置 spark-default.conf
      |
      v
提交 spark-sql / Spark 作业
官方给出的 Spark 配置示例如下,其中关键配置包括启用 Auron、注册 SparkSession Extension、设置 Auron Shuffle Manager,并关闭 Spark offHeap memory:
yaml
spark.auron.enable true
spark.sql.extensions org.apache.spark.sql.auron.AuronSparkSessionExtension
spark.shuffle.manager org.apache.spark.sql.execution.auron.shuffle.AuronShuffleManager
spark.memory.offHeap.enabled false

# suggested executor memory configuration
spark.executor.memory 4g
spark.executor.memoryOverhead 4096
如果要集成远程 Shuffle 服务,Celeborn 场景需要使用AuronCelebornShuffleManager 并配置 Celeborn master endpoints;Uniffle 场景需要使用AuronUniffleShuffleManager 并指定 coordinator quorum。
lua
Auron + RSS 架构示意

Spark Executor
      |
      | Native Shuffle Write / Read
      v
+----------------------+
| Auron ShuffleManager |
+----------------------+
      |
      +--------------------+
      |                    |
      v                    v
Apache Celeborn       Apache Uniffle
Remote Shuffle        Remote Shuffle
Service               Service
八、常用配置与性能指标
- 总开关:
spark.auron.enabled/spark.auron.enable,启用 Auron 支持,默认值为true。 - 内存与 Spill:
spark.auron.onHeapSpill.memoryFraction、spark.auron.process.vmrss.memoryFraction,控制 on-heap spilling 和进程 RSS 内存使用比例。 - 算子开关:
spark.auron.enable.filter、spark.auron.enable.project、spark.auron.enable.smj等,控制对应 Spark 物理算子是否转换为 Native Auron 实现。 - UI 观测:spark.auron.ui.enabled,在 Spark UI 中展示 Auron 相关指标,默认值为
true。
在调优时,不建议一开始就改动大量参数。更稳妥的方式是先启用 Auron,观察 Spark UI、任务耗时、fallback 比例、Shuffle 行为和内存使用,再针对 Join、Scan、Spill、Shuffle 做局部调整。
官方 benchmark 提供了 TPC-DS 1TB 数据集的测试说明,对于企业内部验证,建议不要只看单条 SQL 的最好结果,而要观察三类指标:
- 正确性:结果是否与原 Spark 执行一致,尤其是 Join、NULL、NaN、时间类型、UDF 等边界语义。
- 资源使用:Executor memory、memoryOverhead、CPU 使用率、Shuffle I/O 是否更合理。
- 端到端耗时:SQL 总耗时是否稳定下降。
九、常见问题
1.Auron 是缓存系统吗
不是。Auron 是面向大数据引擎的 native vectorized execution accelerator,用于加速查询处理。它和 Redis、Alluxio、Ignite 这类缓存系统不是同一类项目。
2.使用 Auron 要改 SQL 吗
通常不需要大规模改写。用户可以把 Auron 安装为 Spark client extension,安装后大多数 SQL 查询无需修改即可运行得更快并节省集群资源。但如果 SQL 中包含大量 Auron 暂不支持的表达式或 UDF,实际加速效果需要测试确认。
3.不支持的算子会失败吗
不一定。不支持的 operator 可以 fallback 到 Spark 执行,因此包含未实现算子的 SQL 仍可成功执行;但 fallback 会带来额外成本,过多 fallback 会降低性能。
4.Auron 是否只支持 Spark
早期主要围绕 Spark。官方已将 Auron 表述为面向 Spark、Flink 等大数据引擎的加速器,最新版本明确扩展了 Flink 集成、Flink Kafka source、Flink metrics 等能力。因此更准确的说法是:Spark 是当前重点和成熟场景之一,Flink 集成正在快速增强。