Goroutine 是 Go Runtime 管理的轻量级并发执行单元,可以理解为 Go 的协程。
Goroutine 就像 Go 程序里的"轻量级小工",Go Runtime 就像是调度员,负责安排这些小工什么时候干活、在哪个线程上干活。
之所以说轻量,是因为 Goroutine 和操作系统线程相比非常轻。如果说操作系统线程是大卡车,Goroutine 就相当于小电驴。
只需要用 go 关键字将任务交给 Goroutine ,剩下的调度工作由 Go Runtime 来完成。
go
go doSomething()认识协程
协程是一种比线程轻量的任务执行单元,它可以在执行过程中主动暂停,把执行权交给其他任务,之后再恢复执行。
协程与线程的关系为:
text
操作系统
   │
   ├── 线程 A
   │     ├── 协程 1
   │     ├── 协程 2
   │     └── 协程 3
   │
   └── 线程 B
         ├── 协程 4
         ├── 协程 5
         └── 协程 6
认识并发
并发是指程序在同一时间段内交替推进多个任务的执行,让多个任务能够同时处于执行状态。在多任务的场景下,并发执行任务能缩短任务完成的时间。
比如我们有三个任务:
text
获取用户信息
获取订单信息
获取商品信息
如果按照传统的串行方式:
text
获取用户
   ↓
获取订单
   ↓
获取商品
   ↓
全部完成
假设:
text
获取用户:500ms
获取订单:800ms
获取商品:300ms
那么总耗时大约:
text
500 + 800 + 300 = 1600ms如果这三个任务之间没有任何依赖,则可以:
这样理想情况下,总耗时接近:
text
max(500, 800, 300) = 800ms并发有那么大的好处,是非常值得学习的。
在 Go 语言中,想让函数并发执行,只需在函数前面加个 go 就行:
go
go doSomething()go 关键字的作用是启动一个 Goroutine ,让任务并发执行。
第一个 Goroutine 示例
我们来看一个 Goroutine 完整示例。
go
package main

import (
  "fmt"
  "time"
)

func sayHello() {
  fmt.Println("Hello")
}

func main() {
  go sayHello()

  time.Sleep(time.Second)

  fmt.Println("main结束")
}
运行:
bash
go run main.go可能看到:
text
Hello
main结束
这里使用 go 关键字启动了 Goroutine 去执行 sayHello() 函数。
这里在 main 中硬等了 1s ,让 main 不要那么快执行完成,给调度器留出时间跑 sayHello() 函数。
Go 进程的生命周期只由 main goroutine 决定 :main 一返回,runtime 直接终止进程,不会等其他 goroutine 。
如果去掉 time.Sleep 语句:
go
func main() {
  go sayHello()

  fmt.Println("main结束")
}
这里 sayHello 会来不及执行,由于 main goroutine 结束,进程就退出了。
实际项目不要用 Sleep 等待 Goroutine
如下面的代码:
go
go task()

time.Sleep(time.Second)
time.Sleep 只是看起来解决了问题。如果 task 只需要 100ms ,则 main goroutine 白等 900ms 。
如果 task 需要 2s ,则 Sleep 时间不够,导致无法完成 task 的执行。
在实际项目中,不要用 Sleep 阻塞等待 main goroutine 。真正应该使用的是 WaitGroup 、Channel 和 Context 等并发控制工具。
WaitGroup:等待一群 Goroutine
sync.WaitGroup 可以理解成一个任务计数器。
例如我们有 3 个任务:
text
Task 1
Task 2
Task 3
先告诉 WaitGroup:
go
wg.Add(3)每完成一个:
go
wg.Done()最后:
go
wg.Wait()示例代码:
go
package main

import (
  "fmt"
  "sync"
)

func task(id int) {
  fmt.Println("执行任务", id)
}

func main() {
  var wg sync.WaitGroup

  wg.Add(3)

  for i := 1; i <= 3; i++ {
    go func(id int) {
      defer wg.Done()

      task(id)
    }(i)
  }

  wg.Wait()

  fmt.Println("所有任务完成")
}
执行流程如下:
Add 负责"记账",Done 负责"还账",Wait 负责"等账还完"。
在实际项目中,可以使用 sync.WaitGroup 代替 time.Sleep 等待 goroutine 结束。
Channel:Goroutine 之间的"传送带"
Channel 用于实现 Goroutine 之间的数据传递。
比如要将 Goroutine A 的计算结果交给 Goroutine B,可以使用 Channel 实现。
创建 Channel
go
ch := make(chan string)发送数据给 Channel
go
ch <- "Hello"接收 Channel 的数据
go
message := <-ch完整示例代码:
go
package main

import "fmt"

func main() {
  ch := make(chan string)

  go func() {
    ch <- "Hello Go"
  }()

  message := <-ch

  fmt.Println(message)
}
可以把 Channel 想象成一条传送带:
所以:
go
ch <- data相当于 把数据放上去。
而:
go
data := <-ch相当于 把数据拿下来。
带有缓冲的 Channel
默认:
go
ch := make(chan int)是无缓冲 Channel。
我们也可以:
go
ch := make(chan int, 3)表示:
这个 Channel 最多可以暂存 3 个数据。
例如:
go
ch <- 1
ch <- 2
ch <- 3
都可以正常执行。
但是:
go
ch <- 4就会阻塞,因为 Channel 已经满了。
可以理解成:
text
Channel

┌─────┬─────┬─────┐
│  1  │  2  │  3  │
└─────┴─────┴─────┘
              ↑
             满了
完整实战:并发获取用户、订单和商品
我们综合运用上面学到的 Goroutine 、Channel 和 WaitGroup 知识,实现一个更接近真实项目的例子。
假设我们的页面需要同时获取:
text
用户信息
订单信息
推荐商品
定义三个函数:
go
func getUser() string {
  time.Sleep(500 * time.Millisecond)
  return "用户信息"
}

func getOrders() string {
  time.Sleep(800 * time.Millisecond)
  return "订单信息"
}

func getProducts() string {
  time.Sleep(300 * time.Millisecond)
  return "商品信息"
}
我们可以使用 Channel:
go
package main

import (
  "fmt"
  "sync"
  "time"
)

func getUser() string {
  time.Sleep(500 * time.Millisecond)
  return "用户信息"
}

func getOrders() string {
  time.Sleep(800 * time.Millisecond)
  return "订单信息"
}

func getProducts() string {
  time.Sleep(300 * time.Millisecond)
  return "商品信息"
}

func main() {
  var wg sync.WaitGroup

  userCh := make(chan string)
  orderCh := make(chan string)
  productCh := make(chan string)

  wg.Add(3)

  go func() {
    defer wg.Done()
    userCh <- getUser()
  }()

  go func() {
    defer wg.Done()
    orderCh <- getOrders()
  }()

  go func() {
    defer wg.Done()
    productCh <- getProducts()
  }()

  user := <-userCh
  orders := <-orderCh
  products := <-productCh

  wg.Wait()

  fmt.Println(user)
  fmt.Println(orders)
  fmt.Println(products)
}
整体流程如下:
这是一个非常典型的 并发聚合(Fan-out / Fan-in) 场景
Mutex:给共享数据加锁
Go 提供了互斥锁 sync.Mutex,用来保证同一时间只有一个 Goroutine 可以访问共享数据,从而避免并发数据竞争。
例如:
go
var mu sync.Mutex
count := 0

for i := 0; i < 1000; i++ {
  go func() {
    mu.Lock()

    count++

    mu.Unlock()
  }()
}
可以理解成:
text
            count
              ↑
              │
      ┌───────┴───────┐
      │     Mutex     │
      └───────────────┘
              ↑
       同一时间只允许
       一个 Goroutine 修改
Mutex 解决了大家同时修改同一个数据时,数据竞争的问题。
Select:同时等待多个 Channel
select 用来同时监听多个 Channel,哪个 Channel 先就绪,就执行对应的分支。
例如:
go
select {
case result := <-ch1:
  fmt.Println(result)

case result := <-ch2:
  fmt.Println(result)
}
ch1 和 ch2 都是 Channel,select 会同时监听这两个 Channel,哪个先有数据,就执行对应的分支。
就像你同时等两个快递:
text
快递 A ──┐
         ├── 谁先到处理谁
快递 B ──┘
这在超时控制中尤其有用。
Context:Goroutine 的"遥控器"
context.Context 可以在一条调用链(请求)内的多个 Goroutine 之间传递取消信号、超时/截止时间(以及少量请求级数据),让上游一取消或超时,下游所有 Goroutine 都能收到信号及时收工,从而避免它们偷偷跑下去、造成 Goroutine 泄漏。
context.Context 的特性在 Go Web 开发中特别重要。
例如一个 HTTP 请求:
text
用户
 ↓
HTTP Request
 ↓
Controller
 ↓
Service
 ↓
Goroutine
 ↓
数据库
如果用户把请求取消了:
text
用户取消
   ↓
HTTP Request 取消
   ↓
Context 取消
   ↓
Goroutine 收到信号
   ↓
停止任务
代码:
go
func worker(ctx context.Context) {
  for {
    select {
    case <-ctx.Done():
      fmt.Println("任务取消")
      return

    default:
      // 执行任务
    }
  }
}
可以将 context.Context 看作是Goroutine 的遥控器 ,将取消信号由上往下传递给 Goroutine 。
Worker Pool:不要无限创建 Goroutine
虽然 Goroutine 和操作系统线程相比非常轻。但是也不代表 Goroutine 可以无限创建。如果 CPU、锁、数据库连接等资源成为瓶颈,增加并发反而可能让程序变慢。因此需要限制系统 Goroutine 数量。
假设有:
text
10000 个任务我们并不一定需要:
text
10000 个 Goroutine可以建立:
text
任务队列
   ↓
┌───────────────┐
│   Worker 1    │
│   Worker 2    │
│   Worker 3    │
│   Worker 4    │
│   Worker 5    │
└───────────────┘
   ↓
执行任务
例如:
go
jobs := make(chan int)

for i := 0; i < 5; i++ {
  go worker(jobs)
}
这里我们只启动:
text
5 个 Worker然后让 5 个 Worker 消费:
text
10000 个任务这就是 Worker Pool(工作池) ,其核心思想就是限制并发数量,让系统保持在可控范围内。
这是 Worker Pool(工作池) 完整的代码示例:
go
// workerpool 是最小可用的 Worker Pool:5 个常驻 worker 消费同一条任务队列,
// 并发上限恒为 5,不会因为任务变多而无限开 goroutine。
package main

import (
  "fmt"
  "sync"
)

const (
  workerCount = 5  // 并发上限
  taskCount   = 20 // 任务总数
)

// worker 从 jobs 取任务;jobs 被 close 且排空后 range 结束,自动退出。
func worker(id int, jobs <-chan int) {
  for job := range jobs {
    fmt.Printf("worker %d 处理任务 %d\n", id, job)
  }
}

func main() {
  jobs := make(chan int)

  // ① 启动固定数量的 worker ------ 并发上限就是 workerCount
  var wg sync.WaitGroup
  for i := 1; i <= workerCount; i++ {
    wg.Add(1) // Add 必须在 go 之前
    go func(id int) {
      defer wg.Done()
      worker(id, jobs)
    }(i)
  }

  // ② 投递任务;投完由发送方关闭队列
  for i := 1; i <= taskCount; i++ {
    jobs <- i
  }
  close(jobs)

  // ③ 等所有 worker 退出
  wg.Wait()

  fmt.Println("所有任务处理完成")
}
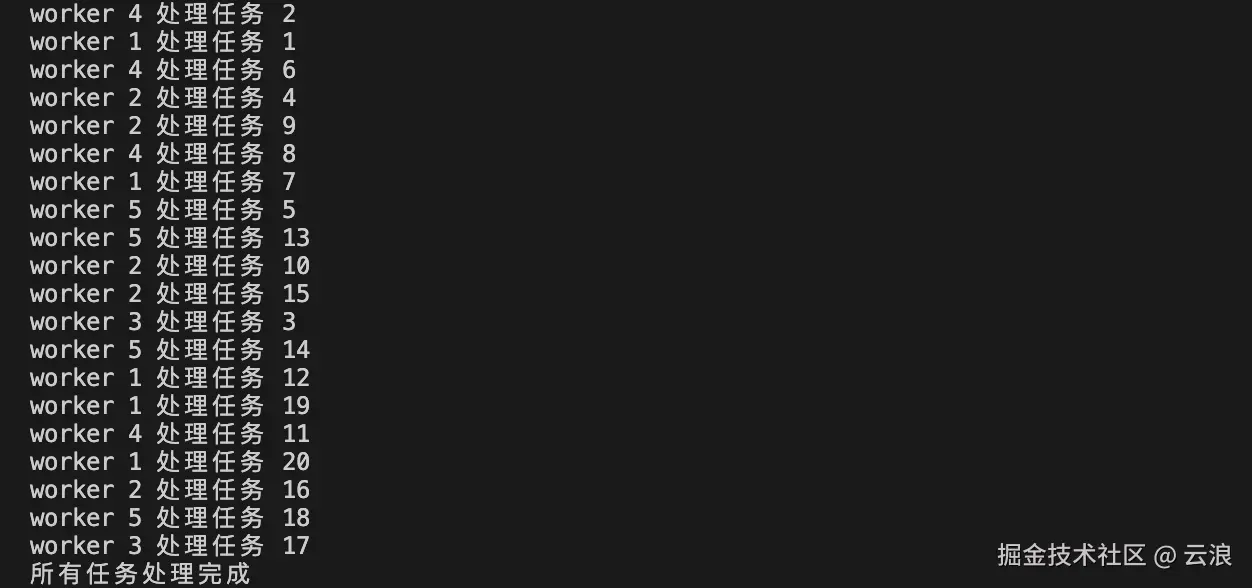
上面代码中 20 个任务由 5 个 worker 抢着处理:谁空闲谁接手,所以输出顺序是乱的、各 worker 的处理量也不均匀 ------ 这正是并发的表现。
运行结果:
Go 并发常见的 9 个坑
坑 1:以为 go 会等待任务
很多初学者第一次写 Goroutine 时最容易产生的误解。
下面代码:
go
go task()
fmt.Println("完成")
并不意味着:
text
task 完成
   ↓
打印 完成
而是启动 task 后立即继续后面的打印语句:
text
启动 task
   ↓
立即继续
   ↓
打印 完成
go task() 不会自动等待,通常要使用 sync.WaitGroup 控制 Goroutine 的执行。
坑 2:WaitGroup 的 Add 放错位置
错误代码:
go
go func() {
  wg.Add(1)
  defer wg.Done()

  task()
}()

wg.Wait()
为什么危险?
因为主 Goroutine 可能先执行:
go
wg.Wait()此时:
text
wg 计数 = 0于是 Wait() 可能直接返回。
正确方式:
go
wg.Add(1)

go func() {
  defer wg.Done()

  task()
}()

wg.Wait()
Add() 应该在启动 Goroutine 前完成。
坑 3:认为 Goroutine 越多越快
这是一个非常危险的想法:
go
go task1()
go task2()
go task3()
go task4()
go task5()
并不是 Goroutine 越多越好。
因为程序真正消耗的是:
text
CPU
内存
网络连接
数据库连接
文件句柄
锁
下游服务容量
例如数据库连接池只有:
text
100你突然启动:
text
10000 个 Goroutine并不会让数据库瞬间拥有 10000 个连接。
反而可能导致:
text
大量任务
   ↓
争抢有限资源
   ↓
排队
   ↓
上下文切换 / 超时
   ↓
整体性能下降
Goroutine 是轻量级的,但并不意味着它是免费的。
可以使用 Worker Pool 限制 Goroutine 的数量。
坑 4:Channel 接收会阻塞
go
value := <-chchannel 里没有数据时,接收操作 <-ch 会阻塞当前 goroutine ,一直等到有别的 goroutine 往里面发数据,才继续往下执行。
如下面示例代码:
go
package main

import (
  "fmt"
  "time"
)

func main() {
  ch := make(chan string)

  // 另一个 goroutine 负责「1 秒之后」再发送数据
  go func() {
    fmt.Println("goroutine:先干活 1 秒,再发送数据")
    time.Sleep(time.Second)
    ch <- "数据来了"
  }()

  start := time.Now()
  fmt.Println("main:准备执行 <-ch(此刻 channel 里没有数据)")

  msg := <-ch // ← 阻塞点:main 会卡在这里,直到上面的 goroutine 把数据放进来

  fmt.Printf("main:收到 %q,一共等了 %v\n", msg, time.Since(start).Round(10*time.Millisecond))
  fmt.Println("main:等了 1 秒说明 <-ch 确实把 main 阻塞住了,不是立刻返回空值")
}
如果没有任何 Goroutine 往里面发送数据,当前 Goroutine 会一直等待。
这也是 Go 初学者非常容易遇到的问题。
坑 5:Channel 关闭后还继续发送
例如:
go
close(ch)

ch <- 100
会直接 panic。
所以通常由:
发送方负责关闭 Channel。
而接收方可以:
go
for value := range ch {
  fmt.Println(value)
}
直到 Channel 被关闭。
坑 6:忽略闭包和循环变量
JavaScript 开发者对闭包应该很熟悉。
Go 中也有闭包。
例如:
go
for i := 0; i < 5; i++ {
  go func() {
    fmt.Println(i)
  }()
}
这里涉及一个非常经典的循环变量捕获问题。
现代 Go 版本已经对 for 循环变量语义进行了改进,但在阅读旧代码、维护旧项目或涉及不同循环写法时,仍然需要理解:
Goroutine 是异步执行的,而闭包捕获的是变量,而不是简单地复制你脑海里的"当前值"。
更稳妥、也更容易理解的写法是显式传参:
go
for i := 0; i < 5; i++ {
  go func(id int) {
    fmt.Println(id)
  }(i)
}
这样 id 就明确表示:这一次 Goroutine 对应的值。
坑 7:多个 Goroutine 修改共享变量
看代码:
go
count := 0

for i := 0; i < 1000; i++ {
  go func() {
    count++
  }()
}
你可能觉得:
text
count 最终应该是 1000但并发环境下并不一定。
因为:
go
count++实际上包含多个步骤:
text
读取 count
   ↓
加 1
   ↓
写回 count
多个 Goroutine 同时操作,就可能发生:
text
Goroutine A:读取 10
Goroutine B:读取 10

A:11
B:11

最终:11
而不是:
text
12这就是: 数据竞争(Data Race)
当涉及到多个 Goroutine 修改共享变量的场景,可以使用 sync.Mutex 给共享数据加锁,避免数据竞争的问题。
坑 8:以为 Channel 可以解决所有并发问题
Channel 很强大,但不是万能的。
例如:
text
共享状态保护使用 Mutex 往往更直接。
而:
text
多个任务之间传递结果Channel 通常更自然。
可以简单这样理解:
| 问题 | 常见工具 |
|---|---|
| 启动并发任务 | Goroutine |
| 等待任务完成 | WaitGroup |
| Goroutine 之间传数据 | Channel |
| 保护共享变量 | Mutex |
| 取消任务 | Context |
| 多个 Channel 等待 | select |
坑 9:Goroutine 泄漏
这是从"会写 Goroutine"走向"会写生产级 Go 程序"的分水岭。 例如:
go
func worker(ch chan string) {
  for {
    data := <-ch

    fmt.Println(data)
  }
}
如果:
text
ch 永远没有数据那么这个 Goroutine:
text
一直等待
   ↓
永远不退出
如果这样的 Goroutine 越来越多:
text
100 个
1000 个
10000 个
最终就可能成为系统问题。
更合理的方式是结合 Context:
go
func worker(
  ctx context.Context,
  ch <-chan string,
) {
  for {
    select {
    case <-ctx.Done():
      return

    case data := <-ch:
      fmt.Println(data)
    }
  }
}
现在:
text
Context Cancel
      ↓
ctx.Done()
      ↓
worker return
      ↓
Goroutine 退出这是生产环境中非常重要的:生命周期管理。 启动 Goroutine 的时候,同时思考它什么时候退出。
总结
Goroutine 是 Go 并发编程的核心,它让我们可以用非常低的成本同时执行多个任务。
但真正掌握 Goroutine,并不是简单地在函数前面加一个 go,更重要的是理解 如何启动、等待、通信、控制和退出 Goroutine。
这篇文章主要学习了:
- Goroutine :用
go关键字启动并发任务。 - WaitGroup:等待一组 Goroutine 执行完成。
- Channel:实现 Goroutine 之间的数据传递。
- Mutex:保护共享数据,避免数据竞争。
- Select:同时等待多个 Channel,并处理超时等场景。
- Context:向 Goroutine 传递取消、超时等信号,管理 Goroutine 生命周期。
- Worker Pool:限制并发数量,避免无限创建 Goroutine。
同时,我们还总结了 Go 并发开发中非常容易踩到的 9 个坑,包括:
go不会等待任务、WaitGroup.Add使用不当、Goroutine 并不是越多越快、Channel 阻塞、错误关闭 Channel、闭包与循环变量、共享变量数据竞争、误以为 Channel 能解决所有并发问题,以及 Goroutine 泄漏。
可以记住下面这张 Go 并发工具地图:
| 需求 | 常用工具 |
|---|---|
| 启动并发任务 | Goroutine |
| 等待任务完成 | WaitGroup |
| Goroutine 之间传递数据 | Channel |
| 保护共享变量 | Mutex |
| 同时等待多个 Channel | Select |
| 取消/超时控制 | Context |
| 限制并发数量 | Worker Pool |
Goroutine 很轻量,但并发编程并不简单。
写下 go 只是开始,真正的生产级 Go 并发编程,还需要关注 任务同步、数据通信、资源竞争、并发控制以及 Goroutine 的生命周期管理。
尤其要记住一句话:
启动 Goroutine 的时候,也要同时思考:它什么时候退出?
这也是从"会写 Goroutine"走向"会写生产级 Go 程序"的关键一步。