本节内容将在第 4.1.3 节创建的 HelloAgentsLLM 基础上进行迭代升级。我们将把这个基础客户端,改造为一个更具适应性的模型调用中枢。本次升级主要围绕以下三个目标展开:
- 多提供商支持:实现对 OpenAI、ModelScope、智谱 AI 等多种主流 LLM 服务商的无缝切换,避免框架与特定供应商绑定。
- 本地模型集成:引入 VLLM 和 Ollama 这两种高性能本地部署方案,作为对第 3.2.3 节中 Hugging Face Transformers 方案的生产级补充,满足数据隐私和成本控制的需求。
- 自动检测机制:建立一套自动识别机制,使框架能根据环境信息智能推断所使用的 LLM 服务类型,简化用户的配置过程。
7.2.1支持多提供商
我们之前定义的 HelloAgentsLLM 类,已经能够通过 api_key 和 base_url 这两个核心参数,连接任何兼容 OpenAI 接口的服务。这在理论上保证了通用性,但在实际应用中,不同的服务商在环境变量命名、默认 API 地址和推荐模型等方面都存在差异。如果每次切换服务商都需要用户手动查询并修改代码,会极大影响开发效率。为了解决这一问题,我们引入 provider。其改进思路是:让 HelloAgentsLLM 在内部处理不同服务商的配置细节,从而为用户提供一个统一、简洁的调用体验。具体的实现细节我们将在7.2.3节"自动检测机制"中详细阐述,在这里,我们首先关注如何利用这一机制来扩展框架。
下面,我们将演示如何通过继承 HelloAgentsLLM,来增加对 ModelScope 平台的支持。我们希望读者不仅学会如何"使用"框架,更能掌握如何"扩展"框架。直接修改已安装的库源码是一种不被推荐的做法,因为它会使后续的库升级变得困难。
(1)创建自定义LLM类并继承
假设我们的项目目录中有一个 my_llm.py 文件。我们首先从 hello_agents 库中导入 HelloAgentsLLM 基类,然后创建一个名为 MyLLM 的新类继承它。
python
# my_llm.py
import os
from typing import Optional
from openai import OpenAI
from hello_agents import HelloAgentsLLM

class MyLLM(HelloAgentsLLM):
    """
    一个自定义的LLM客户端,通过继承增加了对ModelScope的支持。
    """
    pass # 暂时留空复制到剪贴板错误已复制
(2)重写 __init__ 方法以支持新供应商
接下来,我们在 MyLLM 类中重写 __init__ 方法。我们的目标是:当用户传入 provider="modelscope" 时,执行我们自定义的逻辑;否则,就调用父类 HelloAgentsLLM 的原始逻辑,使其能够继续支持 OpenAI 等其他内置的供应商。
python
class MyLLM(HelloAgentsLLM):
    def __init__(
        self,
        model: Optional[str] = None,
        api_key: Optional[str] = None,
        base_url: Optional[str] = None,
        provider: Optional[str] = "auto",
        **kwargs
    ):
        # 检查provider是否为我们想处理的'modelscope'
        if provider == "modelscope":
            print("正在使用自定义的 ModelScope Provider")
            self.provider = "modelscope"

            # 解析 ModelScope 的凭证
            self.api_key = api_key or os.getenv("MODELSCOPE_API_KEY")
            self.base_url = base_url or "https://api-inference.modelscope.cn/v1/"

            # 验证凭证是否存在
            if not self.api_key:
                raise ValueError("ModelScope API key not found. Please set MODELSCOPE_API_KEY environment variable.")

            # 设置默认模型和其他参数
            self.model = model or os.getenv("LLM_MODEL_ID") or "Qwen/Qwen2.5-VL-72B-Instruct"
            self.temperature = kwargs.get('temperature', 0.7)
            self.max_tokens = kwargs.get('max_tokens')
            self.timeout = kwargs.get('timeout', 60)

            # 使用获取的参数创建OpenAI客户端实例
            self._client = OpenAI(api_key=self.api_key, base_url=self.base_url, timeout=self.timeout)

        else:
            # 如果不是 modelscope, 则完全使用父类的原始逻辑来处理
            super().__init__(model=model, api_key=api_key, base_url=base_url, provider=provider, **kwargs)
复制到剪贴板错误已复制
这段代码展示了"重写"的思想:我们拦截了 provider="modelscope" 的情况并进行了特殊处理,对于其他所有情况,则通过 super().__init__(...) 交还给父类,保留了原有框架的全部功能。
(3)使用自定义的 MyLLM 类
现在,我们可以在项目的业务逻辑中,像使用原生 HelloAgentsLLM 一样使用我们自己的 MyLLM 类。
首先,在 .env 文件中配置 ModelScope 的 API 密钥:
ini
# .env file
MODELSCOPE_API_KEY="your-modelscope-api-key"复制到剪贴板错误已复制
然后,在主程序中导入并使用 MyLLM:
python
# my_main.py
from dotenv import load_dotenv
from my_llm import MyLLM # 注意:这里导入我们自己的类

# 加载环境变量
load_dotenv()

# 实例化我们重写的客户端,并指定provider
llm = MyLLM(provider="modelscope")

# 准备消息
messages = [{"role": "user", "content": "你好,请介绍一下你自己。"}]

# 发起调用,think等方法都已从父类继承,无需重写
response_stream = llm.think(messages)

# 打印响应
print("ModelScope Response:")
for chunk in response_stream:
    # chunk在my_llm库中已经打印过一遍,这里只需要pass即可
    # print(chunk, end="", flush=True)
    pass复制到剪贴板错误已复制
通过以上步骤,我们就在不修改 hello-agents 库源码的前提下,成功为其扩展了新的功能。这种方法不仅保证了代码的整洁和可维护性,也使得未来升级 hello-agents 库时,我们的定制化功能不会丢失。
7.2.2本地模型应用
在第 3.2.3 节,我们学习了如何使用 Hugging Face Transformers 库在本地直接运行开源模型。该方法非常适合入门学习和功能验证,但其底层实现在处理高并发请求时性能有限,通常不作为生产环境的首选方案。
为了在本地实现高性能、生产级的模型推理服务,社区涌现出了VLLM 和Ollama 等优秀工具。它们通过连续批处理、PagedAttention 等技术,显着提升了模型的吞吐量和运行效率,并将模型封装为兼容OpenAI 标准的API 服务。这意味着,我们可以将它们无缝地集成到HelloAgentsLLM中。
VLLM
VLLM 是一个为 LLM 推理设计的高性能 Python 库。它通过 PagedAttention 等先进技术,可以实现比标准 Transformers 实现高出数倍的吞吐量。下面是在本地部署一个 VLLM 服务的完整步骤:
首先,需要根据你的硬件环境(特别是 CUDA 版本)安装 VLLM。推荐遵循其官方文档进行安装,以避免版本不匹配问题。
pip install vllm复制到剪贴板错误已复制安装完成后,使用以下命令即可启动一个兼容 OpenAI 的 API 服务。VLLM 会自动从 Hugging Face Hub 下载指定的模型权重(如果本地不存在)。我们依然以 Qwen1.5-0.5B-Chat 模型为例:
css
# 启动 VLLM 服务,并加载 Qwen1.5-0.5B-Chat 模型
python -m vllm.entrypoints.openai.api_server \
    --model Qwen/Qwen1.5-0.5B-Chat \
    --host 0.0.0.0 \
    --port 8000复制到剪贴板错误已复制
服务启动后,便会在 http://localhost:8000/v1 地址上提供与 OpenAI 兼容的 API。
成为
Ollama 进一步简化了本地模型的管理和部署,它将模型下载、配置和服务启动等步骤封装到了一条命令中,非常适合快速上手。访问 Ollama 官方网站下载并安装适用于你操作系统的客户端。
安装后,打开终端,执行以下命令即可下载并运行一个模型(以 Llama 3 为例)。Ollama 会自动处理模型的下载、服务封装和硬件加速配置。
arduino
# 首次运行会自动下载模型,之后会直接启动服务
ollama run llama3复制到剪贴板错误已复制
当你在终端看到模型的交互提示时,即表示服务已经成功在后台启动。Ollama 默认会在 http://localhost:11434/v1 地址上暴露 OpenAI 兼容的 API 接口。
接入 HelloAgentsLLM
由于 VLLM 和 Ollama 都遵循了行业标准 API,将它们接入 HelloAgentsLLM 的过程非常简单。我们只需在实例化客户端时,将它们视为一个新的 provider 即可。
例如,连接本地运行的 VLLM 服务:
ini
llm_client = HelloAgentsLLM(
    provider="vllm",
    model="Qwen/Qwen1.5-0.5B-Chat", # 需与服务启动时指定的模型一致
    base_url="http://localhost:8000/v1",
    api_key="vllm" # 本地服务通常不需要真实API Key,可填任意非空字符串
)复制到剪贴板错误已复制
或者,通过设置环境变量并让客户端自动检测,实现代码的零修改:
ini
# 在 .env 文件中设置
LLM_BASE_URL="http://localhost:8000/v1"
LLM_API_KEY="vllm"

# Python 代码中直接实例化即可
llm_client = HelloAgentsLLM() # 将自动检测为 vllm复制到剪贴板错误已复制
同理,连接本地的 Ollama 服务也一样简单:
ini
llm_client = HelloAgentsLLM(
    provider="ollama",
    model="llama3", # 需与 `ollama run` 指定的模型一致
    base_url="http://localhost:11434/v1",
    api_key="ollama" # 本地服务同样不需要真实 Key
)复制到剪贴板错误已复制
通过这种统一的设计,我们的智能体核心代码无需任何修改,就可以在云端 API 和本地模型之间自由切换。这为后续应用的开发、部署、成本控制以及保护数据隐私提供了极大的灵活性。
7.2.3自动检测机制
为了尽可能减少用户的配置负担并遵循"约定优于配置"的原则,HelloAgentsLLM 内部设计了两个核心辅助方法:_auto_detect_provider 和 _resolve_credentials。它们协同工作,_auto_detect_provider 负责根据环境信息推断服务商,而 _resolve_credentials 则根据推断结果完成具体的参数配置。
_auto_detect_provider 方法负责根据环境信息,按照下述优先级顺序,尝试自动推断服务商:
-
最高优先级:检查特定服务商的环境变量 这是最直接、最可靠的判断依据。框架会依次检查
MODELSCOPE_API_KEY,OPENAI_API_KEY,ZHIPU_API_KEY等环境变量是否存在。一旦发现任何一个,就会立即确定对应的服务商。 -
次高优先级:根据
base_url进行判断 如果用户没有设置特定服务商的密钥,但设置了通用的LLM_BASE_URL,框架会转而解析这个 URL。- 域名匹配 :通过检查 URL 中是否包含
"api-inference.modelscope.cn","api.openai.com"等特征字符串来识别云服务商。 - 端口匹配 :通过检查 URL 中是否包含
:11434(Ollama),:8000(VLLM) 等本地服务的标准端口来识别本地部署方案。
- 域名匹配 :通过检查 URL 中是否包含
-
辅助判断:分析 API 密钥的格式 在某些情况下,如果上述两种方式都无法确定,框架会尝试分析通用环境变量
LLM_API_KEY的格式。例如,某些服务商的 API 密钥有固定的前缀或独特的编码格式。不过,由于这种方式可能存在模糊性(例如多个服务商的密钥格式相似),因此它的优先级较低,仅作为辅助手段。
其部分关键代码如下:
python
def _auto_detect_provider(self, api_key: Optional[str], base_url: Optional[str]) -> str:
    """
    自动检测LLM提供商
    """
    # 1. 检查特定提供商的环境变量 (最高优先级)
    if os.getenv("MODELSCOPE_API_KEY"): return "modelscope"
    if os.getenv("OPENAI_API_KEY"): return "openai"
    if os.getenv("ZHIPU_API_KEY"): return "zhipu"
    # ... 其他服务商的环境变量检查

    # 获取通用的环境变量
    actual_api_key = api_key or os.getenv("LLM_API_KEY")
    actual_base_url = base_url or os.getenv("LLM_BASE_URL")

    # 2. 根据 base_url 判断
    if actual_base_url:
        base_url_lower = actual_base_url.lower()
        if "api-inference.modelscope.cn" in base_url_lower: return "modelscope"
        if "open.bigmodel.cn" in base_url_lower: return "zhipu"
        if "localhost" in base_url_lower or "127.0.0.1" in base_url_lower:
            if ":11434" in base_url_lower: return "ollama"
            if ":8000" in base_url_lower: return "vllm"
            return "local" # 其他本地端口

    # 3. 根据 API 密钥格式辅助判断
    if actual_api_key:
        if actual_api_key.startswith("ms-"): return "modelscope"
        # ... 其他密钥格式判断

    # 4. 默认返回 'auto',使用通用配置
    return "auto"复制到剪贴板错误已复制
一旦 provider 被确定(无论是用户指定还是自动检测),_resolve_credentials 方法便会接手处理服务商的差异化配置。它会根据 provider 的值,去主动查找对应的环境变量,并为其设置默认的 base_url。其部分关键实现如下:
python
def _resolve_credentials(self, api_key: Optional[str], base_url: Optional[str]) -> tuple[str, str]:
    """根据provider解析API密钥和base_url"""
    if self.provider == "openai":
        resolved_api_key = api_key or os.getenv("OPENAI_API_KEY") or os.getenv("LLM_API_KEY")
        resolved_base_url = base_url or os.getenv("LLM_BASE_URL") or "https://api.openai.com/v1"
        return resolved_api_key, resolved_base_url

    elif self.provider == "modelscope":
        resolved_api_key = api_key or os.getenv("MODELSCOPE_API_KEY") or os.getenv("LLM_API_KEY")
        resolved_base_url = base_url or os.getenv("LLM_BASE_URL") or "https://api-inference.modelscope.cn/v1/"
        return resolved_api_key, resolved_base_url

    # ... 其他服务商的逻辑复制到剪贴板错误已复制
让我们通过一个简单的例子来感受自动检测带来的便利。假设一个用户想要使用本地的 Ollama 服务,他只需在 .env 文件中进行如下配置:
ini
LLM_BASE_URL="http://localhost:11434/v1"
LLM_MODEL_ID="llama3"复制到剪贴板错误已复制
他完全不需要配置 LLM_API_KEY 或在代码中指定 provider。然后,在 Python 代码中,他只需简单地实例化 HelloAgentsLLM 即可:
ini
from dotenv import load_dotenv
from hello_agents import HelloAgentsLLM

load_dotenv()

# 无需传入 provider,框架会自动检测
llm = HelloAgentsLLM()
# 框架内部日志会显示检测到 provider 为 'ollama'

# 后续调用方式完全不变
messages = [{"role": "user", "content": "你好!"}]
for chunk in llm.think(messages):
    print(chunk, end="")
复制到剪贴板错误已复制在这个过程中,_auto_detect_provider 方法通过解析 LLM_BASE_URL 中的 "localhost" 和 :11434,成功地将 provider 推断为 "ollama"。随后,_resolve_credentials 方法会为 Ollama 设置正确的默认参数。
相比于4.1.3节的基础实现,现在的HelloAgentsLLM具有以下显着优势:
表 7.1 HelloAgentLLM不同版本特性对比
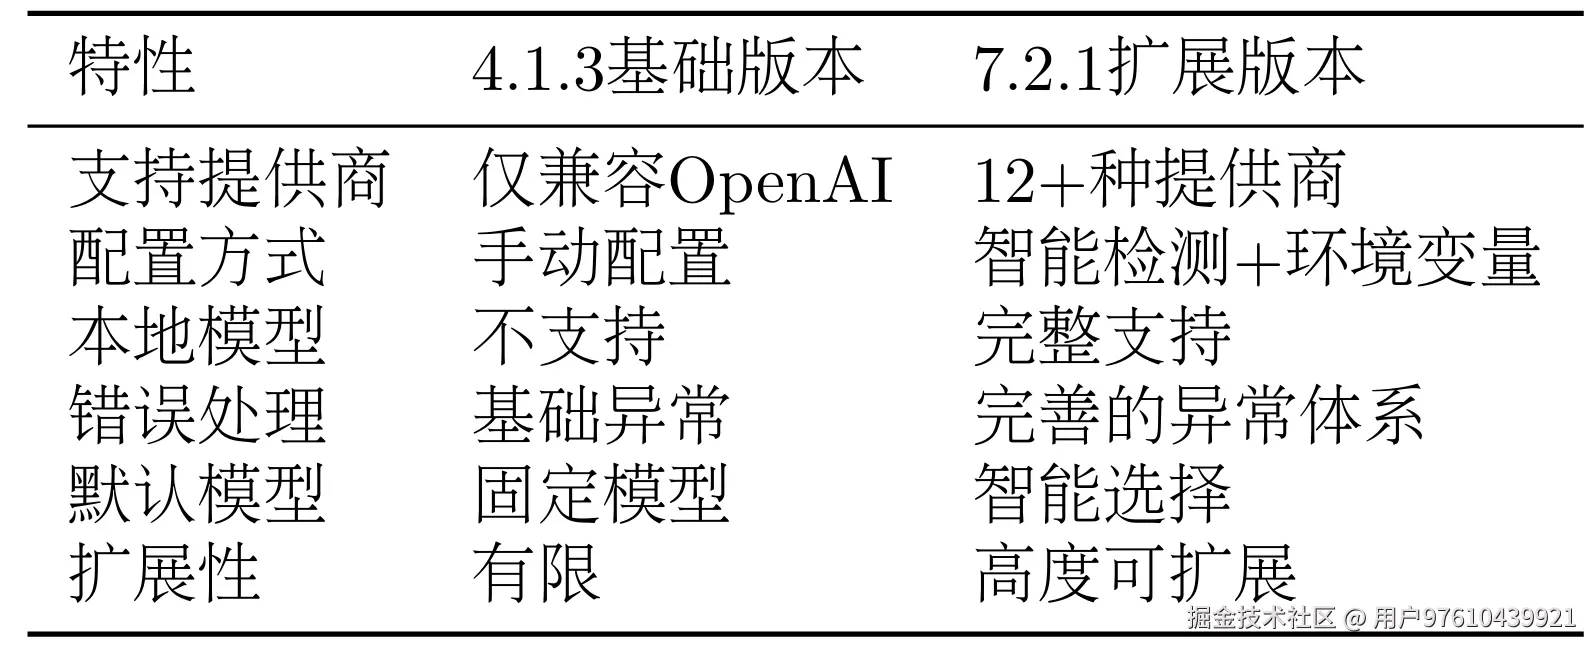
如上表7.1所示,这种演进体现了框架设计的重要原则:从简单开始,逐步完善。我们在保持接口简洁的同时,增强了功能的完整性。