Rust 的内存管理乍看有些复杂。但理解所有权、借用和生命周期之后,你会发现,几乎所有规则都围绕着同一个思路:在程序运行之前,由编译器证明你的内存使用是安全的。
当然了,作为开发者,你需要写出符合这些规则的代码,让编译器能够验证你的内存使用是安全的。
内存管理是每门编程语言都要解决的问题。
创建的数据需要有地方存放。不再需要时,它占用的内存最终需要回收。这里不只是"如何分配内存"的问题,更难的是:
这份数据由谁负责?到底什么时候才能安全地释放它?
不同语言给出的答案很不一样。
C 把控制权直接交给你。Java、Go 这类带垃圾回收的语言,由运行时系统管理不可达的对象。
Rust 则采用另一种方式:通过所有权、借用和生命周期,在编译期检查内存安全规则,不需要依赖垃圾回收器。
这也是刚学 Rust 时,会觉得它有些特别、有些难以理解的主要原因之一。
开始之前,我们先回顾一下三种内存管理手段。
内存管理的三种常见方式
假设你在应用中创建了一个对象,过了一段时间,不再使用它。
对于这块内存,编程语言通常有三种处理方式。
1. 手动管理内存
在 C 中,程序员需要显式分配和释放内存。
大致像这样:
c
char *data = malloc(100);
/* use data */
free(data);
好处是控制权在自己手里,问题是,你必须把生命周期处理正确。一旦忘记调用 free(),可能造成内存泄漏。
释放得太早,可能访问到已经失效的内存。释放两次,又是一个严重的 bug。
对于普通 C 代码,编译器通常无法替你挡住所有这些错误。
2. 垃圾回收
带垃圾回收器的语言,把这部分责任从程序员手里接了过去。
你不必逐个显式释放对象。运行时会追踪哪些对象仍然可达,并在之后回收不再需要的内存。
这让编程更轻松,但垃圾回收本身也需要在运行时做事:追踪内存,定期清理。
现代垃圾回收器可以很复杂,也很高效,不能简单理解成"让整个应用停下来"。不过,垃圾回收依然是一种运行时内存管理策略。
3. Rust 的所有权模型
Rust 走了另一条路。
它通过编译期规则,确定数据归谁所有、谁可以借用,以及引用可以在多长时间内保持有效,而不是等运行时垃圾回收器来判断内存是否还在使用。
因此,许多内存安全问题在程序执行之前就能被拦下来。
这就引出了 Rust 的核心概念:所有权。
所有权
在 Rust 通常的所有权模型中,每个值都有一个所有者。
来看一个简单的例子:
rust
fn main() {
    let name = String::from("Rust");
}
变量 name 拥有这个 String。
String 可以把数据存放在堆上,这个例子就涉及动态分配的内存。当 name 离开作用域时,Rust 的析构规则会清理这个值。Rust 把这个过程叫作 drop,也就是销毁一个值。
通常,你不需要手动写:
text
free(name);也不需要垃圾回收器之后再来扫描堆。
在这个例子里,所有者的存续时间决定了值何时被销毁。
可以这样理解:
text
name owns String
      ↓
scope ends
      ↓
String is dropped
      ↓
resources are released
这是理解 Rust 时最重要的思路之一。
Rust 并没有消除内存管理
这里需要分清一件事。
Rust 并没有让内存管理消失,而是改变了由谁来证明内存管理规则是正确的。
手动管理内存时,程序员说:
相信我,我会正确释放这块内存。
带垃圾回收的语言里,运行时说:
我会追踪对象,回收那些已经不可达的对象。
而 Rust 的说法更接近:
先在编译期证明你的所有权和引用是有效的,生成的程序就可以按这些规则执行,不需要全局垃圾回收器。
这背后的思路差别很大。
所有权移动时,会发生什么?
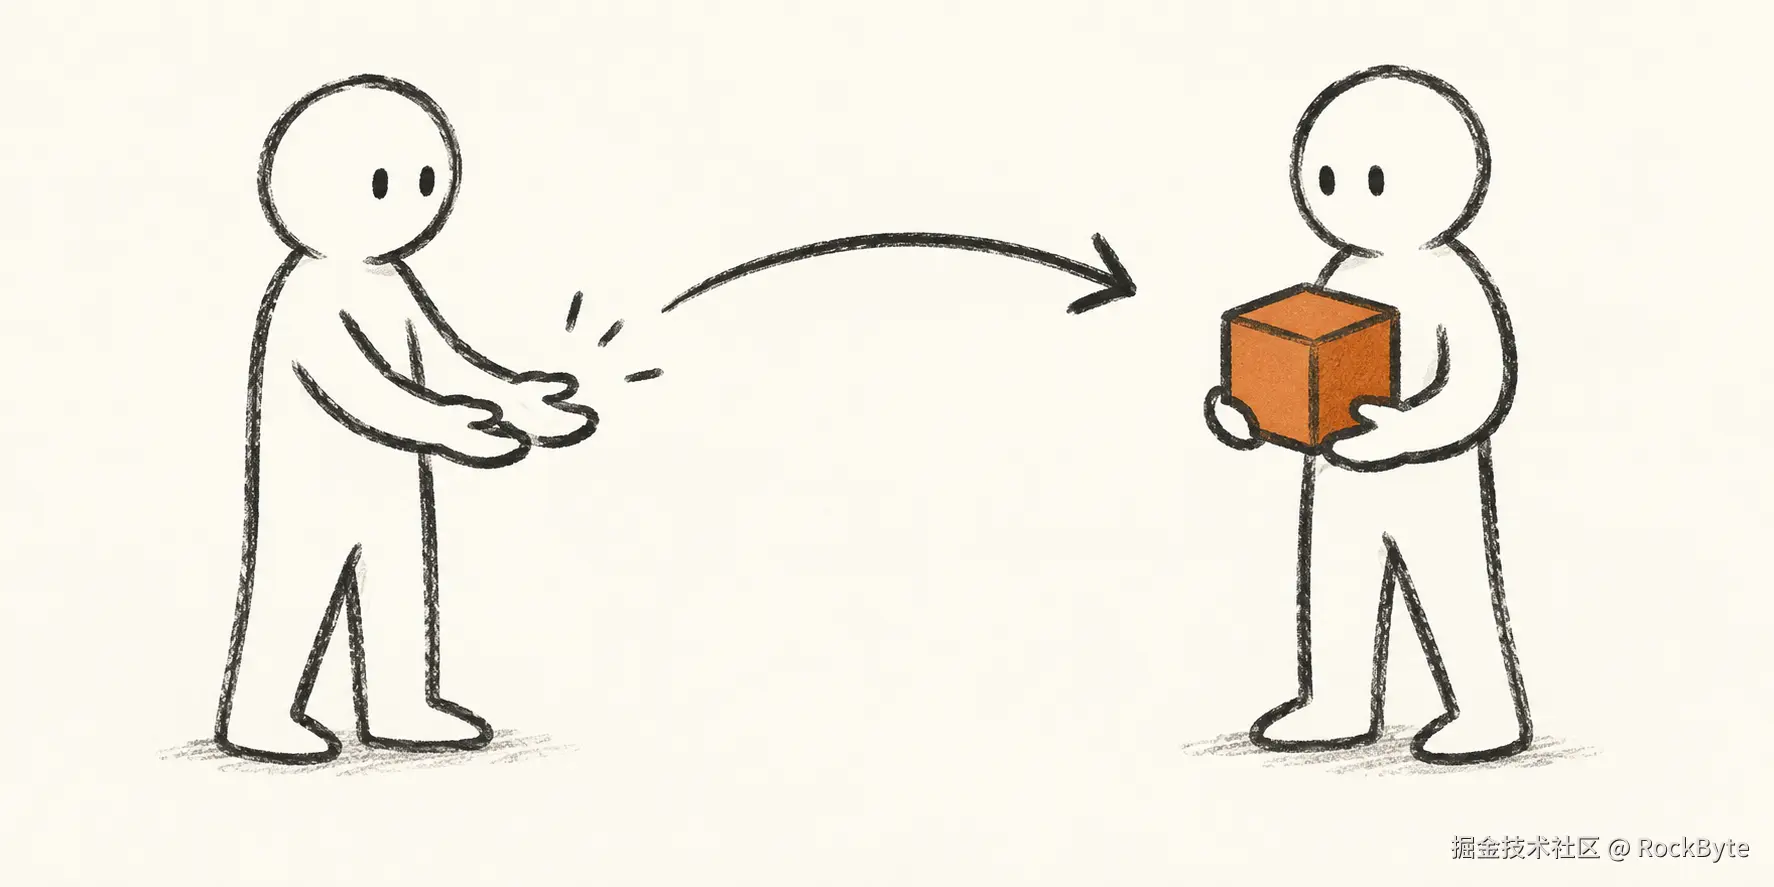
当你在变量或函数之间传递值时,所有权模型就更有意思了。
看这段代码:
rust
fn main() {
    let first = String::from("Hello");
    let second = first;
    println!("{second}");
}
执行下面这行之后:
rust
let second = first;String 的所有权从 first 移动到了 second。
因此,下面的写法是不合法的:
rust
fn main() {
    let first = String::from("Hello");
    let second = first;
    println!("{first}");
}
编译器会拒绝这段代码,因为 first 已经不再拥有这个值。
如果你之前用的是 JavaScript、Java、Python 这类语言,可能会觉得奇怪。
但 Rust 这样做是有原因的。
如果两个普通变量都可以认为自己拥有同一块堆内存,Rust 就需要另一套机制,判断到底由谁负责释放它。
所有权给出了一个更简单的规则:只有一个所有者。
所有权移动之后,原来的所有者不再负责这个值。Rust 编译器会追踪这种关系,在编译期拒绝无效的使用方式。
移动有什么用
我当然知道,很多开发者刚开始学习 Rust,觉得移动(move)看起来像个烦人的限制。
实际上,它可以避免一整类 bug。
假设一个函数接收了 String 的所有权:
rust
fn process(text: String) {
    println!("{text}");
}
fn main() {
    let message = String::from("Hello");
    process(message);
    // message is no longer available here
}
重点不在于 Rust 想为难你,而在于编译器现在明确知道,程序的哪一部分拥有这个值。
这样就更容易推断内存的生命周期。
借用:使用但不取得所有权
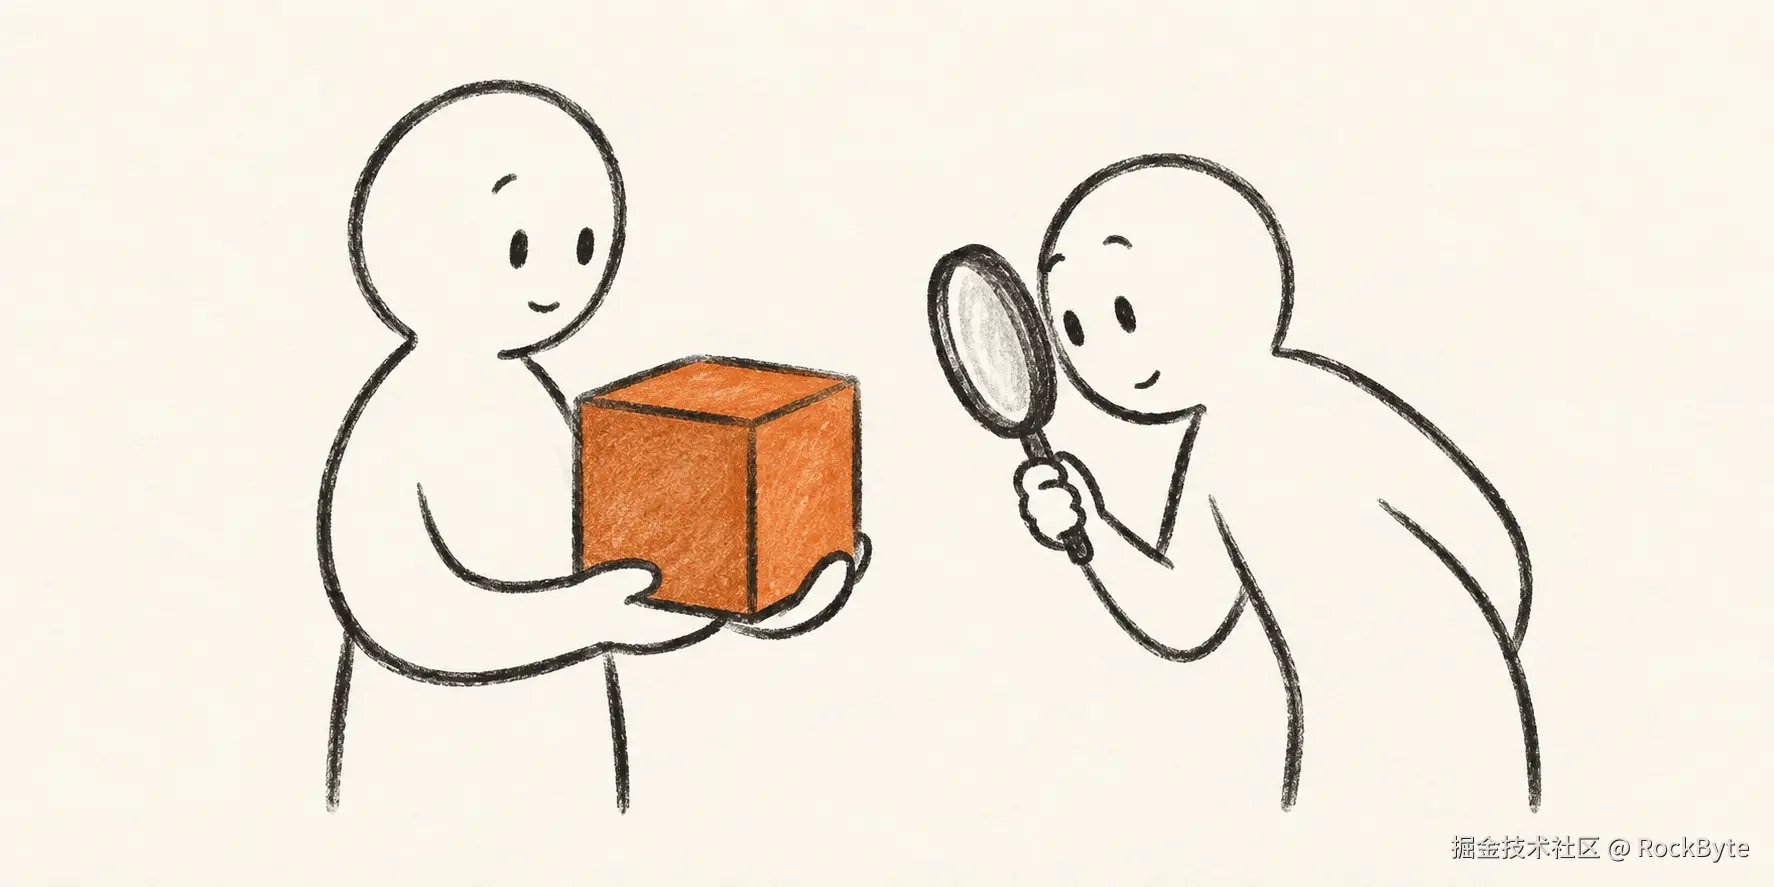
如果每次使用数据都必须转移所有权,Rust 用起来就太不方便了。
好在并不需要,你可以借用一个值。
例如:
rust
fn print_message(message: &String) {
    println!("{message}");
}
fn main() {
    let message = String::from("Hello");
    print_message(&message);
    println!("{message}");
}
函数接收的是字符串的引用,没有取得它的所有权。
原来的变量仍然拥有这份数据。
借用表达的就是这种关系:
text
Owner
  │
  └── String
        ↑
        │
     borrowed reference
函数可以使用数据,但不会成为它的所有者。
Rust 同时支持不可变引用和可变引用。
不可变借用
不可变引用的写法是:
rust
let reference = &value;同一个值可以同时存在多个不可变引用。
例如:
rust
let message = String::from("Hello");
let a = &message;
let b = &message;
println!("{a}");
println!("{b}");
这两个引用都只读取值,没有修改它,所以这种访问是安全的。
可变借用
可变引用的写法是:
rust
let reference = &mut value;例如:
rust
let mut message = String::from("Hello");
let reference = &mut message;
reference.push_str(" Rust");
这里有一条重要限制。
对于同一份数据,在借用的有效范围内,你可以拥有:
- 多个不可变引用;或者
- 一个可变引用。
两者不能以会造成访问冲突的方式同时存在。
这条规则是 Rust 内存安全与安全并发模型的基础之一。
可以把它理解成一个简单的约定,在同一时刻:
text
Many readers
     OR
One writer
两者不能同时发生。
这避免了程序的一部分正在读取数据,另一部分却通过冲突的访问修改同一份数据的情况。
借用检查器
Rust "严格"的名声,很大一部分就来自这里。
**借用检查器(borrow checker)**会在编译时分析所有权和引用。
例如,下面的代码无法通过编译:
rust
let mut value = String::from("hello");
let first = &value;
let second = &mut value;
println!("{first}");
问题在于:程序创建了指向同一个值的可变引用,之后还要使用先前的不可变引用。
Rust 不会等到运行时出了 bug 才处理。
只要代码不满足所有权和借用规则,编译器就不让它通过。
这也是 Rust 设计思路中很重要的一部分:
先阻止不合法的程序通过编译,而不是等进入错误状态后再设法恢复。
引用能有效多久
所有权回答的是:
谁拥有这个值?
借用回答的是:
谁可以暂时使用它?
生命周期回答另一个重要问题:
这个引用能在多长时间内保持有效?
Rust 中的每个引用都有生命周期,也就是引用保持有效的那段范围。许多日常场景下,Rust 可以自动推断,不需要你手动标注。
注意,这里的生命周期针对的是引用!
例如:
rust
fn print_name(name: &str) {
    println!("{name}");
}
这里不需要手写生命周期标注。
但有时,函数会返回一个引用,而它是否有效,取决于多个输入引用之间的关系。
这时,你可能会看到这样的语法:
rust
fn longest<'a>(a: &'a str, b: &'a str) -> &'a str {
    if a.len() > b.len() {
        a
    } else {
        b
    }
}
这里的 'a 并不是说:
"让这个对象恰好存活这么长时间。"
它表达的是引用之间的关系。
在这个函数中,两个输入引用都必须在 'a 内有效,返回的引用也在这个共同的生命周期范围内有效。
Rust 利用这些关系,确保引用不会比它指向的数据活得更久。
Drop 到底做了什么?
你经常会听到:值离开作用域时,Rust 会自动调用 drop()。
这样理解有帮助,但有一个技术细节需要说明。
Rust 提供了 Drop trait,让类型可以定义值被销毁时的清理行为。这里的析构方法是 Drop::drop,与可以手动调用、提前销毁值的 std::mem::drop 函数不同。标准库类型可以利用这套机制,释放堆内存等资源。
例如:
rust
struct Logger;
impl Drop for Logger {
    fn drop(&mut self) {
        println!("Logger is being dropped");
    }
}
接着使用它:
rust
fn main() {
    let logger = Logger;
    println!("Using logger");
}
当 logger 离开作用域时,它的析构逻辑就会执行。
编译器会按照语言规则生成所需的析构行为。优化后的二进制中,具体实现可能被内联,也可能经过其他优化。因此,更准确的理解是,Rust 按语言规则执行相应的析构语义 ,而不是每个作用域末尾都原样放着一次 drop() 函数调用。
解释 Rust 的底层行为时,这个区别很重要。这里讨论的是正常离开作用域的情况,并不意味着析构一定发生;例如,std::mem::forget 可以跳过析构,进程直接终止时也不会正常执行这套清理流程。
如果多个部分都需要所有权呢
到这里,我们讨论的还是简单的所有权模型:
text
one value
   ↓
one owner
但实际程序有时需要共享所有权。
例如,应用中的多个部分都需要访问同一份堆上数据。
对于确实需要多个所有者的场景,Rust 提供了 Rc<T>、Arc<T> 这样的智能指针。
Rc<T>
Rc<T> 中的 Rc 指的是 reference counted,也就是引用计数。
在单线程场景中,它允许同一个值拥有多个所有者。
大致可以这样理解:
text
Owner A ──┐
Owner B ──┼──→ Data
Owner C ──┘
强引用计数会记录还有多少个所有者。
最后一个强引用被销毁时,内部的值也会被销毁。
Arc<T>
Arc<T> 是使用原子引用计数的指针。
它同样提供共享所有权,但计数机制支持跨线程使用。这里的线程安全针对引用计数;要在线程间共享 Arc<T>,T 本身也必须满足 Send 和 Sync 的要求。
关键在于,Rust 不会自动给每个值都套上一层引用计数。
只有设计确实需要共享所有权时,你才显式选择它。
这样既能让所有权关系保持明确,也能支持更复杂的数据共享方式。
Rust 为什么这么严格
Rust 编译器有时像一个要求很高的代码审查者。
有些代码乍看完全合理,它也可能不接受。
这是有原因的。编译器在检查这些问题:
- 谁拥有这个值?
- 所有权是不是已经移动了?
- 这个引用还有效吗?
- 多个引用之间有没有冲突?
- 可变引用会不会与其他引用的有效范围重叠?
- 一个值被销毁时,是否还有引用指向它?
在安全 Rust 中,目标是让通过检查的代码无法表达无效的内存访问。
这不意味着 Rust 能神奇地免疫所有内存 bug。Rust 仍然有 unsafe 代码、外部函数接口、逻辑错误,以及软件出错的其他可能。
不过,安全子集能在所有权和引用方面,提供很强的编译期保证。
取舍
手动管理内存,意味着更多控制权,也意味着更多责任。
垃圾回收让内存管理自动化,但对象回收要依赖运行时系统。
Rust 则把更多推理工作交给了编译器。
你需要理解这些概念:
所有权 → 借用 → 生命周期 → 移动 → 可变引用
刚开始,这些规则会让人有些不顺手。
编译器报错,你改代码,然后编译器又报错。
慢慢地,你开始理解这些规则为什么这样设计。
理解之后,一个有意思的变化就发生了:内存安全不再只是运行时可能遇到的各种意外,而成了你写代码时,程序就必须满足的一项要求。
Rust 背后的思路
这里最重要的启发,其实不在于 String、&T、&mut T、Rc<T> 或生命周期本身。
而在于,一门语言选择在什么时候解决问题。
垃圾回收器在程序运行时解决内存回收问题。
Rust 则把内存安全问题中的很大一部分移到了编译阶段。
这会改变开发体验。
对于无效引用,编译器可以在生成程序之前就拒绝它,而不是等部署之后才发现释放后使用(use-after-free)的 bug。
你也不需要逐个手动决定普通拥有值的销毁时机。通过代码结构定义所有权,Rust 会执行由此产生的规则。
这并不意味着内存管理从此没有成本,只是让内存所有权变得明确。
用四个问题理解 Rust
学习 Rust 时,把整套机制归结为四个问题很有帮助:
- 谁拥有这个值?
- 所有权移动了吗?
- 谁在借用它?
- 这次借用能有效多久?
如果能回答这四个问题,Rust 中相当大的一部分内容就容易理解了。
例如:
rust
fn main() {
    let mut message = String::from("Hello");
    add_world(&mut message);
    println!("{message}");
}
fn add_world(message: &mut String) {
    message.push_str(", world!");
}这段代码中,message 拥有这个 String。
add_world 接收到一个可变借用,可以修改字符串,但不会成为它的所有者。
借用结束后,原来的所有者可以继续使用这个值。
你不需要手动释放字符串。
编译器检查所有权和借用规则;所有者离开作用域时,Rust 的析构语义负责处理这个值。
开始这样看代码之后,所有权就不再像是 Rust 特有的一道奇怪门槛。
它成了描述数据生命周期的一种方式。
一点想法
如果你放弃处处拿 C 或带垃圾回收的语言来直接对照 Rust 的内存管理,Rust 的内存模型反而更容易理解。
Rust 不只是想提供"自动内存管理"。它更想让内存所有权的规则足够明确,以便编译器在程序运行之前就能验证。
所有权决定谁负责一个值。
移动转移这份责任。
借用让你使用数据,而不必取得所有权。
生命周期描述引用能在多长时间内保持有效。
Drop 定义清理行为。
当一个所有者不够用时,Rc 和 Arc 提供受控的共享所有权。
这就是 Rust 背后的核心思路:
你仍然需要思考内存,但不必等到运行时,再手动应对每一种内存安全问题。
理解这一点之后,Rust 严格的编译错误就不再只是阻碍。它们也在告诉你,程序的设计有哪些关系需要理清。