 @bit::Shadow
✧(≖ ◡ ≖✿
目录
[1.1insert 与 on duplicate key](#1.1insert 与 on duplicate key)
[duplicate key](#duplicate key)
[2.2.2 like](#2.2.2 like)
[2.2.3 desc 与 asc](#2.2.3 desc 与 asc)
[2.2.4 limit](#2.2.4 limit)
[4.2 truncate](#4.2 truncate)
什么算"冲突"
冲突指插入或修改后的数据,违反了表上的唯一性约束,主要包括:
-
主键冲突(PRIMARY KEY)
-
唯一键冲突(UNIQUE KEY)
-
对于
REPLACE,还包括:多个唯一约束同时冲突
注意:普通索引、非唯一索引不会造成冲突。
1.增
1.1insert 与 on duplicate key
insert into table_name(f1, f2, ...) values(v_1, v_2, ...) , values(v_1', v_2', ...);
duplicate key
解决插入冲突问题,回显描述。--- 必然导致目标插入
sql
insert table_name(f1,f2,...) values(v_1, v_2, ...)
    on duplicate key update f1=v_1', f2=v_2', ...;
返回值
-- 2 rows affected: 表中已有数据冲突,update后被执行;
-- 1 row affected:表中没有数据冲突,直接插入成功;
-- 0 row affected:表中有数据冲突且与update后相同;
注意:一定要关注自增主键值,其值可能会受影响。
1.2replace
用法是insert的平替+duplicate key冲突。
-- 1 row affected:无冲突,插入成功。
-- 2 row affected:有冲突,删除原内容后插入。
'8'代表的主键冲突下replace的使用

2.查
2.1distinct
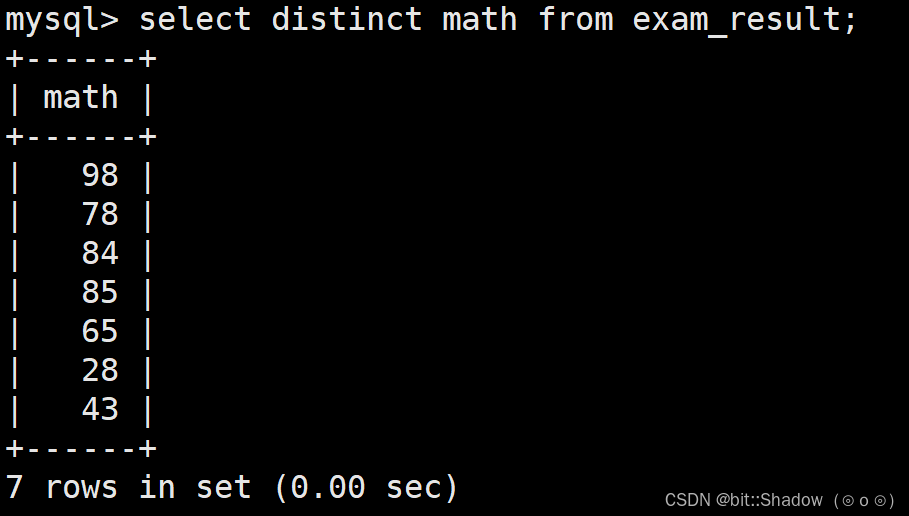
select distinct f1,f2 from table_name; -- 查找(f1,f2)这完全整体不重复的值。(不是一者不同即可)
2.2where
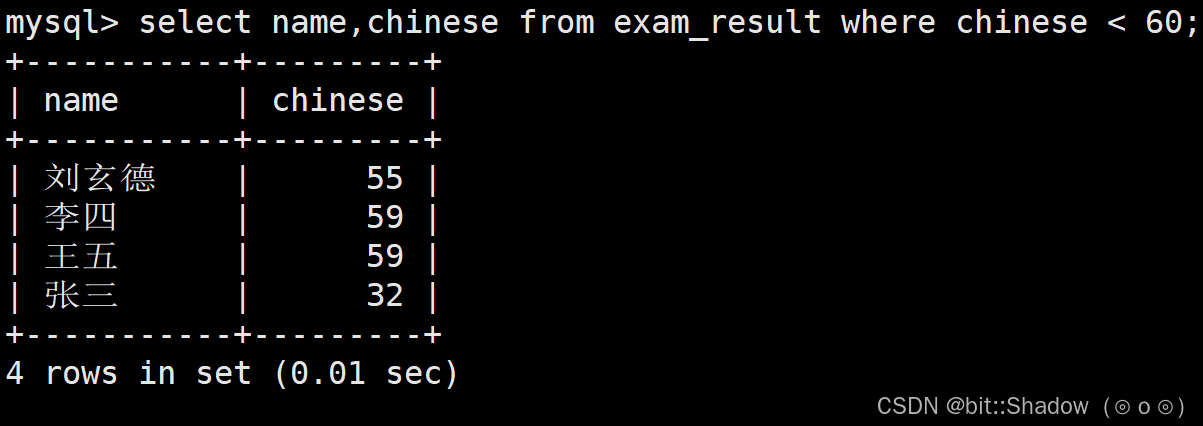
查询语文成绩小于60分的人
2.2.1运算符
比较运算符
| 比较运算符 | 说明 |
|---|---|
| >, >=, <, <= | 大于,大于等于,小于,小于等于 |
| = | 等于,++NULL 不安全++,例如 NULL = NULL 的结果是 NULL |
| <=> | 等于,NULL 安全,例如 NULL <=> NULL 的结果是 TRUE(1) |
| !=, <> | 不等于 |
| BETWEEN a0 AND a1 | 范围匹配,a0, a1,如果 a0 <= value <= a1,返回 TRUE(1) |
| IN (option, ...) | 如果是 option 中的任意一个,返回 TRUE(1) |
| IS NULL | 是 NULL |
| IS NOT NULL | 不是 NULL |
| LIKE | 模糊匹配。% 表示任意多个(包括 0 个)任意字符;_ 表示任意一个字符 |
逻辑运算符
| 逻辑运算符 | 说明 |
|---|---|
| and | 多个条件必须都为 TRUE(1),结果才是 TRUE(1) |
| or | 任意一个条件为 TRUE(1),结果为 TRUE(1) |
| not | 条件为 TRUE(1),结果为 FALSE(0) |
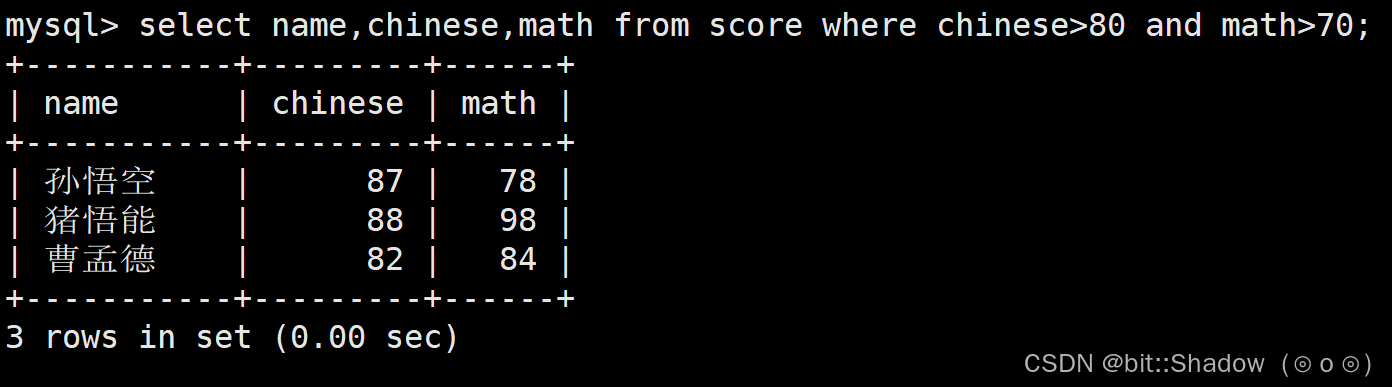
查询语文成绩大于80分且数学成绩大于70分
2.2.2 like
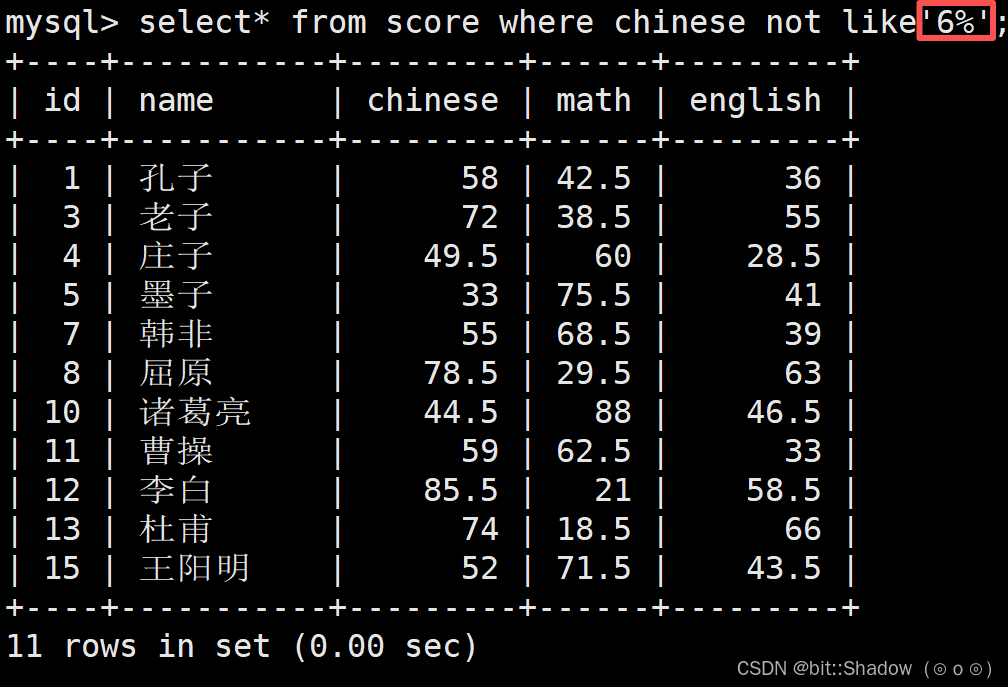
where f1 not like{val}
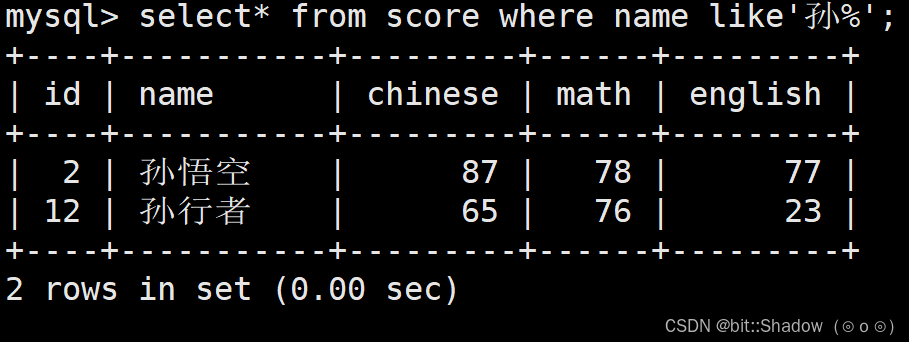
查找姓孙的人的成绩
sql
select* from score where name like'孙%';模糊匹配
用例
sql
DROP TABLE IF EXISTS score;

CREATE TABLE score (
  id int unsigned NOT NULL AUTO_INCREMENT,
  class varchar(20) NOT NULL COMMENT '班级',
  name varchar(20) NOT NULL COMMENT '同学姓名',
  gender char(1) NOT NULL COMMENT '性别:男/女',
  chinese float DEFAULT 0 COMMENT '语文成绩',
  math float DEFAULT 0 COMMENT '数学成绩',
  english float DEFAULT 0 COMMENT '英语成绩',
  PRIMARY KEY (id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

INSERT INTO score (class, name, gender, chinese, math, english) VALUES
('一班', '孔子',   '男', 58.0, 42.5, 36.0),
('一班', '孟子',   '男', 65.5, 51.0, 47.5),
('一班', '老子',   '男', 72.0, 38.5, 55.0),
('一班', '庄子',   '男', 49.5, 60.0, 28.5),
('一班', '墨子',   '男', 33.0, 75.5, 41.0),

('二班', '荀子',   '男', 61.5, 44.0, 52.5),
('二班', '韩非',   '男', 55.0, 68.5, 39.0),
('二班', '屈原',   '男', 78.5, 29.5, 63.0),
('二班', '司马迁', '男', 67.0, 35.0, 71.5),
('二班', '诸葛亮', '男', 44.5, 88.0, 46.5),

('三班', '曹操',   '男', 59.0, 62.5, 33.0),
('三班', '李白',   '男', 85.5, 21.0, 58.5),
('三班', '杜甫',   '男', 74.0, 18.5, 66.0),
('三班', '苏轼',   '男', 69.5, 47.0, 79.0),
('三班', '王阳明', '男', 52.0, 71.5, 43.5);
查找语文成绩不是以'6'开头的成绩
2.2.3 desc 与 asc
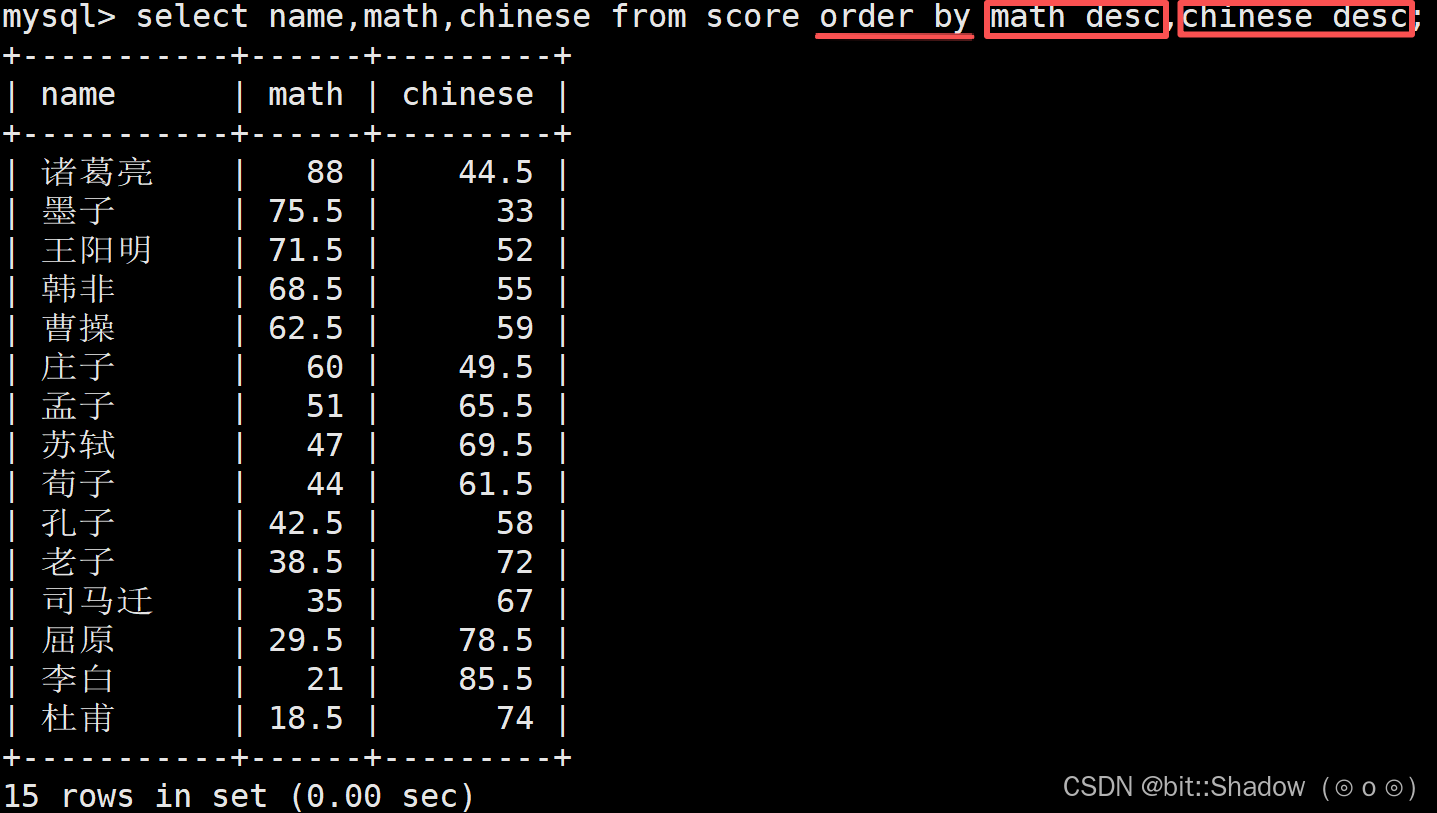
order by desc 或者 order by asc
sql
select f1,f2 from table_name order by f1 desc, f2 desc;查询成绩按照数学优先 语文次之的顺序排列(只有当数学成绩一致时才会对语文成绩进行比较)
2.2.4 limit
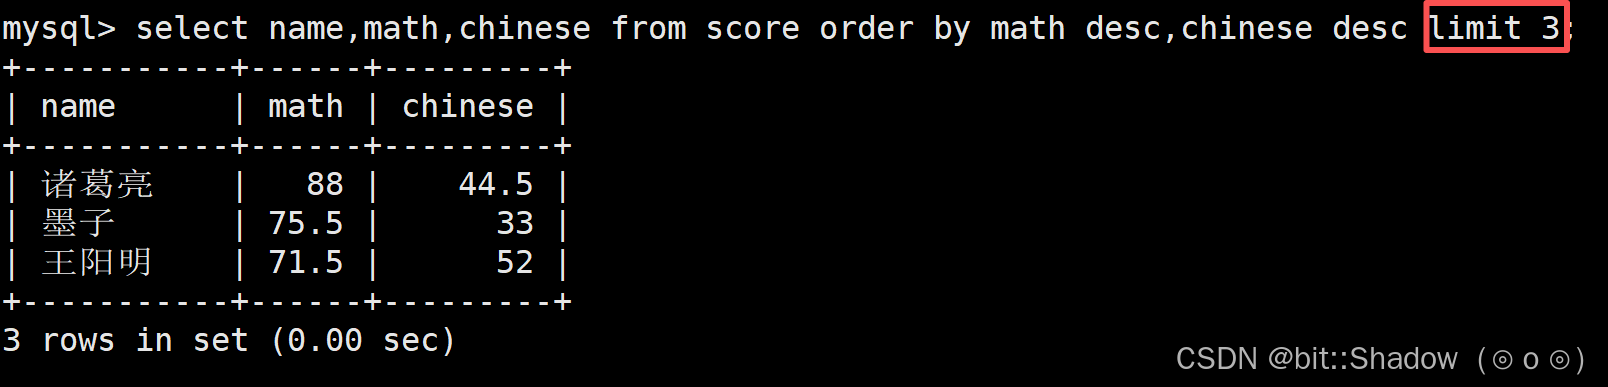
limit num
-- 自筛选后表限定num行显现
在上例的基础上限定3行
查询总分排名前五的同学,若总分一致按照数学成绩排名
sql
mysql> select name,chinese+math+english '总分', math
    -> from score
    -> order by chinese+math+english desc, math desc
    -> limit 5;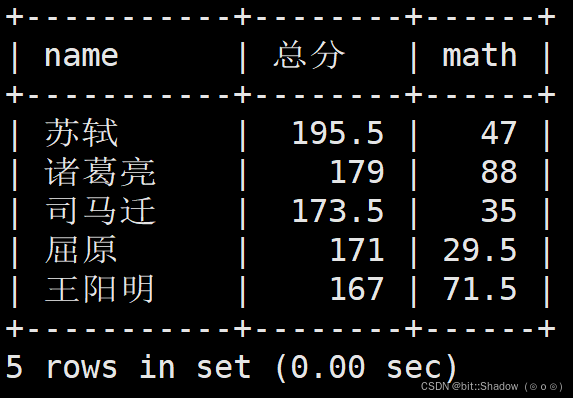
limit的定位用法
limit head, num; 从第head+1位开始取num个
注意:limit是限制"显示 "而不限制"筛选"条件。
3.改
更改某列某行数据
sql
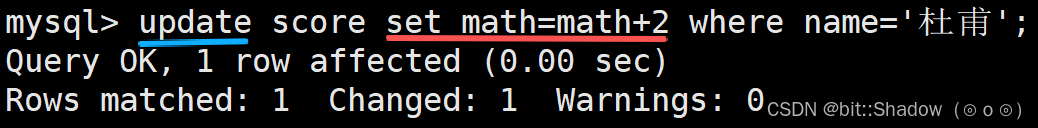
update 表名 set f1=newVal [where . . . ] ;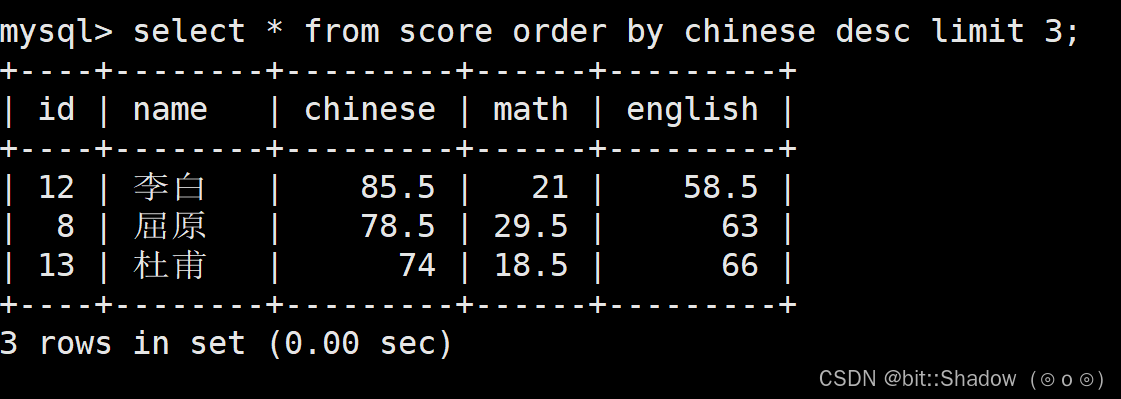
将杜甫的数学成绩提高2分
4.删
4.1delete
删除表内某行数据
sql
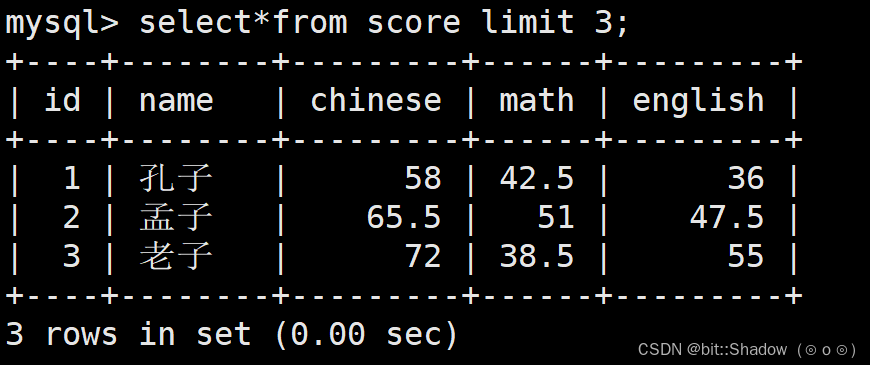
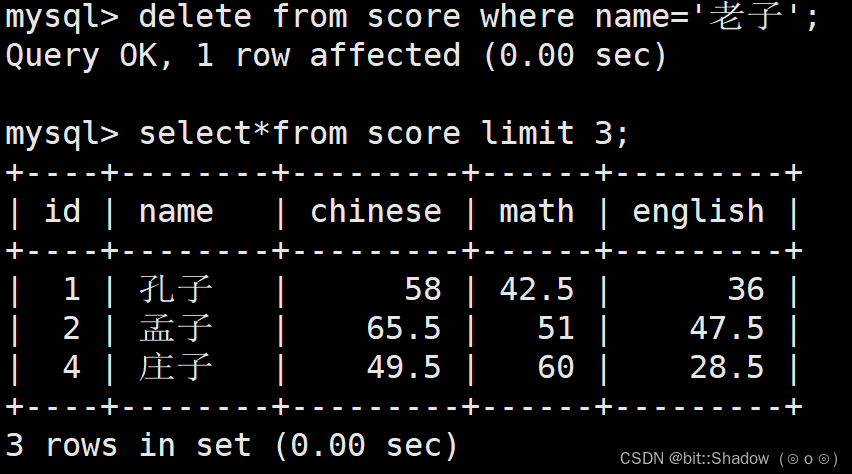
delete from 表名 [where . . .;注意:不使用where定位条件将导致整个表数据被删除。
将"老子"的行删除
4.2 truncate
sql
truncate [table] table_name;1.只能对整个表使用,不能像delete一样可以进行筛选删除。
2.truncate不经过事务。++不会被MySQL日志记录++ ,所以其造成的后果++无法回滚++。
3.truncate较delete更快,并且delete无法重置的 auto_increment 它 truncate 可以重置。
*聚合函数
|---------------------------|-----------------|
| count(distinct value) | 返回查询目标的个数 |
| sum(distinct value) | 返回 计和值,不是数字则无意义 |
| avg(distinct value) | 返回平均值,不是数字无意义 |
| min(distinct value) | 返回最小值,不是数字无意义 |
| max(distinct] value) | 返回最大值,不是数字无意义 |
"distinct":重复的单位不进入计算
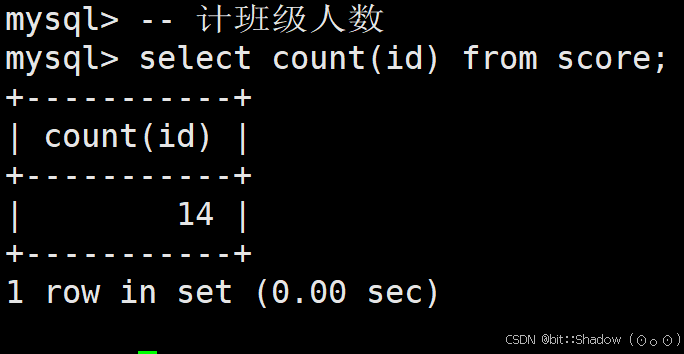
计班级人数
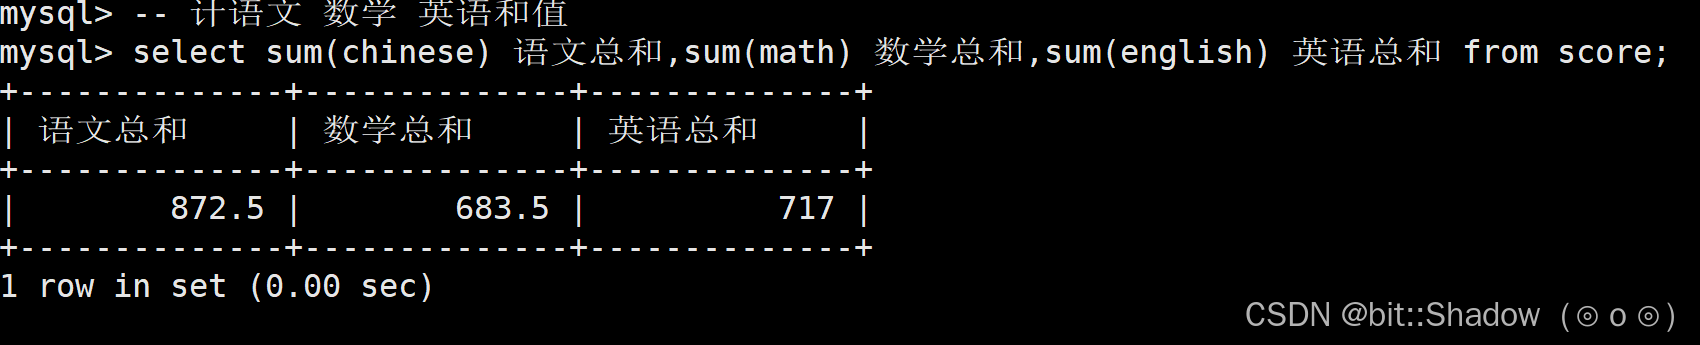
sum 分别计语文 数学 英语总和
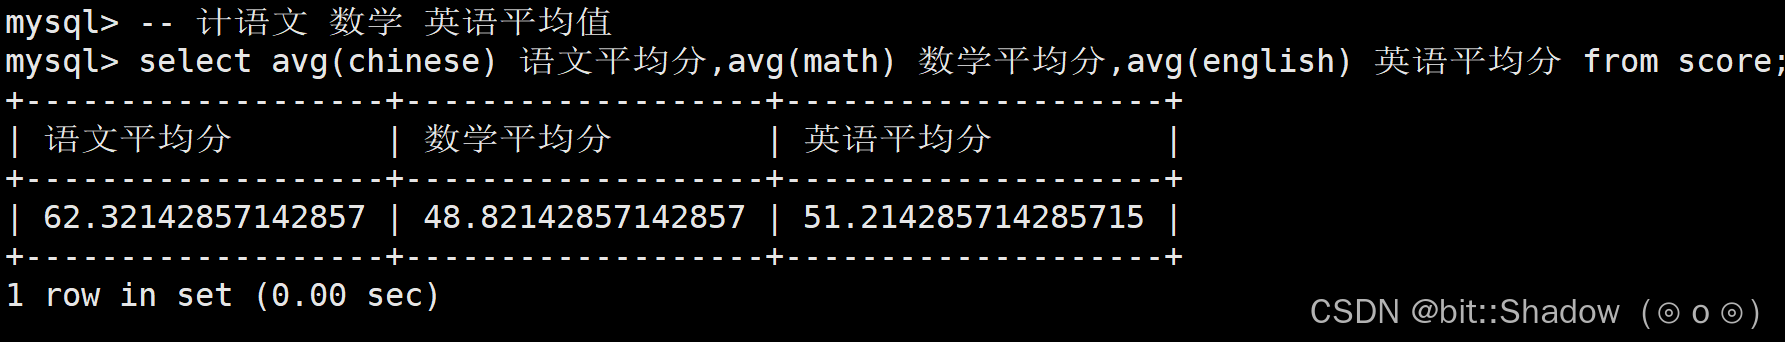
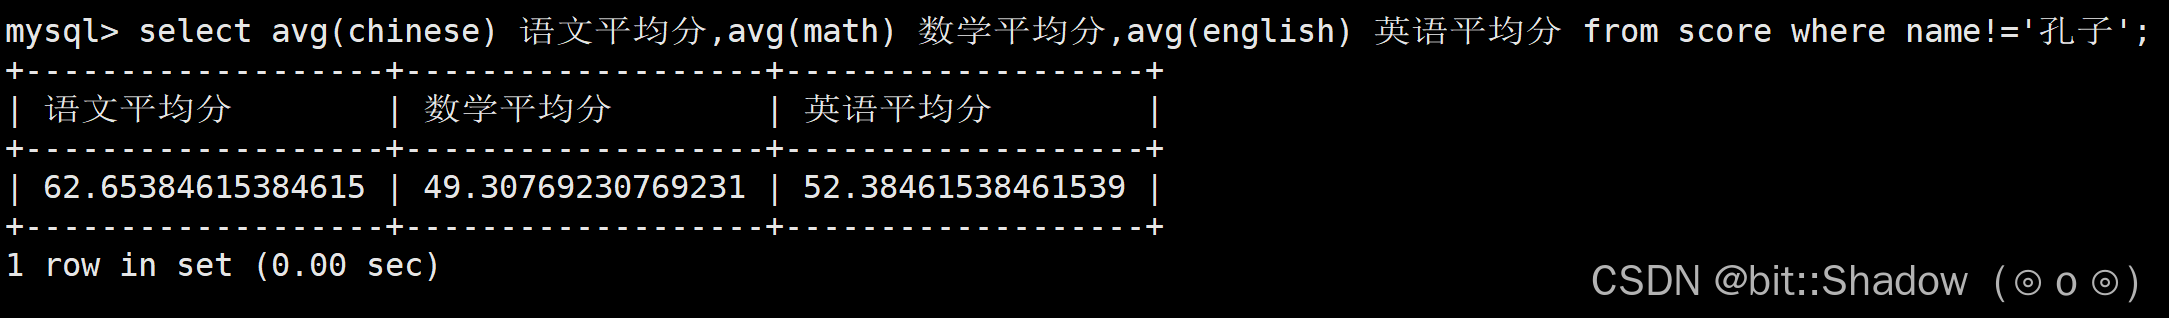
avg 分别计语文 数学 英语 平均分
计除去孔子后的语文 数学 英语 平均分
养成的好习惯
1.勿方便而滥用重命名
2.字符串以单引号
3.即使有auto_increment也要明确指定(尤其是在insert时)
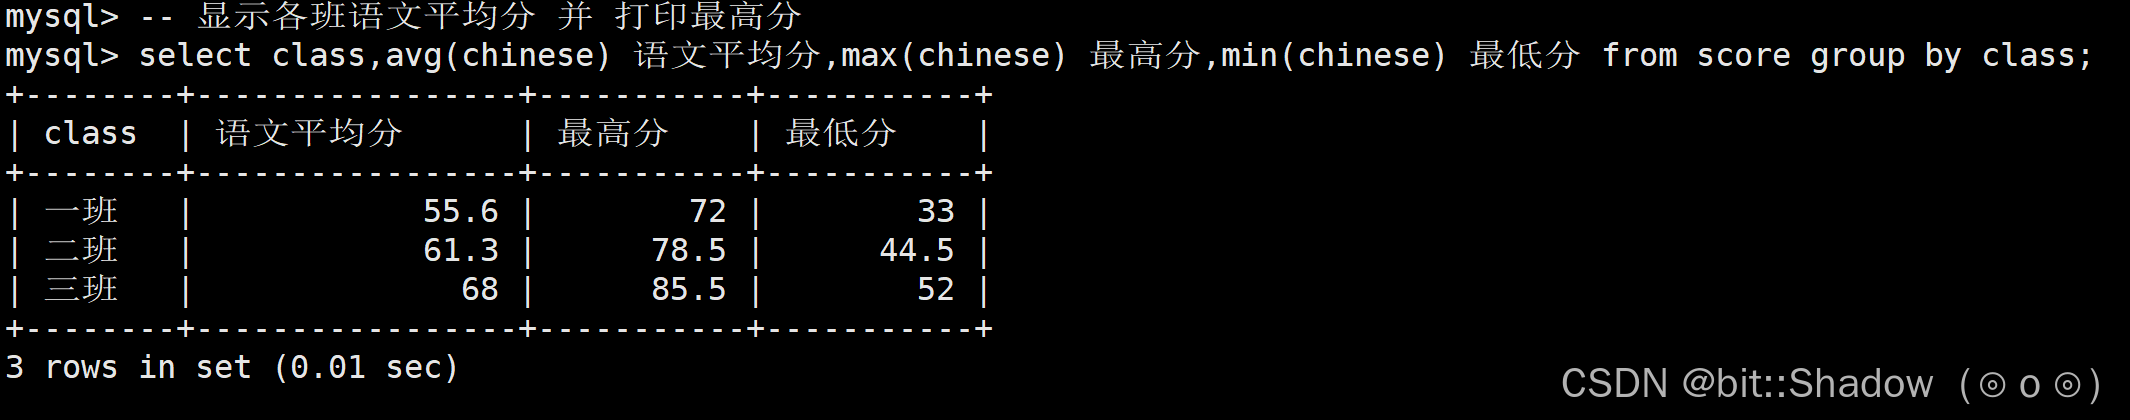
分组聚合查询
group by . . .
having . . .
-- 用于不同组间的隔离
having ....
-- 用于约束分组
计在孔子不参与统计 显示 语文平均分 低于70 的 班级
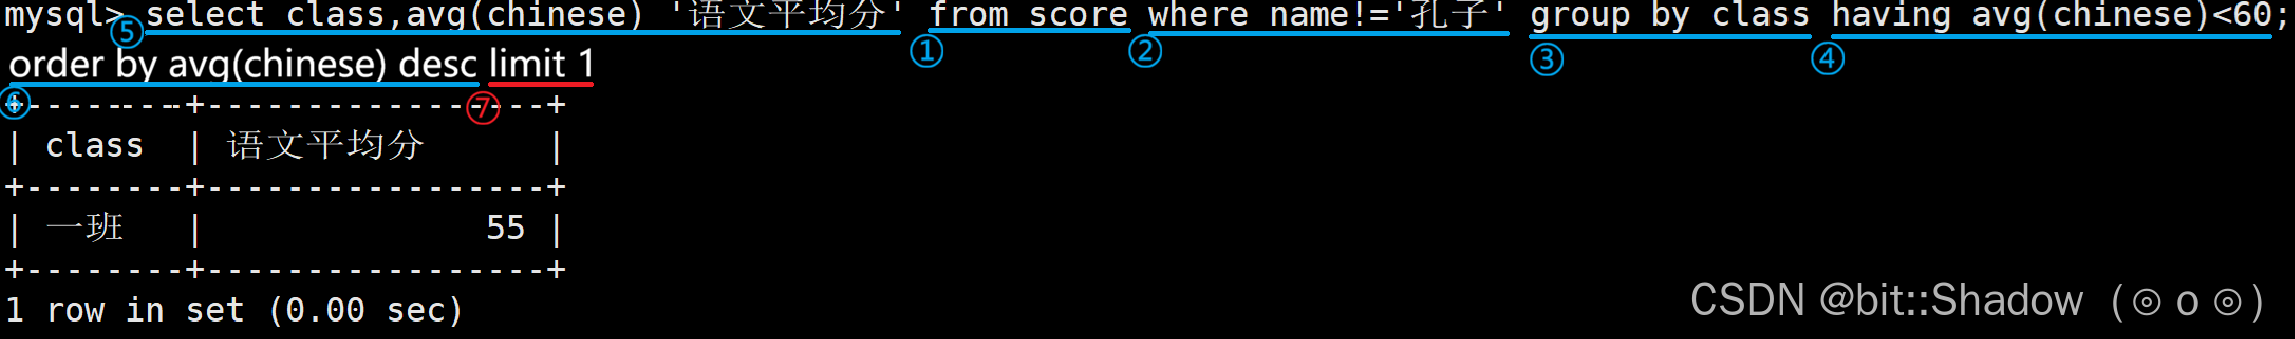
注意:where内不能放置聚合函数,因为where快于group by的分组,此时还没有分组完毕。
OJ
4查找入职员工时间升序排名的情况下的倒数第三的员工所有信息_牛客题霸_牛客网
5查找薪水记录超过15条的员工号emp_no以及其对应的记录次_牛客题霸_牛客网
6获取所有部门当前manager的当前薪水情况,给出dept__牛客题霸_牛客网
7从titles表获取按照title进行分组_牛客题霸_牛客网
87182. 查找重复的电子邮箱 - 力扣(LeetCode)
01https://leetcode.com/problems/nth-highest-salary/description/
感谢支持,长期连载
欢迎关注