很多团队尝试用一些AI搭建舆情监测智能体,跑了两三周后发现同一个问题反复出现:定时抓取的规则跑着跑着就断了,没人在第一时间发现,等负面信息被翻出来的时候,往往已经在多个平台发酵了几天。
这不是 这类AI 不好用,而是 我们工具要选对,像一些AI ****工具的设计目标本来就是"搭建对话式智能体",不是"7×24小时盯着十几个信息源、还要在出错时说清楚是哪一步出的问题"。****智能体用在聊天检索资料上,还是要真正进入企业业务流程上,就不是一回事。
舆情监测的技术账本:从"能聊天"到"能干活"差在哪一层
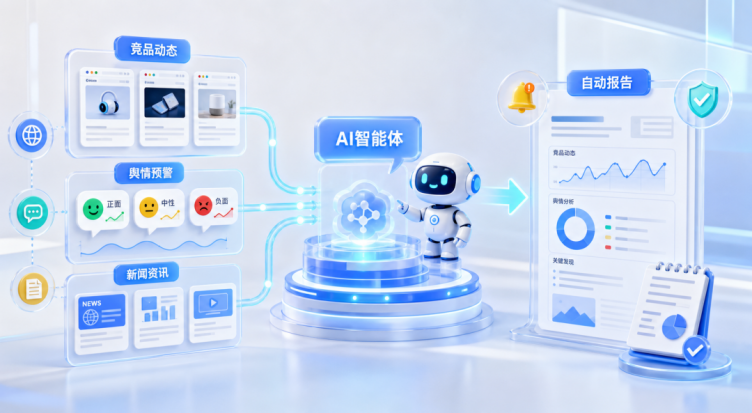
单次问答式AI能回答"帮我分析一下某友商最近的动态",但它不会在没人问的时候,自己第二天再去查一遍对方官网、猎聘和微信公众号。竞品和舆情信息本质上是持续监控问题,而不是一次性检索问题------真正管用的方案得拆成三层:采集执行层 负责按规则定时抓取,理解判断层 负责语义分类和优先级排序,治理与执行层负责权限、审计和风险熔断。少一层,这件事都干不利索。
第一层:采集执行层------定时抓取不是"每天跑一次"那么简单
多信源采集最麻烦的地方在于网页结构不固定:今天竞品官网发的是新闻稿,明天可能是一个新招聘岗位页面,抓取脚本按原来的页面结构解析,很容易漏掉或抓错字段。工程上要处理的细节包括:不同信源的反爬虫机制应对、抓取结果的去重(同一条舆情在多个平台转发,需要按内容指纹去重而不是按URL去重)、以及抓取频率的分层设计------常规信源按日轮询即可,但涉及品牌声誉的关键词一旦触发异常波动,应该自动提高轮询频率,而不是固定用同一套节奏跑所有信源。
金智维K-APA在设计上区分"生成阶段"和"执行阶段":构建阶段由大模型理解需求、生成抓取脚本,验证通过后进入执行阶段------这部分改用确定性脚本运行,脱离大模型算力,既能降低Token消耗,也能保障抓取动作100%稳定执行,不会因为模型偶发性理解偏差导致漏抓。这套逻辑放进舆情监测场景里同样适用:结构稳定的信源,规则一旦验证过就该固化成脚本,不需要每次都重新调用大模型去"理解"该怎么抓。
第二层:理解判断层------关键词匹配为什么做不到分类
竞品官网新增一个"智能制造行业解决方案"页面,和该竞品在招聘平台上发布二十个Agent工程师岗位,字面上毫无关联,但业务判断上都指向同一个结论------这家竞品正在加码智能体产品线。这种跨信源的语义关联,关键词匹配做不到,需要大模型理解上下文并做归因。****传统爬虫擅长执行规则明确的抓取任务,却读不懂"这条信息有没有业务意义";大模型恰好相反,理解语义,但不擅长长期稳定地重复执行同一套流程。****两边各握着一半能力,单靠哪一边都干不完整这件事。
第三层:治理与执行层------决定这套系统能不能上生产环境
个人用AI出错了大不了重来,企业用在舆情、品牌、合规相关的工作上不能这么随意:未经确认的信息被直接推给管理层怎么办?误判了负面舆情怎么办?抓取了不该访问的数据怎么办?金智维创始人廖万里在谈企业级智能体时说过一句话:****"智能体的'自主行为'本质上是基于预设规则、大模型推理能力以及系统调用逻辑的综合体现,其'自主'是在人类设计边界下的受控的智能。"****这句话点出了企业级智能体和个人智能体最本质的差别------不是能力上限的差别,而是能不能被纳入系统治理。
具体到工程实现,Ki-AgentS的企业级护栏体系包括权限与身份边界控制、执行沙箱隔离、全链路审计记录、数据访问校验,所有任务调用都要经过权限验证。放进舆情监测场景,对应的是:****普通信息自动整理归档,疑似风险信息触发人工二次确认,每一次抓取、判断、推送都留痕可溯,不同岗位只看得到权限范围内的信息。****这套"可控优先"的逻辑并非凭空设计------国泰海通证券的"金小智"项目里,资金核查从1小时压缩到8分钟,效率提升85%,全程留痕合规可溯,用在同样要求可追溯的舆情监测场景里,本质上是同一套底层治理能力的复用。
三层能不能自己拼?现实里最容易漏掉的是第三层
Coze、Dify加一段自己写的爬虫脚本,技术上确实能把第一层和第二层拼出来------抓取、分类、总结,跑起来看着也像模像样。
真正的现实差距在第三层:大多数团队自建方案时,权限分级、审计留痕、风险熔断这类"看起来不影响功能"的部分会被直接跳过,等系统真正在生产环境跑起来、出现一次误判被追责的时候,才发现连"这条误判信息是哪一步产生的"都说不清楚。
判断该自建还是买企业级方案,可以问三个问题:
1、 更新频率要求多高(日常汇总够用,还是需要突发舆情实时预警);
2、 误判之后需不需要追溯到具体哪一步、谁的责任;
3、 团队有没有长期同时维护定时任务、语义模型、审计日志三套系统的能力。
三个问题里但凡有一个答案偏向"要求高",自建组合大概率撑不住。
适合上企业级舆情监测方案的,是竞品数量多、更新频繁,品牌声誉敏感,或销售团队高度依赖竞品动态调整话术的企业,尤其是金融、政务这类本身就要求操作留痕、对外部审计负责的行业;如果只是偶尔看看同行动态,用通用AI搜索加人工总结就够了,上一整套企业级智能体纯属杀鸡用牛刀。