SpringBoot3 企业薪酬核算:考勤、绩效与薪资规则如何算出一张可解释的工资单
🌐 文档地址 :https://ruoyioffice.com
👇 文章底部获取源码和演示地址 👇
💬 :17156169080(获取产品咨询)
工资系统最容易被低估的部分,是把"算出一个数字"误认为"完成了薪酬核算"。实际发放前,HR 需要回答:这个数字来自哪一版薪酬方案?缺勤扣款引用了哪段考勤数据?绩效结果还没有回传时,系统是暂停、预估,还是按零处理?员工提出异议时,能不能还原当时参与计算的输入?
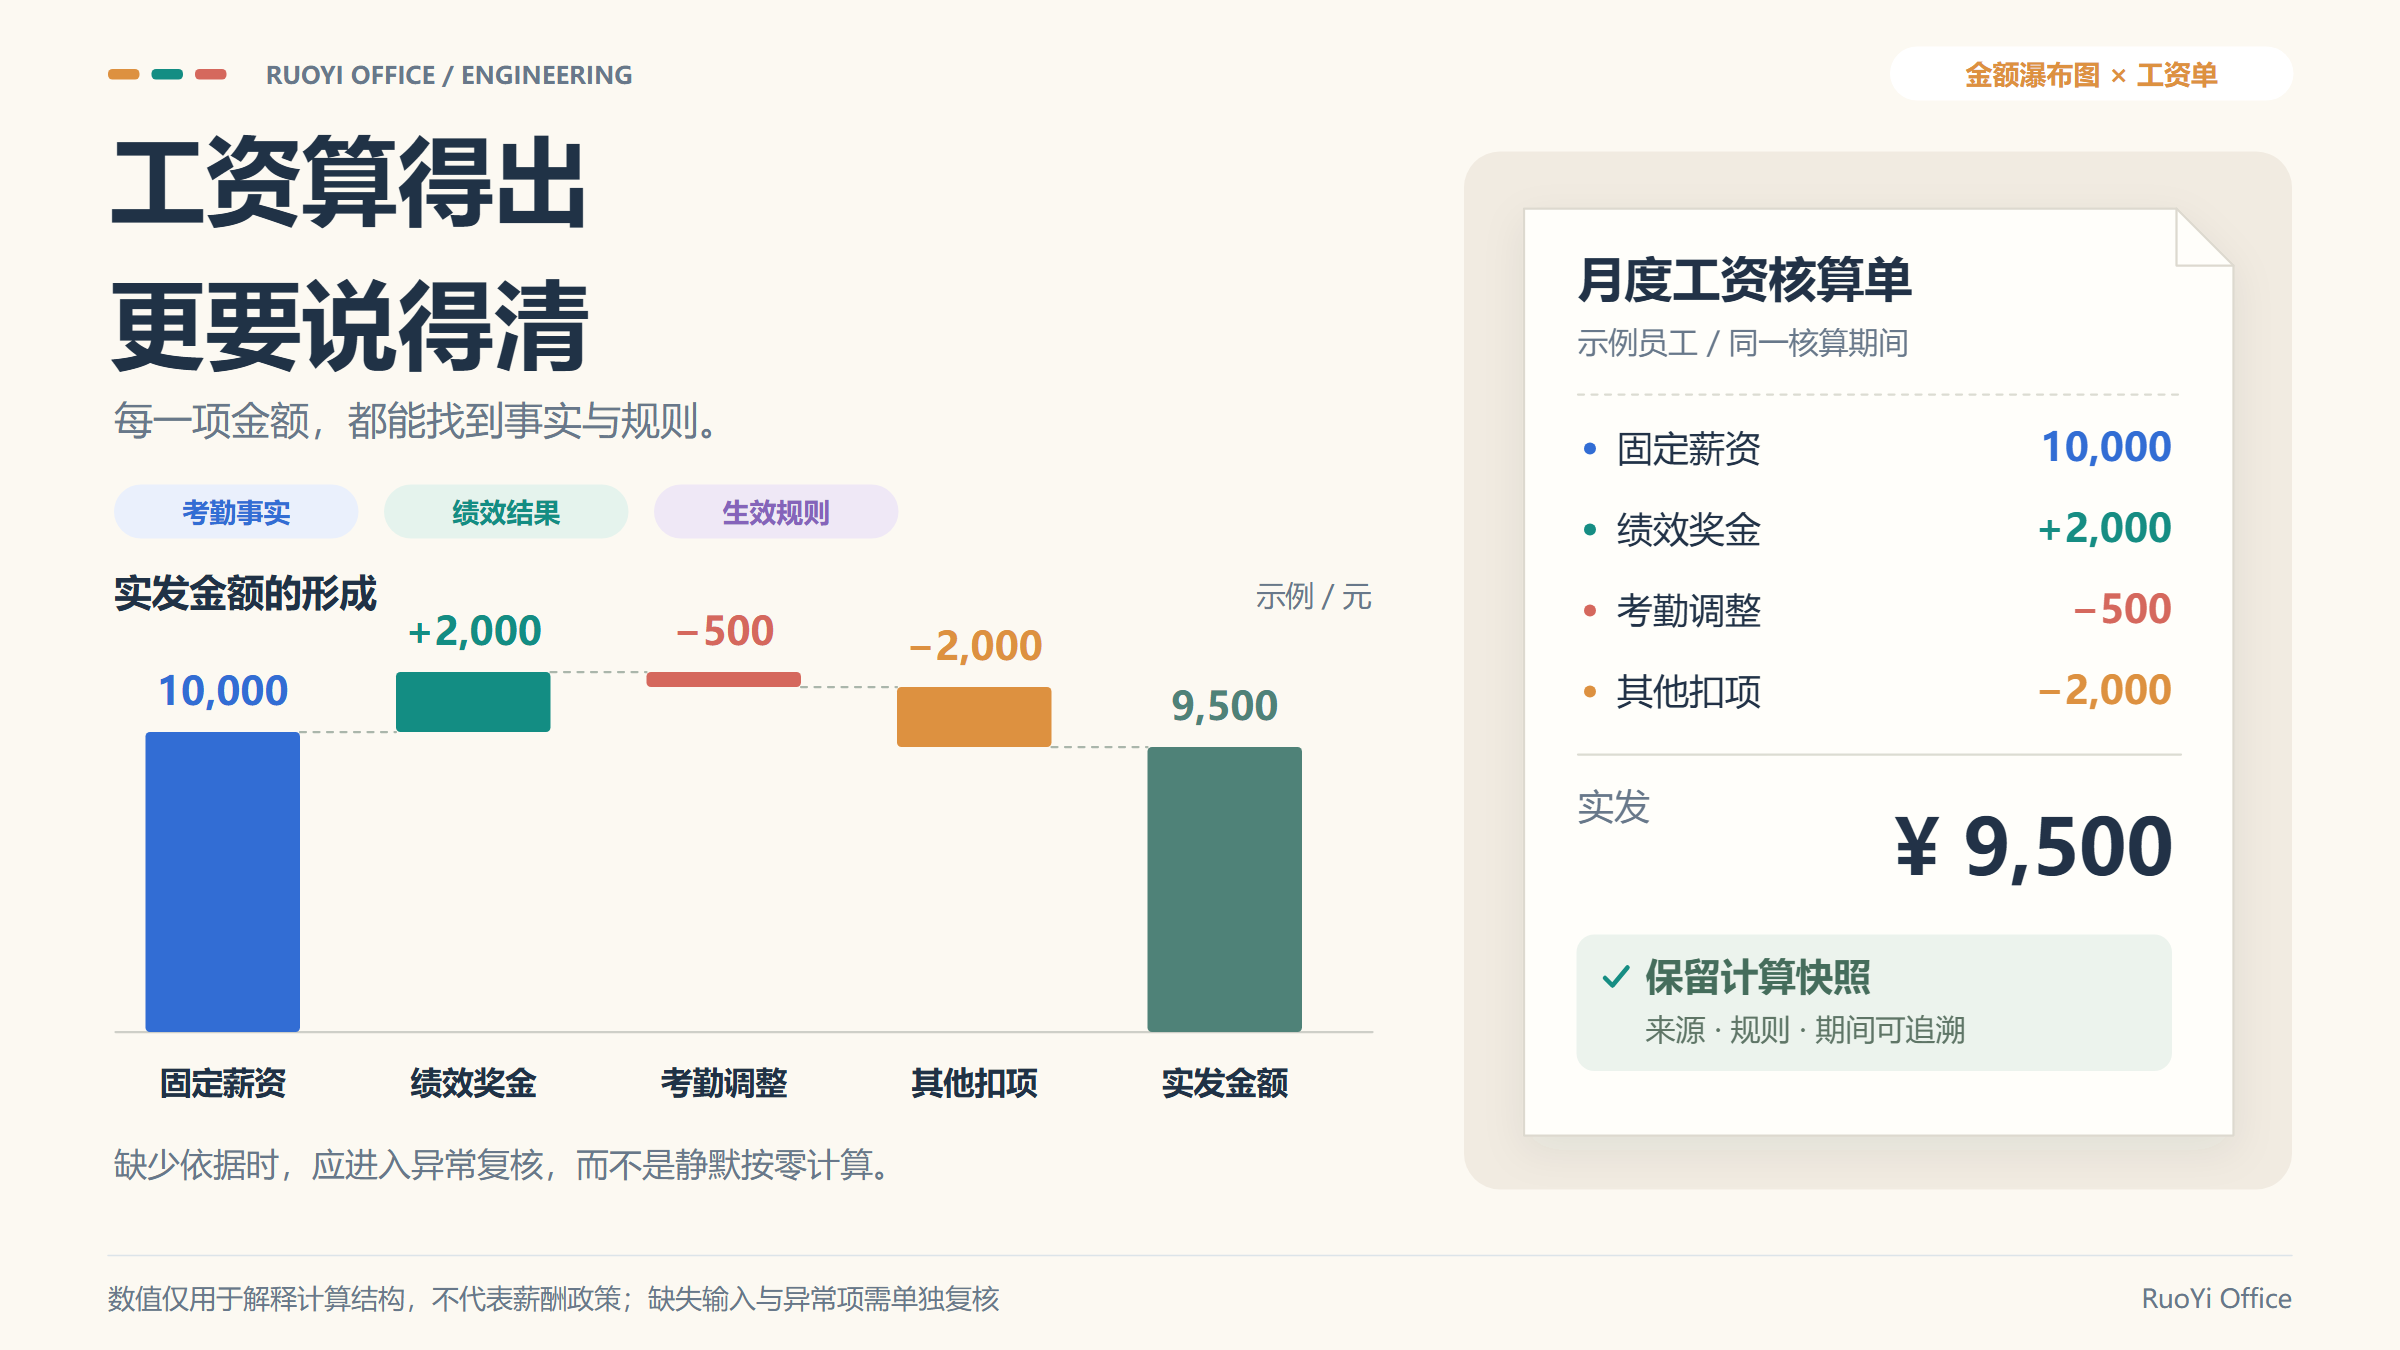
▲ 固定薪资、绩效增加、考勤调整和扣项共同形成实发金额;右侧工资单保留来源、规则和期间快照。
本文讨论的是软件工程问题,不提供税务、劳动法或地区政策结论。示例金额仅用于解释计算结构,真实企业必须以当地政策和财务制度为准。
一、薪酬核算真正难在哪
薪资核算是多来源事实在一个期间内的合并。
薪资方案提供规则,员工档案提供适用对象,考勤和绩效提供期间事实,社保和个税提供地区与累计状态,最后才得到员工级结果。
如果系统只保存"应发、扣款、实发"三个总数,结果看起来简洁,却无法解释。
一旦有人问"为什么少了 500 元",开发人员只能重新跑一遍当前规则;而当前规则可能已经和上个月不同。
| 输入来源 | 例子 | 变化频率 | 缺失时的处理 |
|---|---|---|---|
| 员工档案 | 公司、部门、薪酬方案、社保城市 | 入转调离或版本变更 | 标记无法计算 |
| 考勤事实 | 出勤、缺勤、加班、请假 | 每日或月末 | 需要区分无数据和零扣款 |
| 绩效结果 | 评分、等级、奖金系数 | 绩效周期 | 等待、预估或异常 |
| 薪酬规则 | 基本、岗位、扣款、社保、个税 | 政策或方案变化 | 使用期间生效版本 |
| 累计台账 | 已纳税收入、已缴税额 | 月度累计 | 影响当期计算 |
1.1 一张工资单需要三种解释
第一种是来源解释:数据来自哪个业务事实。
第二种是规则解释:按哪一条薪资项目规则计算。
第三种是时间解释:它属于哪个工资期间,采用哪个生效版本。
这三种解释缺一不可。
"考勤调整 -500"只是结果展示;"本月缺勤 1 天、按月标准工作日折算、来自方案 v3"才是可复核信息。
1.2 试算不是发薪
试算用于发现数据缺口和检查规则结果。
确认用于冻结本批次可作为后续流程依据的结果。
发薪登记用于记录业务动作已经发生。
工资条发布用于向员工暴露经过控制的结果。
这些阶段可以在界面上呈现为几个按钮,但后台必须使用不同状态。
之前的薪资发放专题已经讨论过双审批和工资条幂等,本文把重点放在试算输入、计算上下文和可解释快照。
二、先建立薪酬期间的统一口径
一次批次核算至少需要确定年份、月份、薪资主体和参与员工集合。
所有输入都必须落到同一期间,否则"本月"只是页面上的文字。
2.1 员工档案不是当前页面的一行文本
档案中可能存在薪酬方案、公司、社保城市、个税城市、岗位工资以及当前生效版本。
员工调动或薪资调整后,页面显示的当前值不一定是历史期间使用的值。
因此,批次计算应先为每个员工解析适用档案版本,再把版本传入计算上下文。
源码中的 SalaryCalcContext 组合了批次、档案、版本、员工、岗位标准、绩效结果和考勤汇总,目的就是避免在规则执行过程中到处重新查询"当前值"。
2.2 生效日期比"最新记录"更重要
假设员工 9 月 15 日转正,正式工资从 9 月 16 日生效。
如果简单取数据库最新一条档案版本,可能会把整个月都按正式工资计算。
正确做法是先判断版本是否覆盖核算期间,再决定适用哪一版。
这也是为什么版本表不能只存一个 is_current。
"当前"服务于今天的页面,"在某个期间生效"服务于历史计算。
2.3 地区规则需要明确优先级
社保、公积金和个税规则可能按城市、方案或主体配置。
没有城市规则时,是回退到主体规则、使用默认值,还是标记异常,必须在产品规则中写出来。
不要让 SQL 的排序顺序偷偷决定业务政策。
三、把三类事实汇入一张可解释核算单
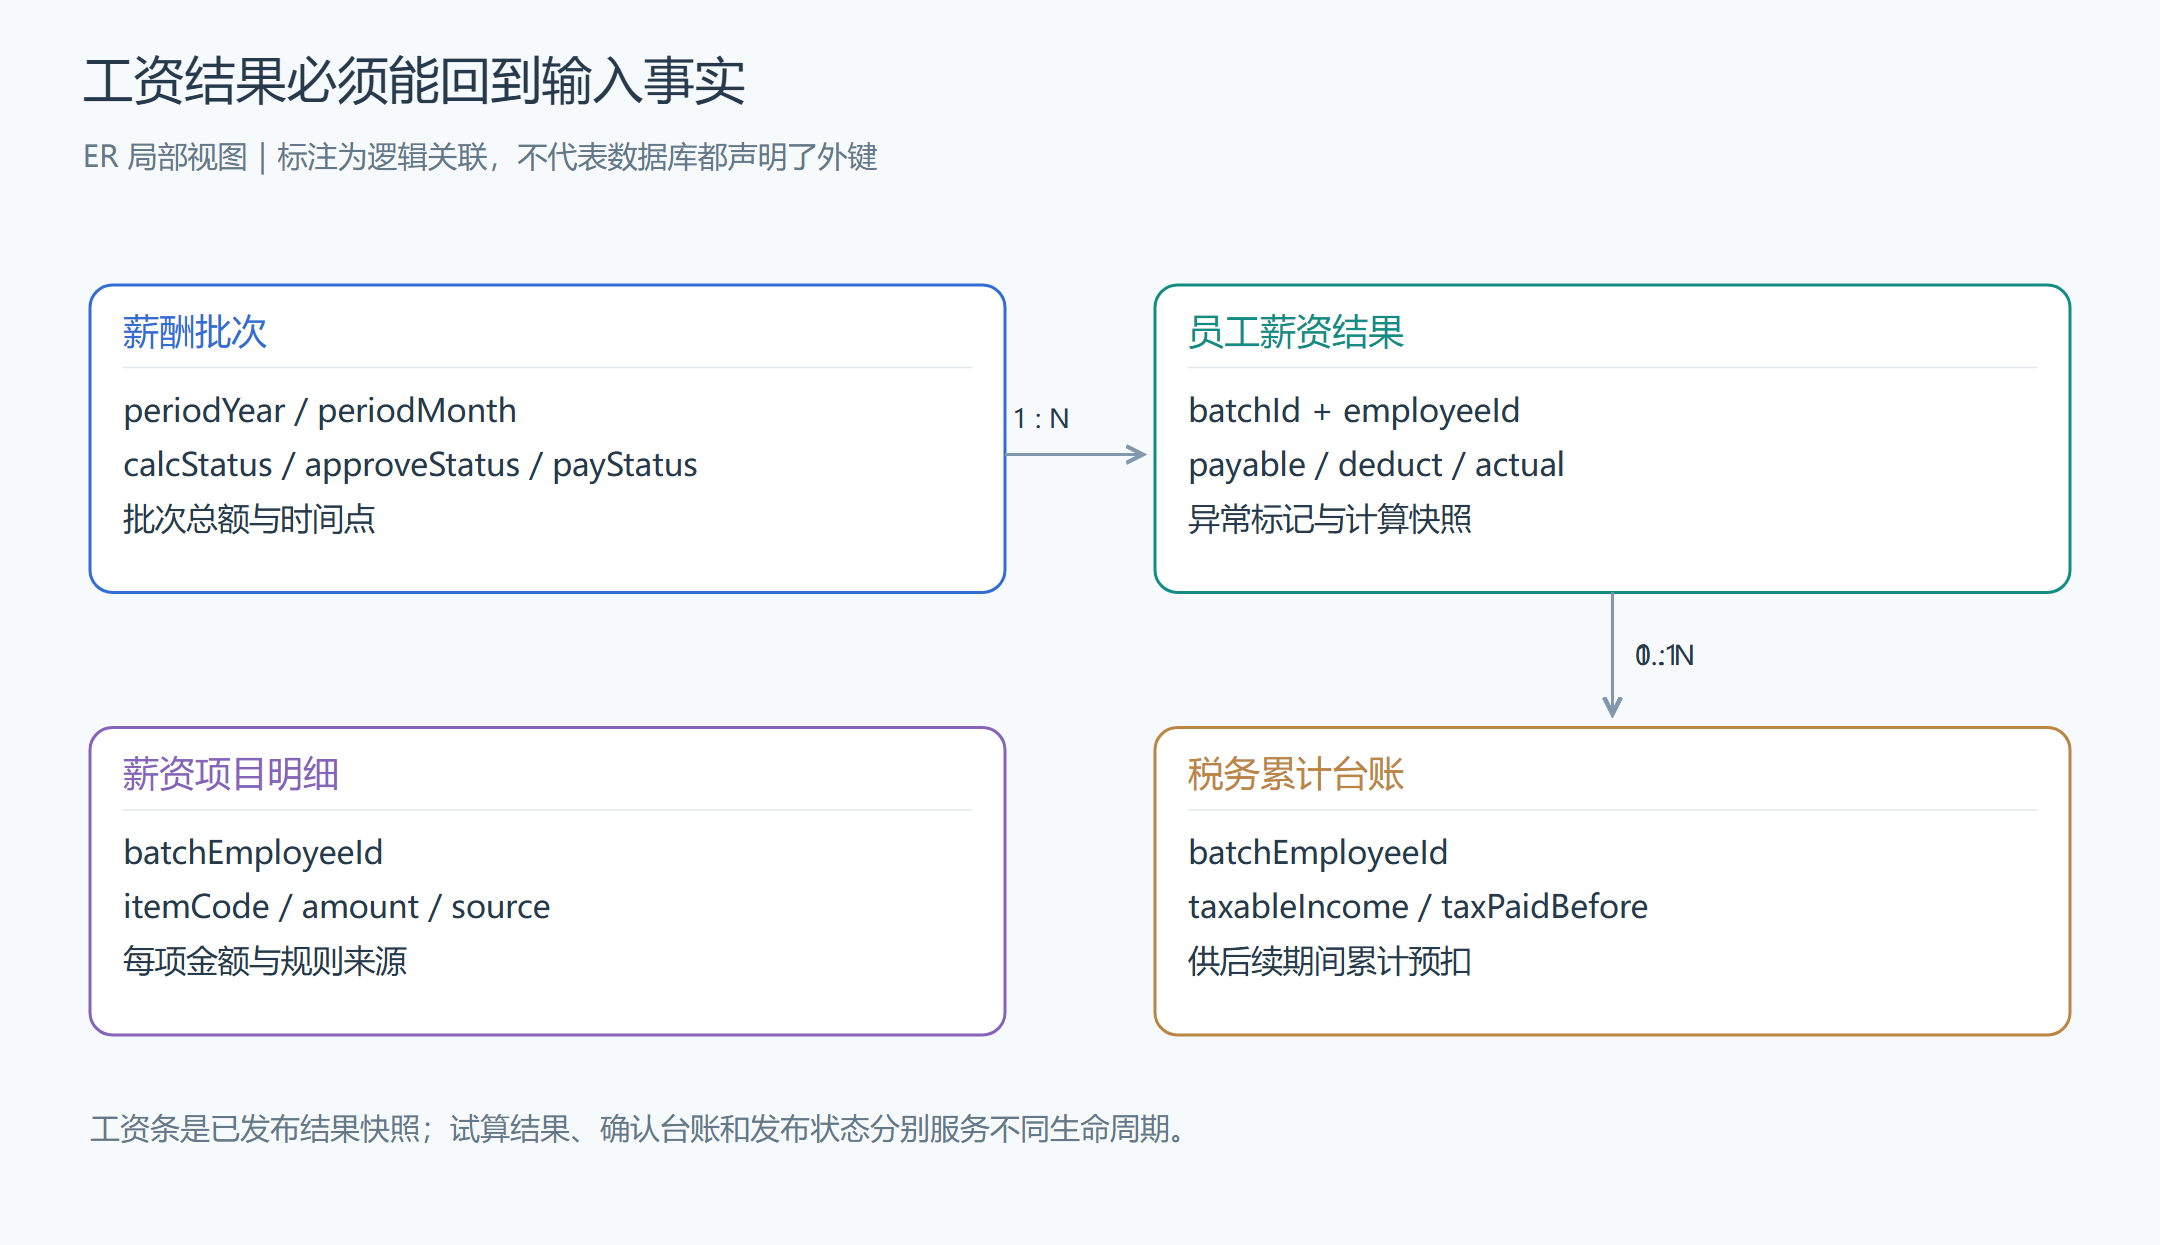
▲ 批次聚合期间,员工结果保存总额和快照,项目明细保留每项金额,税务台账服务后续累计。
员工级结果是本文的中心。
它不是简单的工资条,而是连接"计算过程"和"后续确认"的中间凭证。
| 结果层级 | 典型字段 | 用途 |
|---|---|---|
| 批次 | 期间、员工数、应发总额、实发总额、状态 | 管理整批核算 |
| 员工结果 | 员工、档案版本、应发、扣款、实发、异常 | 复核个人结果 |
| 项目明细 | 项目编码、金额、来源、说明 | 解释每项变化 |
| 计算快照 | 输入摘要、期间、规则命中 | 还原当时计算 |
| 税务台账 | 累计收入、已缴税、专项扣除 | 支撑后续月份累计 |
3.1 计算上下文不要退化成全局 Map
规则很多时,最容易出现的实现是把所有输入塞到一个 Map<String, Object>。
这样短期灵活,长期却难以知道某个值来自哪里、允许为空还是必须存在。
上下文类不一定要把每个项目都写成固定字段,但至少要把核心事实分组。
例如期间、员工档案、岗位标准、绩效结果和考勤汇总就是不同来源。
规则读取时可以通过统一方法访问项目金额,避免把查询逻辑散在每个计薪规则里。
3.2 缺失数据与零金额不是同一件事
没有考勤数据,可能代表考勤接口尚未同步。
考勤数据存在但缺勤为零,才代表本期间没有缺勤。
如果两者都转成 0,工资结果虽然能保存,业务却失去了补救机会。
源码在发现"有缺勤项目但无考勤记录"时增加异常标签,并按当前规则计算。
这是一种明确的风险暴露方式;在不同企业中,也可以选择阻断试算或进入待确认队列。
四、看懂一次真实试算
设某员工 9 月的基础薪资为 10,000 元,绩效增加 2,000 元,考勤调整 -500 元,其他扣项 -2,000 元。
示例实发为 9,500 元。
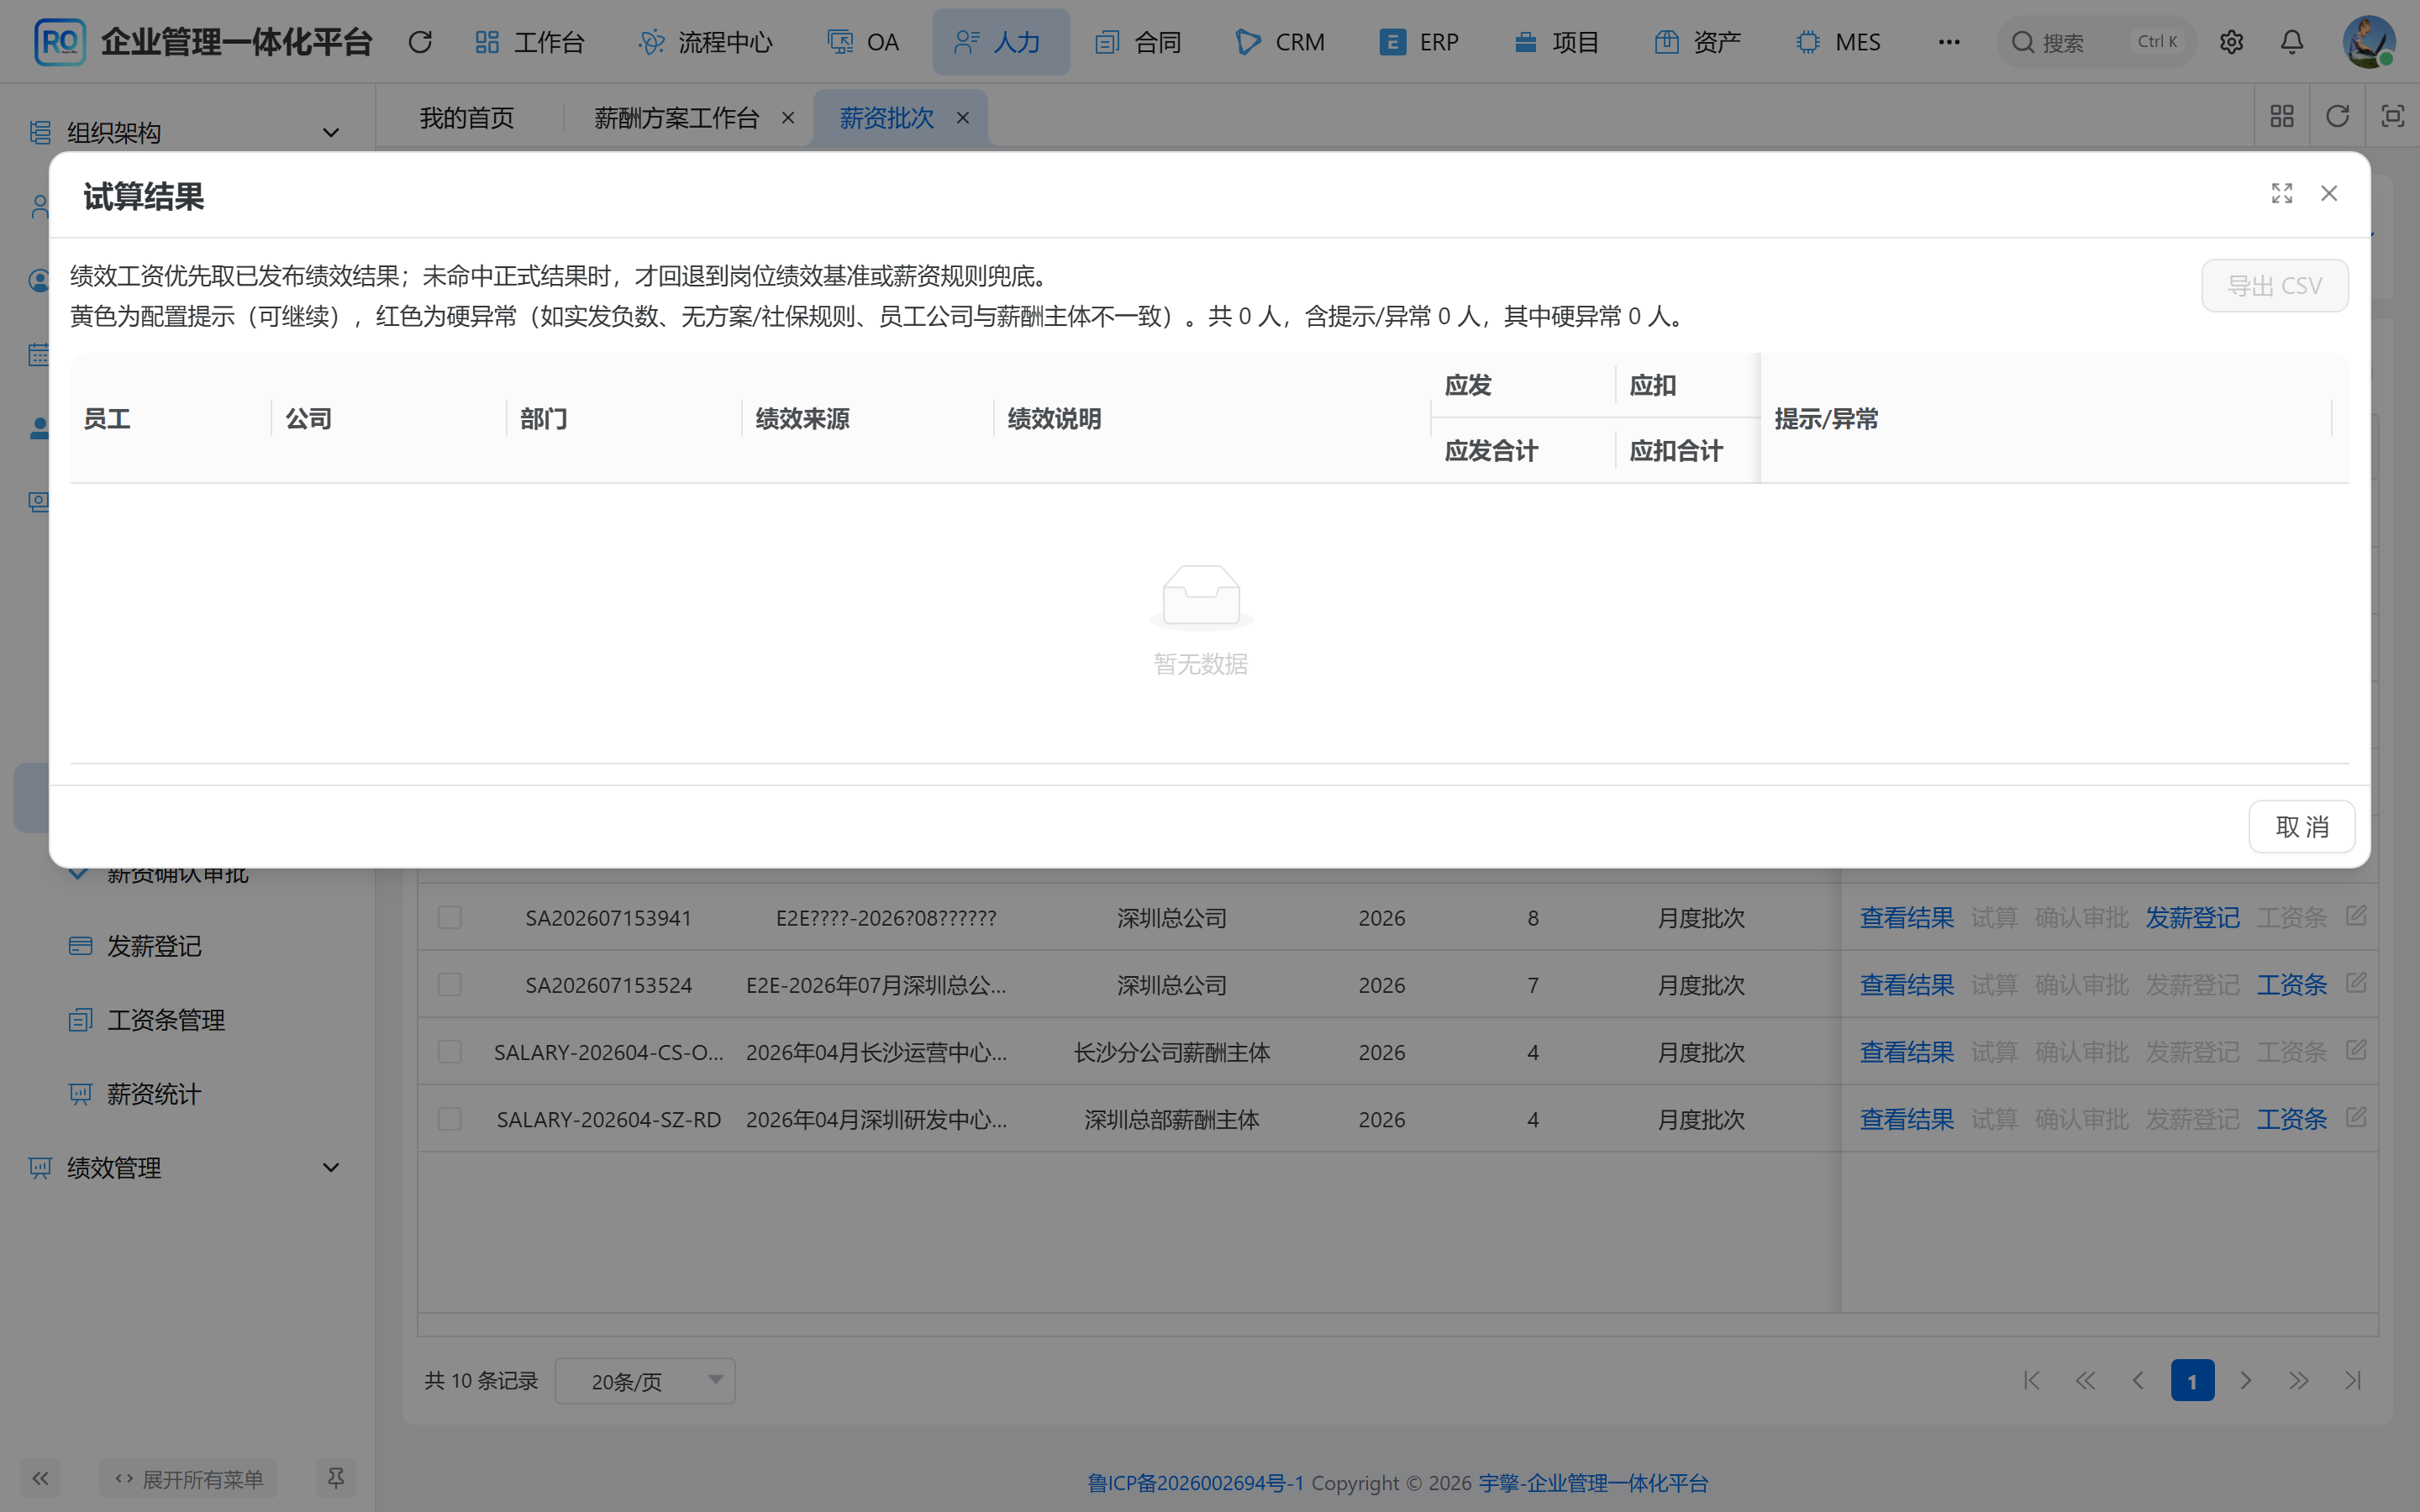
▲ 本地工资批次页面用于展示试算结果和批次状态;示例中的数字解释计算方法,不替代政策口径。
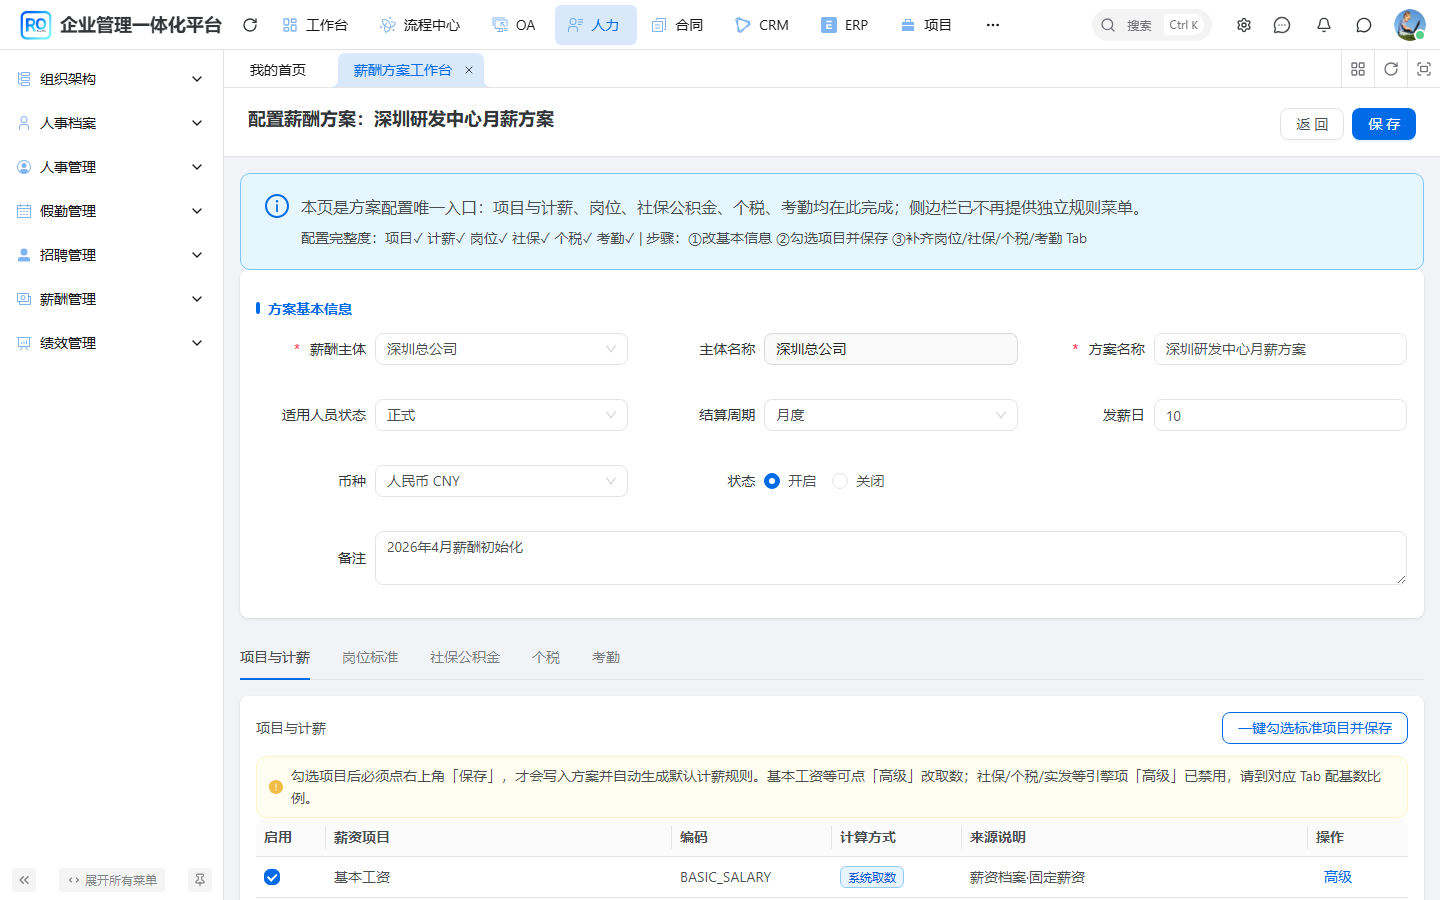
▲ 方案工作台把计薪项目、岗位、考勤、社保公积金与个税配置收拢到一个入口;核算批次仍需按期间读取已生效规则。
如果只展示 9,500,员工无法判断 2,000 元扣项是什么。
如果只展示 10,000 + 2,000 - 500 - 2,000,财务又无法知道扣项来自什么事实。
所以每个项目最好同时保存:
- 项目编码或稳定身份;
- 计算金额;
- 所属期间;
- 规则版本或来源;
- 需要人工处理时的异常说明。
4.1 计算方法要做两次校验
第一次校验在批次开始前,确认参与员工、薪资主体、期间和方案关联。
第二次校验在员工计算过程中,确认版本、岗位标准、考勤和绩效是否满足项目需要。
前置校验能避免一批明显错误的计算。
员工级校验能把具体问题定位到人,而不是只返回"批次失败"。
4.2 计算快照让结果能够被复核
源码在员工结果中保存 calcSnapshotJson。
快照不是把所有数据库表复制一遍,而是保存足以解释本次金额的输入摘要和结果上下文。
快照应当避免包含不必要的敏感信息。
工资系统尤其要控制访问权限、日志输出和导出范围,不能因为"方便调试"就把完整身份证、银行卡等内容写进普通日志。
4.3 规则缓存不等于规则永久有效
服务实现会对薪资项目、规则、社保、个税和考勤规则做批次内缓存。
缓存解决的是同一批次反复读取相同配置的问题,不是把规则冻结成永远有效。
批次开始后,如果管理员修改了方案,当前批次是否允许继续使用旧缓存,应由批次生命周期决定。
更稳妥的做法是:试算批次绑定开始时解析到的版本,方案修改只影响未来批次,已经确认的批次不能被下一次查询覆盖。
这也解释了为什么"清缓存再算一次"不能成为薪酬问题的通用答案。
如果没有明确版本和重算记录,重新计算只是把当时的事实和今天的规则混在一起。
五、把"缺数据不等于零"落实到代码
下面摘录 calculateEmployee 的关键前置检查。
它对应的产品规则是:找不到员工档案、用户或薪酬方案时,结果要带异常,而不是静默生成一张看似正常的工资单。
java
List<String> exceptionTags = new ArrayList<>();
List<SalaryBatchEmployeeItemDO> items = new ArrayList<>();
if (employee == null) {
    exceptionTags.add("未找到员工档案");
} else if (employee.getUserId() == null
        || !Boolean.TRUE.equals(employee.getUserGenerated())) {
    exceptionTags.add("未生成系统用户,无法计算考勤相关薪资项");
}
if (archive.getSalaryPlanId() == null) {
    exceptionTags.add("未配置薪酬方案");
    return buildEmptyResult(items, exceptionTags);
}
List<SalaryPlanItemDO> planItems = planItemCache.computeIfAbsent(
        archive.getSalaryPlanId(),
        salaryPlanItemMapper::selectListByPlanId);
if (planItems.isEmpty()) {
    exceptionTags.add("方案未配置项目或方案已删除");
    return buildEmptyResult(items, exceptionTags);
}
这段逻辑没有试图在一处解决所有问题。
它先判断能否继续计算,再把不能计算的原因保存下来。
后续页面可以按异常标签筛选,管理员也可以先修复员工档案或方案配置,再重新试算。
5.1 版本不在期间内时,结果仍要有结构
java
if (version == null || !isVersionEffective(version,
        periodStart, periodEnd)) {
    exceptionTags.add("期间无生效版本");
    return buildEmptyResult(buildZeroItems(planItems),
            exceptionTags);
}

AttendanceSummary attendanceSummary =
        buildAttendanceSummary(employee, periodStart, periodEnd);
PerformanceResultDO performanceResult =
        resolvePerformanceResult(employee, periodStart, periodEnd);
if (attendanceSummary.available
        && attendanceSummary.recordCount == 0
        && matchAnyPlanItem(planItems, "缺勤", "ATTENDANCE")) {
    exceptionTags.add("无考勤数据,缺勤扣款按全月缺勤测算");
}
返回零项目并不代表业务上"工资就是零"。
它只是让批次拥有统一的结果结构,方便页面显示具体异常并阻止误确认。
在实际产品中,还应明确哪些异常可以带着试算结果进入复核,哪些异常必须阻断确认。
5.2 绩效结果迟到时,不能用静默默认值掩盖
绩效结果经常比考勤晚。
如果系统在绩效结果未到时直接把绩效项目写成 0,后续补录结果后就会出现"工资已经确认但规则又要改"的冲突。
可以把绩效项目设计成三种状态:
- 已命中:期间和员工匹配成功,金额可以进入核算。
- 待补齐:员工已纳入批次,但结果尚未回传,批次显示待复核。
- 不适用:该员工的方案没有绩效项目,明确记录不参与。
三种状态比一个数值字段更容易给操作人员解释,也更容易在导出时筛选。
5.3 将事实放进上下文,再计算项目
java
SalaryCalcContext context = new SalaryCalcContext(
        batch, archive, version, employee, positionRate,
        performanceResult, attendanceSummary);
BigDecimal basicSalary = resolveNamedItemAmount(
        planItems, ruleMap, "基本", "BASIC", context,
        firstPositive(version.getFixedSalary(),
                version.getFormalSalary(),
                version.getProbationSalary()));
context.putAmount("basicSalary", basicSalary);
context.putAmount("基本工资", basicSalary);
BigDecimal postSalary = resolveNamedItemAmount(
        planItems, ruleMap, "岗位", "POST", context,
        positionRate == null
                ? BigDecimal.ZERO
                : defaultValue(positionRate.getPostSalary()));
context.putAmount("postSalary", postSalary);
上下文让后续规则能够读取同一批次、同一员工和同一期间的事实。
规则方法只负责计算自己的项目,不需要在每个项目中重新查员工、再猜期间。
六、为什么需要员工级结果和批次级状态
批次级状态适合回答"这一批能不能进入下一阶段"。
员工级结果适合回答"哪一名员工存在异常,哪一项金额不同"。
6.1 批次状态不能隐藏个人问题
一批 500 人中,499 人正常、1 人缺少薪酬方案。
如果批次只显示"试算成功",财务容易误以为全部可确认。
如果批次只显示"失败",又无法快速定位正常结果。
建议同时展示:
- 参与人数和成功人数;
- 异常人数;
- 应发、扣款、实发总额;
- 异常标签分布;
- 可以继续复核的员工与必须先修复的员工。
6.2 确认时要冻结什么
确认不是把所有数据永久锁死。
它至少要冻结用于后续税务累计、发薪登记和工资条发布的结果口径。
源码的 confirmBatch 会检查批次已经试算且未确认、未发薪,然后把试算台账转为已确认。
这意味着后续月份累计预扣可以读取明确的确认结果。
java
public void confirmBatch(Long batchId) {
    SalaryBatchDO batch = validateSalaryBatchExists(batchId);
    if (!Objects.equals(batch.getCalcStatus(), STATUS_YES)) {
        throw exception(SALARY_BATCH_TRIAL_REQUIRED);
    }
    if (Objects.equals(batch.getApproveStatus(), STATUS_YES)) {
        throw exception(SALARY_BATCH_ALREADY_CONFIRMED);
    }
    if (Objects.equals(batch.getPayStatus(), STATUS_YES)) {
        throw exception(SALARY_BATCH_ALREADY_PAID);
    }
    salaryBatchMapper.updateById(new SalaryBatchDO()
            .setId(batchId)
            .setApproveStatus(STATUS_YES)
            .setConfirmTime(LocalDateTime.now()));
    employeeTaxLedgerMapper.updateStatusByBatchId(batchId, 1);
}
真正的企业流程还可能把确认动作交给 BPM 审批回调。
本文只引用服务中的状态门禁,不把它解释成财务审批已经由这段代码自动完成。
6.3 重新试算要记录"为什么"
重算可能来自输入补齐、规则修正或业务纠错。
如果只保存最后一次结果,事后很难判断金额变化是正常补数还是人为改规则。
建议在批次层记录重算次数、操作人、原因和前后摘要;员工层保留受影响项目的差异。
这类审计记录不必把整个工资表复制几十遍,但要能回答"谁在什么时候因为何种理由重新生成了结果"。
七、工资条是结果快照,不是重新计算页面
工资条发布时,应从已确认的员工结果和项目明细生成快照。
员工打开工资条看到的,应是该期间已经发布的结果,而不是今天重新执行一遍规则的结果。
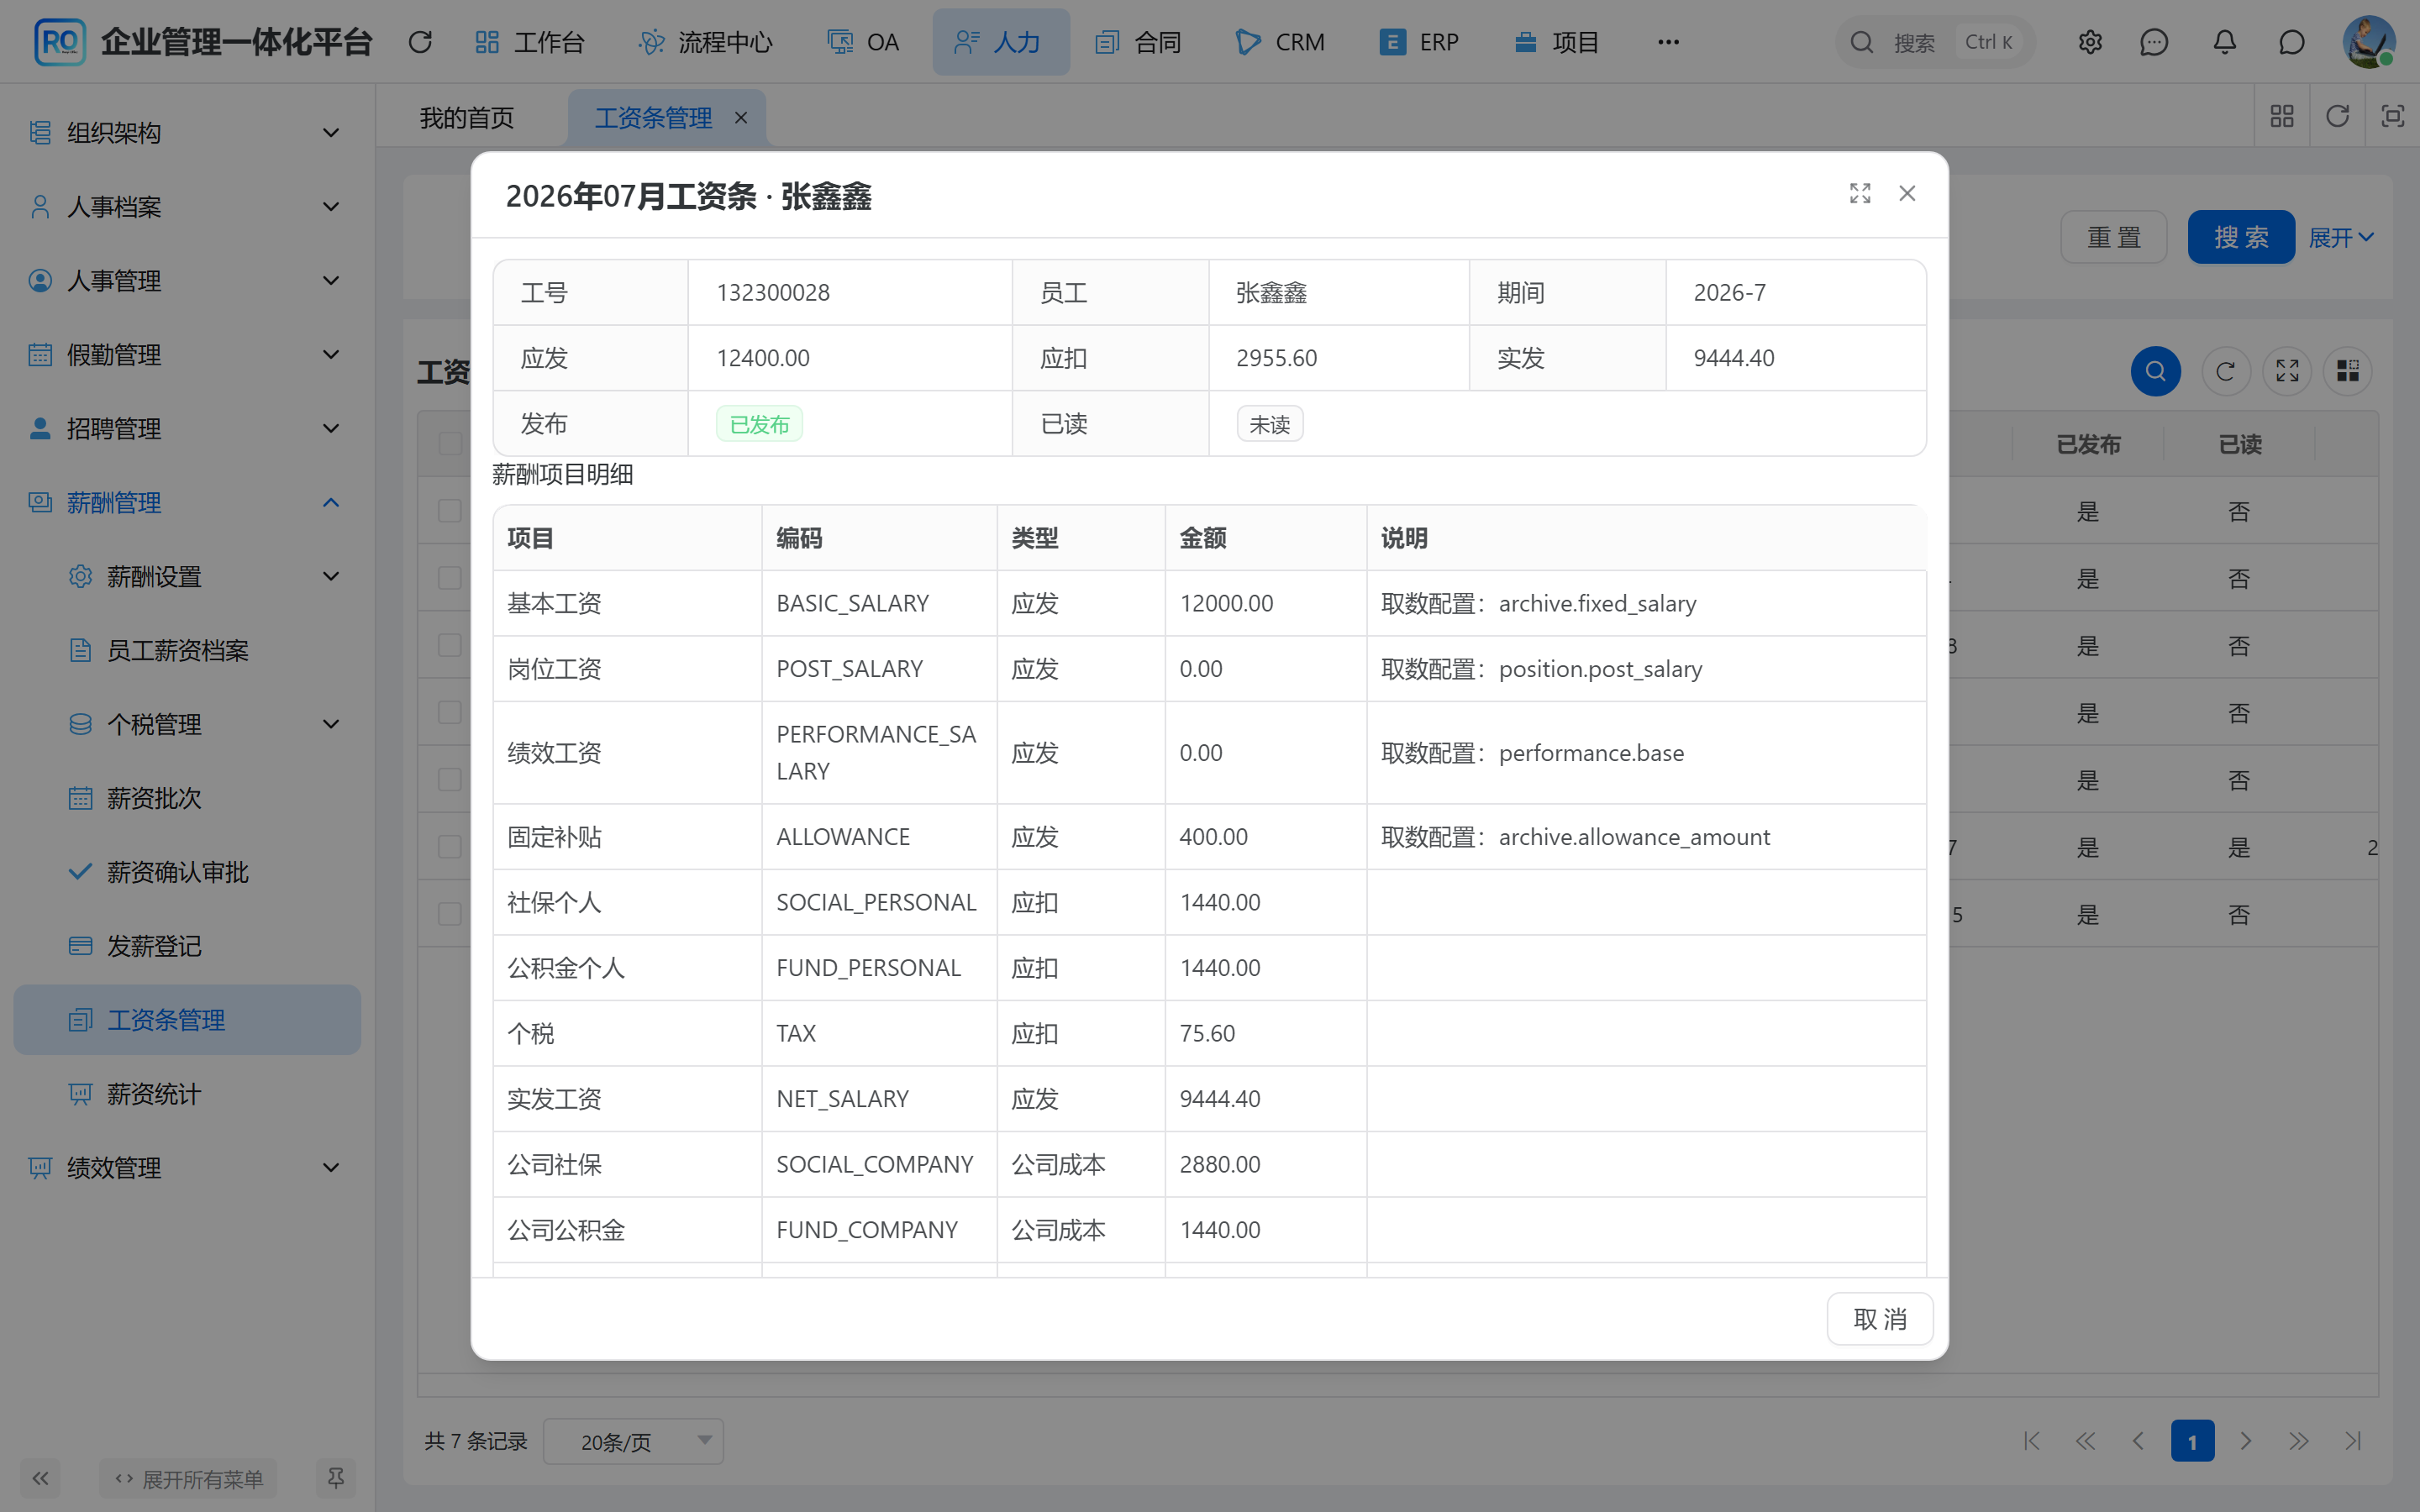
▲ 工资条页面用于展示发布结果。权限上应限制员工只能看到自己的已发布工资条。
发布过程的关键是把期间、员工、项目和汇总写入快照。
java
Map<String, Object> snapshot = new LinkedHashMap<>();
snapshot.put("batchId", batchId);
snapshot.put("employeeId", employee.getEmployeeId());
snapshot.put("employeeName", employee.getEmployeeName());
snapshot.put("periodYear", batch.getPeriodYear());
snapshot.put("periodMonth", batch.getPeriodMonth());
snapshot.put("items", itemList);
snapshot.put("summary", buildSummary(
        employee.getPayableAmount(),
        employee.getDeductAmount(),
        employee.getActualAmount(),
        employee.getCompanyCostAmount()));

SalaryPayslipDO payslip = new SalaryPayslipDO()
        .setBatchId(batchId)
        .setBatchEmployeeId(employee.getId())
        .setEmployeeId(employee.getEmployeeId())
        .setPeriodYear(batch.getPeriodYear())
        .setPeriodMonth(batch.getPeriodMonth())
        .setActualAmount(employee.getActualAmount())
        .setPublishStatus(STATUS_YES)
        .setSnapshotJson(JsonUtils.toJsonString(snapshot));
salaryPayslipMapper.insert(payslip);
如果重复调用发布方法,先清理同批次工资条再重新生成,是一种可见的幂等策略。
实际系统还应保证权限、事务、通知和读取状态与该策略一致。
7.1 本人查询必须同时过滤员工身份和发布状态
员工自助查询接口先从当前登录上下文取得员工 ID,再强制设置员工条件与已发布条件。
详情接口还要再次校验归属,不能只依赖前端列表传来的 ID。
这是一条通用安全规则:列表过滤不是详情授权的替代。
7.2 工资条不能泄露不该看到的字段
管理端可能需要看到公司成本、税务累计和异常来源。
员工本人通常只需要看到自己的应发、扣款、实发和项目说明。
同一快照结构不代表所有角色都可以读取全部字段。
建议将"计算快照"和"员工展示快照"区分访问层级,导出时再按权限裁剪。
7.3 工资条页面还要解释"本期"和"累计"
员工经常把本期扣税和年度累计混在一起理解。
页面最好同时标明工资期间、本期项目、累计收入和累计已缴税额的范围,避免把一个数字放到另一个语义下。
如果企业提供专项附加扣除,页面还应显示数据来源和生效期间,而不是只展示扣减后的结果。
这类信息涉及隐私,默认应按员工本人和授权财务角色隔离。
八、用一条时序线检查业务边界
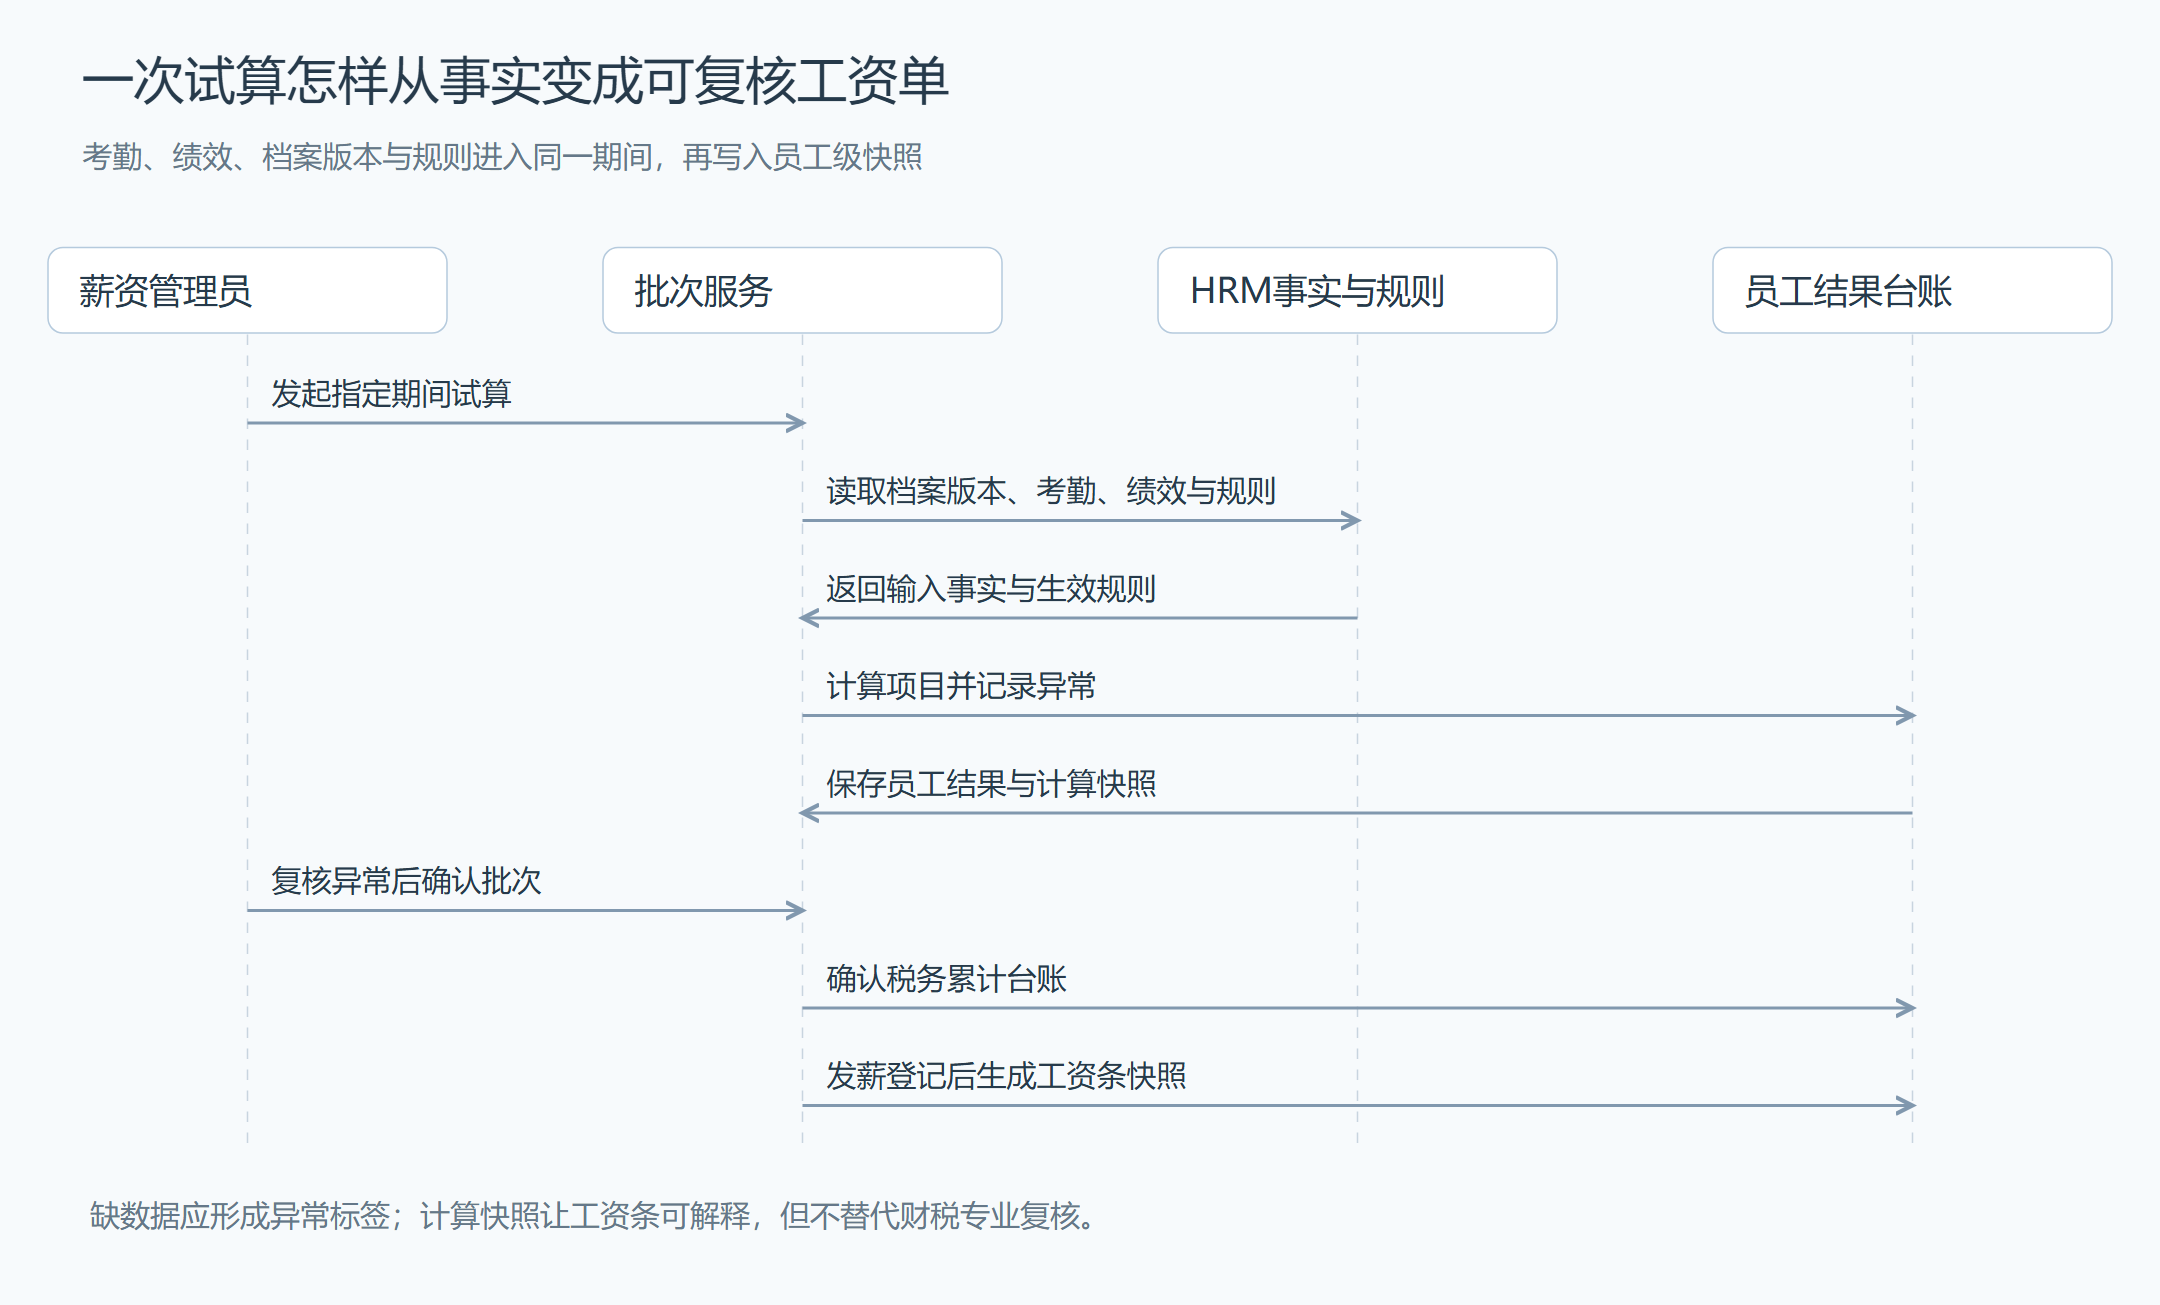
▲ 事实读取发生在试算,确认改变台账状态,发薪登记与工资条发布属于更晚的阶段。
这条链路里最重要的不是步骤数量,而是每个步骤的输入是否可追溯。
8.1 批次与员工的状态要能互相解释
批次显示"已试算"时,员工结果可能仍有异常。
批次显示"已确认"时,员工结果必须已经进入可作为税务累计依据的状态。
批次显示"已登记发薪"时,并不自动代表银行已经完成扣款,除非企业另有资金系统对接。
| 状态文案 | 读者应理解的含义 |
|---|---|
| 试算完成 | 本批次产生了结果,但可能存在异常 |
| 待确认 | 结果需要业务或财务复核 |
| 已确认 | 本批次口径被确认,可供后续阶段使用 |
| 已登记发薪 | 系统记录发薪动作,不等于银行直连成功 |
| 工资条已发布 | 员工可以按权限查看快照 |
如果页面把这些状态都简称为"完成",后续客服、财务和开发会分别给出不同解释。
8.2 试算失败后能不能安全重算
可以重算,但要先清理本批次旧结果,并明确重新计算的输入时间点。
如果考勤刚补录,重算应在操作记录中显示"为什么重新计算"。
确认之后则不应允许普通按钮再次覆盖结果。
8.3 规则变更后能不能追溯
规则表需要有生效期间或版本。
批次结果需要记录命中的方案和版本。
工资条需要保存发布时的展示快照。
三者组合起来,才能回答"今天打开规则页面"和"当时工资为什么这样算"之间的差异。
8.4 个税和社保不能只写成一个扣项
在产品层面,社保、公积金、个税往往有各自的城市、基数、上下限和累计口径。
如果为了快速上线把它们合成"其他扣项",短期看起来简单,后续就无法复核政策变化。
源码中把社保、个税和考勤规则分别放入缓存和计算上下文,说明它们需要不同的输入。
这不意味着系统替代财税专业判断,反而要求实施人员明确每个地区规则的来源和更新时间。
8.5 试算性能要靠批次内复用,而不是牺牲解释性
薪资批次可能包含几百甚至几千名员工。
方案项目、规则、城市政策和考勤规则适合做批次内缓存,员工档案也可以按员工 ID 复用读取。
但缓存键必须包含方案、城市和规则适用范围,不能为了命中率把不同员工的规则混在一起。
性能优化的目标是减少重复读取,不是删除快照、异常和来源字段。
对于耗时较长的批次,应把批次状态、处理进度和失败员工记录下来,让管理员知道系统是在计算、等待输入,还是已经完成。
九、如何设计异常复核台
异常复核不是把所有问题都变成红色标签。
它应该让处理人员知道:问题是什么、影响哪一项、修复后是否需要重算。
| 异常 | 影响 | 推荐动作 |
|---|---|---|
| 员工档案不存在 | 无法归属员工结果 | 补齐档案后重算 |
| 未生成系统用户 | 考勤相关项目无法计算 | 检查账号联动 |
| 无薪酬方案 | 无法确定项目集合 | 绑定方案后重算 |
| 期间无生效版本 | 金额基数不可信 | 修复生效日期 |
| 无考勤数据 | 缺勤项目可能被全月测算 | 核对同步并人工确认 |
| 绩效未回传 | 绩效项目无法解释 | 等待结果或走例外政策 |
异常页面最好支持按标签、部门和方案筛选。
也要保留原始输入,避免处理人员只看到一条泛化的"计算失败"。
9.1 复核台还需要一条"证据链"
处理人员点开一名员工时,页面不应该只返回最终应发金额,而应按时间顺序展示本次核算使用过的证据:员工在本期的组织与岗位、命中的薪酬方案版本、考勤汇总、绩效结果、每个薪资项目的公式输入,以及最后一次重算的操作者。这样做的价值是把"系统认为应该这样算"变成"系统根据这些事实这样算"。
可以将证据链拆成三层。第一层是事实快照,保存计算时读到的员工、考勤和绩效数据;第二层是规则快照,保存方案版本、项目顺序和关键参数;第三层是结果快照,保存应发、扣款、实发以及异常标签。三层都带有批次 ID 和员工 ID,查询时既能从结果向前追溯,也能从某条输入反查影响了哪些员工。
9.2 复核动作也应该有状态
复核并不等同于编辑金额。建议把动作分为"确认事实""要求补数""允许例外""重新试算"四类,并记录动作人、时间、原因和影响范围。财务人员确认某员工"本期无绩效"时,系统可以把一个缺失标签转为已确认的业务事实;但这不应偷偷修改原始绩效接口数据。
对于批量处理,复核台还要显示影响数量。例如补录一条考勤记录后,系统应提示有 18 名员工的迟到扣款需要重算,而不是让管理员凭记忆寻找受影响的人。通过影响范围提示,可以减少全量重算,也能降低误操作风险。
9.3 归档和保留策略要提前约定
工资批次完成后,原始导入文件、计算快照、工资条快照和操作日志的保留期限可能不同。原始文件适合按批次归档,工资条需要满足企业内部查询周期,审计日志则通常不能随业务删除一起消失。设计时至少要把"可见性""可重算性""可删除性"三个维度分开配置。
如果系统使用对象存储保存工资条 PDF,还应在数据库保留文件摘要和生成批次。文件被替换时,旧版本不能静默覆盖;访问链接也应经过本人或授权角色校验。这样既便于员工下载,也避免因为一个公开 URL 泄露整批工资信息。
十、配置与验收清单
建议在演示或实施验收中至少完成以下场景:
- 同一员工存在试用、转正两个版本,验证期间选择。
- 有考勤数据但缺勤为零,验证不应误报为无考勤。
- 完全没有考勤数据,验证异常标签和扣款策略。
- 绩效结果缺失,验证是阻断、预估还是待复核。
- 试算后修改方案,验证批次是否要求重新试算。
- 确认后尝试再次试算,验证状态门禁。
- 发布工资条后员工只看见自己的结果。
- 重复调用发布入口,验证不会出现两份有效工资条。
这些场景比单纯检查"工资算出了一个数"更能发现系统边界。
十一、快速体验
在线演示地址为 https://ruoyioffice.com/web/,账号 admin / admin123。
建议进入 HRM 的薪酬方案、工资批次和工资条页面,按"方案---批次---员工结果---工资条"的顺序查看。
本地开发时,后端使用 Spring Boot 3.5 工程,前端使用 Vue3 管理端;先准备数据库和基础数据,再启动服务。
本文核对的主要源码是 SalaryBatchServiceImpl 的 runTrial、calculateEmployee、confirmBatch 和 publishPayslips。
已有薪资发放文章覆盖双审批与幂等发布,本文刻意把重心前移到输入事实、规则版本和异常可解释性。
常见问题
工资计算为什么一定要保留快照?
因为规则和员工档案会变化,实时重算无法保证复现上次发布结果。
快照保存关键输入和结果,便于复核、申诉和审计。
没有考勤数据时应该按零计算吗?
不能直接等同。
无记录可能表示接口尚未同步,零记录才可能表示本期没有缺勤。
系统至少应形成异常标签,并由企业规则决定是否阻断确认。
试算结果和工资条有什么区别?
试算结果属于批次复核阶段,可能存在异常和待确认输入。
工资条是发薪登记后面向员工发布的结果快照,访问权限和字段范围也不同。
修改薪酬方案后,历史工资会自动变化吗?
不应依赖当前方案自动重算历史工资。
批次、员工结果和工资条应记录适用期间及快照;历史修正需要受控重算和审计。
这套设计能直接推导税务结论吗?
不能。
软件可以保存城市、期间、规则和累计台账,但税率、扣除政策和劳动法规应由企业财务与专业顾问确认。
结语
可解释的工资单不是多显示几行项目,而是让每个数字都能回到同一期间的事实、规则和版本。
当系统把批次、员工结果、项目明细、异常标签和快照分开管理,薪酬核算才真正具备复核能力。
如果这篇对你有用,点个「在看」或收藏。
🌐 演示地址 :https://ruoyioffice.com/web
📦 GitHub 源码 :https://github.com/yuqing2026/ruoyi-office
📦 Gitee 源码 :https://gitee.com/yqzy1688/ruoyi-office
💬 微信:17156169080(获取产品咨询)
打开演示地址直接查看系统。