2026 年 9 月 22 日,Google 官方宣布其新一代文本转语音(Text-to-Speech, TTS)大模型正式进入 GA(General Availability,通用可用)阶段。本次发布涵盖了旗舰级创作者模型 Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) 、主打高吞吐与实时级联的 Gemini 3.8 Flash-Lite TTS (gemini-3.8-flash-lite-tts) ,以及一个关键的基础设施端点 ------ Gemini API Voices 端点 (/v1beta/voices)。
表面上看,这似乎只是各家大模型厂商常规的"参数刷新"与"音质提升"。许多正在学习英语、或者已经用惯了免费开源工具(如 Edge-TTS)的开发者甚至会下意识地产生疑问:
"平时用来读个英文单词、听个新闻,现有的 TTS 早就足够流畅了,新模型宣称的'广播级高保真'、'细腻演艺(Nuanced Acting)'和'自然语言捏声音(Voice Design)',到底是不是厂商的极客自嗨?它真能解决实际问题吗?"
如果将这个问题放进一个极为真实的家庭与个人应用场景中,考量就会变得格外具体:
- 成人自身在进阶学英语,希望突破听力与口语天花板,搞定真实交际中的连读弱读、复杂语调与全球多样化口音;
- 家里有幼儿园大班(5~6 岁)的小朋友需要英语启蒙,注意力极难集中,面对死板生硬的机械发音完全提不起兴趣;
- 正在考虑自制双语学习音视频(例如中英双语卡片、绘本故事广播剧),用内容创作反哺自己和孩子的学习闭环。
在这样的复合场景下,Gemini 3.8 这套全新的 TTS 体系究竟有没有价值?价值到底有多大?它的技术红利落在何处,又存在哪些必须警惕的边界?本文将从底层技术演进、认知语言学规律以及音视频工程落地的多重视角,为你做一次彻底的技术与价值拆解。
一、架构跃迁:Gemini 3.8 语音合成到底带来了哪些实质性突破?
要衡量应用价值,首先必须厘清底层技术的范式转移。过去的云端 TTS(包括早期的神经网络 TTS 与部分大模型语音预览版)本质上是"文本发音机器":给定文本和音素映射,输出一条平滑但情感单一的声学波形。遇到复杂语境时,往往只能靠冷冰冰的 SSML(语音合成标记语言)标签去死板地微调停顿和音高。
Gemini 3.8 语音大模型的 GA,标志着语音合成正式从"机械朗读"跨入**"声优演艺与声音资产解耦"**的新阶段。
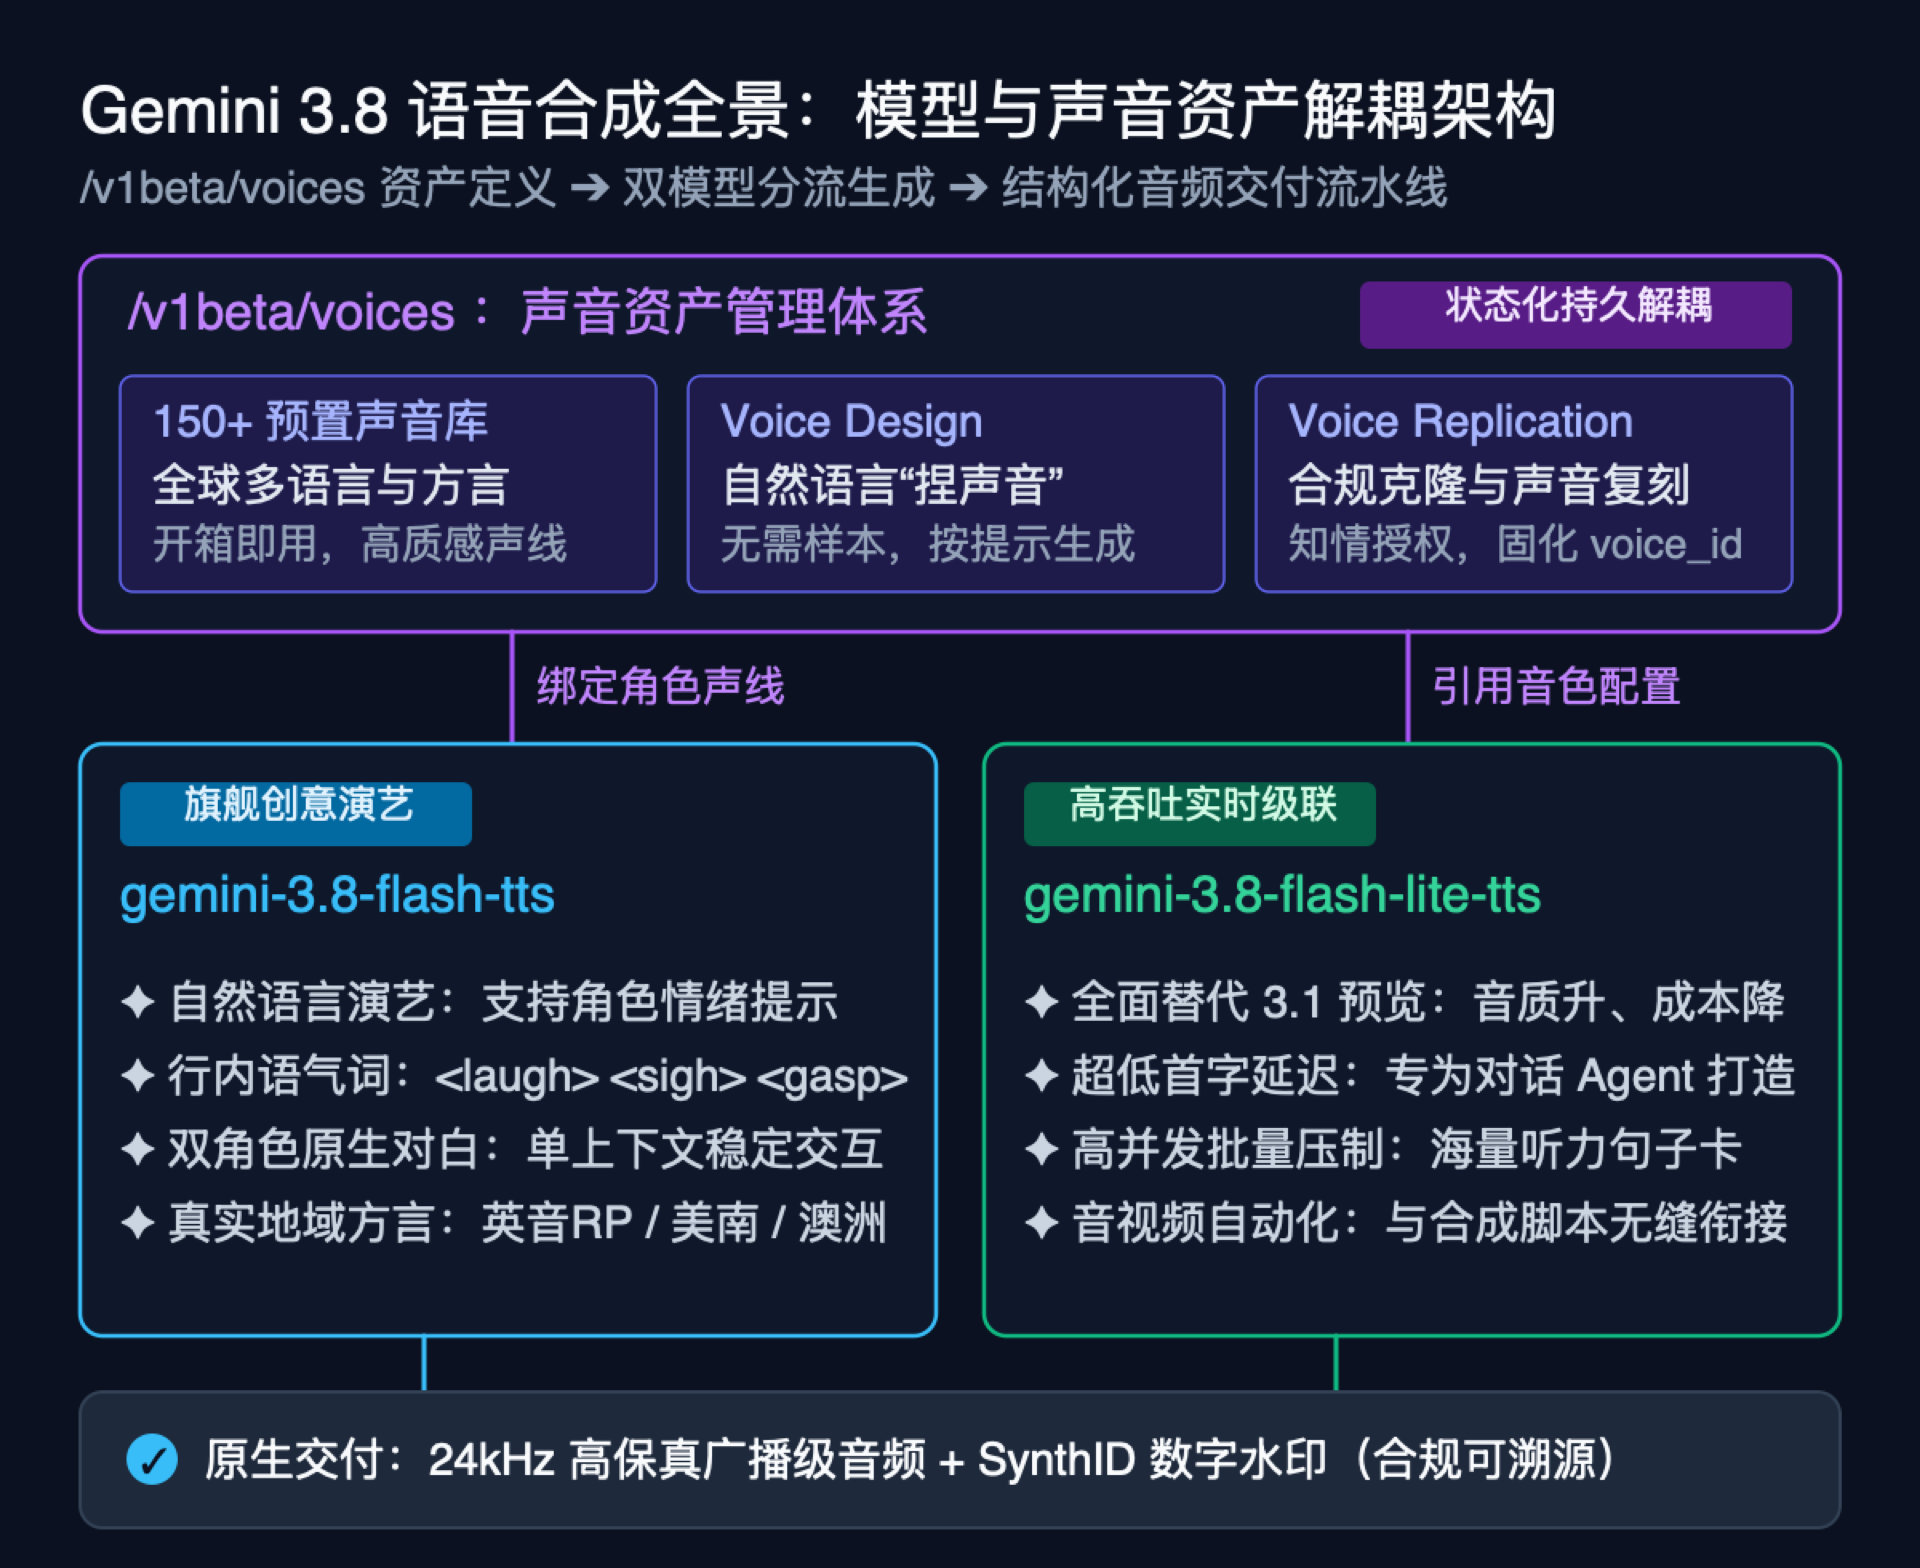
图 1 核心认知发现:注意上图中部紫色框出的 /v1beta/voices 声音资产层,Google 将音色设定从底层推理引擎中彻底剥离,形成了"文本设计声线 ➔ 双模型分流生成 ➔ 广播级音频交付"的解耦架构。
1. 双模型分工:创意旗舰与实时工程的精准解耦
Gemini 3.8 并没有采用单一体积的模型去强行通吃所有场景,而是清晰地划分为两套并行的引擎:
-
Gemini 3.8 Flash TTS (
gemini-3.8-flash-tts) :定位为旗舰级创意声学模型。它的核心指标不是极限推理速度,而是声音表现力(Expressiveness)、角色演技(Nuanced Acting)与长文本多轮稳定性。它能原生解析文本蕴含的情感张力,精准模拟各种地域方言韵律(如英国标准 RP、美式南部口音、澳洲口音),并在几千字的长篇叙事中始终保持音质与音色的高度一致。
-
Gemini 3.8 Flash-Lite TTS (
gemini-3.8-flash-lite-tts) :定位为高吞吐、低成本的工业级替代品,旨在全面替换此前的
gemini-3.1-flash-tts-preview。它针对端到端语音智能体(Voice Agent)的实时级联进行了深度优化,大幅降低了首字生成延迟(TTFT),在保证清晰发音的前提下将单位计算成本压至极低。
2. 声音生命周期重构:/v1beta/voices 体系的资产化
过去使用 TTS 最让人头疼的问题之一,是音色的"一次性"与"被动挑选":厂商给你几十个写死的名字(如 Alice、Bob),你只能在下拉框里选。如果需要一个"既温暖又带一点滑稽语调的鸭子警官",必须四处搜寻声音克隆工具。
全新的 /v1beta/voices 端点彻底颠覆了这种模式,提供了三大维度的声学资产支持:
- 150+ 官方预置声音库(Curated Voices Library):开箱即用,覆盖全球数十种主流语言、地域口音(英音 RP、美式南部、澳洲、苏格兰、印度等)与丰富的情感基调,彻底摆脱过去云端 TTS 仅有屈指可数几个固定音色的尴尬;
- Voice Design(自然语言"捏声音") :开发者无需提供音频样本,只需通过自然语言 Prompt(例如:
"A 35-year-old British female kindergarten teacher, speaking warmly, patiently, and with gentle rhythmic pauses"),即可在毫秒级内凭空创建出一个具备专属辨识度的虚拟声音人格; - Voice Replication(合规声音克隆):支持基于短音频样本复刻特定声线,但强制集成了知情授权验证(Consent Verification),兼顾了个性化需求与安全合规;
- 持久化与无状态的双模存储 :在创建声音时,支持声明
store=True(状态化模式,由平台持久托管并返回全局唯一的voice_id)或store=False(无状态模式,返回客户端保管的加密voice_key)。这意味着创作者可以永久锁定某个 IP 角色的声线,跨项目、跨周期随时复用。
3. 指令驱动演艺与原生行内语气事件(Inline Vocal Events)
以往的 TTS 哪怕声线逼真,听久了依然能被人类耳朵敏锐地识别为"机器味",根源在于真实人类交际中充满了极其微小的副语言现象(Paralinguistics):叹气、轻笑、倒吸凉气、停顿沉思。
Gemini 3.8 Flash TTS 原生支持了两项极具杀伤力的能力:
- 导演级演艺提示词 :在请求文本中,可以直接给出情绪与情境指示(如:"带着悬疑与神秘感轻声耳语,随后突然爆发出惊喜的语调"),模型能够自然调节动态基频范围(F0 Contour)与语速节奏。
- 行内语气词事件(Inline Vocal Tags) :文本中可以直接嵌入
<laugh>、<sigh>、<gasp>、<giggle>、<cough>等标签。模型在合成时会将这些生理声音与前后语音波形进行无缝声学融合,彻底告别了传统人工后期切片贴音效时的生硬割裂感。 - 单上下文双角色原生对白:单次 API 请求即可支持两个说话人交替对白,各自绑定不同角色声线,模型在同一个推理窗口内自主维持多角色的音调平衡与交互节奏。
二、场景价值实测:两代人英语学习与自制视频的四象限评估
搞清了技术底层,回到本文的核心命题:对于成人学英语、幼儿大班启蒙,以及自制音视频辅助教学,这套工具到底有多大价值?
我们可以将技术特性与两代人的真实学习痛点相映射,提炼出如下的价值评估四象限矩阵:
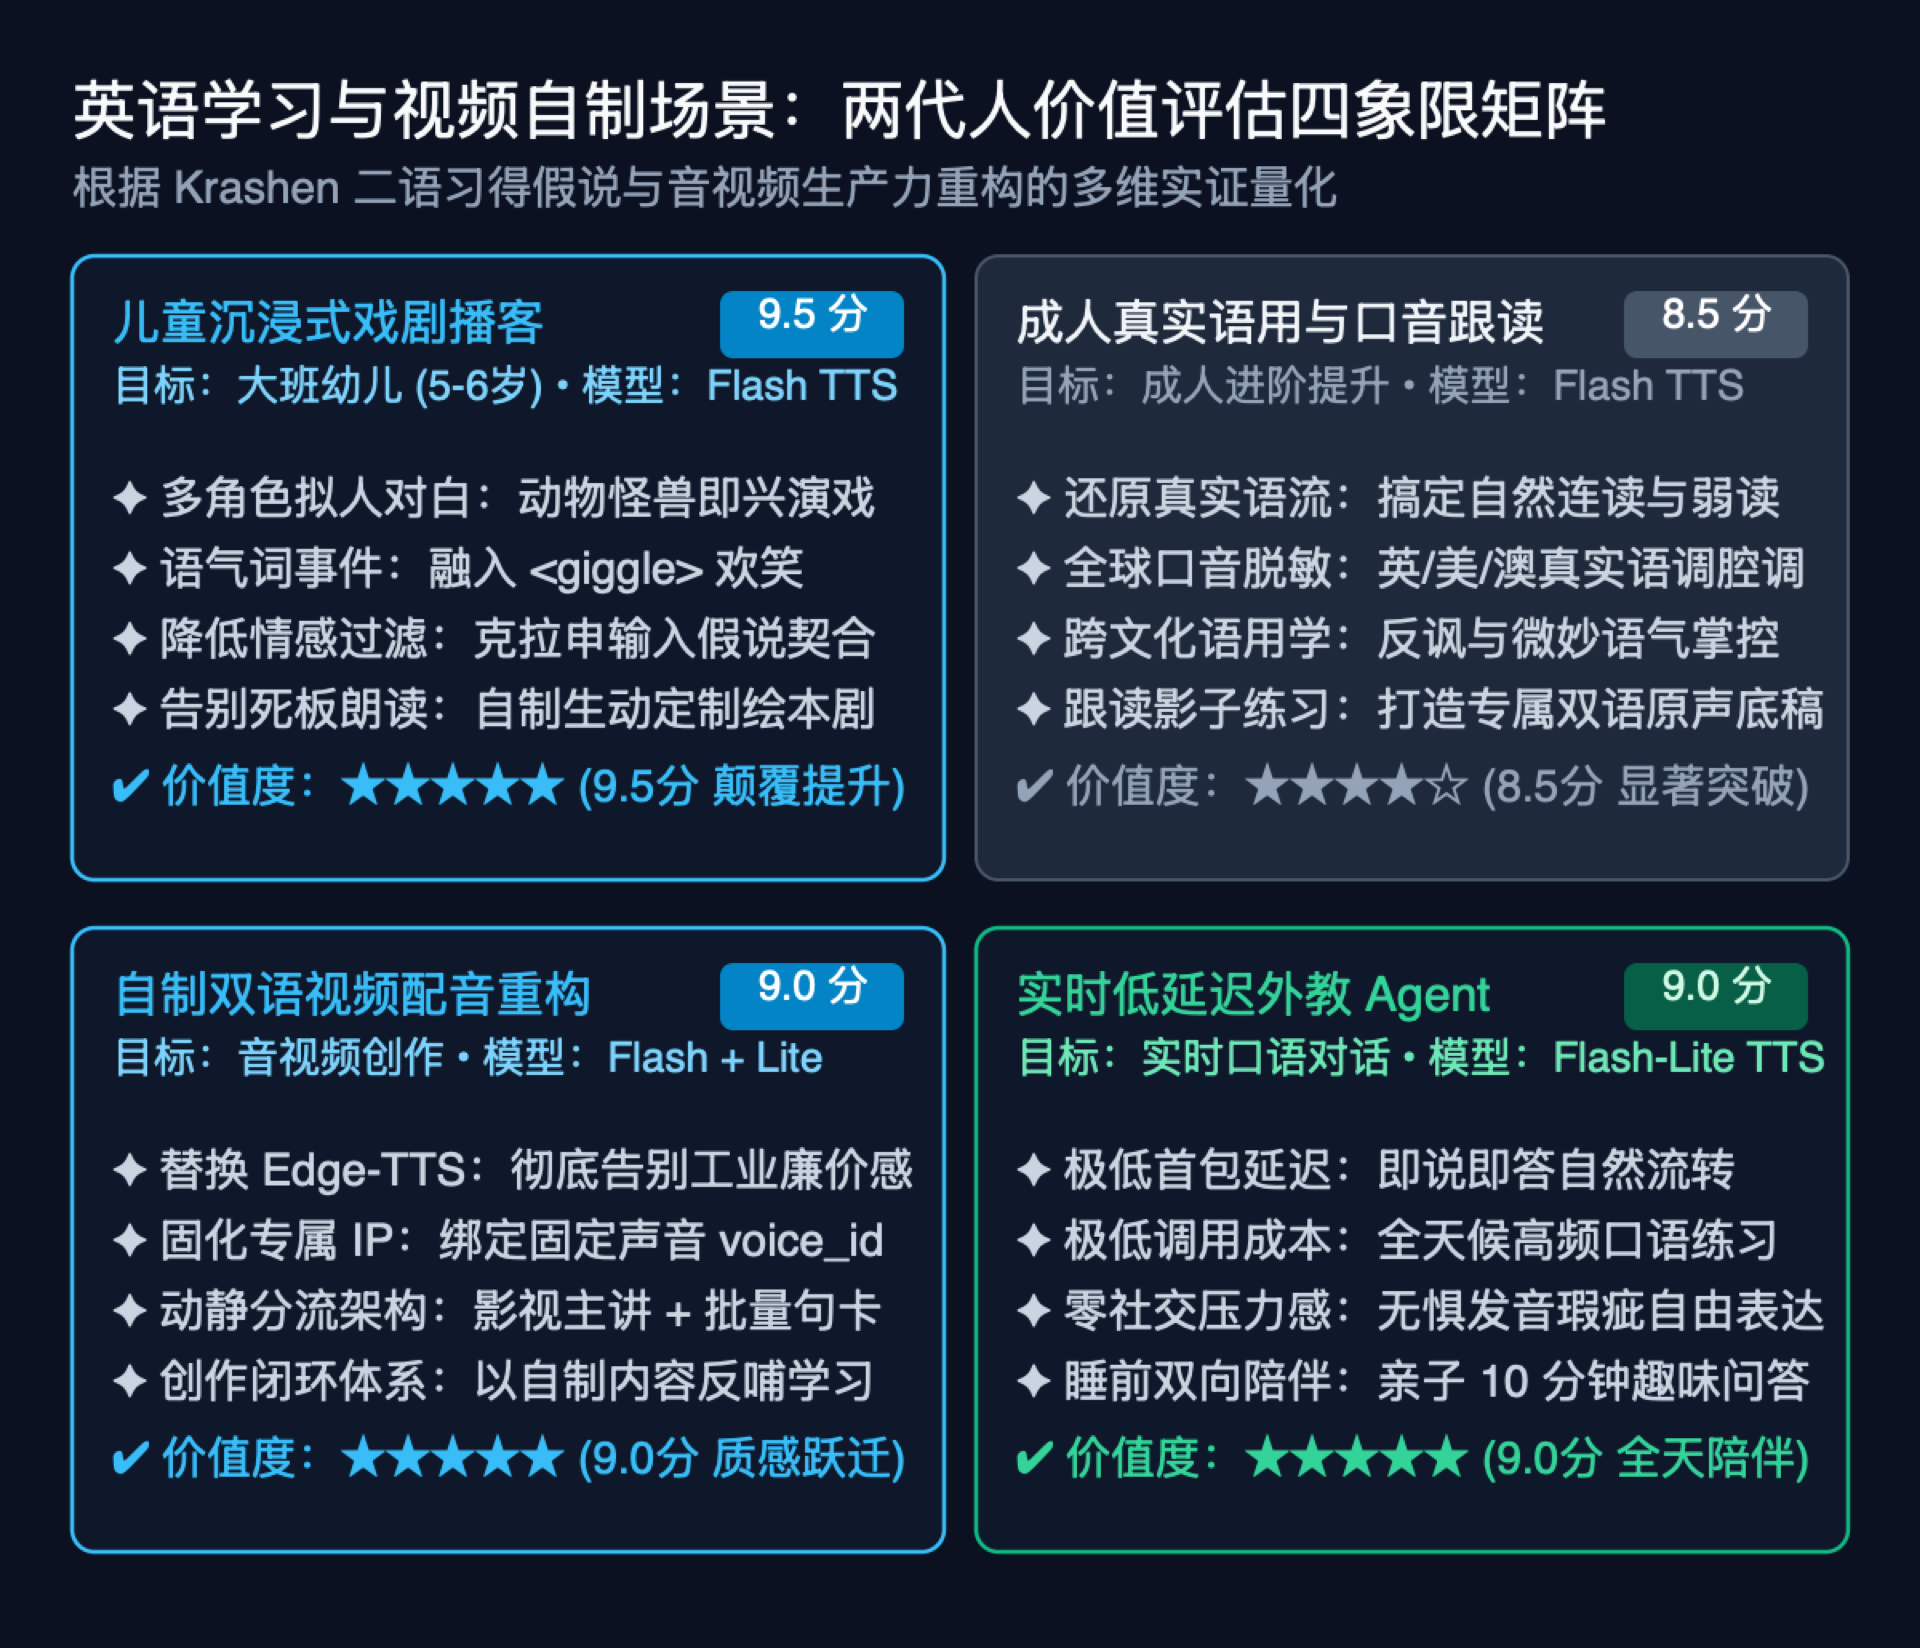
图 2 核心认知发现:注意左上角蓝色高亮的"儿童沉浸式戏剧"与左下角的"自制视频重构",在结合了自然语言演艺与行内语气词后,价值跃迁最为彻底(评分达 9.0~9.5)。
场景一:幼儿园大班(5~6 岁)英语启蒙 ------ 价值度:★★★★★ (9.5 / 10)
如果说在某些成人领域,新模型的提升只是"从 80 分到 90 分",那么在 5~6 岁幼儿英语启蒙场景中,Gemini 3.8 Flash TTS 几乎是一场颠覆性的降维打击。
1. 认知语言学痛点:幼儿的情感过滤屏障极低
根据应用语言学大师斯蒂芬·克拉申(Stephen Krashen)的"二语习得理论",幼儿阶段的语言习得不依赖元语言语法分析,而是完全由**可理解性输入(i + 1 原则)与情感过滤假说(Affective Filter Hypothesis)**驱动:
- 5~6 岁的幼儿对枯燥平铺的语音具有天然的免疫排斥性;
- 传统的 Edge-TTS 或标准云端语音,其基频曲线极其平缓,即便选了女声或童声,本质上依然是"新闻播音员"的调性。孩子听不到两句就会注意力涣散,产生抵触心理(情感过滤屏障拉高);
- 幼儿真正着迷的是极具戏剧冲突的语调、夸张的声音起伏、以及具备鲜明性格特征的拟人化角色(这就是为什么《小猪佩奇》和迪士尼动画能牢牢抓住孩子)。
2. Gemini 3.8 的破局点:零成本自制"儿童有声剧场"
借助 gemini-3.8-flash-tts 的 Voice Design 与演艺指令,家长完全可以为大班的孩子打造"定制化绘本有声剧":
- 角色个性即时捏合:用一段 Prompt 设定一个"憨厚笨拙的棕熊先生(声线低沉、语调缓慢而温柔)"和一个"调皮捣蛋的松鼠皮皮(高频清脆、语速飞快、经常咯咯笑)";
- 把真实生活编成故事 :孩子今天在幼儿园丢了水杯?让 LLM 编一个 150 词的简单英文故事,脚本中加入
<gasp>(发现水杯不见时的倒吸凉气)和<giggle>(最后在滑梯下找到时的开心傻笑); - 孩子的大脑反应完全不同:当声音富含丰富的情绪韵律时,幼儿的大脑听觉皮层与情绪中枢会被深度激活。孩子会误以为是在听一部活生生的动画短片,并在不知不觉中跟读模仿。
在这一维度上,新模型将以往只有专业团队耗费数千元配音费才能做出来的儿童广播剧,直接降维成了普通家庭几分钱、几秒钟就能生成的高效资产。
场景二:成人自身英语进阶与听力破局 ------ 价值度:★★★★☆ (8.5 / 10)
对于成人学习者而言,基础单词和语法往往不是瓶颈,真正的"深水区"在于对真实语流连读弱读的感知 与跨文化语用含义的领会。
1. 突破"考试录音棚英语"的虚假安全感
许多成人在听国内英语考试(如 CET、托福、雅思官方样题)时觉得听力不错,但一到真实海外工作场景或看原版脱口秀就瞬间失灵。核心原因在于:
- 标准化考试为了听力公平性,刻意抹去了方言特征,并人为压制了自然连读、爆破省略与语流吞音(Elision);
- 而真实世界充斥着澳洲口音的鼻音化、美式南部的拖长音、印度口音的齿龈音置换,以及英音非标准区域的喉塞音(Glottal Stop)。
2. 演艺模型带来的高阶训练法
Gemini 3.8 Flash TTS 的方言韵律与语用支持,为成人提供了绝佳的"脱敏训练环境":
- 多口音精准变奏:同一段商务谈判文本,可以通过 Prompt 分别指定为"带有地道纽约节奏的快语速"与"带有苏格兰口音的严谨调性",针对性训练听力辨析度;
- 微妙语用学(Pragmatics)体验 :同一句
"Oh, really? I didn't know that.",通过控制演艺指令,可以分别合成出"真诚求教的惊讶"、"充满嘲弄与反讽的冷笑(配合<sigh>)"以及"职场中不耐烦的敷衍"。这对需要提升跨文化交流情商的高阶学习者来说,价值不可替代; - 实时低延迟口语陪练(Flash-Lite 赋能) :借助
gemini-3.8-flash-lite-tts的超低延迟,开发者可以搭建出完全属于自己的私人实时对话 Agent。它响应极快,并且由于是 AI,使用者无论发音多烂、思考多慢,都完全不存在面对真人外教时的心理羞怯感与社交压力。
场景三:自制双语音视频内容创作 ------ 价值度:★★★★★ (9.0 / 10)
在个人内容创作或辅助自学的管线中,很多创作者(包括本项目此前积累的轻量双字幕视频工作流)通常面临一个核心尴尬:视频画面做得挺好看,但配音一旦用上了 Edge-TTS,整条视频立刻充斥着浓重的"工业廉价感"。
1. 彻底升级现有音视频生产流水线
如果你正在考虑自制音视频来协同学习(例如制作双语对照句型卡片、儿童睡前双语故事视频),Gemini 3.8 的双模型组合提供了一套极其优美的工程流水线:
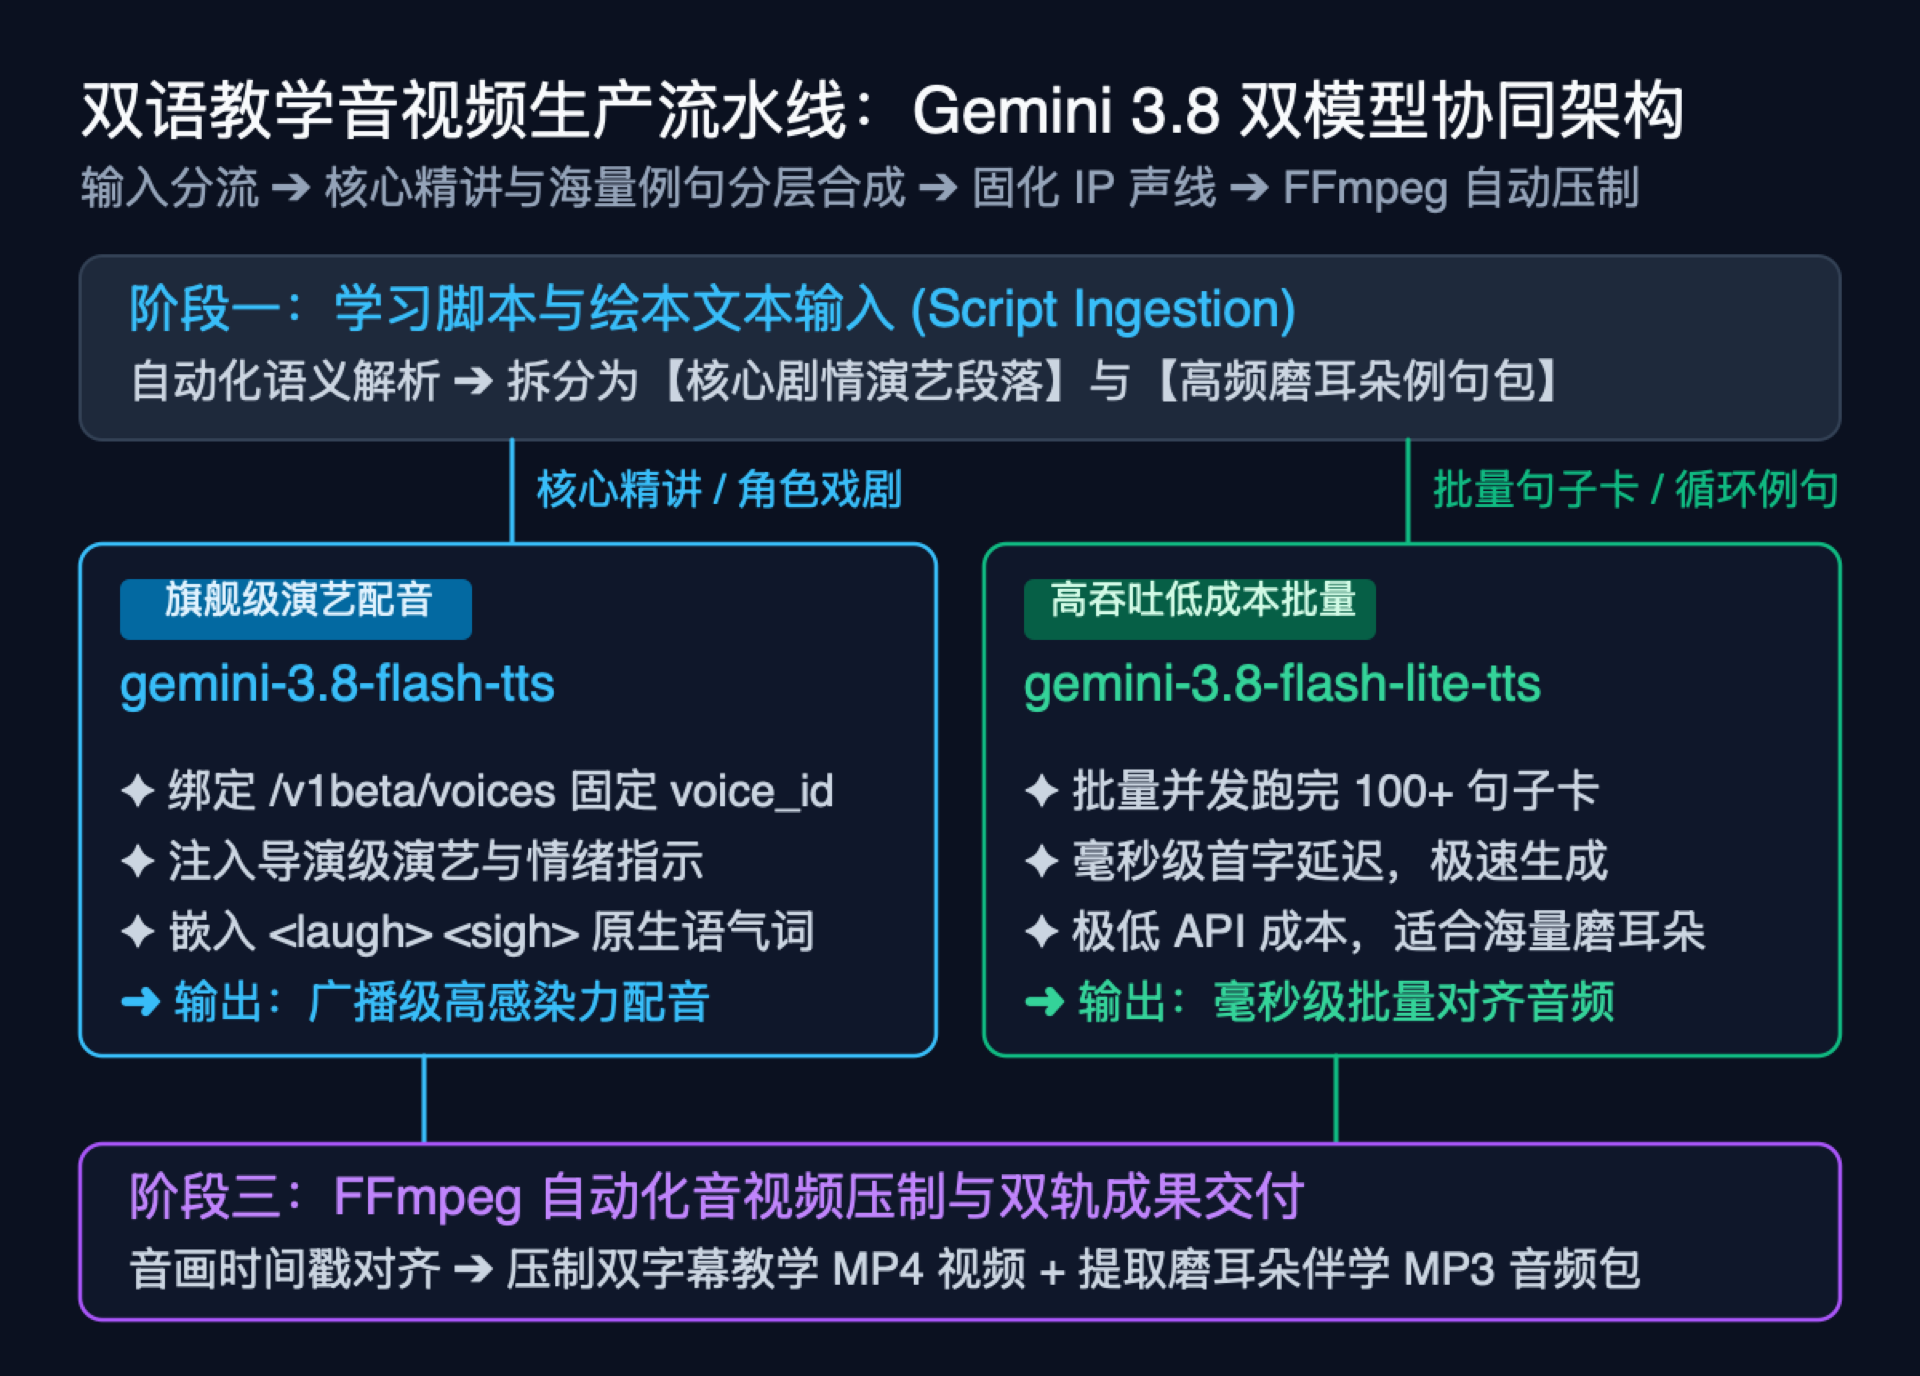
图 3 核心认知发现:在音视频合成流水线中,通过 /v1beta/voices 固化的 voice_id 确保 IP 声线稳定,核心剧情与精讲调用 Flash TTS 赋予表演张力,海量例句卡分流至 Flash-Lite 低成本批量压制。
- 固定频道"专属外教 IP" :利用
/v1beta/voices的Voice Design创建一个专属的教师声音(比如叫 Leo 老师),并将voice_id固化在配置文件中。无论你输出 10 期还是 100 期视频,这个虚拟角色的音色、语气、语速基调都能保持绝对一致,极大增强自制教学视频的品牌感和专业度; - Flash 与 Flash-Lite 的动静结合 :
- 视频开篇的 Hook、核心剧情演绎、角色对白等对情感要求极高的核心内容,调用 Flash TTS 注入精细演艺;
- 视频末尾的单词复习、例句逐句循环磨耳朵,切换到 Flash-Lite TTS 批量跑完,兼顾质量与成本。
三、横向对比:Gemini 3.8 与主流语音方案的现实差距
为了避免盲目追新,我们需要将 Gemini 3.8 放在当前主流语音合成的真实格局中进行客观横向审视:
| 评估维度 | Edge-TTS (开源常用) | ElevenLabs (行业标杆) | OpenAI Audio (gpt-4o / tts-1) | Gemini 3.8 Flash / Flash-Lite |
|---|---|---|---|---|
| 接入成本 | 完全免费,免鉴权 | 商业收费,较贵 | 按 Token / 字符收费 | Gemini API 标准计费 (Lite 极低) |
| 角色演艺控制 | 无(仅简单微调语速音高) | 强(支持情感与微调) | 中等(内置几种固定音色) | 极强(原生 Prompt 演艺指导) |
| 行内副语言事件 | 不支持 | 部分支持(需特殊引导) | 不支持独立行内标签 | 原生支持 (<laugh>, <sigh> 等) |
| 单上下文双人对白 | 需分段请求后人工拼接 | 需分段请求或复杂项目流 | 单次请求单角色 | 原生支持单请求双角色对话 |
| 声音资产解耦 | 无(写死固定音色名) | 强大声音库与克隆 | 仅固定预置声音(Alloy等) | /v1beta/voices 文本捏音与持久化 |
| 生成延迟 | 本地极快 | 中等 (~500ms+) | 中等 | Flash-Lite 专为低延迟 Agent 优化 |
| 水印与合规性 | 无 | 支持合规检测 | 无独立公共水印规范 | 内置 Google SynthID 音频水印 |
从对比中可以清晰地看出:
- 如果你只是需要在本地命令行工具里快速把一个单词读出来,Edge-TTS 依然是无成本、无鉴权开销的轻量首选;
- 但如果你要做的是儿童戏剧故事、高质感自制教学短片、具有情感温度的角色互动 ,Gemini 3.8 Flash TTS 凭借 Prompt 级演艺控制与
/v1beta/voices资产管理,展现出了碾压传统工具的综合优势,甚至在双角色对白与自然语言捏音的便捷度上超越了 ElevenLabs。
四、技术边界与现实清醒思考:它不是万能灵丹
尽管 Gemini 3.8 带来了惊艳的音质与表现力,但在家庭教育与个人学习的落地过程中,仍有三个必须清醒认识的技术边界:
1. 声音刺激无法替代父母的"共同注意"(Joint Visual Attention)
发展心理学与儿童二语习得领域有一个公认铁律:冷冰冰的音频输入(哪怕再富有感情)对幼儿语言能力的转化率,远低于真实人类的面对面交互 。
AI 生成的戏剧故事再精彩,它也无法看到孩子眼神中的困惑,无法在孩子指着画面提问时给出即时、温暖的情感回应。对于大班的孩子,Gemini 3.8 的正确用法是充当父母手头最强大的"备课与内容军火库",由父母陪着孩子一起听、一起哈哈大笑、一起角色扮演,而不是把孩子独自丢给 AI 听广播剧。
2. 听力输入并不直接等同于口语输出能力
优质的 TTS 能够为成人提供世界级的输入素材(Input),并提供精准的影子跟读(Shadowing)范本。但成年人学英语最大的死穴是"听得懂、脑子里有、嘴里倒不出来"。如果只把新模型当成高级听力机,你的语言组织能力依然不会发生根本跃迁。必须将 gemini-3.8-flash-lite-tts 与大模型的推理能力组装成双向交互的 Voice Agent,逼迫自己张嘴输出,才能真正兑现模型的价值。
3. SynthID 水印与平台发布规范
Gemini 3.8 生成的音频在声学频段中嵌入了 Google 的 SynthID 音频水印。该水印对人耳完全不可察觉,也不影响剪辑和压制,但它能够在技术层面准确识别"该音频由 Google AI 生成"。在将自制视频发布到各大公域内容平台时,遵守平台的 AI 生成内容标识规范即可,创作者应当了解这一技术特性的存在。
五、行动建议:从零启动你的家庭学习与创作管线
如果你希望立刻将这套新能力转化为学习与生产力,推荐按照以下三个阶段渐进式落地:
-
第一阶段:在 AI Studio 中"捏"出两套专属声音(10 分钟)
- 前往 Google AI Studio 的 Voices 模块,利用自然语言分别设计两个声音:
- 声音 A(幼儿故事专用):富有活力、带有一点戏剧夸张感的幼儿教师声线;
- 声音 B(成人学习专用):发音纯正、语速适中且富有逻辑感的英/美音母语者声线;
- 保存并记录其对应的
voice_id。
- 前往 Google AI Studio 的 Voices 模块,利用自然语言分别设计两个声音:
-
第二阶段:试水自制第一部 1 分钟儿童双语故事(30 分钟)
- 用常规大模型生成一个 100~150 词的短剧本,题材取自孩子近期最感兴趣的事物(例如恐龙、积木城堡、游乐园);
- 在文本中适当插入
<gasp>和<laugh>,调用gemini-3.8-flash-tts生成配音; - 晚上睡前放给孩子听,观察孩子的眼神和笑声。如果孩子主动要求"再听一遍",说明这条路子彻底走通了。
-
第三阶段:打通本地视频剪辑与双语卡片自动化
- 将固化的
voice_id接入现有的自动化视频脚本(如将本地基于 Edge-TTS 的卡片视频工具,逐步平滑过渡到支持 Gemini TTS API); - 日常记录下的生词、工作中的优秀表达,自动生成带有精细配音的中英双语视频;
- 以教促学,以自制内容作为强反馈纽带,让两代人的英语学习真正摆脱死记硬背的苦役,进入沉浸与创造的正向循环。
- 将固化的