在生产运维和高并发系统架构中,许多工程师排查性能瓶颈的第一反应,往往集中在网络 和文件系统。
这很符合直觉。因为网络和文件系统的问题通常会抛出极其明确的报错:连接打满时抛出 connection reset by peer、broken pipe;文件句柄耗尽时直接报 too many open files。排查链路清晰,通常只要调大 net.core.somaxconn、增大 fs.file-max 或者调大 ulimit -n 就能立刻见效。
然而,当系统进入高并发后端服务、分布式存储(Kafka/ES)、核心数据库(Redis/MySQL)以及大规模 Kubernetes 容器化集群的深水区时,最棘手、最隐蔽的生产事故,往往潜伏在 CPU 与内存 的深层交互之中。
与网络/文件系统的"明病"不同,CPU 与内存的问题几乎从不主动报错,而是表现为各种难以捉摸的"暗伤":
- 偶发性秒级假死:系统 CPU 利用率不高,网络通畅,但接口 P999 延迟突然飙升到数秒,随后又自行恢复;
- 进程无预警蒸发:没有留下任何应用层 Exception 或 Core Dump,关键进程突然被操作系统静默 SIGKILL;
- 容器诡异限流:宿主机整机负载仅有 30%,但容器内多线程服务的响应延迟却周期性跳跃 100ms;
- 多核算力打折:换了 64 核的高配服务器,MySQL 或底层计算组件的吞吐反而不如老机器稳定。
CPU 与内存调优的核心目标,通常不是为了让单次计算"快 5%" ,而是为了:消除长尾延迟(P99/P999 尖刺)、防止系统无预警假死(Direct Reclaim 停顿与锁频延迟),以及防止进程被意外杀掉(OOM)。
本文将从 Linux 内核底层机制出发,深度剖析 CPU 与内存调优的完整知识体系与生产避坑指南。
一、内存调优:稳定与防假死的核心战场
Linux 内存管理基于虚拟内存、伙伴系统(Buddy System)与延迟分配原则,并尽可能利用所有空闲内存作为 Page Cache(文件页缓存)来加速 I/O。
理解内存调优,首先要破除一个常见误区:"系统空闲内存(free)越少,系统越危险"。在 Linux 的设计哲学中,未被利用的内存就是被浪费的内存 。内存调优的真正抓手,是控制内存回收与换出的节奏与边界。
1. 内存水位线与直接回收(Direct Reclaim)风暴
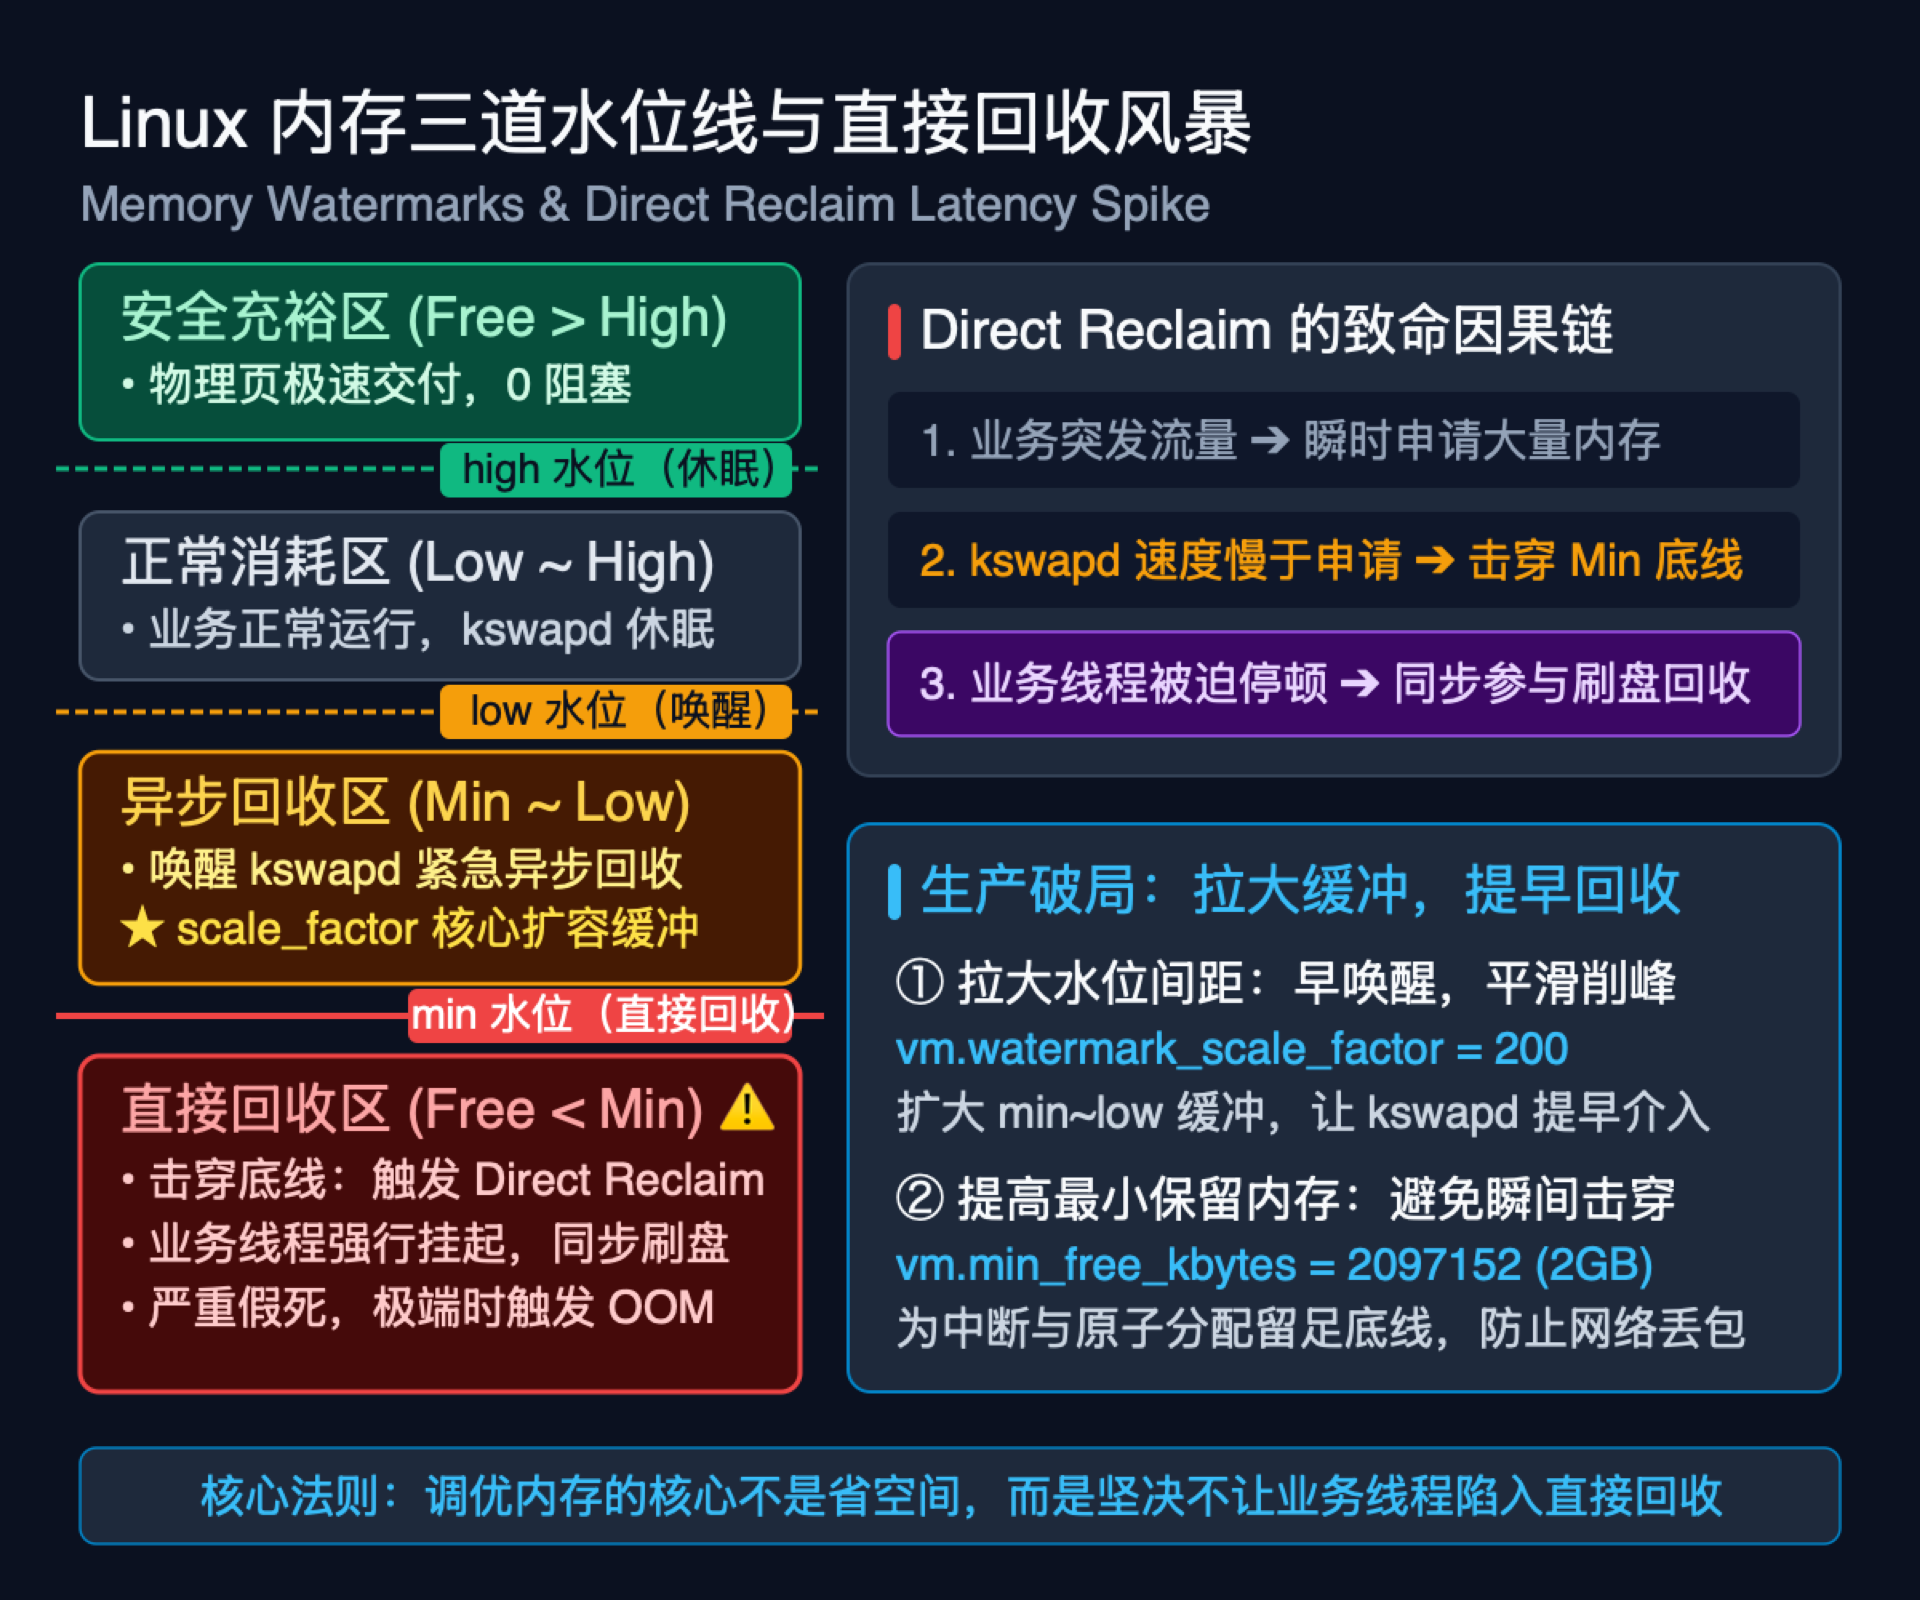
Linux 内核为每个内存区域(Zone,如 ZONE_NORMAL)维护着三道物理内存水位线:high(高水位/休眠线)、low(低水位/唤醒线)、min(最小水位/直接回收底线)。
这三道水位线构成了操作系统内存分配与回收的核心状态机:
- 安全充裕区(Free > High) :系统可用物理内存充足,应用程序分配顺畅即时交付,无任何阻塞,后台
kswapd守护线程保持休眠。 - 正常消耗区(Low < Free < High) :可用内存处于平稳消耗状态,
kswapd默认不介入。若内存此前刚经历回收并回升,kswapd会持续工作直至水位重新推高至high后再次休眠。 - 异步回收区(Min < Free < Low) :当可用内存跌破
low水位 时,内核立即唤醒后台守护线程kswapd。kswapd负责扫描 LRU 链表,异步释放 Page Cache 干净页、将脏页刷盘或把冷数据换入 Swap。这一过程完全在内核后台异步执行,业务线程毫无感知,继续正常计算。 - 直接回收危险区(Free < Min) :如果应用瞬时分配内存速率过于凶猛(例如突然涌入大流量创建大量 Socket Buffer,或批量分配超大对象),
kswapd异步回收的速度赶不上消耗速度,内存水位会瞬间穿透min水位。
一旦击穿 min 水位,灾难就会降临:直接回收(Direct Reclaim) 被强制触发。
什么是 Direct Reclaim?
内核认为物理内存已经处于极度枯竭的危险边缘,后台线程已经来不及救场。此时内核会强制挂起正在申请内存的应用进程/线程,逼迫业务线程停下业务逻辑,亲自去内核态执行同步内存回收与 I/O 刷盘!
在直接回收发生期间,原本响应时间仅为几毫秒的 API,会被挂起数十毫秒甚至数秒;在 Java/Go 场景下,这种停顿常被误判为"GC 停顿",但查看 GC 日志却发现 GC 时间完全正常。若直接回收依然无法释放出足够内存,内核将触发最终手段 ------ OOM-Killer。
生产调优关键参数
为了防止突发流量直接击穿 min 水位,我们需要通过调控参数,拉大预警缓冲,让 kswapd 更早启动:
-
vm.watermark_scale_factor(内核 4.6+ 引入):- 该参数控制
low水位与min水位之间的缓冲间距(内核计算公式为:low = min + (managed_pages * watermark_scale_factor) / 10000,默认值为 10,代表占用内存区域的 0.1%)。 - 调优建议 :在大内存服务器(如 64G/128G+)或高突发流量节点上,将其调大到
150~200(即扩大至可用内存的 1.5%~2.0%)。这样显著拉大了low与min之间的间距(扩容 15~20 倍),让kswapd在离危险线很远时就提前发力异步回收,大幅降低陷入 Direct Reclaim 的概率。
- 该参数控制
-
vm.min_free_kbytes:- 定义了系统的
min水位大小,即内核为原子分配(如网络中断处理、Socket 分配)保留的底线空闲内存。 - 调优建议 :在 64GB ~ 256GB 的高并发节点上,建议设置为
1GB~4GB(例如vm.min_free_kbytes = 2097152)。若设得太小,网络洪峰到来时软中断无法分配sk_buff,直接导致丢包;若设得过大则会压缩正常可用内存。
- 定义了系统的
2. 脏页刷盘(Dirty Page Writeback):消除 I/O 阻塞抖动
为了加速磁盘写入,Linux 会把写入数据先缓存在内存的 Page Cache 中,被修改过的页面称为"脏页(Dirty Pages)",由内核的后台 flusher 线程异步刷入磁盘。
然而,如果脏页阈值配置过大,在大批量连续写场景(如 Kafka 消费落盘、Elasticsearch 批量写入、数据库日志持久化)中,会积攒几十 GB 的脏页。一旦达到前台阈值,内核将直接阻塞应用的写入调用,强制进行同步刷盘。由于机械盘或云盘吞吐有限,这种同步刷盘会导致整个 I/O 链路瞬间被占满,业务请求出现长达数秒甚至几十秒的不可响应。
核心调优参数对照
-
vm.dirty_background_ratio/vm.dirty_background_bytes:- 后台异步刷盘阈值(默认通常是内存的 10%)。当脏页占比达到该值时,后台
flusher线程静默工作。 - 调优建议 :高吞吐写入服务应将该值调低(例如
5%,或者直接配置固定大小如vm.dirty_background_bytes = 268435456即 256MB),促使内核"小步快跑,平滑刷盘",避免脏页积少成多。
- 后台异步刷盘阈值(默认通常是内存的 10%)。当脏页占比达到该值时,后台
-
vm.dirty_ratio/vm.dirty_bytes:- 强制同步刷盘阈值(默认通常是 20%~30%)。达到该值后,任何发起
write()的进程都会被强制阻塞,加入刷盘大军。 - 调优建议 :压低至
10%或固定值(如 1GB ~ 2GB),坚决避免前台产生大批量的突发积压阻塞。
- 强制同步刷盘阈值(默认通常是 20%~30%)。达到该值后,任何发起
3. Swap 策略与 Overcommit 权衡
vm.swappiness 的真实含义
很多工程师认为 swappiness = 0 就是"彻底禁用 Swap"。这是完全错误的。
在 Linux 内核中,内存回收分为两大类:文件页(Page Cache) 和 匿名页(堆内存、栈内存、进程私有数据) 。vm.swappiness(取值 0~100,部分新内核可达 200)是内核在平衡"回收 Page Cache"与"换出匿名页到 Swap"之间的权重系数:
swappiness = 100:内核同等看待文件页与匿名页。swappiness = 0/1:内核极力避免将匿名页换出到磁盘,优先释放 Page Cache。但在物理内存耗尽时,如果设置了0,仍有可能在特定极端情况下触发换出或直接 OOM。
生产建议 :
对于 MySQL、Redis、ES 等对延迟敏感的数据库与中间件,Swap 的换入换出伴随着高昂的磁盘寻道与 I/O 延迟,一次 Swap 换出可能造成几十毫秒的卡顿。因此建议将 vm.swappiness = 1 (保守避免 Swap),而在 Kubernetes 节点上,业界标准是直接执行 swapoff -a,防止 Kubelet 资源调度与驱逐(Eviction)策略因 Swap 的存在而误判。
vm.overcommit_memory:内存超售与 Redis 避坑
Linux 默认允许进程分配超过实际物理内存的虚拟内存空间(Overcommit):
-
0(默认,Heuristic Overcommit):启发式判断,内核尽量满足分配,但估算可能超额严重时拒绝申请。 -
1(Always Overcommit):无论物理内存还剩多少,允许任意虚拟内存分配申请。-
Redis 生产强制要求 :Redis 执行持久化(
BGSAVE/BGREWRITEAOF)时,会调用fork()产生子进程。子进程在虚拟地址空间上是父进程的完整克隆。虽然凭借"写时复制(Copy-on-Write, CoW)",实际物理内存消耗非常小,但在overcommit_memory = 0时,内核可能误以为需要为子进程准备全量物理内存而导致fork()失败报错Cannot allocate memory。因此运行 Redis 的服务器必须设置:bashsysctl vm.overcommit_memory=1
-
-
2(Never Overcommit) :严禁超售,虚拟地址空间申请总量不得超过Swap + RAM * overcommit_ratio。适合金融核心结算等"宁可启动失败,绝不允许运行中因内存超售发生 OOM"的极端场景。
保护关键基础设施:oom_score_adj
当 OOM-Killer 触发时,内核会根据进程占用的内存比例与惩罚权重计算出 oom_score,挑选分数最高的进程杀掉。通过调整 /proc/<pid>/oom_score_adj(-1000 到 1000),可以人为控制进程的存活概率:
- 设为
-1000:该进程完全免疫 OOM-Killer。 - 生产中,如
kubelet、sshd、核心反向代理、数据库哨兵守护进程,都应通过 systemd 服务配置OOMScoreAdjust=-1000,防止在机器资源紧张时运维通道被内核"断尾"误杀。
4. 大页机制(HugePages):透明大页的"毒药"与静态大页的"解药"
CPU 管理内存依靠页表(Page Table),为了加速虚拟地址到物理地址的转换,CPU 内部有一块极高速度的硬件缓存 ------ TLB(Translation Lookaside Buffer)。标准内存页大小为 4KB,当一台机器运行数打几十 GB 内存的数据库时,需要维护数千万个页表项,TLB 缓存频繁 Miss,导致高达 15%~25% 的 CPU 时间白白耗费在"查页表"上。
为了解决这个问题,Linux 提供了大页(HugePages,通常为 2MB 或 1GB)。
透明大页(THP - Transparent Huge Pages):数据库的生产隐形杀手
THP 是内核试图"好心办好事"的机制:它在后台偷偷将连续的 4KB 小页合并为 2MB 大页。
但在 Redis、MongoDB、MySQL 等内存频繁申请与释放的场景下,THP 会引发严重的灾难:
- 内存碎片化与 Compaction 卡死 :当内存缺乏连续 2MB 物理空间时,内核后台线程
khugepaged会强制执行内存碎片整理(Memory Compaction)。这会导致全局锁竞争与内存分配阻塞,应用出现高达数十毫秒甚至数秒的卡顿毛刺; - 写时复制(CoW)内存放大 :在 Redis 执行
BGSAVE时,如果开启了 THP,父进程即使只修改了 1 个字节的数据,内核也必须拷贝完整的 2MB 大页,导致物理内存消耗暴涨数十倍,极易诱发 OOM。
生产铁律 :在所有运行 Redis、MongoDB、Oracle、MySQL 的物理机或虚拟机上,必须彻底禁用 THP:
bash
echo never > /sys/kernel/mm/transparent_hugepage/enabled
echo never > /sys/kernel/mm/transparent_hugepage/defrag
静态大页(Static HugePages):高性能系统的加速器
与 THP 的动态合并不同,静态大页(Static HugePages) 是在内核启动或通过 vm.nr_hugepages 显式预留固定的物理页面。这些页面常驻内存、不可被交换到磁盘、完全排除了碎片整理开销。
- 适用场景 :PostgreSQL 的
shared_buffers、DPDK 网络数据包处理框架、高频低延迟撮合引擎。通过让核心缓存常驻 2MB/1GB 静态大页,TLB 命中率接近 100%,不仅大幅压低了 CPU 寻址开销,更从源头上消除了内存碎片带来的抖动。
5. NUMA 内存分配陷阱:zone_reclaim_mode
现代多路服务器均为非统一内存访问架构(NUMA)。CPU 被划分为多个 Socket/Node,访问本地 Node 挂载的内存速度极快,跨总线(QPI/UPI)访问远端 Node 内存则会有明显的延迟与带宽惩罚。
在早期的 Linux 内核中,vm.zone_reclaim_mode 默认值可能被配置为 1。这意味着:当某个 NUMA 节点的本地内存用尽时,内核宁可在本地进行激烈的内存回收(甚至 Direct Reclaim),也坚决不去借用相邻 Node 上明明空闲的内存!
这曾导致过无数次经典的"MySQL 假死事故":服务器明明还有几十 GB 物理内存,但因为 MySQL 主要线程跑在 Node 0,Node 0 内存满了之后系统疯狂在本地回收,导致数据库卡顿几十秒。
生产准则 :
所有现代多路服务器必须确认将 vm.zone_reclaim_mode = 0:
bash
sysctl vm.zone_reclaim_mode=0该参数确保本地节点内存不足时,内核能平滑向其他 NUMA 节点借用内存,坚决杜绝因本地死磕回收引发的系统停顿。
二、CPU 调优:算力不降频、时间片不被抢、缓存不打飞
如果说内存调优的重点是"防假死、防换出、防被杀",那么 CPU 调优的核心诉求就是:保证算力满血常驻、中断负载均匀分配、保护 CPU 缓存(L1/L2/L3 Cache)以及打破虚拟化/容器限流的枷锁。
1. 电源管理与频点控制(Governor & C-States)
许多运维团队采购了 3.0GHz+ 的高性能服务器,却在压测时发现接口延迟始终达不到预期。排查后往往发现,系统运行在默认的节能模式下。
现代 CPU 具备极其复杂的电源管理架构:
- CPU 频点策略(Governor) :操作系统为了省电,默认往往采用
powersave(省电)或ondemand(按需动态升频)。当流量突然激增时,CPU 从几百 MHz 升频到睿频最高点需要经历检测、决策和硬件锁频的延迟(数百微秒至毫秒级),这直接构成了接口的首包长尾延迟。 - CPU 休眠深度(C-States):当核心空闲时,CPU 会切入 C1、C2 甚至深度的 C6 休眠状态(关闭内部时钟甚至降低核心供电)。从深度休眠中被外部中断唤醒并恢复上下文,需要付出可观的时延代价。
生产调优实践
对于延迟极其敏感的网关、交易系统或核心数据库,必须将系统切换为 performance 性能模式,强制锁定 CPU 主频,消除动态升降频带来的毛刺:
bash
# 检查当前调频器
cpupower frequency-info

# 强制所有 CPU 核心进入 performance 模式
cpupower frequency-set -g performance
在超低延迟极致场景(如金融高频交易),还可以在 Linux 内核启动引导项中追加 idle=poll 或 intel_idle.max_cstate=0,禁止 CPU 核心进入节能休眠,让 CPU 在空闲时以自旋轮询(Busy Polling)代替休眠,实现微秒级的中断响应。
2. 中断亲和性与软中断分流(IRQ Affinity & RPS/RFS)
网络流量进入网卡后,网卡会向 CPU 发送硬件中断通知内核处理数据包。默认情况下,如果不做配置,所有硬件中断很可能会被硬件或 BIOS 全部派发给 CPU 0。
典型故障症状
监控中整机 CPU 利用率可能只有 5%,但仔细查看各核心负载,发现 CPU 0 的软中断占用(si,ksoftirqd)持续 100% 满载 ,网络数据包在队列中积压并被大量丢弃(RX drop),其他数十个 CPU 核心却在一旁看戏。
应对策略
-
物理机多队列网卡硬绑定:
- 现代物理万兆/十万兆网卡支持多收发队列(RSS)。高并发网络节点通常停用系统的
irqbalance服务 ,手动将每个网卡队列的中断(/proc/irq/<irq_num>/smp_affinity)一对一硬绑定到固定的 CPU 物理核心上,实现网络负载绝对均匀的硬件级分流。
- 现代物理万兆/十万兆网卡支持多收发队列(RSS)。高并发网络节点通常停用系统的
-
云主机虚拟网卡软分流(RPS / RFS):
- 在云主机环境(KVM / Virtio)中,虚拟网卡往往只有单队列或有限的几个队列。此时可以使用内核软分流技术:
- RPS(Receive Packet Steering):对数据包的源 IP/端口做哈希,将软中断处理均摊分发到指定的多个 CPU 核心上;
- RFS(Receive Flow Steering):进一步追踪应用层处理该 Socket 的线程所在的 CPU,将软中断派发给同一个 CPU,以极致榨取 CPU 缓存热度(Cache Locality)。
- 在云主机环境(KVM / Virtio)中,虚拟网卡往往只有单队列或有限的几个队列。此时可以使用内核软分流技术:
3. NUMA 亲和性与核心隔离(CPU Pinning)
操作系统 CFS 调度器的职责是追求全系统的"公平"。它会尽可能让所有 CPU 忙碌起来,经常将进程从一个核心迁移到另一个核心。
然而,这种跨核调度在多核与 NUMA 服务器上会带来巨大的性能退化:
- L1 / L2 缓存瞬间被冷落:线程迁到新核心后,之前预热好的热点数据全部失效,引发大量的 Cache Miss;
- 跨 Socket 内存搬运:线程若被调度到了另一个 NUMA 节点,它读取原本分配在原节点上的内存数据时,必须穿过带宽受限的互联总线(Intel UPI / AMD Infinity Fabric),访存延迟暴增 2~3 倍。
绑定亲和性实战
在部署 MySQL、Redis 单线程实例或高性能计算节点时,应当利用 numactl 或 taskset 将进程绑定在特定的 NUMA 节点与 CPU 集合内:
bash
# 启动 Redis 实例,绑定在 NUMA Node 0,并仅使用 Node 0 的物理内存
numactl --cpunodebind=0 --membind=0 redis-server /etc/redis/6379.conf
在超低延迟金融交易或 DPDK 场景下,可以通过 Linux 启动项配置 isolcpus 与 nohz_full:
isolcpus=24-31:将这 8 个核心从内核常规调度域中彻底"剔除",内核永远不会把普通进程或软中断调度上去;nohz_full=24-31:关闭这 8 个核心上的周期性时钟中断(Tickless),专供交易线程跑死循环无感处理任务,实现确定性微秒级时延。
4. Kubernetes 容器时代最大痛点:CFS Quota 限流(Throttling)
在 Kubernetes 中,绝大多数工程师都会为 Pod 配置类似如下的资源限制:
yaml
resources:
  requests:
    cpu: "1"
  limits:
    cpu: "2"
这个看似标准的配置,在多线程高并发应用(如 Java Spring Boot、Go 并发服务、Node.js 工作池)中,却是引发接口偶发性严重超时(P99 尖刺)的第一大元凶。
CFS 限流的底层微观真相
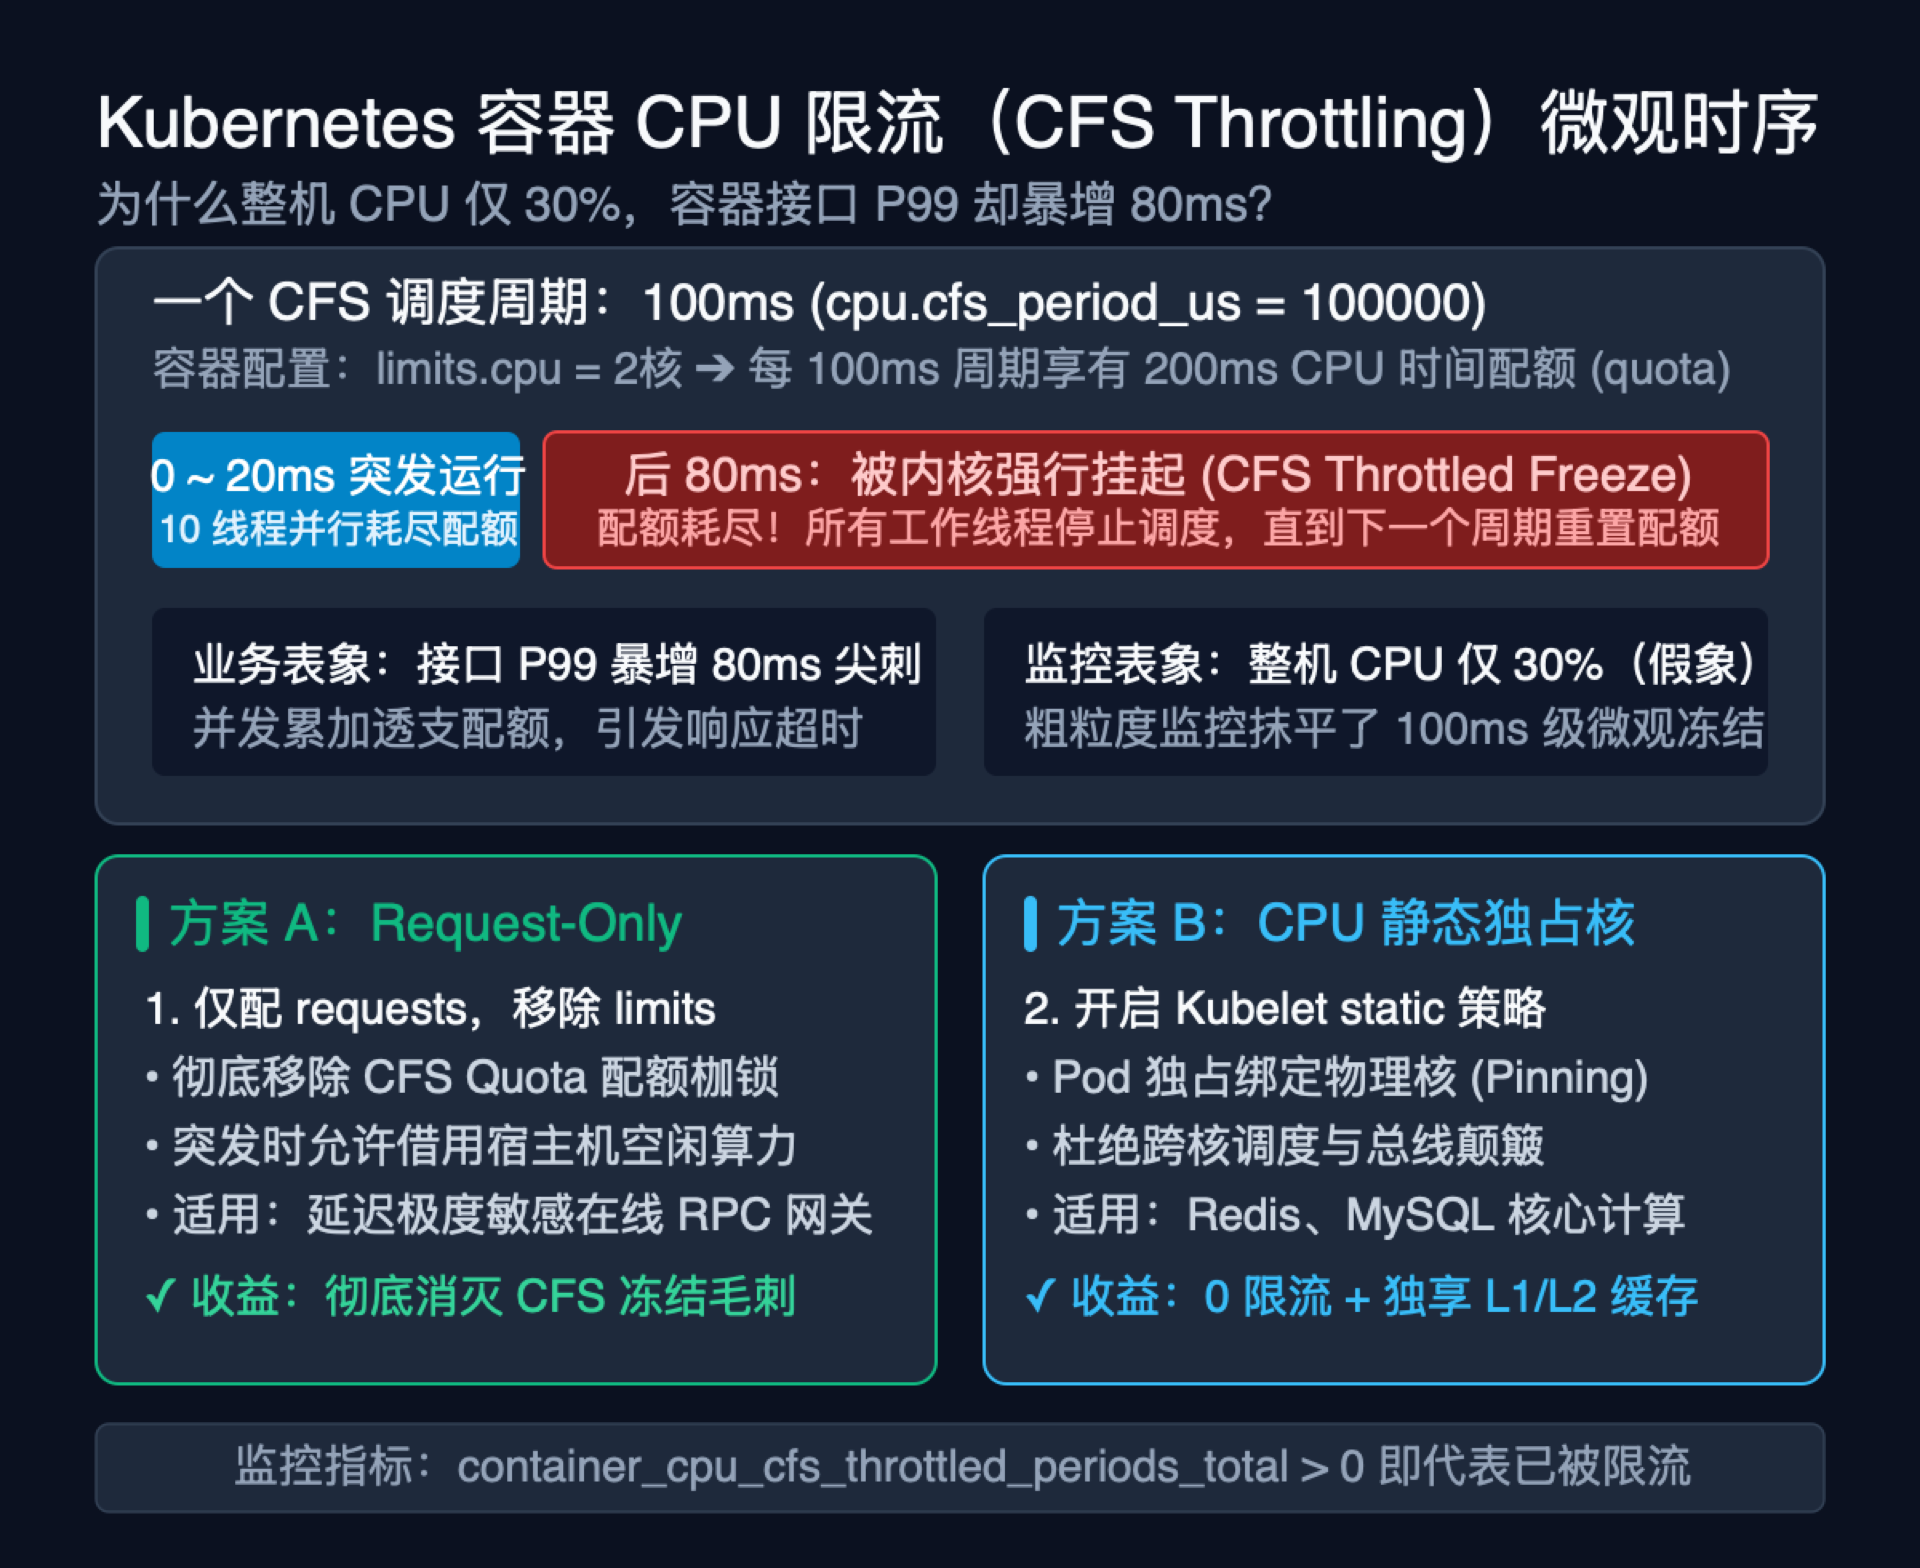
Kubernetes 对容器的 CPU Limit 并不是物理限制,而是通过 Linux cgroups 的 CFS(Completely Fair Scheduler)调度配额实现的:
cpu.cfs_period_us:调度周期,默认是 100,000 微秒(即 100ms);cpu.cfs_quota_us:周期内允许消耗的 CPU 时间总量。如果配置limits: 2,则该值为2 * 100ms = 200,000 微秒(200ms)。
关键在于:CPU 算力消耗是按所有并发线程累加计算的!
假设一个 Java 容器被分配了 2 核的 Limit(每 100ms 周期享有 200ms 配额),当突发流量到来时,容器内 10 个业务线程同时并发处理请求:
- 这 10 个线程在短短 20ms 内,就累计消耗了
10 * 20ms = 200ms的 CPU 配额; - 在当前的 100ms 周期里,还剩下整整 80ms 的时间;
- 由于配额耗尽,Linux 内核会立即对该 cgroup 下的所有线程执行 强行挂起(Throttled Freeze)!
- 整个容器被冻结,直到 80ms 过去、下一个 100ms 调度周期开始,内核重置配额,线程才被唤醒继续执行。
从业务层看,原本处理耗时仅需 5ms 的接口,因为这 80ms 的冻结,端到端延迟瞬间飙升到了 85ms 以上!而在 Prometheus 监控上,因为是采样或分钟级平均值,整台机器与容器的 CPU 使用率可能只有可怜的 30%。
破除限流的三大解法
-
方案一:核心低延迟业务去掉 CPU Limits(Request-Only)
- 在 Kubernetes 中仅声明
requests.cpu,将limits.cpu留空。 - 底层原理:去掉 limit 会直接移除
cpu.cfs_quota_us的紧箍咒。容器在突发计算时允许"借用"宿主机上的其他空闲核心完成计算,彻底杜绝 CFS 限流;而requests.cpu依然保障了调度拓扑与资源基础底线。这是目前 Uber、美团、字节等众多大厂针对核心在线 RPC 服务的标准做法。
- 在 Kubernetes 中仅声明
-
方案二:升级高版本 Linux 内核(Linux 5.4+)
- 旧版本内核(如早期的 Linux 4.14/4.19)在多核下存在严重的 CFS Quota 归还竞争 Bug,导致容器极易被误限流。高版本内核修复了此问题,并引入了 CFS 突发配额缓冲机制(CPU Burst)。
-
方案三:开启 Kubernetes CPU Manager Static Policy(独占物理核)
- 将 Pod 配置为 Guaranteed QoS 级别(
requests.cpu == limits.cpu且为整数核)。 - Kubelet 会将 Pod 独占绑定到指定的物理核上,并将其从共享 CFS 调度池中剥离,不仅 0 限流,还能享受完全隔离的 L1/L2 缓存与 NUMA 本地化。
- 将 Pod 配置为 Guaranteed QoS 级别(
三、四大核心场景调优对照规约
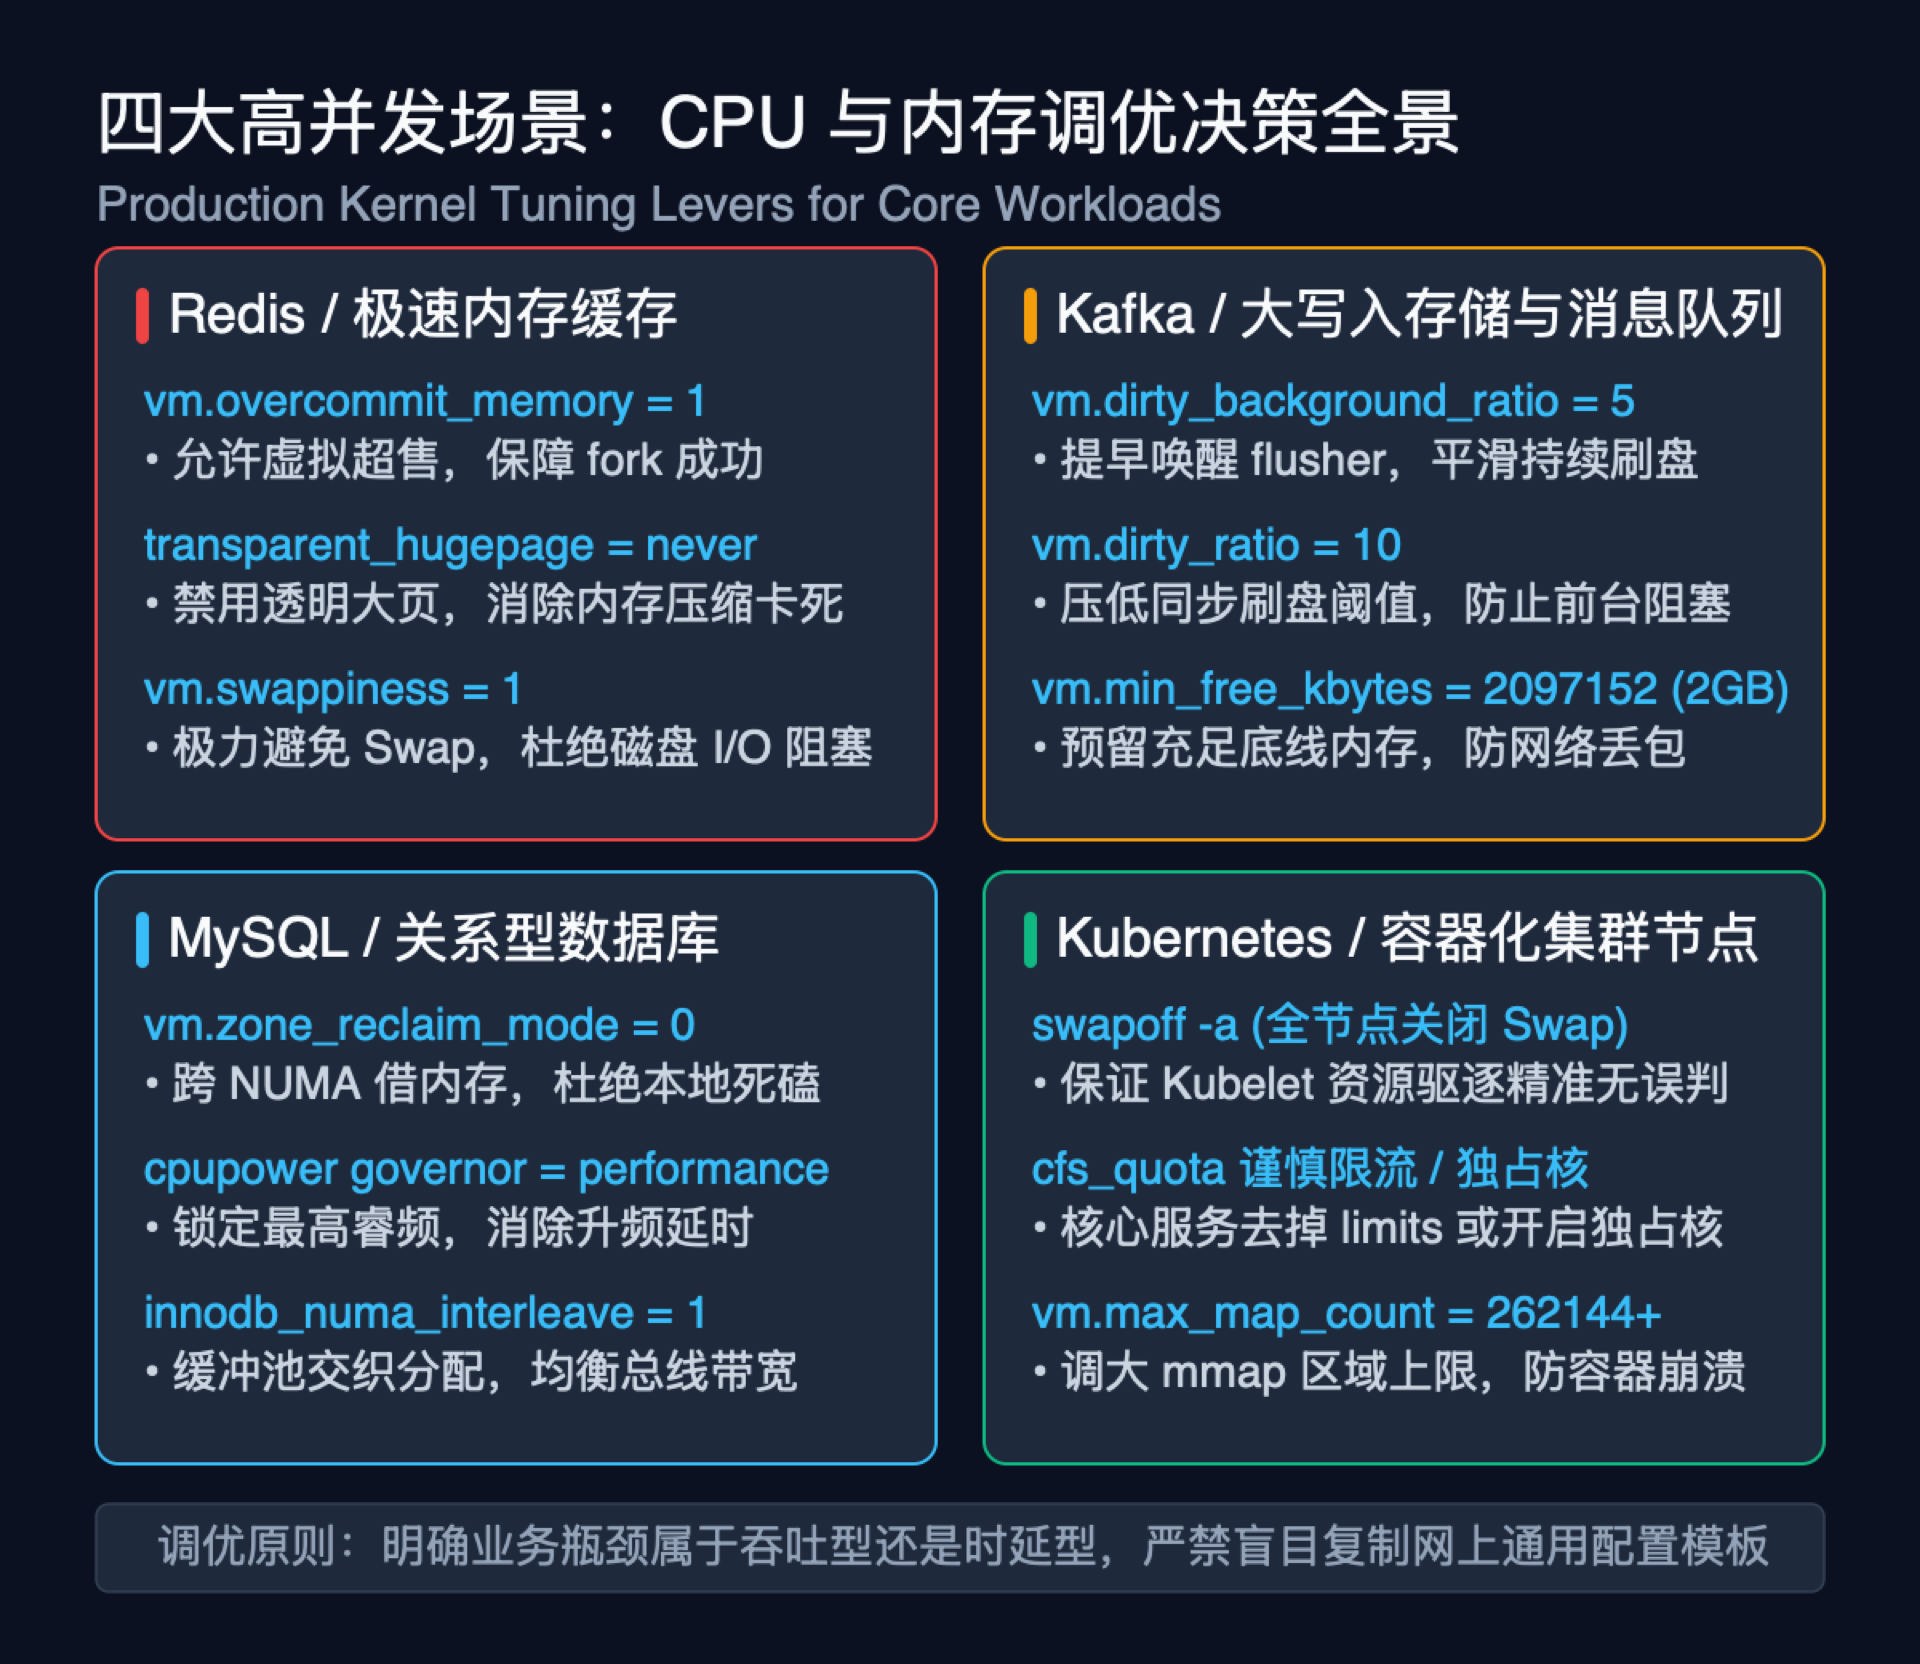
脱离具体业务场景谈内核调优毫无意义。下面我们将高并发架构中最常见的四大工作负载(Redis、Kafka、MySQL、Kubernetes Node)的核心调优参数与底层逻辑规约汇总如下:
1. Redis / 极速内存缓存
vm.overcommit_memory = 1:允许虚拟内存无限制超售,保障后台BGSAVE与 AOF 重写时fork()顺利通过。transparent_hugepage = never:强制禁用透明大页,根治后台 Compaction 碎片整理导致的偶发性毫秒级卡死,并避免 CoW 内存暴增。vm.swappiness = 1:极度保守使用 Swap,优先释放文件缓存,杜绝热点数据落入磁盘导致 I/O 停滞。
2. Kafka / 高吞吐写入与消息队列
vm.dirty_background_ratio = 5(或设置固定字节):提早唤醒后台flusher线程,持续且平缓地向磁盘下刷数据,杜绝脏页大批量积压。vm.dirty_ratio = 10:压低前台同步写入阻塞上限,避免暴发式流量导致应用线程被迫加入刷盘大军而产生秒级不可用。vm.min_free_kbytes = 2GB+:针对万兆网络环境,预留充足的内核保留内存,防止突发消费或海量网络包瞬间击穿最低水位线。
3. MySQL / OLTP 关系型数据库
vm.zone_reclaim_mode = 0:当 NUMA 本地节点内存不足时,优先向其他节点借用内存,坚决杜绝在本地死磕回收与 Direct Reclaim。cpupower frequency-set -g performance:服务器锁定性能模式,关闭动态节能降频,消除 CPU 核心在空闲与峰值切换时的唤醒延迟。innodb_numa_interleave = 1:开启 InnoDB 缓冲池交织分配策略,将内存页均匀分散到各个 NUMA 节点,均衡总线带宽负载。
4. Kubernetes 容器化集群节点
swapoff -a:全节点彻底禁用 Swap,确保 Kubelet 能够基于物理内存精确评估 Pod 的资源配额与驱逐水位线。cfs_quota 监控与优化:核心网关与在线 RPC 服务建议采用"Request-Only"或配置整数独占核,并监控container_cpu_cfs_throttled_periods_total指标。vm.max_map_count = 262144+:调大进程拥有的最大内存映射区域数量,防止 Elasticsearch、Java 容器以及海量协程运行时因mmap上限而崩溃。
四、总结与认知模型
排查和治理系统性能瓶颈,本质上是在与操作系统的资源管理法则打交道。我们可以用两句极简的心智模型来概括 Linux 调优的全局视角:
-
网络与文件系统调优 :关注的是"管道通不通、水管有多粗" ------ 解决连接容量、数据通路由小变大,遇到瓶颈报明错,照方抓药即可。
-
内存调优 :核心底线是"别被换出、别被堵死、别被当成坏人干掉" ------
- 别被换出:压低
swappiness,杜绝磁盘 I/O 抖动; - 别被堵死:调大
watermark_scale_factor,压低脏页刷盘阈值,禁用 THP,坚决拒绝 Direct Reclaim 与 Compaction 造成的秒级假死; - 别被干掉:合理配置
overcommit,给核心守护进程配置oom_score_adj = -1000防误杀。
- 别被换出:压低
-
CPU 调优 :核心底线是"算力不降频、中断不偏科、Cache 不打飞、时间片不被抢" ------
- 锁定
performance调频模式,禁止深度休眠; - 绑定多队列中断与 NUMA 亲和性,保护缓存局部性;
- 警惕 Kubernetes 中的 CFS Quota 限制,消灭因并发累加引发的周期性挂起。
- 锁定
搞懂这套底层机理,面对高并发下突如其来的 P99 毛刺与无预警假死时,你将不再盲目地"重启加机器",而是能像手术刀一样,精准切中内核深处的关键神经。