版本 1.0 | 2026-09-22 | 基于 DataFlow v1.0.10 (main
d70f9ef)与 DataFlow-WebUI(main2e95d40)仓库:https://github.com/OpenDCAI/DataFlow | WebUI:https://github.com/OpenDCAI/DataFlow-WebUI
官方文档:https://opendcai.github.io/DataFlow-Doc/zh/guide/install/ | 论文:https://arxiv.org/abs/2607.16617
系列定位 :源码级深度解读,所有结论
file:line可追溯;拒绝 API 导游与泛泛而谈。
DataFlow 深度分析与技术文档系列计划
第一章 DataFlow 项目深度分析
1.1 项目概述
一句话定性:DataFlow 不是数据流水线引擎,而是一座"算子仓库"加一套极薄的装配规范。
它要解决的问题在官方简介页写得很直白------大模型训练数据的准备「仍然是一个高度依赖手工和分散实现的过程」,而已有工具(Hadoop、Spark)「大多以传统方法为核心,尚未对大模型的自动化数据治理进行集成和优化」。DataFlow 的答案是把数据治理拆成原子算子,再用一层几乎不含逻辑的 pipeline 把它们串起来。
它的行业坐标因此有点特殊:它不是 Spark 那种"计算引擎",也不是 Airflow 那种"调度器",而更接近 scikit-learn 的 Pipeline + HuggingFace datasets 中间地带------但把"算子"这个概念推到了 197 个的规模,并额外为 LLM 数据合成场景(推理链、多跳 QA、PDF 解析、Text2SQL、语音)准备了专用件。
为什么值得读:
- 它把"薄内核 + 厚生态"这条路走到了极端------内核三件加起来 1219 行 ,算子却有 34805 行 (
DataFlow/dataflow/实测)。这个比例本身就是一份架构教材。 - 它的
compile()是一次追踪式降级:让 pipeline 的 Python 代码"照常求值、但不真跑算子",从而把代码无损抽成显式图。这是理解 DataFlow-WebUI 与论文(DataFlow-Harness)全部能力的技术前提。 - 它同时提供了三层可对照的实现------主仓(引擎/算子)、WebUI 仓(Harness:MCP + 画布 + Agent)、论文(形式化主张)。三层之间有真实的差距,逐条对账是极好的"文档 vs 实现"训练。
1.2 核心架构
先建立全局心智模型。下图是四层依赖关系:注意力应从下往上------越下面的层越薄,越上面的层越厚。
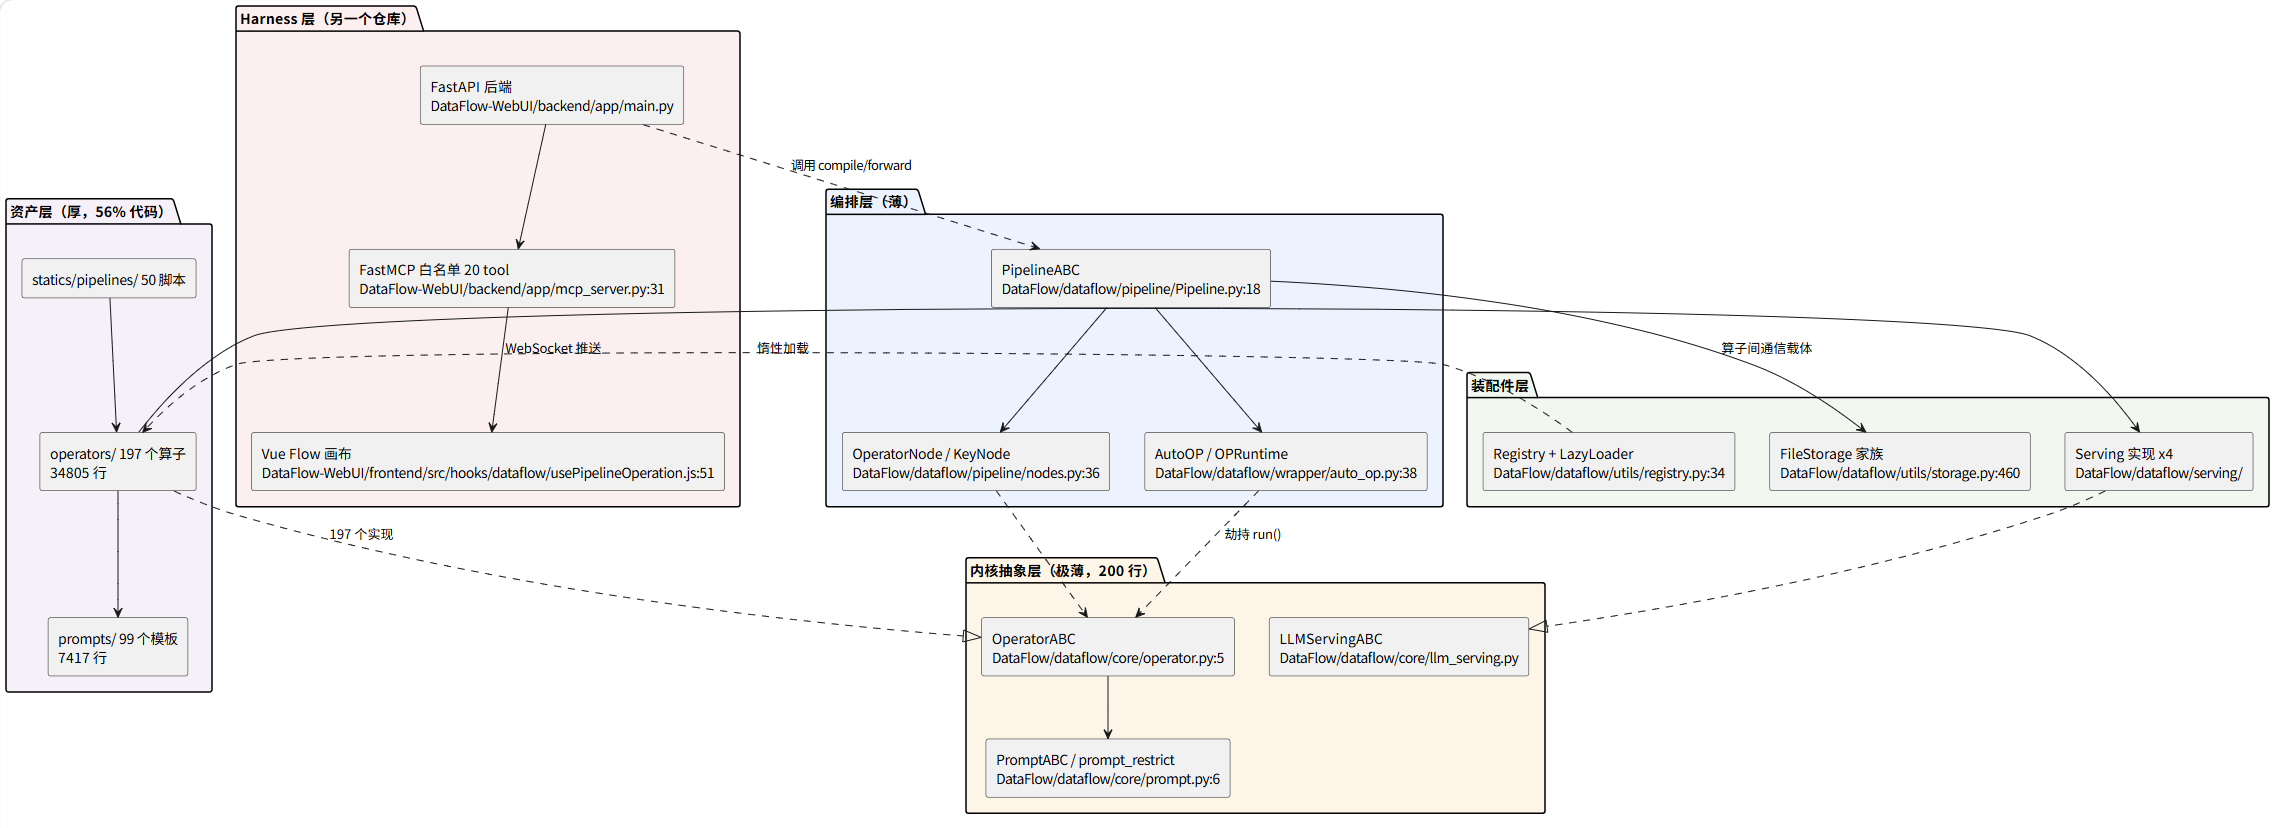
图示讲解 :这张图回答"DataFlow 的复杂度分布在哪一层"。四层从下往上读:**资产层(紫)**最厚------197 个算子与 99 个 prompt 占了主仓 56% 以上的代码,这是项目的真实体量所在;**内核抽象层(橙)**最薄,
OperatorABC只有一个抽象方法(DataFlow/dataflow/core/operator.py:10-15),整个core/包只有 200 行------这是刻意的设计选择而非未完成;**编排层(蓝)**承载全部机制(compile()追踪、键流建图、resume),813+206 行;Harness 层(红)在另一个仓库,它不重新实现任何执行逻辑,而是 站在PipelineABC之上 做 Agent 交互。注意箭头方向:API ..> PIPE是虚线依赖,说明 WebUI 依赖主仓,反向不成立------这正是后面第 99 篇讨论"能力边界由谁决定"的架构依据。
1.3 技术栈与模块结构
主仓 DataFlow/(纯 Python,无编译扩展):
dataflow/
├── core/          200 行   ← OperatorABC / PromptABC / LLMServingABC / 抽象契约
├── pipeline/      813 行   ← PipelineABC + BatchedPipelineABC + StreamBatched + nodes
├── wrapper/       206 行   ← AutoOP(追踪式劫持)/ BatchWrapper
├── utils/        1562 行   ← registry(懒加载)/ storage(6 种后端)
├── serving/      4038 行   ← API / vLLM / SGLang / 音频 / 视觉 serving
├── cli_funcs/    2648 行   ← init / eval / webui / chat 等子命令
├── rayorch/       367 行   ← RayAcceleratedOperator + memory_storage
├── operators/   34805 行   ← 14 个一级分类 / 200 文件 / 197 个注册算子
├── prompts/      7417 行   ← 16 文件 / 99 个注册 prompt
└── statics/               ← 内置流水线 50 个 + playground 示例
WebUI 仓 DataFlow-WebUI/ :backend/(FastAPI + fastapi-mcp + Ray)、frontend/(Vue + Vue Flow)、skills/(三个 Claude Code Skill)。
论文与实现的三层口径(本系列全程不混淆):
| 层 | 形式化程度 | 例 |
|---|---|---|
| 论文 | 有形式化元组 | P=(D,O,E,S,R)、mutation 含"connecting edges" |
| 官方文档 | 自然语言四组件 | 算子 / 流水线 / 提示词 / Agent,无元组 |
| 代码 | 最保守 | PipelineOperator{name, params, location},注释「用 list 的顺序代表算子执行顺序」 |
1.4 体量经济学:这个项目的护城河在哪
这是全系列的第一个反直觉数据。把主仓 66221 行按层切开:
| 层 | LOC | 占比 |
|---|---|---|
算子 operators/ |
34805 | 52.6% |
提示词 prompts/ |
7417 | 11.2% |
| serving | 4038 | 6.1% |
| CLI | 2648 | 4.0% |
| 其他(utils / rayorch / statics 等) | 5678 | 8.6% |
| 编排三件(core + pipeline + wrapper) | 1219 | 1.8% |
| 未分类余量 | 9416 | 14.2% |
引擎占 1.8%,算子资产占 63.8%。 这个比例直接决定了两件事:
- 架构侧 :任何对"引擎"的改动都会波及 197 个使用者,因此引擎必须极度克制------
OperatorABC只强制一个run()就是这种克制的体现(代价见第 01、07 篇)。 - 工程侧 :197 个算子的依赖横跨 vllm / mineru / lightrag / torch,不可能全量导入 。于是才有
TYPE_CHECKING+LazyLoader这套懒加载机制------它不是性能优化,而是规模扩张的生存前提(第 01、07 篇详解)。
第二章 技术文档系列撰写计划
2.0 篇目来源:官方文档细分(Doc-Driven)
- 文档站:
https://opendcai.github.io/DataFlow-Doc/zh/| 采集日期:2026-09-22 - 采集工具:
scripts/parse_sidebar.py(自建,见 §附录"采集说明") - 结构:
guide/分区 7 个语义分组 / 39 个二级页 ;顶层 navbar 另有api/、dev_guide/
官方侧边栏给出的分组与页序 (vp-sidebar 原文顺序,照抄):
[分组 1] 基本信息
    ├─ 简介                          guide/intro/basicinfo/intro
    └─ 框架设计                      guide/basicinfo/framework

[分组 2] 从这里开始
    ├─ 安装                          guide/install
    ├─ 快速上手-第一个 Pipeline       guide/first_pipeline
    ├─ 快速上手-多对一的 Prompt 模板  guide/second_pipeline
    ├─ 快速上手-dataflow init        guide/dataflow_init
    ├─ 快速上手-Ecosystem            guide/df_ecosystem
    ├─ DataFlow-WebUI                guide/webui
    └─ DataFlow Skills               guide/quickstart/dataflow_skills

[分组 3] 上手案例
    ├─ 案例1 机器翻译/答案合成/缩写    guide/translation
    ├─ 案例2 SFT 数据合成             guide/sft_synthesis
    ├─ 案例3 从0开始合成多轮对话       guide/conversation_synthesis
    ├─ 案例4 通用推理数据的合成与处理  guide/reasoning_general
    ├─ 案例5 大规模 PDF 转 Markdown   guide/pdf-to-markdown
    ├─ 案例6 图像问答 (VQA)           guide/p5555dgx
    ├─ 案例7 PDF 中的 VQA 提取流水线   guide/vqa_extract_optimized
    ├─ 案例8 批量 PDF 提取 QA         guide/7s1yn8u5
    └─ 案例9 语音转文字               guide/du2akut8

[分组 4] 内测功能
    ├─ 内测:断点恢复 resume          guide/resume
    └─ 内测:Batch 化推理             guide/batch

[分组 5] 流水线教程
    ├─ 纯文本流水线                   guide/textpipeline
    ├─ 强推理数据合成流水线            guide/reasoningpipeline
    ├─ Text-to-SQL 数据合成流水线      guide/text2sqlpipeline
    ├─ Text-to-QA 数据合成流水线       guide/textqa_pipeline
    ├─ 代码数据合成流水线              guide/i987k1eh
    ├─ AgenticRAG 数据合成流水线       guide/agenticrag_pipeline
    ├─ PDF2QA 流水线                  guide/kbcpipeline
    ├─ 函数调用数据合成流水线          guide/kgdzd34m
    └─ Pdf-to-Model 模型微调流水线     guide/i2pk9pwh

[分组 6] 模型自动评估
    ├─ 模型评估概述                   guide/0zegorzv
    ├─ 模型评估(小白 QA 快速版)      guide/cqro9oa8
    ├─ 模型评估(小白简易版)          guide/ent y5ksn
    └─ 模型评估(科研完整版)          guide/41y6wer6

[分组 7] 专用算子(移动到 API)
    ├─ 强推理算子                     guide/Reasoning_operators
    ├─ Text2SQL 算子                  guide/Text2SQL_operators
    ├─ RARE 算子                      guide/RARE_operators
    ├─ PDF2QA 算子                    guide/Knowledgebase_QA_operators
    ├─ AgenticRAG 算子                guide/agenticrag_operators
└─ 函数调用数据合成算子 guide/kgdzd34m篇目映射原则:官方 7 个 level-0 分组 → 7 篇正文(1:1),篇序照抄官方顺序。
- 分组即"二级章节"级语义单元;组内 39 个 level-1 页作为篇内小节处理(符合 curate 原则"三级子页降为篇内一节,不逐页立篇")。
- 不覆盖的章节及原因:
| 官方分区 | 不覆盖原因 |
|---|---|
api/(API 参考手册) |
逐 API 罗列无叙事线;算子契约已在 07 篇以"规范"形式覆盖 |
dev_guide/(开发者指南) |
面向贡献者的流程文档,非系统设计;贡献规范已在 07 篇讨论 |
- 覆盖率 = 覆盖的 level-1 页数 / 官方 guide 总数 = 39 / 39 = 100%
2.1 系列总览
| # | 主题 | 官方分组(URL) | 视角 | 核心源码入口 | 产出图 |
|---|---|---|---|---|---|
| 01 | 框架设计与四层薄内核 | 基本信息 guide/intro/basicinfo/intro + guide/basicinfo/framework |
架构 | DataFlow/dataflow/core/operator.py:5 → DataFlow/dataflow/utils/registry.py:261 |
组件图 + 时序图 |
| 02 | 上手入口链与 DataFlow-Skills | 从这里开始(7 页) | 架构/源码 | DataFlow/dataflow/cli_funcs/cli_init.py:16 → DataFlow-WebUI/backend/app/mcp_server.py:15 |
时序图 |
| 03 | 九类合成案例的算子链还原 | 上手案例(9 页) | 源码/生产 | DataFlow/dataflow/statics/pipelines/api_pipelines/kbcleaning_pipeline.py:74 |
组件图 |
| 04 | 内测能力:断点恢复与 Batch 化推理 | 内测功能(2 页) | 源码/生产 | DataFlow/dataflow/pipeline/Pipeline.py:507 / :548 |
状态图 |
| 05 | 九条生产级流水线的编排骨架 | 流水线教程(9 页) | 源码/进阶 | DataFlow/dataflow/statics/pipelines/(50 脚本) |
组件图 |
| 06 | 模型评估的三档标尺 | 模型自动评估(4 页) | 生产/进阶 | DataFlow/dataflow/cli_funcs/cli_eval.py:32 |
组件图 |
| 07 | 197 个算子的契约、懒加载与键流盲区 | 专用算子(6 页) | 源码/进阶 | DataFlow/dataflow/pipeline/nodes.py:59 |
类图 + 时序图 |
| 99 | 收尾:论文主张 vs 实现审计 | 跨篇汇总 | 进阶 | 跨篇 | 组件图 |
第三列「核心源码入口」先填再动笔 ------填不出源码入口的篇目会退化成概念复述。本系列 7 篇全部先锚定入口(见
research-wiki/index.md三列索引)。文档线(NN-) 讲"是什么/为什么/怎么用",源码线 在本系列中不另开
fpNN-------因为每篇正文已强制 ≥8 条file:line并打穿到实现层,另立源码线会造成内容重复(此项偏差已在附录说明)。
2.2 文档详细计划
01 框架设计与四层薄内核
读者收获:理解"薄内核 + 厚生态"的取舍、TYPE_CHECKING 单一声明源、compile() 追踪降级、serving 引用计数。
关键 file:line:DataFlow/dataflow/core/operator.py:5、DataFlow/dataflow/utils/registry.py:15/261/343、DataFlow/dataflow/pipeline/Pipeline.py:43/51/507、DataFlow/dataflow/wrapper/auto_op.py:58/99。
图:四层依赖组件图 + 懒加载时序图。
02 上手入口链与 DataFlow-Skills
读者收获:dataflow init 的实际语义(目录级复制)、FileStorage 四参数契约、WebUI 的 FastAPI+MCP 架构、MCP 20 条白名单如何从路由自动投影、Skills 的六核心算子。
关键 file:line:DataFlow/dataflow/cli_funcs/cli_init.py:16、DataFlow/dataflow/cli_funcs/copy_funcs.py:70、DataFlow/dataflow/utils/storage.py:464/528/538、DataFlow-WebUI/backend/app/mcp_server.py:25/31/132。
图:从 dataflow init 到 MCP tool 暴露的时序图。
03 九类合成案例的算子链还原
读者收获:9 个官方 recipe 的真实算子链、字段接力(source → text_path → raw_chunk → cleaned_chunk → QA_pairs)、案例 7 的分叉结构、以及 6 处"文档说错了算子名/路径"的实证。
关键 file:line:DataFlow/dataflow/statics/pipelines/api_pipelines/kbcleaning_pipeline.py:74-97、DataFlow/dataflow/statics/pipelines/api_pipelines/pdf_vqa_extract_pipeline.py:70-86、DataFlow/dataflow/operators/core_speech/generate/speech2text_generator.py:16。
图:案例 7 分叉链组件图。
04 内测能力:断点恢复与 Batch 化推理
读者收获:resume 是算子级整数游标 (不是样本级)、两套实现的差异、_last_success_step.txt 的写入时机、batch 的三层归属(编排/存储/serving)、以及"batch 不等于省内存"的反直觉事实。
关键 file:line:DataFlow/dataflow/pipeline/Pipeline.py:507-541、:548-622、DataFlow/dataflow/utils/storage.py:948/957/997/1100。
图:resume 状态迁移图。
05 九条生产级流水线的编排骨架
读者收获:9 条流水线的算子链与适用场景、CPU/GPU/API 三种部署形态的差异、复用同一算子构建不同领域流水线的手法。
关键 file:line:statics/pipelines/cpu_pipelines/、gpu_pipelines/、api_pipelines/。
图:流水线族谱组件图。
06 模型评估的三档标尺
读者收获:命令行 / pipeline 脚本 / 统一 Benchmark 三档的定位差异、6 类 eval_type 与默认 metric 映射、评估为何比训练数据合成更难工程化。
关键 file:line:DataFlow/dataflow/cli_funcs/cli_eval.py:32/261、DataFlow/dataflow/operators/core_text/eval/bench_dataset_evaluator.py:24、DataFlow/dataflow/operators/core_text/eval/unified_bench_dataset_evaluator.py:31/860。
图:三档评估链路组件图。
07 197 个算子的契约、懒加载与键流盲区
读者收获:算子的一级/二级分类规范、run 签名契约、prompt_restrict 的多对一映射、以及键流追踪盲区 的完整因果链与 A/B 实测。
关键 file:line:DataFlow/dataflow/pipeline/nodes.py:59-66、DataFlow/dataflow/wrapper/auto_op.py:58-82、DataFlow/dataflow/core/prompt.py:28/56、DataFlow/dataflow/operators/core_text/generate/format_str_prompted_generator.py:22/33。
图:键流盲区闭链类图 + 时序图。
99 收尾:论文主张 vs 实现审计
读者收获:P=(D,O,E,S,R) 与代码的逐条对账、"DAG"在 DataFlow 中的真实含义(渲染层上限 vs 源码层能力)、以及一个可迁移的审计方法论。
附录
环境准备
bash
# 常规
git clone --depth 1 https://github.com/OpenDCAI/DataFlow.git
git clone --depth 1 https://github.com/OpenDCAI/DataFlow-WebUI.git

# github.com 的 443 端口 不可达时(本机实测走这条)
curl -sL -o DataFlow.tar.gz "https://codeload.github.com/OpenDCAI/DataFlow/tar.gz/refs/heads/main"
tar -xzf DataFlow.tar.gz -C DataFlow --strip-components=1
# 版本锚定
curl -s https://api.github.com/repos/OpenDCAI/DataFlow/commits/main | grep -m1 '"sha"'
采集说明(本系列的偏差记录)
scripts/fetch_doc_toc.py在本站三种 sitemap 探测全部 404 (VitePress 默认不产 sitemap),且--page只扫<article>/<main>、抓不到<aside class="vp-sidebar">的导航。故自建parse_sidebar.py完成官方目录树还原(7 分组 / 39 叶子),原始 HTML 快照留存。- 本系列未使用
fpNN-源码线:正文已强制 ≥8 条file:line且打穿实现层,另立源码线会造成重复。此为对 skill 默认双轨的显式偏差。
质量门禁
bash
python scripts/quality_gate.py "D:\8_Obsidian _Data\OSS-Blog-Vault\10_DataFlow" \
  --repo "<workspace>/repos" --min-kb 20
python scripts/render_vault_plantuml.py "D:\8_Obsidian _Data\OSS-Blog-Vault\10_DataFlow" --svg未验证声明(本系列全程不写入结论):算子真实执行、vLLM/SGLang 路径、WebUI 端到端、Ray 数据并行、论文性能数字。