架构设计 相关文档,希望互相学习,**************************** ****************************共同进步
知识总览
共19章内容,主要包括:
1)1绪论、2计算机系统、3信息系统、4信息安全技术、5软件工程
2)6数据库设计、7系统架构设计基础知识
3)8系统质量属性与架构评估、9软件可靠性、
10软件架构演化与维护、11未来信息综合技术
4)12信息系统架构设计、13层次式架构设计、14云原生架构设计、
15面向服务架构设计、16嵌入式系统架构设计、17通信系统架构设计、
18安全架构设计、19大数据架构设计
每天进步一点点,加油!小伙伴们!💪
本文学习 第19章 大数据架构设计,以下为个人笔记,希望有所帮助,共同学习。
(涉及案例分析题和论文题,侧重理解性记忆,来源于教材,知识点需要灵活运用)
包括:
传统数据处理系统存在的问题、
大数据处理系统架构分析(大数据处理系统面临挑战、大数据处理系统架构特征)、
Lambda 架构(Lambda 架构对大数据处理系统的理解、应用场景、Lambda架构介绍、 Lambda架构的实现、Lambda 架构优缺点、Lambda 与其他架构模式对比)、
Kappa架构(Kappa架构下对大数据处理系统的理解、架构介绍、Kappa架构的实现、Kappa架构 的优缺点、常见 Kappa架构 变形)、
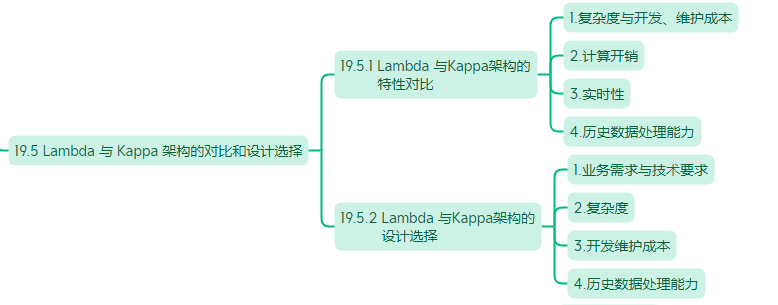
Lambda 与 Kappa 架构的对比和设计选择(Lambda架构与Kappa架构的特性对比、Lambda架构与Kappa架构的设计选择)、
大数据架构设计案例分析(Lambda 架构在某网奥运中的大数据应用、Lambda架构在某网广告平台的应用与演进、某证券公司大数据系统、某电商智能决策大数据系统)。
第19章 大数据架构设计
大数据架构主要面向大数据的容量体量、类型多样、高速实时、客观真实、价值可观、变化多样和复杂多源的特性,既要构建高质量属性的架构解决方案,又受制于成本、性能、可扩展性等诸多条件。同时,云计算、物联网以及边缘计算等客观环境的发展,也对大数据架构的设计提出了弹性、容器化等新的要求。
当前主要技术实践中以 Lambda 架构、Kappa 架构和 IOTA 架构较为典型, 但新版考试大纲中主要考查 Lambda 架构、Kappa 架构在设计中的理论、理解及实践。
19.1 传统数据处理系统存在的问题
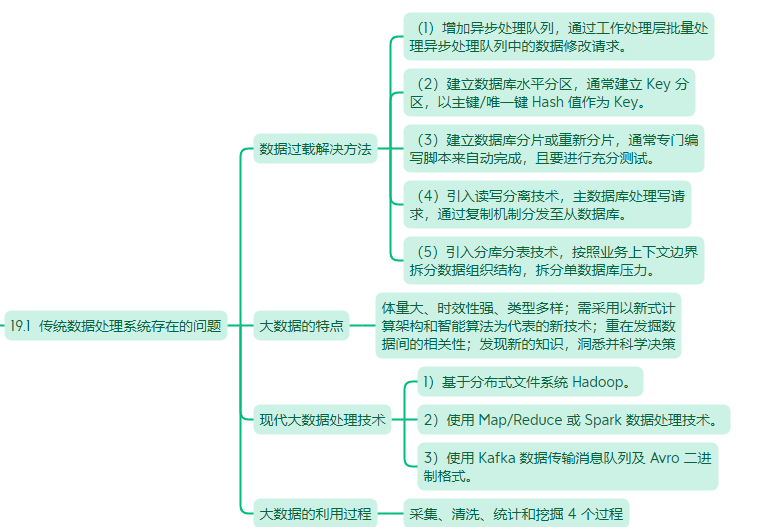
传统数据库的数据过载问题:
传统应用的数据系统架构设计时,应用直接访问数据库系统。当用户访问量增加时,数据库无法支撑日益增长的用户请求的负载,从而导致数据库服务器无法及时响应用户请求,出现超时的错误。常用解决方法如下:
(1)增加异步处理队列,通过工作处理层批量处理异步处理队列中的数据修改请求。
(2)建立数据库水平分区,通常建立 Key 分区,以主键/唯一键 Hash 值作为 Key。
(3)建立数据库分片或重新分片,通常专门编写脚本来自动完成,且要进行充分测试。 (4)引入读写分离技术,主数据库处理写请求,通过复制机制分发至从数据库。
(5)引入分库分表技术,按照业务上下文边界拆分数据组织结构,拆分单数据库压力。
大数据的特点:大数据具有体量大、时效性强的特点,并非构造单调,而是类型多样;处理大数据时,传统数据处理系统因数据过载,来源复杂,类型多样等诸多原因性能低下,需要采用以新式计算架构和智能算法为代表的新技术;大数据的应用重在发掘数据间的相关性,而非传统逻辑上的因果关系;因此,大数据的目的和价值就在于发现新的知识,洞悉并进行科学决策。
现代大数据处理技术,主要分为以下几种:
(1)基于分布式文件系统 Hadoop。
(2)使用 Map/Reduce 或 Spark 数据处理技术。
(3)使用 Kafka 数据传输消息队列及 Avro 二进制格式。
大数据利用过程:大数据的利用过程分为:采集、清洗、统计和挖掘 4 个过程。
19.2 大数据处理系统架构分析
19.2.1 大数据处理系统面临挑战
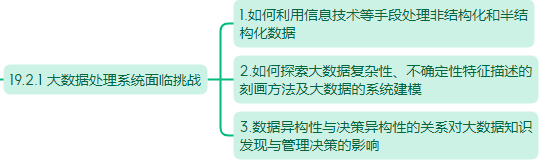
大数据处理系统面临的挑战主要有:
1.如何利用信息技术等手段处理非结构化和半结构化数据
2.如何探索大数据复杂性、不确定性特征描述的刻画方法及大数据的系统建模
3.数据异构性与决策异构性的关系对大数据知识发现与管理决策的影响
19.2.2 大数据处理系统架构特征
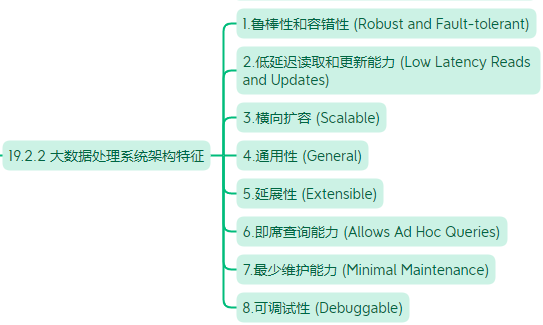
大数据处理系统应具有的属性和特征包括:鲁棒性和容错性、低延迟、横向扩展(通过增强机器性能扩展)、通用、可扩展、即席查询(用户按照自己的要求进行查询)、最少维护和可调试。
1.鲁棒性和容错性 (Robust and Fault-tolerant)
2.低延迟读取和更新能力 (Low Latency Reads and Updates)
3.横向扩容 (Scalable)
4.通用性 (General)
5.延展性 (Extensible)
6.即席查询能力 (Allows Ad Hoc Queries)
7.最少维护能力 (Minimal Maintenance)
8.可调试性 (Debuggable)
19.3 Lambda 架构
19.3.1 Lambda 架构对大数据处理系统的理解

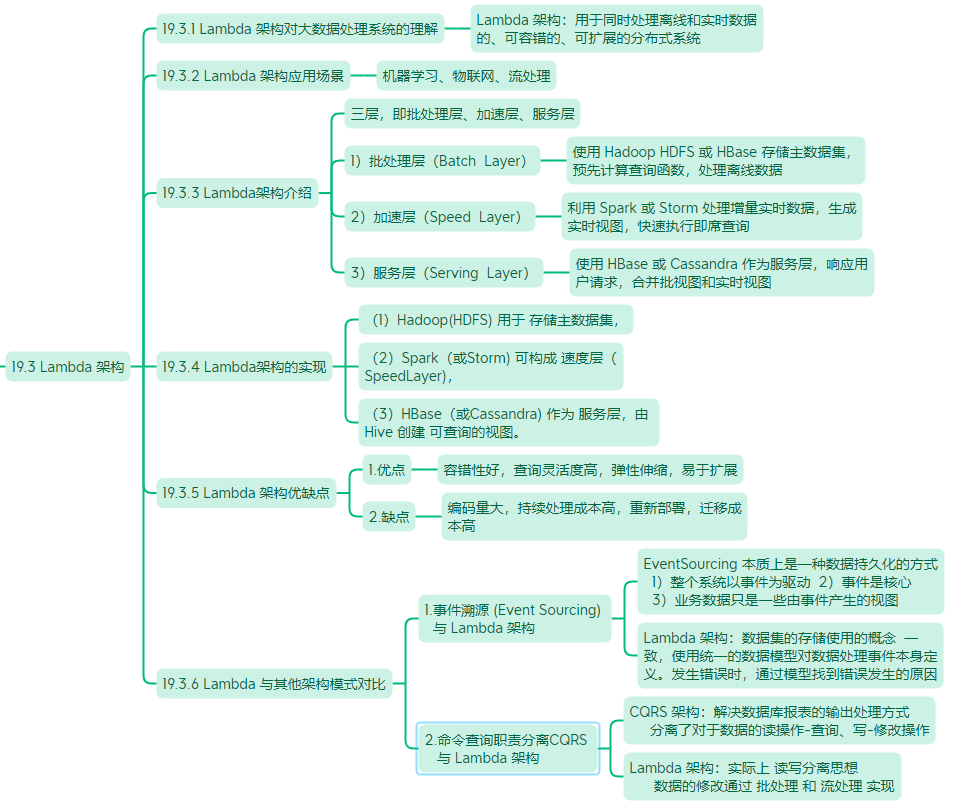
Lambda 架构是一种用于同时处理离线和实时数据的、可容错的、可扩展的分布式系统。
Lambda 架构设计目的在于 提供一个能满足大数据系统关键特性的架构,包括高容错、低延迟、可扩展等。其整合离线计算与实时计算,融合不可变性、读写分离和复杂性隔离等原则。Lambda是用于同时处理离线和实时数据的,可容错的,可扩展的分布式系统。它具备强鲁棒性,提供低延迟和持续更新。
19.3.2 Lambda 架构应用场景

Lambda架构应用场景:机器学习、物联网、流处理。
1.机器学习中的 Lambda架构
2.物联网的 Lambda架构
3.流处理和 Lambda 架构挑战
19.3.3 Lambda架构介绍
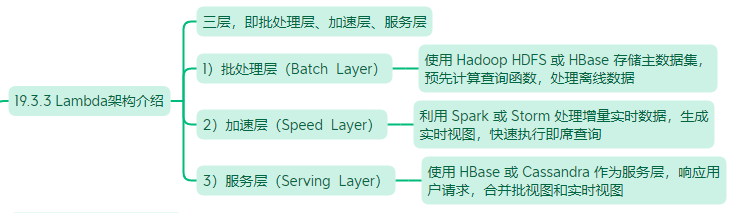
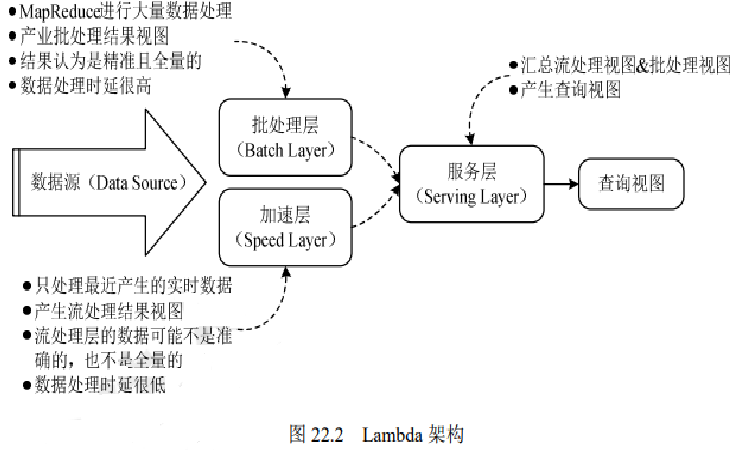
Lambda 架构可分解为三层,即 批处理层、加速层、服务层。
Lambda 架构分为以下 3 层:(1)批处理层(Batch Layer)。
该层核心功能是存储主数据集,主数据集数据具有原始、不可变、真实的特征。批处理层周期性地将增量数据转储至主数据集,并在主数据集上执行批处理,生成批视图。
Batch Layer 在数据集上预先计算查询函数,并构建查询所对应的View。BatchLayer可以很好地处理离线数据,但有很多场景数据不断实时生成,并且需要实时查询处理。Speed Layer正是用来处理增量的实时数据。
架构实现方面可以 使用 Hadoop HDFS 或 HBase 存储主数据集,再利用 Spark 或 MapReduce 执行周期批处理,之后使用 MapReduce 创建批视图。
(2)加速层(Speed Layer)。
该层的核心功能是处理增量实时数据,生成实时视图,快速执行即席查询。
Batch Layer 处理的是全体数据集,而 Speed Layer 处理的是最近的增量数据流。Speed Layer为了效率,在接收到新的数据后会不断更新Real-time View, 而Batch Layer是根据全体离线数据集直接得到BatchView。
架构实现方面可以 使用 Hadoop HDFS 或 HBase 存储实时数据,利用 Spark 或 Storm 实现实时数据处理和实时视图。
(3)服务层(Serving Layer)。
该层的核心功能是响应用户请求,合并批视图和实时视图中的结果数据集得到最终数据集。具体来说就是接收用户请求,通过索引加速访问批视图,直接访问实时视图,然后合并两个视图的结果数据集生成最终数据集,响应用户请求。
Serving Layer 用于合并 Batch View 和 Real-time View 中的结果数据集到最终数据集。用于响应用户的查询请求。
架构实现方面可以 使用 HBase 或 Cassandra 作为服务层,通过 Hive 创建可查询的视图。
19.3.4 Lambda架构的实现
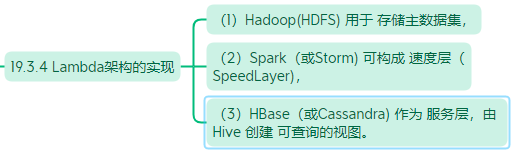
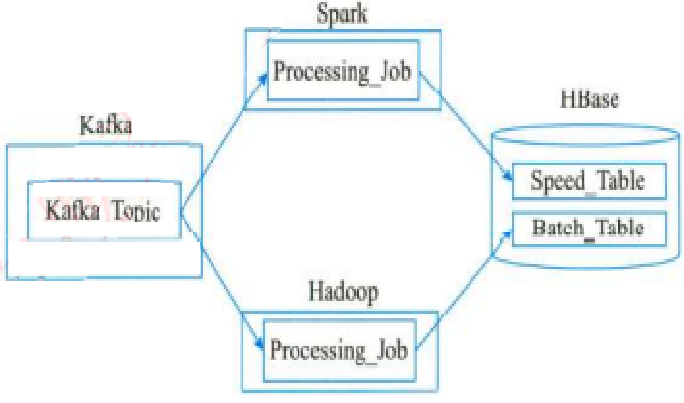
如图所示,在这种 Lambda 架构实现中:
(1)Hadoop(HDFS) 用于 存储主数据集,
(2)Spark(或Storm) 可构成 速度层(SpeedLayer),
(3)HBase(或Cassandra) 作为 服务层,由 Hive 创建 可查询的视图。
◆ Hadoop 是被设计成适合运行在通用硬件上的分布式文件系统。HDFS是一个具有高度容错性的系统,能提供高吞吐量的数据访问,非常适合大规模数据集上的应用。HDFS放宽了一些约束,以达到流式读取文件系统数据的目的。
◆ ApacheSpark 是专为大规模数据处理而设计的快速通用的计算引擎。Spark 中间输出结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的Map Reduce算法。
◆ HBase-HadoopDatabase,是一个高可靠性、高性能、面向列、可伸缩的分布式存储系统,利用HBase技术可在廉价 PCServer 上搭建起大规模结构化存储集群。
19.3.5 Lambda 架构优缺点
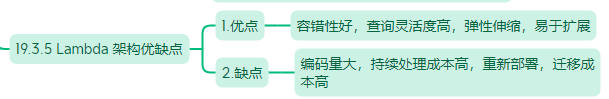
Lambda 架构优缺点:
(1)Lambda 架构的优点:容错性好,查询灵活度高,弹性伸缩,易于扩展。
(2)Lambda 架构的缺点:编码量大,持续处理成本高,重新部署,迁移成本高。
全场景覆盖带来的编码开销。针对具体场景重新离线训练一遍益处不大。重新部署和迁移成本很高。
19.3.6 Lambda 与其他架构模式对比
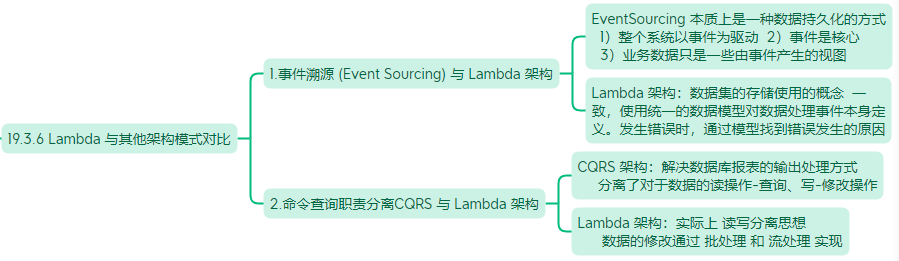
与 Lambda 架构相似的模式有事件溯源模式、命令查询职责分离模式。
1.事件溯源 (Event Sourcing) 与 Lambda 架构
EventSourcing 本质上是一种数据持久化的方式,其由三个核心观点构成:
(1)整个系统以事件为驱动,所有业务都由事件驱动来完成。
(2)事件是核心,系统的数据以事件为基础,事件要保存在某种存储上。
(3)业务数据只是一些由事件产生的视图,不一定要保存到数据库中。
Lambda 架构中 数据集的存储使用的概念与 Event Sourcing 中的思想完全一致,二者都是在使用统一的数据模型对数据处理事件本身进行定义。这样在发生错误的时候,能够通过模型找到错误发生的原因,对这一事件进行重新计算以丢弃错误信息,恢复到系统应该的正确状态,以此实现了系统的容错性。
2.CQRS与 Lambda 架构
CQRS 架构 分离了对于数据进行的读操作(查询)和写(修改)操作。其将能够改变数据模型状态的命令 和 对于模型状态的查询操作 实现了分离。这是领域驱动设计的一个架构模式,主要用来解决数据库报表的输出处理方式。
Lambda 架构中,数据的修改通过 批处理 和 流处理 实现,通过写操作将数据转换成查询时所对应的View。在Lambda架构中,对数据进行查询时,实际上是通过读取 View 直接得到结果,读出所需的内容。这实际上是一种形式的读写分离。
19.4 Kappa架构
【架构专栏】第19章 大数据架构设计 2/2 https://blog.csdn.net/weixin_42081167/article/details/166735588
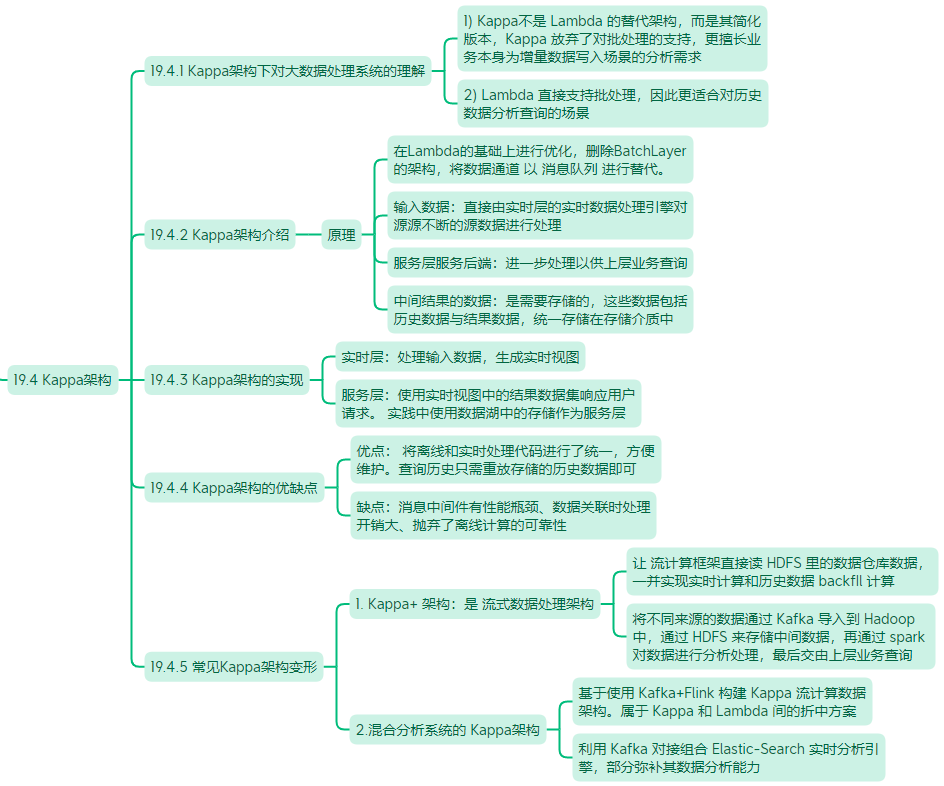
19.5 Lambda 与 Kappa 架构的对比和设计选择
【架构专栏】第19章 大数据架构设计 2/2https://blog.csdn.net/weixin_42081167/article/details/166735588
19.6 大数据架构设计案例分析
【架构专栏】第19章 大数据架构设计 2/2https://blog.csdn.net/weixin_42081167/article/details/166735588
习题:
以下关于大数据的说法中,错误的是( )。
A.大数据拥有体量大、++构造单调++、时效性强等特点
B.处理大数据需要采用新式计算架构和智能算法等新技术
C.大数据的应用着重相关剖析,而不是因果剖析
D.大数据的目的在于发现新的知识,洞悉并进行科学决策
解析:大数据具有体量大、时效性强的特征,并非构造单调,而是类型多样;处理大数据时, 传统数据处理系统因数据过载,来源复杂,类型多样等诸多原因性能低下,需要采用以新式计算架构和智能算法为代表的新技术;大数据的应用重在发掘数据间的相关性,而非传统逻辑上的因果关系;因此,大数据的目的和价值就在于发现新的知识,洞悉并进行科学决策。
答案:A
Lambda 架构分为三层: (1) 的核心功能是存储主数据集。 (2) 的核心功能是处理增量实时数据,生成实时视图,快速执行即席查询。 (3) 的核心功能是响应用户请求,合并批 视图和实时视图中的结果数据集得到最终数据集。(1)A.批处理层 B.流处理层 C.加速层 D.存储层
(2)A.批处理层 B.服务层 C.加速层 D.视图层
(3)A.视图层 B.流处理层 C.服务层 D.存储层
解析:Lambda 架构分为 3 层:
(1)批处理层。该层的核心功能是存储主数据集,主数据集数据具有原始、不可变、真实的 特征。批处理层周期性地将增量数据转储至主数据集,并在主数据集上执行批处理,生成批视图。 架构实现方面可以使用 Hadoop HDFS 或 HBase 存储主数据集,再利用 Spark 或 Map/Reduce 执行 周期批处理,之后使用 Map/Reduce 创建批视图。
(2)加速层。该层的核心功能是处理增量实时数据,生成实时视图,快速执行即席查询。架 构实现方面可以使用 Hadoop HDFS 或 HBase 存储实时数据,利用 Spark 或 Storm 实现实时数据处理和实时视图。
(3)服务层。该层的核心功能是响应用户请求,合并批视图和实时视图中的结果数据集得到最终数据集。具体来说就是接收用户请求,通过索引加速访问批视图,直接访问实时视图,然后合并两个视图的结果数据集生成最终数据集,响应用户请求。架构实现方面可以使用 HBase 或 Cassandra 作为服务层,通过 Hive 创建可查询的视图。
答案:A C C
ok, 今天就到这里吧 🤗
相关系列文章,欢迎点赞、收藏,提供意见!****
计算机系统基础知识 1分:概述、计算机硬件、计算机软件
操作系统 3分:进程管理、存储管理、文件管理、设备管理
数据库技术 3分:数据库设计、关系代数、范式、事务并发、数据库安全、新技术
嵌入式技术 3分:嵌入式硬件、嵌入式操作系统、嵌入式软件开发
计算机网络 3分(超纲较多):OSI七层模型、TCP/IP协议族、网络生命周期、IP地址
其他计算机系统基础知识 1分:计算机语言、多媒体、系统工程
系统性能 1分:性能指标、性能设计
信息系统基础知识 3分:信息系统生命周期、开发方法、五大典型系统
信息安全技术基础 5分:安全属性、信息安全技术、网络安全技术、安全协议
软件工程 12分:概述、需求工程、系统设计、运维、测试、基于构件;
面向对象技术 3分:面向对象基础、分析设计、UML关系、图
项目管理 1分:进度管理、配置管理、质量管理、风险管理
系统架构设计 20分:架构概念、生命周期、ABSD、DSSA、架构风格、
架构复用、质量属性、架构评估
软件可靠性 2分:可靠性建模、软件可靠性设计
软件架构的演化和维护1分:架构演化分类、评估、面向对象架构演化
未来信息综合技术 3分:信息物理系统、人工智能、边缘计算、机器人、数字李生、云计算
数学与经济管理 2分:最小生成树、最短路径、网络与最大流量、线性规划、决策论
知识产权和标准化 2分:知识产权属性、保护期限、产权人确定、侵权判定
专业英语 5分:完形填空,大学英语3级难度,自学
|--------------------------------------------------------------------------------------------------------------------------------------|--------------------------------------------------------------------------------------------------------------------------------------------------|
| 【架构专栏】架构考试介绍 | 【架构专栏】架构知识点 |
| 【架构专栏】第1章 绪论 | 【架构专栏】第11章 未来信息综合技术 |
| 【架构专栏】第2章 计算机基础知识 | 【架构专栏】第12章 信息系统架构设计理论与实践 |
| 【架构专栏】第3章 信息系统基础知识 | 【架构专栏】第13章 层次式架构设计理论与实践 |
| 【架构专栏】第4章 信息安全技术基础知识 | 【架构专栏】第14章 云原生架构设计理论与实践 |
| 【架构专栏】第5章 软件工程基础知识 | 【架构专栏】第15章 面向服务架构设计理论与实践 |
| 【架构专栏】第6章 数据库设计基础知识 | 【架构专栏】第16章 嵌入式系统架构设计理论与实践 |
| 【架构专栏】第7章 系统架构设计基础知识 | 【架构专栏】第17章 通信系统架构设计理论与实践 |
| 【架构专栏】第8章 系统质量属性与架构评估 | 【架构专栏】第18章 安全架构设计理论与实践 |
| 【架构专栏】第9章 软件可靠性基础知识 | 【架构专栏】第19章 大数据架构设计理论与实践 |
| 【架构专栏】第10章 软件架构的演化和维护 | |
[架构专栏 知识点]
希望有所帮助,互相学习、共同进步,欢迎点赞、收藏!