沙漠和洪水在SAR里为什么都"黑"?RSE如何用Sentinel-1相干性破解干旱区洪水误判
- 一、为什么干旱区洪水一直是SAR洪水制图的"盲区"?
-
- [1. 一般洪水监测依赖"水比陆地更黑"](#1. 一般洪水监测依赖“水比陆地更黑”)
- [2. 干沙为什么也会"黑"?](#2. 干沙为什么也会“黑”?)
- [3. 现实中的解决办法:干脆把沙漠排除掉](#3. 现实中的解决办法:干脆把沙漠排除掉)
- 二、作者没有立刻换模型,而是先问四个更基础的问题
- 三、为什么选择伊朗、土库曼斯坦和巴基斯坦?
- 四、参考洪水图怎么做?作者先解决"标准答案"问题
- 五、真正关键的变量之一:VV和VH到底谁更适合沙漠洪水?
- 六、仅看灾后影像为什么不够?因为你不知道"这里是不是本来就黑"
- 七、但变化检测仍然没有彻底解决问题
- 八、真正拉开差距的变量:InSAR相干性
-
- [1. 什么是相干性?](#1. 什么是相干性?)
- [2. 这正好补上"沙和水都黑"的缺陷](#2. 这正好补上“沙和水都黑”的缺陷)
- 九、作者不是只算一张相干图,而是区分"灾前相干"和"跨洪水相干"
- 十、七种情景:作者把Sentinel-1的信息一层层加进去
- 十一、为什么不用深度学习?
- 十二、幅度和相干性到底谁更好?答案是:单独都不够
- [十三、最关键结果:幅度 + 相干性明显优于单独使用任何一种](#十三、最关键结果:幅度 + 相干性明显优于单独使用任何一种)
- 十四、一个很有意思的负结果:灾前相干性几乎没必要
- 十五、作者进一步问:八层数据里,到底哪三层最重要?
- 十六、只保留三层,精度几乎不变
- 十七、为什么"删数据"反而是这篇论文很重要的贡献?
- 十八、论文摘要里说"精度提高约50%",应该怎么理解?
- 十九、模型能不能直接从伊朗拿去巴基斯坦用?答案:还不够
- [二十、这篇论文真正的创新,不是Random Forest](#二十、这篇论文真正的创新,不是Random Forest)
-
- [1. 从"排除沙漠"转向"识别沙漠洪水"](#1. 从“排除沙漠”转向“识别沙漠洪水”)
- [2. 幅度 + 相干性互补](#2. 幅度 + 相干性互补)
- [3. 找到最小有效特征集](#3. 找到最小有效特征集)
- 二十一、这套方法对全球洪水监测意味着什么?
-
- [1. 全球洪水产品可能不必继续"绕开沙漠"](#1. 全球洪水产品可能不必继续“绕开沙漠”)
- [2. Sentinel-1 SLC的价值没有被完全利用](#2. Sentinel-1 SLC的价值没有被完全利用)
- [3. 云计算正在降低相干性应用门槛](#3. 云计算正在降低相干性应用门槛)
- [总结:这篇论文最值得记住的,不是Random Forest,而是"低幅度 + 低相干"](#总结:这篇论文最值得记住的,不是Random Forest,而是“低幅度 + 低相干”)
- 论文信息
一句话读懂这篇论文:
干旱区最大的难题不是"看不见洪水",而是干沙和水在Sentinel-1幅度影像中都可能表现为低后向散射;这篇论文通过把VV极化的灾前---灾后幅度变化与InSAR相干性结合起来,让模型同时看到"这里本来就很黑"以及"这里是否真的发生了变化",从而显著减少沙地被误判成洪水。
用SAR做洪水监测,通常依赖一个非常经典的物理特征:水面比较平滑,对雷达产生镜面反射,因此返回卫星的能量少,在SAR影像中往往表现为低后向散射,也就是"黑"。
在植被、农田或一般陆地背景中,这种方法通常非常有效。但到了沙漠,事情突然变得复杂。干燥、平坦的沙地同样可能产生很低的后向散射,在Sentinel-1影像中也会显得很暗。
于是,一个非常现实的问题出现了:
当沙漠和洪水在SAR影像里都很黑时,算法到底怎么知道哪里真的被淹了?
Shagun Garg等人在发表于 Remote Sensing of Environment 的论文《Unlocking the full potential of Sentinel-1 for flood detection in arid regions》中,系统研究了Sentinel-1中不同类型的信息------包括极化、灾前灾后幅度信息以及干涉相干性------究竟哪些真正能够帮助干旱区洪水识别。
这篇论文最重要的地方,不是提出一个更复杂的深度学习模型。它做的是一件更基础、也更关键的事情:
把Sentinel-1中"哪些信息对干旱区洪水真正有用"这件事系统拆开、逐一测试,并最终找到一套更适合近实时业务运行的最简特征组合。
一、为什么干旱区洪水一直是SAR洪水制图的"盲区"?
1. 一般洪水监测依赖"水比陆地更黑"
在常规SAR洪水制图中,水体通常表现为低后向散射。因此,最简单的方法就是:
text
SAR后向散射很低
        ↓
可能是水
        ↓
阈值分割
        ↓
得到洪水范围
这种方法计算快、容易自动化,因此广泛用于洪水应急监测。但它有一个隐含前提:
非水地表不能和水体拥有相似的低后向散射。
干旱区恰恰破坏了这个前提。
2. 干沙为什么也会"黑"?
SAR后向散射不仅取决于有没有水,还受到表面粗糙度、土壤含水量、介电常数、雷达波长、入射角和地表结构等因素影响。
在干燥、平坦的沙质地表中,土壤含水量低、介电常数低,同时表面可能非常平滑,因此Sentinel-1 C波段返回的能量本身就很弱。
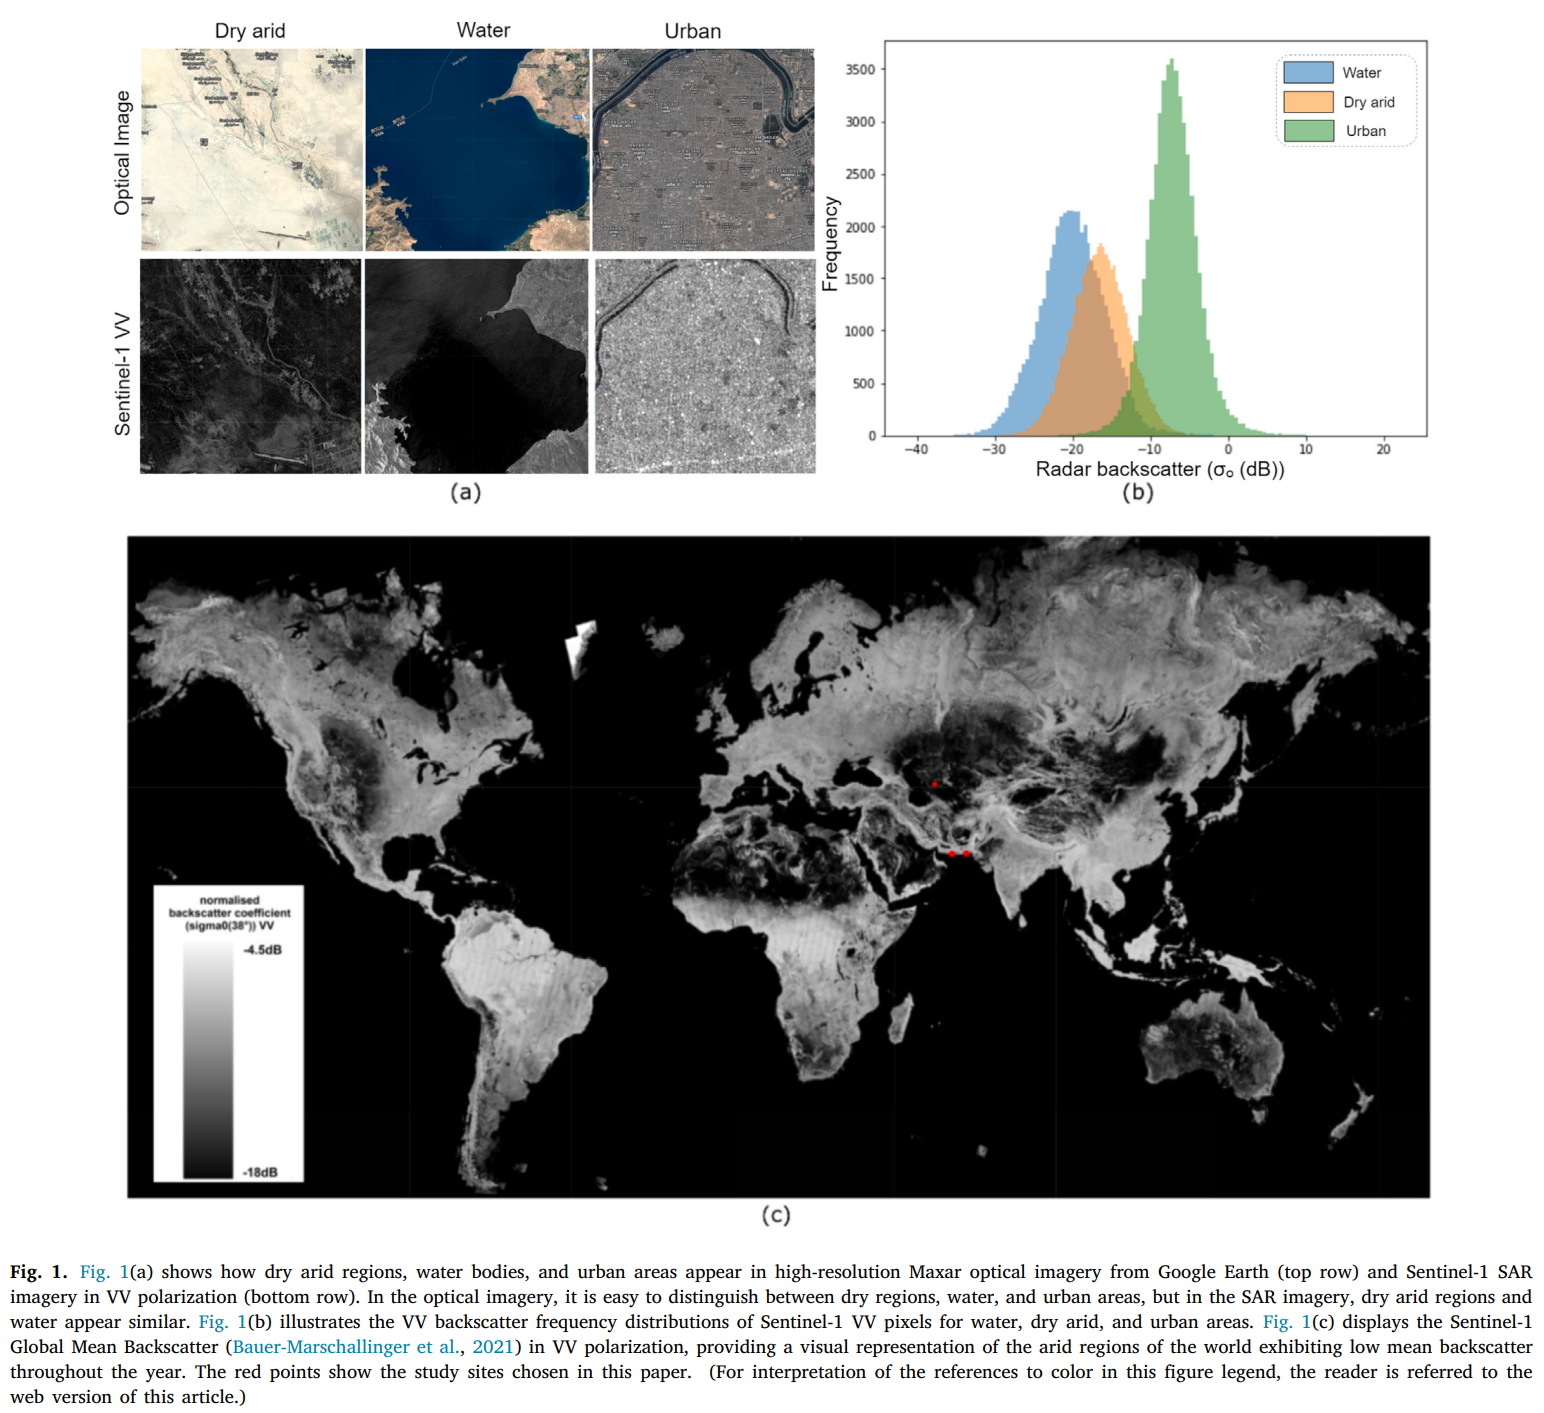
论文图1给出了一个非常直观的例子。在光学影像中,干沙、水体和城市非常容易区分;但在对应的Sentinel-1 VV影像中,水体平均后向散射约为 −19.20 dB ,干旱地表约为 −17 dB ,城市则约为 −6.30 dB。
也就是说:
水和干沙的后向散射分布高度重叠。
因此,仅靠"像元够不够黑"这一条规则,很难稳定分辨两者。
3. 现实中的解决办法:干脆把沙漠排除掉
目前一些全球洪水制图系统为了减少误报,会使用排除层。当某些区域长期表现为低后向散射,例如沙地、平坦裸地、雷达阴影或某些不透水表面,系统会直接将这些区域排除出洪水检测过程。
这种做法确实可以提高总体精度,但代价也非常明显:
如果洪水真的发生在这些被排除的区域,系统就什么也不告诉你。
而在气候变化背景下,干旱和半干旱区的极端降雨和突发洪水正变得越来越值得关注。
所以,这篇论文的核心问题不是"怎样让现有算法在沙漠里少误报一点",而是:
能不能不再把干旱区当作"不可监测区域",而是真正利用Sentinel-1把洪水识别出来?
二、作者没有立刻换模型,而是先问四个更基础的问题
论文把研究目标拆成了四个非常清楚的问题:
- VV和VH极化,哪一种更适合干旱区洪水?
- 加入InSAR相干性,是否真的能提高精度?
- 灾前影像是否必须加入?
- 在精度、计算速度和可解释性之间,最优特征组合是什么?
这四个问题其实对应了一个非常实用的业务逻辑。如果目标是构建全球或近实时洪水系统,那么并不是特征越多越好。每增加一层数据,都意味着更多下载、更多预处理、更高存储和计算成本,以及更长响应时间。
因此,作者真正要寻找的是:
最有信息量,而不是最多的信息。
三、为什么选择伊朗、土库曼斯坦和巴基斯坦?
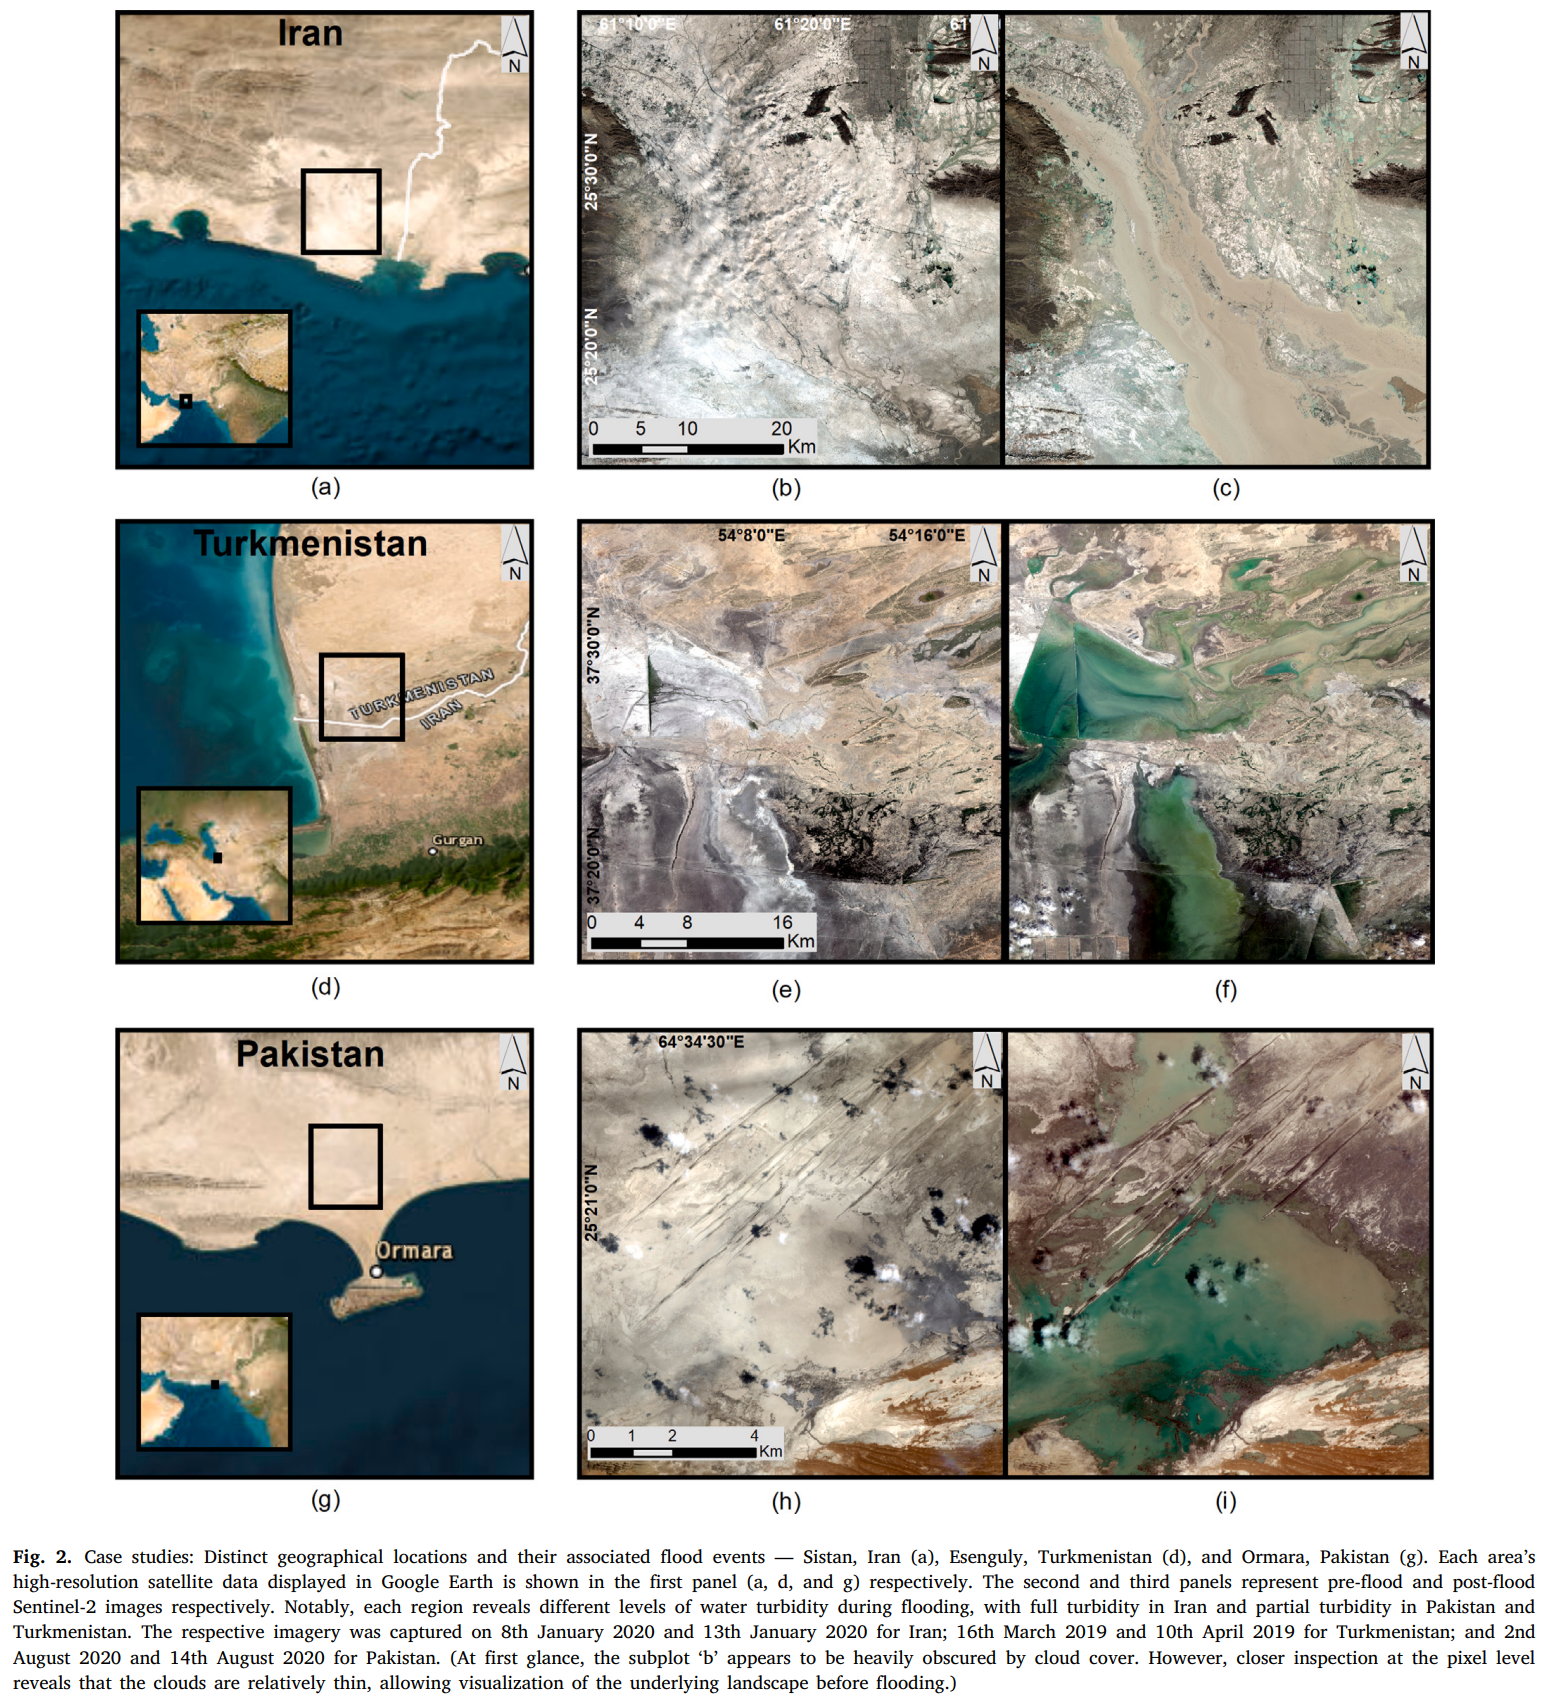
作者最终筛选了三个真实干旱区洪水事件:
- 伊朗 Sistan,2020年1月洪水;
- 土库曼斯坦 Esenguly,2019年4月洪水;
- 巴基斯坦 Ormara,2020年8月洪水。
这三个案例包括强降雨与水坝溢流、水坝失效以及季风强降雨洪水。三个区域都以裸地、沙地、岩石和稀疏植被为主,因此非常适合测试"沙地---洪水混淆"这一核心问题。
更重要的是,作者要求同一天同时具有:
Sentinel-1 SAR + Sentinel-2光学影像
Sentinel-2在这里并不是实际业务运行所必须的数据,而是用于制作参考洪水图。因此,论文的方法本身仍然是:
只依赖Sentinel-1进行洪水识别。
这一点非常关键,因为洪水发生时,真正最需要SAR的原因恰恰就是光学影像可能被云覆盖。
四、参考洪水图怎么做?作者先解决"标准答案"问题
为了评价Sentinel-1分类结果,作者利用同日Sentinel-2制作参考洪水范围。
在干旱区,这一步本身也并不简单。洪水往往携带大量泥沙,水体不一定是典型深色或清澈水体。
因此,作者结合Sentinel-2 B3绿光、B8近红外、B11短波红外、MNDWI与Otsu自动阈值生成水体掩膜,并进一步进行人工检查和清理。
最终参考数据分为:
text
water
land
no data
论文也明确承认,即使使用同日光学影像,泥沙洪水边界仍然存在不确定性。因此,后面的精度指标更准确地理解为:
Sentinel-1结果与同日Sentinel-2参考洪水图之间的一致性。
而不是严格意义上的现场"绝对真值"。
五、真正关键的变量之一:VV和VH到底谁更适合沙漠洪水?
Sentinel-1常见的双极化数据包括VV和VH。很多洪水研究中VH也经常被使用,因为它对植被、体散射等信息比较敏感。
但论文发现:
在干旱区,VV明显优于VH。
作者专门设计了Scenario 2(VH灾前---灾后变化)和Scenario 3(VV灾前---灾后变化)。
三个研究区的结果都表现出相同趋势。与VH相比,使用VV后:
| 区域 | IOU提升 | F1提升 |
|---|---|---|
| 伊朗 | 50% | 13% |
| 土库曼斯坦 | 16% | 10% |
| 巴基斯坦 | 21% | 12% |
VH属于交叉极化,对植被中的体散射更敏感。但干旱区往往植被稀少、地表平坦、沙土干燥,雷达波容易进入干沙并产生较弱的交叉极化返回,因此VH本身就可能长期处于低后向散射。
相比之下,VV对地表粗糙度和介电变化的响应更明显。因此,当干沙被洪水覆盖后,VV中的前后变化更容易被检测出来。
论文结论中给出的平均结果是:
VV相较VH,平均IOU提高约29%,F1提高约12%。
这也是本文非常重要的业务结论:
在干旱区洪水监测中,不应该机械套用其他地表环境下的极化经验。
六、仅看灾后影像为什么不够?因为你不知道"这里是不是本来就黑"
如果只有一张灾后SAR影像,那么一个低后向散射像元可能代表洪水、原本就存在的干沙、永久水体或平滑裸地。
因此,作者比较了两种情况。
Scenario 1只使用灾后幅度,也就是直接问:
"现在这里是不是很黑?"
Scenario 4加入灾前和灾后幅度,也就是变化检测:
"这里和洪水之前相比,是否发生了明显改变?"
结果非常明确。加入灾前信息后:
- 伊朗IOU提高21%,F1提高14%;
- 土库曼斯坦IOU提高13%,F1提高8%;
- 巴基斯坦IOU提高24%,F1提高15%。
论文总结时进一步概括为:
灾前+灾后幅度信息相较仅使用灾后数据,IOU平均提升约25%,F1提升约16%。
这背后的逻辑非常直观。一个沙地像元即使一直很黑,只要灾前灾后没有明显变化,就不应该被当作洪水;真实洪水区域则会出现更明显的状态变化。
因此,时间信息实际上提供了一个"历史基线"。
七、但变化检测仍然没有彻底解决问题
到这里,似乎已经找到答案:用VV灾前---灾后变化检测就行了。
但作者继续向前走了一步。
因为在干旱区,某些地表本身的幅度变化仍可能复杂。仅依靠幅度变化,仍然会出现漏检、边界混淆和局部误报。
所以作者开始利用Sentinel-1 SLC中一个经常在常规洪水制图中被忽略的信息:
干涉相干性。
八、真正拉开差距的变量:InSAR相干性
1. 什么是相干性?
相干性可以简单理解为:
同一个地表在两次SAR成像之间有多"稳定"。
其取值通常在0到1之间:
text
接近1 → 两次观测非常相似,地表稳定
接近0 → 两次观测差异很大,发生明显变化
如果一片干燥裸地在两个时间点之间没有发生变化,相干性通常较高。
如果洪水突然覆盖了这片地表,表面粗糙度、介电性质、散射机制和相位关系都会改变,相干性就会下降。
2. 这正好补上"沙和水都黑"的缺陷
这是全文最核心的物理逻辑。
干沙和水可能都表现为低幅度,但两者在时间稳定性上不同。
未被淹的沙地可能是:
text
低幅度 + 高相干性真正发生洪水的区域则可能变成:
text
低幅度 + 低相干性因此,相干性提供的是:
幅度数据里没有的"变化真实性"证据。
九、作者不是只算一张相干图,而是区分"灾前相干"和"跨洪水相干"
论文构建了两类相干性。
第一类是Pre-flood coherence,完全位于洪水发生之前,描述正常情况下这个区域本身有多稳定。
第二类是Co-flood coherence,由一景灾前和一景洪水期间SAR组成,描述洪水发生前后地表是否失去相干。
两种相干图都使用约12天时间间隔的Sentinel-1 SLC影像生成。
这一设计让作者能够进一步回答:
是否有必要把灾前相干背景也加入模型?
十、七种情景:作者把Sentinel-1的信息一层层加进去
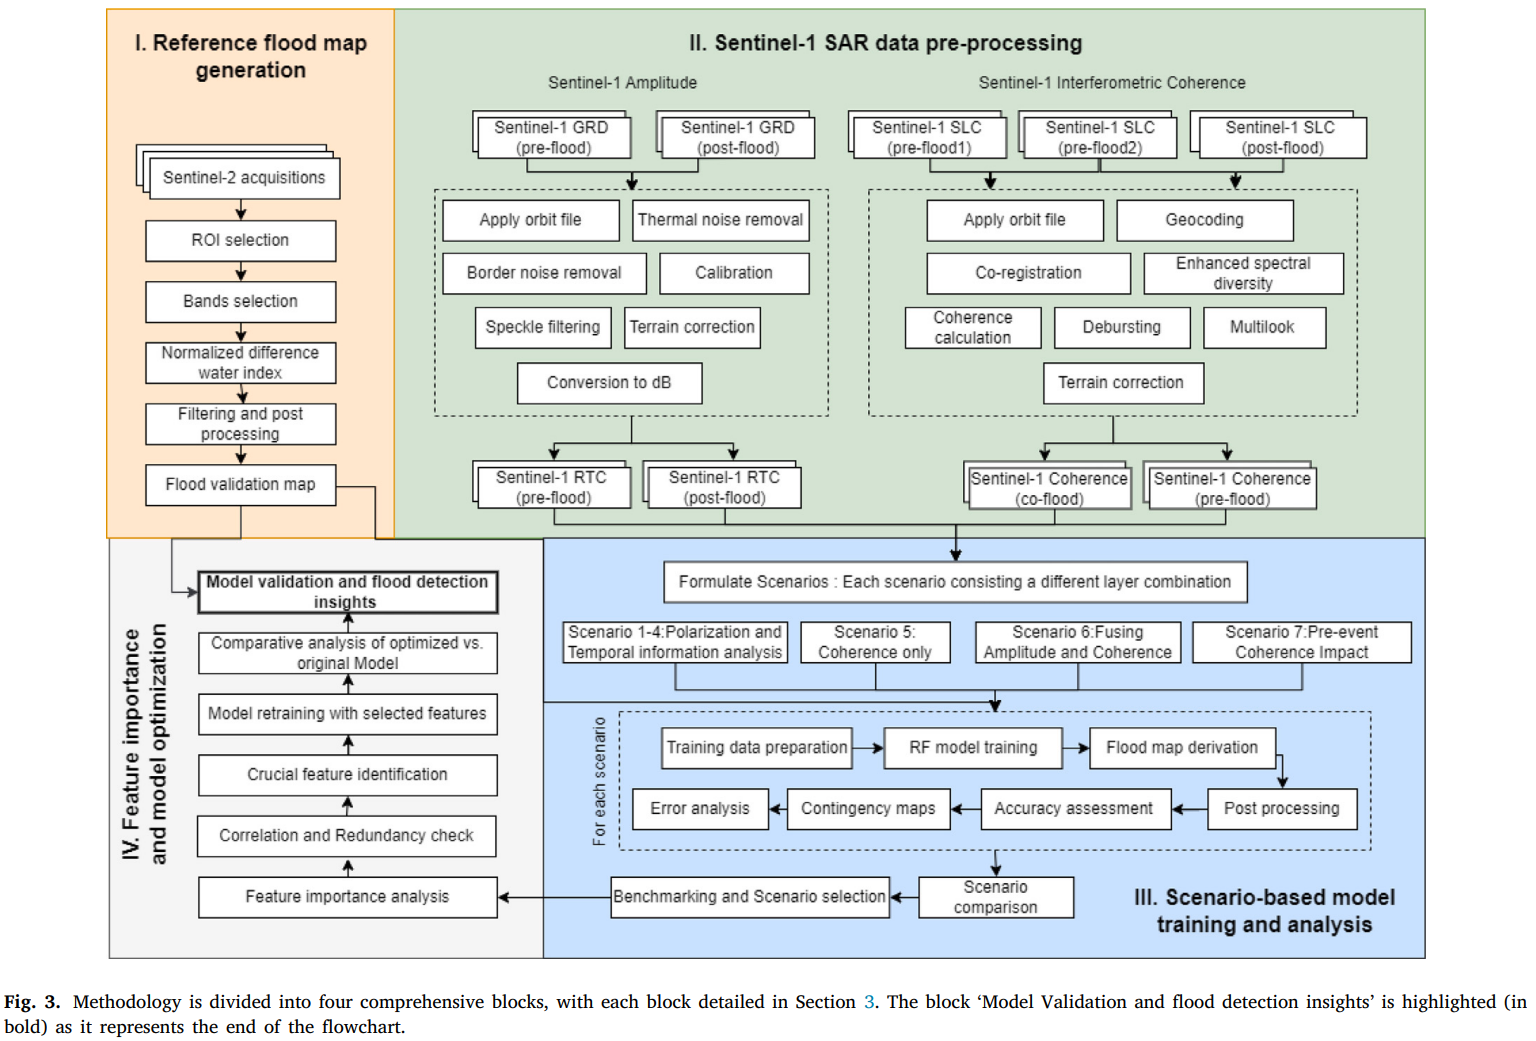
整篇论文的实验设计非常清晰。作者没有直接把所有数据扔给模型,而是建立7个场景逐项测试。
| 场景 | 核心目的 |
|---|---|
| Scenario 1 | 只看灾后幅度 |
| Scenario 2 | 测试VH变化检测 |
| Scenario 3 | 测试VV变化检测 |
| Scenario 4 | VV+VH灾前灾后幅度 |
| Scenario 5 | 只看co-flood相干性 |
| Scenario 6 | 幅度 + co-flood相干性 |
| Scenario 7 | 幅度 + co-flood相干性 + pre-flood相干性 |
每个场景都单独训练Random Forest模型。
作者选择RF并不是因为它"最先进",而是因为训练数据有限、速度快、容易解释,而且能够通过特征重要性分析理解每层输入到底贡献多少。
因此,这篇论文更像一个:
SAR信息源消融实验。
模型只是测试平台。
十一、为什么不用深度学习?
论文明确解释了这一点。
作者尝试解决的是:
什么信息真正有用?
而不是单纯追求最高分类精度。
如果一开始直接使用复杂深度神经网络,虽然可能提高精度,但很难清楚解释VV到底有没有贡献、VH是否必要、pre-flood coherence值不值得计算,以及哪一层数据可以删除。
因此,Random Forest在这里的价值是:
让特征效果变得可解释。
同时,三个案例的数据规模有限,RF对少样本更友好。实验中,三个案例都发现:
使用不到总像元1%的训练样本,就足以让模型性能基本稳定。
十二、幅度和相干性到底谁更好?答案是:单独都不够
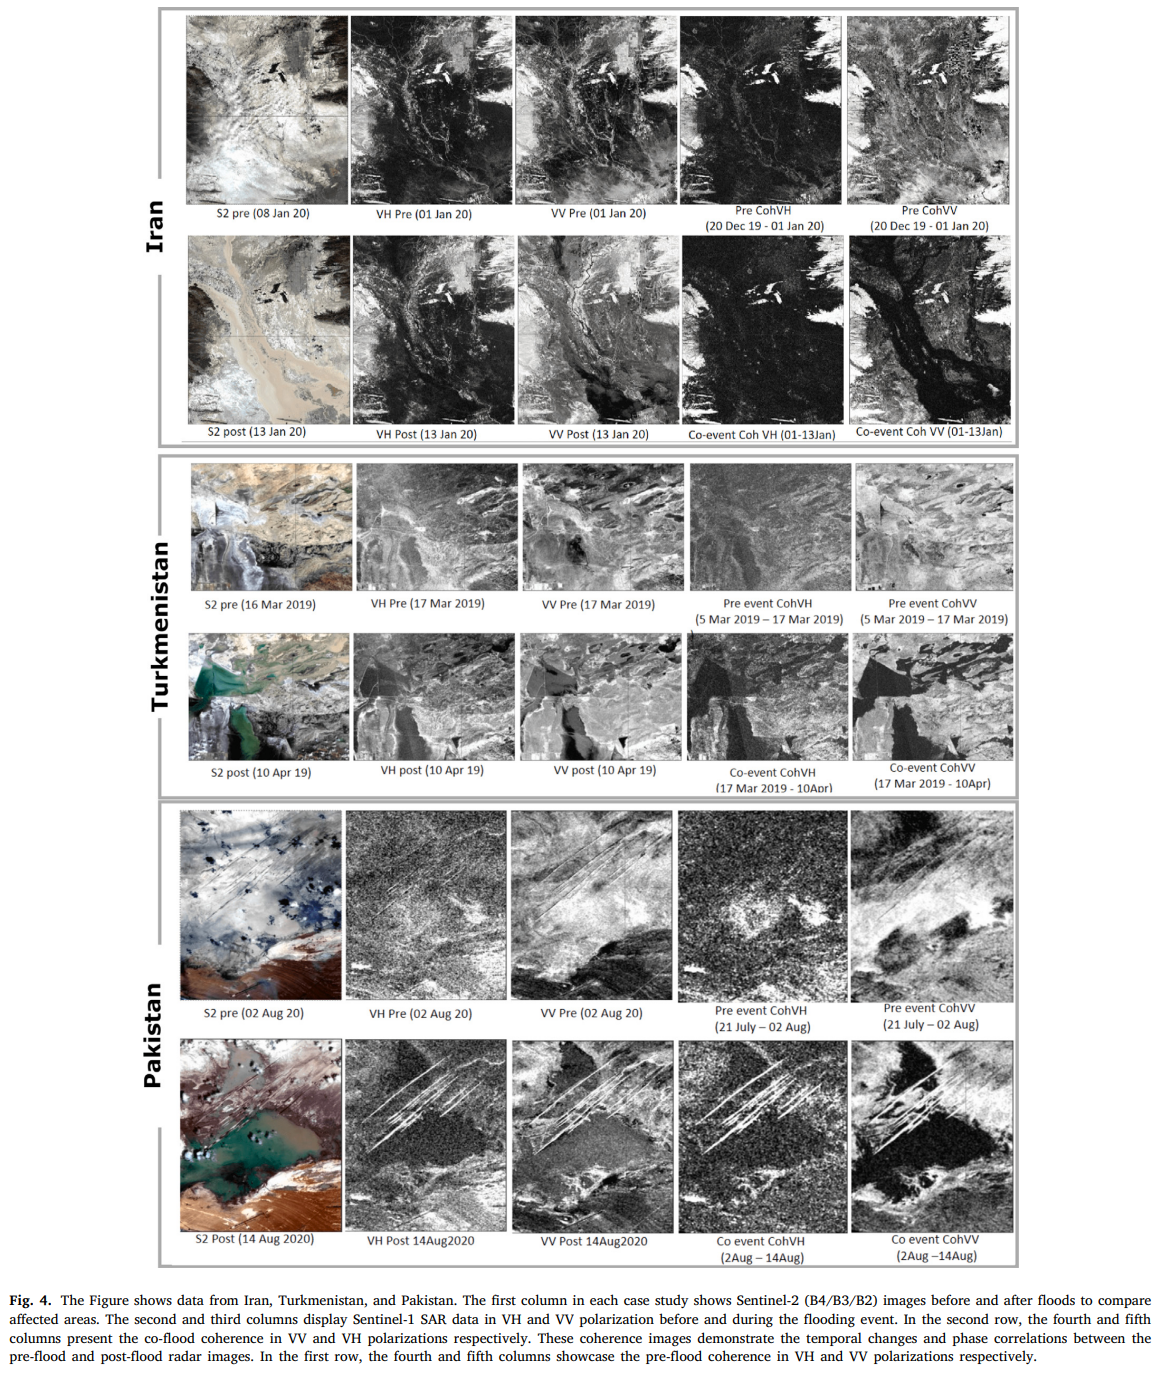
论文首先比较Scenario 4(幅度)和Scenario 5(相干性)。
结果发现,不同地区表现并不完全一致。在土库曼斯坦和巴基斯坦,相干性明显改善了洪水检测;但在伊朗,相干性虽然减少部分漏检,同时又引入新的误报。
为什么?
因为低相干并不是洪水专属现象。例如植被变化、人类活动、工程施工、地表扰动和风沙运动都可能降低相干性。
所以:
相干性本身也不能单独被理解成洪水。
幅度单独使用时,沙和水可能混淆;相干性单独使用时,洪水和其他地表变化可能混淆。
真正有效的是把二者融合。
十三、最关键结果:幅度 + 相干性明显优于单独使用任何一种
Scenario 6将幅度与co-flood coherence融合,这是全文表现最稳定的组合之一。
相较于仅使用幅度的Scenario 4:
| 区域 | IOU提升 | F1提升 |
|---|---|---|
| 伊朗 | 12% | 5% |
| 土库曼斯坦 | 21% | 11% |
| 巴基斯坦 | 26% | 11% |
论文总结时给出的平均结果约为:
IOU提高20%,F1提高10%。
为什么融合能够工作?
因为模型得到的是两种互补证据:
text
幅度:
这个像元现在是否表现得像水?

相干性:
这个像元是否相对于灾前发生了真实地表变化?
将两者结合后,就能区分长期低幅度但稳定的干沙,与低幅度且明显失相干的洪水。
这正是本文真正解决"沙---水混淆"的核心。
十四、一个很有意思的负结果:灾前相干性几乎没必要
按直觉来说,既然灾前影像很重要,那么灾前相干性应该也很重要。
但实验结果并不是这样。
Scenario 7在Scenario 6基础上继续加入VV和VH pre-flood coherence。
结果:
- 伊朗几乎没有提升;
- 巴基斯坦几乎没有提升;
- 土库曼斯坦IOU只提高约1%。
论文图8中,Scenario 6和Scenario 7的雷达图曲线几乎重合。
为什么?
因为co-flood coherence本身已经是一个变化指标,它已经包含"灾前→洪水期间"这一变化信息。
因此,再额外加入纯灾前相干性,在这些干旱案例中提供的新信息非常有限。
这个结果其实非常重要,因为它告诉我们:
不是所有"理论上有用"的数据都值得放进近实时业务系统。
十五、作者进一步问:八层数据里,到底哪三层最重要?
为了避免只依赖场景对比,作者又做了Permutation Feature Importance,也就是PFI分析。
方法很简单:如果把某一层数据随机打乱后,模型精度明显下降,就说明这一层非常重要。
最终结果非常一致。
第一名是:
VV co-flood coherence
在三个案例中都是最重要的特征。打乱它以后,模型精度分别下降:
- 伊朗:约16%;
- 土库曼斯坦:约20%;
- 巴基斯坦:约28%。
随后最稳定的重要特征是:
- VV pre-flood amplitude;
- VV post-flood amplitude。
因此,真正最重要的三层信息是:
text
VV pre-flood amplitude
+
VV post-flood amplitude
+
VV co-flood coherence
注意:
VH没有进入前三。
pre-flood coherence也没有进入前三。
这正是论文标题中"unlocking the full potential of Sentinel-1"真正想表达的东西:不是无限增加数据,而是把Sentinel-1中最有价值的部分找出来。
十六、只保留三层,精度几乎不变
作者随后做了一个非常实用的实验。
原始完整模型使用8层输入,优化模型只保留3层:
text
VV Pre
VV Post
Co-flood Coh VV
结果如下:
| 区域 | 模型 | OA | IOU | F1 |
|---|---|---|---|---|
| 伊朗 | 全8层 | 0.91 | 0.76 | 0.87 |
| 伊朗 | 最优3层 | 0.90 | 0.75 | 0.86 |
| 土库曼斯坦 | 全8层 | 0.95 | 0.86 | 0.93 |
| 土库曼斯坦 | 最优3层 | 0.95 | 0.86 | 0.92 |
| 巴基斯坦 | 全8层 | 0.95 | 0.85 | 0.92 |
| 巴基斯坦 | 最优3层 | 0.95 | 0.85 | 0.92 |
可以看到:
删除5层数据以后,主要精度指标几乎不变。
伊朗IOU和F1仅下降约1%,土库曼斯坦和巴基斯坦变化更小。
这说明大量输入实际上具有明显冗余。
十七、为什么"删数据"反而是这篇论文很重要的贡献?
洪水应急不是离线论文比赛。
真实业务中,每多一层输入,就会增加数据下载、预处理、SLC解算、内存、存储和响应时间。
以伊朗案例为例:
完整8特征模型训练耗时约:
884 ms
最优3特征模型约:
544 ms
时间减少约:
35%
这当然只是RF模型本身的训练时间。
但作者真正想说明的是:
当方法扩展到全球数据、云端计算或更复杂深度学习模型时,减少无效特征会产生更明显的时间和资源收益。
因此,"找到最关键的三层"并不是简单特征选择,它直接服务于近实时洪水应急制图。
十八、论文摘要里说"精度提高约50%",应该怎么理解?
这句话很容易被误解。
论文并不是说:
"最终模型OA比原方法高50个百分点。"
这里的"约50%"更多是指:
在某些特征组合和场景对比中,相对洪水检测指标出现显著提升。
例如伊朗VV相较VH,IOU提高50%;跨区域多区域联合训练相较单一区域训练,也出现接近50%甚至更高的性能改善。
因此,更准确的理解应该是:
通过识别真正关键的Sentinel-1信息源,模型在部分关键指标上的相对性能提升可达到约50%,同时还能减少计算量。
而不是简单理解成"整体精度从50%提升到100%"。
十九、模型能不能直接从伊朗拿去巴基斯坦用?答案:还不够
作者进一步测试了一个非常现实的问题:
训练好的模型能不能直接跨国家应用?
用伊朗训练的最优模型直接测试土库曼斯坦和巴基斯坦后,精度明显下降。
其中:
- 土库曼斯坦IOU下降约23%;
- 巴基斯坦IOU下降约36%;
- F1也出现明显下降。
这说明:
仅用一个地区训练的模型还不足以代表所有干旱区。
但更有意思的是后续实验。
当作者用多个区域联合训练,例如"伊朗+土库曼斯坦→测试巴基斯坦",或者"伊朗+巴基斯坦→测试土库曼斯坦",跨区域性能明显改善。
论文指出,相比单一区域训练:
- 巴基斯坦测试性能改善接近50%;
- 土库曼斯坦可改善约75%。
最后,当三个区域的数据共同参与训练时,模型表现已经接近区域专门模型。
这说明:
真正实现全球干旱区洪水模型的关键,不一定只是换一个更强的网络,而是增加不同类型干旱区洪水案例的多样性。
二十、这篇论文真正的创新,不是Random Forest
如果只看方法,很容易认为:
"这不就是一个RF分类器吗?"
但这篇论文真正的贡献并不在RF。
它真正做的是重新定义干旱区SAR洪水监测的输入逻辑。
| 层次 | 常见做法 | 本文的改变 |
|---|---|---|
| 干旱区处理 | 直接用排除层过滤 | 尝试真正识别沙漠中的洪水 |
| SAR特征 | 主要依赖幅度 | 同时使用幅度与相干性 |
| 时间信息 | 单景灾后识别 | 强调灾前---灾后变化 |
| 极化选择 | VV/VH经验使用 | 定量证明VV更适合干旱区 |
| 相干性 | 较少用于全球洪水业务 | 证明co-flood VV coherence是最关键特征 |
| 特征数量 | 越多越好 | 从8层压缩到3层 |
| 模型目标 | 单纯追求精度 | 同时考虑精度、速度和可解释性 |
因此,这篇论文的创新可以概括为三个关键词。
1. 从"排除沙漠"转向"识别沙漠洪水"
这是最重要的应用突破。
作者并不接受"沙地和水太像,所以干脆不算"的做法,而是寻找真正能够区分二者的Sentinel-1信息。
2. 幅度 + 相干性互补
幅度回答:
这里像不像水?
相干性回答:
这里是不是真的发生了变化?
两者结合后,才能有效破解干沙与洪水的低后向散射混淆。
3. 找到最小有效特征集
最终真正重要的只有:
text
VV灾前幅度
VV灾后幅度
VV跨洪水相干性
这让方法更接近近实时业务应用。
二十一、这套方法对全球洪水监测意味着什么?
1. 全球洪水产品可能不必继续"绕开沙漠"
目前一些业务系统为了控制误报,会把干旱低后向散射区排除。
本文说明:
至少在三个真实案例中,加入相干性后,干旱区并不是天然不可监测。
这为未来改进全球洪水产品提供了新的技术路径。
2. Sentinel-1 SLC的价值没有被完全利用
很多洪水制图只使用GRD幅度产品,但SLC中还保留相位信息,相干性正是利用这部分信息。
因此,本文实际上是在提醒:
Sentinel-1不仅是一张"雷达灰度图",它还有时间相位稳定性信息。
3. 云计算正在降低相干性应用门槛
过去InSAR处理比较复杂,需要SLC下载、精确配准、轨道处理、相干计算和地形校正,这也是为什么相干性难以进入全球实时系统。
但随着ASF、AWS等云平台提供更多处理能力,相干性大规模应用的门槛正在降低。
这也是论文认为该方法具备业务化潜力的重要背景。
总结:这篇论文最值得记住的,不是Random Forest,而是"低幅度 + 低相干"
这篇论文最重要的价值,是把干旱区SAR洪水监测最核心的物理矛盾说清楚了:
水很黑,但沙也很黑。
如果只看SAR幅度,很难区分二者。
但如果加入时间和相干性信息:
text
长期稳定的干沙:
低幅度 + 高相干

真正发生洪水:
低幅度 + 明显失相干
于是,Sentinel-1中原本被忽略的相位信息,就变成了区分洪水和干沙的重要证据。
论文进一步证明:
- 灾前信息必须加入;
- VV明显优于VH;
- 幅度和相干性融合优于单独使用;
- pre-flood coherence贡献有限;
- 真正最重要的是VV灾前幅度、VV灾后幅度和VV co-flood coherence;
- 从8个特征压缩到3个后,精度几乎不变,但训练时间可减少约35%。
所以,这篇论文真正做的不是:
"训练一个更强的洪水分类器。"
而是:
重新回答了一个更基础的问题:在干旱区,Sentinel-1到底应该看什么,才能真正识别洪水。
这也是它对全球洪水制图最有价值的贡献。
过去,沙漠因为"和水太像"而被排除。
这篇论文给出的方向则是:
不要排除它,而是给SAR增加一个判断维度------这里不仅要像水,还必须真的发生过变化。
论文信息
论文题目: Unlocking the full potential of Sentinel-1 for flood detection in arid regions
作者: Shagun Garg、Antara Dasgupta、Mahdi Motagh、Sandro Martinis、Sivasakthy Selvakumaran
期刊: Remote Sensing of Environment
卷期: Volume 315, 114417
发表年份: 2024
DOI: 10.1016/j.rse.2024.114417