论文原标题:SkeletonContext: Skeleton-side Context Prompt Learning for Zero-Shot Skeleton-based Action Recognition
资源位置:https://github.com/NingWang2049/ skeletoncontext.
一、问题背景:
核心痛点
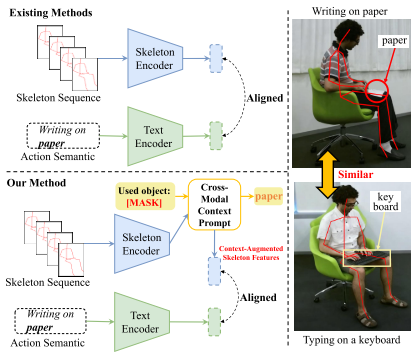
零样本骨架动作识别(ZSSAR)的目标是:用已见类别的骨架数据训练模型,让它能识别从未见过的动作类别。现有方法通常把骨架特征和文本嵌入对齐到同一个潜在空间。
但问题是:骨架序列只有关节坐标,完全没有"用了什么物体、在什么环境"这类上下文信息。
现有方法的局限
| 方法类型 | 代表工作 | 局限 |
|---|---|---|
| 全局对齐 | RelationNet, SynSE, SMIE | 只用类别名称做语义,粒度太粗 |
| 部位级对齐 | PURLS, STAR | 把骨架拆成部位,但仍是静态对齐,没有上下文 |
| 提示学习 | SCoPLe, Neuron | 增强文本编码器,但骨架侧表示没有本质改善 |
| 全监督细粒度 | ProtoGCN | 依赖类特定监督,无法扩展到零样本 |
本文提出SkeletonContext ,其核心主张 :与其只增强文本侧,不如让骨架编码器本身学会"脑补"缺失的上下文------从运动模式反推出"用了什么物体、在什么环境"。
二、主要贡献(三个层面)
| 贡献 | 核心内容 | 通俗解释 |
|---|---|---|
| ① SkeletonContext 框架 | 首次将语言驱动的上下文知识注入骨架编码器本身 | 让骨架编码器学会"从动作猜场景" |
| ② 跨模态上下文提示模块 | 用 BERT 做掩码重建,让骨架特征参与预测被遮蔽的上下文词 | 给骨架编码器配一个"完形填空"任务 |
| ③ 关键部位解耦模块 | 解耦运动相关关节特征,突出最关键的身体部位 | 让模型知道"这个动作主要看手,那个动作主要看腿" |
三、核心创新点与公式详解
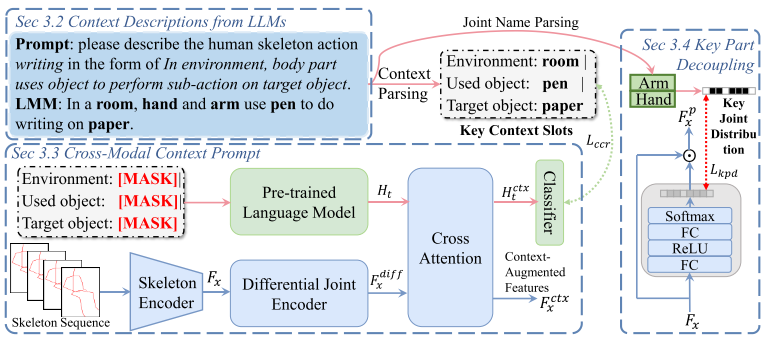
SkeletonContext先用LLM离线生成含"环境/使用物体/目标物体/身体部位"的结构化上下文描述,训练时通过渐进式掩码让骨架编码器与BERT双向交叉注意力重建被掩码的上下文词,并用身体部位先验解耦关键关节,最后将上下文增强特征和部位级特征分别与语义对齐,推理时融合两个分支预测未见动作。
创新点1:LLM 生成结构化上下文描述
用 GPT-4 为每个动作类别生成上下文描述,格式为:
In environment, body part uses object to perform subaction on target object
例子:
-
动作"写字" →
In office, hand uses pen to write on paper -
动作"打字" →
In room, hand uses keyboard to type on tablet
每个类别生成10条描述,允许上下文元素跨类别共享(如"杯子"同时出现在"喝水"和"倒咖啡"中)。
创新点2:跨模态上下文提示模块
首次让骨架编码器通过跨模态掩码重建,从纯运动模式中反推被遮蔽的物体、环境等上下文语义,而非仅仅增强文本编码器。
差分关节编码器(DJE)
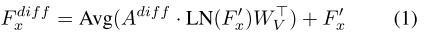
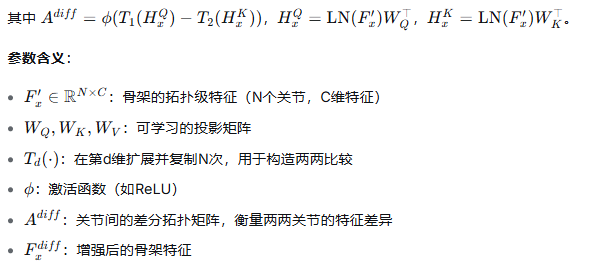
这个公式在做"找不同"。它把每个关节的特征投影成 Query 和 Key,然后让所有关节两两比较。差异大的关节对(比如"左手"和"右手"在打字时交替运动),会在 AdiffAdiff 中得到高响应。最后用这个差异矩阵加权聚合特征,再和原始特征相加。
例子:打字时,左右手交替按键,关节间的运动模式差异明显。DJE 捕捉到这种"左右手交替"的差分模式,为后续推断"这是打字而不是写字"提供了运动学基础。
渐进式部分掩码(PPM)
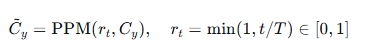
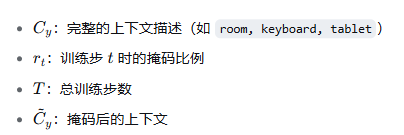
通俗解释 :
训练初期 rt 很小,只掩少量词;训练后期 rt=1,全部掩码。
例子:
-
第1步(rt≈0.1) :
Environment: room | Used object: [MASK] | Target object: tablet------只掩了一个词,模型靠"room"和"tablet"就能猜到"keyboard"。 -
第100步(rt=1.0) :
Environment: [MASK] | Used object: [MASK] | Target object: [MASK]------全掩,模型必须纯靠骨架运动推断出"room, keyboard, tablet"。
就像教小孩拼图:先给大部分拼图只缺一块,慢慢过渡到只给边框让他拼全图。
语义上下文锚定(双向交叉注意力)
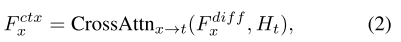
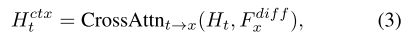
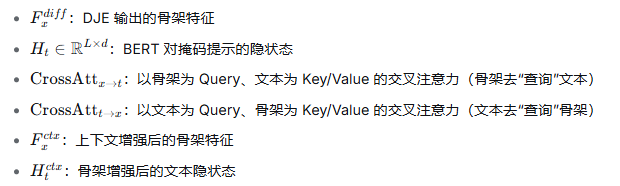
通俗解释 :
这是"双向对话"。骨架特征问文本:"我这段运动对应什么词?"文本也问骨架:"我要填的这个空,运动上有什么线索?"两个模态互相交换信息后,各自都变得更丰富。
例子:骨架说"我的手在身前小幅快速移动,左右交替";文本说"环境是 room,目标是 tablet,中间缺一个词"。双向交互后,骨架特征被注入"键盘"相关的语义,文本隐状态也被注入"交替运动"的运动学线索,最终帮助 BERT 填出"keyboard"。
上下文重建损失(Lccr)
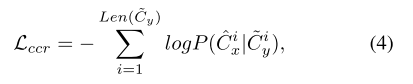
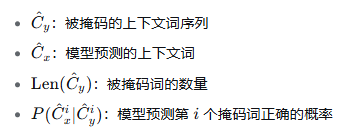
通俗解释 :
这就是"完形填空"的交叉熵损失。模型每填一个空,如果填对了,损失小;填错了,损失大。训练目标就是让模型填得越来越准。
例子 :模板是 In [MASK1], hand uses [MASK2] to type on [MASK3]。模型根据骨架+部分文本,预测 MASK1=room、MASK2=keyboard、MASK3=tablet。如果 MASK2 预测成"pen",损失就会很大,因为"typing on a keyboard"和"writing with a pen"的运动模式不同,模型应该从骨架中区分出来。
预测概率定义
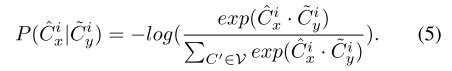
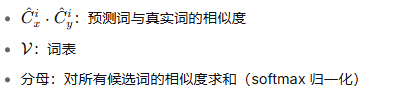
通俗解释 :
这是标准的 softmax 概率计算。模型对每个空位输出一个词表上的概率分布,概率最高的词就是预测结果。
例子 :MASK2 位置上,模型可能输出 keyboard: 0.85, pen: 0.10, mouse: 0.03, ...。训练目标就是让正确词"keyboard"的概率尽量接近1。
创新点3:关键部位解耦模块(6-7)
用LLM生成的身体部位先验作为监督信号,引导骨架编码器自动学习关节重要性并解耦出运动关键部位,从而在不依赖外部上下文的情况下也能准确识别局部动作。
关键部位解耦(KPD)
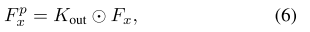
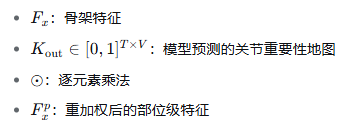
通俗解释 :
这是一个"注意力阀门"。模型给每个关节在每个时刻打一个0到1的重要性分数。重要的关节(如打字时的手腕)乘以接近1的数保留;不重要的关节(如脚踝)乘以接近0的数抑制。
KPD 校准损失(Lkpd)
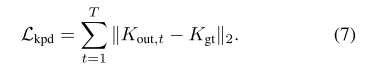
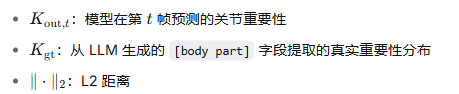
例子:LLM 说"打字主要用手",所以 Kgt 在手部关节上为1,其他为0。如果模型预测脚踝也很重要,L2 距离就会很大,梯度会修正这个错误。
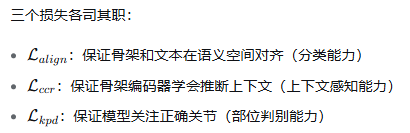
总损失(公式10)
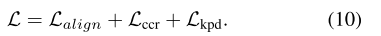
推理时的校准堆叠
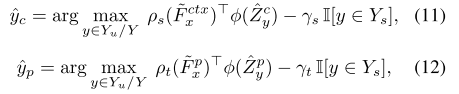
通俗解释 :
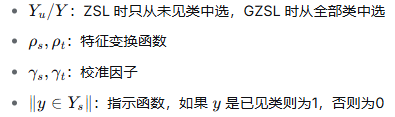
这是"防止偏科"的校准。GZSL 中,模型天然倾向于把样本预测成已见类(因为训练时见过)。所以对已见类的分数减去一个惩罚项 γ,让未见类有机会胜出。
四、比较的基准和数据集
论文对比了三类方法:
| 类别 | 代表方法 | 特点 |
|---|---|---|
| 传统对齐 | ReViSE, JPoSE, CADA-VAE, SynSE | 全局骨架-文本对齐 |
| 部位级对齐 | PURLS (CVPR 2024), STAR, SA-DVAE | 用 LLM 生成部位描述做局部对齐 |
| 最新提示学习 | SCoPLe (CVPR 2025), Neuron (CVPR 2025), FS-VAE (ICCV 2025) | 增强文本编码器或引入频率语义 |
数据集
| 数据集 | 规模 | 动作类别 | 关节数 | 评估划分 |
|---|---|---|---|---|
| NTU RGB+D 60 | 56,880样本 | 60类 | 25 | 55/5, 48/12 |
| NTU RGB+D 120 | 114,480样本 | 120类 | 25 | 110/10, 96/24 |
| PKU-MMD | 20,000+样本 | 51类 | 25 | 46/5(3个随机划分取平均) |
总结
SkeletonContext 的核心洞察 :骨架数据天生缺失上下文,而上下文恰恰是区分相似动作的关键。它通过让骨架编码器学会"脑补"缺失的上下文,从根本上提升了骨架表示的语义丰富度。
最精彩的设计:渐进式部分掩码(PPM)------从"看骨架+部分文本填空"逐步过渡到"纯靠骨架推断完整上下文",这种课程学习策略有效缩小了结构化提示与自然语言之间的分布差距