上一篇 GPU 为什么会挨饿 把视角从单点分析推到全链路优化。今天进入 Datawhale mlsysim 学习活动的第五阶段,问题换了一句话:从一台机器走到一千张卡,成本会怎么变? 对应教程:06 Scaling to 1000 GPUs、07 Geography is a Systems Variable、08 The $9M Question。今天跑下来有两个意外:规模扫描那张表里,通信开销不是随规模上升,而是从 1336.8ms 掉到 319.1ms;而可靠性部分的结论,交叉点位置比教程说的远得多。
一、先说结论
这一阶段跑的是 E1(3D 并行)、E2(规模扫描)、O1(可靠性与 checkpoint)、E4(选址)、E3(经济性),全程 Llama-3-70B + DGX H100 + InfiniBand NDR,mlsysim 0.1.2,纯仿真。五条值得单独记住的:
- 千卡训练最常被讲的瓶颈是通信。实测里通信开销占比只有 5.6%~7.4%,而且随规模上升不升反降------但这不是通信变好了,是教程那张表里混入了 batch 口径的变化。
- 引擎的集群 MTBF 是节点级串联模型,单节点 4285.7h,512 卡 67.0h。教程里"512 卡约 97h"是按 GPU 数直接除 MTTF 得来的另一个假设。
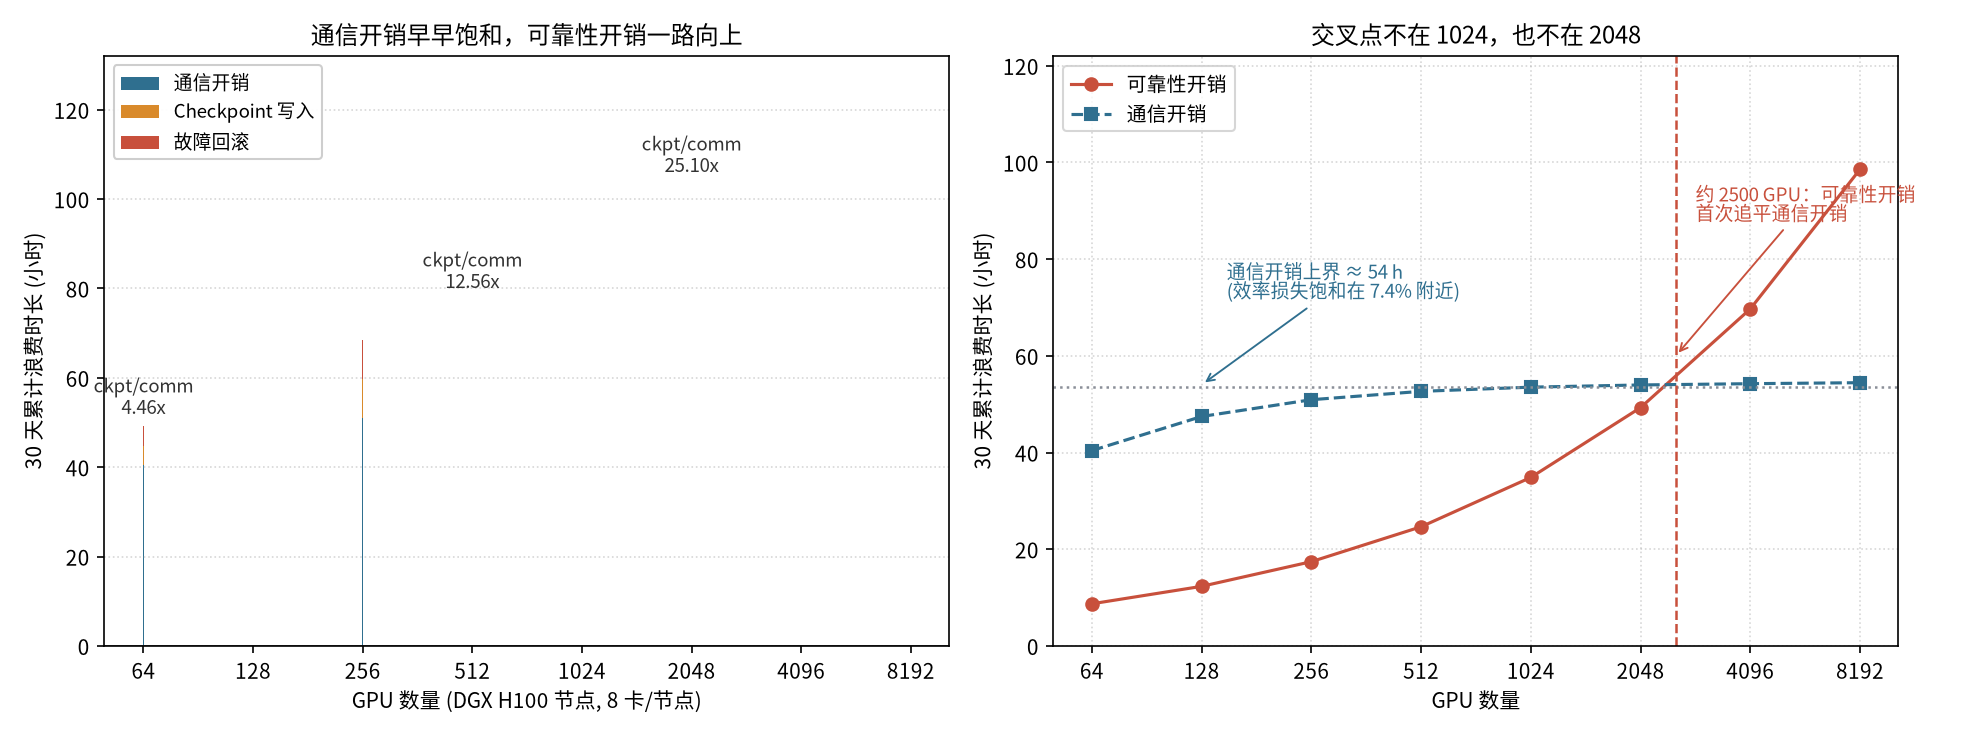
- 教程 §5 说"可靠性开销主导通信开销"。方向对,但交叉点在 2560 卡附近,不在 1024 卡;1024 卡时可靠性开销只有通信的 0.71 倍。
- 同一个集群 30 天作业,引擎里其实有两套可靠性账本。§5 用的是"写入 + 半个间隔回滚";
ReliabilityResult.goodput_ratio用的是"写入/间隔 + 修复时间/MTBF",在 1024 卡上给出的开销只有 §5 的 1/2.9。 - 选址:同样 32 卡、同样运行 30 天,波兰比魁北克多 61.1 倍碳。而经济性这边,30 天窗口里 Capex 恒占 83.4%------短期训练的钱几乎全是折旧,不是电费。
二、E2 规模扫描:那张表为什么会反着走
教程给实验参数设置:TP 固定为 8(节点内 NVLink),PP=1(不引入气泡),DP 靠节点数自然扩大,batch 取 max(64, n_gpus):
| GPU | 节点 | 通信 (ms) | 气泡 (ms) | 扩展效率 | 步延迟 (ms) | 吞吐 (tok/s) | 通信占比 |
|---|---|---|---|---|---|---|---|
| 8 | 1 | 1336.8 | 0.0 | 92.4% | 17,665.4 | 29.0 | 7.57% |
| 32 | 4 | 393.4 | 0.0 | 93.6% | 6,132.1 | 83.5 | 6.42% |
| 64 | 8 | 236.2 | 0.0 | 94.4% | 4,209.9 | 121.6 | 5.61% |
| 128 | 16 | 280.4 | 0.0 | 93.4% | 4,254.0 | 240.7 | 6.59% |
| 256 | 32 | 302.4 | 0.0 | 92.9% | 4,276.1 | 478.9 | 7.07% |
| 512 | 64 | 313.5 | 0.0 | 92.7% | 4,287.2 | 955.4 | 7.31% |
| 1024 | 128 | 319.1 | 0.0 | 92.6% | 4,292.8 | 1,908.3 | 7.43% |
通信从 1336.8ms 降到 236.2ms,再爬回 319.1ms。扩展效率全程贴在 92%~94%,看起来规模扩展近乎完美。教程的解释是 Amdahl 定律下的通信开销"可控"。
但我没敢直接接受那张表。第一处不对劲的是 8→32 这一段:节点数翻了 4 倍,通信却降到 1/3.4。把通信拆成 TP 与 DP 两个分量就清楚了:
| GPU | batch | DP | 本地 batch | TP 通信 | DP 通信 | 合计 |
|---|---|---|---|---|---|---|
| 8 | 64 | 1 | 64.0 | 1336.8 | 0.0 | 1336.8 |
| 32 | 64 | 4 | 16.0 | 334.6 | 58.8 | 393.4 |
| 64 | 64 | 8 | 8.0 | 167.6 | 68.6 | 236.2 |
| 128 | 128 | 16 | 8.0 | 167.6 | 112.8 | 280.4 |
| 512 | 512 | 64 | 8.0 | 167.6 | 145.9 | 313.5 |
| 1024 | 1024 | 128 | 8.0 | 167.6 | 151.5 | 319.1 |
两件事同时发生:
- TP 通信与"本地 batch"严格成正比 ,每样本 20.9ms,不随节点数变化。而
max(64, n)在单机阶段把全局 batch 顶到 64(本地 64),一跨节点本地 batch 立刻塌到 16、再到 8。TP 通信于是从 1336.8ms 一路掉到 167.6ms 封顶。 - DP 通信只跟"rank 内梯度体积"有关 ,等于
params / TP,与全局 batch 无关,与参与方数量只呈弱单调(0 → 151.5ms 后基本饱和)。
也就是说,8 卡和 1024 卡的"通信"根本不是同一个东西:前者是一个节点里 8 张卡为了 64 个样本互相交换激活值,后者是 128 个节点同步梯度。两个量被同一列数字记录,才产生了"规模越大通信越少"的观感。换成分开计算通信开销,结论正常:
| GPU | DP 组 | DP 通信 | TP 通信 | 合计 |
|---|---|---|---|---|
| 8 | 1 | 0.0 | 167.6 | 167.6 |
| 32 | 4 | 58.8 | 167.6 | 226.4 |
| 128 | 16 | 112.8 | 167.6 | 280.4 |
| 512 | 64 | 145.9 | 167.6 | 313.5 |
| 1024 | 128 | 151.5 | 167.6 | 319.1 |
通信随规模单调上升,但天花板很低(319ms,占 7.4%)。这个结论本身是对的------教程的"通信可控"站得住------只是它的论证路径有些问题。
2.1 顺带验一下气泡公式
教程背景栏给了气泡比例 (P-1)/(M+P-1)。8 GPU、TP=4、PP=2、扫 microbatch 数:
| 微批次 M | 引擎 bubble_fraction | 理论 (P-1)/(M+P-1) |
|---|---|---|
| 1 | 0.5000 | 0.5000 |
| 2 | 0.3333 | 0.3333 |
| 4 | 0.2000 | 0.2000 |
| 8 | 0.1111 | 0.1111 |
四个点完全重合,P=4、P=8 也一致。引擎用的是理论计算:没有 1F1B 的额外收益,也没有交错流水线的压缩。所以引擎里的微批次只能换来"公式里的改善",换不来调度算法的工程收益------这点在拿它做并行度决策时要记住。
2.2 E1 的 3D 并行:数字好看,但配置不成立
单节点 8×H100、batch=64、fp16,扫 TP×PP:
| TP | PP | DP | 步延迟 (ms) | 气泡占比 | 通信 (ms) | 效率 |
|---|---|---|---|---|---|---|
| 1 | 1 | 8 | 4,522.8 | 0.0% | 549.1 | 87.9% |
| 2 | 1 | 4 | 6,165.0 | 0.0% | 426.3 | 93.1% |
| 4 | 1 | 2 | 9,920.0 | 0.0% | 651.3 | 93.4% |
| 8 | 1 | 1 | 17,665.4 | 0.0% | 1336.8 | 92.4% |
| 1 | 2 | 4 | 9,078.7 | 50.0% | 470.7 | 63.2% |
| 4 | 2 | 1 | 25,638.6 | 50.0% | 1145.6 | 63.7% |
| 2 | 4 | 1 | 29,338.8 | 75.0% | 763.6 | 55.7% |
三个规律:PP 一启用,气泡直接吃掉一半或 3/4;TP 从 1 到 4 效率单调升(内存墙压力变小);TP=8 反而回落。
三、O1 可靠性: Young-Daly 公式该往哪用
教程背景栏写:单卡 MTTF 50,000 h,512 卡集群约 97 h。这是按 MTTF / N 直接算的。但引擎的 ReliabilityModel 不是这么实现的------它先算节点,再算集群:
节点 MTBF = 1 / (8/MTTF_gpu + 8/MTTF_nic + 2/MTTF_psu)
集群 MTBF = 节点 MTBF / 节点数
单节点 8 GPU + 8 网卡 + 2 电源,代入 MTTF 50,000 / 150,000 / 100,000 h:
节点 MTBF = 1 / (8/50000 + 8/150000 + 2/100000) = 4285.71 h| GPU | 节点 | 集群 MTBF (h) | 30 天故障数 | 故障平均间隔 | Young-Daly 最优 (h) | goodput |
|---|---|---|---|---|---|---|
| 64 | 8 | 535.7 | 1.34 | 22.3 天 | 4.226 | 99.59% |
| 256 | 32 | 133.9 | 5.38 | 5.6 天 | 2.113 | 99.15% |
| 512 | 64 | 67.0 | 10.75 | 2.8 天 | 1.494 | 98.76% |
| 1024 | 128 | 33.5 | 21.50 | 1.4 天 | 1.056 | 98.17% |
| 2048 | 256 | 16.7 | 43.01 | 0.7 天 | 0.747 | 97.27% |
512 卡这行,教程说的"每天坏一次"是"30 天坏 10.75 次"(平均 2.8 天一次)的近似;而它背景栏的 97h,比引擎的 67h 高了 45%------因为 MTTF/N 只算了 GPU,没算网卡和电源,而这三类是串联关系:任何一个坏,同步训练整个停。
用 calc_young_daly_interval 复核 T_opt = √(2·C·M) 本身无误(1.494h 与手算一字不差),但这里的 C 有个陷阱:
| 假设 C | 512 卡最优间隔 |
|---|---|
| 60 s(ReliabilityModel 默认参数) | 1.494 h |
| 141.2 s(70B+Adam 真实写盘耗时) | 2.292 h |
引擎内部这两处用的 C 并不一致:ReliabilityModel.solve(checkpoint_time_s=60) 是默认参数,CheckpointModel 算出的实际写盘是 141.2s。教程 §4 和 §5 都用默认 60s,但一个 988.4GB 的 checkpoint 显然不是 60 秒能写完的。把 C 换回真实值,最优间隔从 1.49h 变成 2.29h,两者相差一半。
3.1 Checkpoint 体积:14 bytes/param 从哪来
| 优化器 | 体积 | bytes/param |
|---|---|---|
| sgd | 282.4 GB | 4.00 |
| adam | 988.4 GB | 14.00 |
| rmsprop | 282.4 GB | 4.00 |
Adam = fp32 权重 + fp32 一阶矩 + fp32 二阶矩 = 14 bytes/param,70.6B × 14 = 988.4GB,和引擎对得上。这个数决定了两件事:写盘是磁盘问题不是节点问题 ,以及间隔不能开太大。
3.2 写入带宽:141s → 2s
n_writers 扫描(间隔 1h):
| n_writers | 写入耗时 | 1h 间隔 MFU 损失 | 存储成为瓶颈 |
|---|---|---|---|
| 1 | 141.20 s | 3.92% | True |
| 8 | 17.65 s | 0.49% | False |
| 64 | 2.21 s | 0.06% | False |
| 256 | 1.98 s | 0.05% | False |
8 个 writer 之后曲线开始弯,64 之后基本压到 2s 不动------写入速度有一个硬件上限(引擎按 500 GB/s 文件系统上限 + 有效带宽折算,4 个 writer 就是 35.3s,说明上限在 4 左右开始生效)。
3.3 教程 §5 的两个口径:同一个作业,三种答案
教程 §5 的算法是:通信损失 = (1 − 效率) × 720h;checkpoint 损失 = 30天写入总时长 + 故障数 × 半个间隔。按 C=141.2s 重算:
| GPU | 通信损失 | 写入 | 回滚 | 可靠性合计 | 可靠性/通信 | 合计占 720h |
|---|---|---|---|---|---|---|
| 64 | 40.4 | 4.4 | 4.4 | 8.7 | 0.22× | 6.8% |
| 256 | 50.9 | 8.7 | 8.7 | 17.4 | 0.34× | 9.5% |
| 512 | 52.7 | 12.3 | 12.3 | 24.6 | 0.47× | 10.7% |
| 1024 | 53.5 | 17.4 | 17.4 | 34.9 | 0.65× | 12.3% |
| 2048 | 54.0 | 24.6 | 24.6 | 49.3 | 0.91× | 14.3% |
| 2560 | 54.1 | 27.6 | 27.6 | 55.1 | 1.02× | 15.2% |
| 4096 | 54.2 | 34.9 | 34.9 | 69.7 | 1.29× | 17.2% |
| 8192 | 54.4 | 49.3 | 49.3 | 98.6 | 1.81× | 21.3% |
两个观察:
- 通信开销是平的,不是"随规模增长" 。它在 7.4% 附近饱和(54.4h),因为步延迟里的固定项(计算 + 层税 + 本地 TP)不随节点数变。所以通信的"损失上限"是一个常数,而可靠性开销是单调上升的------交叉点必然存在,只是位置比教程说的远。
- 交叉点在 2560 卡附近,不在 1024 卡。教程的结论句"At scale, reliability overhead dominates communication overhead"方向没错,但按它自己给的表(1024 卡时 0.71×),dominates 说早了。
而引擎内部还有第三个数字。ReliabilityResult.goodput_ratio 用的公式是 1 − C/M − R/MTBF(C 是单次写入,R 是修复时间 300s),这是稳态占比,分母已包含 §5 那 7.4% 的通信损失,回滚也只计 300s/次而不是半个间隔:
| GPU | §5 口径 | §5 占比 | goodput 口径 | goodput 占比 | 比值 |
|---|---|---|---|---|---|
| 256 | 19.0 h | 2.65% | 6.13 h | 0.85% | 3.11× |
| 512 | 26.9 h | 3.74% | 8.93 h | 1.24% | 3.02× |
| 1024 | 38.1 h | 5.29% | 13.15 h | 1.83% | 2.90× |
| 2048 | 53.9 h | 7.48% | 19.65 h | 2.73% | 2.74× |
三个口径给出的"可靠性吃掉多少时间"差了 3 倍,原因是三处不同假设:分母要不要含通信损失、回滚按半个间隔还是按修复时间、写入按理想 goodput 的补数还是稳态占比。没有哪个是错的,但引用数字时必须说清口径------尤其"千卡训练会浪费 30%~50% 时间"这类说法,在这套模型里找不到支撑:§5 口径 1024 卡是 12.7%,goodput 口径是 1.83%。
值得记的一件事:§5 口径下,写入和回滚是严格相等的 (每行 write=rollback)。原因是 Young-Daly 的最优间隔恰好让两项各占一半------C·(T/C)=1 与 f·(T/2)=1 在最优解处同时成立。所以"checkpoint 开销"这个词在这个模型里天然意味着"写入 + 同量回滚",不是两个独立项。反过来也印证了上面的 C 陷阱:如果把最优间隔用默认 C=60s 算、而实际写入仍按 141.2s,这一等式立刻打破(64 卡:写入 6.7h vs 回滚 2.8h)------间隔被压得太短,checkpoint 次数变多,写入反超回滚。
四、E4 选址:61 倍不是 40 倍
E2 的配置(32 卡)、30 天,只换电网:
| 地区 | 能源 | 碳 (t) | 总能耗 (MWh) | PUE | gCO₂/kWh |
|---|---|---|---|---|---|
| 挪威 | 水电 | 0.2 | 17.1 | 1.06 | 10 |
| 魁北克 | 水电 | 0.3 | 17.1 | 1.06 | 20 |
| 法国 | 核电 | 0.9 | 18.1 | 1.12 | 50 |
| 美国平均 | 混合 | 7.7 | 18.1 | 1.12 | 429 |
| 德国 | 煤+风 | 7.0 | 18.1 | 1.12 | 385 |
| 波兰 | 煤电 | 20.9 | 25.5 | 1.58 | 820 |
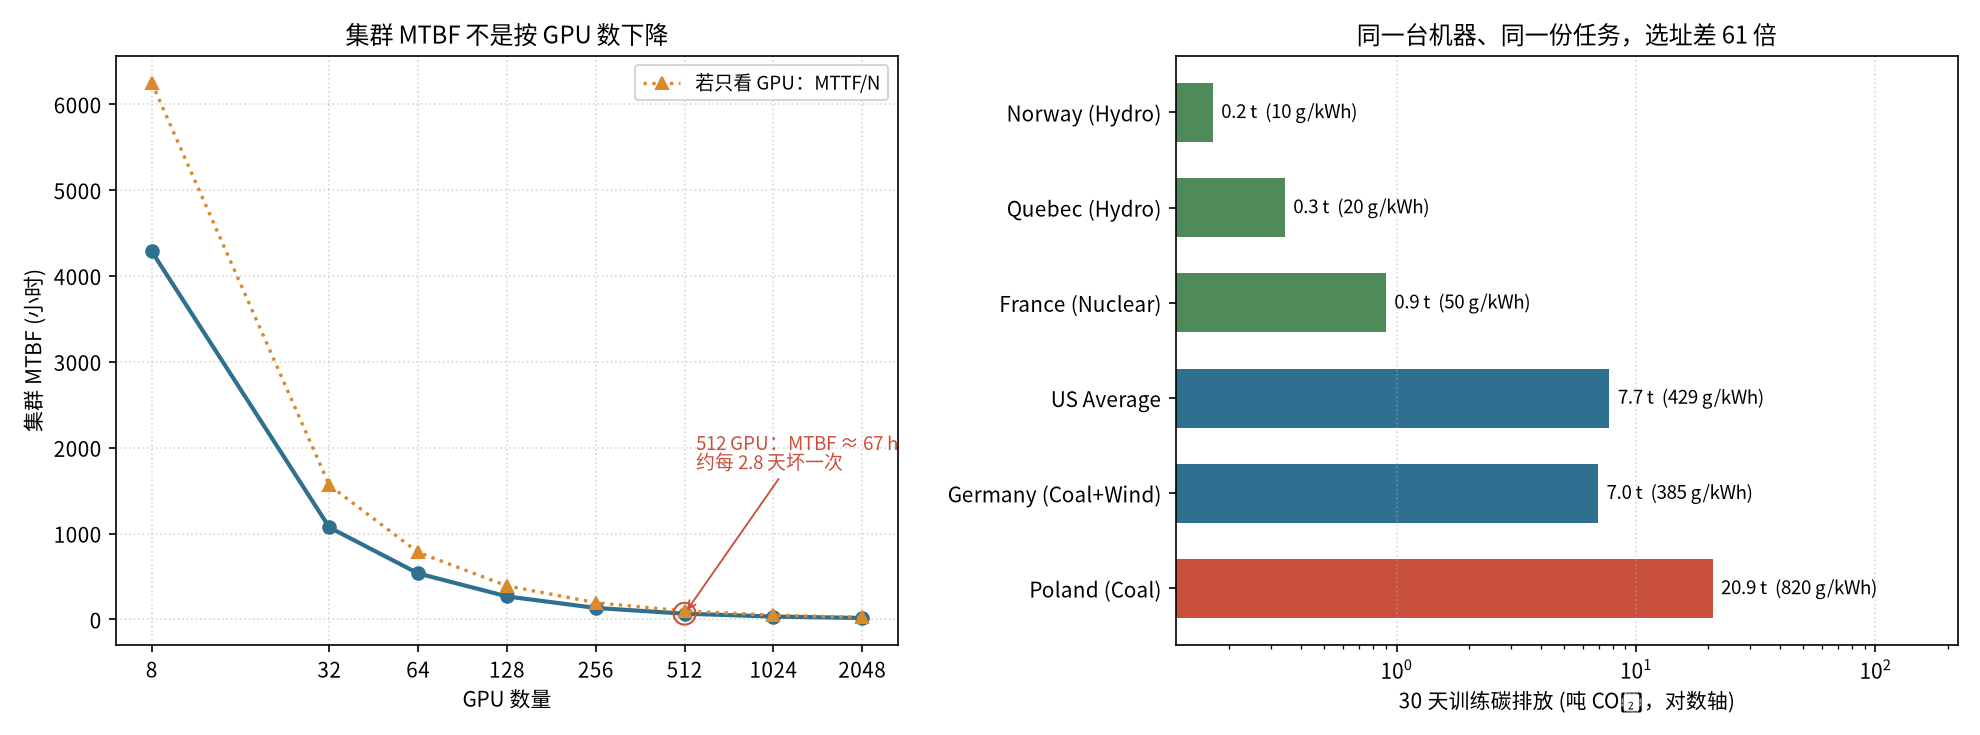
波兰/魁北克 = 61.1 倍,波兰/美国 = 2.7 倍,波兰/冰岛 = 43.7 倍。
4.1 别只算运营碳
embodied_carbon_per_device 扫描(波兰,30 天):
| 制造碳 (kg/卡) | 总碳 (t) | 制造碳 (t) | 运营占比 |
|---|---|---|---|
| 0 | 20.9 | 0.0 | 100.0% |
| 300 | 30.5 | 9.6 | 68.5% |
| 500 | 36.9 | 16.0 | 56.6% |
| 1000 | 52.9 | 32.0 | 39.5% |
默认值是 0------引擎只算运营碳。而制造碳跟选址无关,它是一笔固定摊入。这意味着"搬到水电地区"这个动作只对运营碳有效,对制造碳没有任何影响;反过来,硬件寿命延长的收益在低碳地区更不值钱,在高碳地区才明显。
五、E3 经济性:30 天的账单 83.4% 是折旧
读源码确认的 EconomicsModel 口径:
Capex(本次) = 单卡价 × 卡数 × infra_multiplier / 3年 × 运行天数 / 365
运维       = 全额 Capex × 5%/年 × 天数 / 365
电费       = PUE 后总能耗 × $0.12/kWh
H100 单卡 $25,000,infra_multiplier=2.0(含网络/冷却/机房/人力):
| 天数 | Capex | 电费 | 运维 | TCO | 碳 (t) | Capex 占比 |
|---|---|---|---|---|---|---|
| 7 | $10,228 | $506 | $1,534 | $12,268 | 1.8 | 83.4% |
| 30 | $43,836 | $2,168 | $6,575 | $52,579 | 7.7 | 83.4% |
| 90 | $131,507 | $6,503 | $19,726 | $157,736 | 23.2 | 83.4% |
| 180 | $263,014 | $13,006 | $39,452 | $315,471 | 46.5 | 83.4% |
| 365 | $533,333 | $26,373 | $80,000 | $639,706 | 94.3 | 83.4% |
Capex 占比是常数 83.4%,和时长无关 ------因为 Capex、运维、电费都按期线性摊,三者比值固定。这是这套模型里"成本非线性"的一种表现形式:在 30 天这种短窗口里,几乎全部钱都花在一笔三年折旧上,而不是你真正烧掉的电。
规模扫描(30 天,infra 2.0):
| GPU | TCO | Capex 占比 | 碳 (t) | 碳 / 万元 TCO |
|---|---|---|---|---|
| 8 | $13,145 | 83.4% | 1.9 | 1,473.8 t |
| 32 | $52,579 | 83.4% | 7.7 | 1,473.8 t |
| 128 | $210,314 | 83.4% | 31.0 | 1,473.8 t |
| 512 | $841,257 | 83.4% | 124.0 | 1,473.8 t |
| 1024 | $1,682,514 | 83.4% | 248.0 | 1,473.8 t |
TCO 随规模严格线性 ,碳强度(每吨碳花多少钱)也恒定 1,473.8 t/万元------这套模型里规模本身不产生经济性,只放大绝对量。
infra_multiplier 是"完整数据中心成本"的开关:
| mult | Capex(30d) | 电费 | 运维 | TCO |
|---|---|---|---|---|
| 1.0(只算硬件) | $21,918 | $2,168 | $3,288 | $27,373 |
| 2.0 | $43,836 | $2,168 | $6,575 | $52,579 |
| 2.5 | $54,795 | $2,168 | $8,219 | $65,181 |
电费不变,Capex 和运维翻倍。教程源码注释说 2.0~2.5 才对应完整机房成本,1.0 只算卡------默认值 1.0 是个偏乐观的口径,用它做预算容易少报一倍。
5.1 回到"$9M Question":成本为什么不是线性
打卡要求说清"大规模训练的成本为什么不是线性的"。在这套模型里,我找到的非线性只在三个地方,而且都不是"越大规模越贵/越便宜"这种规模弹性:
- 折旧窗口 。Capex 按 3 年直线摊,30 天的作业承担了
30/365/3 = 2.7%的硬件寿命。同一个集群跑满一年,Capex 占比从 83.4% 掉到......还是 83.4%(因为三者都线性)。真正改变结构的是:如果硬件能连续跑 3 年而不是 30 天,那么 Capex 会被 12 倍摊薄,电费占比才会显著上升。 也就是说,成本非线性来自"利用率",不来自"规模"。 - 可靠性 。§5 口径下,30 天里 12.7%~22.5% 的时间被浪费------这部分对应的是已付的机器时。1024 卡集群 30 天的 1.68M TCO 里,有约 20 万~$38 万是纯浪费。这个量随规模超线性增长(1.81× @8192)。
- 选址。碳强度恒定,但碳本身不随规模线性------它跟 PUE 走,而 PUE 是地区属性。
一句话总结这一节:这套引擎里"规模"不是一个成本杠杆,它是一个时间维度的开关。成本结构由运行时长、折旧年限、可靠性决定,不由卡数决定。这跟直觉相反,但和"训练一个模型的钱主要是买时间"这个判断一致。
六、把两个口径合并看:这张图值得存下来
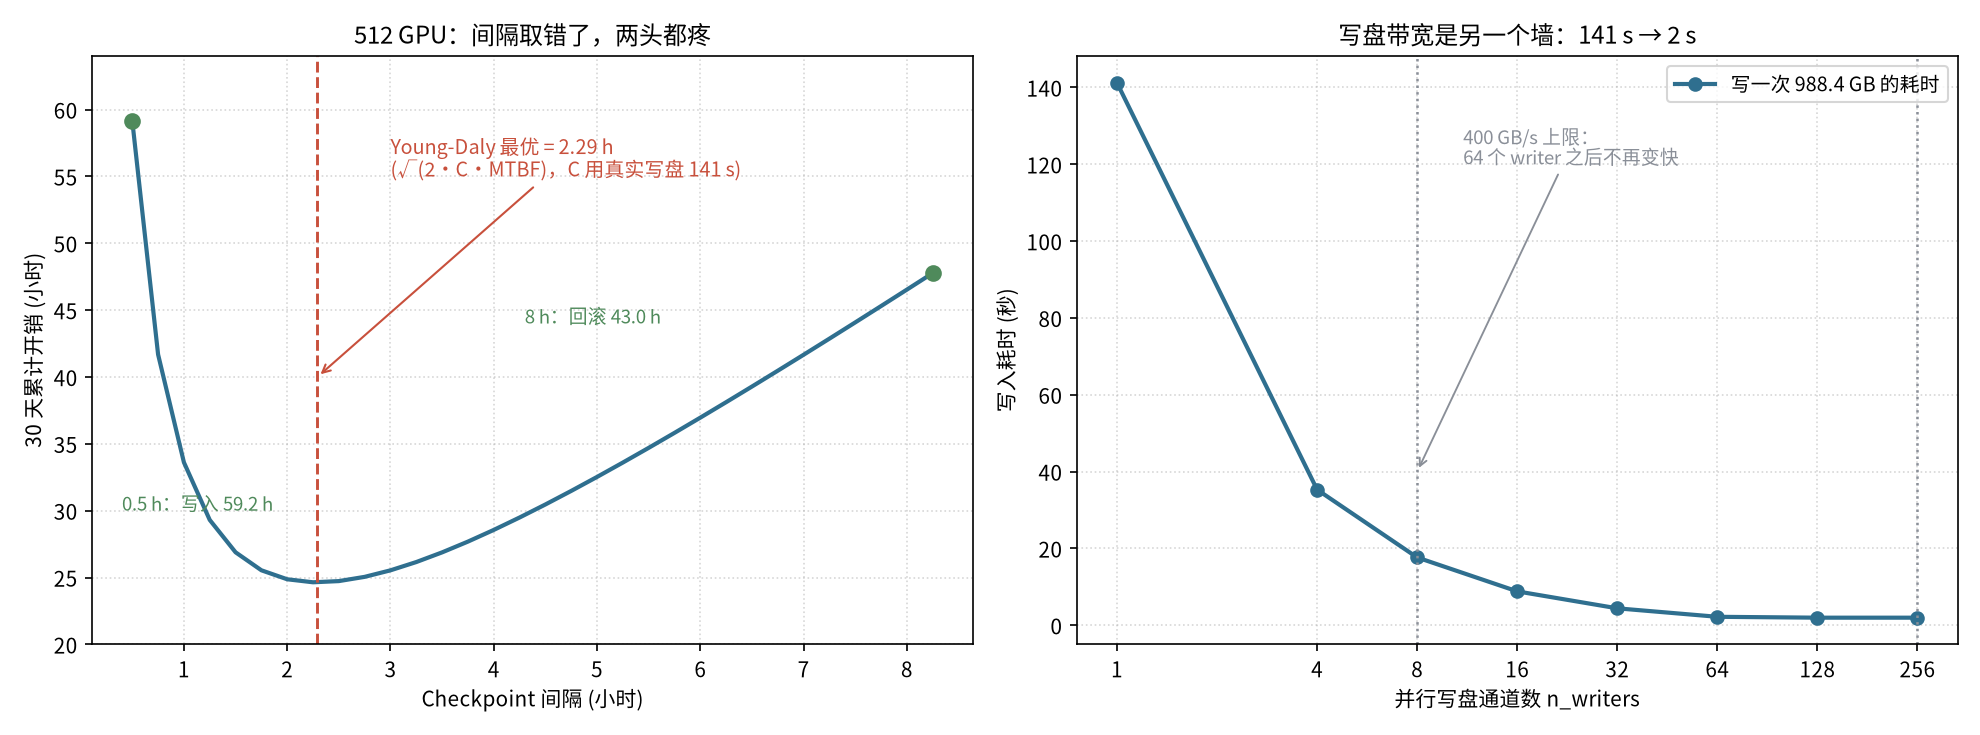
左图是 512 卡的间隔扫描:C=141.2s 时 Young-Daly 最优是 2.29h,30 天总开销 24.6h。取 0.5h 会写到 49.2h,取 8h 会回滚 43.0h------U 型两头都疼,但最优点附近很平(2.29h 到 4h 之间只差 4.5h),这说明工程上不必精确卡住 Young-Daly,把间隔控制在最优的 2 倍以内基本就够了。
右图是另一个墙:写入。141s → 2s 的收益,几乎全部来自 1→8 个 writer,64 之后曲线压平。所以"加存储带宽"和"调 checkpoint 间隔"是两件性质不同的事:前者是一次性投入换 1% 的 MFU,后者是零成本换 3~7% 的 30 天损失。
七、个人思考:今天最大的收获是"口径"
这次学习本身没什么新技术难度------但跑了以后我发现,最容易出错的地方不是公式,而是口径。四个具体例子:
- 通信随规模下降 。表面是"网络很好",实际是
max(64, N)让 batch 口径在 8 卡和 32 卡之间断了一次。同一张表里混了两个不同的量,肉眼看不出来。 - MTBF 是 67h 还是 97h。教程背景栏用 MTTF/N,引擎用节点串联。差 45%。两个都对,但对应不同的故障模型------前者假设只有 GPU 坏,后者假设网卡和电源也会把整个作业拖停。真实集群里后者更接近事实。
- 可靠性吃掉多少时间。§5 口径、goodput 口径、以及各自选用的 C,三者组合出 1.8%~12.7% 的范围。教程引文里的"10-30%"在这套模型里偏高。
我的处理方式是:引用教程结论前,先把它的口径复现出来。E2 那张表如果只看结论,"通信可控、可靠性主导"没错;但一旦要拿它做决策(比如"我该不该把 checkpoint 间隔从 2h 改成 1h"),口径错了 3 倍,决策就反了。
对这套工具的定位也清晰了:它是一个"把假设写出来"的计算器,不是一个"告诉你答案"的预言机。它的价值在于------每次给你一个数字,你都能追问"这里的 C 是多少、这里的分母含不含通信损失、这里的 batch 是全局还是本地"。这些追问本身,就是分布式系统设计的大部分内容。
八、参考资料与复现
- 教程链:00 Hello Roofline(第一篇)→ 01+02 Memory Wall & Two Phases(第二篇)→ 03 KV-Cache(第三篇)→ 04 Starving the GPU + 12 DSE(第四篇)→ 06 Scaling to 1000 GPUs+ 07 Geography+ 08 The $9M Question(本篇)。
- 打卡任务:Datawhale llm-algo-leetcode #137。
- 复现方法:
pip install mlsysim,完整脚本见文末附录,均可直接运行(纯仿真,不需要 GPU)。 - 环境:WSL2 + conda 环境 mlsysim(python 3.11,mlsysim 0.1.2),全程无 GPU。
附:完整运行脚本(可直接复制运行)
python
"""
MLSysBook Task 5 · 附录复现脚本
E2 规模扫描 / E1 气泡公式 / O1 可靠性+checkpoint / E4 选址 / E3 经济学
环境: pip install mlsysim (本文实测 0.1.2) · 纯仿真, 不需要 GPU
"""
import warnings
warnings.filterwarnings("ignore")
import mlsysim
from mlsysim import Models, Systems
from mlsysim.solvers import (DistributedModel, ReliabilityModel, CheckpointModel,
                             EconomicsModel, SustainabilityModel)
from mlsysim.systems.types import Fleet
from mlsysim.systems.reliability import Reliability as REL
from mlsysim.infrastructure.registry import Grids

model = Models.Language.Llama3_70B
solver, rel, ckpt = DistributedModel(), ReliabilityModel(), CheckpointModel()
econ, sust = EconomicsModel(), SustainabilityModel()
JOB = 30 * 24

def fl(n):
    """DGX H100 节点(8 卡) + InfiniBand NDR"""
    return Fleet(name=f"{n}-GPU", node=Systems.Nodes.DGX_H100,
                 count=n // 8, fabric=Systems.Fabrics.InfiniBand_NDR)

# ── E2: 规模扫描, 并把通信拆成 TP 与 DP 两个分量 ──────────────────────
print("E2  通信为什么随规模下降? (TP=8 固定, batch=max(64,N))")
print(f"{'GPUs':>6} {'batch':>6} {'DP':>4} {'本地B':>7} {'TP通信':>8} {'DP通信':>8} {'合计':>8} {'效率':>7}")
for n in [8, 32, 64, 128, 256, 512, 1024]:
    r = solver.solve(model=model, fleet=fl(n), batch_size=max(64, n),
                     precision="fp16", tp_size=8, pp_size=1)
    print(f"{n:>6} {max(64,n):>6} {r.parallelism['dp']:>4} {max(64,n)/(n//8):>7.1f} "
          f"{r.tp_communication_latency.to('ms').magnitude:>8.1f} "
          f"{r.dp_communication_latency.to('ms').magnitude:>8.1f} "
          f"{r.communication_latency.to('ms').magnitude:>8.1f} {r.scaling_efficiency:>7.1%}")

# ── E1: 气泡公式验证 (P-1)/(M+P-1) ─────────────────────────────────
print("\nE1  气泡: 引擎 vs 理论式 (P-1)/(M+P-1)   8 GPU, TP=4 PP=2")
for mb in [1, 2, 4, 8]:
    r = solver.solve(model=model, fleet=fl(8), batch_size=64, precision="fp16",
                     tp_size=4, pp_size=2, microbatch_count=mb)
    print(f"  M={mb}: 引擎 {r.bubble_fraction:.4f}   理论 {(2-1)/(mb+2-1):.4f}")

# ── O1: 节点级 MTBF + Young-Daly + checkpoint 账本 ──────────────────
print("\nO1  节点级 MTBF 与 Young-Daly (C=60s 默认)")
node_mtbf = 1 / (8/REL.Gpu.mttf_hours + 8/REL.Nic.mttf_hours + 2/REL.Psu.mttf_hours)
print(f"  单节点 MTBF = {node_mtbf:.2f} h (8 GPU + 8 NIC + 2 PSU 串联)")
print(f"{'GPUs':>6} {'MTBF(h)':>9} {'故障/30d':>9} {'平均间隔(d)':>11} {'Young-Daly(h)':>14} {'goodput':>8}")
for n in [64, 256, 512, 1024, 2048]:
    r = rel.solve(fl(n), JOB, checkpoint_time_s=60.0)
    print(f"{n:>6} {r.fleet_mtbf.to('hour').magnitude:>9.1f} {r.expected_failures:>9.2f} "
          f"{JOB/r.expected_failures/24:>11.2f} "
          f"{r.optimal_checkpoint_interval.to('hour').magnitude:>14.3f} {r.goodput_ratio:>8.2%}")

print("\nO1  checkpoint 体积 (bytes/param) 与写盘带宽")
for opt in ["sgd", "adam"]:
    r = ckpt.solve(model=model, hardware=Systems.Nodes.DGX_H100.accelerator,
                   optimizer=opt, checkpoint_interval_hours=1.0)
    print(f"  {opt:<5}: {r.checkpoint_size.to('GB').magnitude:>7.1f} GB  "
          f"= {r.checkpoint_size.to('B').magnitude/model.parameters:.2f} bytes/param")
for w in [1, 8, 64, 256]:
    r = ckpt.solve(model=model, hardware=Systems.Nodes.DGX_H100.accelerator, optimizer="adam",
                   checkpoint_interval_hours=1.0, n_writers=w)
    print(f"  n_writers={w:>3}: {r.write_time_seconds.to('s').magnitude:>7.2f} s  "
          f"storage_bottleneck={r.storage_bottleneck}")

print("\nO1  两个口径: §5(写入+半个间隔回滚) vs 引擎 goodput")
for n in [256, 512, 1024, 2048]:
    d = solver.solve(model=model, fleet=fl(n), batch_size=max(64, n), precision="fp16",
                     tp_size=8, pp_size=1)
    rr = rel.solve(fl(n), JOB, checkpoint_time_s=60.0)
    ci = rr.optimal_checkpoint_interval.to("hour").magnitude
    w_s = ckpt.solve(model=model, hardware=Systems.Nodes.DGX_H100.accelerator, optimizer="adam",
                     checkpoint_interval_hours=ci).write_time_seconds.to("s").magnitude
    sec5 = JOB/ci*w_s/3600 + rr.expected_failures*(ci/2)
    gp = (1 - rr.goodput_ratio) * JOB
    print(f"  {n:>5} GPU: §5={sec5:>6.1f}h ({sec5/JOB:>5.2%})  goodput={gp:>5.2f}h ({1-rr.goodput_ratio:>5.2%})"
          f"  比 {sec5/gp:.2f}x  通信损失={(1-d.scaling_efficiency)*JOB:>5.1f}h")

# ── E4: 选址 ────────────────────────────────────────────────────────
print("\nE4  同一台 32xH100, 30 天, 换电网")
base = None
for g in [Grids.Norway, Grids.Quebec, Grids.France, Grids.US_Avg, Grids.Germany, Grids.Poland]:
    r = sust.solve(fleet=fl(32), duration_days=30, datacenter=g)
    base = r.carbon_footprint_kg if base is None else base
    print(f"  {r.region_name:<22} {r.carbon_footprint_kg/1000:>6.1f} t  "
          f"PUE {r.pue:.2f}  {g.carbon_intensity_g_kwh:>5.0f} g/kWh")

# ── E3: 经济学 ──────────────────────────────────────────────────────
print("\nE3  TCO: 规模扫描 (30 天, infra 2.0)")
print(f"{'GPUs':>6} {'TCO':>13} {'Capex占比':>10} {'碳(t)':>8} {'碳/万元TCO':>12}")
for n in [8, 32, 128, 512, 1024]:
    r = econ.solve(fleet=fl(n), duration_days=30, infrastructure_multiplier=2.0)
    print(f"{n:>6} {r.tco_usd:>13,.0f} {r.capex_usd/r.tco_usd:>10.1%} "
          f"{r.carbon_footprint_kg/1000:>8.1f} {r.carbon_footprint_kg/(r.tco_usd/1e4):>12.1f} t")
如果这篇笔记对你有帮助,欢迎交流。