作者:来自 Elastic Jeffrey Rengifo, Gustavo Llermaly
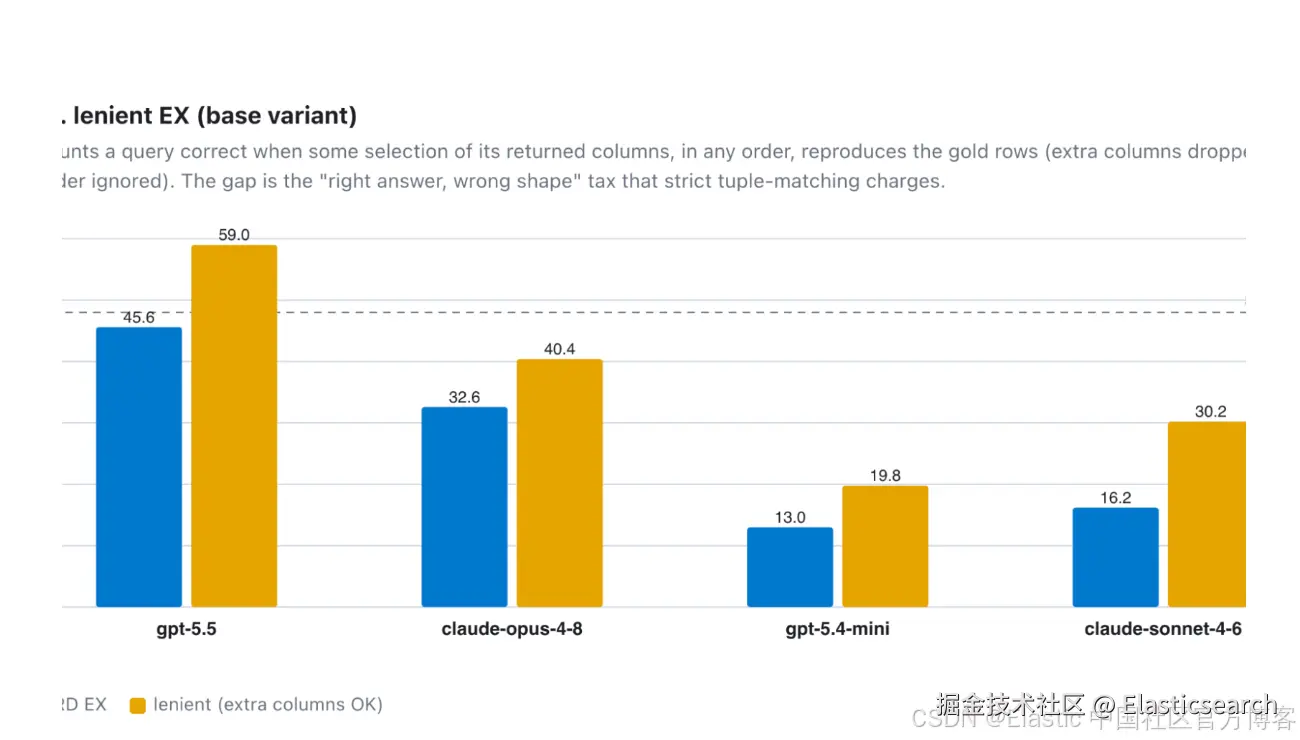
我们根据 BIRD 的答案标准,对来自四个模型的 6,000 条 ES|QL 查询进行了评分。大多数错误来自不匹配的 join 键、解析器拒绝的 SQL 语法、在一对多 join 之后进行计数,或者模型猜测的某个值。
亲自上手体验 Elasticsearch:深入了解 Elasticsearch Labs 仓库中的示例笔记本,开始免费云试用,或者立即在你的本地机器上尝试 Elastic。
我们从 BIRD 的 Mini-Dev 数据集中抽取了 500 个自然语言问题,让四个模型分别为每个问题生成一个Elasticsearch Query Language(ES|QL)查询,并根据是否返回了正确的行,对全部 6,000 个答案进行了评分。最佳模型在仅提供索引映射的情况下,单次尝试就有 59% 的正确率,并且在 500 次尝试中只有 7 次生成了无法解析的查询。语法不再是瓶颈。在提示中加入一份精简的 ES|QL 参考资料,对较小的模型来说大约能提高 10 个百分点,却会让最强的模型降低 10 个百分点。在仍然出错的查询中,大约一半会抛出一个明确的 Elasticsearch 错误,而一次重试就可以修复这些错误。其余查询能够正常运行,却返回空结果,因为模型猜测了一个数据中不存在的值。
我们以 Text-to-ES Bench(ACL 2025)为起点。该基准测试衡量大型语言模型使用 Query DSL 查询 Elasticsearch 的能力。其模型会将 DSL 查询与 Python 后处理结合起来,然后由 pandas 组装多索引答案。我们想了解,当模型可以在查询内部执行 join 时,会发生什么变化。LOOKUP JOIN 可以原生连接索引,因此一个多索引问题可以变成一条语句,由 Elasticsearch 从头到尾执行。
数据集:BIRD 基准测试,Mini-Dev 数据集
Text-to-ES Bench 的问题来自 BIg Bench for LaRge-scale Database Grounded Text-to-SQL Evaluation(BIRD),这是一个广泛使用的 text-to-SQL 基准测试。我们也采用相同的数据来源,使用 BIRD 的 Mini-Dev 数据集:针对真实关系型数据库的 500 个自然语言问题。每个任务都会提供三样东西:
-
**一个英文问题:**模型需要进行翻译的提示。
-
**一个标准 SQL 查询:**用于生成答案的参考查询。
-
**返回的行:**用于评分的答案标准。
我们所依赖的关键点是,真实答案是返回的行,而不是 SQL。我们从不将生成的查询文本与标准 SQL 进行比较;预测结果只根据它返回的行进行评分。无法解析的查询会返回零行,而零行就是零分。"三个平均进站时间最短的车手的名字"应该得到相同的答案,无论你是使用 SQL、ES|QL,还是手工计算。因此,我们保留 BIRD 的问题和 BIRD 的答案标准,只替换模型生成查询时使用的语言。
下面是其中一个任务,来自 student_club 数据库:
sql
`
1. Question: List out the full name and total cost that member id "rec4BLdZHS2Blfp4v" incurred?
2. Evidence: full name refers to first_name, last_name
4. Gold SQL: SELECT T1.first_name, T1.last_name, SUM(T2.cost)
5. FROM member AS T1
6. INNER JOIN expense AS T2 ON T1.member_id = T2.link_to_member
7. WHERE T1.member_id = 'rec4BLdZHS2Blfp4v'
9. Gold rows: [["Sacha", "Harrison", 866.25]]
`AI写代码这个 [["Sacha", "Harrison", 866.25]] 就是答案标准。我们还会完全按照数据集提供的方式传入 BIRD 的 "证据/evidence" 提示(上面的 full name refers to... 这一行);这些问题在编写时就假定你已经获得了这些提示。
将 BIRD 导入 Elasticsearch
每个表都成为自己的索引,我们特意不进行反规范化。提前将架构扁平化,会悄悄替模型回答问题中最困难的部分,最终我们测量的将是数据建模能力,而不是查询能力。
LOOKUP JOIN 右侧的索引必须使用lookup index模式:
ini
`es.indices.create(index=idx, settings={"index.mode": "lookup"}, mappings=mapping)`AI写代码任何用于 join 或分组的字段都需要使用keyword,而不是 text 字段,因此文本列会被转换为带有 ignore_above 限制的 keyword:
bash
`

1.  KEYWORD_IGNORE_ABOVE = 8000  # keeps UTF-8 byte length under Lucene's 32766 term limit

3.  props[field] = {"type": "keyword", "ignore_above": KEYWORD_IGNORE_ABOVE}

`AI写代码
总计约有 390 万个文档,分布在 75 个索引中,运行于 Elasticsearch 9.5。如果你之前没有构建过这样的 join,这篇关于 Elasticsearch 原生 join 的操作指南更深入地介绍了索引模式要求。
我们如何向模型提供提示以及评估 ES|QL 准确率
提示遵循 BIRD 的零样本协议:包含一个架构块、证据提示、问题,以及一条要求仅返回查询的指令。唯一的不同之处在于,架构以 Elasticsearch 索引映射的形式呈现,而不是 CREATE TABLE DDL,因为目标语言是 ES|QL。
swift
`

1.  SYSTEM_PROMPT = (
2.      "You are an expert Elasticsearch ES|QL query writer. You translate a natural-language "
3.      "question into ONE valid ES|QL query that runs against the provided indices.\n\n"
4.      "ES|QL is a piped query language: FROM <index> | WHERE ... | STATS ... BY ... | SORT ... | LIMIT ...\n"
5.      "It is NOT SQL and NOT Elasticsearch Query DSL. To join indices, use LOOKUP JOIN.\n\n"
6.      "Think step by step, then return ONLY the final ES|QL query."
7.  )

`AI写代码
每个查询只有一次尝试。这是有意为之,因为一次调用、一个提示可以将模型本身掌握的知识与脚手架能够挽救的问题区分开来。
我们针对四个模型运行了三种提示版本:
-
**基础版:**架构、证据、问题;模型使用其已经掌握的 ES|QL 知识。
-
**聚焦技能版:**在上述内容之前加入一份精简的 ES|QL 技能子集:其中的
SKILL.md概览,加上语言参考、生成提示和查询模式。与关系型查询、时间序列、PromQL 和全文搜索无关的部分被省略。 -
**完整技能版:**内容相同,但附加完整技能,并包含所有参考文件。
在这两种技能版本中,文件都会作为静态内容块粘贴到提示中。通常情况下,技能会通过触发器到达模型,由 agent 判断自己需要参考资料,然后加载这些资料。我们去掉了这一步,因此测试变量就是参考资料本身的内容。
测试的模型包括 gpt-5.5、claude-opus-4-8、claude-sonnet-4-6 和 gpt-5.4-mini。
评分时,我们通过_queryAPI 运行生成的 ES|QL,并将结果作为集合与 BIRD 的标准行进行比较。行顺序、重复行、列顺序以及额外返回的列都会被忽略。标准只有一个:查询返回正确的数据。
我们决定忽略结果的呈现细节,因为这些细节无法说明模型是否理解了问题。以之前的 student_club 任务为例,严格的元组比较会拒绝下面这个模型答案:
lua
`

1.  gold: [["Sacha", "Harrison", 866.25]]
2.  pred: [["Sacha Harrison", 866.25]]

`AI写代码
模型构建了一个 full_name,而标准 SQL 将 first_name 和 last_name 分开保留。两者返回的是相同的数据、相同的行。额外列属于同一类问题,而且更加常见;如果问题只要求元素,而模型回答 KEEP atom_id, element,它仍然找到了该元素。
LLM 编写的 ES|QL 到底有多准确?
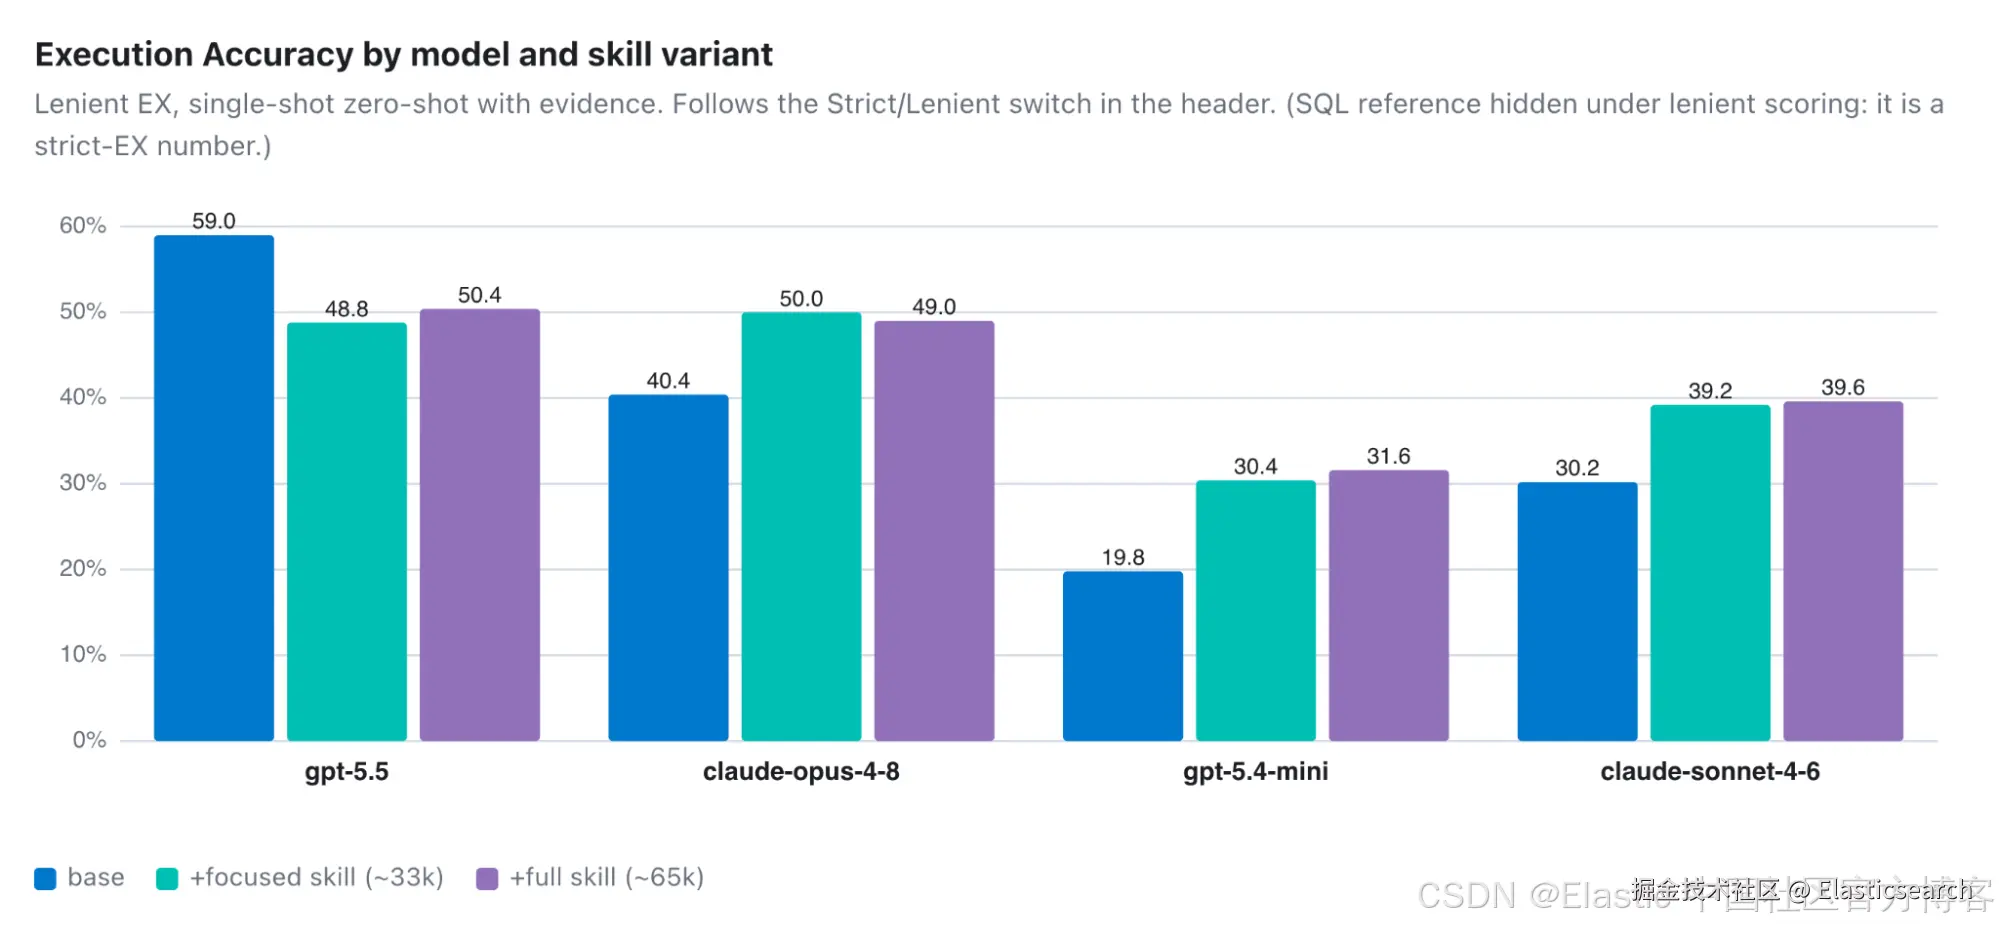
执行准确率,每个单元格 500 个问题:
| 模型 | 基础版 | 聚焦技能版 | 完整技能版 |
|---|---|---|---|
gpt-5.5 |
59.0% | 48.8% | 50.4% |
claude-opus-4-8 |
40.4% | 50.0% | 49.0% |
claude-sonnet-4-6 |
30.2% | 39.2% | 39.6% |
gpt-5.4-mini |
19.8% | 30.4% | 31.6% |
有两点值得注意:
-
除了最强模型之外,参考资料对每个模型都价值约 10 个百分点 :Opus、Sonnet 和
gpt-5.4-mini从聚焦技能版中获得 9.0 到 10.6 个百分点的提升;gpt-5.5则下降了 10.2 个百分点。它在只有架构的情况下就已经达到 59.0%,并且 500 个查询中只有 7 个查询出现格式错误,因此它本身并不存在需要参考资料来解决的语法问题,而提供参考资料带来的损失超过了它可能获得的收益。 -
**提升幅度小于错误数量所显示的程度:**skill 几乎消除了本次运行中最大的错误类型:在全部 6,000 个查询中,join 错误从 939 个下降到 354 个。但总体准确率没有变化。原因出现在旁边的另一列中,这是一种之前几乎不存在的错误类型:
Found ambiguous reference从 120 个增加到 706 个。错误并没有真正得到解决,而只是换了一种形式出现;我们将在下一节详细分析这一点。文档可以教会模型 ES|QL 的语法,但无法教会它你的数据是什么样的。
ES|QL 生成失败的四种方式
下面的百分比都是以错误查询为基数计算的。_错误查询_指任何没有返回正确数据的查询,无论是运行失败,还是运行成功但返回了错误的行。数据正确但结果形状错误,不计入错误。
| 失败类型 | 应对方法 |
|---|---|
| 两侧的 Join 键名称不同 | 在 join 之前使用 RENAME,将外键名称与主键名称匹配,或者使用 9.2 版本的 join 谓词 |
| ES | QL 解析器拒绝的 SQL 语法 |
在一对多 LOOKUP JOIN 之后进行计数 |
对实体使用 COUNT_DISTINCT,或者在 join 之前进行聚合 |
| 模型猜测了数据中不存在的值 | 在提示中提供示例行和不同值 |
1. ES|QL LOOKUP JOIN 要求两侧使用相同的字段名
Join 键命名是最大的失败类型:Opus 的 298 个 基础版 错误中有 134 个属于此类,约占 45%。SQL 可以使用名称不同的列进行 join,而 BIRD 的架构就依赖这一点(superhero.skin_colour_id 与 colour.id 进行 join)。ES|QL 的基本 join 形式则不支持这种方式。LOOKUP JOIN <index> ON <field> 只接受一个字段名,并且该字段必须存在于两侧,这更接近 SQL 的 JOIN ... USING,而不是 JOIN ... ON。Elasticsearch 9.2 增加了第二种形式,解除了这一限制,但仅适用于两侧键名称不同的情况。这个条件正是我们本次测试出现问题的地方,我们将在本节末尾回到这一点。
模型如果尝试使用 SQL 的 join 语法,就会写出这样的查询:
ini
`

1.  FROM superhero__superhero
2.  | LOOKUP JOIN superhero__colour ON skin_colour_id = id
3.  | WHERE colour == "Green"

`AI写代码
arduino
`line 2:51: mismatched input '=' expecting {<EOF>, '|', 'and', ...}`AI写代码给它提供技能后,它学会了 ON <field> 这种形式,却在下一步仍然出错,还是使用左侧的名称(expense.link_to_budget 指向 budget.budget_id):
sql
`line 3:39: Unknown column [link_to_budget] in right side of join`AI写代码在整个测试中,有 212 个 join 查询完全无法解析,其中包括类似 SQL 的 ON a = b;另外还有 226 个查询能够解析,但因为右侧字段名称不正确而被拒绝。根据你能控制的部分,有三种解决方法。
**1. 在查询时重命名。**在 join 之前添加一行:
vbnet
`

1.  FROM student_club__expense
2.  | WHERE expense_description == "Post Cards, Posters" AND expense_date == "2019-8-20"
3.  | RENAME link_to_budget AS budget_id
4.  | LOOKUP JOIN student_club__budget ON budget_id
5.  | KEEP event_status

`AI写代码有一个需要注意的地方:RENAME 会替换目标列,如果你重命名后的名称已经存在于左侧。因此,将 superhero 与 colour 进行 join 正好属于这种情况,因为两者都有一个 id,所以需要在同一个命令中将冲突移开(重命名会从左到右依次应用):
vbnet
`

1.  FROM superhero__superhero
2.  | RENAME id AS hero_id, skin_colour_id AS id
3.  | LOOKUP JOIN superhero__colour ON id
4.  | WHERE colour == "Green"

`AI写代码
**2. 在数据模型中修复。**让外键使用与其所指向的主键相同的名称,这样问题就会永久消失。在设计阶段这样做成本很低,因此我们称之为一种建模习惯。
**3. 使用 join 谓词(Elasticsearch 9.2 及更高版本)。**Elasticsearch 9.2 增加了复杂的 join 谓词,可以直接比较名称不同的字段,就像 SQL 教给你的那样:
ini
`| LOOKUP JOIN student_club__budget ON link_to_budget == budget_id`AI写代码谓词中的每个名称都必须是明确无歧义的,因此当键已经存在于两侧时,这种形式无法解决问题。BIRD 中的大多数情况都属于这种情况,也正是我们修改后的技能产生反效果的地方。告诉模型优先使用谓词而不是 RENAME,使 gpt-5.5 在 join 中使用 RENAME 的比例从 47% 降至 11%,而原本由 RENAME 阻止的错误则以另一种形式出现:
python
`Found ambiguous reference to [id]; matches any of [line 1:1 [id], line 3:15 [id]]`AI写代码在整个测试中,这类错误从 120 个增加到 706 个,而 join 错误类别则从 939 个下降到 354 个;两者几乎完全抵消。9.2 版本发布说明详细介绍了新的 join 形式。
2. ES|QL 解析器拒绝的 SQL 语法
表现最差的模型往往是那些习惯使用 SQL 思维的模型。这也是 gpt-5.4-mini 的 500 个基础版查询中有 236 个出错、 Sonnet 有 181 个出错的地方。
| 模型写法 | ES|QL 要求 |
|---|---|
WHERE x = 5 |
WHERE x == 5 |
WHERE name = 'Bob' |
WHERE name == "Bob" |
CASE WHEN x > 1 THEN 'a' ELSE 'b' END |
CASE(x > 1, "a", "b") |
COUNT(DISTINCT id) |
COUNT_DISTINCT(id) |
DIVIDE(a, b)、YEAR(d) |
这些都不存在 |
| 相关子查询 | 使用 STATS 和 join 重新组织 |
单引号是其中最隐蔽的一种,因为在 ES|QL 中,双引号用于界定字符串,而单引号则不行。在这里,Sonnet 同时采用了这两种习惯:一个裸 = 和一个使用单引号括起来的字符串,结果解析器在遇到引号时就停止了:
ini
`

1.  FROM financial__client
2.  | WHERE gender = 'F'

`AI写代码
arduino
`line 2:18: token recognition error at: '''`AI写代码这是唯一一种可以从上下文文档中获益的类别。Sonnet 的 181 个语法错误减少到了 86 个,而 gpt-5.4-mini 的 236 个减少到了 150 个。如果你要让一个较小的模型处理 ES|QL,那么在 提示词 中加入一页语法速查表,是回报最高的单项措施。完整的语言参考并不会更好。
3. 跨一对多 LOOKUP JOIN 进行计数
LOOKUP JOIN 的结果展开方式与 SQL join 一样;当左侧的一行与 lookup index 中的多行匹配时,每个匹配都会产生一行输出。忘记这一点的模型会统计 join 后的行数,而不是问题所要求统计的实体数量。这约占"运行成功但结果错误"类别的 32%。
将一个成员与其费用进行 join,你会得到每笔费用一行,因此普通计数回答的是_有多少笔费用_,而问题问的是_有多少名成员_:
vbnet
`

1.  FROM student_club__expense
2.  | RENAME link_to_member AS member_id
3.  | LOOKUP JOIN student_club__member ON member_id
4.  | STATS members = COUNT(*)

`AI写代码
这里的 COUNT(*) 统计的是费用行。解决方法是统计你实际想要统计的实体,或者在 join 之前进行聚合,而不是在 join 之后聚合:
ini
`| STATS members = COUNT_DISTINCT(member_id)`AI写代码4. 模型猜测了一个你的数据中不存在的值
第四种失败类型是模型编造了一个看起来合理的值,但这个值并不是实际存储的值。
BIRD 的数据库中到处都是这种情况。某种交易类型存储的是 'VYBER',而不是 'withdrawal'。当要求查询取款记录时, gpt-5.4-mini 写入了英文单词,但这个值与任何数据都不匹配:
ini
`

1.  FROM financial__trans
2.  | WHERE account_id == 3 AND type == "withdrawal"
3.  | STATS requests = COUNT(*) BY k_symbol

`AI写代码
这个查询是有效的 ES|QL,并且可以正常运行。它只是返回空结果,因为该列中没有任何值是 withdrawal。同样的模式在整个数据集中反复出现:
-
实验室检测结果是
'negative',而不是'-'或false -
日期经常以 keyword 字符串的形式存储,而不是 date 字段,这会导致模型调用的任何日期函数失效,并且这一问题本身就约占错误结果的 17% 到 24%
-
排名问题会将位置与实际存储的排名列混淆
仅靠 schema 块无法解决这个问题,因为 schema 只能告诉你某一列是 keyword,却不会告诉你其中有哪些 keyword。解决方法是在提示词中加入示例值:提供少量行,或者提供低基数列的不同值。这是检索能够提供帮助、而文档无法解决的失败类型。
结论:这对生产环境中的文本转 ES|QL 意味着什么
我们从这次测试中得出三个结论:
-
最新的模型已经能够很好地编写 ES|QL: 单次调用、零样本、只有 schema,而最强的模型仍然能在大多数问题上正确获取数据,同时几乎不会编写无法运行的查询。ES|QL 对前沿模型来说已经不再是什么陌生技术了。
-
新的语言特性不会自动带来收益: Elasticsearch 9.2 的 join 谓词消除了导致我们最大失败类别的限制,而让模型使用这一特性后,该类别的错误确实从 939 个减少到了 354 个。但准确率没有提升,因为模型将节省下来的错误空间用在了另一种新错误上。一个特性只有在指导信息明确说明什么时候不要使用它之后,才能真正产生收益。
-
增加提示词内容对除最强模型之外的所有模型都有帮助: 一份精简的语法参考可以为较小的模型带来约 10 个百分点的提升,更完整的参考并不会带来更多帮助,而前沿模型两者都不需要。给它提供它本来就不需要的建议,反而可能让它损失 10 个百分点。
大约一半的失败都会抛出精确且可操作的 Elasticsearch 错误(Unknown column [gender_id] in right side of join 会明确告诉你需要修复什么),因此,在使用类似 Elastic Agent Builder 这样的 agent 时,将错误文本附加到提示词中进行一次重试,就可以恢复其中很大一部分。
另一半则会因为猜测的值而静默失败,重试无法解决这类问题;它们需要在提示词中加入示例行和取值查询。语法已经不再是上限。真正的上限是了解你的 schema 和数据中的值,而这是一个检索问题,也更加容易解决。
资源
-
浏览 benchmark 测试框架和全部 6,000 条评分查询,或者在 实时交互式报告 中进行筛选
-
LOOKUP JOIN命令参考,包括多字段 join 和谓词形式 -
Elasticsearch 9.2 ES|QL 发布文章,介绍新的 join 形式
-
Text-to-ES Bench(ACL 2025),这是本文所基于的 Query DSL 基准测试
原文:Elasticsearch query language: can LLMs write correct ES|QL? | Elasticsearch Labs