分词器的执行流程
Character Filter(字符过滤器) → Tokenizer(切词器) → Token Filter(词条过滤器)
字符过滤器(Character Filter)
操作对象:原始完整字符串 (还没切词)
工作:字符层面替换、删除、清洗。
例子:去掉 HTML 标签、全角转半角、正则替换。
切词器(Tokenizer)
操作对象:经过字符过滤器处理后的字符串
工作:把连续字符串切割成一个个独立的 token,同时生成:
- term(词条文本)
- position(词位置,match_phrase 依赖)
- start_offset /end_offset(字符起止偏移)
例如 standard tokenizer 按单词边界切分。
词条过滤器(Token Filter)
操作对象:已经切好的单个 token
工作:对每个 token 里面的 term 做修改、删除、新增;不会改变 token 的 position 和 offset 。
常见操作:小写转换、去停用词、同义词、词干提取。
文本正常化:把token做标准化处理,消除无关差异,让语义相同、写法不同的文本,分词后得到一样的 term。
常见的正常化操作(standard 分词器自带)
- 大小写转换 :全部转为小写
Xiaomi→xiaomi
这样match搜Xiaomi和xiaomi能命中同一文档。 - 去掉变音符号(重音)
café→cafe
法语、西班牙语的重音符号剥离。 - 删除停用词(可选,stop token filter)
英文the、a、is这类无实义虚词直接移除,减少索引体积。 - 同义词替换(synonym filter)
手机、移动电话→ 统一映射成同一个 term。 - 去除多余符号、特殊字符、空白
自定义分词器
在 settings 里面定义 analyzer,由三部分组成:
char_filter(可选) + tokenizer(必须,只能 1 个) + filter(可选,token filter)
java
# 自定义分词器,支持字符映射和同义词过滤
PUT my_index
{
  "settings": {
    "analysis": {
      "char_filter": {
        "my_mapping": {
          "type": "mapping",
          "mappings": [
            "$ => yuan",
            "@ => youjian"
          ]
        }
      },
      "filter": {
        "my_synonym": {
          "type": "synonym",
          "synonyms": [
            "xiaomi,pianyi",
            "phone,dianhua"
          ]
        }
      },
      "analyzer": {
        "my_analyzer": {
          "type": "custom",
          "char_filter": ["my_mapping"],
          "tokenizer": "standard",
          "filter": ["lowercase", "my_synonym"]
        }
      }
    }
  }
}

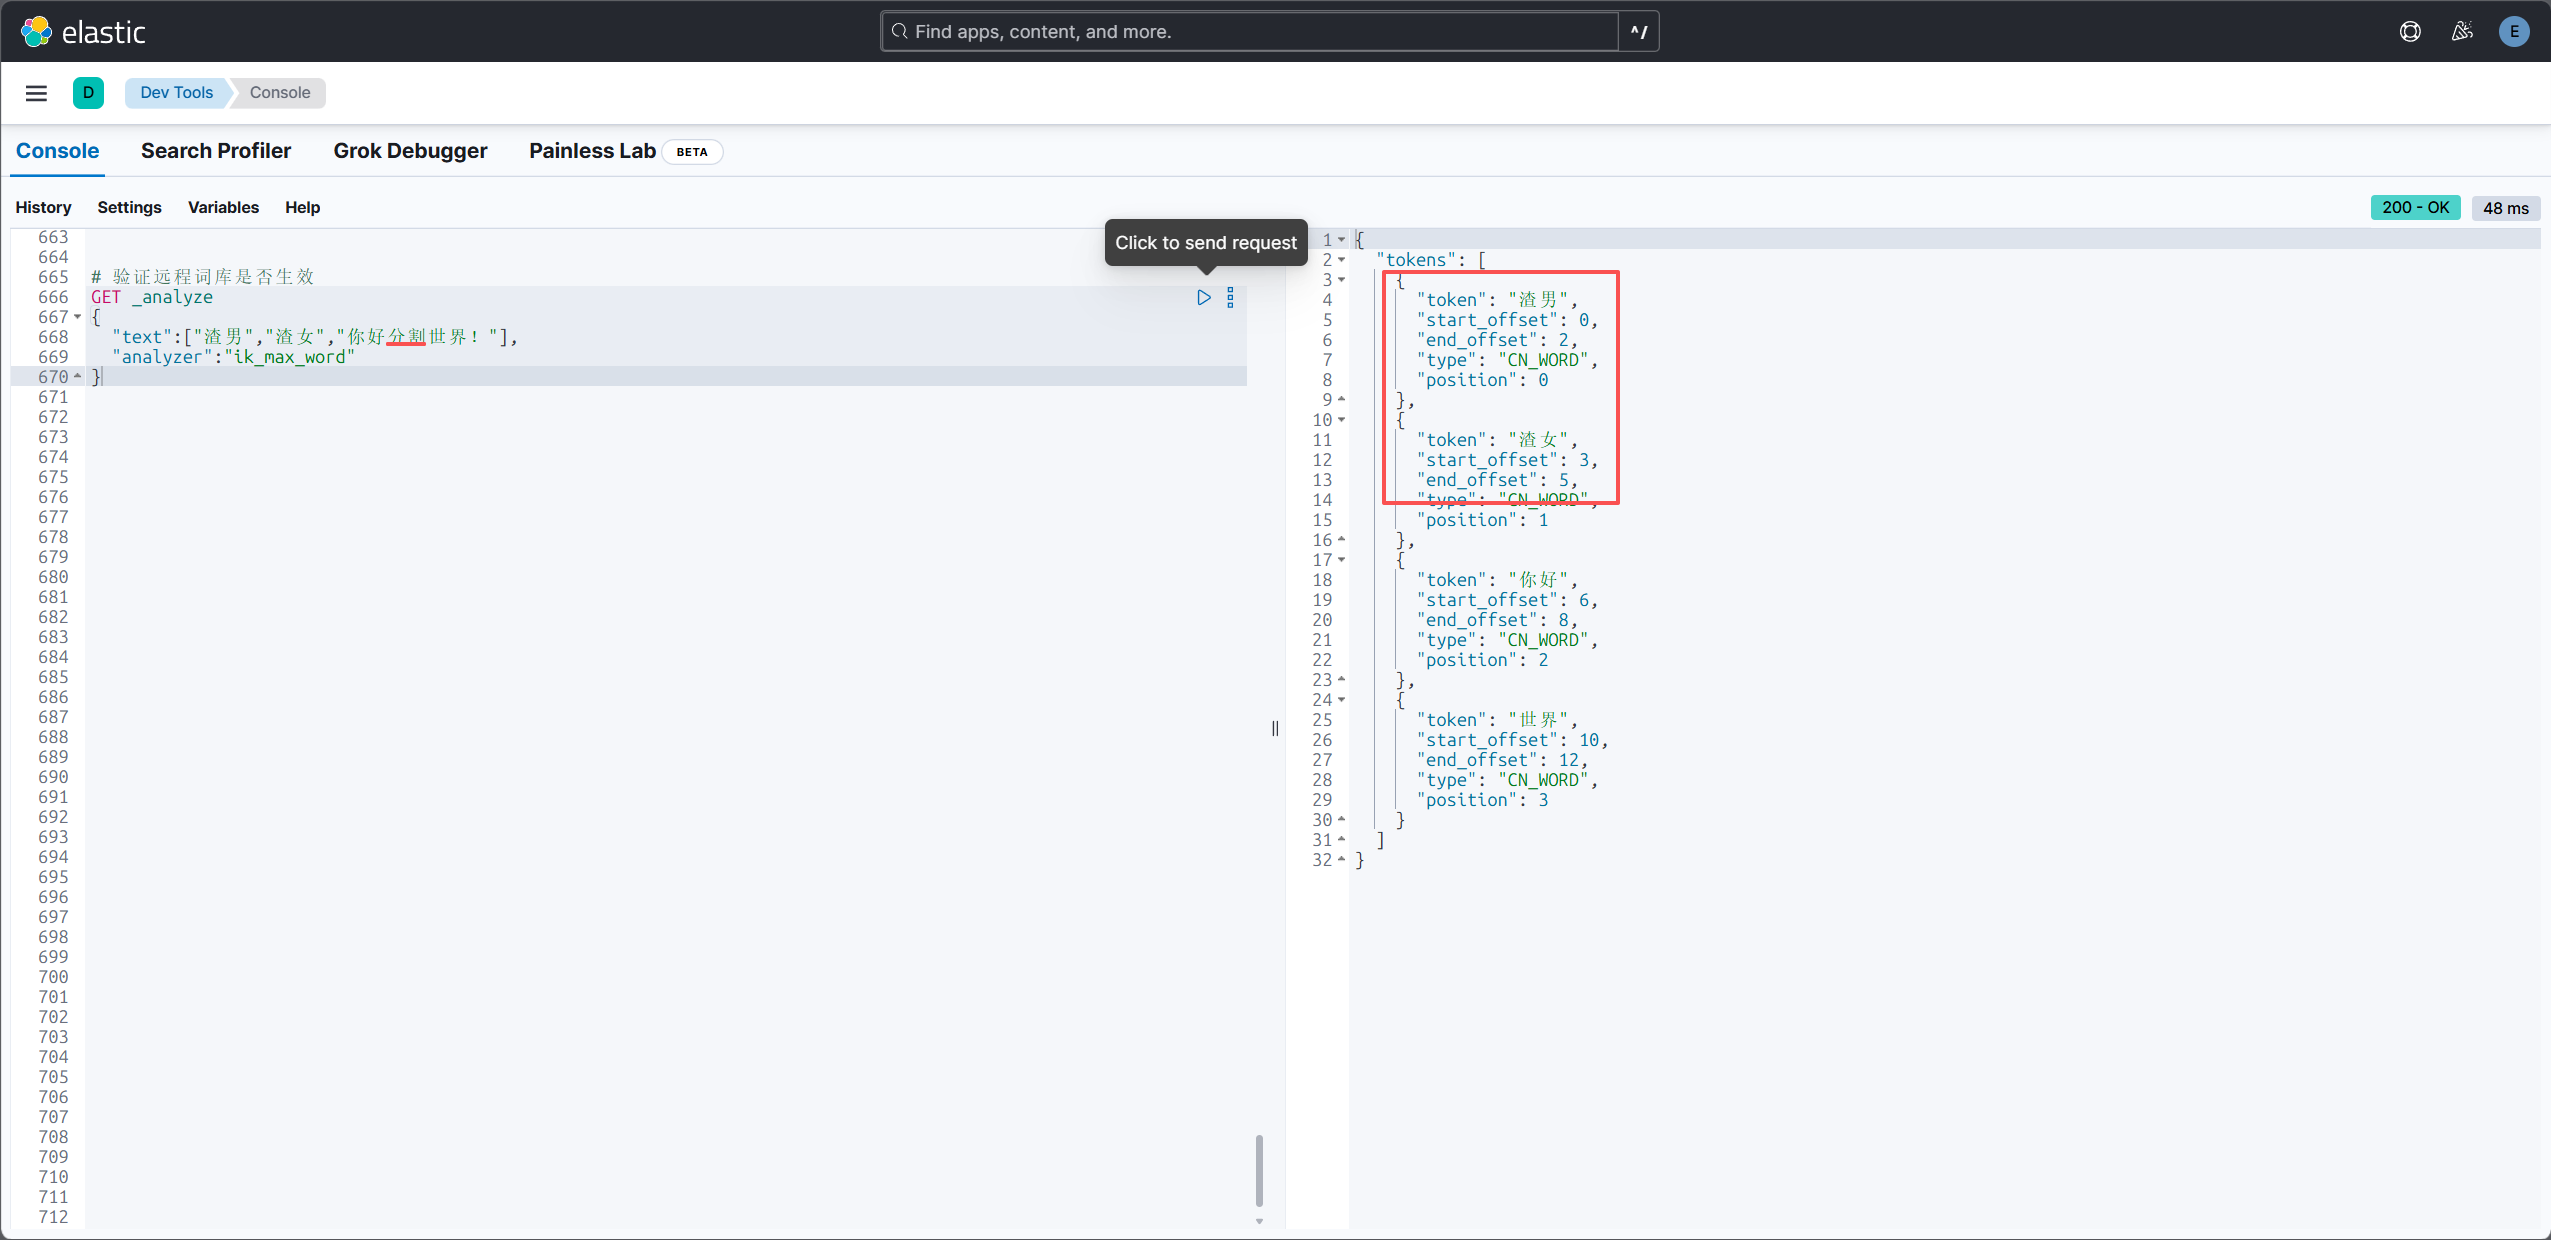
# 测试
GET /my_index/_analyze
{
  "text":["xiaomi shouji $","phone"],
  "analyzer":"my_analyzer"
}
其中字符通过映射转化:$ => yuan,phone新增了近义词dianhua。
分词器插件
中文使用默认的standard分词器,文本将被拆分成单个字符,中文一般使用ik分词器。
ik分词器插件安装
插件版本需和es版本对应,下载地址:https://release.infinilabs.com/analysis-ik/stable/
得到对应版本的下载地址后在容器内执行:
java
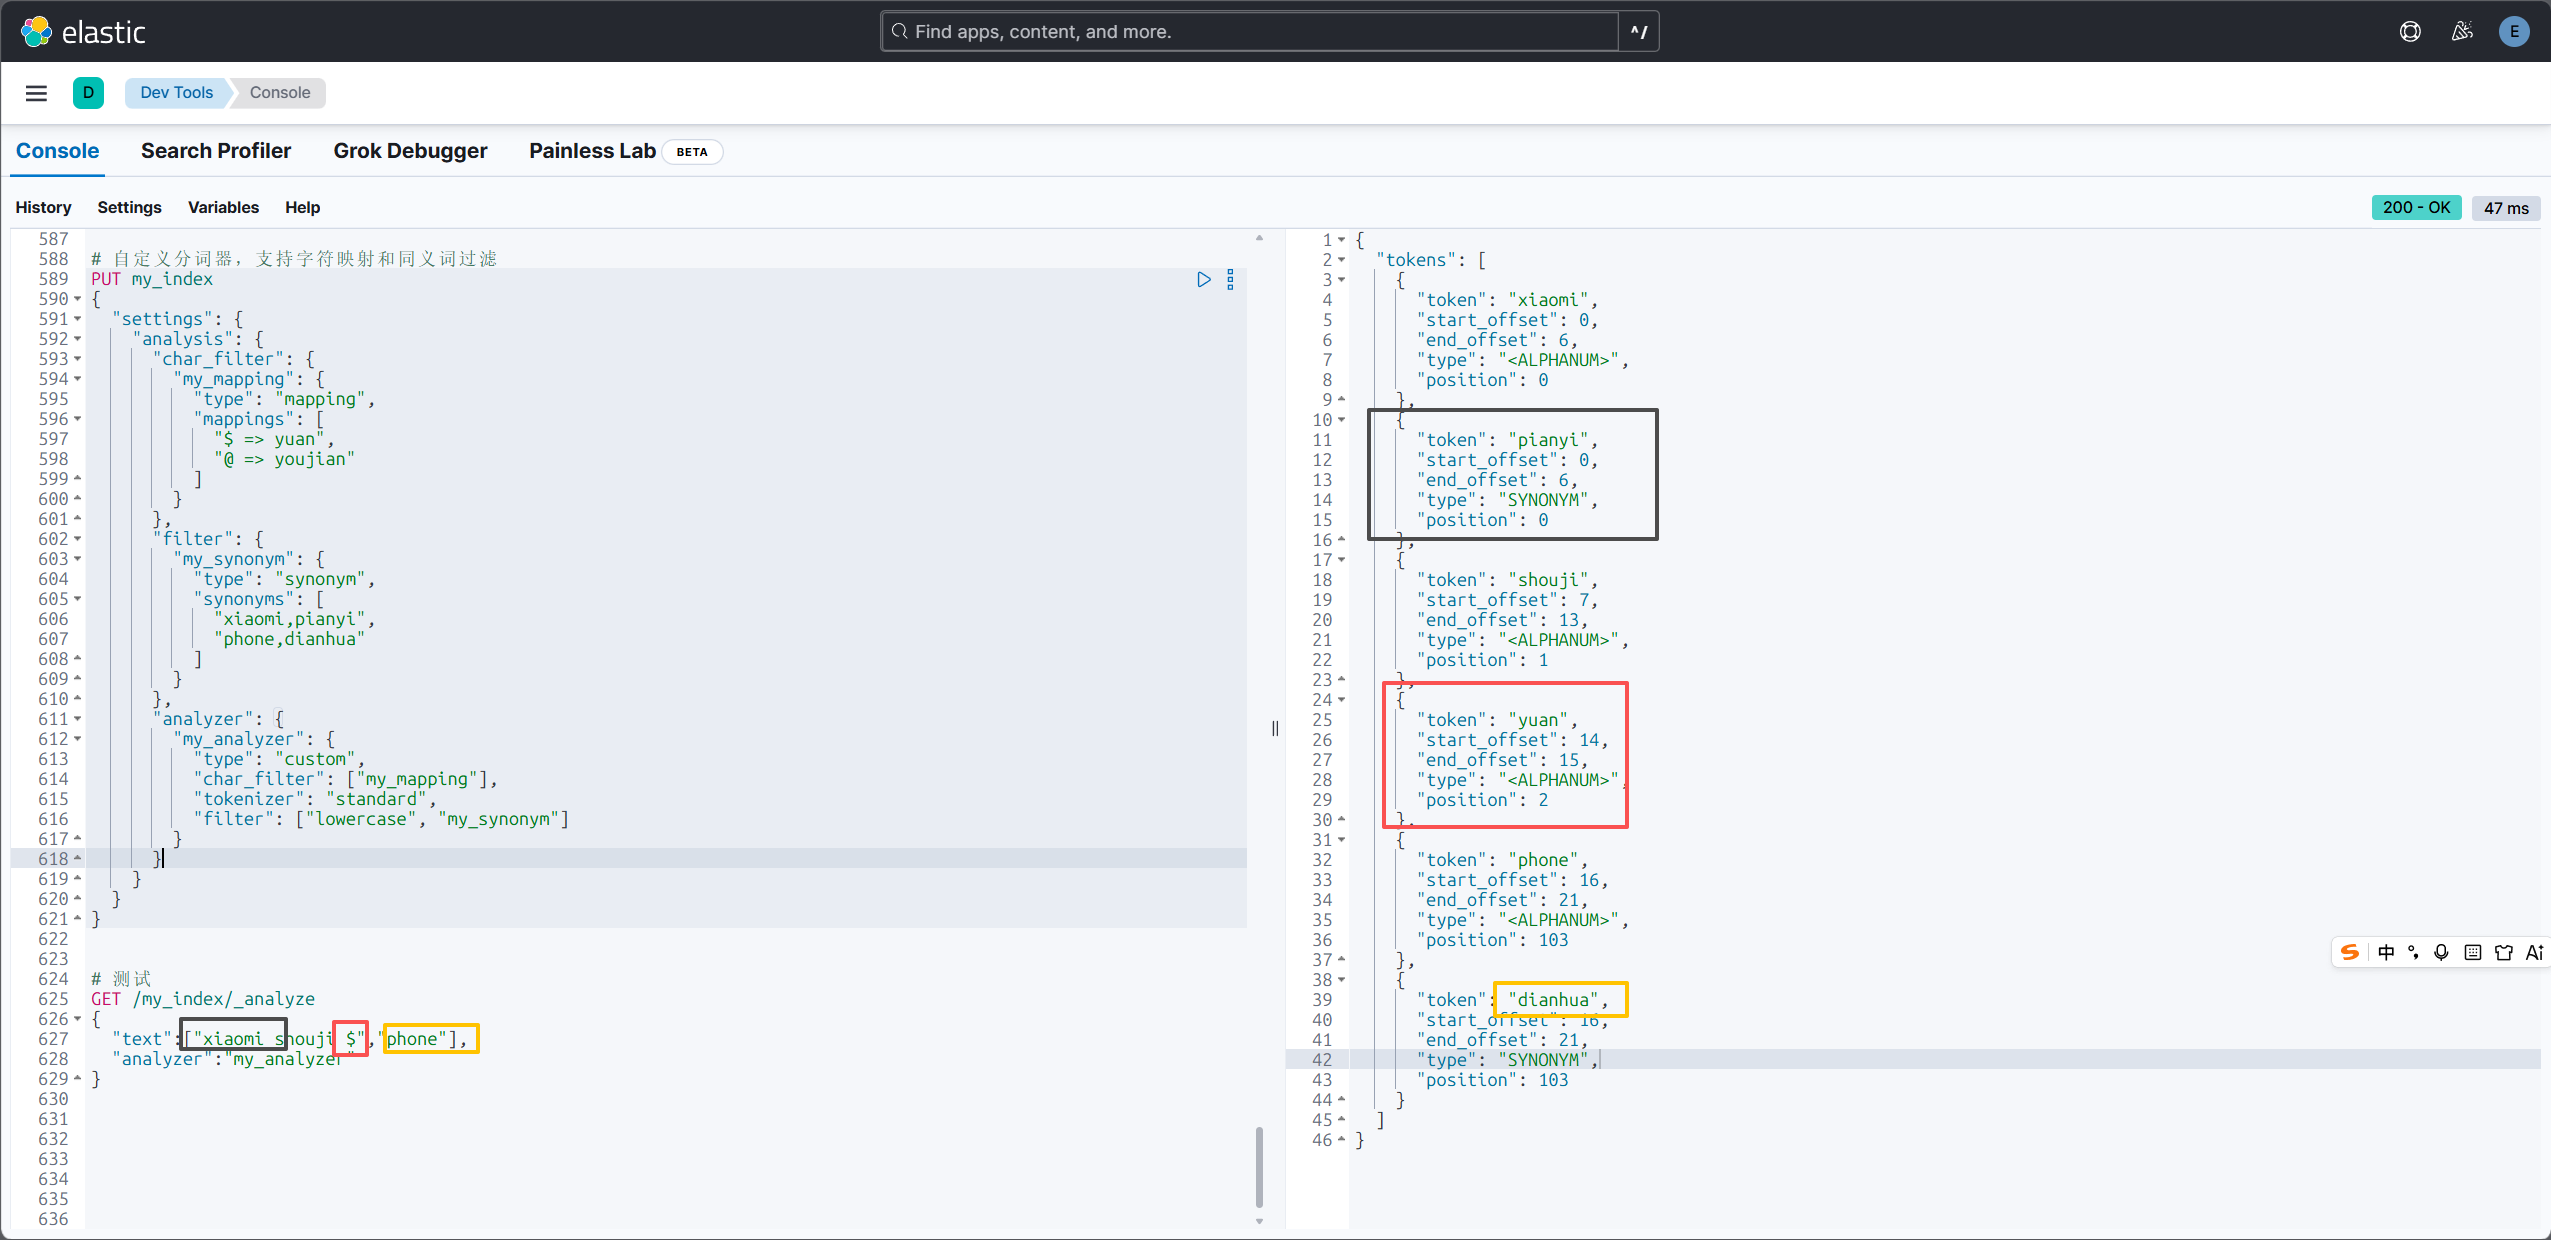
./bin/elasticsearch-plugin install https://release.infinilabs.com/analysis-ik/stable/elasticsearch-analysis-ik-8.15.0.zip安装后重启es,测试:
添加扩展词典
若有自定义的词组或停顿词,未被正常识别,可添加自定义的拓展词典,然后再ik插件目录的文件中进行配置。
1、新增自定义词典my_ext.dic
java
小米手机
鸿蒙系统
豆包大模型
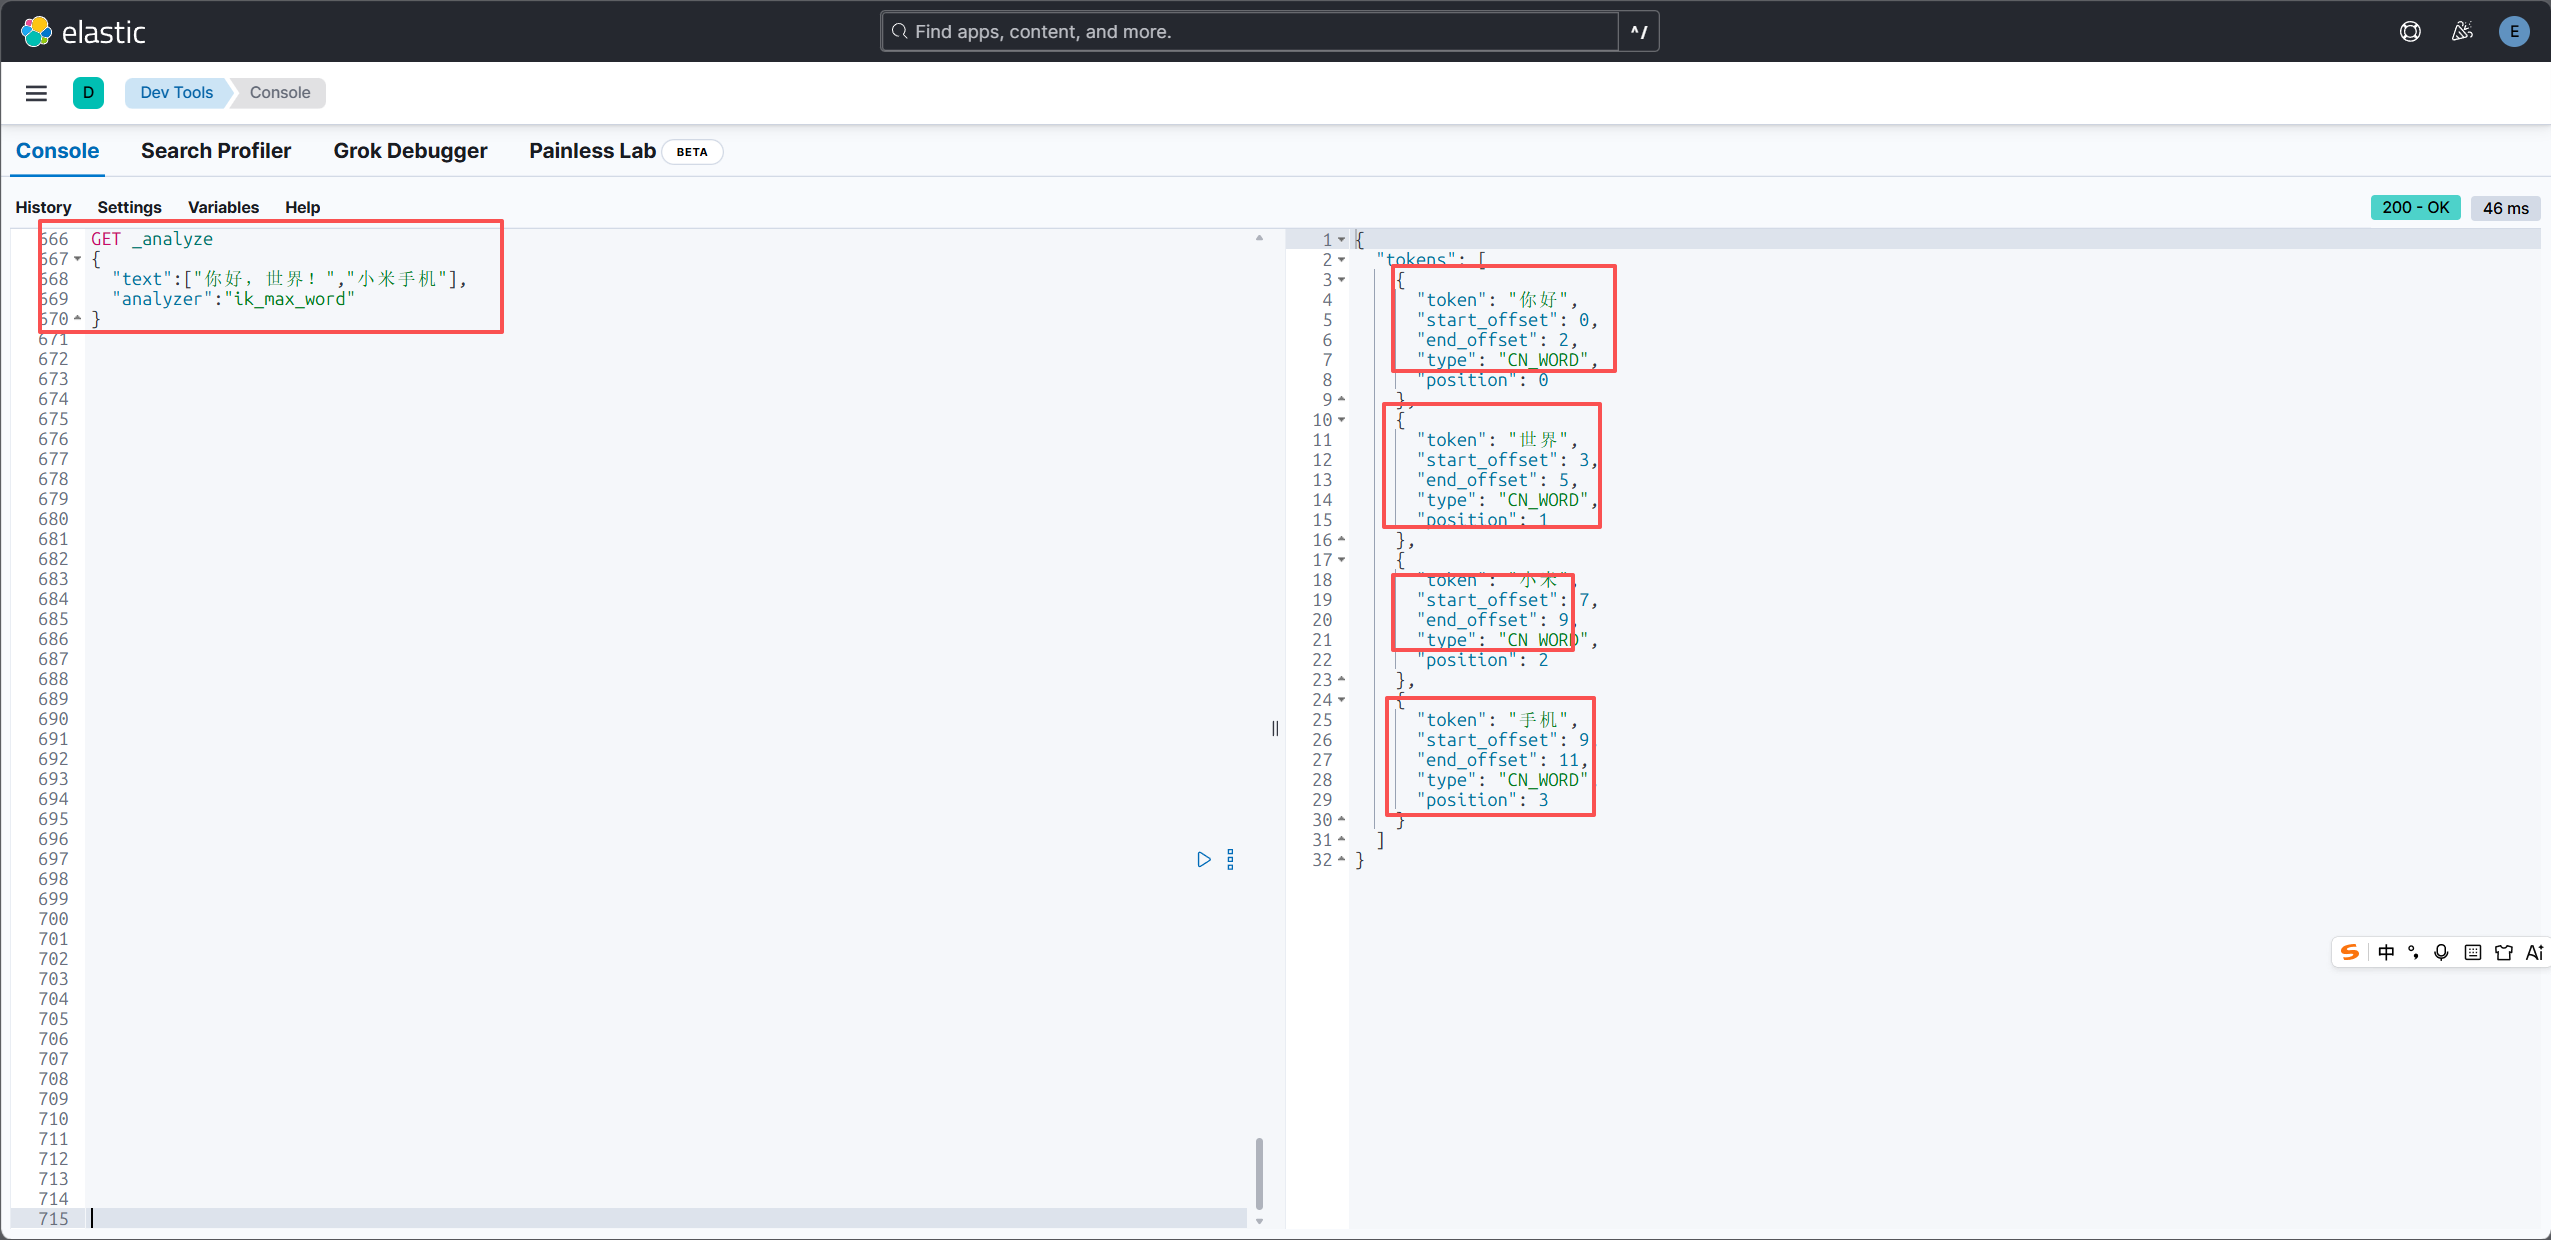
2、将文件放入到配置目录
目录地址:/usr/share/elasticsearch/config/analysis-ik
3、配置文件中指定自定义的词典
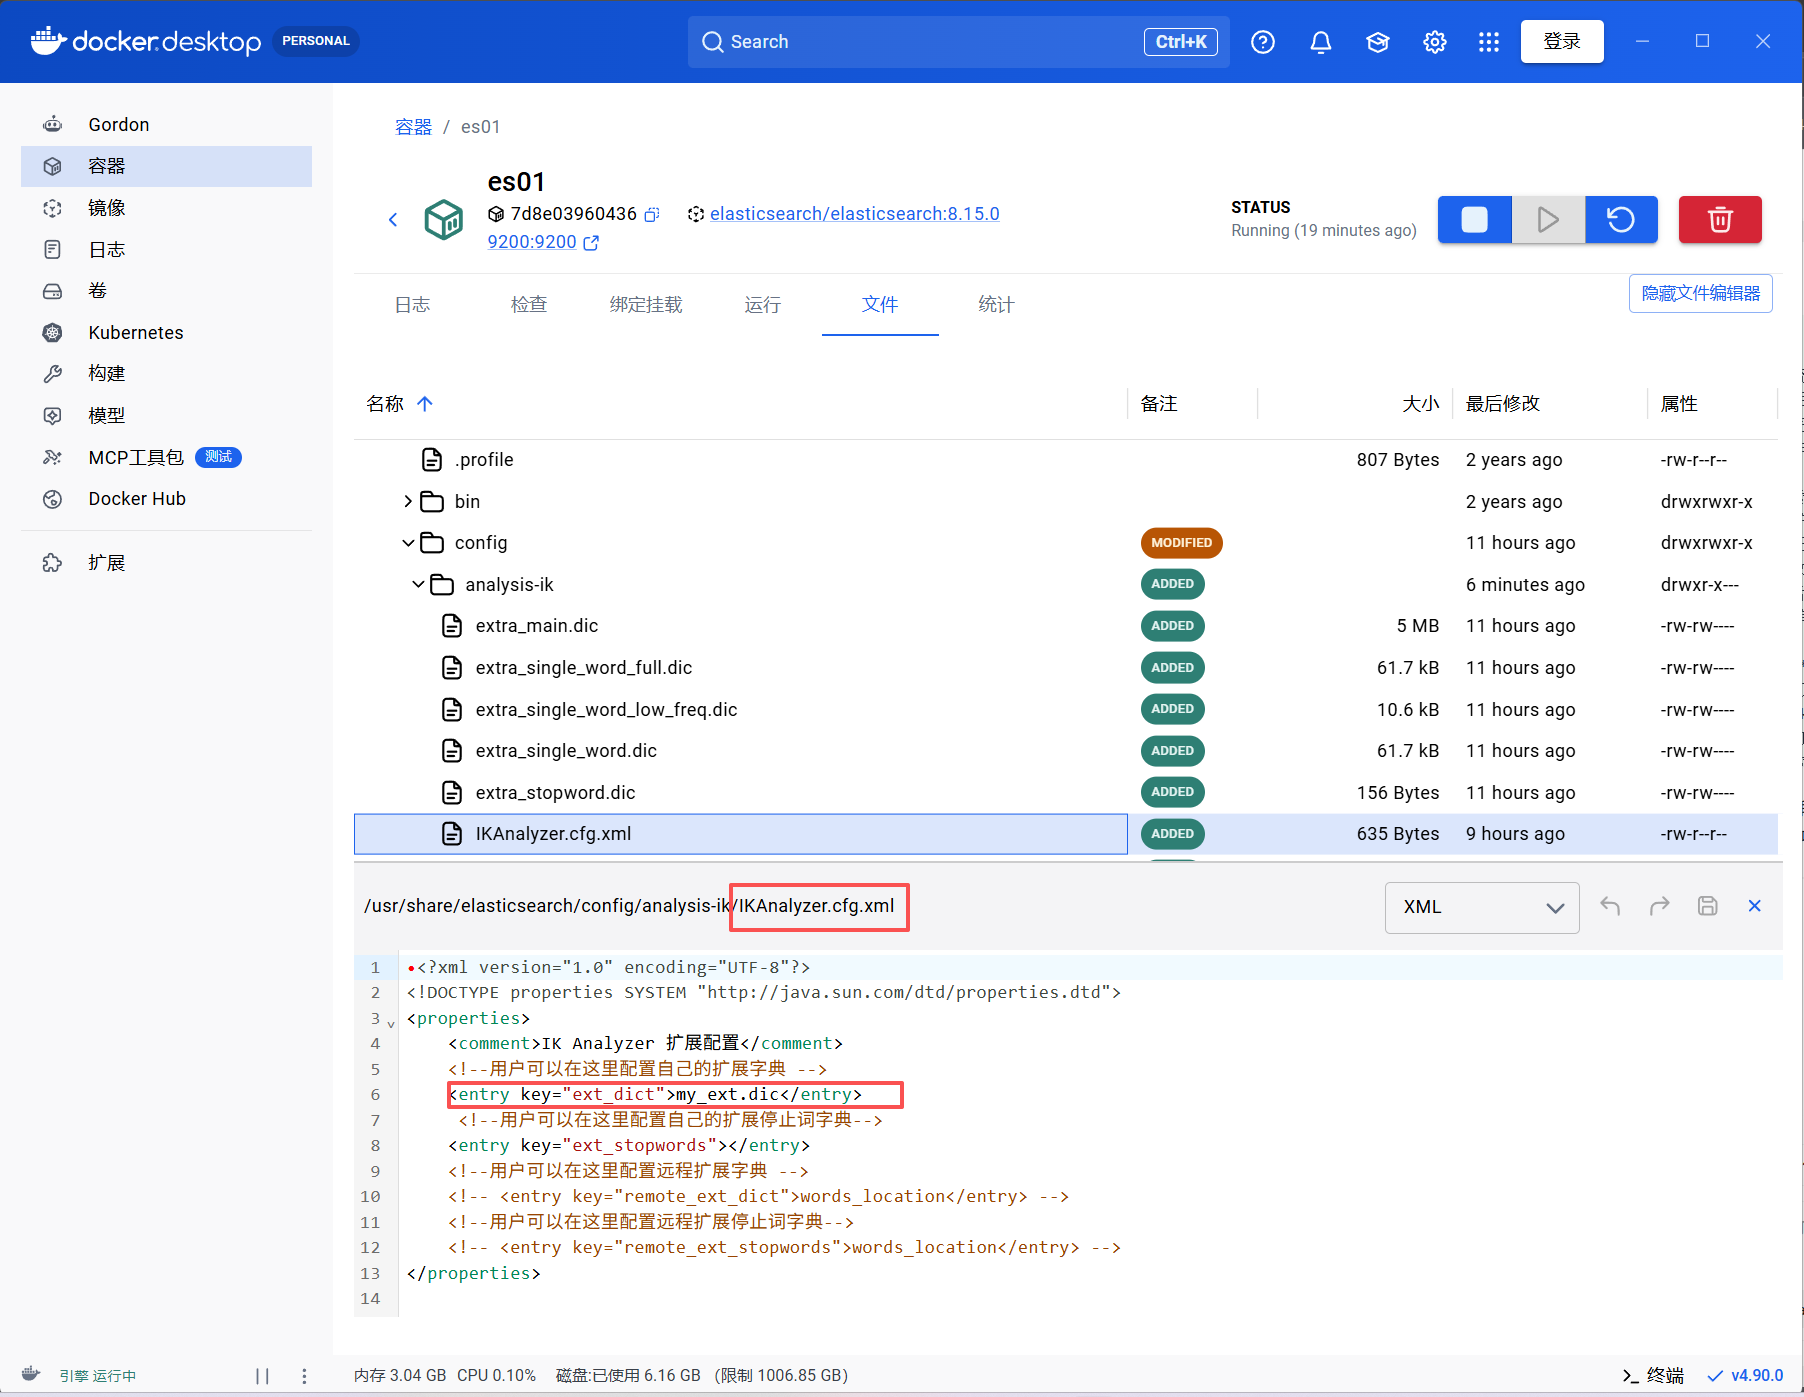
4、重启es,验证
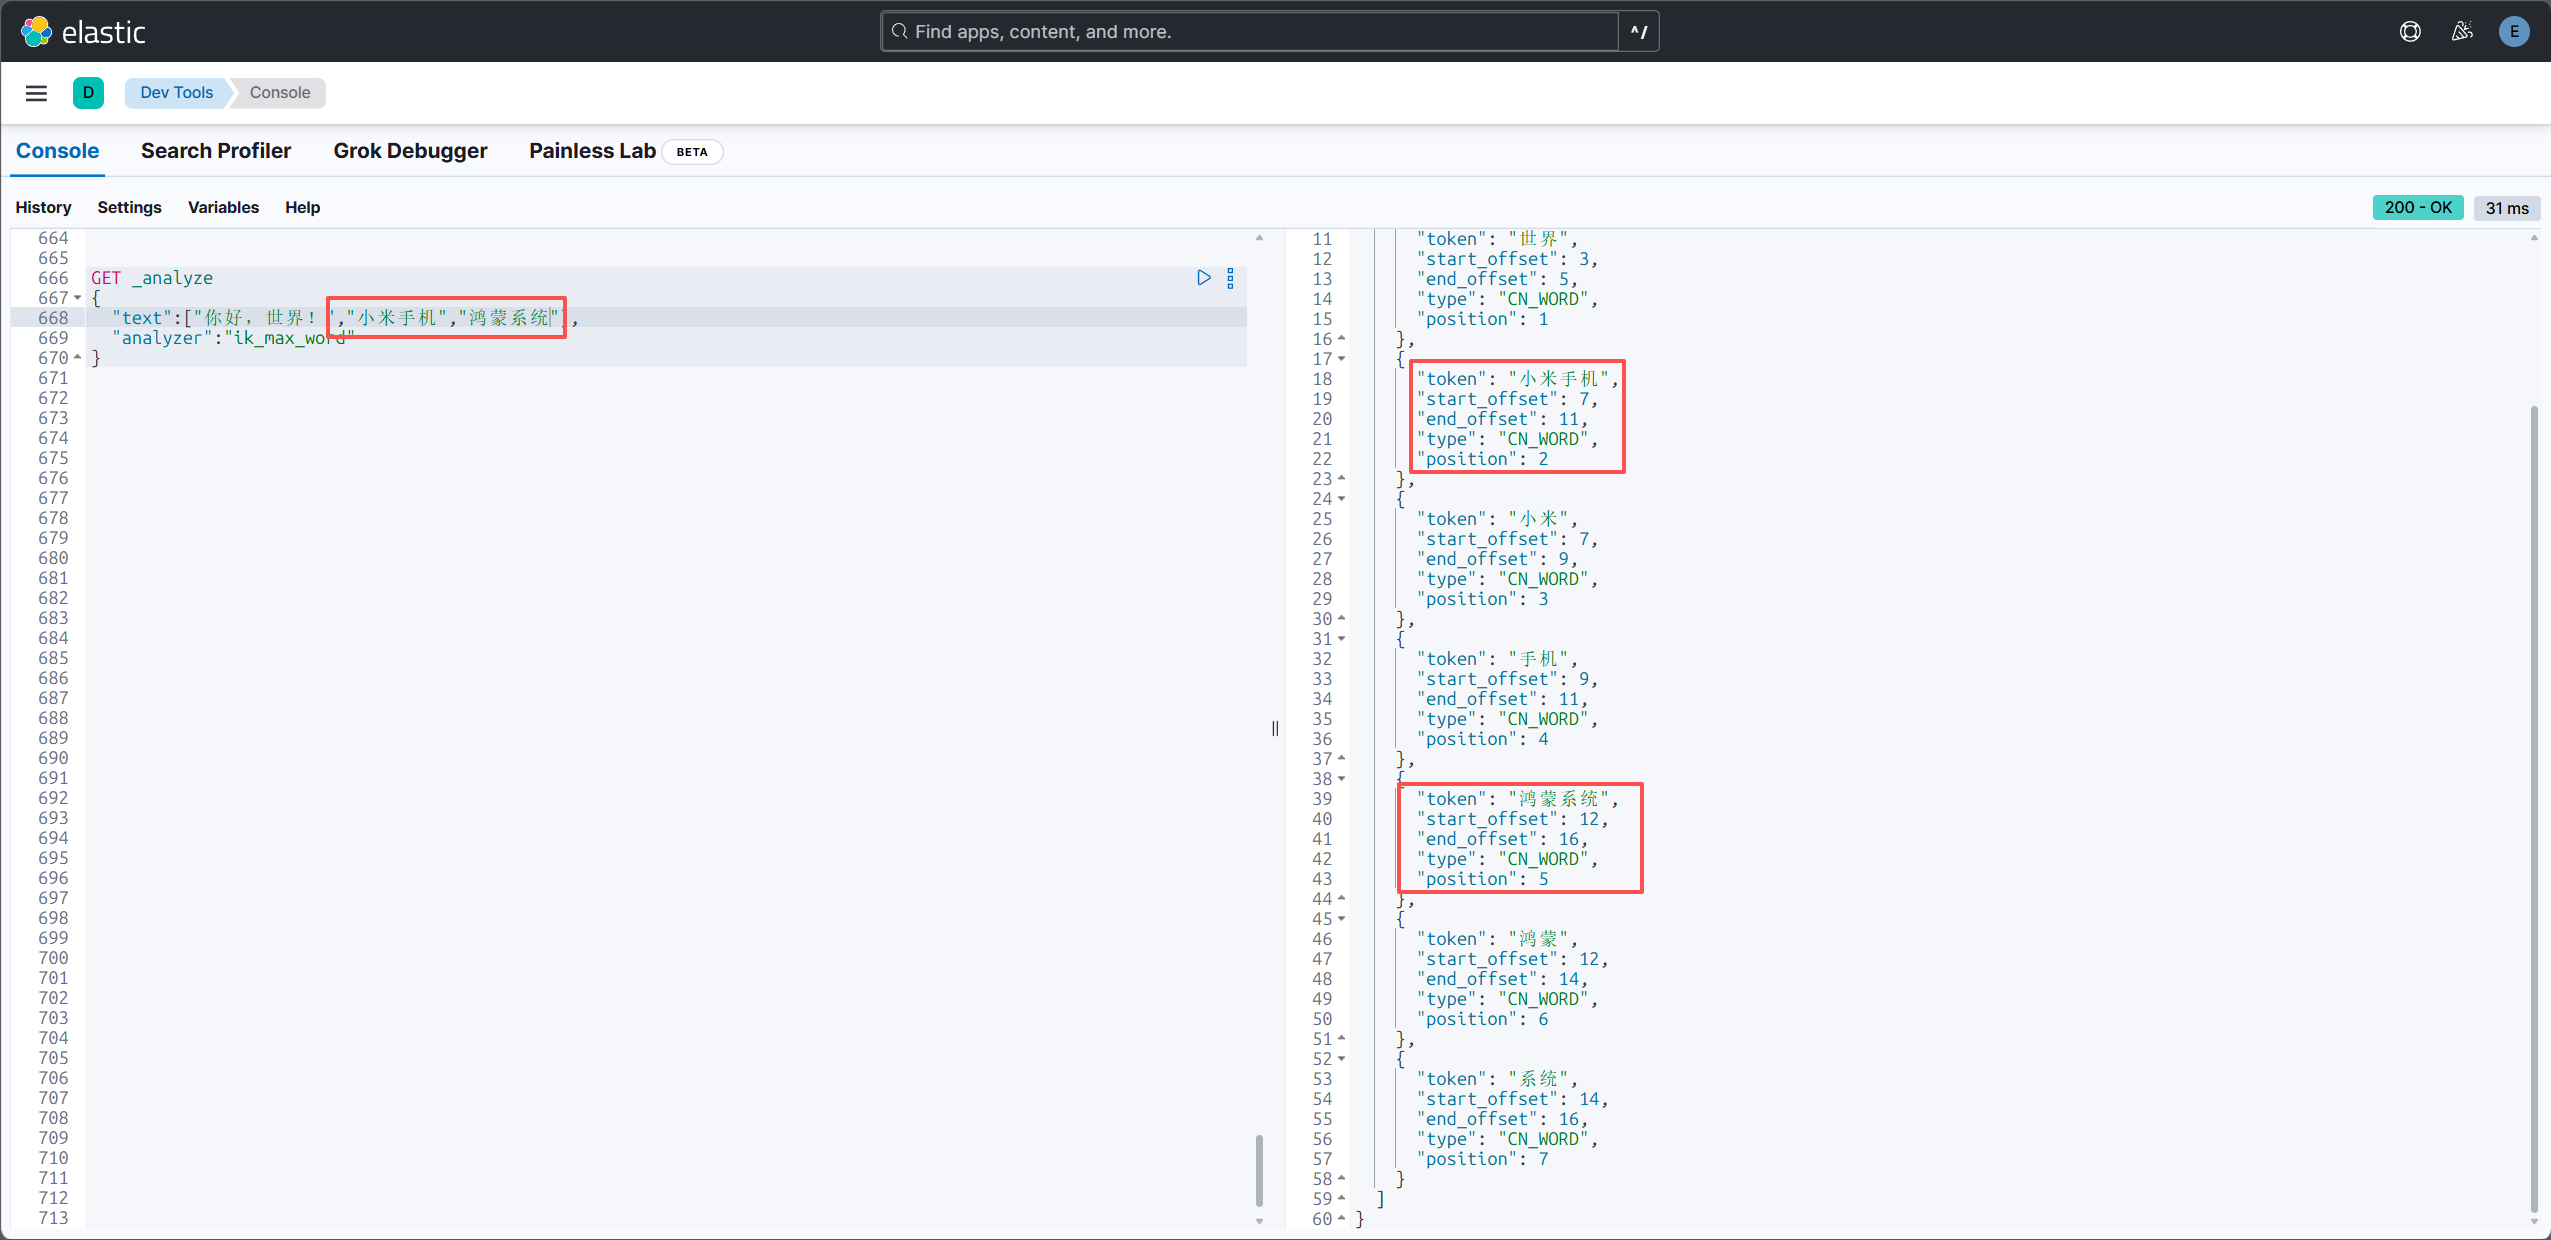
同样的方法也可以配置指定义停顿词,在停顿词文件中的词条,分词时会被去掉。
配置远程词库
本地扩展词库每次修改需要重启es服务才能生效,es支持配置远程词库,通过接口请求的方式热更新扩展词库。
核心:IK 内置Monitor 定时线程 ,每隔1 分钟 向远程 URL 发起HEAD请求,校验Last-Modified/ETag;任意一个发生变化,则GET拉取词库,内存重载词典,不需要重启 ES 。
可以通过搭建服务或使用nginx返回对应扩展文件。
1、使用nginx返回词典数据
nginx配置静态服务:
java
# 服务1:IK远程词典 8002端口
    server {
        listen 8002;
        # 指定静态资源目录
        root /usr/share/nginx/html;
        # 本server下所有返回文本默认标记utf-8
        charset utf-8;
        # 关键:让txt文件也带上charset(默认charset只对html生效)
        charset_types text/plain;
        location /ikdict/ {
        	# 设置文件不缓存
            add_header Cache-Control "no-cache";
        }
    }
2、在资源目录下添加remote_dict.txt和remote_stop.txt
java
remote_dict.txt
渣男
渣女
java
remote_stop.txt
分割
3、配置文件中配置远程地址
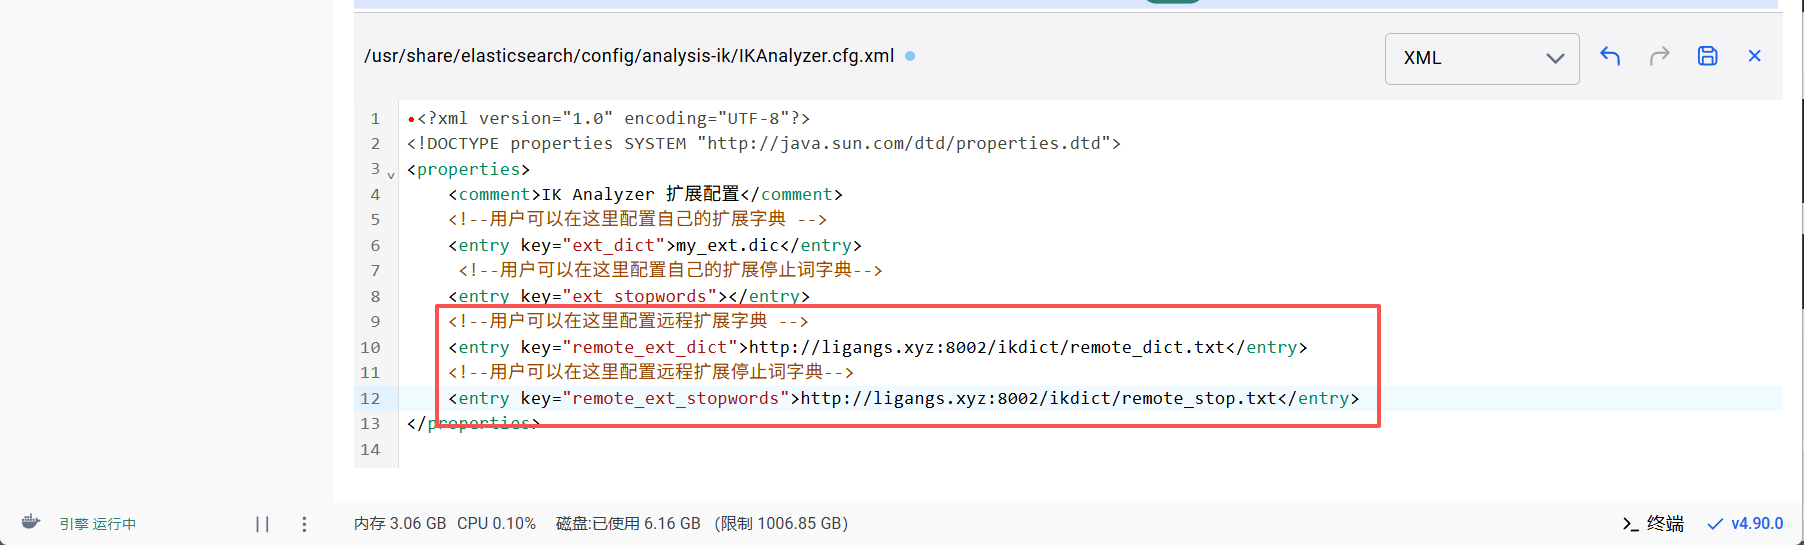
保存后重启一次es,后续只要远程文件有改动,词库会自动更新。
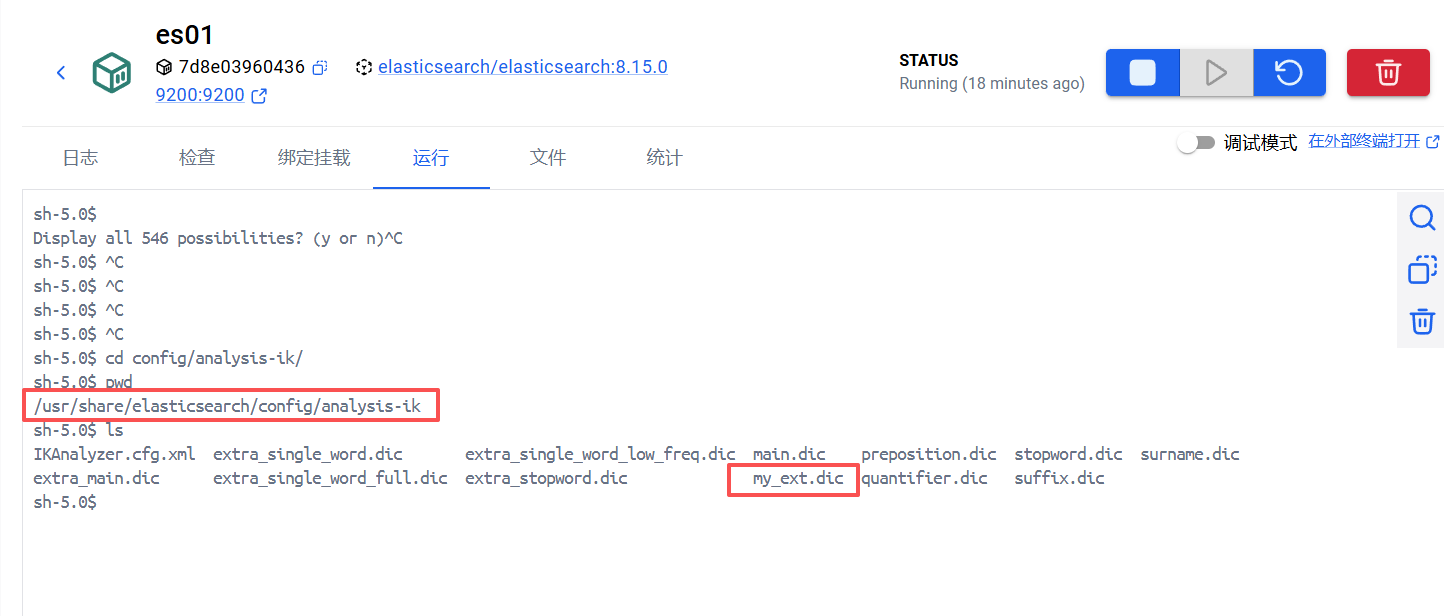
4、验证
添加远程词库前:
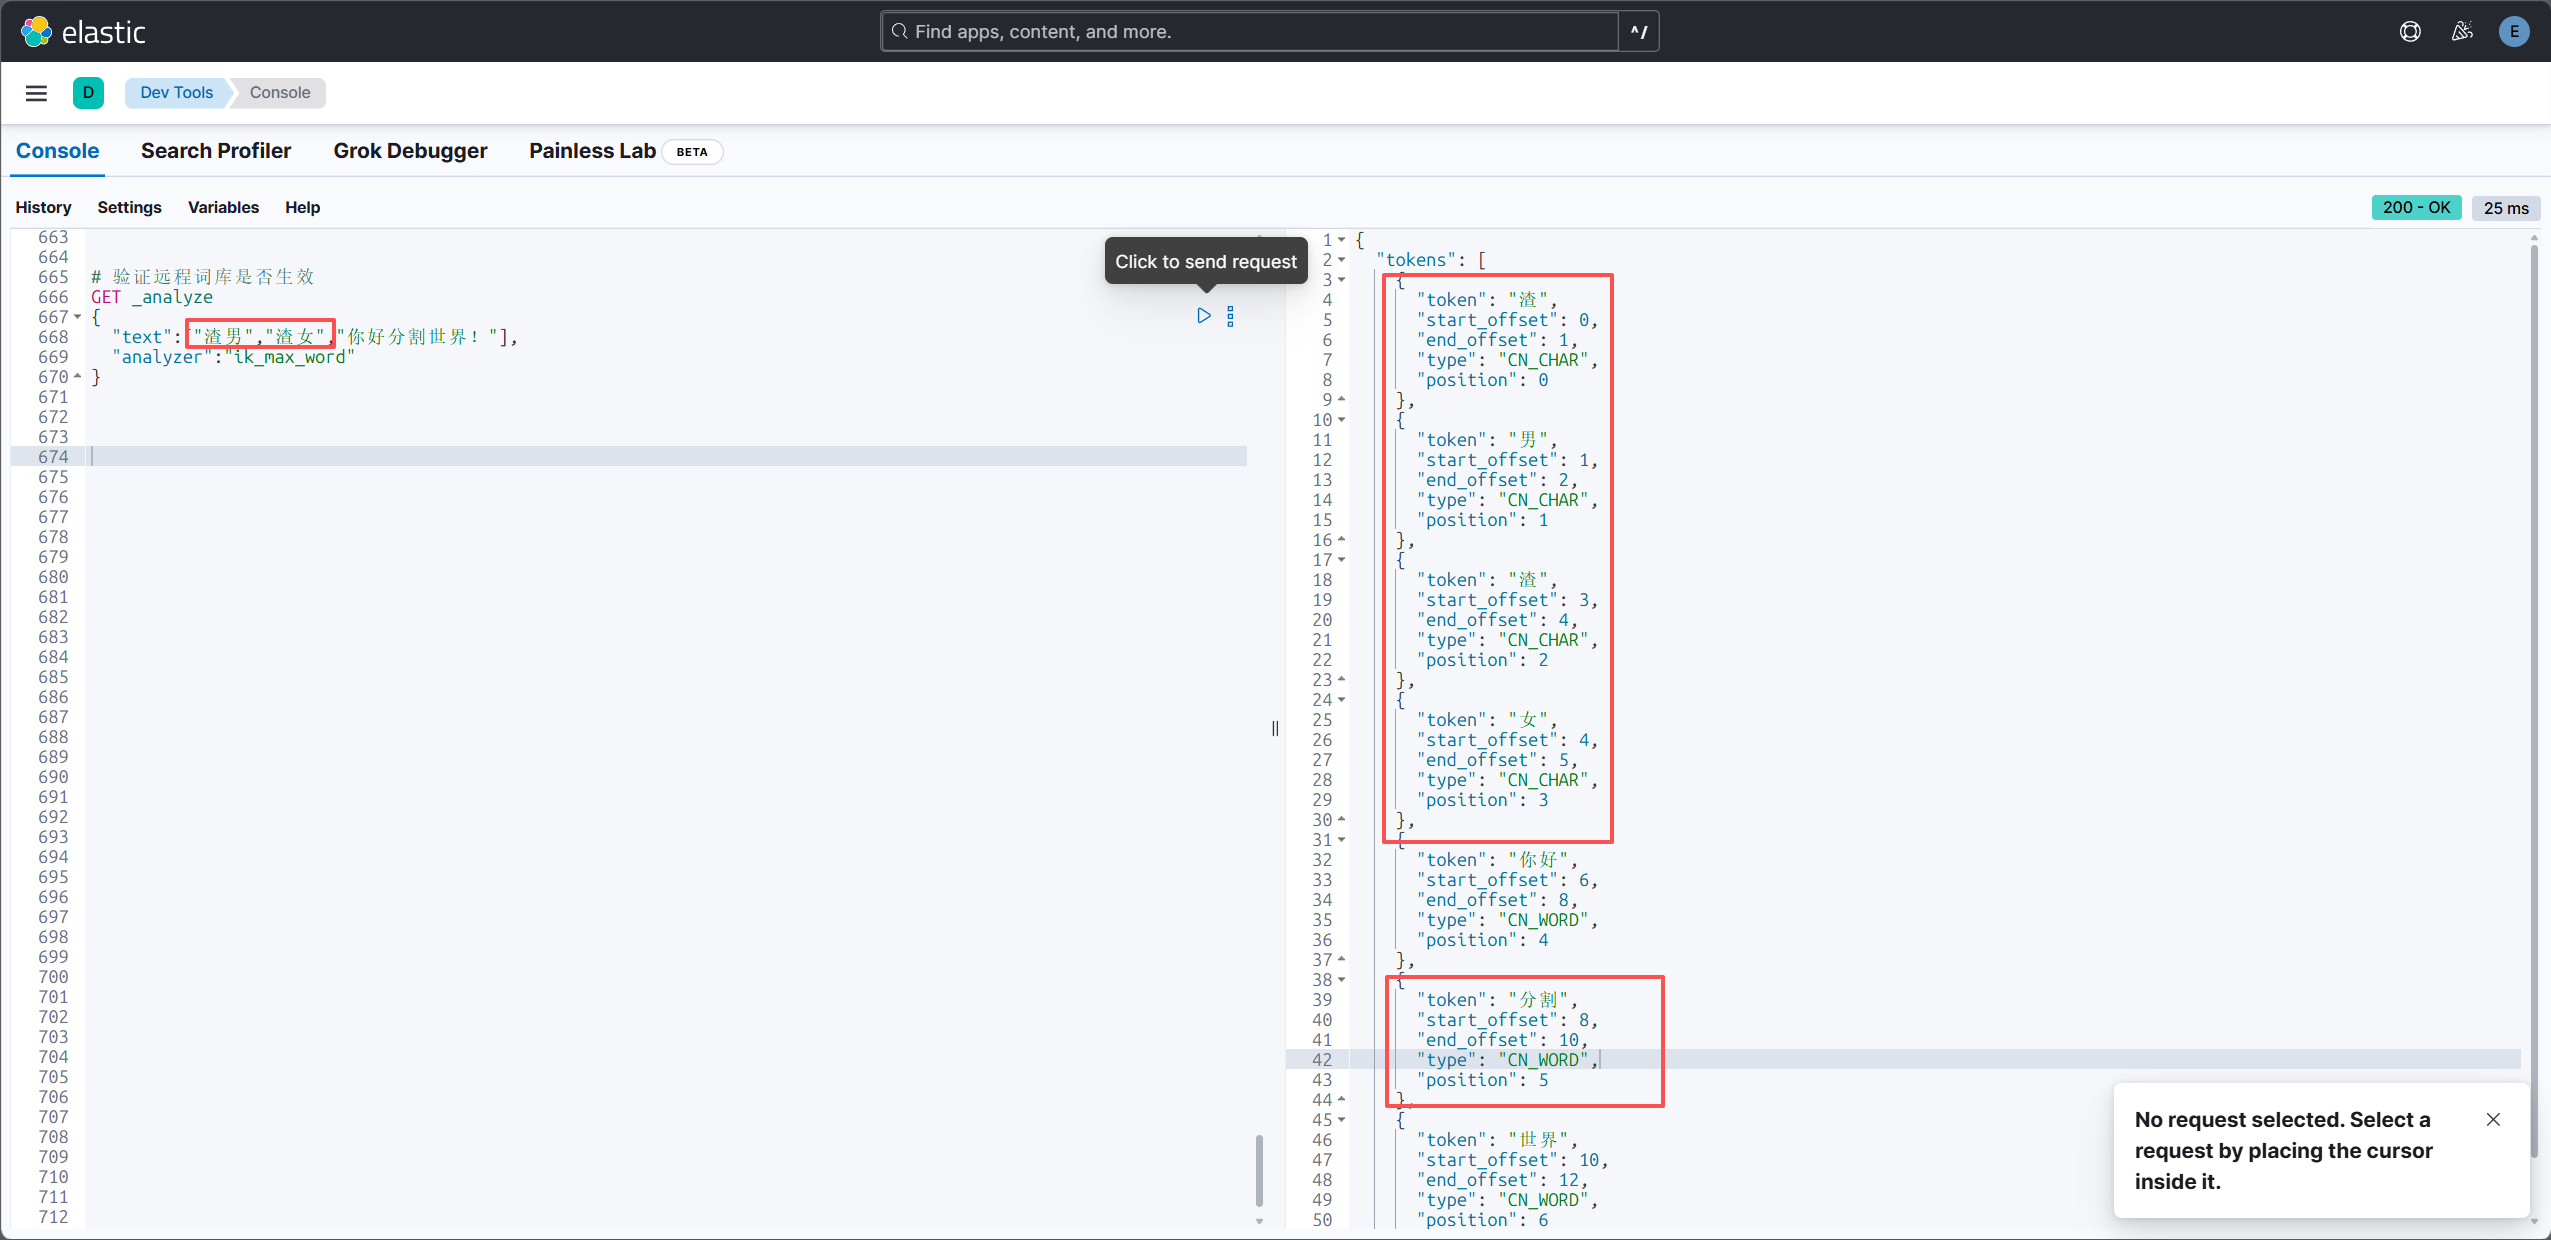
词库生效前,'渣男'、'渣女'被单独拆分,'分割'也被识别为了词条。
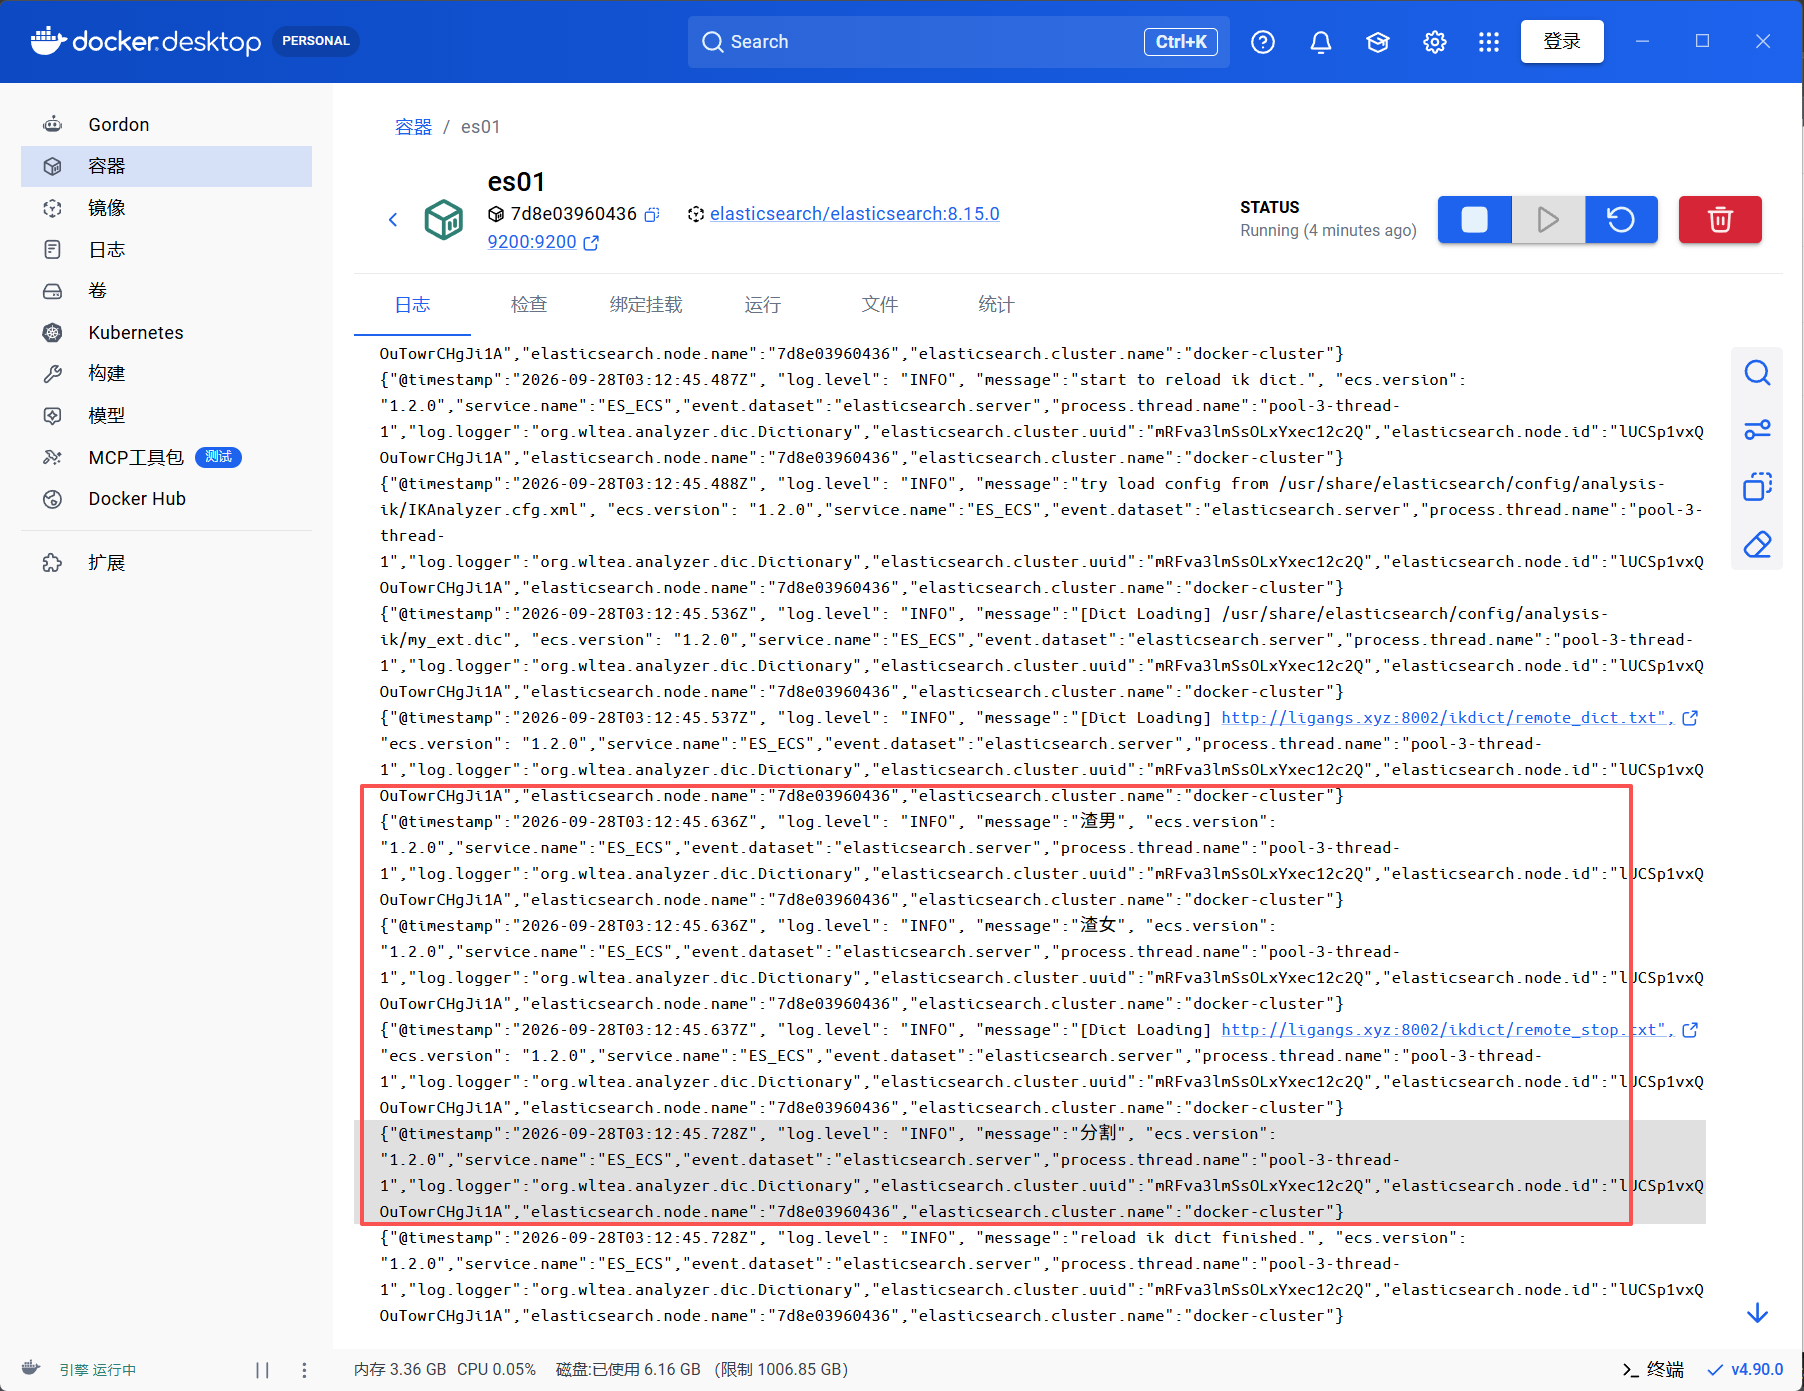
当检测到远程文件变动时,es会重新加载文件,控制台有日志打印:
生效后: