最近工作中需要将扫描的pdf文件转换为Markdown格式,方便后续项目复用相同的合同文本信息,而且Markdown格式更方便大家及大模型解读,因此就做了这个转换工具,主要支持三种:直接提取文本、通过OCR提取文本、提取pdf中的文本和图像、去除页眉页脚后的文本提取等。其他类型的转换工具详见之前文章。主要内容如下,供参考。
一、主要功能
主要实现将pdf格式的文本内容完整提取出来, 包括直接提取文本、通过OCR提取文本、提取pdf中的文本和图像、去除页眉页脚后的文本提取等。
具体支持:
1.通过PyMuPDF实现PDF转Markdown
pdf_to_markdown_with_images() - 基于pymupdf实现PDF转Markdown,包含图像提取功能,按照原文顺序保存文本和图像
2.通过OCR提取文本,实现了文本提取的功能增强,具体如下:
pdf_ocr_extract() - 基于Tesseract OCR提取PDF文本
pdf_to_markdown_ocr() - OCR转换PDF为Markdown,支持页眉页脚裁剪
pdf_extract_smart() - 智能提取:自动判断是否需要OCR
pdf_compare_extraction() - 对比直接提取与OCR结果
_remove_chinese_spaces() - 后处理:去除中文字符间多余空格 __
二、实现效果
原始pdf部分截图
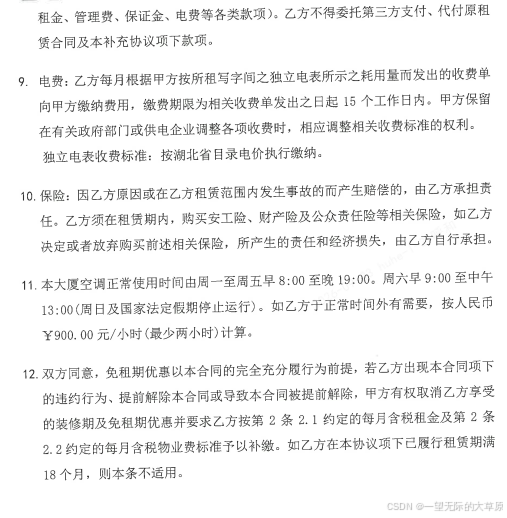
转换后的Markdown文本
租金、管理费、保证金、电费等各类款项 )。乙方不得委托第三方支付、代付原租赁合同及本补充协议项下款项。

9, 电费 : 乙方每月根据甲方按所租写字间之独立电表所示之耗用量而发出的收费单向甲方缴纳费用 , 缴费期限为相关收费单发出之日起 15 个工作日内。甲方保留在有关政府部门或供电企业调整各项收费时 , 相应谋整相关收费标准的权利。 ---
独立电表收费标准 : 按湖北省目录电价执行缴纳。

10. 保险 : 因乙方原回或在乙方租赁范围内发生事故的而产生赔修的 , 由乙方承担责任。乙方须在租贩期内 , 购买安工险、财产险及公众责任险等相关保险 , 如乙方
决定或者放弃购买前述相关保险 , 所产生的责任和经济损失 , 由乙方自行承担。

11 本大厦空调正常使用时间由周一至周五早 8:00 至晚 19:00。周六早 9:00 至中午
13:00 ( 周日及国家法定假期停止运行 ) 。如乙方于正常时间外有需要 , 按人民币¥ 900. 00 元 / 小时 ( 最少两小时 ) 计算。

12. 双方同意 , 免租期优惠以本合同的完全充分履行为前提 , 若乙方出现本合同项下
的违约行为、提前解除本合同或导致本各同被提前解除 , 甲方有权取消乙方享受
的装修期及免租期优惠并要求乙方按第 2 条 2. 1 约定的每月含税租金及第 2 条
2.2 约定的每月含税物业费标准予以补缴。如乙方在本协议项下已履行租赁期满
18 个月 , 则本条不适用。
三、核心代码
python
#!/root/anaconda3/envs/llm/bin/python
# -*- coding: utf-8 -*-
import fitz # PyMuPDF
import pymupdf4llm
import pathlib
import pytesseract
from PIL import Image
import io, argparse
# 基于PyMuPDF提取PDF标题
def extract_title_from_pdf(file_path):
doc = fitz.open(file_path)
# metadata = doc.metadata
# title = metadata.get('title', 'No Title Found') # return title page = doc[0]
blocks = page.get_text("dict")["blocks"]
for block in blocks:
if block["type"] == 0: # 文本块
for line in block["lines"]:
for span in line["spans"]:
# 获取格式信息
font_size = span["size"] # 字体大小
font_flags = span["flags"] # 样式标志(加粗、斜体等)
font_name = span["font"] # 字体名称
text = span["text"] # 文本内容
# 判断是否可能是标题
if font_size > 12 and font_flags & 2 ** 4: # 字号大且加粗
print(f"可能的标题: {text}")
return blocks
# 基于Tesseract OCR提取PDF文本
def pdf_ocr_extract(pdf_path, lang='chi_sim+eng', zoom=2, pages=None):
"""
基于Tesseract OCR提取PDF中的文本,适用于扫描版PDF或直接提取文本不准确的情况
参数:
pdf_path: PDF文件路径
lang: OCR语言,默认中文简体+英文,可选 'chi_sim'(简体中文), 'chi_tra'(繁体中文), 'eng'(英文)
zoom: 页面渲染缩放比例,值越大图像越清晰但处理越慢,默认2
pages: 要处理的页码列表(从0开始),None表示处理所有页
返回:
按页组织的文本列表,每个元素为(页码, 文本内容)元组
""" doc = fitz.open(pdf_path)
results = []
page_indices = pages if pages is not None else range(doc.page_count)
for page_num in page_indices:
page = doc[page_num]
# 将页面渲染为图片
pix = page.get_pixmap(matrix=fitz.Matrix(zoom, zoom))
# 转换为PIL Image
img_data = pix.tobytes("png")
img = Image.open(io.BytesIO(img_data))
# OCR识别
text = pytesseract.image_to_string(img, lang=lang)
# 后处理:去除中文字符间的多余空格
text = _remove_chinese_spaces(text)
results.append((page_num, text.strip()))
print(f"OCR处理第 {page_num + 1} 页完成,识别字符数: {len(text)}")
doc.close()
return results
# 后处理:去除中文字符间多余空格
def _remove_chinese_spaces(text):
"""
去除中文字符之间的多余空格,保留英文单词间的空格
""" import re
# 匹配中文字符(包括标点)之间的空格
# 模式:中文字符 + 空格 + 中文字符
result = re.sub(r'([\u4e00-\u9fff\u3000-\u303f\uff00-\uffef])\s+([\u4e00-\u9fff\u3000-\u303f\uff00-\uffef])', r'\1\2', text)
# 多次处理直到没有变化
while result != text:
text = result
result = re.sub(r'([\u4e00-\u9fff\u3000-\u303f\uff00-\uffef])\s+([\u4e00-\u9fff\u3000-\u303f\uff00-\uffef])', r'\1\2', text)
return result
# 对比直接提取与OCR结果
def pdf_compare_extraction(pdf_path, lang='chi_sim+eng', zoom=2):
"""
对比直接提取和OCR提取的结果,帮助选择最佳方案
参数:
pdf_path: PDF文件路径
lang: OCR语言
zoom: OCR渲染缩放
返回:
dict: 包含direct_text(直接提取)和ocr_text(OCR识别)的对比结果
""" doc = fitz.open(pdf_path)
print("=" * 60)
print("PDF文本提取对比分析")
print("=" * 60)
# 直接提取
direct_texts = []
for page_num in range(doc.page_count):
page = doc[page_num]
text = page.get_text("text").strip()
direct_texts.append((page_num, text))
# OCR提取
ocr_texts = pdf_ocr_extract(pdf_path, lang, zoom)
doc.close()
# 统计对比
direct_total = sum(len(t) for _, t in direct_texts)
ocr_total = sum(len(t) for _, t in ocr_texts)
print(f"\n直接提取总字符数: {direct_total}")
print(f"OCR识别总字符数: {ocr_total}")
# 显示第一页对比
if direct_texts and ocr_texts:
print("\n" + "=" * 60)
print("第一页对比预览")
print("=" * 60)
print("\n【直接提取】:")
print(direct_texts[0][1][:300] + "..." if len(direct_texts[0][1]) > 300 else direct_texts[0][1])
print("\n【OCR识别】:")
print(ocr_texts[0][1][:300] + "..." if len(ocr_texts[0][1]) > 300 else ocr_texts[0][1])
return {
"direct_text": direct_texts,
"ocr_text": ocr_texts,
"direct_total": direct_total,
"ocr_total": ocr_total
}
# OCR转换PDF为Markdown,支持页眉页脚裁剪
def pdf_to_markdown_ocr(pdf_path, output_md_path, lang='chi_sim+eng', zoom=2, header_ratio=0.08, footer_ratio=0.08):
"""
基于OCR将PDF转换为Markdown,支持页眉页脚裁剪
参数:
pdf_path: PDF文件路径
output_md_path: 输出的Markdown文件路径
lang: OCR语言
zoom: 渲染缩放比例
header_ratio: 页眉占比(从顶部裁剪)
footer_ratio: 页脚占比(从底部裁剪)
""" doc = fitz.open(pdf_path)
markdown_content = []
for page_num in range(doc.page_count):
page = doc[page_num]
page_height = page.rect.height
page_width = page.rect.width
# 计算裁剪区域
clip_rect = fitz.Rect(
0,
header_ratio * page_height,
page_width,
(1 - footer_ratio) * page_height
)
# 渲染裁剪后的区域
pix = page.get_pixmap(matrix=fitz.Matrix(zoom, zoom), clip=clip_rect)
img_data = pix.tobytes("png")
img = Image.open(io.BytesIO(img_data))
# OCR识别
text = pytesseract.image_to_string(img, lang=lang)
# 后处理:去除中文字符间的多余空格
text = _remove_chinese_spaces(text)
# 添加页面分隔
if page_num > 0:
markdown_content.append(f"\n\n---\n\n")
markdown_content.append(f"## 第 {page_num + 1} 页\n\n")
markdown_content.append(text.strip())
print(f"OCR处理第 {page_num + 1}/{doc.page_count} 页")
doc.close()
# 保存Markdown文件
output_path = pathlib.Path(output_md_path)
output_path.write_text('\n'.join(markdown_content), encoding='utf-8')
print(f"\n✅ OCR识别完成,Markdown文件已保存: {output_path.absolute()}")
return '\n'.join(markdown_content)
# 智能提取:自动判断是否需要OCR
def pdf_extract_smart(pdf_path, output_md_path=None, lang='chi_sim+eng', zoom=2, use_ocr_fallback=True):
"""
智能PDF文本提取:优先直接提取文本,若文本量过少则自动使用OCR
参数:
pdf_path: PDF文件路径
output_md_path: 输出Markdown路径,None则自动生成
lang: OCR语言
zoom: OCR渲染缩放
use_ocr_fallback: 当直接提取文本量少于阈值时是否使用OCR补充
""" doc = fitz.open(pdf_path)
total_direct_text = 0
pages_need_ocr = []
# 第一遍:直接提取文本,统计每页文本量
page_texts = []
for page_num in range(doc.page_count):
page = doc[page_num]
text = page.get_text("text").strip()
page_texts.append(text)
total_direct_text += len(text)
# 如果该页文本量很少,可能需要OCR
if len(text) < 100: # 阈值:少于100字符
pages_need_ocr.append(page_num)
doc.close()
print(f"直接提取总字符数: {total_direct_text}")
print(f"需要OCR补充的页面: {[p+1 for p in pages_need_ocr]}")
# 判断是否需要OCR
avg_text_per_page = total_direct_text / len(page_texts) if page_texts else 0
if avg_text_per_page < 200 or len(pages_need_ocr) > len(page_texts) * 0.3:
# 平均每页少于200字符,或超过30%的页需要OCR,则全部使用OCR
print("检测到文本量较少,使用OCR进行完整识别...")
if output_md_path is None:
output_md_path = pathlib.Path(pdf_path).with_suffix('.ocr.md')
return pdf_to_markdown_ocr(pdf_path, output_md_path, lang, zoom)
elif use_ocr_fallback and pages_need_ocr:
# 只对需要OCR的页面进行补充识别
print(f"对 {len(pages_need_ocr)} 页进行OCR补充识别...")
ocr_results = pdf_ocr_extract(pdf_path, lang, zoom, pages_need_ocr)
ocr_dict = {p: t for p, t in ocr_results}
# 合并结果
markdown_content = []
for page_num, direct_text in enumerate(page_texts):
if page_num > 0:
markdown_content.append(f"\n\n---\n\n")
markdown_content.append(f"## 第 {page_num + 1} 页\n\n")
# 优先使用直接提取的文本,若太少则用OCR结果
if len(direct_text) >= 100:
markdown_content.append(direct_text)
else:
markdown_content.append(ocr_dict.get(page_num, direct_text))
if output_md_path is None:
output_md_path = pathlib.Path(pdf_path).with_suffix('.smart.md')
output_path = pathlib.Path(output_md_path)
output_path.write_text('\n'.join(markdown_content), encoding='utf-8')
print(f"\n✅ 智能提取完成,Markdown文件已保存: {output_path.absolute()}")
return '\n'.join(markdown_content)
else:
# 直接提取足够,无需OCR
print("直接提取文本量充足,无需OCR。")
if output_md_path is None:
output_md_path = pathlib.Path(pdf_path).with_suffix('.md')
markdown_content = []
for page_num, text in enumerate(page_texts):
if page_num > 0:
markdown_content.append(f"\n\n---\n\n")
markdown_content.append(f"## 第 {page_num + 1} 页\n\n")
markdown_content.append(text)
output_path = pathlib.Path(output_md_path)
output_path.write_text('\n'.join(markdown_content), encoding='utf-8')
print(f"\n✅ 文本提取完成,Markdown文件已保存: {output_path.absolute()}")
return '\n'.join(markdown_content)
# 基于pymupdf4llm实现PDF转Markdown,包含图像提取功能,按照原文顺序保存文本和图像
def pdf_to_markdown_with_images(pdf_path, output_md_path, image_folder="images"):
"""
将 PDF 转换为 Markdown,文本和图像按原顺序保存,图像以外部文件关联
参数:
pdf_path: PDF 文件路径
output_md_path: 输出的 Markdown 文件路径
image_folder: 图像存储文件夹名称
""" # 创建图像存储文件夹
# sys.path.append("../") # 将当前目录加载道path中
image_path = pathlib.Path(image_folder)
image_path.mkdir(exist_ok=True)
# 去掉页眉页脚方法,结合PyMuPDF获取页面大小
# 打开PDF获取页面尺寸
doc = fitz.open(pdf_path)
page = doc[0]
# 获取页面尺寸
# page_width = page.rect.width
page_height = page.rect.height
header_ratio = 0.08
footer_ratio = 0.08
# 计算裁剪区域(排除页眉页脚)
topClip=header_ratio * page_height
bottomClip=footer_ratio * page_height
# 提取 PDF 内容,包含图像
# write_images=True: 将图像保存为外部文件
# image_path: 指定图像保存文件夹
# image_format: 选择图像格式(png/jpg)
# dpi: 设置图像分辨率,默认150
# margins:裁剪页眉页脚,(上, 下) 或者 (左, 上, 右, 下)
md_content = pymupdf4llm.to_markdown(
doc=pdf_path,
margins=(topClip,bottomClip), # 方法:去掉页眉页脚,(上, 下)
write_images=True, # 关键:将图像写入文件而非嵌入
image_path=str(image_path), # 图像保存路径
image_format="png", # 图像格式
dpi=200 # 分辨率,越高越清晰但文件越大
)
# 保存 Markdown 文件(UTF-8 编码)
output_path = pathlib.Path(output_md_path)
output_path.write_bytes(md_content.encode('utf-8'))
print(f"✅ Markdown 文件已保存: {output_path.absolute()}")
print(f"✅ 图像文件已保存至: {image_path.absolute()}")
print(f"✅ 共提取 {md_content.count('} 张图像")
return md_content
# 使用示例
if __name__ == "__main__":
parser = argparse.ArgumentParser(description='PDF文本提取与OCR识别工具')
parser.add_argument('pdf_path', nargs='?', help='PDF文件路径')
parser.add_argument('-o', '--output', help='输出Markdown文件路径')
parser.add_argument('-m', '--mode', choices=['smart', 'ocr', 'direct', 'compare'], default='smart',
help='提取模式: smart(智能), ocr(强制OCR), direct(直接提取), compare(对比)')
parser.add_argument('-l', '--lang', default='chi_sim+eng', help='OCR语言,默认chi_sim+eng')
parser.add_argument('-z', '--zoom', type=float, default=2, help='OCR渲染缩放比例,默认2')
args = parser.parse_args()
# 如果没有提供参数,使用测试文件
if args.pdf_path is None:
test_pdf = pathlib.Path(__file__).parent / 'data' / 'temp.pdf'
output_md = pathlib.Path(__file__).parent / 'data' / 'temp_ocr.md'
print("=" * 60)
print("PDF OCR文本识别测试")
print("=" * 60)
print(f"测试文件: {test_pdf}")
print(f"输出文件: {output_md}")
print()
# 默认使用对比模式展示效果
result = pdf_compare_extraction(str(test_pdf), args.lang, args.zoom)
# 同时保存OCR结果
print("\n" + "=" * 60)
print("保存OCR识别结果到文件")
print("=" * 60)
ocr_content = []
for page_num, text in result["ocr_text"]:
if page_num > 0:
ocr_content.append("\n\n---\n\n")
ocr_content.append(f"## 第 {page_num + 1} 页\n\n")
ocr_content.append(text)
pathlib.Path(output_md).write_text('\n'.join(ocr_content), encoding='utf-8')
print(f"✅ 已保存: {output_md}")
else:
pdf_path = pathlib.Path(args.pdf_path)
output_md = args.output if args.output else pdf_path.with_suffix('.md')
if args.mode == 'compare':
pdf_compare_extraction(str(pdf_path), args.lang, args.zoom)
elif args.mode == 'ocr':
pdf_to_markdown_ocr(str(pdf_path), str(output_md), args.lang, args.zoom)
elif args.mode == 'direct':
# 方式1: 仅提取文本
doc = fitz.open(str(pdf_path))
content = []
for page_num in range(doc.page_count):
if page_num > 0:
content.append("\n\n---\n\n")
content.append(f"## 第 {page_num + 1} 页\n\n")
content.append(doc[page_num].get_text("text"))
doc.close()
pathlib.Path(output_md).write_text('\n'.join(content), encoding='utf-8')
print(f"✅ 直接提取完成: {output_md}")
# # 方式2: 文本和图像都提取
# pdf_to_markdown_with_images(str(pdf_path), str(output_md))
else: # smart
pdf_extract_smart(str(pdf_path), str(output_md), args.lang, args.zoom)