PP-OCRv6是飞桨最新开源的轻量化高精度OCR模型,相比v5版本,在小目标文本、倾斜文本、模糊文本检测场景精度大幅提升,且推理速度更快、适配端侧部署。官方预训练模型适配通用场景,但在票据、证件、工业铭牌、手写文本、特殊版式文档等垂直场景检测效果较差。
本文将手把手带你完成 PP-OCRv6文本检测模型自定义数据集微调全流程,包含环境搭建、数据集标注与划分、配置文件修改、模型微调训练、模型评估、推理测试、模型导出,同时整理实操高频踩坑问题,全程代码开源、可直接复制运行,零基础也能轻松上手。
✅ 适用场景:垂直场景文本检测、自定义版式OCR优化、学术实验、项目落地微调
✅ 环境适配:Linux/Windows、GPU/CPU训练
✅ 核心收获:掌握PP-OCRv6微调逻辑、自定义数据集规范、模型调优技巧
一、前置知识与环境准备
1.1 PP-OCRv6检测模型优势
PP-OCRv6文本检测模块基于DB算法优化,针对产业落地痛点做了针对性升级:
- 优化小尺寸文本、密集文本检测能力,误检、漏检率大幅降低
- 增强倾斜、畸变、模糊文本的鲁棒性
- 轻量化结构,兼顾精度与速度,支持服务器、移动端、嵌入式设备部署
- 完整支持自定义数据集微调、增量训练,适配各类垂直场景
1.2 环境配置(精准适配版)
推荐使用Python3.10(兼容性最佳,规避高版本库适配问题),基于PaddlePaddle框架搭建环境。
1、创建虚拟环境
bash
# 创建虚拟环境
conda create -n ppocrv6 python=3.10 -y
bash
# 激活环境
conda activate ppocrv6
2、安装Paddle核心框架
根据自己CUDA版本安装GPU版本,无GPU可安装CPU版本:
bash
# GPU版本(推荐,CUDA11.7示例)
pip install paddlepaddle-gpu==2.6.0.post117 -f https://www.paddlepaddle.org.cn/whl/linux/mkl/avx/stable.html

# CPU版本(仅测试使用)
pip install paddlepaddle==2.6.0
3、克隆PaddleOCR源码并安装依赖
bash
# 克隆最新PaddleOCR源码(包含PP-OCRv6完整配置)
git clone https://github.com/PaddlePaddle/PaddleOCR.git
cd PaddleOCR

# 安装全部依赖
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
4、环境验证
bash
import paddle
import paddleocr
# 输出版本信息,无报错即环境搭建成功
print(paddle.__version__)
print("PaddleOCR环境就绪")
二、自定义数据集制作(规范核心)
数据集质量直接决定微调效果,PP-OCR检测任务有固定的数据格式要求,必须严格遵循官方标注规范,否则训练报错、精度异常。
2.1 数据集基本要求
- 数据量:垂直场景建议至少500张图片,复杂场景建议1000+,数据越多泛化性越好
- 图像格式:支持jpg、png、jpeg,建议统一jpg格式
- 标注规范:仅标注需要检测的文本区域,标注框贴合文本边缘,不冗余、不缺失,倾斜文本跟随文本角度标注
- 训练测试划分:默认9:1划分训练集、验证集
2.2 数据集标注工具(PPOCRLabel)
推荐使用官方开源半自动化标注工具 PPOCRLabel,一键导出PaddleOCR检测任务专属标签格式,无需手动转换。
1、安装PPOCRLabel
bash
pip install PPOCRLabel==v3.1.6 -i https://pypi.tuna.tsinghua.edu.cn/simple2、启动标注工具
bash
PPOCRLabel3、标注与导出规则
打开图片后框选文本区域,完成批量标注后,选择导出检测标签,最终生成标准数据集结构:
bash
custom_det_data/
├── images/          # 所有训练图片存放目录
│   ├── 001.jpg
│   ├── 002.jpg
│   └── ...
├── train.txt     # 训练集检测标签文件
└── val.txt       # 验证集检测标签文件
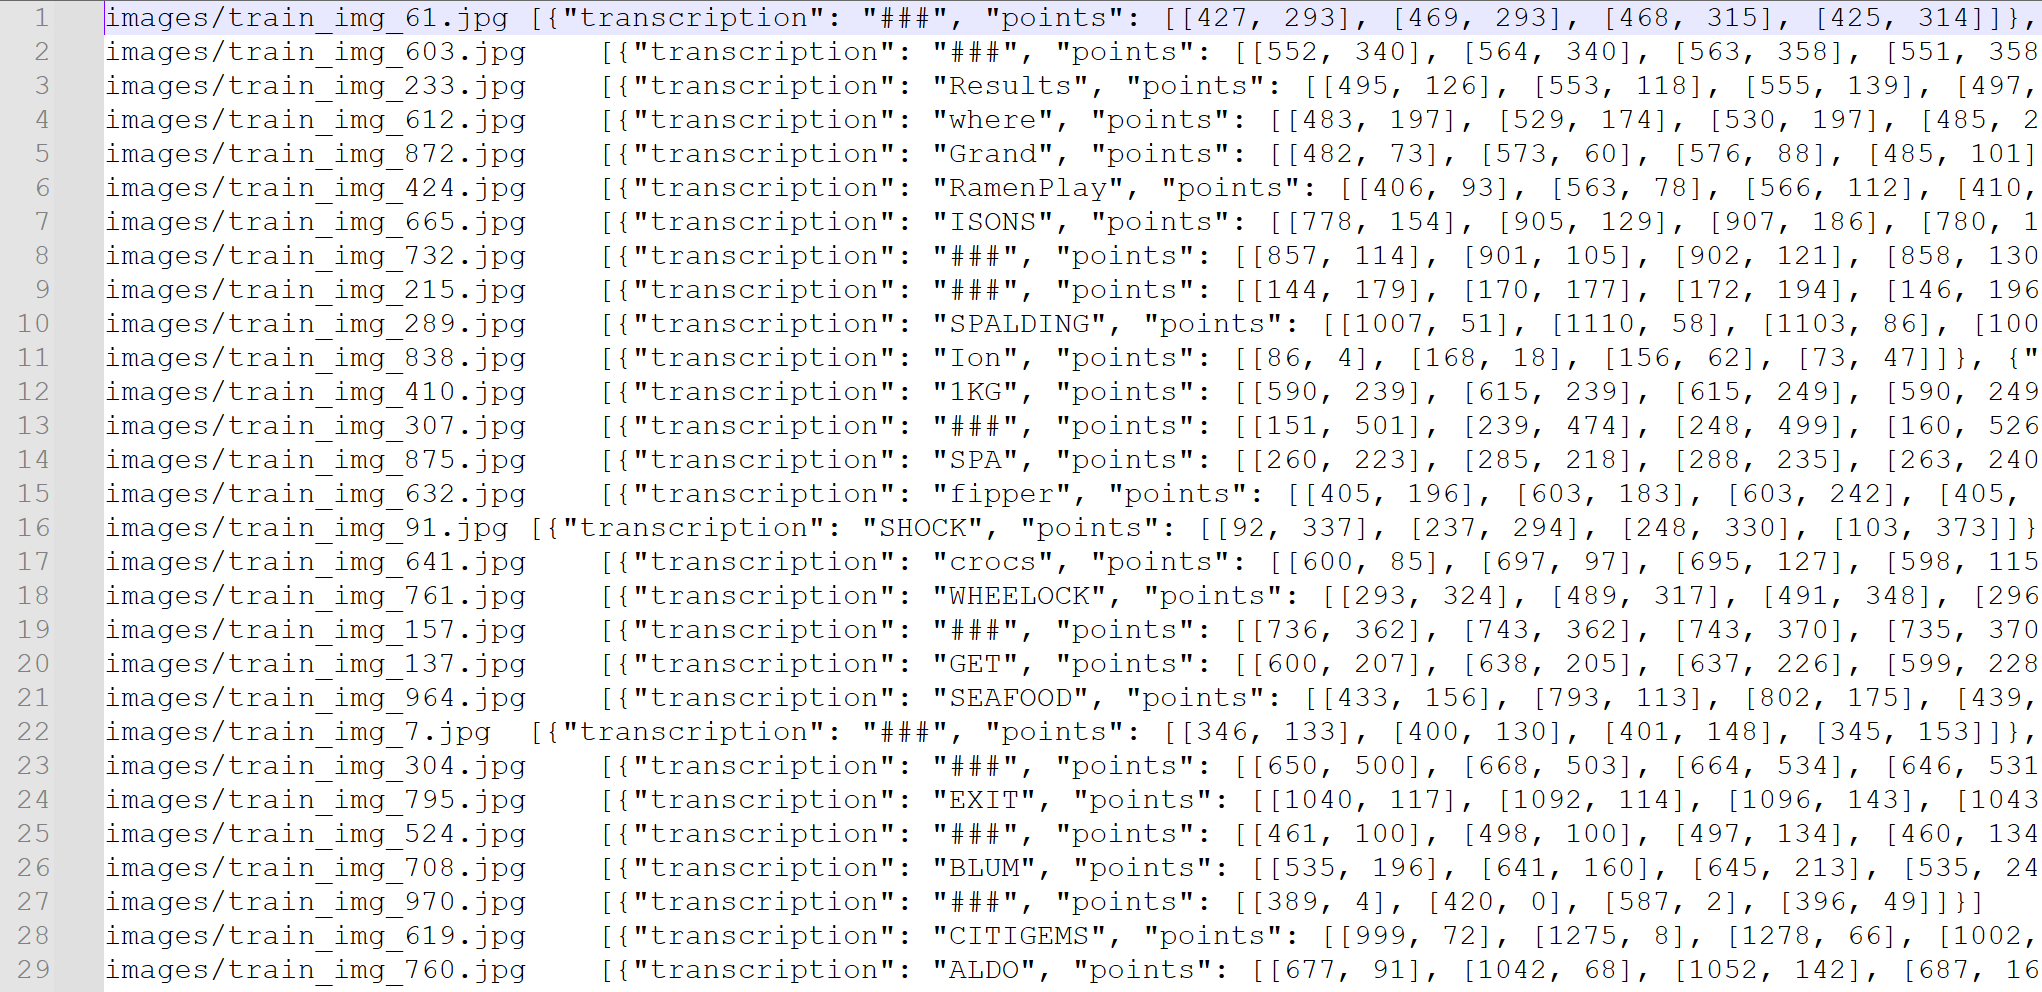
train.txt格式说明:每行对应一张图片,格式为图片路径 标注框坐标+标注信息,工具自动生成,无需手动修改。
2.3 数据集自动划分(训练集/验证集)
编写Python脚本自动划分数据集,生成train.txt、val.txt,规避手动划分的繁琐操作:
bash
import random

# 读取全局标签文件
with open("custom_det_data/Label.txt", "r", encoding="utf-8") as f:
    data = f.readlines()

# 9:1划分训练集、验证集
train_ratio = 0.9
train_num = int(len(data) * train_ratio)
train_list = random.sample(data, train_num)
val_list = [x for x in data if x not in train_list]

# 写入训练集标签
with open("custom_det_data/train.txt", "w", encoding="utf-8") as f:
    f.writelines(train_list)

# 写入验证集标签
with open("custom_det_data/val.txt", "w", encoding="utf-8") as f:
    f.writelines(val_list)

print(f"训练集数量:{len(train_list)},验证集数量:{len(val_list)}")
三、修改PP-OCRv6微调配置文件
PaddleOCR为PP-OCRv6检测模型提供了专属微调配置文件,路径:configs/det/PP-OCRv6/PP-OCRv6_medium_det.yml,我们只需针对性修改即可。
3.1 核心配置修改
打开配置文件,依次修改以下4个核心模块:
提前将预训练权重下载:PP-OCRv6_medium_det_pretrained.pdparams
1、全局配置(预训练权重、保存路径)
bash
Global:
  use_gpu: true          # 有GPU设为true,CPU设为false
  epoch_num: 100         # 迭代轮次,自定义数据集建议50-100轮
  log_smooth_window: 20
  print_batch_step: 10
  save_epoch_step: 5     # 每5轮保存一次模型
  eval_batch_step: 100
  pretrained_model: PP-OCRv6_medium_det_pretrained.pdparams  # v6预训练权重
  save_dir: ./output/ppocrv6_det_finetune  # 模型保存路径
2、数据集路径配置(重点!)
bash
Train:
  dataset:
    name: DBDataSet
    data_dir: ./custom_det_data  # 数据集根目录
    label_file_list: ["./custom_det_data/train.txt"]  # 训练集标签
  loader:
    batch_size_per_card: 8  # 根据显存调整,16G显存可设16
    shuffle: true

Eval:
  dataset:
    name: DBDataSet
    data_dir: ./custom_det_data  # 数据集根目录
    label_file_list: ["./custom_det_data/val.txt"]  # 验证集标签
  loader:
    batch_size_per_card: 8
    shuffle: false
3、学习率配置(微调关键)
微调不建议使用过大学习率,避免破坏预训练权重特征,推荐小学习率微调:
bash
Optimizer:
  name: Adam
  lr:
    name: Cosine
    learning_rate: 0.001  # 微调推荐0.0005-0.001
    warmup_epoch: 5
3.2 配置优化建议
- 小数据集:降低batch_size、减小学习率,增加warmup轮次,防止过拟合
- 大数据集:适当提升batch_size,加快收敛速度
- 复杂场景:调高epoch_num,充分训练模型
四、启动模型微调训练
4.1 训练命令(一键启动)
在PaddleOCR根目录下执行以下命令,开启微调训练:
bash
python tools/train.py \
-c configs/det/PP-OCRv6/det_PP-OCRv6.yml \
-o Global.use_gpu=true
如果一些参数没有在配置文件进行配置,也可以通过训练指令进行指定:
bash
python tools/train.py -c configs/det/PP-OCRv6/PP-OCRv6_medium_det.yml -o Global.pretrained_model=./PP-OCRv6_medium_det_pretrained.pdparams Train.dataset.data_dir=./ocr_det_dataset_examples Train.dataset.label_file_list=[./ocr_det_dataset_examples/train.txt] Eval.dataset.data_dir=./ocr_det_dataset_examples Eval.dataset.label_file_list=[./ocr_det_dataset_examples/val.txt]五、模型评估与推理测试
5.1 模型指标评估
训练完成后,在验证集上评估模型精度,输出精确率、召回率、F1值:
bash
python tools/eval.py \
-c configs/det/PP-OCRv6/det_PP-OCRv6.yml \
-o Global.pretrained_model=./output/ppocrv6_det_finetune/best_model
5.2 单图推理测试
编写测试脚本,验证微调后模型的实际检测效果:
bash
from paddleocr import PaddleOCR, draw_det_res
import cv2

# 加载微调后的最优检测模型
ocr = PaddleOCR(
    det_model_dir="./output/ppocrv6_det_finetune/best_model",
    use_angle_cls=False,
    use_gpu=True
)

# 测试图片推理
img_path = "test.jpg"
result = ocr.det(img_path)

# 绘制检测结果并保存
img = cv2.imread(img_path)
img_draw = draw_det_res(img, result)
cv2.imwrite("det_result.jpg", img_draw)
print("检测完成,结果已保存为det_result.jpg")
print("检测文本框坐标:", result)
六、模型导出(用于部署)
训练保存的是训练权重,无法直接用于工程部署,需导出为推理模型(pdmodel、pdiparams格式):
bash
python tools/export_model.py \
-c configs/det/PP-OCRv6/det_PP-OCRv6.yml \
-o Global.pretrained_model=./output/ppocrv6_det_finetune/best_model \
Global.save_inference_dir=./inference/ppocrv6_det_finetune
导出完成后,inference/ppocrv6_det_finetune目录下即为可部署的推理模型,支持Python、C++、ONNX、端侧部署。
七、高频踩坑避坑指南(实操总结)
整理微调过程中90%用户会遇到的问题,一次性解决:
坑1:训练报错标签文件路径不存在
✅ 解决方案:配置文件中 data_dir + 标签内图片相对路径必须真实有效,路径不要包含中文、空格、特殊符号。
坑2:训练loss不下降、精度为0
✅ 解决方案:1、检查标注格式是否规范,是否存在空标注、错误标注;2、降低学习率,微调不适合大学习率;3、检查数据集划分是否有效。
坑3:GPU显存不足报错
✅ 解决方案:降低配置文件中 batch_size_per_card,8G显存设为4,4G显存设为2。
坑4:微调后通用场景效果变差
✅ 解决方案:属于正常现象,微调是场景适配优化,垂直场景精度提升的同时,通用场景泛化性会轻微下降,如需兼顾可增加混合数据集训练。
坑5:导出模型推理速度异常
✅ 解决方案:务必使用best_model最优模型导出,不要使用epoch阶段性模型。
八、微调优化进阶技巧
- 数据增强:添加随机裁剪、翻转、缩放、模糊增强,提升模型泛化能力,适配复杂场景
- 学习率调度:使用余弦退火学习率,后期降低学习率精细调优,提升精度
- 早停策略:监控验证集F1值,连续10轮无提升自动停止训练,防止过拟合
- 增量训练:在已有微调模型基础上添加新数据续训,无需重新训练,节省算力
九、总结
本文完整讲解了 PP-OCRv6文本检测模型自定义数据集微调全流程,从环境搭建、数据集标注、配置修改、训练调优、评估推理、模型部署全覆盖,所有代码均可直接复用。
PP-OCRv6相比旧版本模型,在工业落地场景优势显著,通过自定义微调可以完美解决通用模型在垂直场景漏检、误检、检测不准的问题,快速适配票据、证件、工业文本、手写文本等个性化场景。
后续可以结合PP-OCRv6识别模型微调,完成检测+识别全链路定制化OCR系统落地。