欢迎来到我的频道!【点击跳转专栏】
本文所有代码已托管至码云:【点此转跳】
文章目录
- [1. 传输层](#1. 传输层)
- [2. 再谈端⼝号](#2. 再谈端⼝号)
- [2.1 端⼝号范围划分](#2.1 端⼝号范围划分)
- [2.2 认识知名端⼝号](#2.2 认识知名端⼝号)
- [2.3 两个问题](#2.3 两个问题)
- [3. UDP协议](#3. UDP协议)
- [3.1 UDP协议端格式](#3.1 UDP协议端格式)
- [3.2 几个结论和问题(重点!封装和解包本质)](#3.2 几个结论和问题(重点!封装和解包本质))
- [3.3 【结合源码解析】当我们收到一个报文的时候,我们是如何做到以文件管理的原理,读到数据到应用层的?(超级大重点!一定要读)](#3.3 【结合源码解析】当我们收到一个报文的时候,我们是如何做到以文件管理的原理,读到数据到应用层的?(超级大重点!一定要读))
- [3.4 UDP的特点](#3.4 UDP的特点)
- [3.5 ⾯向数据报](#3.5 ⾯向数据报)
- [3.6 既然不可靠,为什么还要有UDP](#3.6 既然不可靠,为什么还要有UDP)
- [3.7 UDP的缓冲区](#3.7 UDP的缓冲区)
- [3.8 UDP使⽤注意事项](#3.8 UDP使⽤注意事项)
- [3.9 补充:基于UDP的应⽤层协议](#3.9 补充:基于UDP的应⽤层协议)
1. 传输层
负责数据能够从发送端传输接收端。
2. 再谈端⼝号
端⼝号(Port)标识了⼀个主机上进⾏通信的不同的应⽤程序
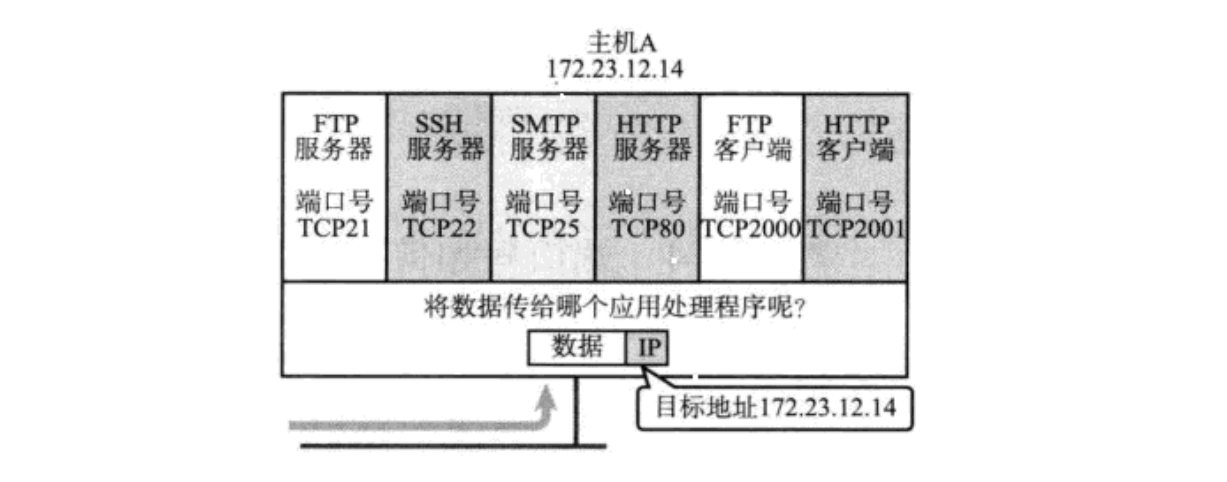
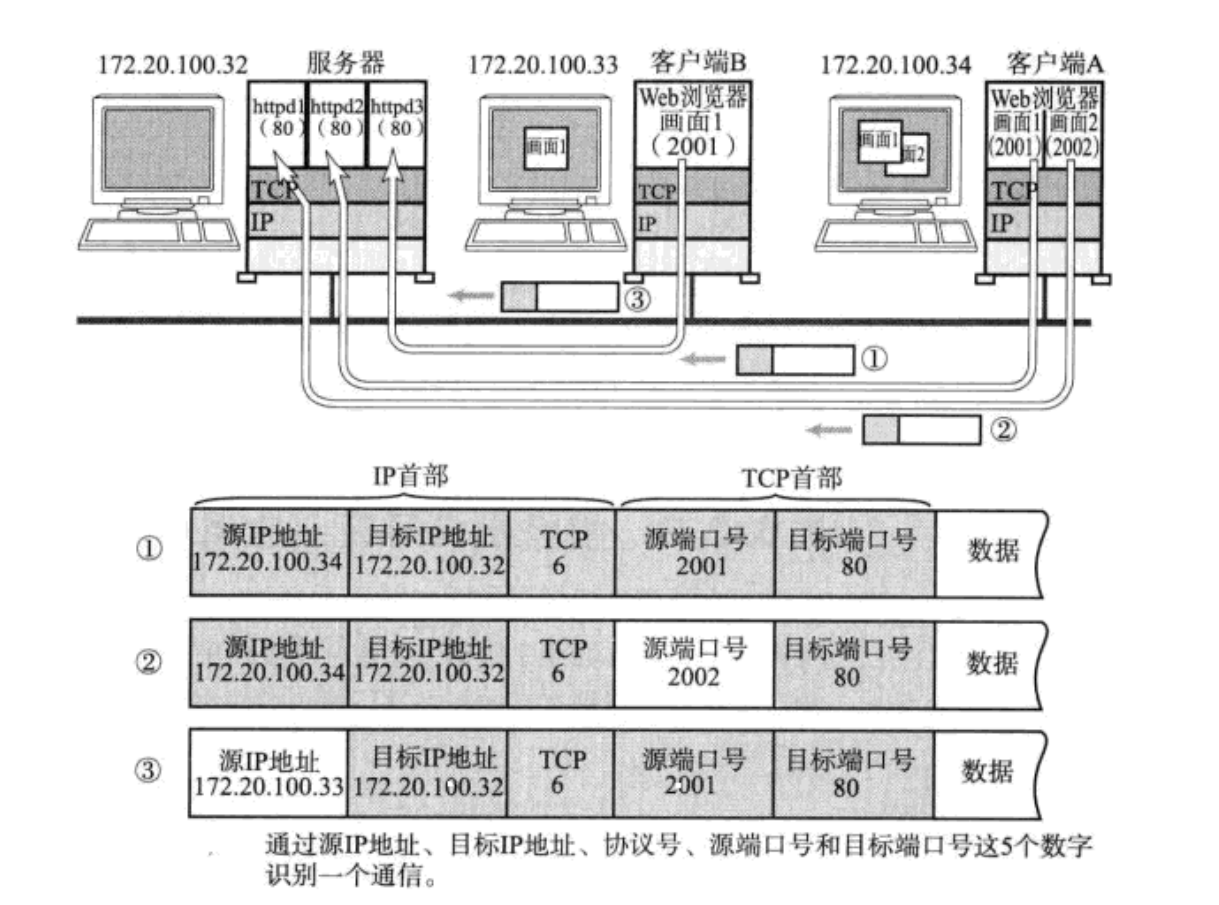
在TCP/IP协议中, ⽤ "源IP", "源端⼝号", "⽬的IP", "⽬的端⼝号", "协议号" 这样⼀个五元组来标识⼀个通信(可以通过
netstat -n查看);
2.1 端⼝号范围划分
0‑1023: 知名端口号, HTTP, FTP, SSH等这些广为使用的应用层协议, 他们的端口号都是固定的.1024‑65535: 操作系统动态分配的端口号. 客户端程序的端口号, 就是由操作系统从这个范围分配的.
2.2 认识知名端⼝号
有些服务器是非常常用的,为了使用方便,人们约定一些常用的服务器,都是用以下这些固定的端口号:
- ssh服务器,使用22端口
- ftp服务器,使用21端口
- telnet服务器,使用23端口
- http服务器,使用80端口
- https服务器,使用443
执行下面的命令,可以看到知名端口号
1 cat /etc/services我们自己写一个程序使用端口号时,要避开这些知名端口号.
2.3 两个问题
- 一个进程可以绑定多个端口号吗?
可以!
- 一个端口号可以绑定多个进程吗?
不可以!
3. UDP协议
3.1 UDP协议端格式
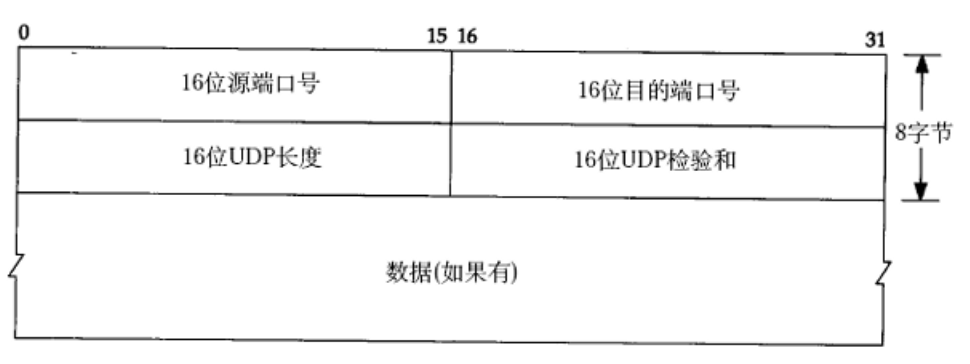
16位UDP⻓度, 表⽰整个数据报(UDP⾸部+UDP数据)的最⼤⻓度;- 如果校验和出错, 就会直接丢弃;
3.2 几个结论和问题(重点!封装和解包本质)
- 为什么我们写socket的时候,port是16位的? 因为UDP协议规定!
- 报头和有效载荷如何分离?
UDP是采用固定长度的报头(8字节)!其中有一个固定位置是
16位UDP长度!因为我们有它的长度,所以我们就能很轻松的将报头和正文内容进行分离!
- 那么有效载荷是怎么交付给上层的呢?
因为有16位目的端口号,就能得到交付给哪个端口的进程!
- 那么UDP是否存在粘包问题?
UDP叫用户数据报协议,长度固定好,收一个报文得一个报文!!所以不存在粘包问题!
- 我们是如何理解UDP协议的报头的呢?
OS内核是C语言写的,协议本质是一个结构体!在OS内部,双方是能互传结构体变量!(天然可以做反序列化)
如图:
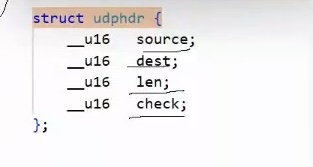
- 所以我们该如何理UDP解封装过程?
当我们需要发送数据了,在OS内部会给我们开辟一段缓冲区,会把上层数据拷贝下来,并将指针向前移动UPD报头的位置,然后以访问结构体的方式通过指针将UDP属性部分填充进去!
封装的本质 就是对结构体的拷贝!
- 报文如何在协议层从一层到另一层
从底层到上层,你就是在做回调;从上层传下层,你就是调用下层函数,本质都是传参的方式,进行协议栈式的流通!
3.3 【结合源码解析】当我们收到一个报文的时候,我们是如何做到以文件管理的原理,读到数据到应用层的?(超级大重点!一定要读)
首先,OS内部,可能会同时存在多个报文! 那么就不可避免的需要对报文进行管理!
OS,报文的在内核表达的本质是一个 struct sk_buff结构体!所谓管理,就是将收到的报文以某种数据结构(假设是链表)进行管理!
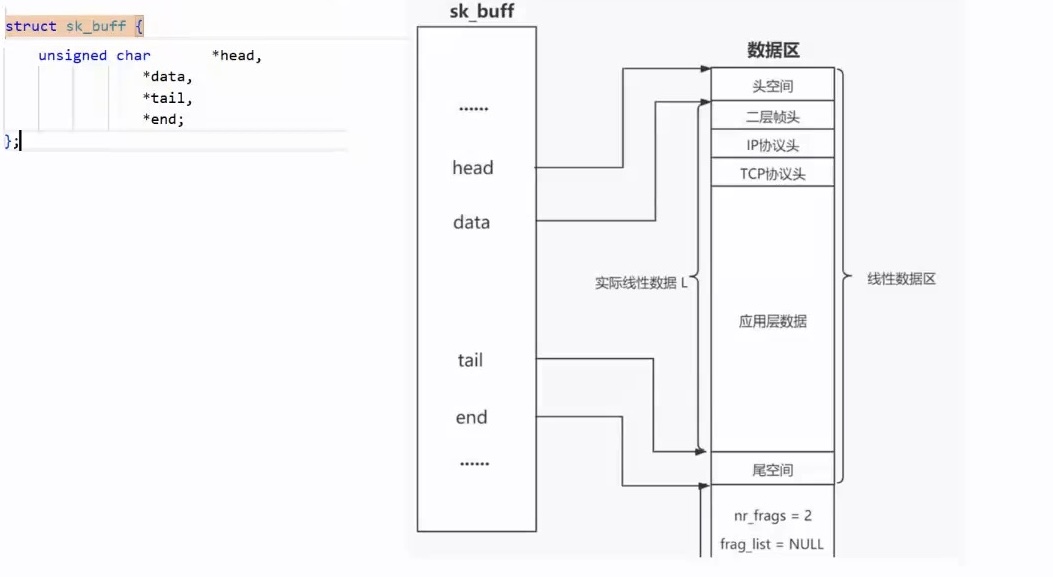
head: 一般指向数据的最开头。end: 指向结尾边界,后面有些属性字段也要被管理(不用管)data: 在应用层指向应用层数据开头,到传输层移动到TCP协议头开头,到网络层,移动到IP协议头,依次类推!(而这就是封装的本质,即不断入栈的形式,对指针进行移动!解包就是反过来!)tail: 指向应用层数据结尾!
结论 :报文贯穿协议栈,封装和解包的过程,最核心的其实就是移动指针就可以了!
知道报文数据的存储结构体,接着将视线移动到进程内部:
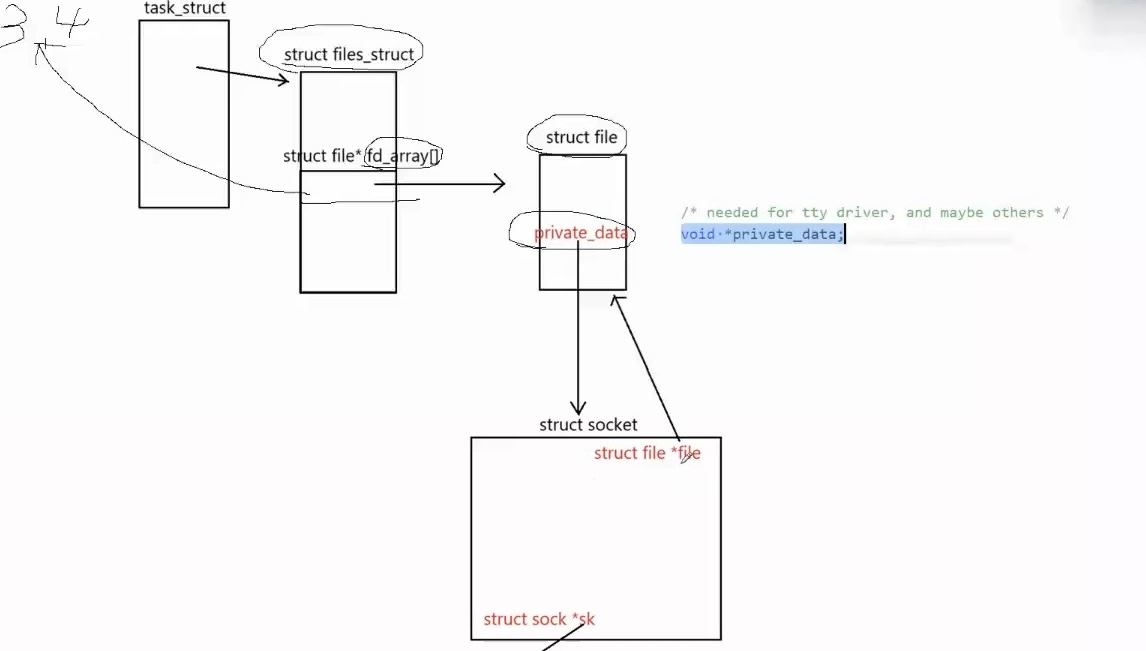
- 进程,OS会创建对应的
task_struct结构体,同时会会创建一个files_struct,里面有个struct file* fd_arrary[]的数组负责该进程所创建的文件,以下标fd的方式进行管理! - 当创建对应套接字的时候,就会创建对应的
struct file结构体,但是怎么标识 套接字的特殊型 ,于是会创建一个struct socket的结构体,通过file内部的万能指针void* private_data指向对应的struct socket,至此就完成了文件到套接字的转换
接着把视角放到socket内部:
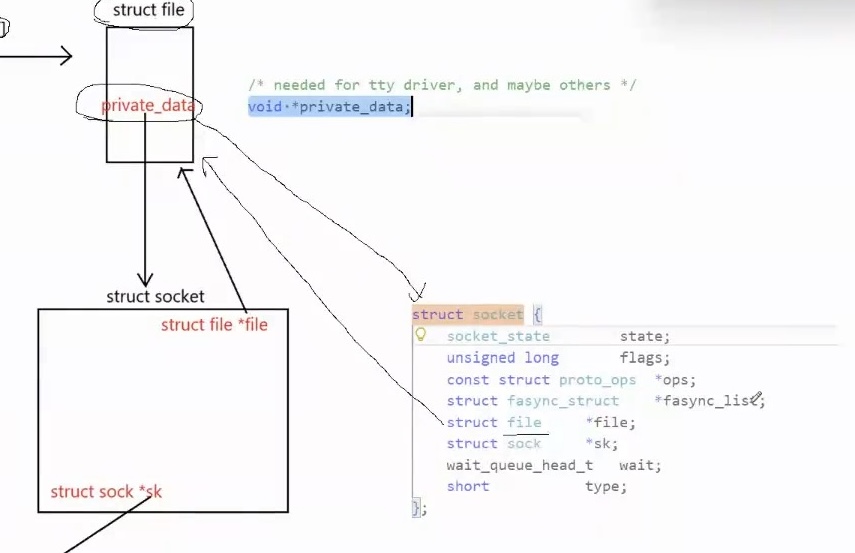
socket被private_data指向,同时socket内部还有个struct file * file回指struct file!- 由于一切皆文件,当我们通过
read、recv等接口进行读写的时候,进程回被阻塞,进程就会把PCB列入wait_queue_head_t wait中呆着!当数据有了,就会再次把进程唤醒! - 同时 还有个结构叫
struct sock * sk指向的就是套接字内部的属性了!
将视线继续往下看:
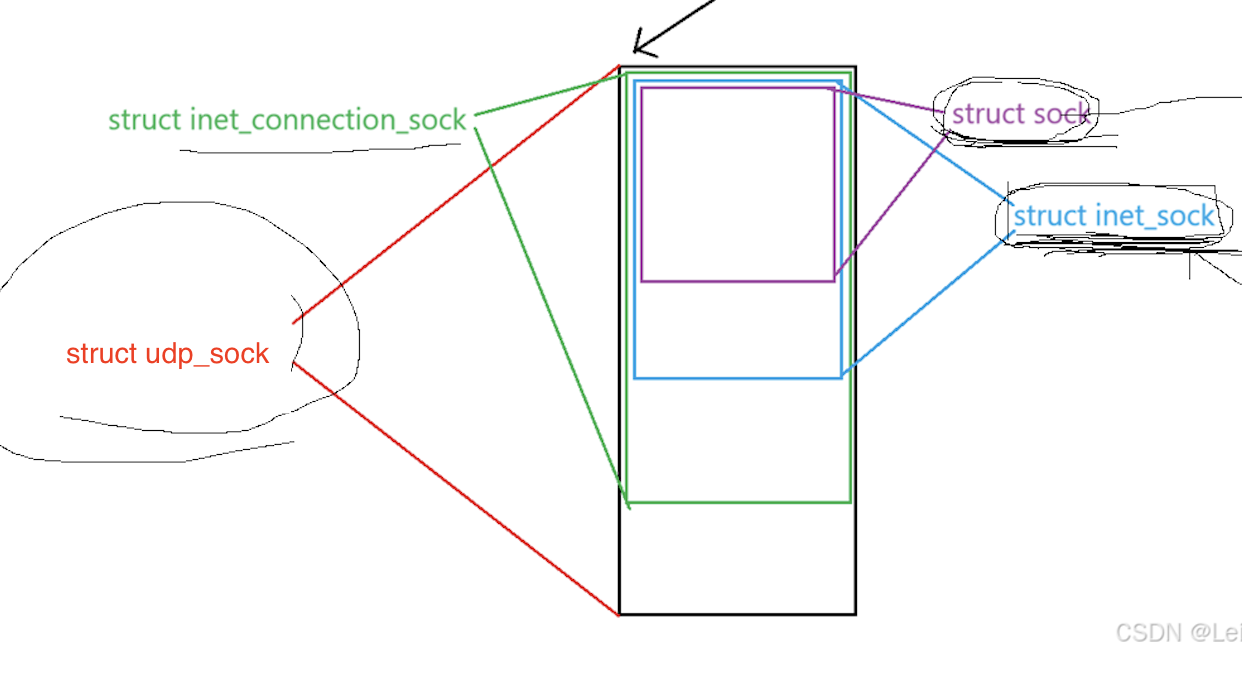
- 在
struct sock中有两个属性: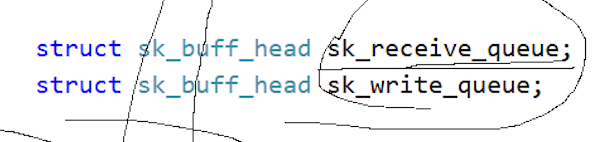
struct sk_buff_head就是对应的 缓冲队列 这一块我写过 为了文章完整性 我把关键内容截取下来了:
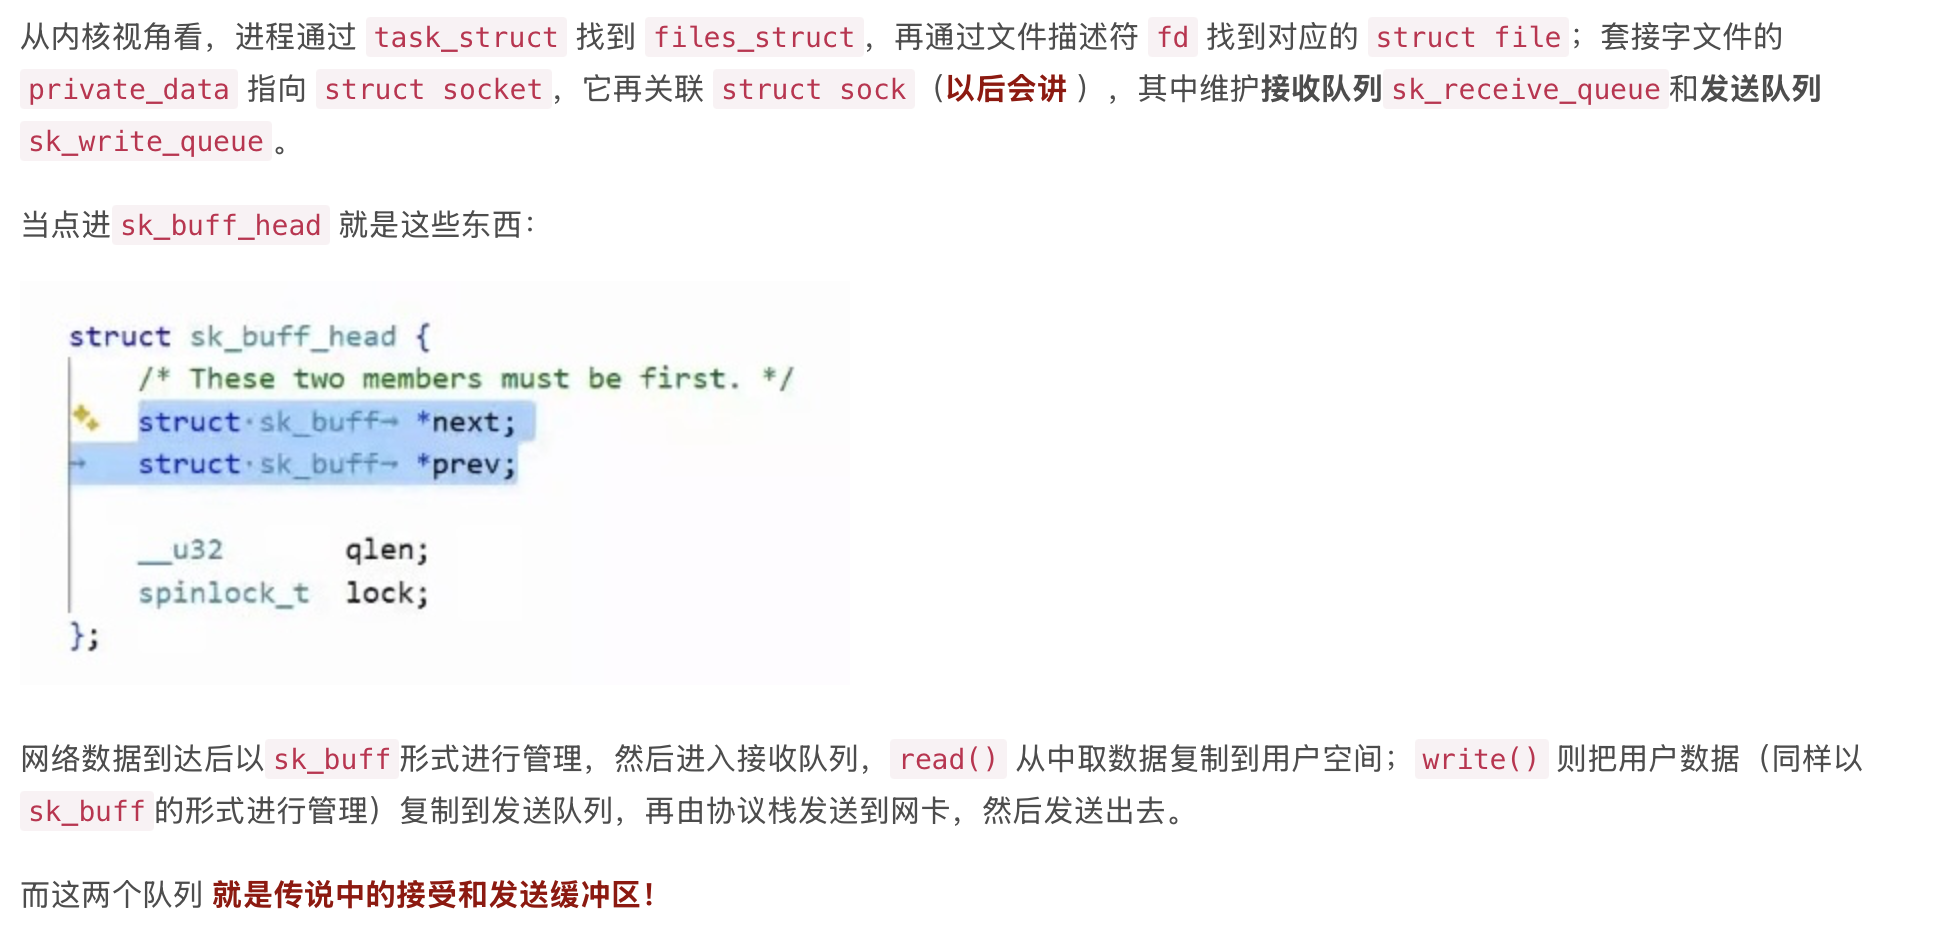
- 当然光有
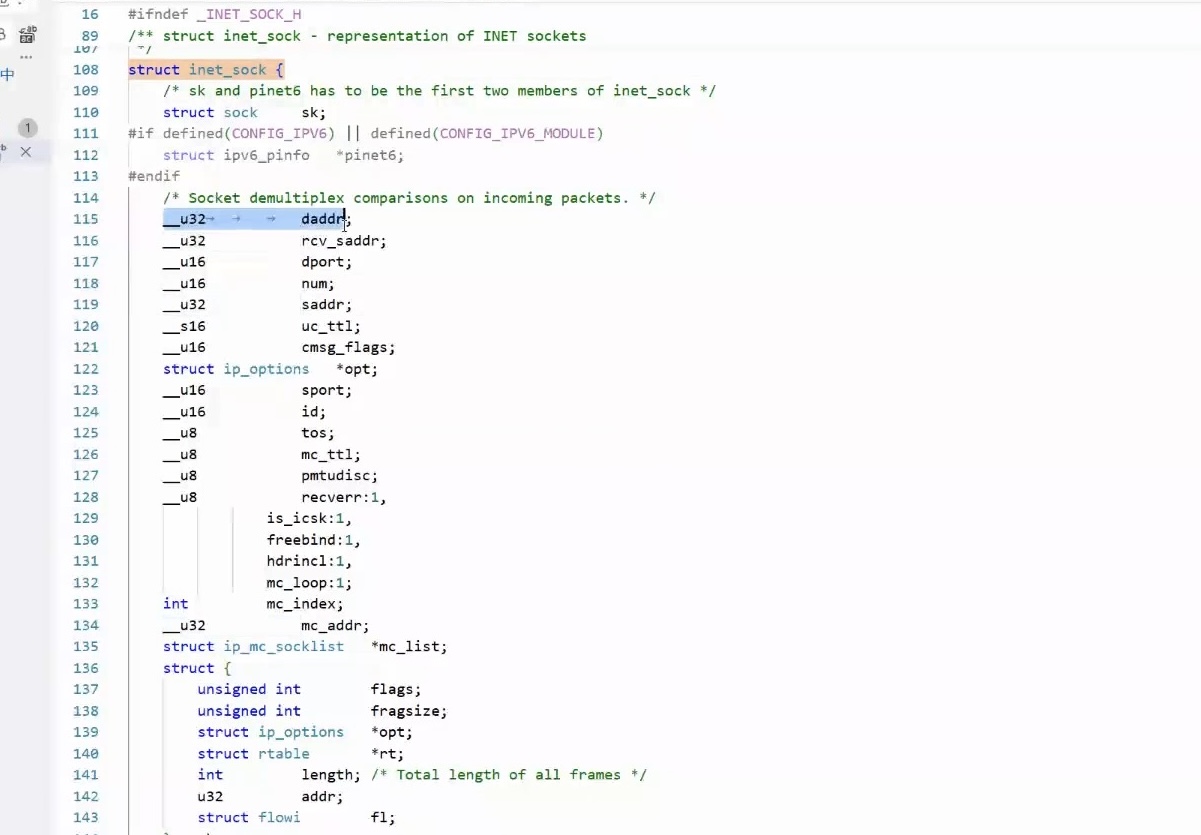
sock还不够,上层它还套了层struct inet_sock:
里面第一个成员就是
struct sock,这里面的daddr、rcv_saddr、dport等就是目的地址、原地址、端口号等,即 套接字的绑定信息,就是填到这里的!!
我们真实在内核创建套接字,并持有信息的结构体其实是inet_sock!而不是struct sock!,只是其第一个成员是 struct scok!
那么怎么区分是UDP还是TCP呢?
其实利用多态的思想 本质上就是在struct inet_sock 上再套上一层 struct udp_sock
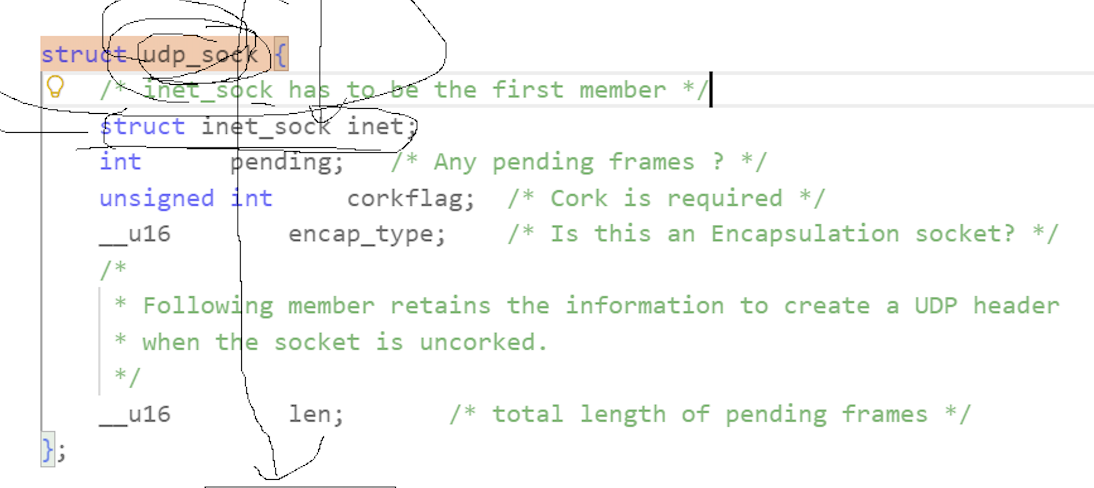
里面第一个属性就是struct inet_sock inet!;未来换成TCP也是同理! 而里面的struct sock就是最原始的基类(网络传送接收的数据就是通过该基类管理的)!后面不管是套上什么样的子类,都可以利用多态思想 通过指针的强转 ,然后利用文件的wirte、read接口读取写入 网络缓冲区里面的东西!!至此 文件和套接字网络就关联起来了!!
3.4 UDP的特点
UDP传输的过程类似于寄信
⽆连接: 知道对端的IP和端⼝号就直接进⾏传输, 不需要建⽴连接;不可靠: 没有确认机制, 没有重传机制; 如果因为⽹络故障该段⽆法发到对⽅, UDP协议层也不会给应⽤层返回任何错误信息(UDP本身不可靠,但不排除上层代码维护可靠性)⾯向数据报: 不能够灵活的控制读写数据的次数和数量
3.5 ⾯向数据报
应⽤层交给UDP多⻓的报⽂, UDP原样发送, 既不会拆分, 也不会合并
⽤UDP传输100个字节的数据:
如果发送端调⽤⼀次sendto, 发送100个字节, 那么接收端也必须调⽤对应的⼀次recvfrom, 接收100个字节; ⽽不能循环调⽤10次recvfrom, 每次接收10个字节
3.6 既然不可靠,为什么还要有UDP
所谓的不可靠,不是数据传不过去,而是丢包了,我们不关心!!现阶段网络环境已经很少丢包了!
所谓的不可靠,不代表 不可用!!
可靠,意味着需要做更多工作,就相对更慢,而不可靠,就意味着相对快一点,使用更简单,意味着在不重要的场合可以更简单更快速进行传输!
3.7 UDP的缓冲区
虽然UDP也是全双工!!
- 但是 UDP没有真正意义上的
发送缓冲区. 调⽤sendto会直接交给内核, 由内核将数据传给⽹络层协议进⾏后续的传输动作( 因为UDP是不可靠的,直接发出去就行,不存在TCP那种如果传输失败,需要缓冲区数据作为备份再次发送!); UDP具有接收缓冲区. 但是 这个接收缓冲区不能保证收到的UDP报的顺序和发送UDP报的顺序⼀致 ; 如果缓冲区满了, 再到达的UDP数据就会被丢弃;
3.8 UDP使⽤注意事项
我们注意到, UDP协议⾸部中有⼀个16位的最⼤⻓度. 也就是说⼀个UDP能传输的数据最⼤⻓度是64K(包含UDP⾸部)!
然⽽64K在当今的互联⽹环境下, 是⼀个⾮常⼩的数字.
如果我们需要传输的数据超过64K, 就需要在应⽤层⼿动的分包, 多次发送, 并在接收端⼿动拼装
3.9 补充:基于UDP的应⽤层协议
NFS: 网络文件系统TFTP: 简单文件传输协议DHCP: 动态主机配置协议BOOTP: 启动协议(用于无盘设备启动)DNS: 域名解析协议
当然,也包括你自己写UDP程序时自定义的应用层协议!
类似动不动10w+的直播视频,都是UDP的,因为一个一个建立连接,服务器成本太高了!