云计算的每个时代,都有自己的计量单位。
过去二十年,这个单位一直是实例的运行小时。大家冲着算力来,按小时付钱------不管你是在干活还是在干等。后面跟出来的每一项服务,说白了都是为了让更多实例小时被消耗掉。十四年前,我们(DigitalOcean)给出的答案是 5 美元的 Droplet 云服务器,一批中小企业就靠它起步,因为它够简单、够好上手。
Agent 要的也是这种简单,但它现在这套工作流,已经塞不进一台虚拟机里了。
AI Agent 跑起来跟 Web 服务器完全是两回事:
- 它用 token 思考,用短促的计算爆发来行动。然后它就开始等------等模型推理、等工具返回、等人点头。
- 它可能今天下午需要四个分身,到了晚上一个都不需要。第二天早上,它又得把工作状态捞回来------可能在另一台设备上,可能换个人接手,也可能交给另一个 Agent。
- 它的天然单位是:烧掉的 token、微虚拟机实际运行的秒数,以及比会话活得更久的状态。
拿 token 和微虚拟机实际运行的秒数去替代实例小时,听着像是个小改动。真不是。它改的是你怎么架一朵云、怎么保它安全、怎么给它算账。
这周,DigitalOcean 托管 Agents服务(Managed Agents) 进入公测上线状态:沙箱、推理、数据,一个运行时全包,专门为 token 和突发式计算而生,底下跑的还是你已经熟悉的 Droplets、数据库和网络。
为什么是现在:workload 跑得比基础设施快
这个缺口不是自己冒出来的。三个趋势一起把 workload 拽到了基础设施前面,也推着我们下决心投这个平台:
- Token 代表思考。 一个 Agent 任务烧的 token,是普通聊天交互的 5 到 30 倍。一张工单能散成十几次模型调用、一次网络搜索、一次数据库查询,外加一个 PR。软件经济学正在从"服务了多少请求"转向"干完了多少活",而干完的活是按 token 结账的。
- 构建者在选开放智能。 现在 Agent 的大部分 token 负载,都是开放权重模型在扛。产品一旦找到市场,团队就会往开放权重上转------既为了压住单位成本,也为了真正拥有自己的智能,而不是租一个。
- 做 Agent、跑 Agent 的团队,快被复杂度淹死了。 我跟几十个创始人和 CTO 聊下来,听到的是同一套栈被描述成五花八门的样子:笔记本上跑个 harness,沙箱找一家创业公司,推理再找两家,存储丢给超大规模云,搜索又是第六家------全靠胶水代码粘着。没人能准确说出一次运行到底花了多少钱、怎么保安全、怎么规模化运营。
Agent 要的一切,紧密集成在一起
DigitalOcean 托管 Agents服务(Managed Agents) 不是"一个沙箱产品加点附加件"。它是 Agent 的三个组成部分终于住到了一起:
- 沙箱给它一双手:一台隔离的机器来跑代码、开浏览器、产出文件。
- 推理给它一个脑子:开放权重和前沿模型就在沙箱旁边服务。
- 数据层给它记忆:工作区状态、检查点、数据库、检索,全都比会话活得久。
沙箱、推理、数据之间的每一次交接,都是一次函数调用,不是一次跨广域网的跳转。
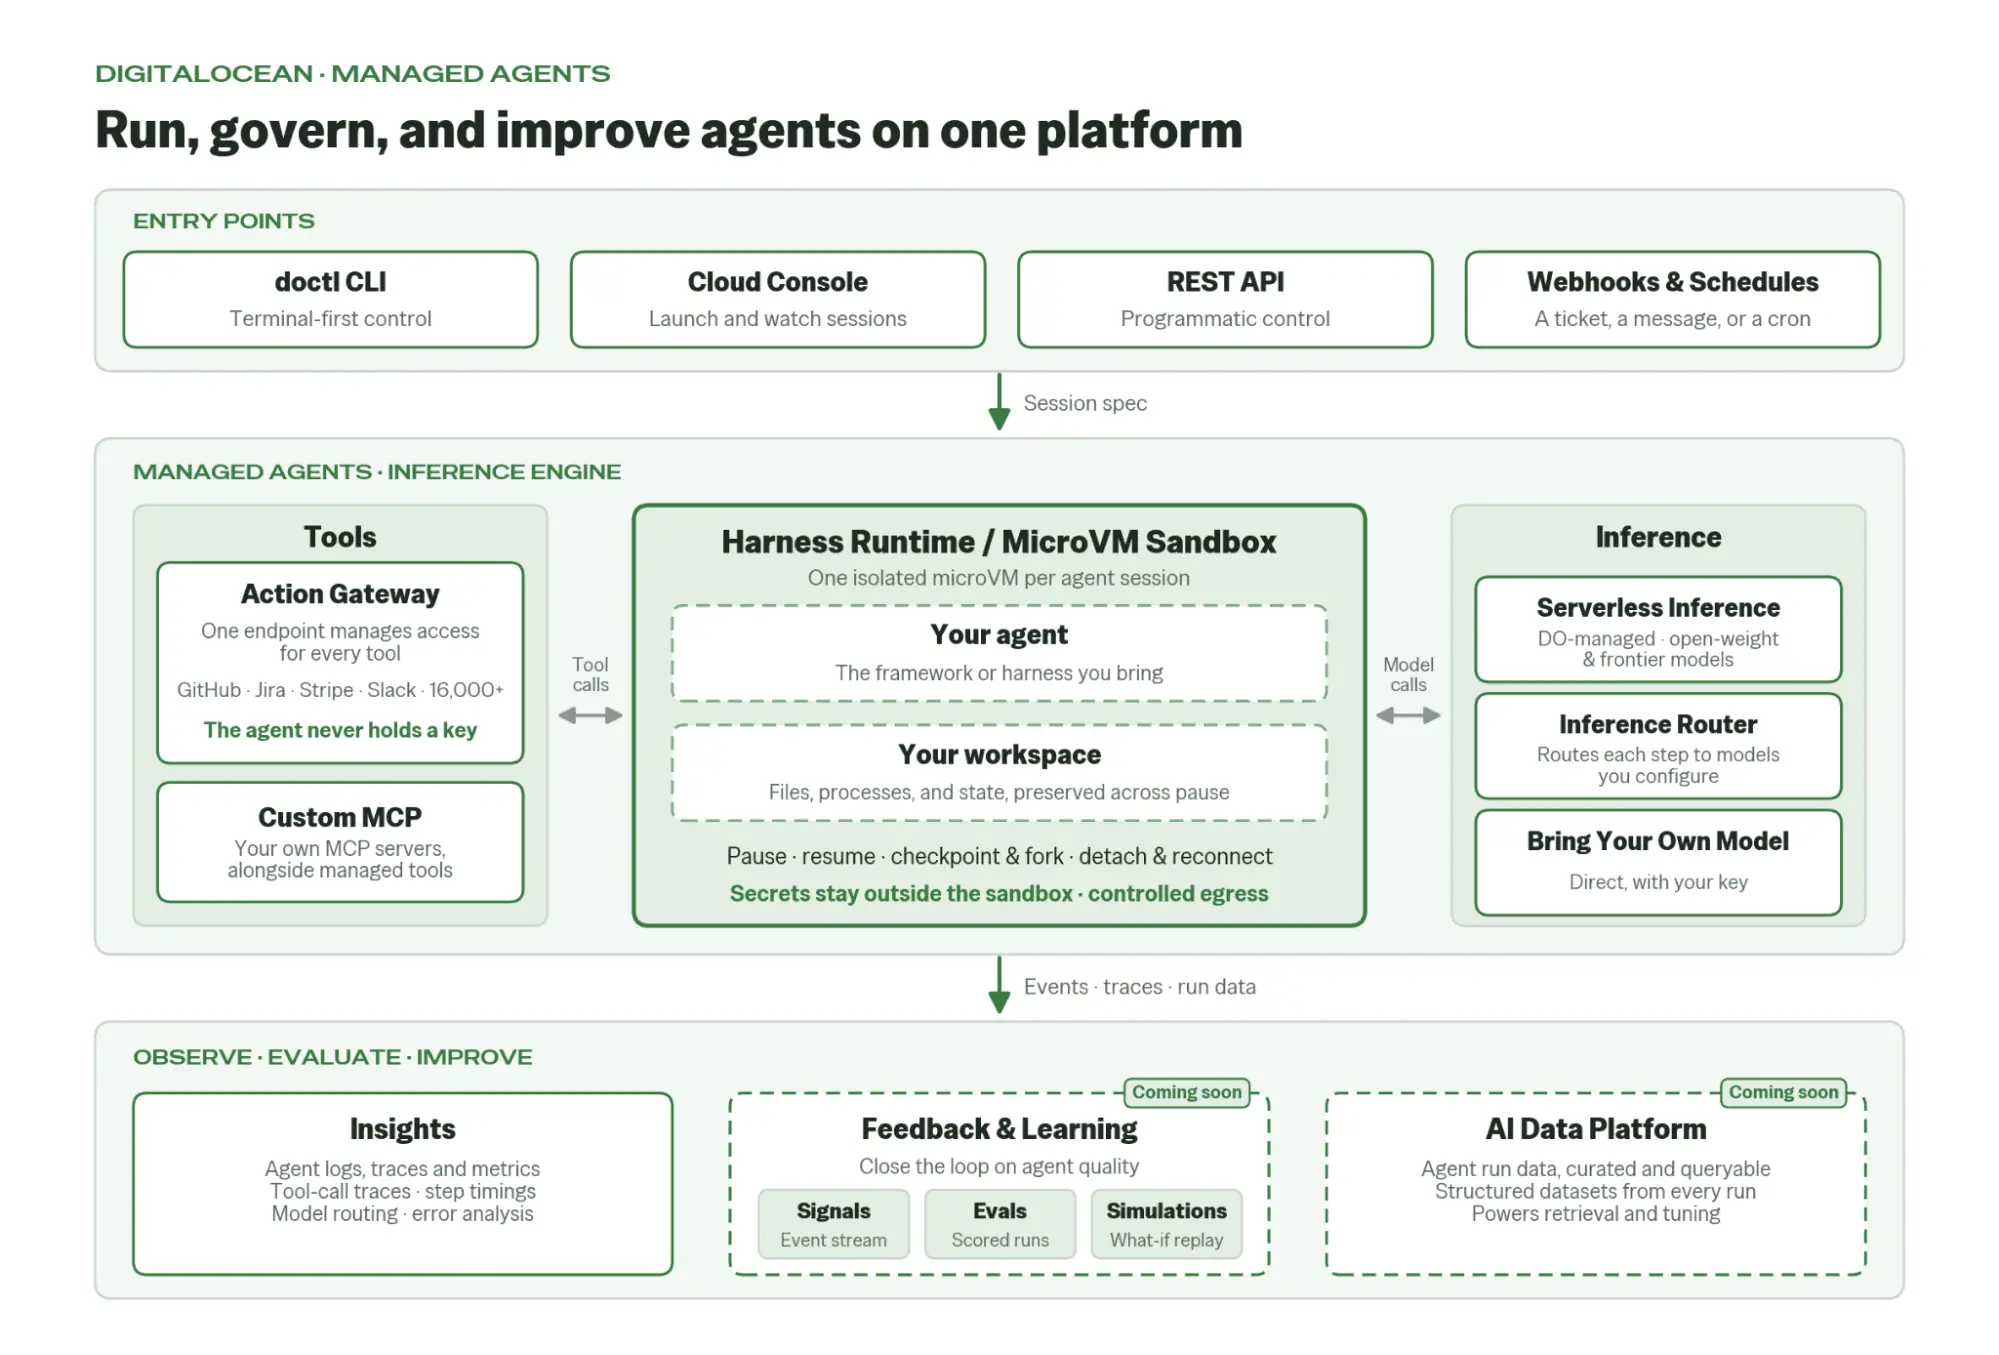
如图:Managed Agents架构逻辑是,带上你的 Agent 和 spec,剩下的沙箱、工具、模型、遥测,由 DigitalOcean 全包。
三件事让这变成现实:
DigitalOcean Harness Runtime 是持久执行
- 每个会话都有自己的 Firecracker 微虚拟机:自己的内核、硬件级隔离、亚秒级启动、约 300 毫秒恢复。
- 会话比你的笔记本活得久。合上盖子,Agent 在云端继续跑完。你可以从手机上重新接上,或者把活着的会话丢给同事。给热好的会话打个检查点,分叉成四份,留下最好的那个。
- 带上 Claude Code、Codex CLI、OpenCode、Hermes、LangGraph,或者把你自己的授权 Agent 打包成标准 OCI 镜像。
Action Gateway 是受治理的执行
- 一个托管的 MCP 端点,通到 500 多家供应商的 16,000+ 工具,从 GitHub、Stripe 到你自己的 MCP 服务器。你本来要自己搭的凭证、重试、权限管道,它全给你替了。
- 它按 Agent 的意图搜对的工具,而不是把整个目录倒进上下文窗口;它会修格式错的调用、处理限流、敏感操作卡一道人工审批。
- 最关键的一点:凭证在执行那一刻才被代理进去,永远不会碰到模型、提示词或者沙箱。Agent 永远看不到密钥。
Agent 的定价,终于跟 workload 对上了
Agent 就是一阵一阵的:这儿编译一下,那儿跑个测试,中间大段大段等 token、等人批。大多数产品是先开一台虚拟机,从开机到关机一直计费。DigitalOcean 按实际用掉的 CPU 秒数 算,vCPU 每小时 0.044,内存每GB每小时0.0095,快照每 GiB 每月 $0.05。
不一样在哪:一个平台,而不是六个供应商
没得选的时候,团队只能认了,把五六家供应商拼在一起。六个供应商,就是十五个接缝 :每个接缝都是一个你要搭的集成、一个你要存的凭证、一个追踪会断掉的地方。结果就是,保这张网、运这张网,成了团队的第二份工作。点状方案很优秀,但都只是一块,因为大多数沙箱公司不跑推理,而模型公司不管 Agent 的记忆和可观测性。超大规模云什么都给,但账单一拉一长串,复杂性也是企业级的。
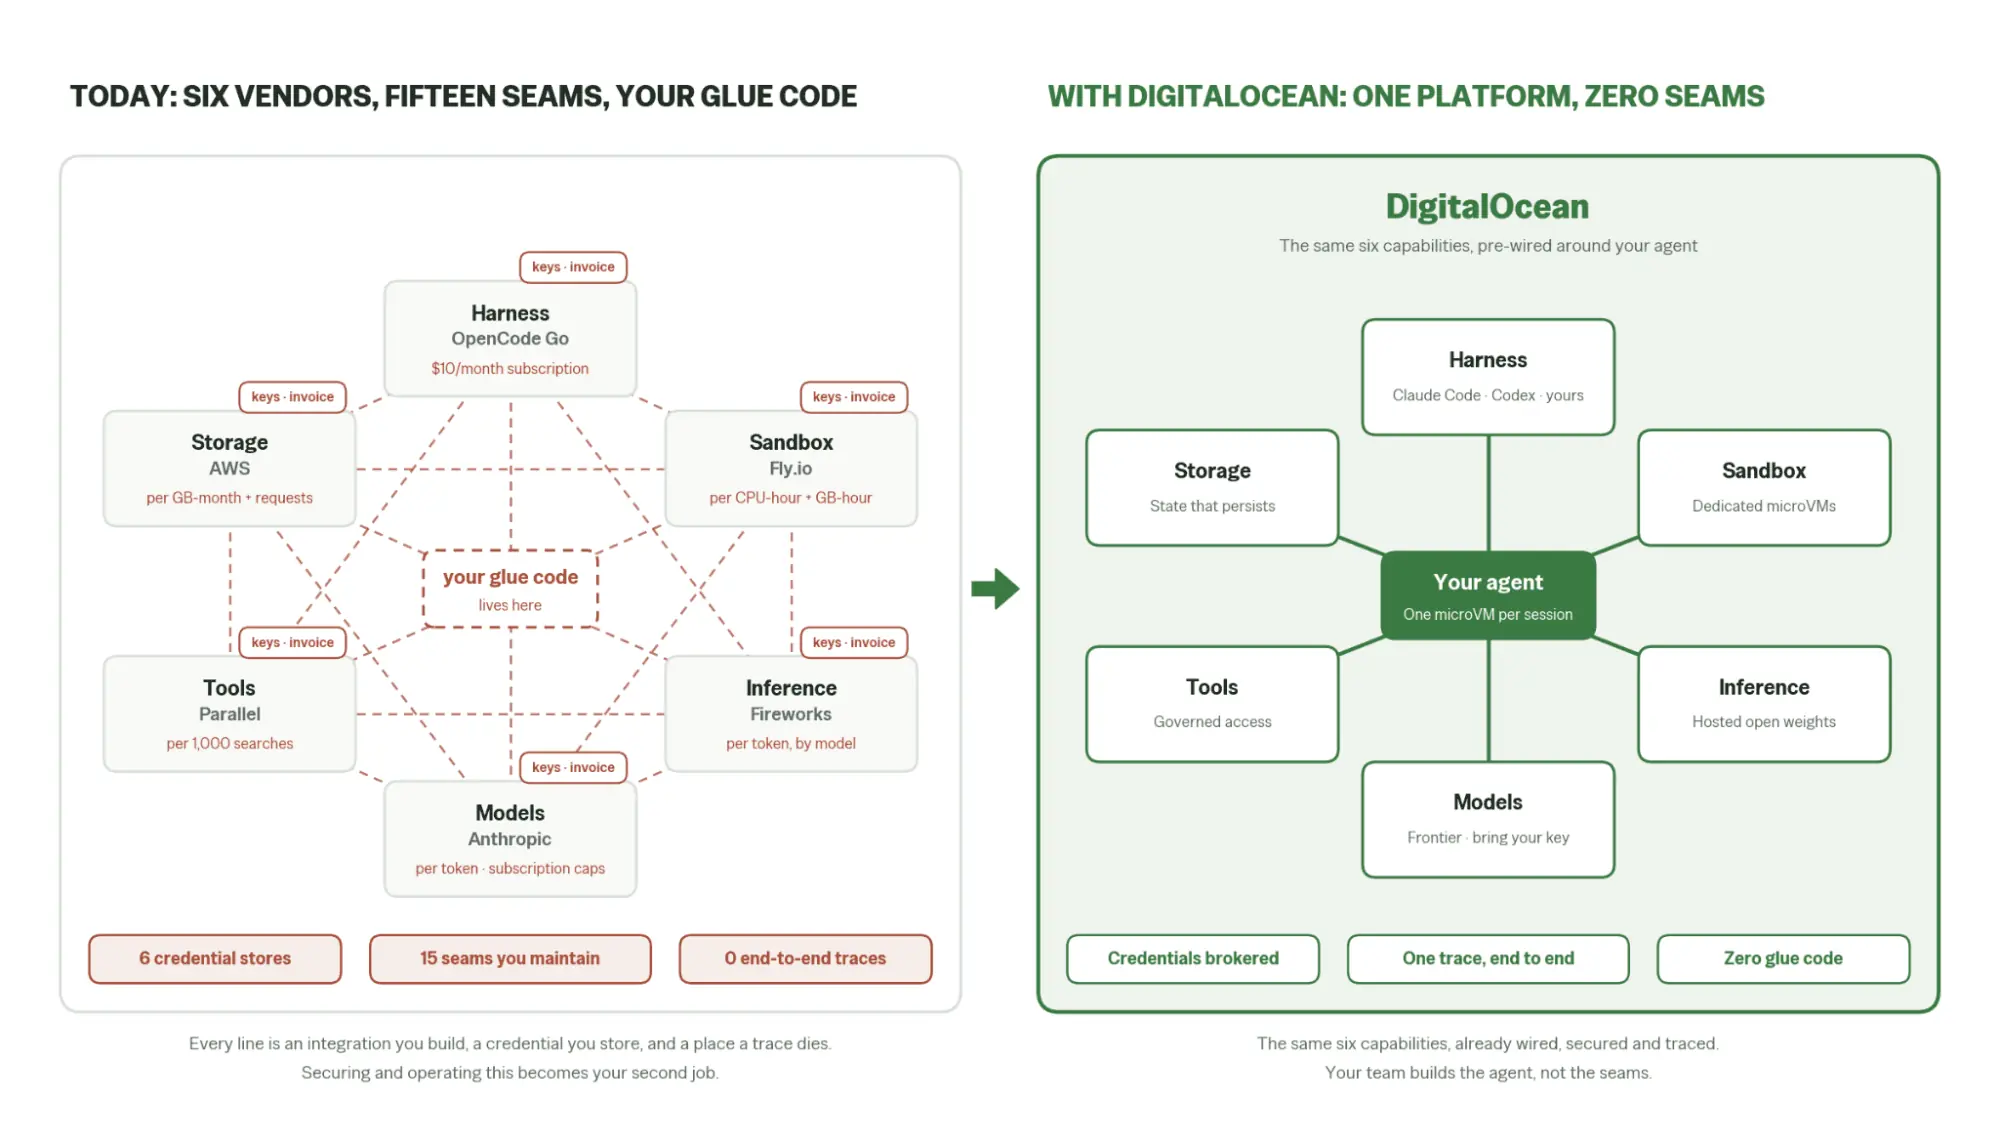
Agent 是第一个能在单个循环里走遍云每一层的 workload:它思考、在真实系统上动手、记住、然后改进。一个有凝聚力的平台,就是为这个循环本身设计的------一套架构,不是一堆捆在一起的零件。
一套有凝聚力的架构,带来的是:
- 开发提速。 原语到的时候就是集成好的:沙箱能碰到模型路由器,网关能碰到你的工具,工作区同步到持久存储。你的第一个会话,就是一条 CLI 命令加一个 spec 文件。
- 延迟压到最低。 沙箱、模型、数据共享一个平台(往往还在同一个数据中心),循环直接跳过了跨供应商的网络税,而缓存感知路由把热上下文留在服务它的模型旁边。
- 默认就安全。 每会话硬件虚拟化隔离、按调用代理凭证、出站流量受治理、敏感操作要人签批。SSO、MFA、基于角色的访问、审计日志,都是标配,不是企业级附加项。
- 可观测性和运维,一条线拉通。 一条流里装着运行时追踪、工具调用、模型调用、步骤耗时和成本。用量就落在一张明明白白的账单上。
- 开放、异构的架构。 harness、框架、模型,你随便挑:自托管开放权重,比如 Kimi K3 和 GLM 5.3;按量付费的前沿模型;或者用你自己的 key。自定义镜像和你自己的 MCP 服务器,跟 DigitalOcean 的并排放。
全栈优势
Agent 在会话的大部分时间里都在闲着,等 token、等工具、等人。这就是 Agent 经济学的全部故事。如果你按预置容量计费,那你就是在为"等"付钱。DigitalOcean 按活跃 CPU和峰值内存计费,所以你付的是干活的钱,不是干等的钱......
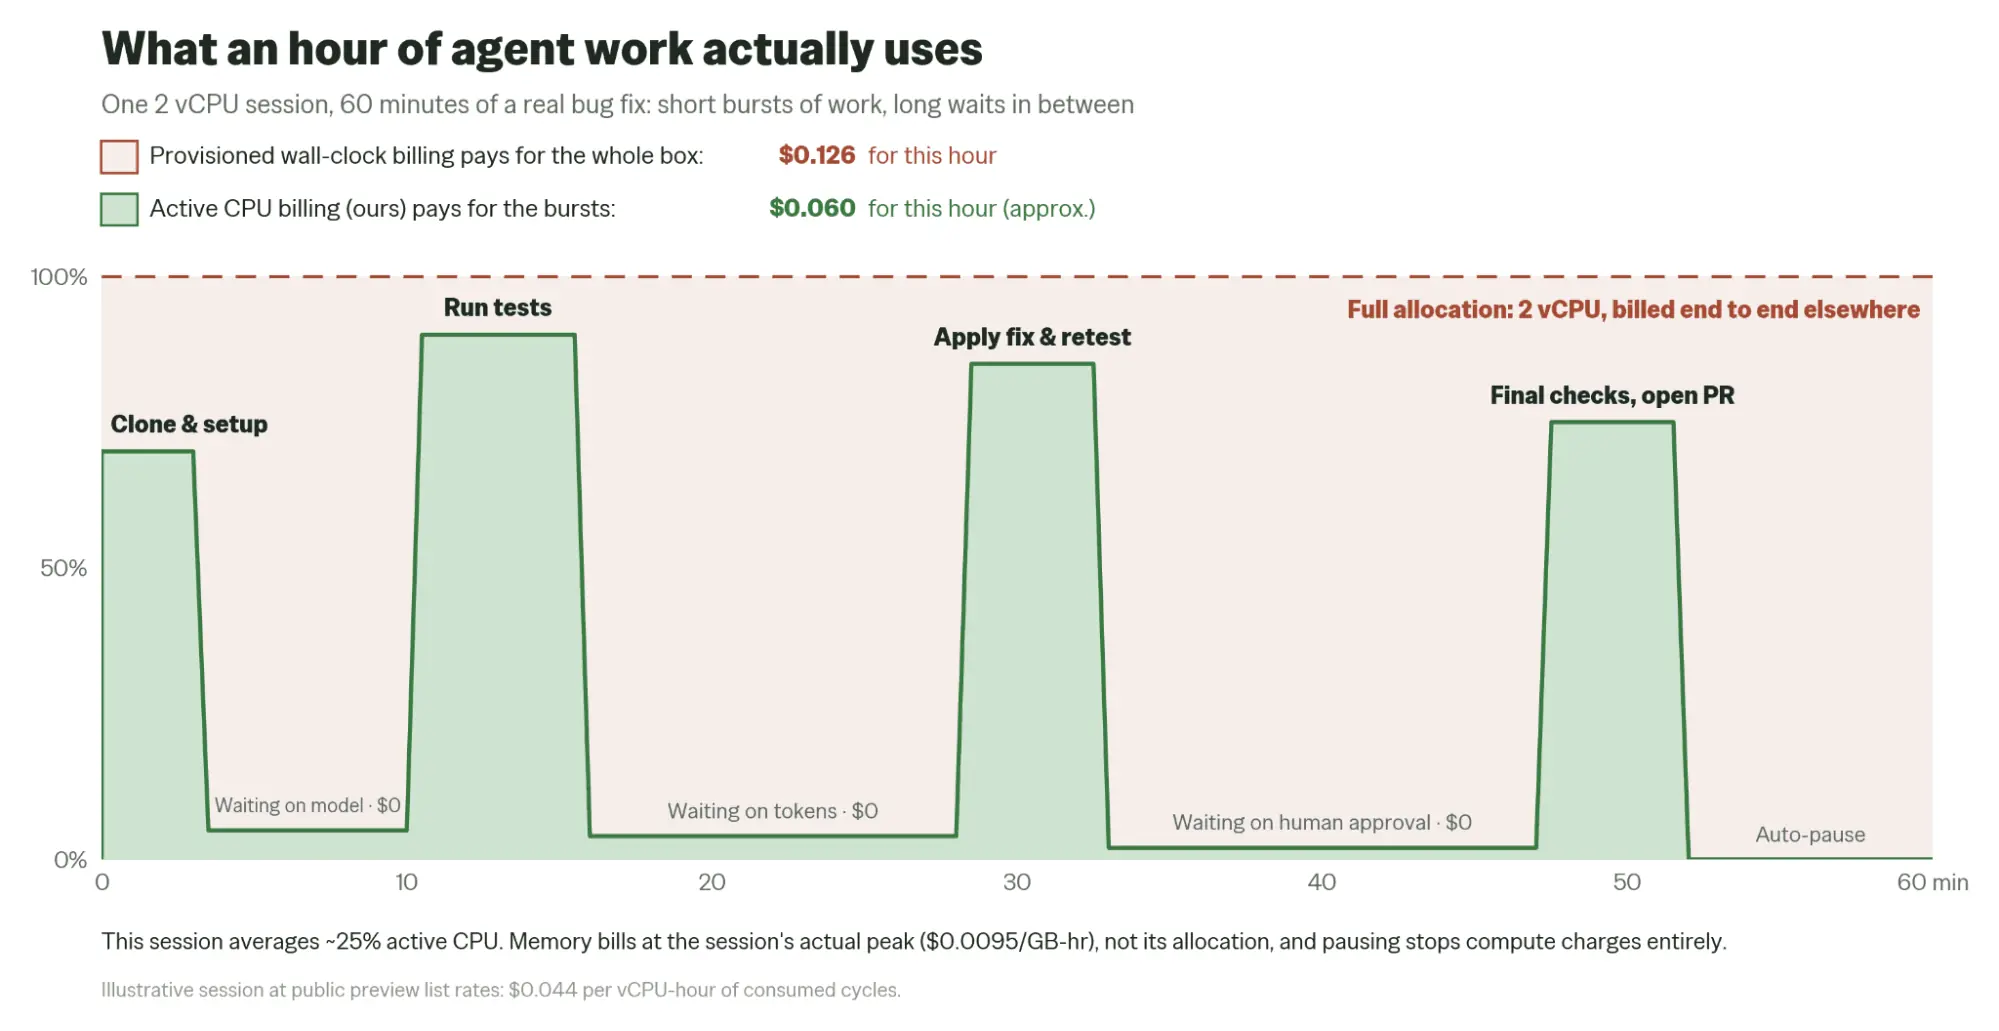
如图所示,同一小时,两种计法:预置计费收整台机器的钱,活跃计费只收那几下爆发。中间等的部分,在活跃 CPU 计费下是 $0。示意图会话按公开预览列表价。
一次典型运行背后的基础设施成本,四舍五入就是几美分;真正拉高支出的是 token。举个例子:一个默认的 2 vCPU、4 GB 会话,满打满算一小时 0.126;但按典型的∗∗250.060**。Agent 等着的时候,CPU 那条线是零------自动暂停会把空闲会话收走。
你可以通过路由来控制支出。DigitalOcean 推理路由器能把每一步匹配到它真正需要的模型上:常规步骤走托管的开放权重,比如 Kimi K3 和 GLM 5.3;复杂推理走按量付费的前沿模型;或者干脆走你自己的 key。
推理和数据放在一起:价值复利增长的地方
热上下文留在模型旁边,被重算的 token 就少了。检索从你 Agent 写入的同一个湖仓里读,上下文就能保持简短、有引用,而不是又旧又复制。用检查点,意味着活永远不会被白白重做一遍,而每次运行的遥测,都会让下一次更利索。在拼接式技术栈上,每一次这种交接都得付一笔出站费,还得有人维护集成。跑在 DigitalOcean 托管 Agents服务上,它就是一次直截了当的函数调用。
成本走向:AI 更便宜,工作负载更多
现在,基础设施大约占一次典型运行成本的 3% 到 8%,剩下全是 token------这个比例会随着智能成本一路往下掉而改变。但更聪明的模型不会缩小 Agent 的计算足迹,反而会放大它:更多步骤、更多工具调用、每个结果更多并行分叉。这么一路推下去,计算在每次运行里的占比会稳稳上升,哪怕运行本身越来越便宜。
Managed Agents 是给谁用的
三类团队正在用 Managed Agents 构建:
- 产品本身就是 Agent 的公司 :DigitalOcean 帮你运营客户永远看不到的那一层:按租户的微虚拟机隔离、凭证代理、黄金环境模板,你可以在毫秒内给每个客户分叉一个。这类 Managed Agent 构建者里,有 OpenHands 和 Amplitude。
- 在自动化真实工作的团队 :Qencode 做了一个支持分诊 Agent,把 Slack、邮件、Intercom 里的每一条请求都读一遍,建或更新对应的 Jira 工单,低置信度的标出来给人看。早期结果是每周省回大约 4 到 8 小时,响应时间从几小时降到几乎即时。
- 已经在跑编码 Agent 的 AI 原生团队:你们组织里的 Claude Code、Codex CLI、OpenCode 会话,是不是还散落在笔记本和宠物虚拟机上?Managed Agents 就是它们的新家,持久、能并行、状态共享、检查点加分叉、工具访问受治理------而且什么基础设施都不用管。
会从自己工作里学习的 Agent(即将推出)
跑 Agent 是一半问题。教它们从自己的活里学习,是另一半------这就是接下来几周要铺开的数据与学习层。
它是 Agent 背后转起来的飞轮。DigitalOcean Signals 会盯着生产轨迹,把 Agent 让用户困惑的失败指纹翻出来:纠正、重复问、转人工、放弃。Evaluations 把每一次失败变成一条回归测试,由 LLM 裁判打分。
在一个内部演示里,一个优化过的支持 Agent,从过不了货币准确性检查,变成通过,同时输入 token 少了 99%,延迟低了大概三分之一。
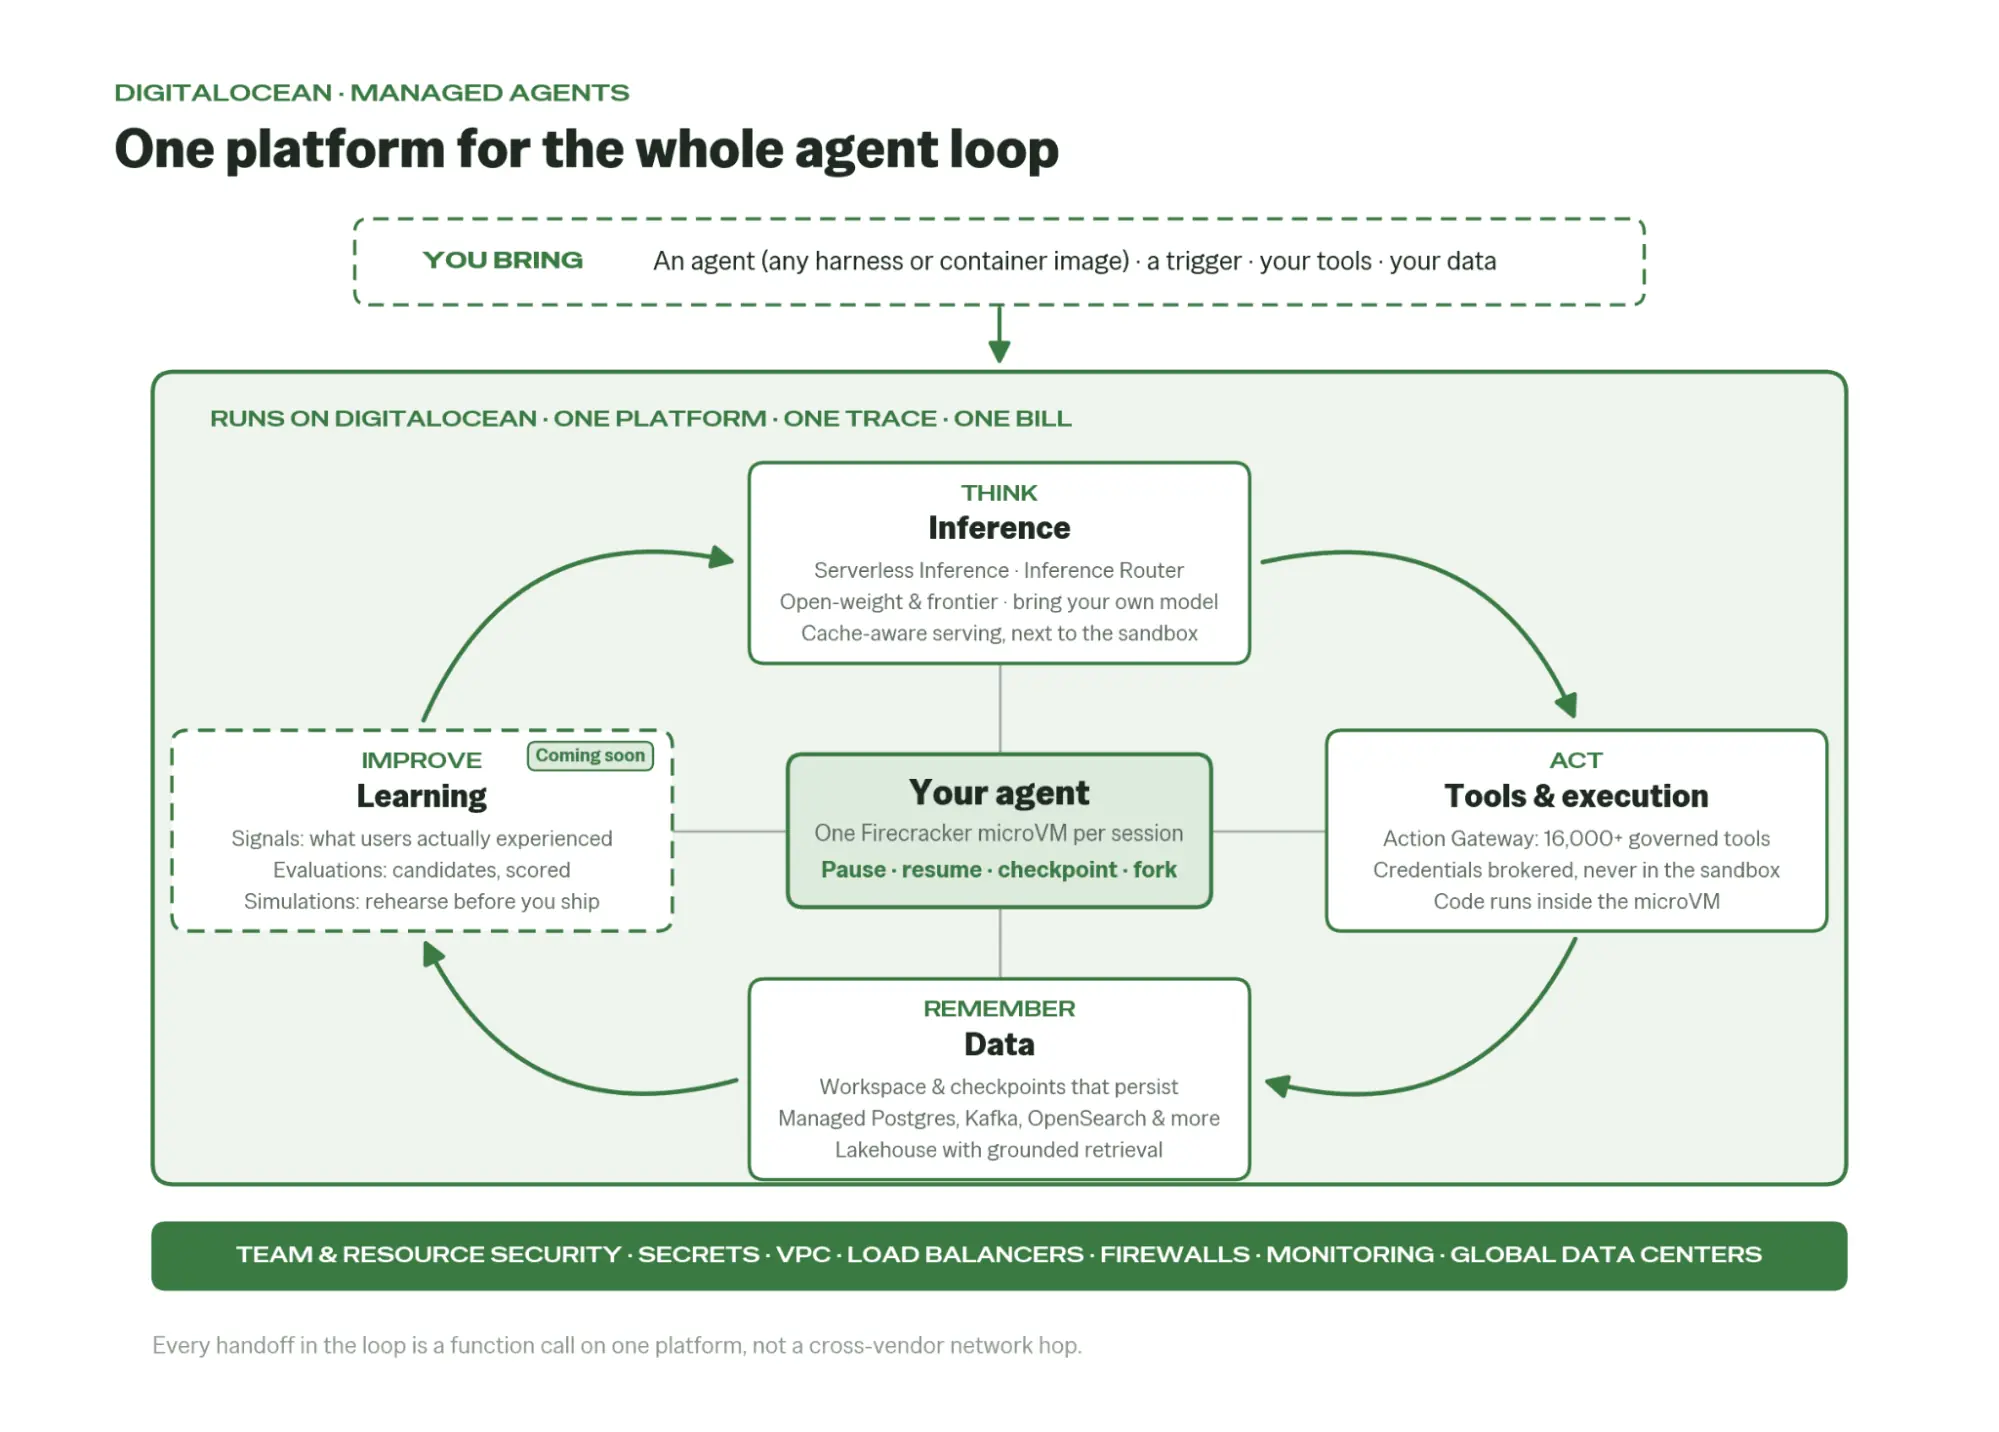
如图所示,Agent 循环:思考、行动、记忆、改进。每一步都跑在一个平台上,所以每一次交接都是函数调用,不是跨供应商的一跳。
DigitalOcean Simulations (预览)是让你在发布前,对着模拟用户把整套场景回放一遍:十个生产场景,端到端,不到一分钟。每个事件都会落到我们规划中的 AI Data Platform------一个开放的、基于 Iceberg 的湖仓,你的 Agent 遥测一条 SQL 就能查到。
拼接式技术栈跑不动这个循环。整合式技术栈可以。运行产生数据,数据产生更好的运行。
用 Managed Agents 构建未来
云计算的每个时代,都有自己的计量单位,每个时代都会拿到为它而建的那个平台。十四年前,是 5 美元的 Droplet。今天,是 Managed Agents:计算、推理、数据作为一个运行时,跑在 DigitalOcean AI 原生云上,任何框架、任何模型,干多少活算多少钱,空等不计费。
立即开始。一条命令就能部署你的第一个会话。如果希望了解更多产品详情,可直接咨询 DigitalOcean 中国区战略合作伙伴卓普云(aidroplet.com)。