你的 Agent 聊到第 20 轮就"失忆"?你管理的是历史,高手管理的是上下文
📦 本文属于「AI Agent 全栈实战」系列支线 A 辑。所有工程细节均来自我的真实开源项目: Ticnix/weather-travel-recommend-system ------ 基于气象大数据的出行推荐系统,AI Agent 全栈项目。FastAPI + PostgreSQL(TimescaleDB/pgvector/PostGIS) + Redis;LangGraph + MCP + Skill + RAG,对接 DeepSeek API。
TL;DR :2026 年,"上下文管理"从零散技巧收敛成了三件套------Context Editing (外科手术式删除旧工具结果)、Compaction (全量摘要重写历史)、Memory Tool (Agent 自己读写外置记忆文件)。三者不是竞争关系,是分工。而它们共同遵守一条刚沉淀下来的铁律:压缩已经解决的中段,逐字保住活跃的尾部 。我用这条标准回头审视自己项目里 HISTORY_LIMIT = 10 的硬截断,发现了它真正的毛病------不是丢得太多,而是丢错了地方。
目录
- 我项目的真实配置:最近 10 条,硬截断
- "历史"和"上下文"是两个物种
- 长对话为什么变蠢:四种病
- 2026 三件套:删、重写、外置
- 那条铁律:压缩中段,保住尾部
- 落地:我的 10 条截断怎么升级
- 可复用清单
1. 我项目的真实配置:最近 10 条,硬截断
先看我自己写的代码。多轮对话的记忆,我是这么做的:全量消息按 user_id + conversation_id 存进 PostgreSQL,每次请求时取最近几条拼进 prompt:
python
# chat_history_service.py
# 拼进多轮上下文的历史条数(取最近 N 条消息,超出截断)
HISTORY_LIMIT = 10

async def get_recent_history(user_id, conversation_id, limit=HISTORY_LIMIT, ...):
    stmt = (
        select(ChatMessage)
        .where(ChatMessage.user_id == user_id,
               ChatMessage.conversation_id == conversation_id)
        .order_by(ChatMessage.id.desc())
        .limit(limit)
    )
    rows = (await s.execute(stmt)).scalars().all()
return [{"role": r.role, "content": r.content} for r in reversed(rows)]这个设计当年我觉得挺得意:全量落库、按需取近。用户聊天记录一条不丢(前端回放侧栏随时能看完整历史),模型只看最近 10 条,窗口永远可控。
用 LangChain 那套分类法看,这属于四框架里的 Compress(压缩) 中最原始的一档------不是摘要,是修剪(trimming):硬编码启发式,从列表尾部往前数,数够就扔。
它工作得不错------直到对话超过 10 条。而我真正意识到它有问题,是搞明白下面这件事之后。
2. "历史"和"上下文"是两个物种
这是我今年想清楚的第一件事:我把两个概念混在一起了。
- 历史(history) :给"回放"用的。用户想翻三个月前的对话,侧栏点开,一条不落。它服务于人。
- 上下文(context) :给"推理"用的。模型这一轮要做出好回答,需要哪些信息在场。它服务于模型。
我的架构其实已经做了这个分离------DB 是历史,最近 10 条是上下文。分离本身没错,错在从历史到上下文的那道"选择"太糙:只按时间数条数,不看内容重要性。
打个比方:这就像你准备一场重要会议,秘书的策略是"只带最近 10 封邮件进会议室"------不是按相关性挑,是按时间挑。如果 11 封邮件之前刚发生过"预算从 200 改成 500"的决定,对不起,没带进来。你会看到会上有人拿着过时数字重新讨论一遍已经定死的事。
Agent 也会。而且它不会像人一样说"等等,这个数字是不是改过了?"------它只会自信地用旧数字。
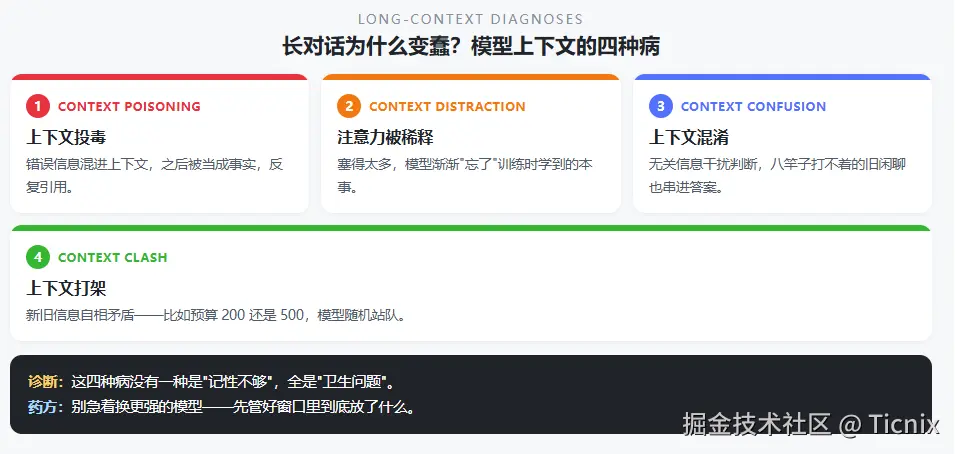
3. 长对话为什么变蠢:四种病
Drew Breunig 给过长上下文的病理清单(LangChain 那篇著名的 Context Engineering 引用过),我按自己的理解重新讲一遍:
| 病 | 通俗版 | 在我项目里的样子 |
|---|---|---|
| Context Poisoning | 幻觉进了上下文,被当事实反复引用 | 一次天气查询返回了错的城市名,后面 5 轮模型都在围绕错的规划 |
| Context Distraction | 塞太多,模型"忘了"训练时学到的本事 | 工具返回的原始 JSON 越堆越长,回答质量肉眼可见地下滑 |
| Context Confusion | 无关信息干扰判断 | 十轮前的闲聊还挂在窗口里,模型往出行推荐里硬塞不相关内容 |
| Context Clash | 上下文自相矛盾 | 旧消息说预算 200,新消息说 500------模型随机站队 |
注意一个反直觉的事实:这四种病没有一种是"记性不够"。全是"卫生问题"。所以解法不是换更强的模型,而是管好窗口里到底放了什么。
4. 2026 三件套:删、重写、外置
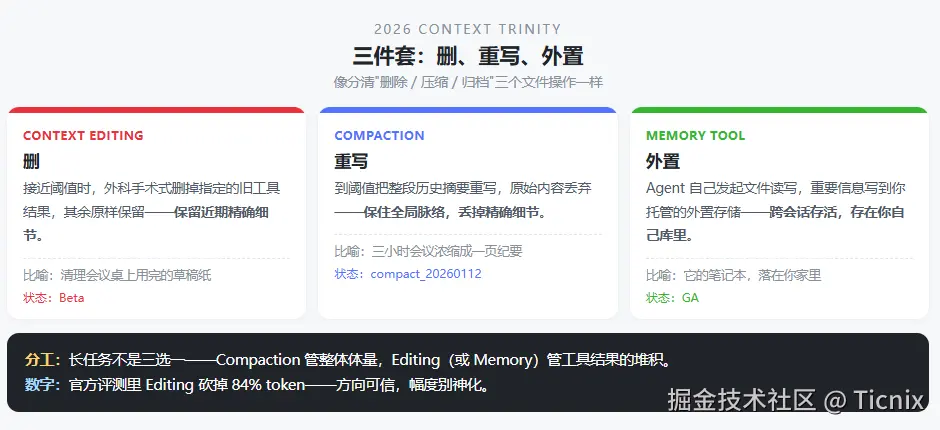
到了 2026 年,Anthropic 把上下文管理做成了三个边界清晰的机制,我第一次分清它们时感觉像第一次分清"删除、压缩、归档"三个文件操作:
| 机制 | 干什么 | 比喻 | 状态(2026 中) |
|---|---|---|---|
| Context Editing | 接近阈值时,外科手术式删除指定的旧工具结果,其余原样保留 | 清理会议桌上已经用完的草稿纸 | Beta(context-management-2025-06-27) |
| Compaction | 到阈值时把整段历史摘要重写,原始内容丢弃 | 把三小时会议浓缩成一页纪要 | compact_20260112 |
| Memory Tool | Agent 自己发起文件 CRUD,把重要信息写到你托管的外置存储,跨会话存活 | Agent 自己的笔记本,落在你家里而非它脑子里 | GA(memory_20250818) |
几个容易被混掉的细节,我都替你踩过了:
Editing 和 Compaction 不是一回事。 Editing 是"删这几条,别的别动"------保留近期的精确细节;Compaction 是"全部重写成摘要"------保住全局脉络但丢掉精确细节。Anthropic 官方给的建议是长任务两者都要:Compaction 管整体体量,Editing(或 Memory)管工具结果的堆积。
Memory Tool 的执行方是"你"。 模型只是发出 view / create / str_replace 这类操作请求,真正读写文件的是你的应用代码,文件存在你自己的存储里。所以它不依赖平台,你可以接到自己的数据库上------这一点对我们这种自建后端的项目特别友好。
数字要诚实看。 官方口径:Editing 在 100 轮网页搜索评测中把 token 消耗砍了 84% ;Editing + Memory 组合比基线性能高 39%(单 Editing 是 29%)。但注意这些都是 Anthropic 自家 eval 的数字------方向可信,幅度别神化,尤其你的 Agent 如果单任务就几轮结束,触发阈值都摸不到,这些数字跟你没关系。
5. 那条铁律:压缩中段,保住尾部
三件套之上,是今年业界反复被验证的一条实践铁律,我觉得它是整篇文章最值得记住的一句话:
Compress the resolved middle, keep the live tail verbatim. 压缩已经解决的中段,逐字保住活跃的尾部。
为什么尾部不能摘要?因为有损摘要最容易杀死的就是"最近几轮" :刚做的决定、刚拿到手的未解决问题、刚确认的约束。一旦这些被压成一句"用户讨论了预算问题",模型在下一轮就很可能把已经定死的决定重新诉讼一遍------表现为反复确认你已经回答过的问题,或者用回被否决的方案。用户看起来就是"这 Agent 怎么越聊越回去"。
同理,Anthropic 给 Compaction 的"保什么 / 丢什么"清单,我一直贴在项目文档里:
必须保留:
- 已定的架构决策和为什么(防止重新论证)
- 未解决的 bug 和 blocker 的当前状态(不是诊断历史)
- 已经做了什么、测到哪一步
- 当前目标和子目标
可以丢弃:
- 已经提取过结论的原始工具输出
- 走进死胡同的推理过程(记一句"试过 X,因为 Y 失败"就够)
- 重复的确认和状态检查
Cognition(就是做 Devin 的那家)在这上面吃过亏才有了更狠的结论:通用模型做摘要不可靠地丢失关键决策 ,他们生产环境用的是专门微调过的压缩模型。这个信息对我这种独立开发者的意义不是"赶紧微调一个",而是------压缩这一步的真实难度被严重低估了,别把它当成调个参数的事。
6. 落地:我的 10 条截断怎么升级
回到 HISTORY_LIMIT = 10。现在你能看出它真正的问题了:截断位置与内容无关。它不区分"刚定的决策"和"十轮前的寒暄"------一刀下去切在哪全看运气。
我的三步升级路线,每一步都不需要重构:
第一步:从"数条数"到"数 token"。 10 条长消息和 10 条短消息差出十倍 token。把 limit=10 换成按 usage_metadata 累计的 token 预算(我的 multi_agent.py 里已经在用 usage_metadata 记账了,复用即可),预算之外的照旧丢弃。
第二步:丢弃前先"过一遍脑子"。 被截断的消息不直接消失------用一个便宜模型把"已解决中段"压成决策摘要("预算已定 500;目的地已选广州"),替换原始内容。这就是手工版 Compaction,且天然满足铁律:摘要只动中段,最近 2-3 轮永远逐字保留。
第三步:把"跨会话必须活下来"的信息写出去。 用户偏好、长期约束这类东西,不该依赖对话历史活着------我项目里已经有偏好注入机制(_with_preferences),方向一致,缺的是让模型自己决定 什么值得写。这是 Memory Tool 的思路,我可以用一个 save_user_memory 工具把它落地,存储直接复用现有 PostgreSQL。
顺便说一句我的私货判断:对一个"查天气、排行程"的对话型 Agent,三件套里优先级最高的是 Memory (用户偏好天然跨会话),Editing 反而排最后------我的工具返回都是短 JSON,没有"巨型工具结果"可删。按自己业务的上下文构成选机制,别按热度。
7. 可复用清单
- 历史 ≠ 上下文:DB 存全量给回放,窗口只放推理所需------分离本身是对的,糙的是"选择"策略
- 窗口卫生 > 窗口容量:Poisoning / Distraction / Confusion / Clash 四种病没有一种是靠更大窗口治好的
- 三件套分工:Editing 删旧工具结果(外科手术)、Compaction 全量重写(会议纪要)、Memory 外置文件(跨会话笔记本)
- 铁律:压缩已解决的中段,逐字保住活跃尾部------尾部有损摘要 = 让模型重新诉讼已定决策
- Compaction 保留清单:决策与理由 / 未解决问题现状 / 已完成事项 / 当前目标;丢弃已提取的原始输出、死胡同推理、重复确认
- 压缩很难:通用模型做摘要会丢关键决策(Cognition 专门微调了压缩模型),别当参数调
- 84% / 39% 是厂商自评:方向可信,幅度别神化;短任务 Agent 连阈值都触发不了
下一篇预告
三件套治的是"窗口里的东西"。但还有一种根本不用治的思路:让脏东西根本没有机会进来 ------把子任务整个丢给一个全新窗口的子 Agent,只让结论回来。这就是四框架里最难也最强的 Isolate(隔离)。下一篇 A7,我拆我自己的 multi-agent:它其实已经在做隔离了,也悄悄付了一笔没人注意的代价。
参考资料
- Anthropic Docs --- Agent Loop & Automatic Compaction ------ compaction 触发机制、
compact_boundary事件、CLAUDE.md 摘要指令 - Anthropic Docs --- Memory Tool & Context Editing ------
memory_20250818(GA)与context-management-2025-06-27(Beta)机制原文 - LangChain Blog --- Context Engineering ------ write / select / compress / isolate 四框架原始出处(2025-07)
- Dev.to --- How AI Agent Memory Works in 2026 ------ "压缩已解决中段、保住活跃尾部"的表述与 Mem0 数据点
- Digital Applied --- Context Engineering: Agent Reliability Playbook 2026 ------ Anthropic/Cognition/LangChain 多源数字汇编
- 项目源码(仍在更新中) :Ticnix/weather-travel-recommend-system ------ 本文
HISTORY_LIMIT与升级路线均来自backend/app/services/chat_history_service.py